

Khóa học
Nhập môn các mô hình Claude
3 giờ
15K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleAnthropic lại vừa có một mẫu mới đứng thứ hai toàn đội hình.
Lần này là Claude Opus 5, được quảng bá là thông minh tiệm cận nhóm dẫn đầu, nhưng có giá chỉ bằng một nửa Claude Fable 5 và hơn thế nữa, Opus 5 thực sự vượt Fable 5 ở một số bài đánh giá về lập trình và công việc tri thức, bao gồm Frontier-Bench và GDPval-AA. Nó chỉ xếp sau Mythos 5, vốn vẫn chưa được phát hành rộng rãi.
Dưới đây là phần điểm qua những điểm mới ở Opus 5, cách nó thể hiện ở nhiều bài kiểm định, những gì Anthropic nói về cân chỉnh an toàn, và mức giá.
Opus 5 là bản phát hành mới nhất trong tầng Opus của Anthropic, về năng lực tổng thể thì nằm dưới Mythos, nhưng trên Sonnet và Haiku.
Anthropic cho biết mẫu mới nhất của họ “biết suy nghĩ và chủ động” (họ luôn có chút nhân hóa). Họ cũng nói mô hình được xây cho việc sử dụng hằng ngày, tức là đủ hiệu quả để chạy liên tục đối với kỹ sư AI.
Ở các bài đánh giá lập trình và công việc tri thức như Frontier-Bench và GDPval-AA, Anthropic nói Opus 5 hiện là mẫu tối tân nhất trong nội bộ, dù vẫn thua Mythos 5 ở các tác vụ an ninh mạng, điều chúng tôi đã phân tích kỹ trong bài viết Mythos 5.
Để xem đối đầu trực tiếp với các mẫu đối thủ và “anh em”, hãy đọc các bài so sánh sau:
Hai điểm nổi bật theo cách Anthropic mô tả điều thực sự mới: chuyển hướng sang hoàn thành nhiệm vụ thay vì dừng ở một câu trả lời có vẻ hợp lý, và bước nhảy về chất lượng đầu ra trực quan.
Thay đổi định tính lớn nhất của Opus 5 là sẵn sàng tiếp tục làm việc cho đến khi nhiệm vụ thật sự thành công. Anthropic cho một số hình dung như sau:
Sự sẵn sàng lặp lại thay vì chấp nhận câu trả lời có vẻ hợp lý này dường như là động lực giúp Opus 5 bứt phá ở các điểm chuẩn tác tử như Frontier-Bench.
Anthropic cũng nhấn mạnh Opus 5 có khả năng tạo đầu ra trực quan mạnh mẽ hơn đáng kể so với các mẫu trước, dẫn chứng bằng các ví dụ như mô phỏng kiểu hầm gió dòng khí chảy qua các vật thể khí động học, như một chiếc ô tô. Đây là ví dụ thuyết phục, và là tin tốt nếu công việc của bạn liên quan đến dựng sơ đồ sinh thành.
Bảng này chỉ bao gồm các mẫu của riêng Anthropic. Tôi xem các bản phát hành tương ứng và ghép lại trong phạm vi có thể. Tôi sẽ so sánh Opus 5 với các mẫu cạnh tranh ở phần tiếp theo.
Lưu ý: “không công bố” hoặc “không xuất bản” nghĩa là mẫu đó không được đưa vào bài kiểm định cụ thể trong bản phát hành tương ứng, chứ không phải điểm bằng không.
| Bài kiểm định | Haiku 4.5 | Sonnet 4.6 | Opus 4.7 | Opus 4.8 | Sonnet 5 | Fable 5 | Opus 5 |
|---|---|---|---|---|---|---|---|
| SWE-bench Verified | 73.3% | 79.6% | 87.6% | 88.6% | — | 95.0% | 96.0% |
| SWE-bench Pro | — | 58.1% | 64.3% | 69.2% | 63.2% | 80.3% | 79.2% |
| Terminal-Bench | 41% | 67.0% (2.1) | 69.4% (2.0) | 74.6% (2.1) | 80.4% (2.1) | 88.0% (2.1) | not published |
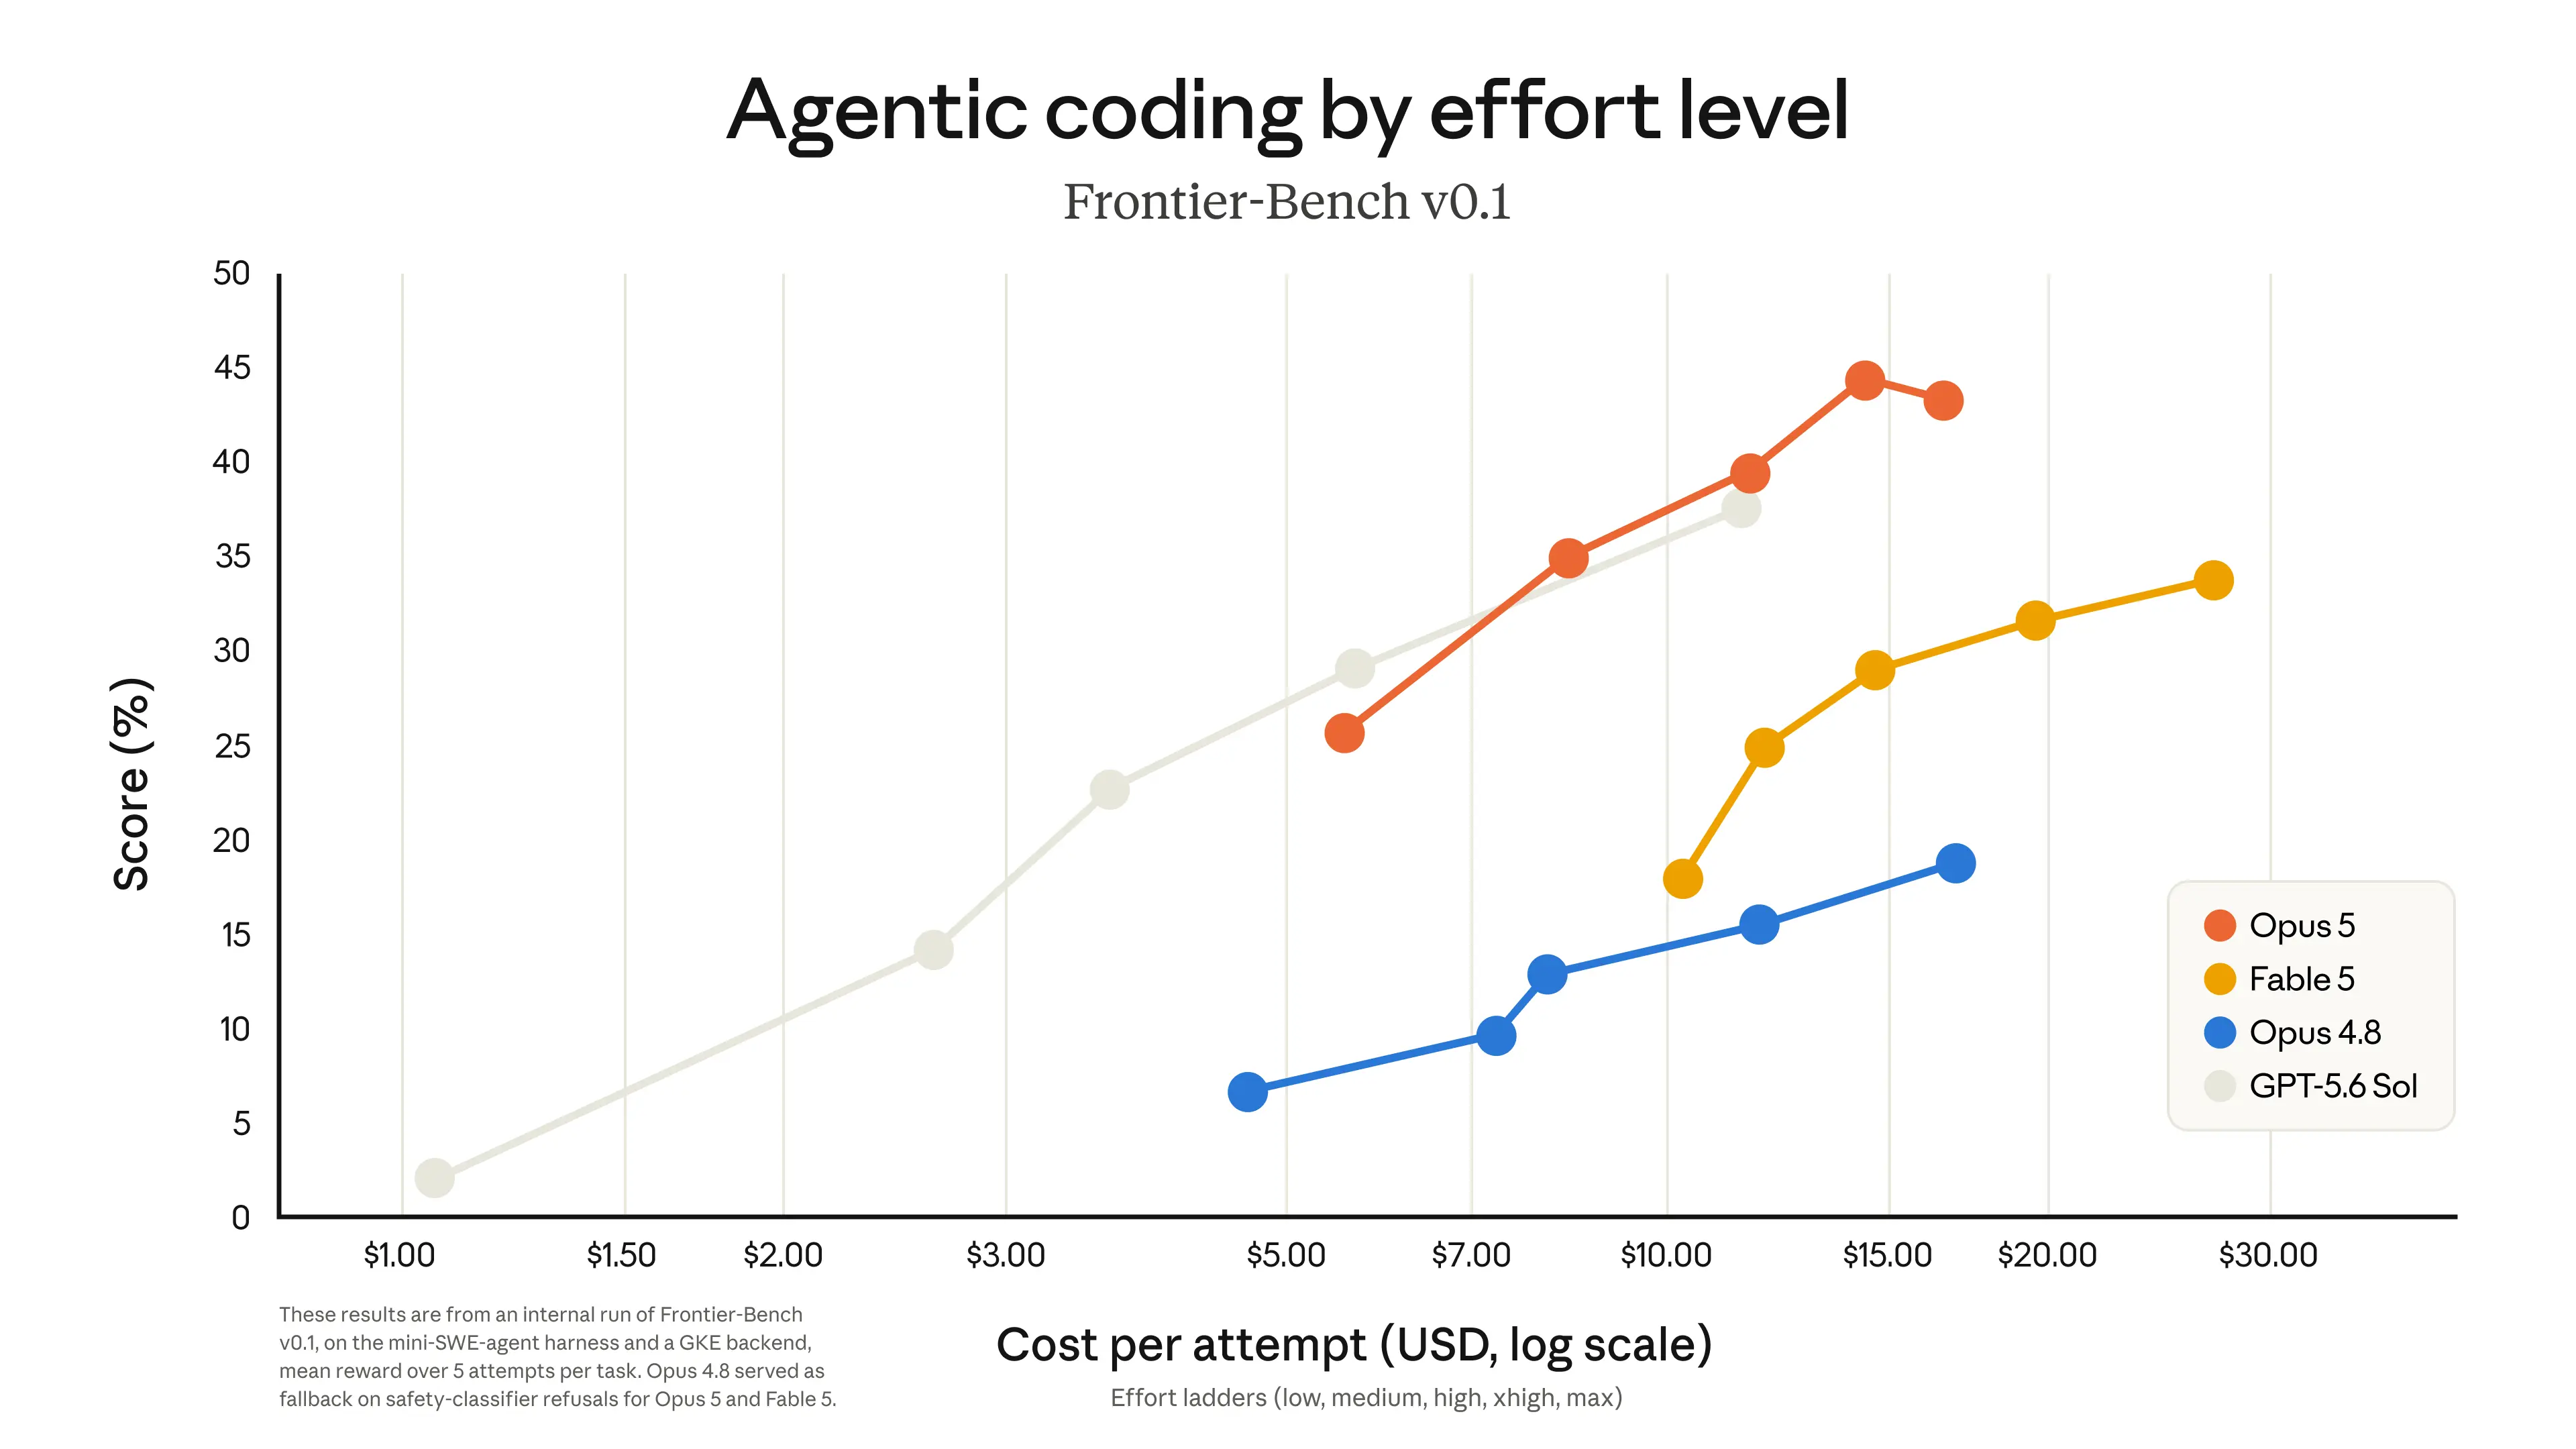
| Frontier-Bench v0.1 (đánh giá mới) | — | — | — | 18.7% | — | 33.7% | 43.3% |
| GDPval-AA / v2 (Elo, /2000) | — | — | 1,753 | 1,890 (v1) / 1,593 (v2) | 1,618 (v2) | 1,747 (v2) | 1,861 (v2) |
| Kiểm toán hành vi lệch chuẩn (thấp = tốt hơn) | — | — | — | not disclosed | not disclosed | not disclosed | 2.3 (tốt nhất tới nay) |
| Giá ($/MTok vào/ra) | $1/$5 | $3/$15 | $5/$25 | $5/$25 | $2–3/$10–15 | $10/$50 | $5/$25 |
Bạn có thể thấy trong bảng trên rằng Opus 5 thực sự vượt “người anh em” đắt tiền hơn ở Frontier-Bench v0.1 (43.3% so với 33.7%) và GDPval-AA v2 (1861 so với 1747) — lại còn với mức giá chỉ bằng một nửa Fable 5.
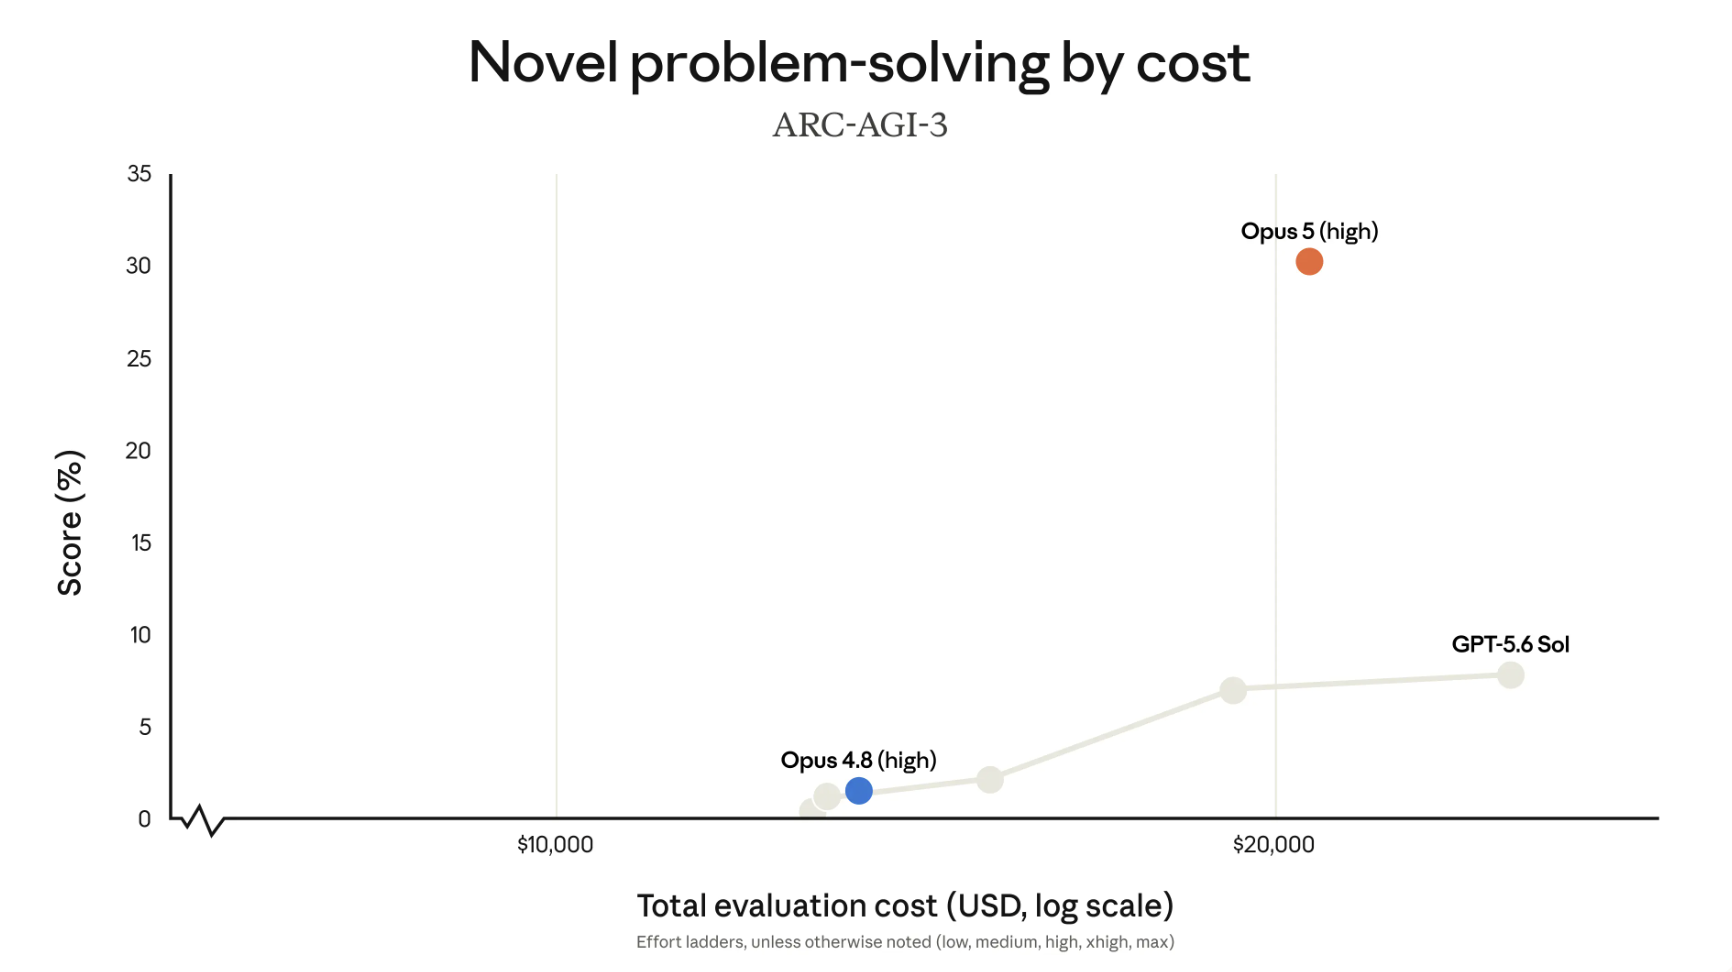
Đây là bước nhảy thế hệ rõ ràng nhất: Opus 5 dẫn trước tiền nhiệm ở ARC-AGI-3, từ 1.5% lên 30.2%, và Frontier-Bench v0.1, như bạn thấy trong bảng, tăng hơn gấp đôi (43.3% so với 18.7%). Xin nhớ rằng Opus 4.8 mới ra mắt cách đây chỉ hai tháng.
Bảng so sánh sau được tổng hợp bằng cách lấy trực tiếp kết quả điểm chuẩn từ các thông báo phát hành mô hình do Anthropic, OpenAI và Google công bố. Tôi chọn đưa vào các hàng nơi đủ nhiều mô hình có điểm số được công bố và có thể so sánh để hàng đó có ý nghĩa. Ngoài ra, các điểm chuẩn chỉ được báo cáo bằng những tuyên bố mơ hồ mang tính tương đối thì tôi loại ra.
| Danh mục | Bài kiểm định | Claude Opus 5 | GPT-5.6 Sol | GPT-5.6 Sol Ultra | GPT-5.6 Terra | GPT-5.6 Luna | GPT-5.5 | Gemini 3.6 Flash | Gemini 3.5 Flash-Lite | Gemini 3.5 Flash | Gemini 3.1 Pro Preview |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Công việc tri thức | GDPval-AA v2 (Elo) | 1861 | 1736 | — | 1593 | 1591.8 | 1493.7 | 1421 | — | 1348.8 | 962.3 |
| Lập trình | SWE-Bench Pro | 79.2% | 64.6% | — | 63.4% | 62.7% | 59.4% | — | 54.2% | — | 54.2% |
| Lập trình | DeepSWE v1.1 | 68.8% | 72.7% | — | 69.6% | 67.2% | 67% | 49% | — | 37% (đường cơ sở) | 11.8% |
| Lập trình | Terminal-Bench 2.1 | — | 88.8% | 91.9% | 87.4% | 84.7% | 85.6% | — | 54% (so với đường cơ sở 3.1 Flash-Lite là 31%) | — | 70.7% |
| Lập trình | Frontier-Bench v0.1 (lập trình trong terminal) | 43.3% | 37.5% | — | — | — | — | — | — | — | — |
| Sử dụng máy tính | BrowseComp | 90.8% | 90.4% | 92.2% | 87.5% | 83.3% | 84.4% | — | — | — | 85.9% |
| Sử dụng máy tính | OSWorld 2.0* | 70.6% | 62.6% | — | 50.2% | 45.6% | 47.5% | — | — | — | — |
| Lý luận trừu tượng | ARC-AGI-3 | 30.2% | 7.78% | — | 0.8% | 0.18% | 0.43% | — | — | — | 0.42% |
| Sử dụng công cụ | AutomationBench | 26.0% | 18.1% | — | 15.2% | 14.9% | 12.9% | — | — | 14.5% |
— |
Cần nói rõ: Mọi con số ở đây đều do phòng thí nghiệm phát hành mô hình tự báo cáo, chạy trên bộ khung đánh giá, thiết lập nhắc lệnh, và (trong một số trường hợp) mức cấu hình nỗ lực hay suy luận của chính họ.
Opus 5 dẫn trước ở các bài toán suy luận khó và mới (ARC-AGI-3, Frontier-Bench, AutomationBench) trong khi GPT-5.6 Sol nhỉnh hơn ở các điểm chuẩn lập trình đã thành hình như SWE-Bench Pro và DeepSWE. Điều này có thể gợi ý Opus 5 có lợi thế ở giải quyết vấn đề mở hoặc ít theo khuôn mẫu, trong khi Sol mạnh ở các tác vụ lập trình xác định rõ và được huấn luyện nhiều.
Bản phát hành gần đây của Gemini tập trung vào tầng Flash tối ưu chi phí hơn là flagship tiên phong, nên đa số hàng hoặc không có dữ liệu Gemini, hoặc chỉ có số Flash/Flash-Lite và kém xa cả Opus 5 lẫn GPT-5.6. So sánh này nói nhiều hơn về tầng mô hình chứ không phải năng lực tiên phong của Google.
Ở những nơi hai flagship trùng nhau, Opus 5 dẫn ở các tác vụ suy luận mới và tác tử (ARC-AGI-3, BrowseComp, OSWorld 2.0, AutomationBench), trong khi GPT-5.6 Sol nhỉnh hơn ở lập trình tầm xa (DeepSWE). Sol Ultra, Terra và Luna chủ yếu xuất hiện ở các điểm chuẩn lập trình riêng nơi Opus 5 không có điểm công bố, nên thực ra đây là “một flagship của Anthropic so với cả họ nhà OpenAI” hơn là một phép so sánh một-một gọn gàng.
Opus 5 hiện đã có trên các nền tảng của Claude với mức giá giống tiền nhiệm:
Chế độ nhanh chạy khoảng gấp 2,5 lần tốc độ mặc định, với giá gấp đôi mức cơ bản của Opus 5 trên Claude Platform (hoặc qua tín dụng sử dụng trong Claude Code) — cùng cấu trúc như Opus 4.8.
Nhà phát triển có thể truy cập mô hình qua API bằng chuỗi mô hình claude-opus-5.
Hai tính năng liên quan ra mắt beta cùng Opus 5:
Như các bản Opus trước, Opus 5 không áp dụng yêu cầu lưu trữ dữ liệu cho truy cập phổ thông.
Nếu bạn thấy gần đây chúng tôi viết khá nhiều về các mẫu Claude, là vì đúng thế. Anthropic đang tập trung mạnh vào cải tiến nhanh để tối ưu năng lực và hiệu suất mô hình.
Hiện Anthropic đã tạo ra thứ gì đó nhìn chung tốt hơn mẫu tốt nhất trước đây, Fable 5. Nó đi kèm mức giá thấp hơn đáng kể, đồng thời công bố các chỉ số cân chỉnh tốt nhất từ trước đến nay.
Tiếp theo là gì? À, Haiku là mẫu lâu đời nhất của Anthropic, và chúng ta vẫn đang chờ nâng cấp lên series 5. Đó là một dự đoán cho bước tiếp theo, nhưng Anthropic vẫn luôn khiến chúng ta bất ngờ.
Học cùng DataCamp
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
