Cursor 于 2026 年 3 月 19 日发布了Composer 2,这是其第三代自研代码模型。该发布仅比Composer 1.5 晚了六周,后者在不改变底层架构的情况下,将同一基础模型上的强化学习扩展了 20 倍。那次 RL 扩展实际上超过了原始预训练的算力预算,这说明它已将既有基础推到了极限。Composer 2 采用不同路径:先进行持续预训练以夯实基础,再叠加 RL。这也是为何在短时间内基准分数跃升如此之大的原因。
它还提供 200,000 令牌的上下文窗口,以及两种定价版本:Standard 每百万输入令牌 $0.50(比 Composer 1.5 便宜约 86%),以及用于实时交互会话的 Fast 版本。
本文将解析 Composer 2 是什么、它在基准和成本上如何对比 Composer 1.5,以及它与 Claude Opus 4.6 与 GPT-5.4 的对比。我们还会讲解如何在 Cursor 中使用它以及其已知局限。
如果您对与 Composer 2 竞争的前沿模型感兴趣,请查阅我们的指南:
什么是 Composer?
Composer 是 Cursor 的自研 AI 代码模型家族,专为在 Cursor IDE 内的代理式编码而设计。与 Claude Opus 4.6 或 GPT-5.4 等通用模型不同,Composer 模型专注于多文件编辑、终端命令执行以及跨代码库的重构。它们并非用于写邮件、答题或任何非代码任务。
该谱系始于一个名为 Cheetah 的内部原型,随后经历三次公开发布:
|
模型
|
发布日期
|
关键创新
|
|
Composer 1
|
2025 年 10 月 29 日
|
首个自研模型;采用 MoE 架构并进行 RL 训练
|
|
Composer 1.5
|
2026 年 2 月 9 日
|
在相同基础上增加 20 倍 RL 算力;自适应思考;引入自我摘要
|
|
Composer 2
|
2026 年 3 月 19 日
|
首次进行持续预训练以打造新基础;改进自我摘要;成本大幅降低
|
每一代都建立在前一代之上,但 Composer 2 标志着迄今为止最大的架构转变。
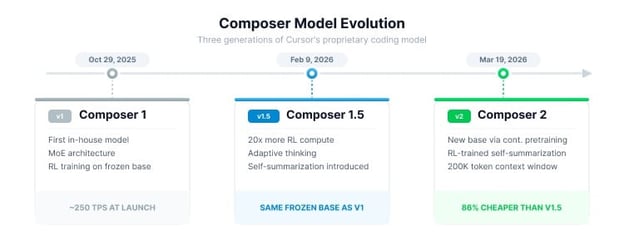
Composer 模型演进时间线可视化。图片来源:作者。
什么是 Composer 2?
Composer 2 是 Cursor 的第三代自研代理式编码模型,也是该系列中首个经历持续预训练的模型。
架构与训练方法
此前的 Composer 模型是在冻结的基础模型之上叠加强化学习来构建的。可以将其理解为:在不提升基础理解力的情况下教授新技能。Composer 2 则先用面向编码的数据更新基础模型的底层权重,再叠加 RL。
该模型采用专家混合(Mixture-of-Experts)(MoE)架构,即针对任一输入,仅有部分参数被激活。这在保持总参数量较大的同时,维持了推理速度。Cursor 未公布精确参数量。
基础模型的身份在发布时未披露,但在 2026 年 3 月 20 日因用户在 API 请求头中发现而公开。Cursor 开发者教育副总裁 Lee Robinson确认 Composer 2 构建于Kimi K2.5 之上,这是来自 Moonshot AI 的开源模型。他表示,约四分之三的总算力来自 Cursor 自身的训练(持续预训练和 RL),而非基础模型,这也解释了为何评测表现不同于原始 Kimi K2.5 的结果。
Moonshot AI 随后确认通过 Fireworks AI 建立了授权的商业合作关系,后者负责 RL 训练基础设施与推理。联合创始人Aman Sanger 称团队用基于困惑度的基准评估了多个基础模型后选择 Kimi K2.5,并将后续训练描述为持续预训练加上 4 倍规模的 RL 算力扩展。
训练基础设施运行在 PyTorch 与 Ray 上,使用针对 NVIDIA Blackwell GPU 优化的定制 MXFP8 量化内核。
自我摘要
自我摘要(Cursor 称为“环内压缩 RL”)的工作方式如下:当模型的 200,000 令牌上下文窗口开始被填满时,它会暂停,将自身上下文压缩到约 1,000 个令牌,然后继续工作。由于该压缩行为是 RL 奖励函数的一部分,模型会学习保留哪些变量、架构决策和错误日志,以及丢弃哪些内容。
Cursor 的研究博客报告称,相较基于提示的摘要,此方法将压缩错误减少了 50%,同时仅使用约五分之一的令牌。在一次实际演示中,Composer 2 用 170 步解决了 Terminal-Bench 2.0 中的“make-doom-for-mips”问题,并在过程中压缩了超过 100,000 个令牌的上下文。
核心能力
在一次会话中,Composer 2 可访问:
这些能力结合在一起,让代理能够在单次会话中跨多文件、多步骤工作。
Composer 2 的版本
Cursor 提供两个 Composer 2 版本,二者共享相同的底层智能。
Composer 2 Fast
当您在模型下拉菜单中选择 Composer 2 时,默认即为Fast 版本。它专为低延迟的交互式会话打造,适合您实时编码并希望获得近乎即时的响应。
Composer 2 Standard
相比之下,Standard 版本速度较低,但每个令牌的成本显著更低,更适合后台任务、批量重构或不需要即时反馈的长时间代理循环。
以下是定价分解:
|
版本
|
输入(每 100 万令牌)
|
缓存读取(每 100 万令牌)
|
输出(每 100 万令牌)
|
|
Composer 2 Standard
|
$0.50
|
$0.20
|
$2.50
|
|
Composer 2 Fast(默认)
|
$1.50
|
$0.35
|
$7.50
|
您可以在主动编码时使用 Fast 版本,而在通宵或批量操作时切换到 Standard,以降低额度消耗。我们将在后文进一步介绍定价差异。
Composer 2 基准测试
Cursor 通过三项基准评估 Composer 2,分别覆盖编码性能的不同方面。
理解这些基准
CursorBench 是 Cursor 的内部专有基准,目前为 CursorBench-3 版本。任务来自真实的 Cursor 会话,使用名为 Cursor Blame 的工具溯源——将提交的代码追溯到生成它的代理请求。该基准衡量解法正确性、代码质量、效率与交互行为,问题规模自初版至 CursorBench-3 在代码行数与文件数上大约翻倍。Cursor 还通过受控的实时流量实验补充 CursorBench,以捕捉离线评分难以发现的回归。显而易见的注意点:CursorBench 不能公开复现,因此这些分数无法独立验证。
Terminal-Bench 2.0 由 Laude Institute 维护,测试 AI 代理在终端环境中执行真实任务的能力。这包括目录导航、运行脚本、解析错误并迭代求解。Cursor 使用官方 Harbor 评估框架的默认设置,对每个模型运行五次并报告平均值。
SWE-bench Multilingual 是 SWE-bench 的一个子集,涵盖 9 种编程语言的 300 个任务。它衡量解决真实 GitHub Issue 的能力,因而是跨语言编码的合理测试。
跨 Composer 代际的基准结果
每一代的得分都在提升:
|
基准
|
Composer 1
|
Composer 1.5
|
Composer 2
|
|
CursorBench
|
38.0
|
44.2
|
61.3
|
|
Terminal-Bench 2.0
|
40.0
|
47.9
|
61.7
|
|
SWE-bench Multilingual
|
56.9
|
65.9
|
73.7
|
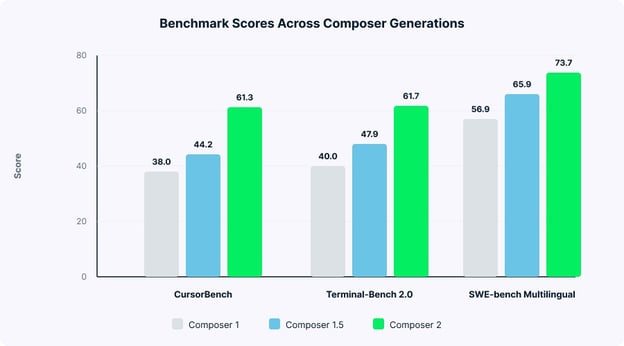
三代 Composer 的基准分数对比。图片来源:作者。
关于基准局限性的说明
- CursorBench 是闭源且无法独立复现。Cursor 未在 SWE-bench Verified 等既有基准上公布分数,这一点与社区部分观点不一致。
- SWE-bench Verified 在 OpenAI 发现前沿模型可凭记忆重现测试补丁,且近 60% 的未解问题存在有缺陷的测试后,已不再由其报告。
- Terminal-Bench 包含谜题式任务(如从棋局中找最佳一步),与实际开发工作不完全相符。但因其采用公开框架并记录评测方法,仍是三者中透明度最高的。
Composer 2 比 Composer 1.5 好多少?
从 Composer 1.5 到 Composer 2 的提升,是历代中最大的一次,覆盖性能与成本两方面。
如上表所示,Composer 2 在 CursorBench 上得分 61.3,相比 Composer 1.5 的 44.2 提升约 39%。Terminal-Bench 2.0 的差距约 29%(61.7 对 47.9),SWE-bench Multilingual 提升约 12%(73.7 对 65.9)。
成本下降幅度甚至大于基准提升。根据 Cursor 的发布博客,Composer 2 Standard 在输入令牌上的成本比 Composer 1.5 低约 86%,即便是 Fast 版本也低约 57%。Cursor 未单独发布 Composer 1.5 的定价页面,因此这些百分比来自其发布时的对比。
关键技术差异在于:
- 训练路径:Composer 1.5 在相同冻结基础上将 RL 进一步扩展了 20 倍,且后训练的 RL 算力甚至超过了用于预训练基础模型的算力。Composer 2 则先通过持续预训练打造更强的新基础,再在其上进行 4 倍规模的 RL 扩展。
- 自我摘要质量:Composer 1.5 引入了自我摘要,但使用带有数千令牌指令的基于提示压缩,生成的摘要平均约 5,000 令牌。Composer 2 的 RL 训练压缩可产出约 1,000 令牌、错误减少 50% 的摘要,并重用先前令牌的 KV 缓存,进一步降低推理成本。
- 长程能力:Composer 2 能处理需要数百次连续操作的任务。正如前文所述,这超出了 1.5 稳定可达的范围。
社区对 Composer 1.5 的反馈不一。部分开发者认为其只适合小任务,如提交与简单编辑。基准数据表明,开发者吐槽较多的方面已有改进。
Composer 2 vs. Claude Opus 4.6 vs. GPT-5.4
这可能是多数读者最关心的对比。Composer 2 在部分编码基准上超过 Claude Opus 4.6,在大多数方面落后于 GPT-5.4,但成本远低于二者。
基准对比
数据基本说明了一切:
|
基准
|
Composer 2
|
Claude Opus 4.6
|
GPT-5.4
|
|
CursorBench
|
61.3
|
~58.2
|
~63.9
|
|
Terminal-Bench 2.0
|
61.7
|
58.0
|
75.1
|
|
SWE-bench Verified
|
未报告
|
~80.8%
|
~80.0%
|
Composer 2 与 Claude Opus 4.6、GPT-5.4 对比
Composer 2 在 CursorBench 与 Terminal-Bench 2.0 上小幅领先 Opus 4.6,但 GPT-5.4 在二者上均明显领先。Terminal-Bench 2.0 中,Composer 2(61.7)与 GPT-5.4(75.1)相差 13 分。
需要注意:Terminal-Bench 2.0 的分数衡量的是“代理+模型”的组合,而非裸模型。Cursor 的分数使用 Harbor 评估框架;而 GPT-5.4 的 75.1 对应官方榜单上的 Simple Codex harness 条目。不同测评器对同一模型可能产生不同结果。
定价对比
以下是价格对比:
|
模型
|
输入(每 100 万令牌)
|
输出(每 100 万令牌)
|
|
Composer 2 Standard
|
$0.50
|
$2.50
|
|
Composer 2 Fast
|
$1.50
|
$7.50
|
|
Claude Opus 4.6
|
$5.00
|
$25.00
|
|
GPT-5.4
|
$2.50
|
$15.00
|
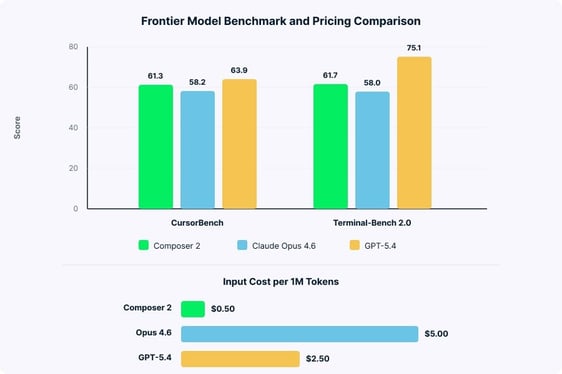
基准分数与令牌定价对比。图片来源:作者。
Composer 2 Standard 的令牌价格约比 Opus 4.6 低 90%,比 GPT-5.4 低约 80%。对于每天运行数千次代理请求的团队而言,这一差距会迅速累积为可观成本节省。
各模型最擅长的领域
Composer 2 是仅限 Cursor IDE 使用的纯代码模型。它能以较低成本快速处理常规编码任务,但无法处理代码以外的任何内容。
Claude Opus 4.6 具备 200,000 令牌上下文窗口(并提供 100 万令牌的更高成本 Beta),擅长多文件架构规划,并通过 Agent Teams 支持多代理编排。它是通用模型,但在代码方面表现出色。
GPT-5.4 在最难的编码基准上领先,具备原生电脑使用能力,并支持 105 万令牌的实验性上下文窗口。它是单模型中能力最强的,但在大规模运行时成本也最高。
Cursor 的卖点是在 IDE 内每个任务的性价比,而非绝对的基准领先。
Composer 2 vs. Claude Code vs. GitHub Copilot
前文比较的是原始模型。下面从产品层面来看。
Claude Code 是 Anthropic 的基于终端的编码代理。根据2026 年开发者调研,它如今是专业人士使用最多的 AI 编码工具,其中 46% 的受访者将其列为最爱,而 Cursor 为 19%。许多开发者在日常 IDE 编辑中使用 Cursor,而在复杂的自主任务上切换至 Claude Code。二者更多是互补,而非竞争。
GitHub Copilot 仍是采用最广的工具,累计用户超 2,000 万,且入门价更低($10/月)。其近期新增了多步动作的 Agent 模式,但许多开发者反映 Cursor 的多文件编辑更深入。
目前约有 70% 的开发者同时使用两到四个 AI 工具。问题不再是“选哪个?”,而是“选哪种组合?”
如何使用 Composer 2
Composer 2 完全运行在 Cursor IDE 内,无需单独安装。
分步设置
要开始使用 Composer 2,请从cursor.com 下载或更新 Cursor。Composer 2 对所有付费方案(Pro、Pro+、Ultra、Teams、Enterprise)开放。Mac 使用 Cmd+I 或 Windows/Linux 使用 Ctrl+I 打开代理面板,然后在模型下拉菜单中选择“Composer 2”或“Composer 2 Fast”。默认选择 Fast 版本。
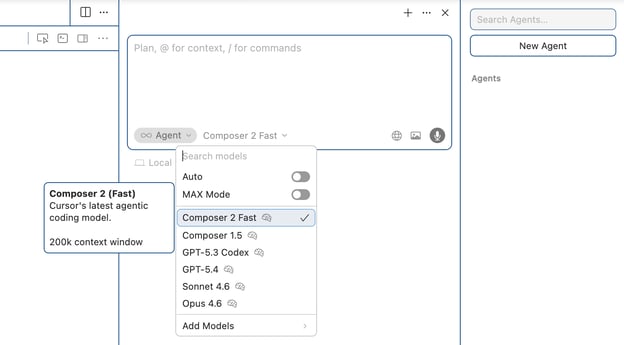
定位 Cursor 模型选择下拉菜单。图片来源:作者。
接下来,输入对任务的自然语言描述。Composer 2 默认以 Agent 模式运行,意味着它可自主探索您的代码库、进行修改、运行终端命令并使用所有可用工具。您在代理工作过程中审核并接受或拒绝变更。
常用快捷键
以下是您在使用 Composer 2 时最常使用的快捷键:
|
操作
|
Mac
|
Windows/Linux
|
|
打开 Agent/Composer
|
Cmd+I
|
Ctrl+I
|
|
新建会话
|
Cmd+N
|
Ctrl+N
|
|
切换模式(Agent/Ask/Edit)
|
Cmd+.
|
Ctrl+.
|
|
Ask 模式(只读)
|
Cmd+L
|
Ctrl+L
|
|
行内编辑
|
Cmd+K
|
Ctrl+K
|
|
打开历史
|
Cmd+Opt+L
|
Ctrl+Alt+L
|
管理上下文
Composer 2 支持多种方式控制可见上下文。输入 @ 后跟文件名、文件夹或 URL 可将特定上下文注入提示中。# 符号可聚焦到某个特定文件。聊天顶部的上下文胶囊展示代理当前引用的内容。
对于大型项目,可在设置中启用 Autocontext,让 Cursor 通过嵌入自动提取相关代码。您也可以在设置中添加自定义文档,以便提供特定框架的上下文。
自我摘要的实践
对于长时任务,当上下文窗口填满时,自我摘要会自动触发。您也可以通过 /compress 命令手动压缩。如果代理建议开启新会话,通常意味着上下文已过大,难以高效摘要,开启新会话会更可靠。
Composer 2 定价
有关按令牌计费的内容已在“版本”一节介绍,此处不再复述具体数字。下面说明实际的计费方式。
Cursor 订阅层级
Cursor 使用按额度(credits)计费的分级订阅体系,额度决定您对第三方模型的使用量。当前分级如下:
|
方案
|
价格
|
主要包含
|
|
Hobby
|
免费
|
有限的代理请求与补全
|
|
Pro
|
$20/月(按年计费 $16/月)
|
$20 额度池、无限 Tab 补全、云端代理
|
|
Pro+
|
$60/月(按年计费 $48/月)
|
所有模型 3 倍用量
|
|
Ultra
|
$200/月
|
所有模型 20 倍用量,优先访问
|
|
Teams
|
$40/用户/月(按年计费 $32)
|
集中计费、SAML/OIDC SSO、分析
|
|
Enterprise
|
定制
|
SOC 2、法务审查、先进安全控制
|
Composer 2 与额度的关系
这部分最容易让人困惑。个人方案中对 Composer 的使用来自单独的使用池,与用于 Claude 或 GPT 等第三方模型的额度池分离。Cursor 将该池描述为“包含充足的用量”,但未公布确切上限。
当您使用“Auto”模式(让 Cursor 为每次请求自动选型)时,付费方案中对 Composer 模型的使用不受限且不消耗额度。手动选择高级第三方模型则会从您的月度额度池中扣除。一旦用尽,您可以启用按量付费的超额模式。
定价背景
过去一年里,Cursor 的定价经历了多次调整。2025 年 6 月,其以额度计费取代了“每月 500 次快速请求”的固定制度,实际将 Pro 层的请求量从约 500 次降至约 225 次/月。
截至 2026 年 3 月,GPT-5.4 与 Opus 4.6 等前沿模型按照令牌动态定价并计入您的月度额度池;而 Composer 2 的使用仍在其独立池中。如果您为团队做预算,建议将日常工作默认交给 Composer 2,保留第三方额度处理更高要求的任务。
Composer 2 已知局限
如对比部分所述,Composer 2 是纯代码模型。联合创始人 Aman Sanger 表示:“它帮不了您报税,也写不出诗。”对于通用任务,您仍需在 Cursor 中使用 Claude 或 GPT。
用户反映在严格的多步执行计划中,Composer 2 有时会跳过中间的验证步骤而急于实现。这可能是训练的产物——模型更倾向于推动完成而非验证。
一些用户报告在 macOS 上,Cursor 的后台文件监视器在超大的 monorepo 中会忽略 .gitignore 指令,导致代理索引 node_modules 等依赖文件夹,并意外耗尽令牌额度。
CursorBench 仍为闭源。对于 Terminal-Bench 2.0,Cursor 在非 Composer 模型上采用了“取官方榜单分数与我们基础设施上实测分数的较大值”的做法,这一方法学选择值得知悉。
关于透明度:Cursor 未在发布博客中披露 Kimi K2.5 为基础模型。该遗漏在 2026 年 3 月 20 日因用户在 API 请求头发现模型 ID 而曝光,曾短暂引发关于许可合规的公开争论。 Fireworks AI CEO Lin Qiao 澄清称,Cursor 自第一天起便通过 Fireworks 平台实现合规。Moonshot AI 也确认该合作为授权的商业伙伴关系。Lee Robinson 与联合创始人 Aman Sanger 均承认未披露是“一次疏漏”,并承诺未来将更透明地披露基础模型。
结语
Cursor 曾直言:Composer 2 并非力求成为整体最强模型,其重点是在日常 IDE 工作中以更低成本完成任务。
前文的基准也印证了这一点:Composer 2 在 Terminal-Bench 2.0 上优于 Claude Opus 4.6,且每个令牌的成本约低 90%,但在更难的基准上仍落后于 GPT-5.4。
市场正走向多模型协作流程,而 Cursor 对 Composer 2 的定价方式表明,他们正围绕这一假设构建产品。
若您想进一步了解塑造软件开发版图的 AI 工具,请查看我们的GPT-5.4 vs. Claude Opus 4.6 对比。


Cursor 于 2026 年 3 月 19 日发布了Composer 2,这是其第三代自研代码模型。该发布仅比Composer 1.5 晚了六周,后者在不改变底层架构的情况下,将同一基础模型上的强化学习扩展了 20 倍。那次 RL 扩展实际上超过了原始预训练的算力预算,这说明它已将既有基础推到了极限。Composer 2 采用不同路径:先进行持续预训练以夯实基础,再叠加 RL。这也是为何在短时间内基准分数跃升如此之大的原因。
它还提供 200,000 令牌的上下文窗口,以及两种定价版本:Standard 每百万输入令牌 $0.50(比 Composer 1.5 便宜约 86%),以及用于实时交互会话的 Fast 版本。
本文将解析 Composer 2 是什么、它在基准和成本上如何对比 Composer 1.5,以及它与 Claude Opus 4.6 与 GPT-5.4 的对比。我们还会讲解如何在 Cursor 中使用它以及其已知局限。
如果您对与 Composer 2 竞争的前沿模型感兴趣,请查阅我们的指南:
什么是 Composer?
Composer 是 Cursor 的自研 AI 代码模型家族,专为在 Cursor IDE 内的代理式编码而设计。与 Claude Opus 4.6 或 GPT-5.4 等通用模型不同,Composer 模型专注于多文件编辑、终端命令执行以及跨代码库的重构。它们并非用于写邮件、答题或任何非代码任务。
该谱系始于一个名为 Cheetah 的内部原型,随后经历三次公开发布:
模型
发布日期
关键创新
Composer 1
2025 年 10 月 29 日
首个自研模型;采用 MoE 架构并进行 RL 训练
Composer 1.5
2026 年 2 月 9 日
在相同基础上增加 20 倍 RL 算力;自适应思考;引入自我摘要
Composer 2
2026 年 3 月 19 日
首次进行持续预训练以打造新基础;改进自我摘要;成本大幅降低
每一代都建立在前一代之上,但 Composer 2 标志着迄今为止最大的架构转变。
Composer 模型演进时间线可视化。图片来源:作者。
什么是 Composer 2?
Composer 2 是 Cursor 的第三代自研代理式编码模型,也是该系列中首个经历持续预训练的模型。
架构与训练方法
此前的 Composer 模型是在冻结的基础模型之上叠加强化学习来构建的。可以将其理解为:在不提升基础理解力的情况下教授新技能。Composer 2 则先用面向编码的数据更新基础模型的底层权重,再叠加 RL。
该模型采用专家混合(Mixture-of-Experts)(MoE)架构,即针对任一输入,仅有部分参数被激活。这在保持总参数量较大的同时,维持了推理速度。Cursor 未公布精确参数量。
基础模型的身份在发布时未披露,但在 2026 年 3 月 20 日因用户在 API 请求头中发现而公开。Cursor 开发者教育副总裁 Lee Robinson确认 Composer 2 构建于Kimi K2.5 之上,这是来自 Moonshot AI 的开源模型。他表示,约四分之三的总算力来自 Cursor 自身的训练(持续预训练和 RL),而非基础模型,这也解释了为何评测表现不同于原始 Kimi K2.5 的结果。
Moonshot AI 随后确认通过 Fireworks AI 建立了授权的商业合作关系,后者负责 RL 训练基础设施与推理。联合创始人Aman Sanger 称团队用基于困惑度的基准评估了多个基础模型后选择 Kimi K2.5,并将后续训练描述为持续预训练加上 4 倍规模的 RL 算力扩展。
训练基础设施运行在 PyTorch 与 Ray 上,使用针对 NVIDIA Blackwell GPU 优化的定制 MXFP8 量化内核。
自我摘要
自我摘要(Cursor 称为“环内压缩 RL”)的工作方式如下:当模型的 200,000 令牌上下文窗口开始被填满时,它会暂停,将自身上下文压缩到约 1,000 个令牌,然后继续工作。由于该压缩行为是 RL 奖励函数的一部分,模型会学习保留哪些变量、架构决策和错误日志,以及丢弃哪些内容。
Cursor 的研究博客报告称,相较基于提示的摘要,此方法将压缩错误减少了 50%,同时仅使用约五分之一的令牌。在一次实际演示中,Composer 2 用 170 步解决了 Terminal-Bench 2.0 中的“make-doom-for-mips”问题,并在过程中压缩了超过 100,000 个令牌的上下文。
核心能力
在一次会话中,Composer 2 可访问:
这些能力结合在一起,让代理能够在单次会话中跨多文件、多步骤工作。
Composer 2 的版本
Cursor 提供两个 Composer 2 版本,二者共享相同的底层智能。
Composer 2 Fast
当您在模型下拉菜单中选择 Composer 2 时,默认即为Fast 版本。它专为低延迟的交互式会话打造,适合您实时编码并希望获得近乎即时的响应。
Composer 2 Standard
相比之下,Standard 版本速度较低,但每个令牌的成本显著更低,更适合后台任务、批量重构或不需要即时反馈的长时间代理循环。
以下是定价分解:
版本
输入(每 100 万令牌)
缓存读取(每 100 万令牌)
输出(每 100 万令牌)
Composer 2 Standard
$0.50
$0.20
$2.50
Composer 2 Fast(默认)
$1.50
$0.35
$7.50
您可以在主动编码时使用 Fast 版本,而在通宵或批量操作时切换到 Standard,以降低额度消耗。我们将在后文进一步介绍定价差异。
Composer 2 基准测试
Cursor 通过三项基准评估 Composer 2,分别覆盖编码性能的不同方面。
理解这些基准
CursorBench 是 Cursor 的内部专有基准,目前为 CursorBench-3 版本。任务来自真实的 Cursor 会话,使用名为 Cursor Blame 的工具溯源——将提交的代码追溯到生成它的代理请求。该基准衡量解法正确性、代码质量、效率与交互行为,问题规模自初版至 CursorBench-3 在代码行数与文件数上大约翻倍。Cursor 还通过受控的实时流量实验补充 CursorBench,以捕捉离线评分难以发现的回归。显而易见的注意点:CursorBench 不能公开复现,因此这些分数无法独立验证。
Terminal-Bench 2.0 由 Laude Institute 维护,测试 AI 代理在终端环境中执行真实任务的能力。这包括目录导航、运行脚本、解析错误并迭代求解。Cursor 使用官方 Harbor 评估框架的默认设置,对每个模型运行五次并报告平均值。
SWE-bench Multilingual 是 SWE-bench 的一个子集,涵盖 9 种编程语言的 300 个任务。它衡量解决真实 GitHub Issue 的能力,因而是跨语言编码的合理测试。
跨 Composer 代际的基准结果
每一代的得分都在提升:
基准
Composer 1
Composer 1.5
Composer 2
CursorBench
38.0
44.2
61.3
Terminal-Bench 2.0
40.0
47.9
61.7
SWE-bench Multilingual
56.9
65.9
73.7
三代 Composer 的基准分数对比。图片来源:作者。
关于基准局限性的说明
Composer 2 比 Composer 1.5 好多少?
从 Composer 1.5 到 Composer 2 的提升,是历代中最大的一次,覆盖性能与成本两方面。
如上表所示,Composer 2 在 CursorBench 上得分 61.3,相比 Composer 1.5 的 44.2 提升约 39%。Terminal-Bench 2.0 的差距约 29%(61.7 对 47.9),SWE-bench Multilingual 提升约 12%(73.7 对 65.9)。
成本下降幅度甚至大于基准提升。根据 Cursor 的发布博客,Composer 2 Standard 在输入令牌上的成本比 Composer 1.5 低约 86%,即便是 Fast 版本也低约 57%。Cursor 未单独发布 Composer 1.5 的定价页面,因此这些百分比来自其发布时的对比。
关键技术差异在于:
社区对 Composer 1.5 的反馈不一。部分开发者认为其只适合小任务,如提交与简单编辑。基准数据表明,开发者吐槽较多的方面已有改进。
Composer 2 vs. Claude Opus 4.6 vs. GPT-5.4
这可能是多数读者最关心的对比。Composer 2 在部分编码基准上超过 Claude Opus 4.6,在大多数方面落后于 GPT-5.4,但成本远低于二者。
基准对比
数据基本说明了一切:
基准
Composer 2
Claude Opus 4.6
GPT-5.4
CursorBench
61.3
~58.2
~63.9
Terminal-Bench 2.0
61.7
58.0
75.1
SWE-bench Verified
未报告
~80.8%
~80.0%
Composer 2 与 Claude Opus 4.6、GPT-5.4 对比
Composer 2 在 CursorBench 与 Terminal-Bench 2.0 上小幅领先 Opus 4.6,但 GPT-5.4 在二者上均明显领先。Terminal-Bench 2.0 中,Composer 2(61.7)与 GPT-5.4(75.1)相差 13 分。
需要注意:Terminal-Bench 2.0 的分数衡量的是“代理+模型”的组合,而非裸模型。Cursor 的分数使用 Harbor 评估框架;而 GPT-5.4 的 75.1 对应官方榜单上的 Simple Codex harness 条目。不同测评器对同一模型可能产生不同结果。
定价对比
以下是价格对比:
模型
输入(每 100 万令牌)
输出(每 100 万令牌)
Composer 2 Standard
$0.50
$2.50
Composer 2 Fast
$1.50
$7.50
Claude Opus 4.6
$5.00
$25.00
GPT-5.4
$2.50
$15.00
基准分数与令牌定价对比。图片来源:作者。
Composer 2 Standard 的令牌价格约比 Opus 4.6 低 90%,比 GPT-5.4 低约 80%。对于每天运行数千次代理请求的团队而言,这一差距会迅速累积为可观成本节省。
各模型最擅长的领域
Composer 2 是仅限 Cursor IDE 使用的纯代码模型。它能以较低成本快速处理常规编码任务,但无法处理代码以外的任何内容。
Claude Opus 4.6 具备 200,000 令牌上下文窗口(并提供 100 万令牌的更高成本 Beta),擅长多文件架构规划,并通过 Agent Teams 支持多代理编排。它是通用模型,但在代码方面表现出色。
GPT-5.4 在最难的编码基准上领先,具备原生电脑使用能力,并支持 105 万令牌的实验性上下文窗口。它是单模型中能力最强的,但在大规模运行时成本也最高。
Cursor 的卖点是在 IDE 内每个任务的性价比,而非绝对的基准领先。
Composer 2 vs. Claude Code vs. GitHub Copilot
前文比较的是原始模型。下面从产品层面来看。
Claude Code 是 Anthropic 的基于终端的编码代理。根据2026 年开发者调研,它如今是专业人士使用最多的 AI 编码工具,其中 46% 的受访者将其列为最爱,而 Cursor 为 19%。许多开发者在日常 IDE 编辑中使用 Cursor,而在复杂的自主任务上切换至 Claude Code。二者更多是互补,而非竞争。
GitHub Copilot 仍是采用最广的工具,累计用户超 2,000 万,且入门价更低($10/月)。其近期新增了多步动作的 Agent 模式,但许多开发者反映 Cursor 的多文件编辑更深入。
目前约有 70% 的开发者同时使用两到四个 AI 工具。问题不再是“选哪个?”,而是“选哪种组合?”
如何使用 Composer 2
Composer 2 完全运行在 Cursor IDE 内,无需单独安装。
分步设置
要开始使用 Composer 2,请从cursor.com 下载或更新 Cursor。Composer 2 对所有付费方案(Pro、Pro+、Ultra、Teams、Enterprise)开放。Mac 使用
Cmd+I或 Windows/Linux 使用Ctrl+I打开代理面板,然后在模型下拉菜单中选择“Composer 2”或“Composer 2 Fast”。默认选择 Fast 版本。定位 Cursor 模型选择下拉菜单。图片来源:作者。
接下来,输入对任务的自然语言描述。Composer 2 默认以 Agent 模式运行,意味着它可自主探索您的代码库、进行修改、运行终端命令并使用所有可用工具。您在代理工作过程中审核并接受或拒绝变更。
常用快捷键
以下是您在使用 Composer 2 时最常使用的快捷键:
操作
Mac
Windows/Linux
打开 Agent/Composer
Cmd+I
Ctrl+I
新建会话
Cmd+N
Ctrl+N
切换模式(Agent/Ask/Edit)
Cmd+.
Ctrl+.
Ask 模式(只读)
Cmd+L
Ctrl+L
行内编辑
Cmd+K
Ctrl+K
打开历史
Cmd+Opt+L
Ctrl+Alt+L
管理上下文
Composer 2 支持多种方式控制可见上下文。输入
@后跟文件名、文件夹或 URL 可将特定上下文注入提示中。#符号可聚焦到某个特定文件。聊天顶部的上下文胶囊展示代理当前引用的内容。对于大型项目,可在设置中启用 Autocontext,让 Cursor 通过嵌入自动提取相关代码。您也可以在设置中添加自定义文档,以便提供特定框架的上下文。
自我摘要的实践
对于长时任务,当上下文窗口填满时,自我摘要会自动触发。您也可以通过
/compress命令手动压缩。如果代理建议开启新会话,通常意味着上下文已过大,难以高效摘要,开启新会话会更可靠。Composer 2 定价
有关按令牌计费的内容已在“版本”一节介绍,此处不再复述具体数字。下面说明实际的计费方式。
Cursor 订阅层级
Cursor 使用按额度(credits)计费的分级订阅体系,额度决定您对第三方模型的使用量。当前分级如下:
方案
价格
主要包含
Hobby
免费
有限的代理请求与补全
Pro
$20/月(按年计费 $16/月)
$20 额度池、无限 Tab 补全、云端代理
Pro+
$60/月(按年计费 $48/月)
所有模型 3 倍用量
Ultra
$200/月
所有模型 20 倍用量,优先访问
Teams
$40/用户/月(按年计费 $32)
集中计费、SAML/OIDC SSO、分析
Enterprise
定制
SOC 2、法务审查、先进安全控制
Composer 2 与额度的关系
这部分最容易让人困惑。个人方案中对 Composer 的使用来自单独的使用池,与用于 Claude 或 GPT 等第三方模型的额度池分离。Cursor 将该池描述为“包含充足的用量”,但未公布确切上限。
当您使用“Auto”模式(让 Cursor 为每次请求自动选型)时,付费方案中对 Composer 模型的使用不受限且不消耗额度。手动选择高级第三方模型则会从您的月度额度池中扣除。一旦用尽,您可以启用按量付费的超额模式。
定价背景
过去一年里,Cursor 的定价经历了多次调整。2025 年 6 月,其以额度计费取代了“每月 500 次快速请求”的固定制度,实际将 Pro 层的请求量从约 500 次降至约 225 次/月。
截至 2026 年 3 月,GPT-5.4 与 Opus 4.6 等前沿模型按照令牌动态定价并计入您的月度额度池;而 Composer 2 的使用仍在其独立池中。如果您为团队做预算,建议将日常工作默认交给 Composer 2,保留第三方额度处理更高要求的任务。
Composer 2 已知局限
如对比部分所述,Composer 2 是纯代码模型。联合创始人 Aman Sanger 表示:“它帮不了您报税,也写不出诗。”对于通用任务,您仍需在 Cursor 中使用 Claude 或 GPT。
用户反映在严格的多步执行计划中,Composer 2 有时会跳过中间的验证步骤而急于实现。这可能是训练的产物——模型更倾向于推动完成而非验证。
一些用户报告在 macOS 上,Cursor 的后台文件监视器在超大的 monorepo 中会忽略
.gitignore指令,导致代理索引node_modules等依赖文件夹,并意外耗尽令牌额度。CursorBench 仍为闭源。对于 Terminal-Bench 2.0,Cursor 在非 Composer 模型上采用了“取官方榜单分数与我们基础设施上实测分数的较大值”的做法,这一方法学选择值得知悉。
关于透明度:Cursor 未在发布博客中披露 Kimi K2.5 为基础模型。该遗漏在 2026 年 3 月 20 日因用户在 API 请求头发现模型 ID 而曝光,曾短暂引发关于许可合规的公开争论。 Fireworks AI CEO Lin Qiao 澄清称,Cursor 自第一天起便通过 Fireworks 平台实现合规。Moonshot AI 也确认该合作为授权的商业伙伴关系。Lee Robinson 与联合创始人 Aman Sanger 均承认未披露是“一次疏漏”,并承诺未来将更透明地披露基础模型。
结语
Cursor 曾直言:Composer 2 并非力求成为整体最强模型,其重点是在日常 IDE 工作中以更低成本完成任务。
前文的基准也印证了这一点:Composer 2 在 Terminal-Bench 2.0 上优于 Claude Opus 4.6,且每个令牌的成本约低 90%,但在更难的基准上仍落后于 GPT-5.4。
市场正走向多模型协作流程,而 Cursor 对 Composer 2 的定价方式表明,他们正围绕这一假设构建产品。
若您想进一步了解塑造软件开发版图的 AI 工具,请查看我们的GPT-5.4 vs. Claude Opus 4.6 对比。