几年前,您几乎很难让大型语言模型写出一封像样的邮件。OpenAI 发布首个开源模型时,能生成连贯文本已令人惊叹。短短几年后,我们已经拥有能搭建完整软件工程项目、预订会议、在亚马逊下单等的 AI 模型。到了 2026 年,格局已然改变,开发者正在思考的问题不再是“能否做到”,而是“哪款模型更适合我的场景”。
GPT-5.4 和 Claude Opus 4.6 正处在这一问题的核心位置。两者各有所长,且发布时间仅相隔数周。不过,它们定价不同,最擅长的应用场景也各异。
过去一周我深入研读了它们的发布报告与独立排行榜。本文将带您了解我的发现,帮助您为自己的工作流选出更合适的模型。
什么是 Claude Opus 4.6?
Claude Opus 4.6 是 Anthropic 迄今最强大的模型。Opus 4.6 在上一代基础上升级,重点提升了编码与长时间运行的 agentic 任务能力。Anthropic 表示它在规划、代码审查和调试方面表现更佳,甚至能发现并纠正自身错误。
Claude Opus 4.6 的关键特性与能力
Anthropic 发布了处于测试阶段的 Opus 4.6,配备 100 万 token 上下文窗口,最大输出 128K token。这使模型能够处理大型代码库与大体量文档(如技术文档)。
此次发布还引入了 自适应思考(Adaptive Thinking),也就是说 Claude 现在可以自行判断何时需要启用扩展思考,而无需等您手动开启。
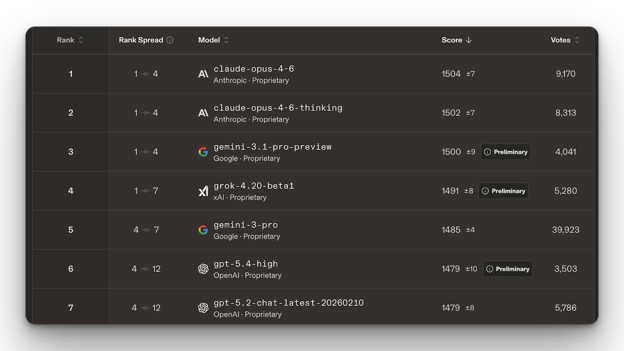
Claude Opus 4.6 能判断某件事是快速修复即可,还是需要投入更多时间推理并制定方案。我认为这对解决复杂工程问题非常有用。难怪该模型位居 文本与编码擂台排行榜榜首。
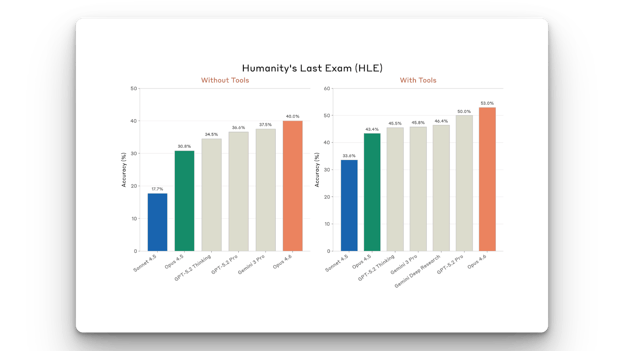
在编码基准中,Claude Opus 4.6 在 SWE-Bench Verified 上得分 81.42%,该基准用于评估模型解决真实 GitHub 问题的能力。该模型还在 Humanity’s Last Exam 中获得最佳成绩。
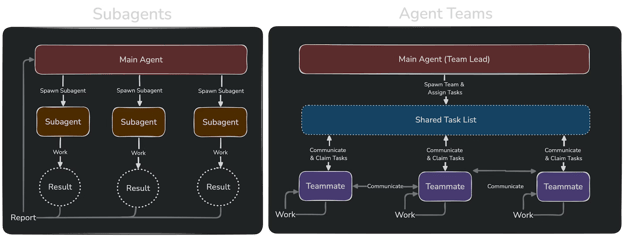
随着 Opus 4.6 的发布,Claude 还在 Claude Code 中以实验性功能形式引入了 Agent 团队(Agent Teams)。开启后,您可以同时启动多个代理协同完成任务。代理以团队形式协作,共享任务并进行代理间消息通信。
您可以通过我们的Claude Code 教程,结合 Supabase Python 库的实践示例,学习如何使用 Anthropic 的 Claude Code 改进软件开发工作流。
Claude Opus 4.6 的优缺点
Claude Opus 4.6 是非常强劲的 agentic 模型。事实上,OpenClaw 的作者建议在 OpenClaw 中使用它,因为它不易被提示注入“投毒”。这让模型对恶意代码更具鲁棒性。
尽管仍处于实验阶段,Agent 团队功能相较子代理是一次重大升级。借助该功能,您可以将任务拆分给多个 Claude 代理:例如,一个负责后端,另一个负责前端,还有一个负责测试。每个代理拥有各自的上下文窗口,从而降低因上下文窗口限制导致任务失败的风险。
Cladue Opus 4.6 很强大,但俗话说“天下没有免费的午餐”。如果您是重度用户,运行成本并不低。
同时,Anthropic 已发布其后续模型。也别忘了查看我们的 Claude Opus 4.7 指南!
什么是 GPT-5.4?
GPT-5.4 是 OpenAI 最新且最强的模型。它将GPT-5.3-Codex 的编码能力与推理结合为一个强大的统一模型。这意味着您不再需要在编码用的 Codex 模型与处理其他任务的 OpenAI 模型之间来回切换。
GPT-5.4 的关键特性与能力
我认为 GPT-5.4 最有意思的特性是计算机使用能力。在 OSWorld 基准(衡量模型使用台式电脑的能力)上,GPT-5.4 得分 75.0%,而人类表现为 72.4%。作一对比,GPT-5.2 在同一测试中的得分为 47.3%。
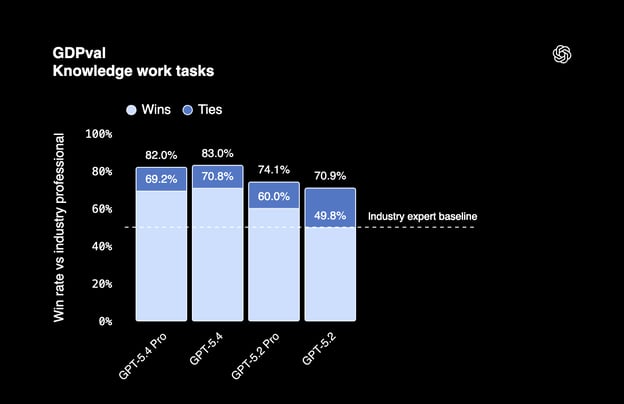
在 GDPval 基准(覆盖 44 个职业的专业知识型工作测试)上,GPT-5.4 得分 83%。这意味着该模型能够以专业水准完成美国热门岗位中的 agentic 任务。
GPT-5.4 还具备令牌效率更高的特性,即在许多任务上使用的 token 少于以往模型。如果您每天要发起多次请求,这一点值得关注。
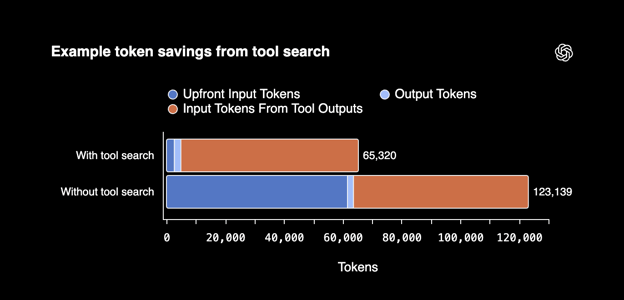
GPT-5.4 还引入了 工具搜索(Tool Search)系统,当提供多个工具时,可让模型更高效地工作。不必将工具定义直接塞进提示词(这会增加 token),而是给模型一份工具清单与搜索能力。当模型需要某个工具时,会自行查找并将其附加到对应会话中,从而提升令牌效率。
GPT-5.4 的优缺点
我最为赞叹的,是 GPT-5.4 在自主使用计算机方面超越人类。它在该领域胜过 Claude Opus 4.6,OSWorld 基准得分 75%,而 Opus 4.6 为72.7%。
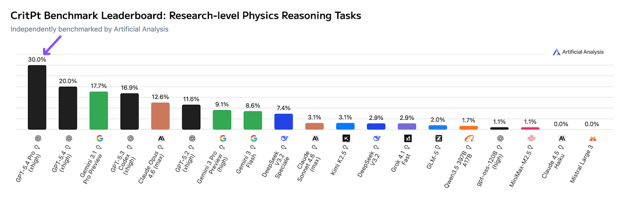
Artificial Analysis 的独立研究显示,GPT 5.4(xhigh)在 CritPt 基准上取得了 30% 的成绩。CritPt 用于评测 LLM 在研究级物理推理任务上的表现,包含 71 个复合研究挑战。
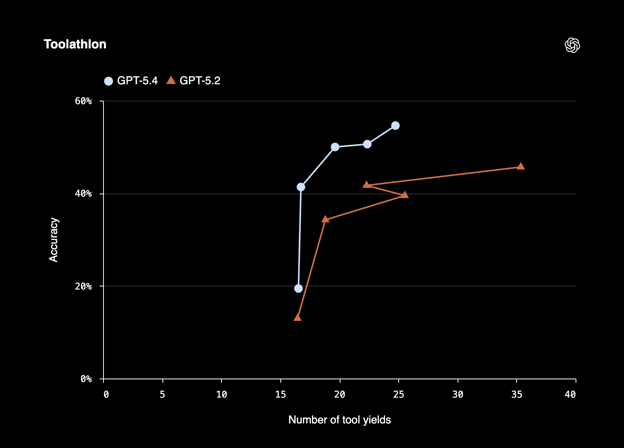
GPT-5.4 在工具调用方面更好、更准确。OpenAI 在发布报告中指出,在 Toolathlon 基准(测试代理如何使用真实世界的工具与 API 完成多步任务)上,GPT-5.4 能以更少步骤取得更佳结果。
与 Claude Opus 4.6 一样,GPT-5.4 的价格也不算便宜。所幸 OpenAI 在批处理推理 API 上提供了更低价的选项。
GPT-5.4 与 Claude Opus 4.6:正面对比
既然已经了解了 GPT-5.4 与 Opus 4.6 的优缺点,接下来我们来比较它们,看看哪个更适合您的应用场景。
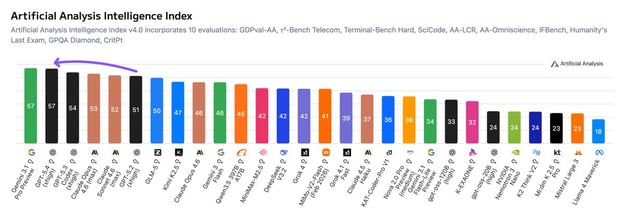
综合来看,根据 Artificial Analysis Intelligence Index(衡量模型在多种基准下的表现),GPT-5.4 是总体最佳模型。唯一超过它的是 Gemini 3.1 Pro。
Agentic 与计算机使用表现
在多代理编排方面,Claude Opus 4.6 更胜一筹。借助 Agent 团队功能,您可以运行由并行代理分工处理不同任务的多条工作流。
在计算机使用上,GPT-5.4 小幅领先。如果您的代理需要操作桌面、浏览器导航或与 GUI 软件交互,当前 GPT-5.4 是更好的选择。
编码基准
Claude Opus 4.6 在编程方面表现更强:SWE-Bench Verified 得分 80.84%,使用修改提示后得分 81.4%。
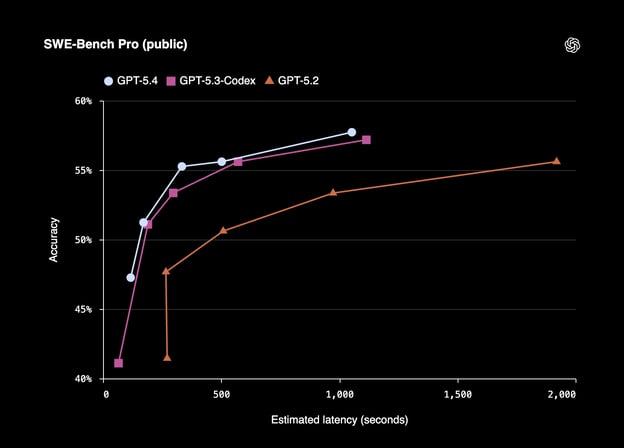
GPT-5.4 继承了 GPT-5.3-Codex 的编码能力。根据 OpenAI 的数据,GPT-5.4 在 SWE-Bench Pro(Public)上得分 57.7%,并在推理任务上具备更低延迟。
成本与令牌效率
OpenAI 在报告中声称,GPT-5.4 在某些任务上可将 token 使用量降低 47%。虽然单价高于 Opus 4.6,但由于 token 使用下降,GPT-5.4 在大规模场景下的总体成本可能更低。
不过,对于数量不多但复杂度高的 agentic 任务,Opus 4.6 可能仍是更佳选择。
作为参考,最强大的 GPT-5.4 模型(上下文长度>272K)输入 100 万 token 费用为 60 美元、输出 100 万 token 费用为 270 美元;而 Claude Opus 4.6 输入 100 万 token 费用为 5 美元、输出 100 万 token 费用为 25 美元。
上下文窗口与记忆
GPT-5.4 与 Claude Opus 4.6 都支持最高 100 万 token 的上下文(Claude 处于测试阶段)。这让两者在处理大型代码库时都具备强劲竞争力。
对比表
|
类别
|
Claude Opus 4.6
|
GPT-5.4
|
|
Agentic 任务
|
强(Agent 团队,并行编排)
|
强(计算机使用,OSWorld 75%)
|
|
编码基准
|
SWE-Bench 80.2%(启用 Thinking)
|
SWE-Bench Pro(Public)57.7%
|
|
计算机使用
|
OSWorld 72.7%
|
OSWorld 75%(超越人类专家)
|
|
上下文窗口
|
100 万 token(测试版),最大输出 128K
|
100 万 token
|
|
知识型工作
|
Humanity's Last Exam 领先者
|
GDPval 83%
|
|
定价(输入/输出)
|
$5 基础输入 token
每百万输出 token $25
|
gpt-5.4(<272K 上下文长度)输入 100 万 token $2.50,输出 100 万 token $15.00。更大上下文窗口的模型价格更高。
|
|
令牌效率
|
标准
|
部分任务 token 降低 47%
|
|
最佳适用
|
长时间运行的代理、复杂代码库
|
计算机使用、文档流程、企业场景
|
GPT-5.4 与 Claude Opus 4.6:该如何选择?
最后,我们来回答最关键的问题:两者之中,您该选哪一个?
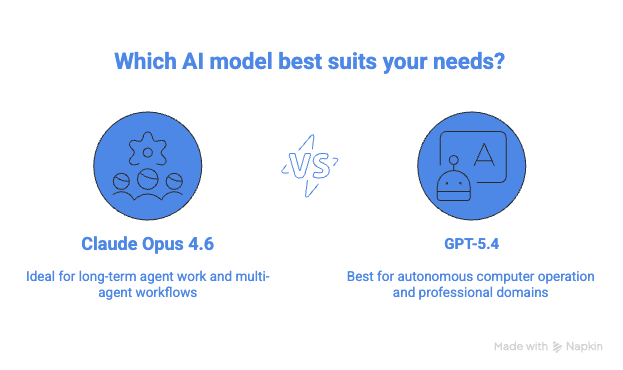
以下情况建议选择 Claude Opus 4.6…
- 您在构建或运行需要长时间在大型代码库内工作的代理。
- 您希望采用多代理工作流,让不同代理并行工作并相互移交任务。
- 您的流程涉及极长的文档、冗长的代码文件,或需要持有大量上下文的任务。
- 您已经在使用 Anthropic 生态,且团队对 Claude 较为熟悉。
以下情况建议选择 GPT-5.4…
- 您的 AI 代理需要操作计算机:自主点击、输入、导航应用和填写表单。
- 您跨金融、法律或运营等专业领域工作,需要模型以行业专业人士的水准完成任务。
- 您希望在规模化下压缩 API 成本。部分任务上 47% 的 token 效率提升,在日均成千上万次调用下会带来显著节省。
- 您希望“一模走天下”,无需在多款专用模型之间切换。
未来展望
长期以来,Anthropic 的模型在编码方面备受青睐,但它们在创意写作等意想不到的领域也表现出色。事实上,许多人认为它们在这一领域堪称业内最佳。
不过,Anthropic 从未公开宣称其模型专精某项任务;而 OpenAI 过去则明确表示 Codex 模型专为编程而生。
我觉得非常有意思的是,OpenAI 现在正朝 Anthropic 的方向迈进。在最新发布中,他们正推动一个能处理大量专业任务的统一模型。这对用户而言是巨大利好:没人愿意为了把工作做完而在专用模型之间频繁切换。
另一方面,看到 Anthropic 采用 100 万上下文窗口也令人欣慰(其他模型如 Gemini 3 早已具备)。我认为未来这些模型的特性会高度趋同,真正决定用户取舍的“硬性差异”会越来越少。话虽如此,模型在不同任务上的实际表现将成为主要区分点,用户会更偏好在自身工作流中表现更优的模型。
结论
到了 2026 年,Anthropic 与 OpenAI 都已拥有适合 agentic 工作的强大模型。或许让您困惑的是,它们各自报告的基准不同,多少都有“择优展示”的成分。
接下来就取决于您参考其他独立分析,并在自身用例中进行测试。可以肯定的是,模型在不断进步。而您,也应当不断精进自己的使用能力。
要确保不被这股 agentic 浪潮甩在身后,一个办法是掌握如何高效将这些模型用于软件工程。我建议从免费报名我们的Cursor 软件开发课程开始。您也可以学习Claude 模型入门课程与OpenAI 基础技能路径。


几年前,您几乎很难让大型语言模型写出一封像样的邮件。OpenAI 发布首个开源模型时,能生成连贯文本已令人惊叹。短短几年后,我们已经拥有能搭建完整软件工程项目、预订会议、在亚马逊下单等的 AI 模型。到了 2026 年,格局已然改变,开发者正在思考的问题不再是“能否做到”,而是“哪款模型更适合我的场景”。
GPT-5.4 和 Claude Opus 4.6 正处在这一问题的核心位置。两者各有所长,且发布时间仅相隔数周。不过,它们定价不同,最擅长的应用场景也各异。
过去一周我深入研读了它们的发布报告与独立排行榜。本文将带您了解我的发现,帮助您为自己的工作流选出更合适的模型。
什么是 Claude Opus 4.6?
Claude Opus 4.6 是 Anthropic 迄今最强大的模型。Opus 4.6 在上一代基础上升级,重点提升了编码与长时间运行的 agentic 任务能力。Anthropic 表示它在规划、代码审查和调试方面表现更佳,甚至能发现并纠正自身错误。
Claude Opus 4.6 的关键特性与能力
Anthropic 发布了处于测试阶段的 Opus 4.6,配备 100 万 token 上下文窗口,最大输出 128K token。这使模型能够处理大型代码库与大体量文档(如技术文档)。
此次发布还引入了 自适应思考(Adaptive Thinking),也就是说 Claude 现在可以自行判断何时需要启用扩展思考,而无需等您手动开启。
Claude Opus 4.6 能判断某件事是快速修复即可,还是需要投入更多时间推理并制定方案。我认为这对解决复杂工程问题非常有用。难怪该模型位居 文本与编码擂台排行榜榜首。
在编码基准中,Claude Opus 4.6 在 SWE-Bench Verified 上得分 81.42%,该基准用于评估模型解决真实 GitHub 问题的能力。该模型还在 Humanity’s Last Exam 中获得最佳成绩。
随着 Opus 4.6 的发布,Claude 还在 Claude Code 中以实验性功能形式引入了 Agent 团队(Agent Teams)。开启后,您可以同时启动多个代理协同完成任务。代理以团队形式协作,共享任务并进行代理间消息通信。
您可以通过我们的Claude Code 教程,结合 Supabase Python 库的实践示例,学习如何使用 Anthropic 的 Claude Code 改进软件开发工作流。
Claude Opus 4.6 的优缺点
Claude Opus 4.6 是非常强劲的 agentic 模型。事实上,OpenClaw 的作者建议在 OpenClaw 中使用它,因为它不易被提示注入“投毒”。这让模型对恶意代码更具鲁棒性。
尽管仍处于实验阶段,Agent 团队功能相较子代理是一次重大升级。借助该功能,您可以将任务拆分给多个 Claude 代理:例如,一个负责后端,另一个负责前端,还有一个负责测试。每个代理拥有各自的上下文窗口,从而降低因上下文窗口限制导致任务失败的风险。
Cladue Opus 4.6 很强大,但俗话说“天下没有免费的午餐”。如果您是重度用户,运行成本并不低。
同时,Anthropic 已发布其后续模型。也别忘了查看我们的 Claude Opus 4.7 指南!
什么是 GPT-5.4?
GPT-5.4 是 OpenAI 最新且最强的模型。它将GPT-5.3-Codex 的编码能力与推理结合为一个强大的统一模型。这意味着您不再需要在编码用的 Codex 模型与处理其他任务的 OpenAI 模型之间来回切换。
GPT-5.4 的关键特性与能力
我认为 GPT-5.4 最有意思的特性是计算机使用能力。在 OSWorld 基准(衡量模型使用台式电脑的能力)上,GPT-5.4 得分 75.0%,而人类表现为 72.4%。作一对比,GPT-5.2 在同一测试中的得分为 47.3%。
在 GDPval 基准(覆盖 44 个职业的专业知识型工作测试)上,GPT-5.4 得分 83%。这意味着该模型能够以专业水准完成美国热门岗位中的 agentic 任务。
GPT-5.4 还具备令牌效率更高的特性,即在许多任务上使用的 token 少于以往模型。如果您每天要发起多次请求,这一点值得关注。
GPT-5.4 还引入了 工具搜索(Tool Search)系统,当提供多个工具时,可让模型更高效地工作。不必将工具定义直接塞进提示词(这会增加 token),而是给模型一份工具清单与搜索能力。当模型需要某个工具时,会自行查找并将其附加到对应会话中,从而提升令牌效率。
GPT-5.4 的优缺点
我最为赞叹的,是 GPT-5.4 在自主使用计算机方面超越人类。它在该领域胜过 Claude Opus 4.6,OSWorld 基准得分 75%,而 Opus 4.6 为72.7%。
Artificial Analysis 的独立研究显示,GPT 5.4(xhigh)在 CritPt 基准上取得了 30% 的成绩。CritPt 用于评测 LLM 在研究级物理推理任务上的表现,包含 71 个复合研究挑战。
GPT-5.4 在工具调用方面更好、更准确。OpenAI 在发布报告中指出,在 Toolathlon 基准(测试代理如何使用真实世界的工具与 API 完成多步任务)上,GPT-5.4 能以更少步骤取得更佳结果。
与 Claude Opus 4.6 一样,GPT-5.4 的价格也不算便宜。所幸 OpenAI 在批处理推理 API 上提供了更低价的选项。
GPT-5.4 与 Claude Opus 4.6:正面对比
既然已经了解了 GPT-5.4 与 Opus 4.6 的优缺点,接下来我们来比较它们,看看哪个更适合您的应用场景。
综合来看,根据 Artificial Analysis Intelligence Index(衡量模型在多种基准下的表现),GPT-5.4 是总体最佳模型。唯一超过它的是 Gemini 3.1 Pro。
Agentic 与计算机使用表现
在多代理编排方面,Claude Opus 4.6 更胜一筹。借助 Agent 团队功能,您可以运行由并行代理分工处理不同任务的多条工作流。
在计算机使用上,GPT-5.4 小幅领先。如果您的代理需要操作桌面、浏览器导航或与 GUI 软件交互,当前 GPT-5.4 是更好的选择。
编码基准
Claude Opus 4.6 在编程方面表现更强:SWE-Bench Verified 得分 80.84%,使用修改提示后得分 81.4%。
GPT-5.4 继承了 GPT-5.3-Codex 的编码能力。根据 OpenAI 的数据,GPT-5.4 在 SWE-Bench Pro(Public)上得分 57.7%,并在推理任务上具备更低延迟。
成本与令牌效率
OpenAI 在报告中声称,GPT-5.4 在某些任务上可将 token 使用量降低 47%。虽然单价高于 Opus 4.6,但由于 token 使用下降,GPT-5.4 在大规模场景下的总体成本可能更低。
不过,对于数量不多但复杂度高的 agentic 任务,Opus 4.6 可能仍是更佳选择。
作为参考,最强大的 GPT-5.4 模型(上下文长度>272K)输入 100 万 token 费用为 60 美元、输出 100 万 token 费用为 270 美元;而 Claude Opus 4.6 输入 100 万 token 费用为 5 美元、输出 100 万 token 费用为 25 美元。
上下文窗口与记忆
GPT-5.4 与 Claude Opus 4.6 都支持最高 100 万 token 的上下文(Claude 处于测试阶段)。这让两者在处理大型代码库时都具备强劲竞争力。
对比表
类别
Claude Opus 4.6
GPT-5.4
Agentic 任务
强(Agent 团队,并行编排)
强(计算机使用,OSWorld 75%)
编码基准
SWE-Bench 80.2%(启用 Thinking)
SWE-Bench Pro(Public)57.7%
计算机使用
OSWorld 72.7%
OSWorld 75%(超越人类专家)
上下文窗口
100 万 token(测试版),最大输出 128K
100 万 token
知识型工作
Humanity's Last Exam 领先者
GDPval 83%
定价(输入/输出)
$5 基础输入 token
每百万输出 token $25
gpt-5.4(<272K 上下文长度)输入 100 万 token $2.50,输出 100 万 token $15.00。更大上下文窗口的模型价格更高。
令牌效率
标准
部分任务 token 降低 47%
最佳适用
长时间运行的代理、复杂代码库
计算机使用、文档流程、企业场景
GPT-5.4 与 Claude Opus 4.6:该如何选择?
最后,我们来回答最关键的问题:两者之中,您该选哪一个?
以下情况建议选择 Claude Opus 4.6…
以下情况建议选择 GPT-5.4…
未来展望
长期以来,Anthropic 的模型在编码方面备受青睐,但它们在创意写作等意想不到的领域也表现出色。事实上,许多人认为它们在这一领域堪称业内最佳。
不过,Anthropic 从未公开宣称其模型专精某项任务;而 OpenAI 过去则明确表示 Codex 模型专为编程而生。
我觉得非常有意思的是,OpenAI 现在正朝 Anthropic 的方向迈进。在最新发布中,他们正推动一个能处理大量专业任务的统一模型。这对用户而言是巨大利好:没人愿意为了把工作做完而在专用模型之间频繁切换。
另一方面,看到 Anthropic 采用 100 万上下文窗口也令人欣慰(其他模型如 Gemini 3 早已具备)。我认为未来这些模型的特性会高度趋同,真正决定用户取舍的“硬性差异”会越来越少。话虽如此,模型在不同任务上的实际表现将成为主要区分点,用户会更偏好在自身工作流中表现更优的模型。
结论
到了 2026 年,Anthropic 与 OpenAI 都已拥有适合 agentic 工作的强大模型。或许让您困惑的是,它们各自报告的基准不同,多少都有“择优展示”的成分。
接下来就取决于您参考其他独立分析,并在自身用例中进行测试。可以肯定的是,模型在不断进步。而您,也应当不断精进自己的使用能力。
要确保不被这股 agentic 浪潮甩在身后,一个办法是掌握如何高效将这些模型用于软件工程。我建议从免费报名我们的Cursor 软件开发课程开始。您也可以学习Claude 模型入门课程与OpenAI 基础技能路径。