Cursor hat am 19. März 2026 Composer 2 veröffentlicht – die dritte Generation des hauseigenen Coding-Modells. Der Release kam nur sechs Wochen nach Composer 1.5, das Reinforcement Learning (RL) auf demselben Basismodell 20-fach hochskaliert hat, ohne die Architektur zu ändern. Dieser RL-Run übertraf sogar das ursprüngliche Pretraining-Compute-Budget – ein Zeichen, dass die Basis bis an ihr Limit gebracht wurde. Composer 2 wählt einen anderen Weg: erst fortgesetztes Pretraining für ein stärkeres Fundament, dann RL obendrauf. Deshalb fällt der Benchmark-Sprung trotz kurzer Pause so groß aus.
Außerdem kommt es mit einem Kontextfenster von 200.000 Tokens und zwei Preisvarianten: Standard für $0,50 pro Million Input-Tokens (etwa 86% günstiger als Composer 1.5) und Fast für interaktive Echtzeitsessions.
In diesem Artikel schauen wir uns an, was Composer 2 ist, wie es sich bei Benchmarks und Kosten gegenüber Composer 1.5 schlägt und wie es im Vergleich zu Claude Opus 4.6 und GPT-5.4 einordnet. Wir zeigen außerdem, wie du es in Cursor nutzt und welche bekannten Einschränkungen es gibt.
Wenn dich die Spitzenmodelle interessieren, gegen die Composer 2 antritt, sieh dir auch unsere Guides an:
Was ist Composer?
Composer ist Cursors Familie proprietärer KI-Coding-Modelle, entwickelt für agentisches Programmieren in der Cursor-IDE. Anders als Generalisten wie Claude Opus 4.6 oder GPT-5.4 sind Composer-Modelle speziell für Multi-File-Editing, das Ausführen von Terminalbefehlen und Codebase-weite Refactorings gebaut. Sie sind nicht für E-Mails, Trivia oder andere Non-Code-Aufgaben gedacht.
Die Linie begann mit einem internen Prototyp namens Cheetah, und entwickelte sich dann über drei öffentliche Releases weiter:
|
Modell
|
Release-Datum
|
Schlüsselinnovation
|
|
Composer 1
|
29. Oktober 2025
|
Erstes Inhouse-Modell; MoE-Architektur mit RL-Training
|
|
Composer 1.5
|
9. Februar 2026
|
20x mehr RL-Compute auf derselben Basis; adaptives Denken; Self-Summarization eingeführt
|
|
Composer 2
|
19. März 2026
|
Erster Run mit fortgesetztem Pretraining für eine neue Basis; verbesserte Self-Summarization; deutlich geringere Kosten
|
Jede Generation baute auf der vorherigen auf, doch Composer 2 markiert den bislang größten architektonischen Sprung.
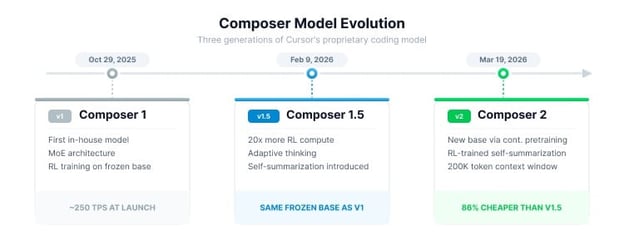
Die Entwicklung der Composer-Modelle im Überblick. Bild: Autor.
Was ist Composer 2?
Composer 2 ist Cursors agentisches Coding-Modell der dritten Generation – und das erste der Reihe mit fortgesetztem Pretraining.
Architektur und Trainingsansatz
Frühere Composer-Modelle wurden gebaut, indem Reinforcement Learning auf ein eingefrorenes Basismodell aufgesetzt wurde. Stell es dir vor wie neue Skills beibringen, ohne das Grundverständnis zu verbessern. Composer 2 ändert das: Zuerst werden die Gewichte der Basis mit code-spezifischen Daten weiter vortrainiert, dann kommt RL obendrauf.
Das Modell nutzt eine Mixture-of-Experts-Architektur (MoE), bei der nur ein Teil der Parameter pro Eingabe aktiv ist. So bleibt die Inferenz schnell, bei gleichzeitig hoher Gesamtparameterzahl. Cursor hat die genaue Parameteranzahl nicht veröffentlicht.
Die Identität des Basismodells wurde zum Start nicht offengelegt, wurde aber am 20. März 2026 öffentlich, nachdem ein Nutzer sie in API-Headern entdeckt hatte. Lee Robinson, VP of Developer Education bei Cursor, bestätigte, dass Composer 2 auf Kimi K2.5 von Moonshot AI basiert, einem Open-Source-Modell. Er sagte, rund drei Viertel des gesamten Computes stammten aus Cursors eigenem Training (fortgesetztes Pretraining und RL), nicht aus dem Basismodell – was erkläre, warum die Evals anders aussehen als ein Raw-Run von Kimi K2.5.
Moonshot AI bestätigte später die Zusammenarbeit als autorisierte kommerzielle Partnerschaft über Fireworks AI, das sowohl die RL-Trainingsinfrastruktur als auch die Inferenz betrieb. Mitgründer Aman Sanger erklärte, das Team habe mehrere Basismodelle mit Perplexity-basierten Benchmarks evaluiert, bevor Kimi K2.5 gewählt wurde, und beschrieb das Training nach der Basis als fortgesetztes Pretraining gefolgt von einem 4x-Scale-up beim RL-Compute.
Die Trainingsinfrastruktur läuft auf PyTorch und Ray, mit benutzerdefinierten MXFP8-Quantisierungskernen für NVIDIA-Blackwell-GPUs.
Self-Summarization
Self-Summarization – von Cursor „Compaction-in-the-loop RL“ genannt – funktioniert so: Wenn das 200.000-Token-Kontextfenster vollzulaufen beginnt, pausiert das Modell, komprimiert seinen eigenen Kontext auf circa 1.000 Tokens und arbeitet weiter. Weil dieses Kompressionsverhalten Teil der RL-Belohnungsfunktion ist, lernt das Modell, welche Variablen, Architekturentscheidungen und Error-Logs es behalten und was es verwerfen soll.
Cursors Research-Blog berichtet, dass diese Methode Kompaktionsfehler gegenüber Prompt-basierter Zusammenfassung um 50% reduziert – bei rund einem Fünftel der Tokens. In einer Demo löste Composer 2 das „make-doom-for-mips“-Problem aus Terminal-Bench 2.0 in 170 Zügen und komprimierte dabei über 100.000 Tokens Kontext.
Kernfähigkeiten
Während einer Session hat Composer 2 Zugriff auf:
- Semantische Codebase-Suche, um relevanten Code im gesamten Projekt zu finden
- Lesen, Bearbeiten und Erstellen über mehrere Dateien hinweg mit Zeilenpräzision
- Ausführen von Terminalbefehlen inklusive Auswerten der Ausgaben
- MCP (Model Context Protocol)-Integrationen für externe Services
- Ein natives Browser-Tool, um UI-Änderungen direkt im Editor zu testen
In Summe kann der Agent so in einer Session über viele Dateien und Schritte hinweg arbeiten.
Composer-2-Varianten
Cursor liefert Composer 2 in zwei Varianten aus, beide mit derselben zugrundeliegenden Intelligenz.
Composer 2 Fast
Die Variante Fast ist die Standardeinstellung, wenn du Composer 2 im Modelldropdown auswählst. Sie ist für latenzarme, interaktive Sessions gedacht, in denen du in Echtzeit programmierst und nahezu sofortige Antworten willst.
Composer 2 Standard
Die Variante Standard läuft langsamer, kostet aber deutlich weniger pro Token. Ideal für Hintergrundtasks, Batch-Refactorings oder langlaufende agentische Loops, bei denen du nicht auf unmittelbares Feedback angewiesen bist.
Hier ist die Preisaufschlüsselung:
|
Variante
|
Input (pro 1 Mio. Tokens)
|
Cache Read (pro 1 Mio. Tokens)
|
Output (pro 1 Mio. Tokens)
|
|
Composer 2 Standard
|
$0,50
|
$0,20
|
$2,50
|
|
Composer 2 Fast (Standard)
|
$1,50
|
$0,35
|
$7,50
|
Du kannst die Fast-Variante beim aktiven Coden nutzen und für Overnight- oder Bulk-Operationen auf Standard umschalten, um den Kreditverbrauch niedrig zu halten. Auf die Preisunterschiede gehen wir später noch genauer ein.
Composer-2-Benchmarks
Cursor bewertet Composer 2 über drei Benchmarks, die unterschiedliche Aspekte der Coding-Performance abdecken.
Die Benchmarks im Überblick
CursorBench ist Cursors proprietärer interner Benchmark, aktuell in Version CursorBench-3. Die Aufgaben stammen aus echten Cursor-Sessions und werden mit einem Tool namens Cursor Blame gewonnen, das Commits auf die Agent-Anfrage zurückführt, die sie erzeugt hat. Der Benchmark misst Lösungskorrektheit, Codequalität, Effizienz und Interaktionsverhalten. Der Problemumfang hat sich von der ersten Version bis CursorBench-3 in Zeilenanzahl und Dateizahl etwa verdoppelt. Zusätzlich ergänzt Cursor CursorBench um kontrollierte Live-Traffic-Experimente, um Regressionen zu erkennen, die reines Offline-Grading übersehen könnte. Der klare Haken: CursorBench ist nicht öffentlich reproduzierbar, daher sind die Scores nicht unabhängig verifizierbar.
Terminal-Bench 2.0 wird vom Laude Institute gepflegt und testet die Fähigkeit eines KI-Agenten, reale Aufgaben in einer Terminalumgebung auszuführen – inklusive Navigieren, Skripte laufen lassen, Fehler interpretieren und iterativ zur Lösung gelangen. Cursor nutzte das offizielle Harbor-Evaluationsframework in den Standardeinstellungen und ließ pro Modell fünf Läufe, gemeldet wurde der Durchschnitt.
SWE-bench Multilingual ist ein Subset von SWE-bench mit 300 Aufgaben in 9 Programmiersprachen. Es misst die Fähigkeit, echte GitHub-Issues zu beheben – ein guter Test für sprachübergreifendes Coden.
Benchmark-Ergebnisse über die Composer-Generationen
Die Scores sind mit jeder Generation gestiegen:
|
Benchmark
|
Composer 1
|
Composer 1.5
|
Composer 2
|
|
CursorBench
|
38,0
|
44,2
|
61,3
|
|
Terminal-Bench 2.0
|
40,0
|
47,9
|
61,7
|
|
SWE-bench Multilingual
|
56,9
|
65,9
|
73,7
|
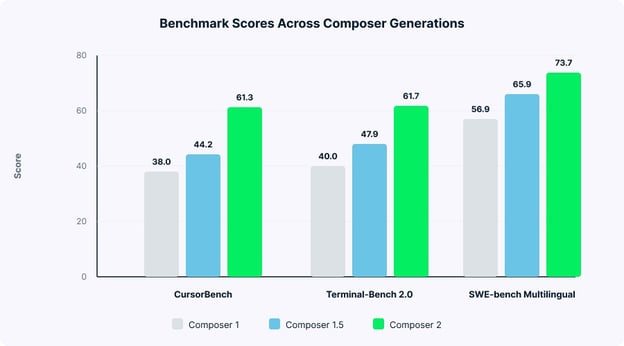
Benchmark-Scores über drei Composer-Generationen. Bild: Autor.
Hinweis zu Benchmark-Grenzen
- CursorBench ist Closed Source und nicht unabhängig reproduzierbar. Cursor veröffentlicht keine Scores auf etablierten Benchmarks wie SWE-bench Verified, was einige in der Community kritisch sehen.
- SWE-bench Verified wird von OpenAI nicht mehr berichtet, nachdem sich zeigte, dass Frontier-Modelle Test-Patches aus dem Gedächtnis reproduzieren konnten und fast 60% der ungelösten Aufgaben fehlerhafte Tests hatten.
- Terminal-Bench enthält Puzzle-Aufgaben (z. B. den besten Schachzug finden), die nicht der Praxis entsprechen. Es ist dennoch der transparenteste der drei, da ein öffentliches Framework mit dokumentierter Methodik genutzt wird.
Wie viel besser ist Composer 2 als Composer 1.5?
Der Sprung von Composer 1.5 auf Composer 2 ist größer als in allen vorherigen Generationen – sowohl bei Performance als auch bei Kosten.
Wie oben gezeigt, erzielt Composer 2 auf dem CursorBench 61,3 gegenüber 44,2 bei Composer 1.5 – rund 39% mehr. Auf Terminal-Bench 2.0 liegt der Vorsprung bei rund 29% (61,7 vs. 47,9), bei SWE-bench Multilingual etwa 12% (73,7 vs. 65,9).
Der Kostensprung ist noch größer als die Benchmark-Gewinne. Laut Launch-Blog ist Composer 2 Standard bei Input-Tokens rund 86% günstiger als Composer 1.5, und selbst die Fast-Variante ist etwa 57% günstiger. Eine separate Preisseite für Composer 1.5 gibt es nicht; die Prozentsätze stammen aus Cursors eigener Gegenüberstellung zum Launch.
Die wichtigsten technischen Unterschiede:
- Trainingsansatz: Composer 1.5 skalierte RL 20x weiter auf derselben eingefrorenen Basis; der nachgelagerte RL-Compute übertraf sogar den Compute des ursprünglichen Pretrainings. Composer 2 ging anders vor: neue, stärkere Basis via fortgesetztem Pretraining, danach 4x mehr RL-Compute obendrauf.
- Qualität der Self-Summarization: Composer 1.5 führte Self-Summarization ein, nutzte aber Prompt-basierte Kompression mit tausenden Token an Instruktionen und erzeugte im Schnitt ca. 5.000 Token lange Summaries. Composer 2 kompaktisiert RL-trainiert auf ca. 1.000 Tokens mit 50% weniger Fehlern und nutzt zudem den KV-Cache vorheriger Tokens weiter – das senkt die Inferenzkosten zusätzlich.
- Long-Horizon-Fähigkeit: Composer 2 bewältigt Aufgaben mit hunderten sequentiellen Schritten. Das geht, wie erwähnt, über das hinaus, was 1.5 zuverlässig schaffte.
Die Community nahm Composer 1.5 gemischt auf. Einige Entwickler fanden es nur für kleinere Tasks wie Commits und einfache Edits hilfreich. Die Benchmarks zeigen nun Verbesserungen genau bei den Kritikpunkten.
Composer 2 vs. Claude Opus 4.6 vs. GPT-5.4
Das ist der Vergleich, nach dem die meisten suchen. Composer 2 schlägt Claude Opus 4.6 auf einigen Coding-Benchmarks, liegt bei den meisten hinter GPT-5.4 – und kostet in beiden Fällen deutlich weniger.
Benchmark-Vergleich
Die Zahlen erzählen den Großteil der Geschichte:
|
Benchmark
|
Composer 2
|
Claude Opus 4.6
|
GPT-5.4
|
|
CursorBench
|
61,3
|
~58,2
|
~63,9
|
|
Terminal-Bench 2.0
|
61,7
|
58,0
|
75,1
|
|
SWE-bench Verified
|
Nicht berichtet
|
~80,8%
|
~80,0%
|
Composer 2 vs. Claude Opus 4.6 vs. GPT-5.4
Composer 2 liegt bei CursorBench und Terminal-Bench 2.0 knapp vor Opus 4.6, während GPT-5.4 beide mit deutlichem Abstand anführt. Beim Terminal-Bench 2.0 beträgt der Abstand zwischen Composer 2 (61,7) und GPT-5.4 (75,1) 13 Punkte.
Wichtig: Die Terminal-Bench-2.0-Scores messen Agent-plus-Modell-Paare, nicht die Rohmodelle. Cursor nutzte das Harbor-Framework; der Wert 75,1 für GPT-5.4 stammt aus dem Simple-Codex-Harness auf dem offiziellen Leaderboard. Unterschiedliche Harnesses können beim selben Modell unterschiedliche Ergebnisse liefern.
Preisvergleich
So vergleichen sich die Preise:
|
Modell
|
Input (pro 1 Mio. Tokens)
|
Output (pro 1 Mio. Tokens)
|
|
Composer 2 Standard
|
$0,50
|
$2,50
|
|
Composer 2 Fast
|
$1,50
|
$7,50
|
|
Claude Opus 4.6
|
$5,00
|
$25,00
|
|
GPT-5.4
|
$2,50
|
$15,00
|
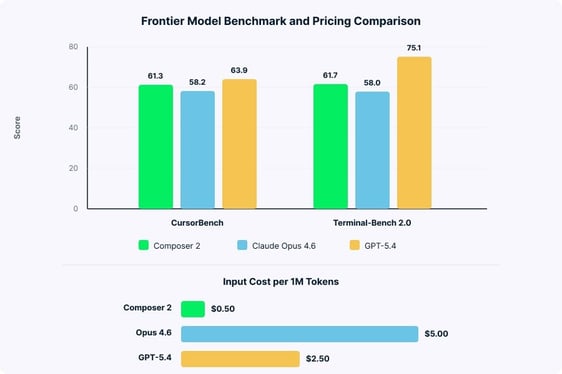
Benchmark-Scores und Tokenpreise im Vergleich. Bild: Autor.
Composer 2 Standard ist pro Token etwa 90% günstiger als Opus 4.6 und rund 80% günstiger als GPT-5.4. Für Teams mit tausenden agentischen Requests pro Tag summiert sich das schnell.
Worin die Modelle jeweils stark sind
Composer 2 ist ein reines Code-Modell, das an die Cursor-IDE gebunden ist. Es erledigt Routineaufgaben schnell und günstig, kann aber außerhalb von Code nichts.
Claude Opus 4.6 bietet 200.000 Tokens Kontext (mit 1 Mio. im Beta-Modus zu höheren Kosten), glänzt bei Architekturplanung über viele Dateien und unterstützt Multi-Agent-Orchestrierung via Agent Teams. Es ist ein Generalist, der sehr gut coden kann.
GPT-5.4 führt die schwierigsten Coding-Benchmarks an, beherrscht Native Computer Use und unterstützt ein experimentelles Kontextfenster mit 1,05 Mio. Tokens. Es ist als Einzelmodell am fähigsten, aber im großen Maßstab am teuersten.
Cursors Positionierung zielt auf Wert pro Aufgabe in der IDE, nicht auf bloße Benchmark-Spitzenwerte.
Composer 2 vs. Claude Code vs. GitHub Copilot
Oben haben wir Composer 2 mit Rohmodellen verglichen. So sieht es auf Produktebene aus.
Claude Code ist Anthropics Terminal-basierter Coding-Agent. Laut einer Entwicklerumfrage 2026 ist es inzwischen das meistgenutzte KI-Coding-Tool unter Profis; 46% nennen es ihr Lieblingswerkzeug, gegenüber 19% für Cursor. Viele nutzen Cursor fürs tägliche IDE-Editing und wechseln für komplexe, autonome Aufgaben zu Claude Code. Die Tools ergänzen sich eher, als dass sie konkurrieren.
GitHub Copilot bleibt mit über 20 Millionen Nutzerinnen und Nutzern insgesamt am weitesten verbreitet und bietet mit $10/Monat einen günstigeren Einstieg. Kürzlich kam Agent Mode für Mehrschritt-Aktionen hinzu, doch viele berichten, dass Cursors Multi-File-Editing tiefer greift.
Rund 70% der Entwickler setzen inzwischen zwei bis vier KI-Tools parallel ein. Die Frage lautet weniger „welches Tool?“ als „welche Kombination?“
So nutzt du Composer 2
Composer 2 lebt vollständig in der Cursor-IDE – es gibt nichts separat zu installieren.
Schritt-für-Schritt-Setup
Um loszulegen, lade Cursor von cursor.com herunter oder aktualisiere es. Composer 2 ist in allen kostenpflichtigen Plänen verfügbar (Pro, Pro+, Ultra, Teams, Enterprise). Öffne das Agent-Panel mit Cmd+I auf dem Mac oder Ctrl+I unter Windows und Linux, und wähle „Composer 2“ oder „Composer 2 Fast“ im Modelldropdown. Fast ist standardmäßig aktiv.
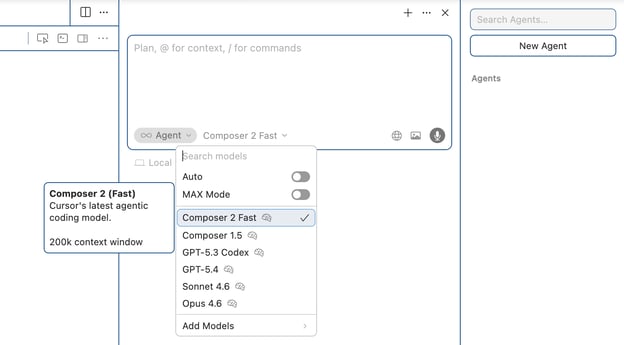
So findest du das Cursor-Modelldropdown. Bild: Autor.
Formuliere dann in natürlicher Sprache, was erledigt werden soll. Composer 2 arbeitet standardmäßig im Agent-Modus, kann also eigenständig deine Codebase erkunden, Änderungen vornehmen, Terminalbefehle ausführen und alle verfügbaren Tools nutzen. Du prüfst und akzeptierst oder verwirfst die Änderungen, während der Agent arbeitet.
Wichtige Shortcuts
Diese Shortcuts wirst du beim Arbeiten mit Composer 2 am häufigsten nutzen:
|
Aktion
|
Mac
|
Windows/Linux
|
|
Agent/Composer öffnen
|
Cmd+I
|
Ctrl+I
|
|
Neue Konversation
|
Cmd+N
|
Ctrl+N
|
|
Modus wechseln (Agent/Ask/Edit)
|
Cmd+.
|
Ctrl+.
|
|
Ask-Modus (Read-only)
|
Cmd+L
|
Ctrl+L
|
|
Inline-Edit
|
Cmd+K
|
Ctrl+K
|
|
Historie öffnen
|
Cmd+Opt+L
|
Ctrl+Alt+L
|
Mit Kontext arbeiten
Composer 2 bietet verschiedene Wege, den Kontext zu steuern. Tippe @ gefolgt von einem Dateinamen, Ordner oder einer URL, um gezielten Kontext einzubringen. Das #-Symbol fokussiert eine bestimmte Datei. Oben in der Chatansicht zeigen Kontext-Pills, worauf sich der Agent aktuell bezieht.
Für größere Projekte zieht Autocontext (in den Settings aktivierbar) automatisch relevanten Code per Embeddings. Du kannst außerdem eigene Doku in den Settings hinzufügen, um Framework-spezifischen Kontext bereitzustellen.
Self-Summarization in der Praxis
Bei langlaufenden Aufgaben springt Self-Summarization automatisch an, wenn das Kontextfenster voll wird. Du kannst die Kompression auch manuell mit /compress auslösen. Wenn der Agent eine neue Konversation vorschlägt, ist der Kontext meist zu groß für eine saubere Zusammenfassung – ein frischer Thread ist dann zuverlässiger.
Composer-2-Preise
Die Token-Preise haben wir im Varianten-Abschnitt abgedeckt. Hier geht es darum, wie die Preislogik in der Praxis funktioniert.
Cursor-Abostufen
Cursor nutzt ein gestuftes Abo-System mit Credits, die bestimmen, wie stark du Drittanbieter-Modelle nutzen kannst. Aktuell sieht es so aus:
|
Plan
|
Preis
|
Wesentliche Leistungen
|
|
Hobby
|
Kostenlos
|
Begrenzte Agent-Requests und Tab-Completions
|
|
Pro
|
$20/Monat ($16/Monat jährlich abgerechnet)
|
$20 Credit-Pool, unbegrenzte Tab-Completions, Cloud-Agents
|
|
Pro+
|
$60/Monat ($48/Monat jährlich abgerechnet)
|
3x Nutzung auf allen Modellen
|
|
Ultra
|
$200/Monat
|
20x Nutzung auf allen Modellen, Priorisierter Zugang
|
|
Teams
|
$40/Nutzer/Monat ($32 jährlich)
|
Zentrale Abrechnung, SAML/OIDC SSO, Analytics
|
|
Enterprise
|
Individuell
|
SOC 2, Legal Review, erweiterte Security-Kontrollen
|
So funktionieren Credits mit Composer 2
Hier stolpern viele: Die Composer-Nutzung in Individualplänen kommt aus einem separaten Nutzungspool, der getrennt vom Credit-Pool für Drittmodelle wie Claude oder GPT ist. Cursor beschreibt diesen Pool als „großzügige Nutzung inklusive“, ohne exakte Limits zu veröffentlichen.
Wenn du „Auto“-Mode nutzt, bei dem Cursor pro Request ein Modell wählt, ist die Nutzung von Composer-Modellen in kostenpflichtigen Plänen unbegrenzt und zieht keine Credits ab. Wählst du manuell Premium-Drittmodelle, wird vom monatlichen Credit-Pool abgebucht. Ist der Pool leer, kannst du nutzungsbasierte Überziehungen aktivieren.
Preis-Hintergrund
Cursor hat die Preislogik im letzten Jahr mehrfach geändert. Im Juni 2025 ersetzte man das fixe System „500 Fast-Requests pro Monat“ durch Credit-basiertes Billing, was die Requests im Pro-Tier effektiv von ca. 500 auf rund 225 pro Monat senkte.
Stand März 2026 werden Frontier-Modelle wie GPT-5.4 und Opus 4.6 dynamisch Token-basiert gegen deinen monatlichen Credit-Pool abgerechnet. Composer-2-Nutzung bleibt im separaten Pool. Wenn du für ein Team budgetierst, nutze Composer 2 für Routinearbeit und hebe Drittanbieter-Credits für aufwändigere Aufgaben auf.
Bekannte Einschränkungen von Composer 2
Wie im Vergleichsteil erwähnt, ist Composer 2 Code-only. Mitgründer Aman Sanger sagt es klar: „Es hilft dir nicht bei der Steuererklärung. Es kann keine Gedichte schreiben.“ Für General-Purpose-Aufgaben brauchst du weiterhin Claude oder GPT in Cursor.
Berichten zufolge überspringt Composer 2 in starren, mehrstufigen Ausführungsplänen mitunter Zwischenschritte zur Verifikation und eilt zur Implementierung. Wahrscheinlich ein Trainingseffekt, bei dem das Modell stärker auf Fertigstellung als auf Absicherung optimiert ist.
Einige Nutzer berichten, dass unter macOS Cursors Background-File-Watcher .gitignore in sehr großen Monorepos ignoriert und so Ordner wie node_modules indiziert – wodurch Tokenbudgets unerwartet aufgebraucht werden.
CursorBench bleibt Closed Source. Für Terminal-Bench 2.0 nahm Cursor bei Nicht-Composer-Modellen „den Maximalwert aus offiziellem Leaderboard und unserem Infrastrukturlauf“ – eine methodische Entscheidung, die man kennen sollte.
Zur Transparenz: Cursor nannte das Basismodell Kimi K2.5 im Launch-Blogpost nicht. Am 20. März 2026 wurde die Modell-ID in API-Headern entdeckt, was kurz eine Debatte über Lizenz-Compliance auslöste. Lin Qiao, CEO von Fireworks AI, stellte klar, dass Cursor von Tag eins an über die Fireworks-Plattform compliant war. Moonshot AI bestätigte die autorisierte Partnerschaft. Sowohl Lee Robinson als auch Mitgründer Aman Sanger räumten ein, dass die Nicht-Nennung „ein Versäumnis“ war, und sagten künftig mehr Transparenz zu.
Fazit
Cursor sagt es selbst: Composer 2 will nicht das insgesamt fähigste Modell sein. Der Fokus liegt auf geringeren Kosten für tägliche IDE-Arbeit.
Die Benchmarks stützen das: Composer 2 übertrifft Claude Opus 4.6 auf Terminal-Bench 2.0 bei rund 90% niedrigeren Kosten pro Token, liegt aber bei härteren Benchmarks noch hinter GPT-5.4.
Der Markt bewegt sich zu Multi-Modell-Workflows, und Cursors Preisgestaltung bei Composer 2 zeigt, dass sie genau darauf setzen.
Wenn du mehr über die KI-Tools erfahren willst, die Softwareentwicklung prägen, lies unseren Vergleich GPT-5.4 vs. Claude Opus 4.6.





Cursor hat am 19. März 2026 Composer 2 veröffentlicht – die dritte Generation des hauseigenen Coding-Modells. Der Release kam nur sechs Wochen nach Composer 1.5, das Reinforcement Learning (RL) auf demselben Basismodell 20-fach hochskaliert hat, ohne die Architektur zu ändern. Dieser RL-Run übertraf sogar das ursprüngliche Pretraining-Compute-Budget – ein Zeichen, dass die Basis bis an ihr Limit gebracht wurde. Composer 2 wählt einen anderen Weg: erst fortgesetztes Pretraining für ein stärkeres Fundament, dann RL obendrauf. Deshalb fällt der Benchmark-Sprung trotz kurzer Pause so groß aus.
Außerdem kommt es mit einem Kontextfenster von 200.000 Tokens und zwei Preisvarianten: Standard für $0,50 pro Million Input-Tokens (etwa 86% günstiger als Composer 1.5) und Fast für interaktive Echtzeitsessions.
In diesem Artikel schauen wir uns an, was Composer 2 ist, wie es sich bei Benchmarks und Kosten gegenüber Composer 1.5 schlägt und wie es im Vergleich zu Claude Opus 4.6 und GPT-5.4 einordnet. Wir zeigen außerdem, wie du es in Cursor nutzt und welche bekannten Einschränkungen es gibt.
Wenn dich die Spitzenmodelle interessieren, gegen die Composer 2 antritt, sieh dir auch unsere Guides an:
Was ist Composer?
Composer ist Cursors Familie proprietärer KI-Coding-Modelle, entwickelt für agentisches Programmieren in der Cursor-IDE. Anders als Generalisten wie Claude Opus 4.6 oder GPT-5.4 sind Composer-Modelle speziell für Multi-File-Editing, das Ausführen von Terminalbefehlen und Codebase-weite Refactorings gebaut. Sie sind nicht für E-Mails, Trivia oder andere Non-Code-Aufgaben gedacht.
Die Linie begann mit einem internen Prototyp namens Cheetah, und entwickelte sich dann über drei öffentliche Releases weiter:
Modell
Release-Datum
Schlüsselinnovation
Composer 1
29. Oktober 2025
Erstes Inhouse-Modell; MoE-Architektur mit RL-Training
Composer 1.5
9. Februar 2026
20x mehr RL-Compute auf derselben Basis; adaptives Denken; Self-Summarization eingeführt
Composer 2
19. März 2026
Erster Run mit fortgesetztem Pretraining für eine neue Basis; verbesserte Self-Summarization; deutlich geringere Kosten
Jede Generation baute auf der vorherigen auf, doch Composer 2 markiert den bislang größten architektonischen Sprung.
Die Entwicklung der Composer-Modelle im Überblick. Bild: Autor.
Was ist Composer 2?
Composer 2 ist Cursors agentisches Coding-Modell der dritten Generation – und das erste der Reihe mit fortgesetztem Pretraining.
Architektur und Trainingsansatz
Frühere Composer-Modelle wurden gebaut, indem Reinforcement Learning auf ein eingefrorenes Basismodell aufgesetzt wurde. Stell es dir vor wie neue Skills beibringen, ohne das Grundverständnis zu verbessern. Composer 2 ändert das: Zuerst werden die Gewichte der Basis mit code-spezifischen Daten weiter vortrainiert, dann kommt RL obendrauf.
Das Modell nutzt eine Mixture-of-Experts-Architektur (MoE), bei der nur ein Teil der Parameter pro Eingabe aktiv ist. So bleibt die Inferenz schnell, bei gleichzeitig hoher Gesamtparameterzahl. Cursor hat die genaue Parameteranzahl nicht veröffentlicht.
Die Identität des Basismodells wurde zum Start nicht offengelegt, wurde aber am 20. März 2026 öffentlich, nachdem ein Nutzer sie in API-Headern entdeckt hatte. Lee Robinson, VP of Developer Education bei Cursor, bestätigte, dass Composer 2 auf Kimi K2.5 von Moonshot AI basiert, einem Open-Source-Modell. Er sagte, rund drei Viertel des gesamten Computes stammten aus Cursors eigenem Training (fortgesetztes Pretraining und RL), nicht aus dem Basismodell – was erkläre, warum die Evals anders aussehen als ein Raw-Run von Kimi K2.5.
Moonshot AI bestätigte später die Zusammenarbeit als autorisierte kommerzielle Partnerschaft über Fireworks AI, das sowohl die RL-Trainingsinfrastruktur als auch die Inferenz betrieb. Mitgründer Aman Sanger erklärte, das Team habe mehrere Basismodelle mit Perplexity-basierten Benchmarks evaluiert, bevor Kimi K2.5 gewählt wurde, und beschrieb das Training nach der Basis als fortgesetztes Pretraining gefolgt von einem 4x-Scale-up beim RL-Compute.
Die Trainingsinfrastruktur läuft auf PyTorch und Ray, mit benutzerdefinierten MXFP8-Quantisierungskernen für NVIDIA-Blackwell-GPUs.
Self-Summarization
Self-Summarization – von Cursor „Compaction-in-the-loop RL“ genannt – funktioniert so: Wenn das 200.000-Token-Kontextfenster vollzulaufen beginnt, pausiert das Modell, komprimiert seinen eigenen Kontext auf circa 1.000 Tokens und arbeitet weiter. Weil dieses Kompressionsverhalten Teil der RL-Belohnungsfunktion ist, lernt das Modell, welche Variablen, Architekturentscheidungen und Error-Logs es behalten und was es verwerfen soll.
Cursors Research-Blog berichtet, dass diese Methode Kompaktionsfehler gegenüber Prompt-basierter Zusammenfassung um 50% reduziert – bei rund einem Fünftel der Tokens. In einer Demo löste Composer 2 das „make-doom-for-mips“-Problem aus Terminal-Bench 2.0 in 170 Zügen und komprimierte dabei über 100.000 Tokens Kontext.
Kernfähigkeiten
Während einer Session hat Composer 2 Zugriff auf:
In Summe kann der Agent so in einer Session über viele Dateien und Schritte hinweg arbeiten.
Composer-2-Varianten
Cursor liefert Composer 2 in zwei Varianten aus, beide mit derselben zugrundeliegenden Intelligenz.
Composer 2 Fast
Die Variante Fast ist die Standardeinstellung, wenn du Composer 2 im Modelldropdown auswählst. Sie ist für latenzarme, interaktive Sessions gedacht, in denen du in Echtzeit programmierst und nahezu sofortige Antworten willst.
Composer 2 Standard
Die Variante Standard läuft langsamer, kostet aber deutlich weniger pro Token. Ideal für Hintergrundtasks, Batch-Refactorings oder langlaufende agentische Loops, bei denen du nicht auf unmittelbares Feedback angewiesen bist.
Hier ist die Preisaufschlüsselung:
Variante
Input (pro 1 Mio. Tokens)
Cache Read (pro 1 Mio. Tokens)
Output (pro 1 Mio. Tokens)
Composer 2 Standard
$0,50
$0,20
$2,50
Composer 2 Fast (Standard)
$1,50
$0,35
$7,50
Du kannst die Fast-Variante beim aktiven Coden nutzen und für Overnight- oder Bulk-Operationen auf Standard umschalten, um den Kreditverbrauch niedrig zu halten. Auf die Preisunterschiede gehen wir später noch genauer ein.
Composer-2-Benchmarks
Cursor bewertet Composer 2 über drei Benchmarks, die unterschiedliche Aspekte der Coding-Performance abdecken.
Die Benchmarks im Überblick
CursorBench ist Cursors proprietärer interner Benchmark, aktuell in Version CursorBench-3. Die Aufgaben stammen aus echten Cursor-Sessions und werden mit einem Tool namens Cursor Blame gewonnen, das Commits auf die Agent-Anfrage zurückführt, die sie erzeugt hat. Der Benchmark misst Lösungskorrektheit, Codequalität, Effizienz und Interaktionsverhalten. Der Problemumfang hat sich von der ersten Version bis CursorBench-3 in Zeilenanzahl und Dateizahl etwa verdoppelt. Zusätzlich ergänzt Cursor CursorBench um kontrollierte Live-Traffic-Experimente, um Regressionen zu erkennen, die reines Offline-Grading übersehen könnte. Der klare Haken: CursorBench ist nicht öffentlich reproduzierbar, daher sind die Scores nicht unabhängig verifizierbar.
Terminal-Bench 2.0 wird vom Laude Institute gepflegt und testet die Fähigkeit eines KI-Agenten, reale Aufgaben in einer Terminalumgebung auszuführen – inklusive Navigieren, Skripte laufen lassen, Fehler interpretieren und iterativ zur Lösung gelangen. Cursor nutzte das offizielle Harbor-Evaluationsframework in den Standardeinstellungen und ließ pro Modell fünf Läufe, gemeldet wurde der Durchschnitt.
SWE-bench Multilingual ist ein Subset von SWE-bench mit 300 Aufgaben in 9 Programmiersprachen. Es misst die Fähigkeit, echte GitHub-Issues zu beheben – ein guter Test für sprachübergreifendes Coden.
Benchmark-Ergebnisse über die Composer-Generationen
Die Scores sind mit jeder Generation gestiegen:
Benchmark
Composer 1
Composer 1.5
Composer 2
CursorBench
38,0
44,2
61,3
Terminal-Bench 2.0
40,0
47,9
61,7
SWE-bench Multilingual
56,9
65,9
73,7
Benchmark-Scores über drei Composer-Generationen. Bild: Autor.
Hinweis zu Benchmark-Grenzen
Wie viel besser ist Composer 2 als Composer 1.5?
Der Sprung von Composer 1.5 auf Composer 2 ist größer als in allen vorherigen Generationen – sowohl bei Performance als auch bei Kosten.
Wie oben gezeigt, erzielt Composer 2 auf dem CursorBench 61,3 gegenüber 44,2 bei Composer 1.5 – rund 39% mehr. Auf Terminal-Bench 2.0 liegt der Vorsprung bei rund 29% (61,7 vs. 47,9), bei SWE-bench Multilingual etwa 12% (73,7 vs. 65,9).
Der Kostensprung ist noch größer als die Benchmark-Gewinne. Laut Launch-Blog ist Composer 2 Standard bei Input-Tokens rund 86% günstiger als Composer 1.5, und selbst die Fast-Variante ist etwa 57% günstiger. Eine separate Preisseite für Composer 1.5 gibt es nicht; die Prozentsätze stammen aus Cursors eigener Gegenüberstellung zum Launch.
Die wichtigsten technischen Unterschiede:
Die Community nahm Composer 1.5 gemischt auf. Einige Entwickler fanden es nur für kleinere Tasks wie Commits und einfache Edits hilfreich. Die Benchmarks zeigen nun Verbesserungen genau bei den Kritikpunkten.
Composer 2 vs. Claude Opus 4.6 vs. GPT-5.4
Das ist der Vergleich, nach dem die meisten suchen. Composer 2 schlägt Claude Opus 4.6 auf einigen Coding-Benchmarks, liegt bei den meisten hinter GPT-5.4 – und kostet in beiden Fällen deutlich weniger.
Benchmark-Vergleich
Die Zahlen erzählen den Großteil der Geschichte:
Benchmark
Composer 2
Claude Opus 4.6
GPT-5.4
CursorBench
61,3
~58,2
~63,9
Terminal-Bench 2.0
61,7
58,0
75,1
SWE-bench Verified
Nicht berichtet
~80,8%
~80,0%
Composer 2 vs. Claude Opus 4.6 vs. GPT-5.4
Composer 2 liegt bei CursorBench und Terminal-Bench 2.0 knapp vor Opus 4.6, während GPT-5.4 beide mit deutlichem Abstand anführt. Beim Terminal-Bench 2.0 beträgt der Abstand zwischen Composer 2 (61,7) und GPT-5.4 (75,1) 13 Punkte.
Wichtig: Die Terminal-Bench-2.0-Scores messen Agent-plus-Modell-Paare, nicht die Rohmodelle. Cursor nutzte das Harbor-Framework; der Wert 75,1 für GPT-5.4 stammt aus dem Simple-Codex-Harness auf dem offiziellen Leaderboard. Unterschiedliche Harnesses können beim selben Modell unterschiedliche Ergebnisse liefern.
Preisvergleich
So vergleichen sich die Preise:
Modell
Input (pro 1 Mio. Tokens)
Output (pro 1 Mio. Tokens)
Composer 2 Standard
$0,50
$2,50
Composer 2 Fast
$1,50
$7,50
Claude Opus 4.6
$5,00
$25,00
GPT-5.4
$2,50
$15,00
Benchmark-Scores und Tokenpreise im Vergleich. Bild: Autor.
Composer 2 Standard ist pro Token etwa 90% günstiger als Opus 4.6 und rund 80% günstiger als GPT-5.4. Für Teams mit tausenden agentischen Requests pro Tag summiert sich das schnell.
Worin die Modelle jeweils stark sind
Composer 2 ist ein reines Code-Modell, das an die Cursor-IDE gebunden ist. Es erledigt Routineaufgaben schnell und günstig, kann aber außerhalb von Code nichts.
Claude Opus 4.6 bietet 200.000 Tokens Kontext (mit 1 Mio. im Beta-Modus zu höheren Kosten), glänzt bei Architekturplanung über viele Dateien und unterstützt Multi-Agent-Orchestrierung via Agent Teams. Es ist ein Generalist, der sehr gut coden kann.
GPT-5.4 führt die schwierigsten Coding-Benchmarks an, beherrscht Native Computer Use und unterstützt ein experimentelles Kontextfenster mit 1,05 Mio. Tokens. Es ist als Einzelmodell am fähigsten, aber im großen Maßstab am teuersten.
Cursors Positionierung zielt auf Wert pro Aufgabe in der IDE, nicht auf bloße Benchmark-Spitzenwerte.
Composer 2 vs. Claude Code vs. GitHub Copilot
Oben haben wir Composer 2 mit Rohmodellen verglichen. So sieht es auf Produktebene aus.
Claude Code ist Anthropics Terminal-basierter Coding-Agent. Laut einer Entwicklerumfrage 2026 ist es inzwischen das meistgenutzte KI-Coding-Tool unter Profis; 46% nennen es ihr Lieblingswerkzeug, gegenüber 19% für Cursor. Viele nutzen Cursor fürs tägliche IDE-Editing und wechseln für komplexe, autonome Aufgaben zu Claude Code. Die Tools ergänzen sich eher, als dass sie konkurrieren.
GitHub Copilot bleibt mit über 20 Millionen Nutzerinnen und Nutzern insgesamt am weitesten verbreitet und bietet mit $10/Monat einen günstigeren Einstieg. Kürzlich kam Agent Mode für Mehrschritt-Aktionen hinzu, doch viele berichten, dass Cursors Multi-File-Editing tiefer greift.
Rund 70% der Entwickler setzen inzwischen zwei bis vier KI-Tools parallel ein. Die Frage lautet weniger „welches Tool?“ als „welche Kombination?“
So nutzt du Composer 2
Composer 2 lebt vollständig in der Cursor-IDE – es gibt nichts separat zu installieren.
Schritt-für-Schritt-Setup
Um loszulegen, lade Cursor von cursor.com herunter oder aktualisiere es. Composer 2 ist in allen kostenpflichtigen Plänen verfügbar (Pro, Pro+, Ultra, Teams, Enterprise). Öffne das Agent-Panel mit
Cmd+Iauf dem Mac oderCtrl+Iunter Windows und Linux, und wähle „Composer 2“ oder „Composer 2 Fast“ im Modelldropdown. Fast ist standardmäßig aktiv.So findest du das Cursor-Modelldropdown. Bild: Autor.
Formuliere dann in natürlicher Sprache, was erledigt werden soll. Composer 2 arbeitet standardmäßig im Agent-Modus, kann also eigenständig deine Codebase erkunden, Änderungen vornehmen, Terminalbefehle ausführen und alle verfügbaren Tools nutzen. Du prüfst und akzeptierst oder verwirfst die Änderungen, während der Agent arbeitet.
Wichtige Shortcuts
Diese Shortcuts wirst du beim Arbeiten mit Composer 2 am häufigsten nutzen:
Aktion
Mac
Windows/Linux
Agent/Composer öffnen
Cmd+I
Ctrl+I
Neue Konversation
Cmd+N
Ctrl+N
Modus wechseln (Agent/Ask/Edit)
Cmd+.
Ctrl+.
Ask-Modus (Read-only)
Cmd+L
Ctrl+L
Inline-Edit
Cmd+K
Ctrl+K
Historie öffnen
Cmd+Opt+L
Ctrl+Alt+L
Mit Kontext arbeiten
Composer 2 bietet verschiedene Wege, den Kontext zu steuern. Tippe
@gefolgt von einem Dateinamen, Ordner oder einer URL, um gezielten Kontext einzubringen. Das#-Symbol fokussiert eine bestimmte Datei. Oben in der Chatansicht zeigen Kontext-Pills, worauf sich der Agent aktuell bezieht.Für größere Projekte zieht Autocontext (in den Settings aktivierbar) automatisch relevanten Code per Embeddings. Du kannst außerdem eigene Doku in den Settings hinzufügen, um Framework-spezifischen Kontext bereitzustellen.
Self-Summarization in der Praxis
Bei langlaufenden Aufgaben springt Self-Summarization automatisch an, wenn das Kontextfenster voll wird. Du kannst die Kompression auch manuell mit
/compressauslösen. Wenn der Agent eine neue Konversation vorschlägt, ist der Kontext meist zu groß für eine saubere Zusammenfassung – ein frischer Thread ist dann zuverlässiger.Composer-2-Preise
Die Token-Preise haben wir im Varianten-Abschnitt abgedeckt. Hier geht es darum, wie die Preislogik in der Praxis funktioniert.
Cursor-Abostufen
Cursor nutzt ein gestuftes Abo-System mit Credits, die bestimmen, wie stark du Drittanbieter-Modelle nutzen kannst. Aktuell sieht es so aus:
Plan
Preis
Wesentliche Leistungen
Hobby
Kostenlos
Begrenzte Agent-Requests und Tab-Completions
Pro
$20/Monat ($16/Monat jährlich abgerechnet)
$20 Credit-Pool, unbegrenzte Tab-Completions, Cloud-Agents
Pro+
$60/Monat ($48/Monat jährlich abgerechnet)
3x Nutzung auf allen Modellen
Ultra
$200/Monat
20x Nutzung auf allen Modellen, Priorisierter Zugang
Teams
$40/Nutzer/Monat ($32 jährlich)
Zentrale Abrechnung, SAML/OIDC SSO, Analytics
Enterprise
Individuell
SOC 2, Legal Review, erweiterte Security-Kontrollen
So funktionieren Credits mit Composer 2
Hier stolpern viele: Die Composer-Nutzung in Individualplänen kommt aus einem separaten Nutzungspool, der getrennt vom Credit-Pool für Drittmodelle wie Claude oder GPT ist. Cursor beschreibt diesen Pool als „großzügige Nutzung inklusive“, ohne exakte Limits zu veröffentlichen.
Wenn du „Auto“-Mode nutzt, bei dem Cursor pro Request ein Modell wählt, ist die Nutzung von Composer-Modellen in kostenpflichtigen Plänen unbegrenzt und zieht keine Credits ab. Wählst du manuell Premium-Drittmodelle, wird vom monatlichen Credit-Pool abgebucht. Ist der Pool leer, kannst du nutzungsbasierte Überziehungen aktivieren.
Preis-Hintergrund
Cursor hat die Preislogik im letzten Jahr mehrfach geändert. Im Juni 2025 ersetzte man das fixe System „500 Fast-Requests pro Monat“ durch Credit-basiertes Billing, was die Requests im Pro-Tier effektiv von ca. 500 auf rund 225 pro Monat senkte.
Stand März 2026 werden Frontier-Modelle wie GPT-5.4 und Opus 4.6 dynamisch Token-basiert gegen deinen monatlichen Credit-Pool abgerechnet. Composer-2-Nutzung bleibt im separaten Pool. Wenn du für ein Team budgetierst, nutze Composer 2 für Routinearbeit und hebe Drittanbieter-Credits für aufwändigere Aufgaben auf.
Bekannte Einschränkungen von Composer 2
Wie im Vergleichsteil erwähnt, ist Composer 2 Code-only. Mitgründer Aman Sanger sagt es klar: „Es hilft dir nicht bei der Steuererklärung. Es kann keine Gedichte schreiben.“ Für General-Purpose-Aufgaben brauchst du weiterhin Claude oder GPT in Cursor.
Berichten zufolge überspringt Composer 2 in starren, mehrstufigen Ausführungsplänen mitunter Zwischenschritte zur Verifikation und eilt zur Implementierung. Wahrscheinlich ein Trainingseffekt, bei dem das Modell stärker auf Fertigstellung als auf Absicherung optimiert ist.
Einige Nutzer berichten, dass unter macOS Cursors Background-File-Watcher
.gitignorein sehr großen Monorepos ignoriert und so Ordner wienode_modulesindiziert – wodurch Tokenbudgets unerwartet aufgebraucht werden.CursorBench bleibt Closed Source. Für Terminal-Bench 2.0 nahm Cursor bei Nicht-Composer-Modellen „den Maximalwert aus offiziellem Leaderboard und unserem Infrastrukturlauf“ – eine methodische Entscheidung, die man kennen sollte.
Zur Transparenz: Cursor nannte das Basismodell Kimi K2.5 im Launch-Blogpost nicht. Am 20. März 2026 wurde die Modell-ID in API-Headern entdeckt, was kurz eine Debatte über Lizenz-Compliance auslöste. Lin Qiao, CEO von Fireworks AI, stellte klar, dass Cursor von Tag eins an über die Fireworks-Plattform compliant war. Moonshot AI bestätigte die autorisierte Partnerschaft. Sowohl Lee Robinson als auch Mitgründer Aman Sanger räumten ein, dass die Nicht-Nennung „ein Versäumnis“ war, und sagten künftig mehr Transparenz zu.
Fazit
Cursor sagt es selbst: Composer 2 will nicht das insgesamt fähigste Modell sein. Der Fokus liegt auf geringeren Kosten für tägliche IDE-Arbeit.
Die Benchmarks stützen das: Composer 2 übertrifft Claude Opus 4.6 auf Terminal-Bench 2.0 bei rund 90% niedrigeren Kosten pro Token, liegt aber bei härteren Benchmarks noch hinter GPT-5.4.
Der Markt bewegt sich zu Multi-Modell-Workflows, und Cursors Preisgestaltung bei Composer 2 zeigt, dass sie genau darauf setzen.
Wenn du mehr über die KI-Tools erfahren willst, die Softwareentwicklung prägen, lies unseren Vergleich GPT-5.4 vs. Claude Opus 4.6.