

不过,缺点在于最终文稿中的部分论断引用不足或表述过于绝对。由于生产环境建议高度依赖具体情境,若能补充链接、来源以及更清晰的前提假设(硬件、模型规模、批大小、上下文长度),该指南会更有说服力。总体而言,它很好地处理了一个复杂的多部分提示词,并交付了一份简洁、可即刻使用、看起来可直接投入生产的行动手册。
数据集创建与标注
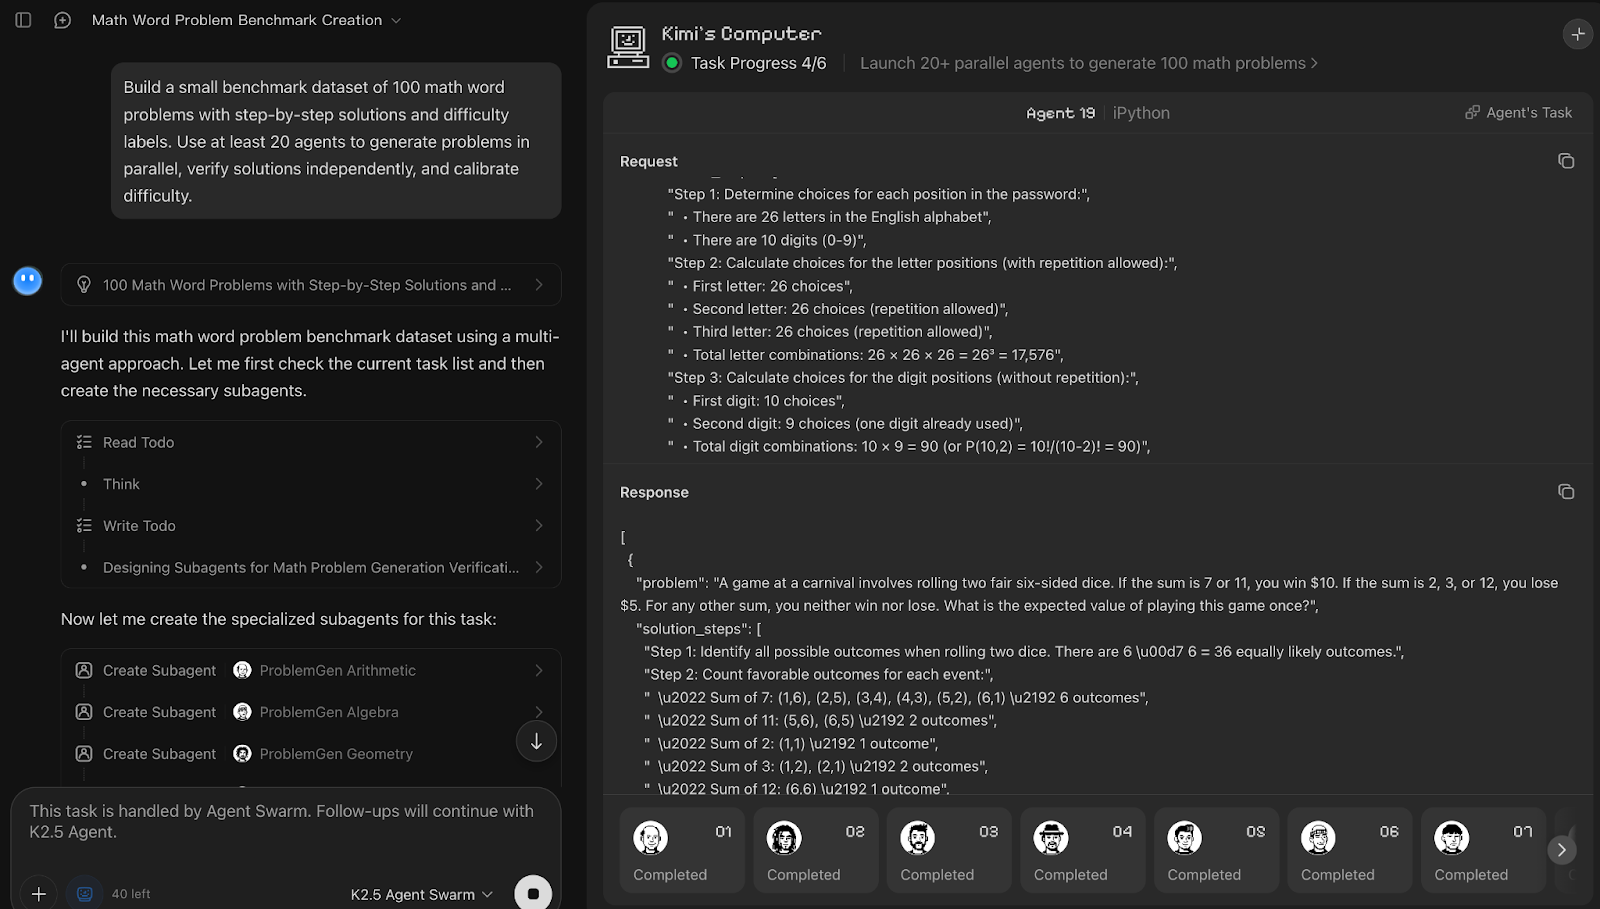
接下来,我将 Agent Swarm 应用于一个数据集构建任务,要求 Kimi K2.5 生成包含解题步骤与难度标签的 100 道数学应用题基准集。我还明确要求使用20 个智能体,以观察其在保证质量的同时,能否贴合蜂群规模的限制。
提示词:
Build a small benchmark dataset of 100 math word problems with step-by-step solutions and difficulty labels. Use at least 20 agents to generate problems in parallel, verify solutions independently, and calibrate difficulty.Kimi K2.5 Agent Swarm 将数据集创建视为包含生成、核验与校准的三阶段流水线。尽管提示词要求至少 20 个智能体,系统仍自主启动了 25 个子智能体,优先保证正确性而非严格遵循数量要求。有趣的是,同时活跃工作的智能体大约有 5 个,其他则排队等待,并在前序子任务完成后继续,这表明内部存在调度机制。
每个生成智能体负责一个不同的数学领域,并产出 5 道题与分步解答;随后分配 10 个智能体进行核验,最后由 5 个较小规模的智能体专注于难度校准。
亮点在于职责清晰分离与核验层面的冗余设计,实质性提升了数据集质量。主要缺点则是延迟与顺序瓶颈。
全程运行约需 20–25 分钟,使这种方法更适合高质量基准构建,而非快速迭代。即便有 25 个智能体,部分仍需等待他人完成,意味着蜂群仍受步骤逻辑所限。
尽管如此,能够根据子任务动态调整智能体数量、复用空闲智能体,并最终收敛到有标签的数据集,充分展示了 Agent Swarm 的行为特征。
大规模多模态问答
随后,我将 Kimi K2.5 推向多模态工作流:提供多张营养成分表图片,并要求进行结构化对比。目标是观察其在抽取、归一化与核验视觉数据方面的能力。
提示词:
I’m sharing images of nutrition labels from 7 packaged food items. Analyze them and produce a clear comparison specifically:
Extract fields like: calories, protein, total fat, sugar, sodium, from each label.Normalize all values to a per-100g basis so items are comparableDouble-check numeric consistency (e.g. serving size vs totals)Rank the products from healthiest to least healthy, explaining the reasoningReturn a comparison table with normalized values for all items. Also include a summary highlighting, best high-protein option, the lowest sugar option, and items to avoid and why.
Assume the labels may vary in format and serving size. Resolve ambiguities where possible and note any missing or unclear values.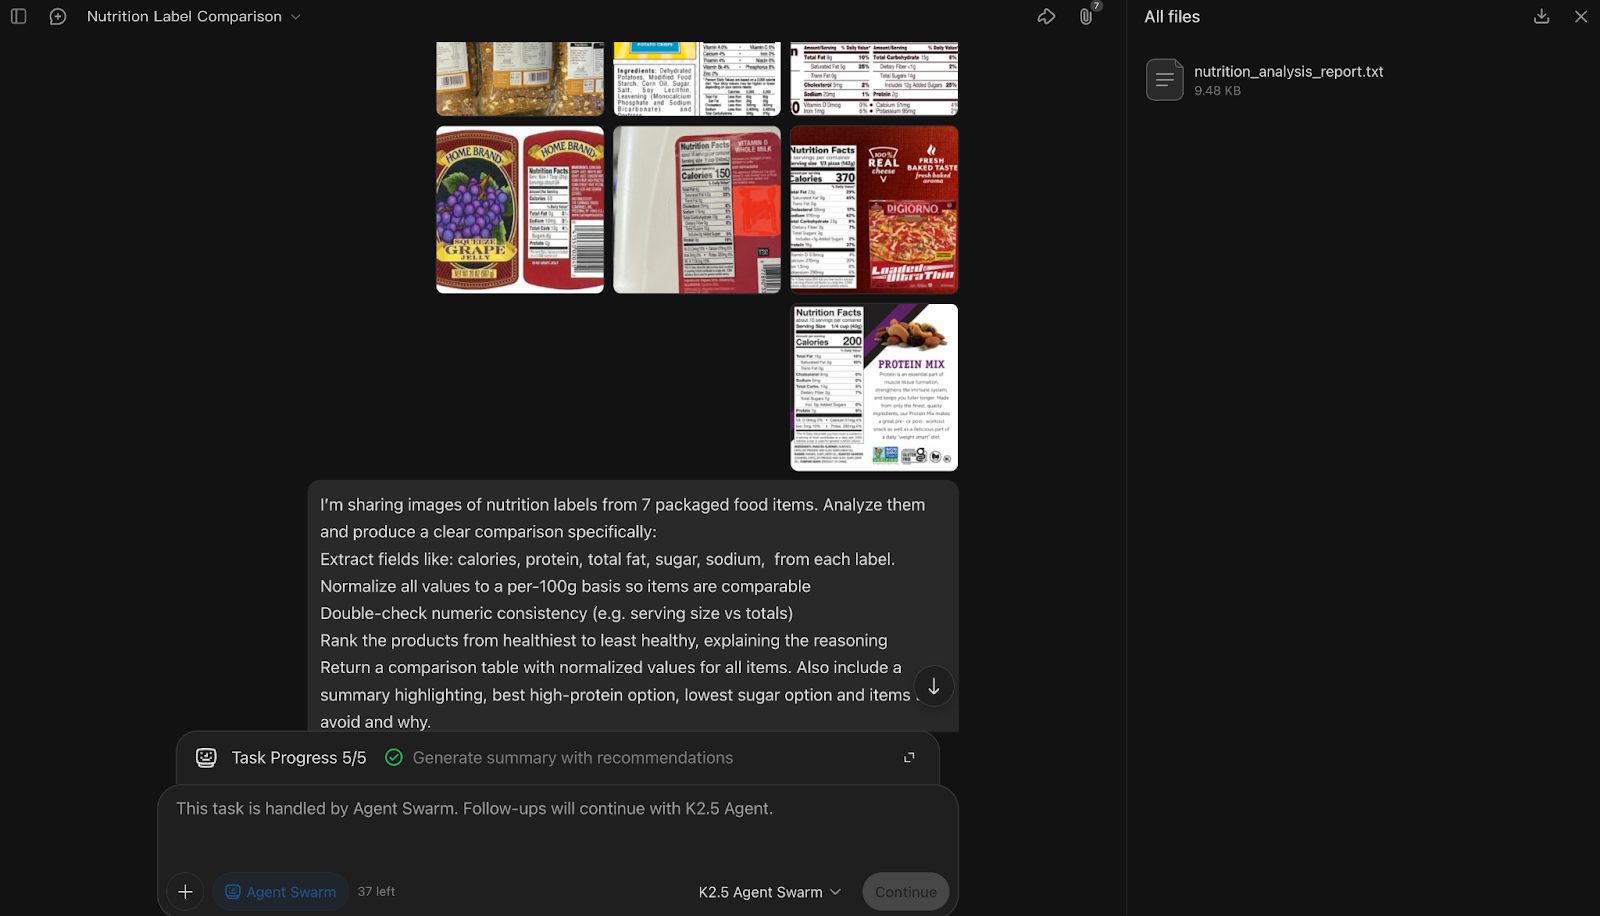
在这个多模态问答实验中,Kimi K2.5 Agent Swarm 以“一张标签对应一个子智能体”的方式拆解任务,启动 7 个并行子智能体从每张图中抽取营养字段,同时由一个协调智能体负责归一化、交叉核对与排序。
Kimi 的一个有趣之处在于,您在提示词中明确的约束(抽取、归一化、核验、排序)会有效转化为它实例化并指派子智能体的蓝图。
令我印象深刻的是,蜂群将核验视作重要步骤:在抽取之后,编排器会明确对齐食用分量、归一化数值并标记不明确之处,而非静默猜测。最终的综合步骤对产品进行排序,并指出高蛋白与低糖的最佳选项,展现了跨视觉输入的强聚合能力。
不足之处在于,使用蜂群分析 7 张高分辨率图片计算量较大,更像是高级功能,而非快速聊天工具。
该示例也暴露了一个当前限制:尽管基于图像的多模态分析表现良好,但尚不支持直接视频输入,因此后续尝试从烹饪视频生成食谱未能执行。
总体而言,该演示凸显了 Agent Swarm 在并行视觉抽取与结构化对齐方面的优势。
开发一款游戏
最后,我通过让其从零构建一款可交互的泡泡龙(Bubble Shooter)游戏来测试 Kimi K2.5 的编码能力。该实验强调模型如何处理端到端、具备状态的一致性代码生成,此时连贯性比并行性更重要。
提示词:
```markdown
构建一款可在本地网页浏览器中运行的完整泡泡龙游戏。游戏需支持鼠标与触控瞄准,显示实时瞄准辅助线,从底部中央发射彩色泡泡,允许子弹在侧墙反弹,并在碰撞后将泡泡吸附到顶部网格。
实现核心玩法逻辑:消除三个及以上相连同色泡泡,掉落与之断开的簇;跟踪并显示得分;显示下一颗泡泡预览;当泡泡越过接近底部的危险线时结束游戏。
视觉尽量简洁但响应式,包含重开按钮,并在最后给出本地运行与测试游戏的简要说明。
```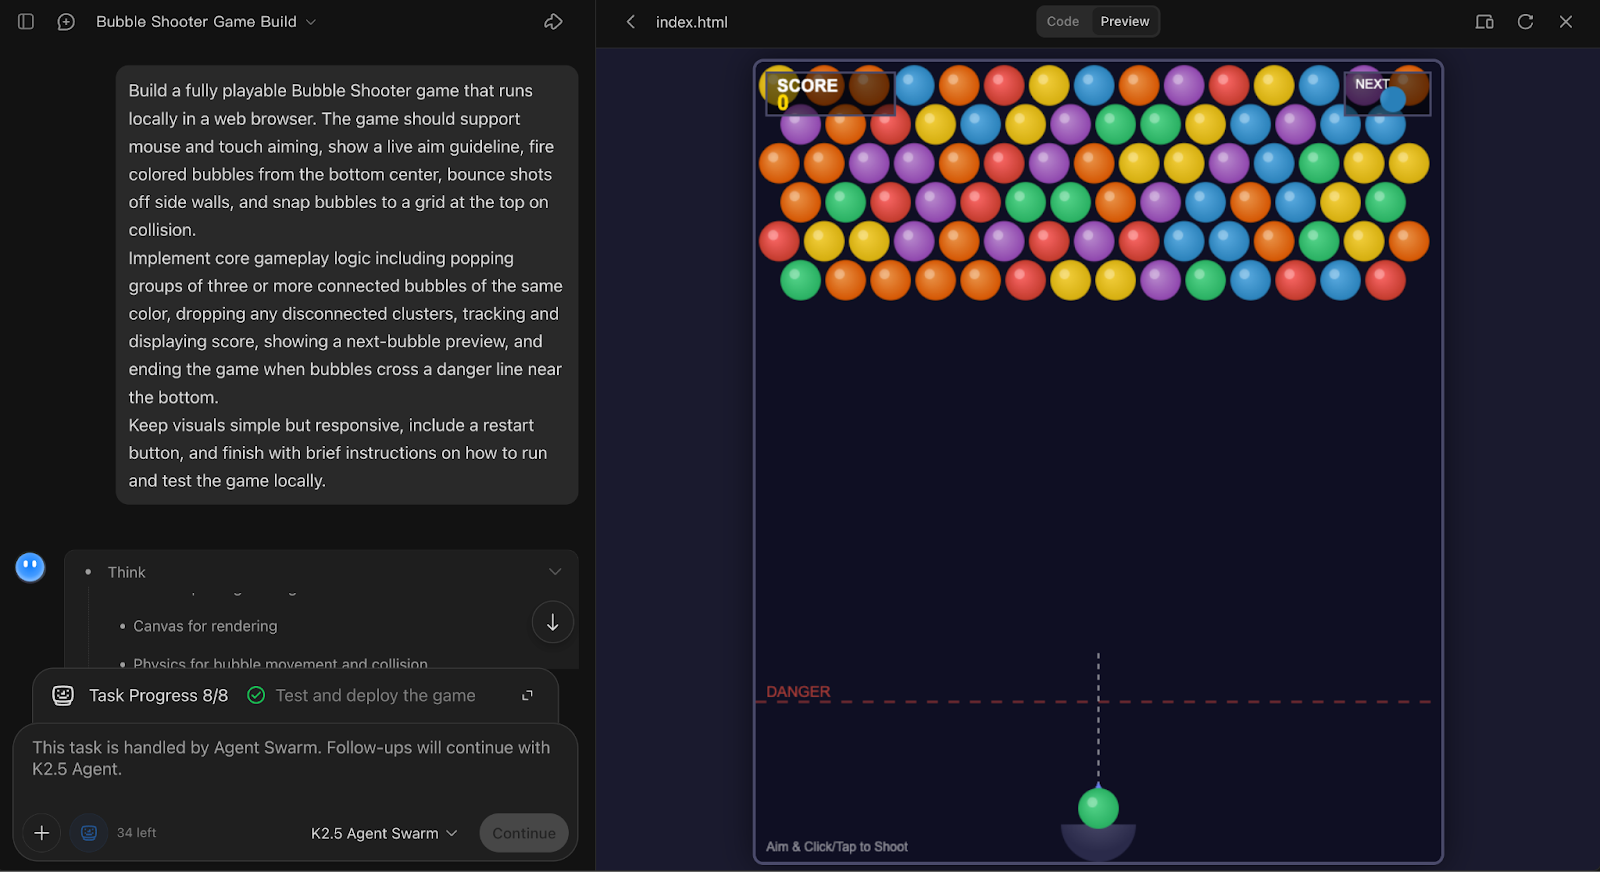
在这个游戏构建实验中,Kimi K2.5 Agent Swarm 作出了显著保守的选择:仅分配一个子智能体处理整个任务。
这一决策本身就很有意思,因为系统正确识别到这是一个耦合度高、具备状态的编码问题,重度并行只会增加协调开销而无益处。
该智能体产出了完整的本地可运行泡泡龙实现,包括瞄准、墙面反弹、网格吸附、三连消除、得分追踪与重启逻辑,既体现了玩法机制,也覆盖了 UI 流程。
我特别喜欢的是输出整体连贯、集成度高。但代价是,打磨与完善可能需要迭代式提示,因为一切都通过单智能体进行。
总体来看,该示例很好地说明了 Kimi K2.5 的 Agent Swarm 并非一味多生智能体,而是仅在并行确实能改善结果时才使用。
结语
在本教程中,Kimi K2.5 展示了其拆解复杂任务、动态分配智能体、并产出结构化、可直接用于决策的结果的能力,而这些传统上往往需要一个小团队才能完成。
同时,这些示例也清晰地勾勒了它的边界。
Agent Swarm 在调研、数据集构建与多模态抽取等广度型、重工具工作流中表现卓越,但对于如交互式游戏开发这类耦合紧密、具状态的任务,优势不大。
它也带来了关于延迟、成本与迭代速度的真实权衡,尤其在将核验与对齐置于原始吞吐之上时更为明显。
总体而言,Kimi K2.5 为智能体系统的未来方向提供了一个颇具吸引力的蓝图。对于愿意在智能体式工作流上进行探索的开发者与研究者而言,它是当下最值得体验的模型之一。
如果您希望进一步了解智能体式 AI 如何工作,建议查看AI Agent Fundamentals 技能路径。
Kimi K2.5 与 Agent Swarm 常见问答
Kimi K2.5 真的开源且可免费使用吗?
是的,Moonshot AI 以经修改的 MIT 许可证发布了 Kimi K2.5,权重已在 Hugging Face 提供。不过,由于它是一个庞大的1.04 万亿参数(Mixture-of-Experts)模型,在本地运行需要企业级硬件(如多张 H100 GPU)。对大多数用户而言,官方 API 或 Web 界面是最实用的接入方式。
Kimi K2.5 的 API 定价是多少?
Kimi K2.5 提供具有竞争力的 API 定价:每 100 万输入 tokens 收费 $0.60(对缓存输入降至$0.10),以及每 100 万输出 tokens 收费 $3.00。
标准聊天与 Agent Swarm 有何区别?
标准聊天是线性、单线程的。Agent Swarm 是并行编排器:它能自主将提示分解为子任务,并生成多达100 个专业化子智能体同时执行。Swarm 适合“广度型”任务,如深度调研或批量数据抽取;而 Chat 更适合如游戏编码这类具状态、顺序性的任务。
Kimi K2.5 是否支持视频输入?
是的,该模型为原生多模态,支持最高2K 分辨率的视频输入。虽然它在长上下文视频基准(如 LongVideoBench)上表现出色,但该功能目前仍为实验性,这意味着与静态图像相比,在基于视频的智能体工作流中,复杂指令跟随偶尔可能遇到困难。
Kimi K2.5 的上下文窗口有多大?
Kimi K2.5 支持256,000 token 的上下文窗口(约 200,000 字)。这一超长上下文使模型可在一次处理内阅读整本书、庞大代码库或冗长法律文档,而无需切分数据,这对于在大型蜂群中保持准确性至关重要。

我是一名 Google Developers 机器学习(生成式 AI)领域的专家、Kaggle 三项专家,以及 Women Techmakers 大使,拥有 3 年以上的技术从业经验。2020 年我共同创办了一家健康科技初创公司,目前在佐治亚理工学院攻读计算机科学硕士,专攻机器学习。
Kimi K2.5 是 Moonshot AI 推出的开源多模态模型,面向的是具备智能体能力的工作流,不仅限于聊天。它并非对孤立的提示逐一响应,而是可以拆解复杂任务、协调工具使用,并在多步工作流中产出诸如表格、报告、计划和代码等结构化结果。
Kimi K2.5 特别有意思之处在于 Agent Swarm。这是一种自我驱动模式,模型可以动态并行启动并编排多个子智能体,以加速调研、核验与执行。
在本教程中,我将介绍 Kimi K2.5 是什么、在哪些方面表现出色,随后重点通过四个上手实验展示 Agent Swarm 在实践中的行为,包括其令人印象深刻之处、短板所在,以及它何时能真正胜过单智能体方案。
什么是 Kimi K2.5?
Kimi K2.5 是 Moonshot AI 的开源、原生多模态模型,能够在同一系统中处理文本、图像、视频和文档。它在 Kimi K2 的基础上,继续在约 15T 的混合文本与视觉标记上进行预训练,并被设计为不仅能充当聊天机器人,更是一个能够规划、调用工具,并(在蜂群模式下)并行执行任务的智能体系统。
在实践中,Kimi K2.5 在三方面表现突出:
来源: Kimi K2.5
上图概述了 Kimi K2.5 在四大类目的表现:智能体、编码、图像与视频。Kimi 以蓝色显示,其他前沿模型以灰色柱状显示。
您可以通过多种方式体验 Kimi K2.5:
https://platform.moonshot.ai为确保基准结果可复现,Moonshot 建议使用官方 API 或通过 Kimi Vendor Verifier 验证的服务商。
Kimi K2.5 中的 Agent Swarm 是什么?
目前大多数多智能体设置仍是手工搭建:您需要定义角色、布线工作流,并寄希望于当任务扩展时编排仍然稳健。Kimi K2.5 的 Agent Swarm 则颠覆了这种模式。
K2.5 不再预设智能体与流水线,而是能自我指挥蜂群,根据任务本身决定何时并行、生成多少智能体、使用哪些工具、以及如何合并结果。
它可以自主创建并协调最多 100 个子智能体的蜂群,在无需预设角色的情况下执行并行工作流,累计可进行多达 1,500 次工具调用。
Kimi K2.5 Agent Swarm 如何工作?
在底层,Agent Swarm 引入了一个可训练的编排器,它学习将工作分解为并行子任务并高效调度:
为何 PARL(并行智能体强化学习)重要
Kimi K2.5 的蜂群行为是通过并行智能体强化学习(PARL)进行训练的,这种训练方式让“并行化”本身成为一种可学习能力。这很关键,因为天真的多智能体系统常以两种方式失效:
PARL 通过在训练中塑造奖励来应对上述问题:它在早期鼓励并行化,随后逐渐将优化重心转向端到端任务质量,从而避免伪并行。为使优化对延迟更敏感,K2.5 使用关键步骤(Critical Steps)来评估表现,因为只有在实际缩短最慢执行路径、而不是徒增协调开销的情况下,增加智能体数才有意义。
当任务具有广度且依赖大量工具时,Agent Swarm 能显著缩短产出时间。Moonshot 报告称,与单智能体方案相比,K2.5 Swarm 可将执行时间缩短约 3 倍至 4.5 倍;内部评估显示,通过真正的并行化,在复杂工作负载上端到端运行时长可最多减少约 80%。
Kimi K2.5 示例与观察
本节我将分享亲测 Kimi K2.5 Agent Swarm 在多种场景下的体验。每个示例都展示蜂群如何拆解任务、分配智能体,以及这种方法在实践中何时真正奏效、何时有所不足。
调研蜂群
作为首个实验,我测试了 Kimi K2.5 Agent Swarm 是否能处理高风险、真实世界的任务,比如起草开源 LLM 的部署方案。
提示词:
在该演示中,Kimi K2.5 Agent Swarm 立即将提示词拆解为并行的调研路径,并启动了三个专门的子智能体,分别为
InferenceStackResearcher、QuantizationHardwareResearcher和CostControlResearcher。这些子智能体名称对应的是各自分配的工作,随后它又将工作扩散到多个工作者角色中。我最喜欢的是,最终输出包含一张清晰的推理栈对比表,并附有简洁的量化建议与注意事项。您还可以通过任务进度条查看它如何在前期拆解工作并跟踪每个子任务直至完成。