

为何使用数据管道?
您也许会疑惑,为什么需要构建管道。如果您一直使用预制数据集,或仅来自单一来源的数据(如 Kaggle 或 DataCamp 练习中的数据),可能根本用不到管道。这些精选数据集已为分析师准备好,可直接获取并使用。
然而,若您想整合来自多来源的信息,可能就需要搭建一条管道,确保所有数据都能被顺利获取并用于分析。
使用数据管道的关键原因
以下是您可能考虑使用数据管道的一些关键理由:
- 单一来源的局限。预制数据集通常受限于单一来源,制约分析范围。
- 数据集成。管道能将多来源数据整合在一起,丰富分析维度。
- 自动化分析。管道便于定期、自动化的数据采集与分析,节省时间并减少人工错误。
- 数据一致性。它们有助于对不同来源的数据进行标准化与转换,保持一致。
- 效率。自动化管道可精简数据工作流,使分析过程更高效。
数据管道示例
例如,设想您想了解某学区学生的平均 GPA 是否与县域的平均收入或人口规模相关。为此,您可能需要从分析范围内每个学区获取 GPA 数据,从 IRS 获取收入数据,并从人口普查局获取人口规模。
一次性手动获取这些信息或许可行。但如果需要定期重复此类分析,构建一条可靠的管道可以帮助您自动化信息收集,节省时间与精力。
处理数据不一致
除了将数据集中到一处,管道还能帮助您处理来自不同来源的数据不一致。例如,人口普查局可能使用县域全名标识,而 IRS 则可能使用缩写名标识。
数据转换
在管道中,您可以设置系统来标准化最终存储库中县域的标识方式。或者,不同条目中的人口数可能使用了不同单位,您需要统一最终目的地所采用的计量单位。这类更改称为转换。
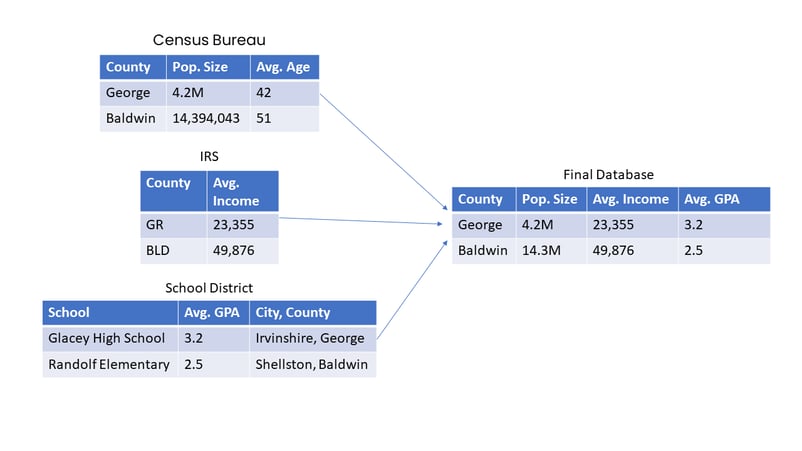
图 2:当合并来自不同来源的信息时,可能需要进行单位转换与名称标准化等变换。
数据管道的使用场景与相关方
数据管道通常由数据工程师开发与维护。
一旦数据在管道末端被收集、清洗并整理好,数据分析师、数据科学家或业务分析师等各类相关方即可获取使用。
随后,这些数据可用于实时分析、导入可更新的仪表板,或加入机器学习模型。有时,管道的终点可能是由业务领导者或个人使用的应用或仪表板。
几乎所有大量使用数据的行业都会用到管道。在一些大型组织(如科技行业)中,其管道通常复杂、受严格监管,并由专业工程师团队管理。
在较小的组织中,例如一名研究人员尝试从世界各地的多个传感器收集数据,管道可能非常直接简单,仅包含少数步骤。其他示例还包括:券商收集金融信息以决定买入哪些股票,或医院系统从各附属医院收集患者记录。
管道对于机器学习模型同样至关重要。这些模型消耗海量数据,良好的管道是顺畅运行的必要条件。这篇 MLOps 教程详细介绍了管道在机器学习中的应用。
数据存储:数据湖、数据仓库与数据库
数据可根据类型与用途以多种方式存储。与数据存储相关,您很可能会遇到三个术语:数据湖、数据库与数据仓库。下面分别简要介绍。
数据湖
数据湖是大型且灵活的存储库,可大规模容纳结构化与非结构化数据。它允许组织以原生格式存储来自各种来源的原始、未处理数据,如网络日志、传感器、社交媒体等。
数据湖以其多样性著称,数据科学家与分析师能够以多种方式探索、转换与分析数据。对于架构与结构未预先定义的大数据与高级分析场景,数据湖尤为有价值,赋予组织从多元数据源中提取洞见的灵活性。
数据库
数据库是更通用的系统,用于高效存储、管理与检索结构化数据。尽管与数据仓库有一些相似之处,数据库通常用于事务性数据、日常运营与实时应用。它们有多种类型,包括关系型数据库、NoSQL 数据库与内存数据库,各自适配特定的数据存储与处理需求。数据库确保数据完整性、支持并发访问,并提供多种查询与检索机制。
数据仓库
数据仓库则是高度结构化且优化的存储库,主要面向分析目的,用于存储、组织与查询结构化数据。它们通常遵循预定义的架构,强化数据质量与一致性,并针对复杂查询与报表任务进行优化。
对于希望基于历史数据做出明智决策的企业,数据仓库是理想之选,因为它为标准化报表与分析提供了单一真实数据源。数据通常从各来源抽取、转换为一致格式后加载入数据仓库以供分析。
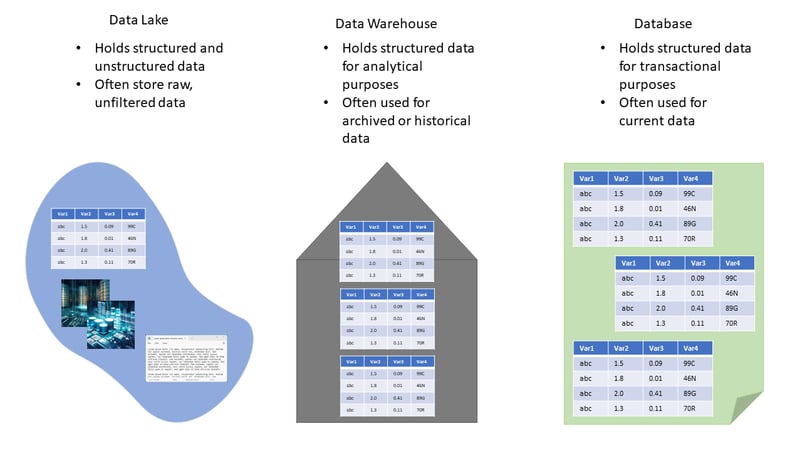
图 3:展示数据湖、数据仓库与数据库的一些差异。数据湖可作为管道中的前置步骤,管道的终点可能是数据仓库或数据库。
管道范式(ETL 与 ELT)
管道通常遵循两种主要范式之一:ETL(Extract, Transform, Load,抽取-转换-加载)或 ELT(Extract, Load, Transform,抽取-加载-转换)。
ETL
ETL 采用顺序式方法。首先,从各种源系统(包括数据库、文件、API 或其他数据存储库)抽取数据。
抽取后,将数据转换为所需的架构、质量与业务规则。此转换可能涉及清洗、聚合与结构化数据。最后,将转换后的数据加载到目标数据仓库或存储系统,通常以利于报表与分析的优化格式存放。
当数据在存入数据仓库前需要大量重构或清洗时,ETL 尤为有益,因为它确保数据干净且可直接用于分析。这门 Python ETL 课程提供了使用 Python 与 SQL 进行 ETL 的详细概览。
ELT
ELT 则将转换步骤的顺序颠倒。在 ELT 流程中,数据先从源系统抽取并按原样加载至数据仓库,有时也会加载到数据湖,而不会进行显著的预处理转换。数据的转换与处理在数据仓库内部完成。
这种方法利用了现代数据仓库与大数据平台的处理能力与灵活性,适用于希望存储海量原始数据并按需执行转换的场景。
当您的数据仓储解决方案能高效处理复杂转换(如云端数据仓库或像 Hadoop 这样的分布式数据处理框架)时,ELT 往往更受青睐。
常见数据管道工具与技术
用于开发管道的工具种类繁多。选择合适工具取决于管道规模、扩展需求、可用资金与管道目标。您可以仅用 Python 与 SQL(或 R 与 SQL)构建完整管道,或使用多种商用工具。
以下是一些常见商用技术与工具的简要清单。
ETL 工具
- Apache NiFi:NiFi 是开源数据集成工具,提供友好的数据流设计界面。它支持数据摄取、转换与路由,特别适合处理来自多种来源与多种格式的数据。
- Apache Airflow:Airflow 是开源的工作流自动化工具,擅长编排复杂数据工作流。它让您能够轻松定义、调度与监控数据管道任务。
- Talend:Talend 是广受欢迎的 ETL 工具,提供全面的数据集成与转换能力,拥有丰富连接器,支持批处理与实时处理。
您可以在另一篇文章中查看我们整理的最佳 ETL 工具清单及其选用理由。
数据流平台
- Apache Kafka:Kafka 是分布式事件流平台,支持对数据流的实时处理。其可扩展性与容错能力出色,适合高吞吐数据场景。
- Amazon Kinesis:Kinesis 是由 AWS 提供的托管流式服务,简化了大规模实时数据流的摄取、处理与分析流程。
数据库技术
- SQL 数据库:传统 SQL 数据库如 MySQL、PostgreSQL 与 Oracle 常作为数据管道中结构化数据的来源与落地目标。
- NoSQL 数据库:当处理不适合表格结构的非结构化或半结构化数据时,MongoDB 与 Cassandra 等 NoSQL 数据库更为合适。
- 数据仓储:如 Amazon Redshift 与 Google BigQuery 等数据仓储解决方案用于存储与分析大型数据集。它们可无缝集成数据管道,支持高级分析与报表。
为管道抽取数据
创建数据管道的第一步是收集要放入管道的数据。在线上有多个获取更新信息的来源,包括政府网页、社交媒体平台及部分非营利组织。它们通常提供相对易用的 API。
使用 API
API(应用程序编程接口)本质上是让两个或多个应用程序之间进行通信的软件。例如,您可以在 Python 应用中集成 Twitter 的 API,使您的应用能够代表您发推或“读取”推文。它本质上是一个中间桥梁。
您可以在管道起点使用 API 从多种来源收集数据。例如,您可以使用 API 收集来自 SEC 的公司申报数据,或收集 NIH 维护表格中的临床数据。
网络爬取
另一种用于收集数据的技术是网络爬取。这是一种使用自定义脚本从互联网上的网页收集信息的技术。Python 的 BeautifulSoup 与 Scrapy 等库能让这一过程相对轻松,但您仍需能够在 HTML 或 XML 中导航以找到所需信息。
如果您想进一步了解网络爬取,DataCamp 提供了 Python 的 Beautiful Soup 教程、 使用 R 进行网页抓取以及 面向 NLP 的网页抓取等资料。
市面上也有零代码的网页抓取服务。这里有一项此类服务,可帮助您从网页收集信息并监控页面变化。
结构化与非结构化数据
您的数据收集过程可能包含结构化数据(如电子表格或数据库)与非结构化数据(如文本或图像)的混合。
根据您的管道最终目标,您可以从非结构化数据中抽取信息,创建统一的结构化数据集;或者保留部分非结构化数据,仅确保为终端用户提供适当的交叉引用。
结构化数据通常可通过 SQL 查询或 ETL 工具抽取,而非结构化数据可能需要自然语言处理(NLP)技术或专业工具。
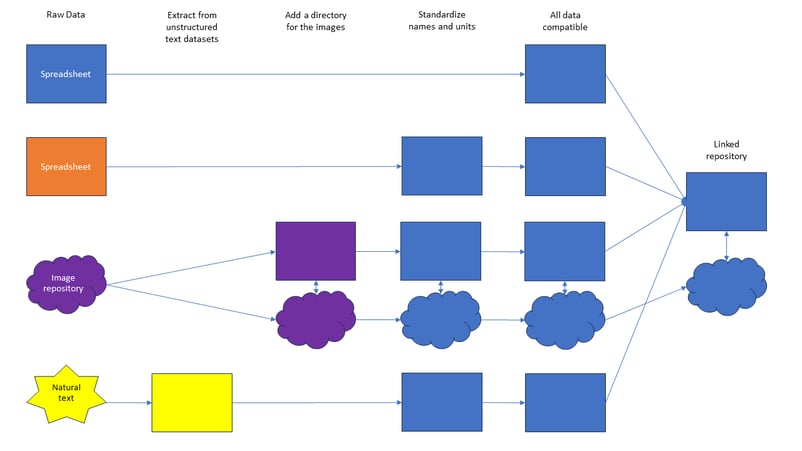
图 4:在管道末端保留非结构化数据的示例。在此示例中,我们希望创建一个包含精选结构化数据与已关联图像的存储库(也可以是数据湖)。因此,我们没有从图像中抽取结构化数据,而是创建了一个目录,将图像与数据库中的相关数据相链接。终端用户随后可以按需为电子表格中的每一行提取原始图像。或者,我们也可以对图像进行分析,并提供突出或去除特定区域的图像。有关如何实现,请参阅这篇图像分析教程。
搭建数据管道
当您已有可用数据源并明确最终目标后,就可以开始搭建管道。
规划
首先要做的是规划您的管道。我建议先在纸上绘制:在纸的最左侧写下您的数据来源,在最右侧写上最终目标;中间则列出从来源到达目标所需的全部步骤。
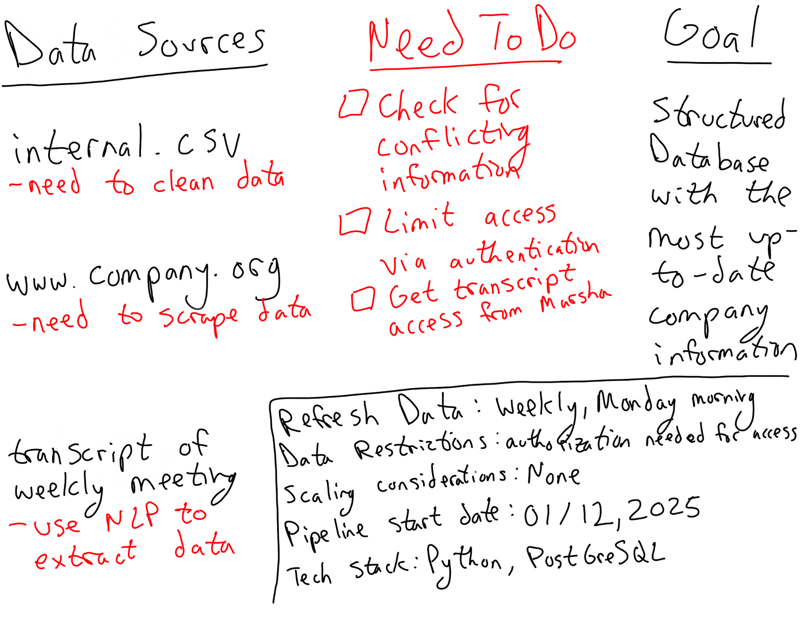
图 5:管道规划示例。
您可能需要包含的一些步骤:
- 为数据收集设置 API 或网络爬取
- 确保数据质量达到终端用户所需标准
- 清洗各数据集,移除 NaN、解决冲突、去重、填补缺失值等
- 在各数据集中标准化数值,以便联合使用
- 为数据集打标签或为终端用户创建交叉引用表
- 从非结构化数据集中抽取结构化数据
- 应用必要的安全措施,如匿名化或加密
构建
在完成规划后,开始构建。这可能完全用您偏好的编程语言实现,或结合一个或多个支持管道的服务。在构建过程中,务必始终牢记终端用户及其需求。
您需要做出的关键决策之一是数据更新频率。如果必须获取最即时的信息,您需要配置支持实时处理的管道。但若不需要如此精细的时效性,可考虑批处理以节省资源。这意味着数据将按批次(如每周或每日)而非连续地通过管道各步骤。
维护
在构建管道时,另一个需要考虑的问题是后续如何维护。您需要建立机制来监控管道运行,并能检测与纠正任何意外问题。
错别字、不完整或重复条目、不同文件类型,仅是管道在初始部署后可能面临的众多挑战之一。构建完善的错误处理与监控系统能为您省去不少烦恼。
若想更深入了解数据管道设计,尤其是在机器学习语境下,请查看 DataCamp 的 设计机器学习工作流(Python)课程。
避免过度复杂,保持简洁
与所有数据相关工作一样,务必让管道仅保持所需的复杂度。更简单的管道更易、更省成本地维护,更易更新,也更便于在需要时移交给其他工程师。
评估项目需求
在管道设计之初,评估项目需求(包括未来预期的扩展)非常重要。这样可帮助您选择恰当的复杂度。
例如,若您需要一个临时管道,在几个月内从三个不同传感器收集数据,您可以考虑使用像 Google Drive 这类广泛可用的免费资源,构建一个简单的一步式管道。
但如果您处理的是敏感数据,或需要执行多次转换,可能需要为管道编写带有加密功能的自定义 Python 或 C# 代码。
最后,您也许正在搭建目前规模较小、但预计未来几年会大幅扩展的管道。在这种情况下,您很可能需要构建具备足够基础设施、可承载扩展的管道。
欠规划的风险
人们往往倾向于先设计一个较小的管道,计划在需要时再重建大型管道。这种做法有时可行,但请谨慎!
许多数据工程师都曾被要求“打补丁”去修复一个并未为当前规模而设计的管道,因为重建被认为成本过高或过于耗时。
尽管简洁至关重要,但如果您在构建长期使用的管道,明智之举是结合预期的扩展计划进行设计。
需要思考的关键问题
在项目伊始,您可以考虑以下问题:
- 需要处理的数据量是多少?
- 数据需要多频繁地更新或分析?
- 是否需要特定的数据转换或数据增强流程?
- 性能与时延要求是什么?
避免“追风”陷阱
初级工程师常见的陷阱是迎合当下潮流,而非选用最契合任务的工具。
例如,许多公司在没有合适用例的情况下,试图将生成式 AI 硬塞进其技术栈。
作为数据从业者,紧跟新技术与趋势固然重要,但务必选择最契合项目的工具,而非盲目追逐潮流,从而导致管道质量不佳。
数据管道优化
当您制定好管道方案后,务必考虑优化方法。目标是在获得所需数据、达到期望分辨率与刷新频率的同时,尽量减少所消耗的计算资源或数据在管道中的延迟。
监控与日志
管道优化的关键组成部分是监控与记录数据在管道中的流动。这能让您洞察瓶颈所在,了解哪些环节在放慢数据流或消耗更多计算资源。
识别常见瓶颈
常见瓶颈包括数据源响应缓慢、资源受限或数据转换效率低下等。
性能优化策略
识别瓶颈后,您可以考虑以下方式优化性能:
- 并行处理。利用多个处理器同时对数据的不同部分执行相同步骤。
- 数据分区。将数据切分为不同部分以提升处理效率。
- 云计算。借助云服务在管道中执行步骤,可能使用比您本地更强大的硬件。
刷新频率的考量
另一个优化考量是数据的刷新频率。如果数据每分钟就通过管道刷新,但您只需要每五分钟更新一次,那么减少不必要的刷新次数可以释放处理器并降低能耗。
数据管道的安全与合规
某些类型的数据在通过您的管道时可能涉及安全或隐私问题。例如,医疗数据受到美国政府的严格监管,所需的安全措施也远高于媒体观看习惯等数据。其他需要更高安全级别的数据还包括金融数据与密码。
您采取的安全措施类型取决于该类数据的安全考量。在某些情况下,匿名化即可满足需求,即将个人信息与数据集解耦或删除。这在不需要个人身份信息、但需要医疗记录中其他信息的医学研究中可能适用。
您可能还需要采用其他安全措施,包括加密以及通过登录授权控制数据访问。这些方式可用于金融数据或公司机密。
对于所有敏感数据,熟悉并遵守政府法规(如 GDPR《通用数据保护条例》或 HIPAA《健康保险流通与责任法案》)至关重要。
根据您的行业与所处理数据的类型,您可能还需遵守其他法规,如 CCPA(《加州消费者隐私法》)或 FERPA(《家庭教育权利与隐私法》)。
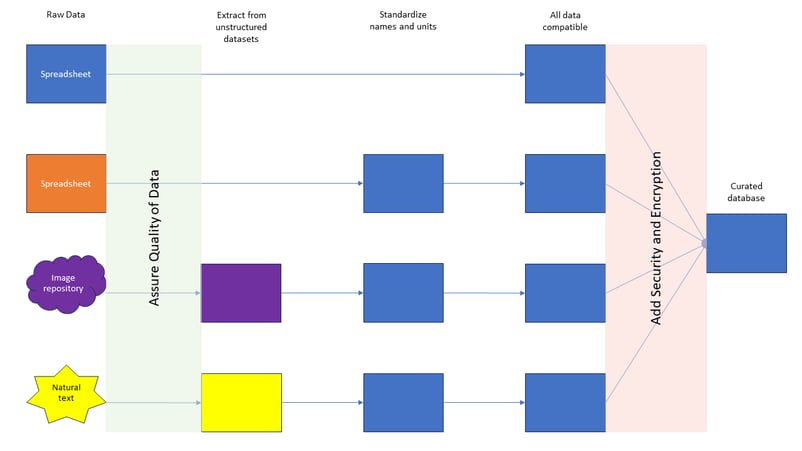
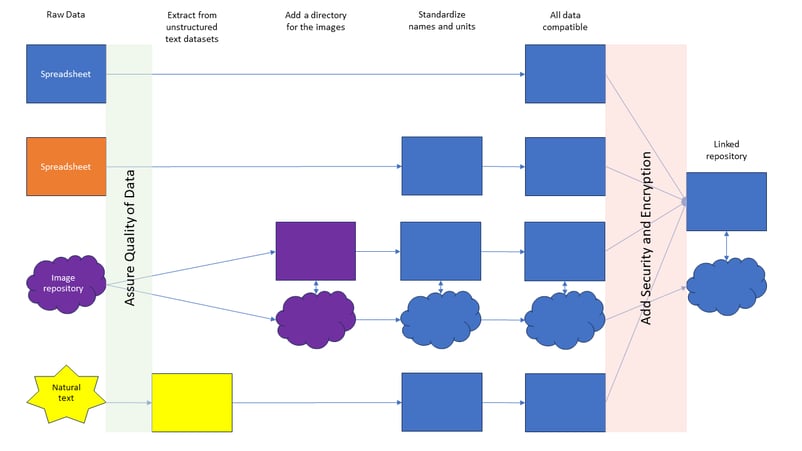
图 6:在管道中加入质量保证与安全步骤的示例。
结语
数据管道及其背后的工程师是数据世界中默默无闻的英雄。他们让数据在各处之间顺畅流动,并对其进行组织与归类。根据 Statista 的数据,世界在 2020 年一年就已生成、消费并存储了 64.2 ZB 的数据,而且这一数字每年都在增加。
在这样的数据环境下,构建并维护稳健的数据管道变得愈发关键。如果本教程激发了您对数据管道的兴趣,欢迎查看这门入门课程以获得更深入的理解。若您希望学习如何构建数据管道,请从这门Python 数据工程课程开始。若您正准备开启职业生涯并向雇主证明您的能力,请查看我们的数据工程师认证。

我拥有博士学位,在生物研究环境中从事数据相关工作已有13年。我使用包括 Python、MATLAB 和 R 在内的多种编程语言开发软件。我热衷于与世界分享我对学习的热爱。
数据对企业和各类组织至关重要,而组织这些数据流动的任务正是数据管道大显身手之处。那么,什么是数据管道?要构建您自己的管道,需要了解哪些内容?
什么是数据管道?
数据是现代企业与组织的生命线,驱动决策、洞察与创新。然而,管理并释放数据的力量可能复杂且令人望而却步。这正是数据管道派上用场的地方。那么,数据管道究竟是什么?
数据管道是一种系统,用于从各种来源获取数据,将其汇入新的位置(如数据库、存储库或应用程序),并在此过程中执行必要的数据转换(将数据从一种格式或结构转换为另一种)。该管道的终端用户可能是分析师、数据科学家或业务领导者。
图 1:简单数据管道示例。在此示例中,有四个数据来源:两个结构化、两个非结构化。通过一系列步骤,您从非结构化数据集中提取结构化数据,统一所有名称与计量单位;当所有数据彼此兼容后,您即可创建一个精选数据库,囊括所需信息。分析师、科学家或业务领导者随后都可使用该数据库。
尽管听起来简单,但其中充满抉择与挑战。在许多组织中,构建与维护管道是一项由数据工程师负责的完整工作;在另一些组织中,这只是数据科学家众多职责之一。由谁来维护通常取决于组织规模、管道复杂性及可用经费。
构建可靠、安全、及时的管道是数据驱动决策的关键一环。无论您打算从事数据工程,还是涉足数据流程的其他岗位,理解数据管道都将物超所值。