在手机或桌面上使用 DeepSeek 应用时,我们常常会拿不准:日常任务究竟该选 R1(也称为 DeepThink),还是使用默认的 V3 模型。
对开发者来说,挑战略有不同。通过 API 集成 DeepSeek 时,要判断哪个模型更契合项目需求并能提升功能表现。
在本文中,我将梳理这两个模型的关键点,帮助您更轻松地做出选择。我会通过示例展示各模型在不同场景下的行为与表现,并提供一份决策指南,方便您在 DeepSeek-R1 与 DeepSeek-V3 之间进行选择。
我们通过每周五的免费通讯 The Median 为读者带来最新 AI 动态,精炼解读本周要闻。订阅后,每周花几分钟即可保持敏锐:
什么是 DeepSeek-V3 与 DeepSeek-R1?
DeepSeek 是一家中国 AI 初创公司。其以显著低于 OpenAI o1 的成本开发出 DeepSeek-R1,因而获得国际关注。就像 OpenAI 拥有我们熟悉的 ChatGPT 应用一样,DeepSeek 也有类似的对话机器人,并提供两个模型:DeepSeek-V3 和 DeepSeek-R1。
什么是 DeepSeek-V3?
DeepSeek-V3 是我们与 DeepSeek 应用交互时的默认模型。它是一款通用型 大型语言模型(LLM) ,擅长充当多用途工具,能处理广泛任务。
该模型与其他知名语言模型竞争,例如 OpenAI 的 GPT-4o 。
DeepSeek-V3 的一项关键特性是采用了专家混合(MoE)方法。该方法允许模型从不同的“专家”中选择来执行特定任务。当您给出提示后,模型只会激活与该任务最相关的部分,从而在节省算力的同时提供精准结果。想进一步了解,可查看这篇关于 专家混合(MoE) 的博文。
总的来说,DeepSeek-V3 是满足我们对 LLM 日常大多数需求的可靠之选。但与多数 LLM 一样,它基于下一词预测工作,这限制了其在需要推理的问题求解上,以及在训练数据未涵盖的新答案上的能力。
什么是 DeepSeek-R1?
DeepSeek-R1 是一款面向高级推理与深度问题求解的强大推理模型。它非常适合不止于“复述”已有代码的编程挑战,以及偏重逻辑的问题。
可以把它看作在任务需要高阶认知操作(类似专业级/专家级推理)时的首选方案。
我们可以通过点击“DeepThink (R1)”按钮来激活它:
DeepSeek-R1 的独到之处在于其对 强化学习 的专项应用。R1 的训练以 V3 为基础,利用其强大的能力与海量参数空间。它通过让模型为问题场景生成多种解法来进行强化学习,再用基于规则的奖励系统评估答案与推理步骤的正确性。该强化学习方法促使模型随时间打磨推理能力,逐步学会自主探索与构建推理路径。
DeepSeek-R1 是 OpenAI o1 的直接竞争对手。
V3 与 R1 的一个差异在于,与 R1 对话时我们不会立刻得到回复。模型会先采用 思维链 推理来思考问题,完成思考后才开始输出答案。
这也意味着总体上 R1 的响应明显慢于 V3,因为其思考过程可能需要数分钟,后面的示例会提到这一点。
V3 与 R1 的差异
我们从多个方面来对比 DeepSeek-R1 与 DeepSeek-V3 的不同:
推理能力
DeepSeek-V3 不具备推理能力。如前所述,它作为下一词预测器工作。这意味着它能回答那些在训练数据中已被编码的问题。
由于训练数据量极其庞大,它几乎可以回答任何主题的问题。与其他 LLM 一样,它擅长自然流畅的对话与创意表达。它适用于写作、内容创作,或回答很可能已被多次解决的通用问题。
相对而言,DeepSeek-R1 在复杂问题求解、逻辑推断与循序渐进的推理任务上更具优势。它旨在应对需要深入分析与结构化解法的棘手问题。遇到复杂编程挑战或精细的逻辑谜题时,R1 值得依赖。
速度与效率
得益于专家混合(MoE)架构,DeepSeek-V3 的响应更快、更高效。这使 V3 成为对速度要求较高的实时交互场景的理想选择。
DeepSeek-R1 通常需要更久来生成回复,但这是为了提供更深入、更结构化的答案。额外耗时用于确保解答全面且深思熟虑。
记忆与上下文处理
两者都可处理最多 64,000 个输入 token,但 DeepSeek-R1 在长时交互中维持逻辑与上下文的一致性方面尤为擅长。这使其适合需要持续推理与跨长对话或复杂项目保持理解的任务。
最适合 API 用户的场景
对于 API 使用者,DeepSeek-V3 能提供更自然流畅的交互体验。其在语言与对话上的优势使用户互动更顺滑、更具吸引力。
R1 的响应时间对许多应用来说可能是个问题,因此我建议仅在确有必要时才使用它。
需要注意的是,API 使用时的模型名称并非 V3 与 R1。V3 对应 deepseek-chat,而 R1 对应 deepseek-reasoner。
价格差异
在选择模型时,还需注意 V3 比 R1 更便宜。虽然本文重点关注功能性,但也应结合各模型的成本与我们的具体需求和预算来权衡。有关费用的更多信息,请查看 其 API 定价文档 。
DeepSeek-R1 vs. V3:来自 DeepSeek Chat 的示例
示例 1:问题求解与逻辑任务
我们用下面这个问题来比较两者的推理能力:
“使用数字 [0-9] 组成三个数:x、y、z,使得 x+y=z”
例如,一个可行解是:x = 26,y = 4987,z = 5013。它使用了 0-9 所有数字,且 x + y = z。
当我们把这个问题交给 V3 时,它会立即输出一段很长的回答,并最终错误地得出“无解”的结论:
另一方面,R1 经过大约 5 分钟的推理后可以找到一个解:
这表明 R1 更适合需要数学推理的问题;而像 V3 这样的下一词预测模型,除非训练时见过大量类似问题,否则很难走上正确的解题路径。
示例 2:创意写作
接下来关注创意写作。我们让两个模型分别写一篇关于“群体中的孤独”的微型小说。
“写一篇关于群体中孤独感的微型小说”
下面是 V3 的输出:
我们立即得到一篇契合主题的故事。喜不喜欢是主观的,但答案与需求一致。
使用推理时,模型会先进行构思。此处不展示全部细节,但它将任务分解为如下步骤:
首先,我应该设定场景…… 接着,添加感官细节…… 我需要展现他们的内在状态…… 以一个动人的意象收束…… 让我检查一下是否涵盖了所有要素……
可以看到,创作过程非常结构化,这可能会压缩输出的创造力。
我认为,除非我们对推理过程本身感兴趣,否则这类任务更不必用 R1,因为我们想要的产出并非主要源自逻辑推导,而是源自创意表达。
示例 3:编码协助
第三个示例中,我们请 DeepSeek 帮忙修复一个略有错误的 Python 函数,用于解决如下问题:
“参加城市跑步的人在起跑与终点都要登记姓名。我们知道恰有一人未完成比赛。下面这个 Python 函数试图找出那个人的名字,但无法正常工作。请修复。”
def find_person ( names) :
freq = { }
for name in names:
if name not in freq:
freq[ name] = 0
freq[ name] += 1
for name in names:
if freq[ name] == 1 :
return name
return None 技术支持 在交给 AI 之前,我们先理解一下这段代码的问题所在。
由于每个人在起跑与完赛时都会登记姓名,这段代码试图通过找出“只出现一次的名字”来解决问题。完成比赛的人会登记两次,没完成的人只登记一次。然而,这段代码错误地假设所有姓名都是唯一的(互不重名)。
正确答案不是“出现频次等于 1 的名字”,而是“出现频次为奇数的名字”。因此,应将第二个 for 循环中的 if freq[name] == 1: 替换为 if freq[name] % 2 == 1,以找到奇数频次的名字。
接下来看看两个模型如何应对这个问题。我们提供的提示如下:
以下是 V3 的回答:
V3 未能找到正确答案。不仅通过引入两个输入列表更改了题目设定,而且即便真的有两个不同列表,其给出的解法也无法奏效。
相比之下,R1 能发现代码的问题,尽管其方案是重写代码而非直接修复给定代码:
该模型找到答案的速度较慢。我们可以看到,它推理了将近 8 分钟。高亮部分显示了模型意识到代码问题所在的时刻。
何时选择 DeepSeek-R1 与 DeepSeek-V3
在 DeepSeek-R1 与 DeepSeek-V3 之间做选择,取决于您希望通过任务或项目实现什么目标。
我对大多数任务的一般建议是:优先使用 V3;若 V3 陷入“找不到答案的循环”,再切换到 R1。不过,这个流程假设我们能分辨答案对错。而在某些问题上,我们未必总能清楚判断。
比如,写一个汇总数据的简单脚本时,我们可以运行代码,检验是否达成预期;但如果要构建一个复杂算法,验证代码是否正确就没那么容易了。
因此, 在两者之间做选择时,仍然需要一些指导原则。以下是推荐的选择指南:
任务
模型
写作、内容创作、翻译
V3
可以自评输出质量的任务
V3
通用编程问题
V3
AI 助手
V3
研究
R1
复杂数学、编程或逻辑问题
R1
为解决单个问题而进行的长且迭代的对话
R1
希望了解得到答案的思考过程
R1
结论
DeepSeek V3 适合处理日常任务,例如写作、内容创作与快速编程问题,也适合构建以自然流畅对话为核心的 AI 助手。对于可以快速评估输出质量的任务,它同样表现出色。
然而,面对需要深度推理的复杂挑战(如研究、复杂编程或数学问题,或长时间的问题求解对话),DeepSeek R1 会是更好的选择。
若想进一步了解 DeepSeek,请参阅以下博文:


在手机或桌面上使用 DeepSeek 应用时,我们常常会拿不准:日常任务究竟该选 R1(也称为 DeepThink),还是使用默认的 V3 模型。
对开发者来说,挑战略有不同。通过 API 集成 DeepSeek 时,要判断哪个模型更契合项目需求并能提升功能表现。
在本文中,我将梳理这两个模型的关键点,帮助您更轻松地做出选择。我会通过示例展示各模型在不同场景下的行为与表现,并提供一份决策指南,方便您在 DeepSeek-R1 与 DeepSeek-V3 之间进行选择。
我们通过每周五的免费通讯 The Median 为读者带来最新 AI 动态,精炼解读本周要闻。订阅后,每周花几分钟即可保持敏锐:
什么是 DeepSeek-V3 与 DeepSeek-R1?
DeepSeek 是一家中国 AI 初创公司。其以显著低于 OpenAI o1 的成本开发出 DeepSeek-R1,因而获得国际关注。就像 OpenAI 拥有我们熟悉的 ChatGPT 应用一样,DeepSeek 也有类似的对话机器人,并提供两个模型:DeepSeek-V3 和 DeepSeek-R1。
什么是 DeepSeek-V3?
DeepSeek-V3 是我们与 DeepSeek 应用交互时的默认模型。它是一款通用型 大型语言模型(LLM),擅长充当多用途工具,能处理广泛任务。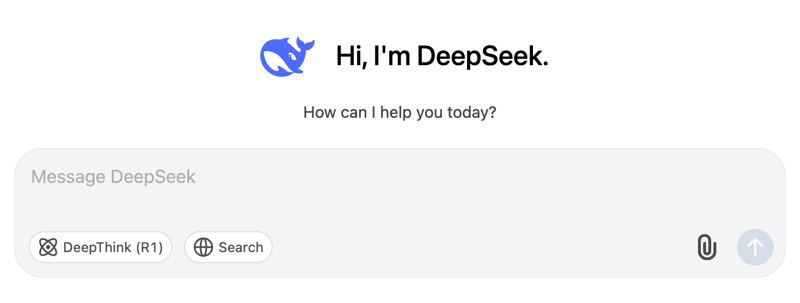
该模型与其他知名语言模型竞争,例如 OpenAI 的 GPT-4o。
DeepSeek-V3 的一项关键特性是采用了专家混合(MoE)方法。该方法允许模型从不同的“专家”中选择来执行特定任务。当您给出提示后,模型只会激活与该任务最相关的部分,从而在节省算力的同时提供精准结果。想进一步了解,可查看这篇关于 专家混合(MoE) 的博文。
总的来说,DeepSeek-V3 是满足我们对 LLM 日常大多数需求的可靠之选。但与多数 LLM 一样,它基于下一词预测工作,这限制了其在需要推理的问题求解上,以及在训练数据未涵盖的新答案上的能力。
什么是 DeepSeek-R1?
DeepSeek-R1 是一款面向高级推理与深度问题求解的强大推理模型。它非常适合不止于“复述”已有代码的编程挑战,以及偏重逻辑的问题。
可以把它看作在任务需要高阶认知操作(类似专业级/专家级推理)时的首选方案。
我们可以通过点击“DeepThink (R1)”按钮来激活它:
DeepSeek-R1 的独到之处在于其对 强化学习 的专项应用。R1 的训练以 V3 为基础,利用其强大的能力与海量参数空间。它通过让模型为问题场景生成多种解法来进行强化学习,再用基于规则的奖励系统评估答案与推理步骤的正确性。该强化学习方法促使模型随时间打磨推理能力,逐步学会自主探索与构建推理路径。
DeepSeek-R1 是 OpenAI o1 的直接竞争对手。
V3 与 R1 的一个差异在于,与 R1 对话时我们不会立刻得到回复。模型会先采用 思维链 推理来思考问题,完成思考后才开始输出答案。
这也意味着总体上 R1 的响应明显慢于 V3,因为其思考过程可能需要数分钟,后面的示例会提到这一点。
V3 与 R1 的差异
我们从多个方面来对比 DeepSeek-R1 与 DeepSeek-V3 的不同:
推理能力
DeepSeek-V3 不具备推理能力。如前所述,它作为下一词预测器工作。这意味着它能回答那些在训练数据中已被编码的问题。
由于训练数据量极其庞大,它几乎可以回答任何主题的问题。与其他 LLM 一样,它擅长自然流畅的对话与创意表达。它适用于写作、内容创作,或回答很可能已被多次解决的通用问题。
相对而言,DeepSeek-R1 在复杂问题求解、逻辑推断与循序渐进的推理任务上更具优势。它旨在应对需要深入分析与结构化解法的棘手问题。遇到复杂编程挑战或精细的逻辑谜题时,R1 值得依赖。
速度与效率
得益于专家混合(MoE)架构,DeepSeek-V3 的响应更快、更高效。这使 V3 成为对速度要求较高的实时交互场景的理想选择。
DeepSeek-R1 通常需要更久来生成回复,但这是为了提供更深入、更结构化的答案。额外耗时用于确保解答全面且深思熟虑。
记忆与上下文处理
两者都可处理最多 64,000 个输入 token,但 DeepSeek-R1 在长时交互中维持逻辑与上下文的一致性方面尤为擅长。这使其适合需要持续推理与跨长对话或复杂项目保持理解的任务。
最适合 API 用户的场景
对于 API 使用者,DeepSeek-V3 能提供更自然流畅的交互体验。其在语言与对话上的优势使用户互动更顺滑、更具吸引力。
R1 的响应时间对许多应用来说可能是个问题,因此我建议仅在确有必要时才使用它。
需要注意的是,API 使用时的模型名称并非 V3 与 R1。V3 对应
deepseek-chat,而 R1 对应deepseek-reasoner。价格差异
在选择模型时,还需注意 V3 比 R1 更便宜。虽然本文重点关注功能性,但也应结合各模型的成本与我们的具体需求和预算来权衡。有关费用的更多信息,请查看 其 API 定价文档。
DeepSeek-R1 vs. V3:来自 DeepSeek Chat 的示例
示例 1:问题求解与逻辑任务
我们用下面这个问题来比较两者的推理能力:
“使用数字 [0-9] 组成三个数:x、y、z,使得 x+y=z”
例如,一个可行解是:x = 26,y = 4987,z = 5013。它使用了 0-9 所有数字,且 x + y = z。
当我们把这个问题交给 V3 时,它会立即输出一段很长的回答,并最终错误地得出“无解”的结论:
另一方面,R1 经过大约 5 分钟的推理后可以找到一个解:
这表明 R1 更适合需要数学推理的问题;而像 V3 这样的下一词预测模型,除非训练时见过大量类似问题,否则很难走上正确的解题路径。
示例 2:创意写作
接下来关注创意写作。我们让两个模型分别写一篇关于“群体中的孤独”的微型小说。
“写一篇关于群体中孤独感的微型小说”
下面是 V3 的输出:
我们立即得到一篇契合主题的故事。喜不喜欢是主观的,但答案与需求一致。
使用推理时,模型会先进行构思。此处不展示全部细节,但它将任务分解为如下步骤:
可以看到,创作过程非常结构化,这可能会压缩输出的创造力。
我认为,除非我们对推理过程本身感兴趣,否则这类任务更不必用 R1,因为我们想要的产出并非主要源自逻辑推导,而是源自创意表达。
示例 3:编码协助
第三个示例中,我们请 DeepSeek 帮忙修复一个略有错误的 Python 函数,用于解决如下问题:
“参加城市跑步的人在起跑与终点都要登记姓名。我们知道恰有一人未完成比赛。下面这个 Python 函数试图找出那个人的名字,但无法正常工作。请修复。”
在交给 AI 之前,我们先理解一下这段代码的问题所在。
由于每个人在起跑与完赛时都会登记姓名,这段代码试图通过找出“只出现一次的名字”来解决问题。完成比赛的人会登记两次,没完成的人只登记一次。然而,这段代码错误地假设所有姓名都是唯一的(互不重名)。
正确答案不是“出现频次等于 1 的名字”,而是“出现频次为奇数的名字”。因此,应将第二个
for循环中的if freq[name] == 1:替换为if freq[name] % 2 == 1,以找到奇数频次的名字。接下来看看两个模型如何应对这个问题。我们提供的提示如下:
以下是 V3 的回答:
V3 未能找到正确答案。不仅通过引入两个输入列表更改了题目设定,而且即便真的有两个不同列表,其给出的解法也无法奏效。
相比之下,R1 能发现代码的问题,尽管其方案是重写代码而非直接修复给定代码:
该模型找到答案的速度较慢。我们可以看到,它推理了将近 8 分钟。高亮部分显示了模型意识到代码问题所在的时刻。
何时选择 DeepSeek-R1 与 DeepSeek-V3
在 DeepSeek-R1 与 DeepSeek-V3 之间做选择,取决于您希望通过任务或项目实现什么目标。
我对大多数任务的一般建议是:优先使用 V3;若 V3 陷入“找不到答案的循环”,再切换到 R1。不过,这个流程假设我们能分辨答案对错。而在某些问题上,我们未必总能清楚判断。
比如,写一个汇总数据的简单脚本时,我们可以运行代码,检验是否达成预期;但如果要构建一个复杂算法,验证代码是否正确就没那么容易了。
因此,在两者之间做选择时,仍然需要一些指导原则。以下是推荐的选择指南:
任务
模型
写作、内容创作、翻译
V3
可以自评输出质量的任务
V3
通用编程问题
V3
AI 助手
V3
研究
R1
复杂数学、编程或逻辑问题
R1
为解决单个问题而进行的长且迭代的对话
R1
希望了解得到答案的思考过程
R1
结论
DeepSeek V3 适合处理日常任务,例如写作、内容创作与快速编程问题,也适合构建以自然流畅对话为核心的 AI 助手。对于可以快速评估输出质量的任务,它同样表现出色。
然而,面对需要深度推理的复杂挑战(如研究、复杂编程或数学问题,或长时间的问题求解对话),DeepSeek R1 会是更好的选择。
若想进一步了解 DeepSeek,请参阅以下博文: