

Leerpad
AI-basisprincipes
10 uur
Oefen en volg je voortgang.
Ga Verder Met GoogleWanneer we de DeepSeek-app op onze telefoon of desktop gebruiken, kan het lastig zijn om te bepalen wanneer je R1, ook wel DeepThink, kiest in plaats van het standaard V3-model voor alledaagse taken.
Voor developers is de uitdaging net anders. Bij het integreren van DeepSeek via de API is het de kunst om te bepalen welk model het beste past bij de projectvereisten en de functionaliteit versterkt.
In deze blog behandel ik de belangrijkste aspecten van beide modellen om die keuze makkelijker te maken. Ik geef voorbeelden om te laten zien hoe elk model zich gedraagt en presteert in verschillende situaties. Ook krijg je een keuzegids die je kunt gebruiken om te kiezen tussen DeepSeek-R1 en DeepSeek-V3.
We houden onze lezers op de hoogte van het laatste AI-nieuws met The Median, onze gratis vrijdagse nieuwsbrief die de belangrijkste verhalen van de week samenvat. Abonneer je en blijf scherp in een paar minuten per week:
DeepSeek is een Chinese AI-startup die internationaal in de belangstelling kwam doordat het DeepSeek-R1 ontwikkelde tegen veel lagere kosten dan OpenAI’s o1. Net zoals OpenAI de ChatGPT-app heeft die we allemaal kennen, heeft DeepSeek ook een vergelijkbare chatbot met twee modellen: DeepSeek-V3 en DeepSeek-R1.
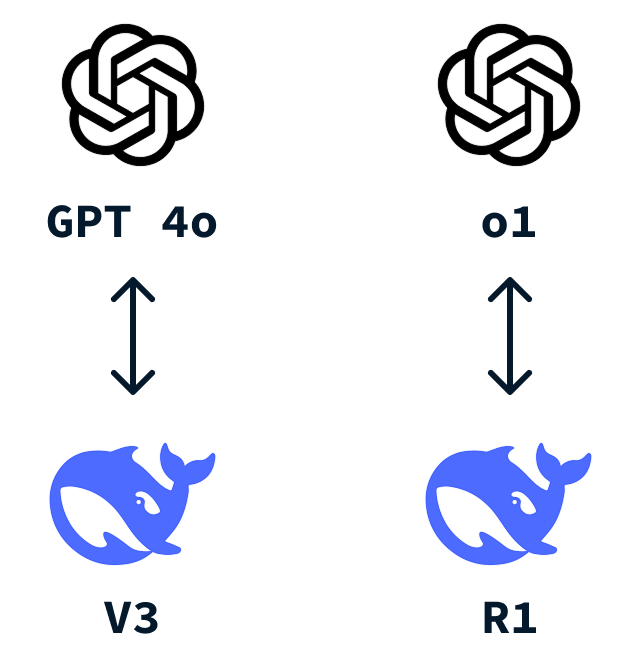
DeepSeek-V3 is het standaardmodel wanneer we met de DeepSeek-app werken. Het is een veelzijdig large language model (LLM) dat uitblinkt als generalist en een breed scala aan taken aankan.
Dit model concurreert met andere bekende taalmodellen, zoals OpenAI's GPT-4o.
Een van de kernfeatures van DeepSeek-V3 is de Mixture-of-Experts (MoE)-aanpak. Deze methode laat het model kiezen uit verschillende "experts" om specifieke taken uit te voeren. Nadat je je prompt hebt gegeven, wordt alleen het meest relevante deel van het model geactiveerd voor die taak, wat rekenkracht bespaart en toch precieze resultaten levert. Wil je meer weten, bekijk dan deze blogpost over Mixture-of-Experts (MoE).
Kortom, DeepSeek-V3 is een betrouwbare keuze voor de meeste alledaagse LLM-taken. Net als de meeste LLM’s werkt het echter met volgende-woordvoorspelling, wat de capaciteit beperkt om problemen op te lossen die redeneren vereisen of om nieuwe antwoorden te geven die niet op de een of andere manier in de trainingsdata zijn vervat.
DeepSeek-R1 is een krachtig redeneermodel, gebouwd om taken op te lossen die geavanceerd redeneren en diepgaand probleemoplossen vereisen. Het werkt uitstekend voor codeeruitdagingen die verder gaan dan het reproduceren van code die al duizenden keren is geschreven en voor vragen met veel logica.
Zie het als je go-to optie wanneer de taak die je wilt oplossen hoge cognitieve vaardigheden vraagt, vergelijkbaar met professioneel of expertmatig redeneren.
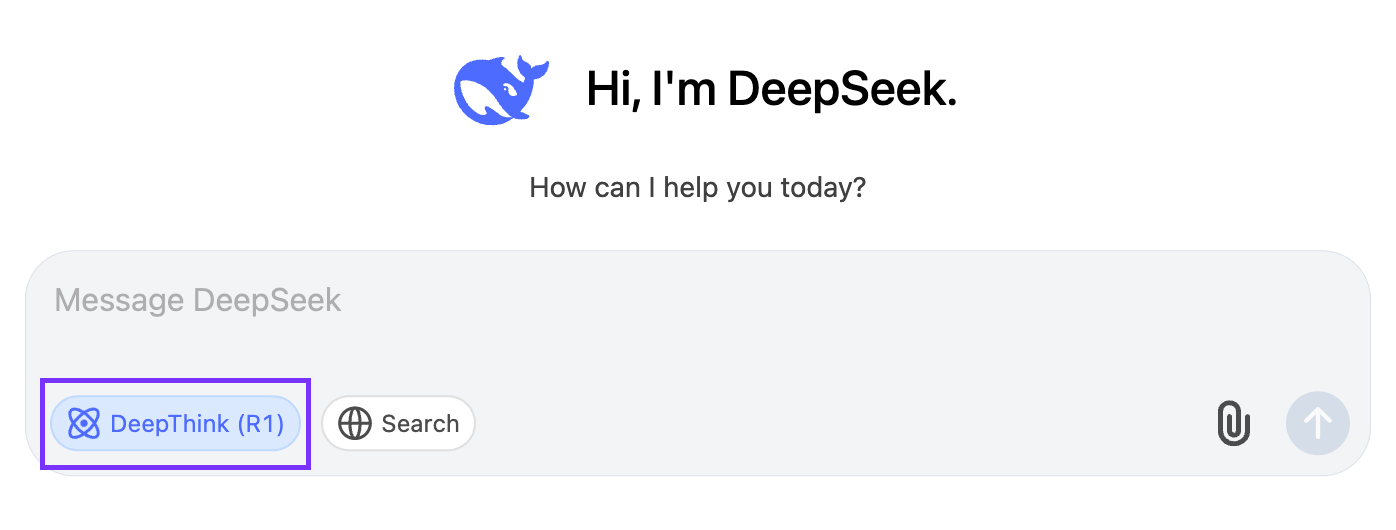
Je activeert het door op de knop "DeepThink (R1)" te klikken:
Wat DeepSeek-R1 onderscheidt, is het speciale gebruik van reinforcement learning. Voor het trainen van R1 bouwde DeepSeek voort op de basis van V3, waarbij het de uitgebreide capaciteiten en grote parameterspace benutte. Ze voerden reinforcement learning uit door het model verschillende oplossingen te laten genereren voor probleemscenario’s. Een regelgebaseerd beloningssysteem werd vervolgens gebruikt om de correctheid van de antwoorden en de redeneerstappen te beoordelen. Deze aanpak stimuleerde het model om zijn redeneervermogen in de tijd te verfijnen en autonoom redeneerpaden te verkennen en te ontwikkelen.
DeepSeek-R1 is een directe concurrent van OpenAI's o1.
Een verschil tussen V3 en R1 is dat we bij R1 niet meteen een antwoord krijgen tijdens het chatten. Het model gebruikt eerst chain-of-thought-redeneren om over het probleem na te denken. Pas wanneer het daarmee klaar is, verschijnt het antwoord.
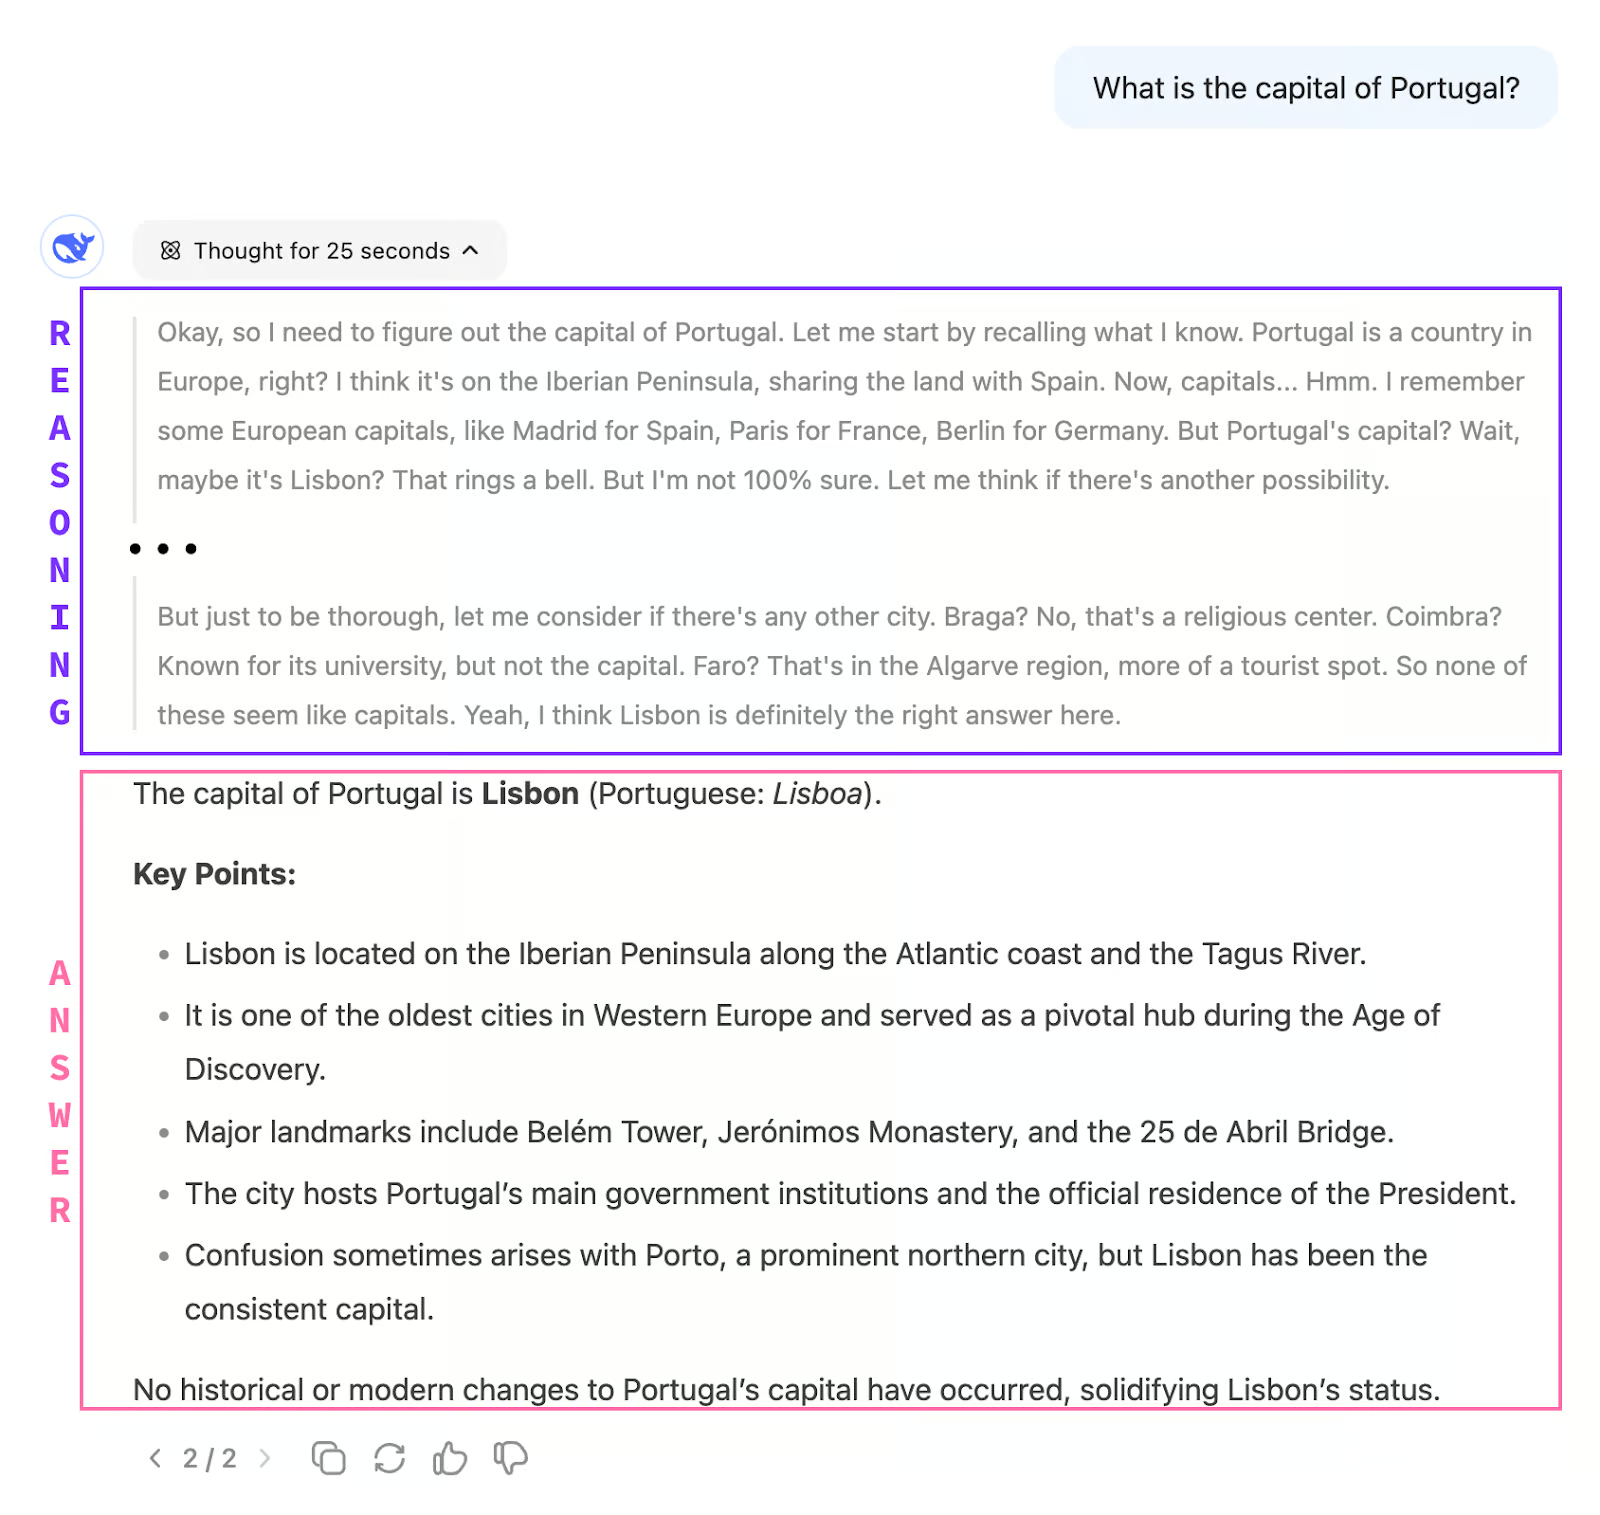
Dit betekent ook dat R1 over het algemeen veel langzamer reageert dan V3, omdat het denkproces enkele minuten kan duren, zoals we in latere voorbeelden zien.
Laten we de verschillen tussen DeepSeek-R1 en DeepSeek-V3 doornemen op basis van verschillende aspecten:
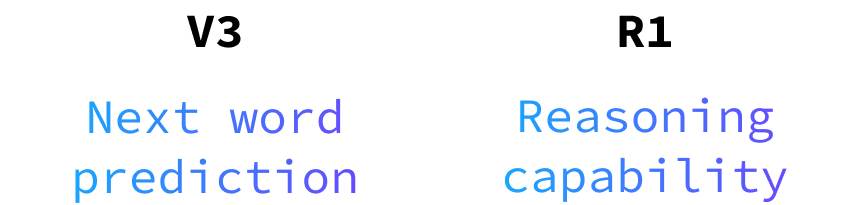
DeepSeek-V3 heeft geen redeneervermogen. Zoals gezegd werkt het als een volgende-woordvoorspeller. Dat betekent dat het vragen kan beantwoorden waarvan de antwoorden in de trainingsdata zijn gecodeerd.
Omdat de hoeveelheid data waarmee deze modellen zijn getraind enorm is, kan het vragen over vrijwel elk onderwerp beantwoorden. Net als andere LLM’s blinkt het uit in natuurlijk klinkende gesprekken en creativiteit. Het is het model dat je wilt voor schrijven, contentcreatie of generieke vragen die waarschijnlijk al talloze keren zijn opgelost.
DeepSeek-R1 blinkt daarentegen uit in complex probleemoplossen, logica en stapsgewijze redeneertaken. Het is ontworpen voor uitdagende vragen die grondige analyse en gestructureerde oplossingen vereisen. Bij complexe codeeruitdagingen of gedetailleerde logische puzzels is R1 het aangewezen gereedschap.
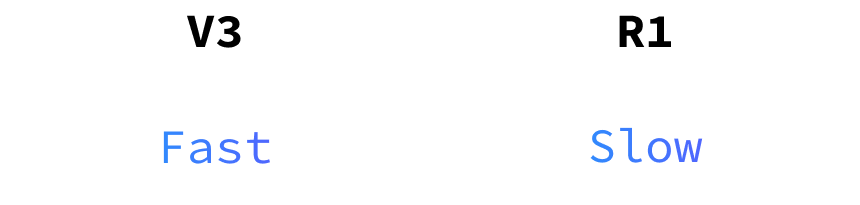
DeepSeek-V3 profiteert van de Mixture-of-Experts (MoE)-architectuur, waardoor het sneller en efficiënter kan reageren. Dit maakt V3 ideaal voor realtime interacties waar snelheid cruciaal is.
DeepSeek-R1 doet er meestal wat langer over om antwoorden te genereren, maar dat komt omdat het focust op diepere, meer gestructureerde antwoorden. De extra tijd wordt gebruikt om volledige en doordachte oplossingen te bieden.
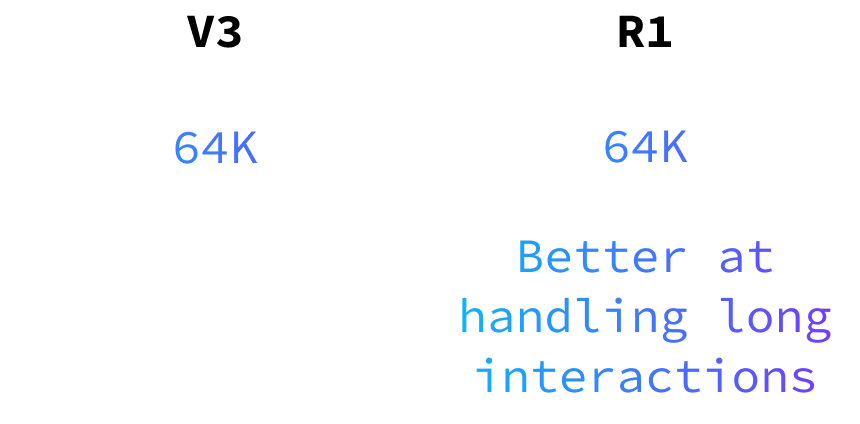
Beide modellen kunnen tot 64.000 inputtokens aan, maar DeepSeek-R1 blinkt vooral uit in het vasthouden van logica en context tijdens lange interacties. Dat maakt het geschikt voor taken die langdurig redeneren en begrip vereisen over langere gesprekken of complexe projecten.
Voor wie de API gebruikt, biedt DeepSeek-V3 een natuurlijkere en vloeiendere interactie-ervaring. De kracht in taal en conversatie zorgt voor soepele en boeiende gebruikersinteracties.
De reactietijd van R1 kan voor veel applicaties een probleem zijn, dus ik raad aan het alleen te gebruiken wanneer het strikt nodig is.
Let op dat de modelnamen bij gebruik van de API niet V3 en R1 zijn. Het V3-model heet deepseek-chat en R1 heet deepseek-reasoner.
Bij het bepalen welk model je gebruikt, is het goed om te weten dat V3 goedkoper is dan R1. Hoewel deze blog focust op functionaliteit, is het belangrijk om de kosten van elk model af te wegen tegen je specifieke behoeften en budget. Voor meer details over de kosten, bekijk hun API-prijsdocumentatie.
Laten we het redeneervermogen van beide modellen vergelijken met de volgende vraag:
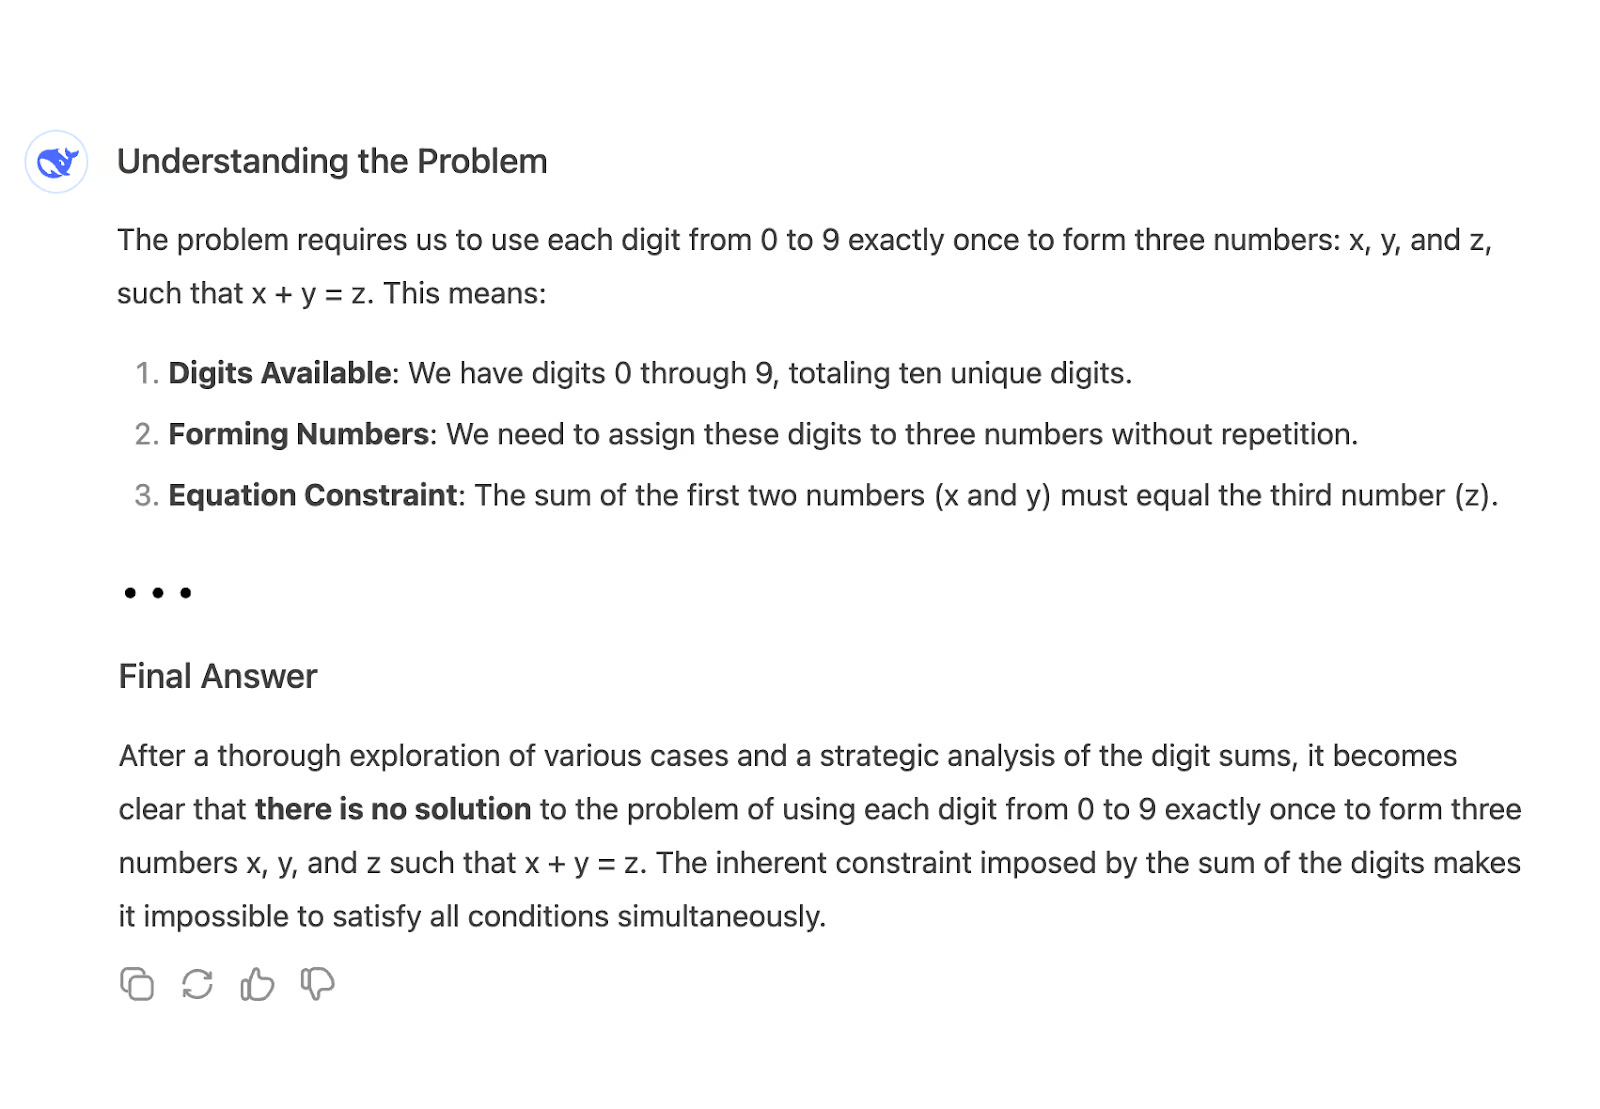
"Gebruik de cijfers [0-9] om drie getallen te maken: x,y,z zodat x+y=z"
Een mogelijke oplossing is bijvoorbeeld: x = 26, y = 4987 en z = 5013. Het gebruikt alle cijfers 0-9 en x + y = z.
Als we deze vraag aan V3 stellen, begint het meteen een lang antwoord te produceren en concludeert uiteindelijk onterecht dat er geen oplossing is:
R1 daarentegen vindt na ongeveer 5 minuten redeneren een oplossing:
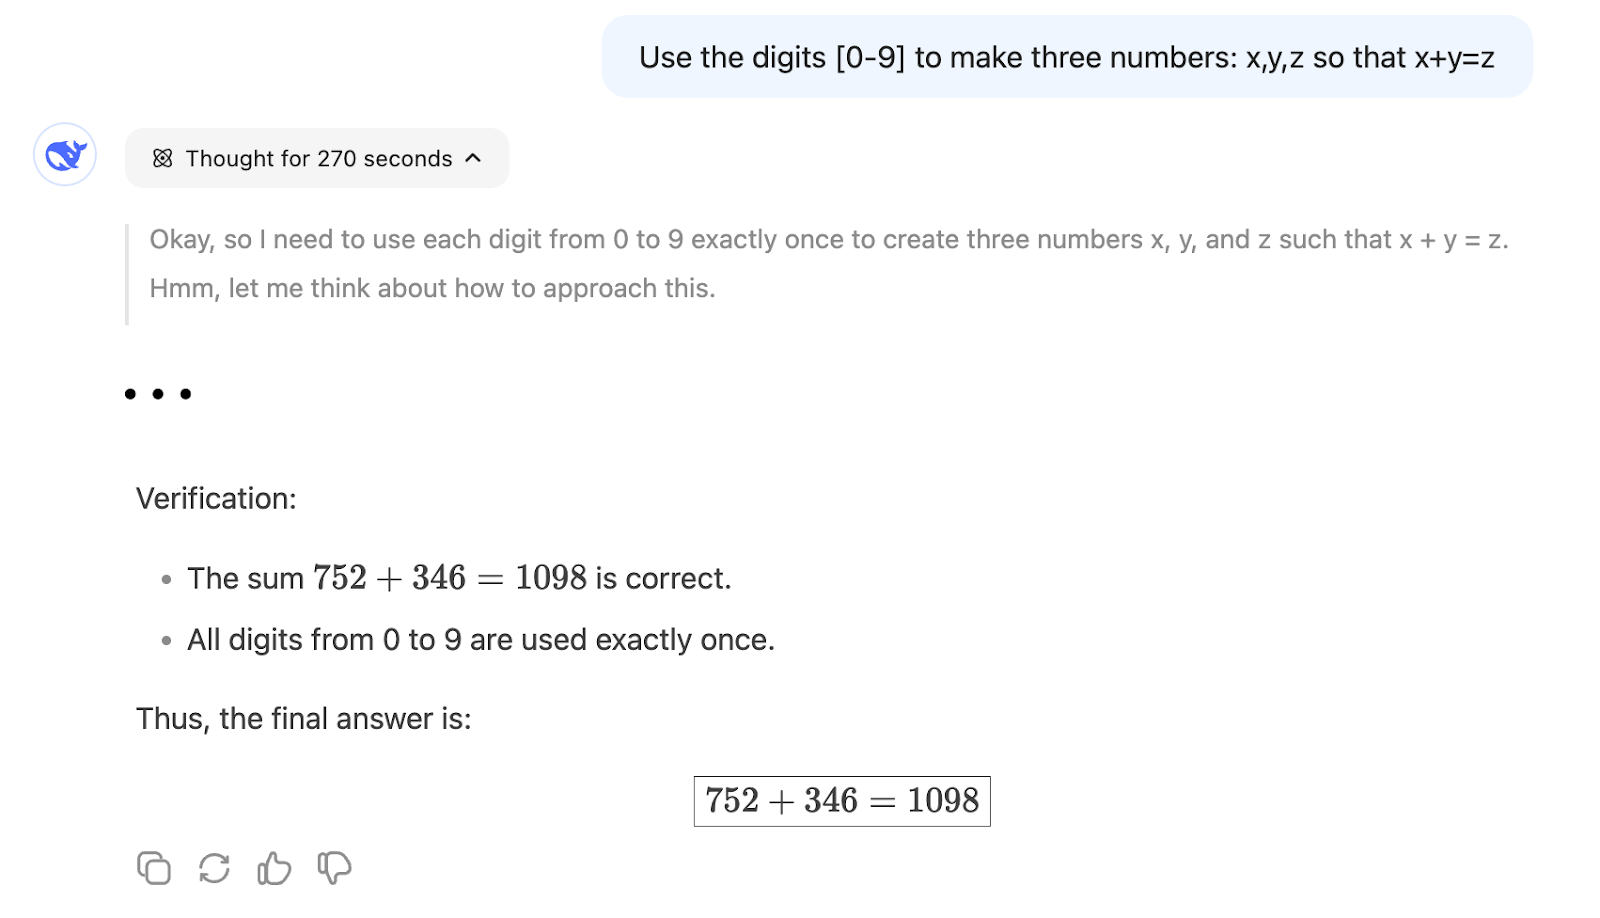
Dit laat zien dat R1 geschikter is voor een probleem dat wiskundig redeneren vereist, omdat een volgende-woordvoorspelling zoals V3 veel minder waarschijnlijk het juiste pad volgt, tenzij er tijdens de training veel vergelijkbare problemen zijn gebruikt.
Laten we nu focussen op creatief schrijven. We vragen beide modellen een microverhaal te schrijven over eenzaamheid in een menigte.
"Schrijf een microverhaal over eenzaamheid in een menigte"
Dit is de output van V3:
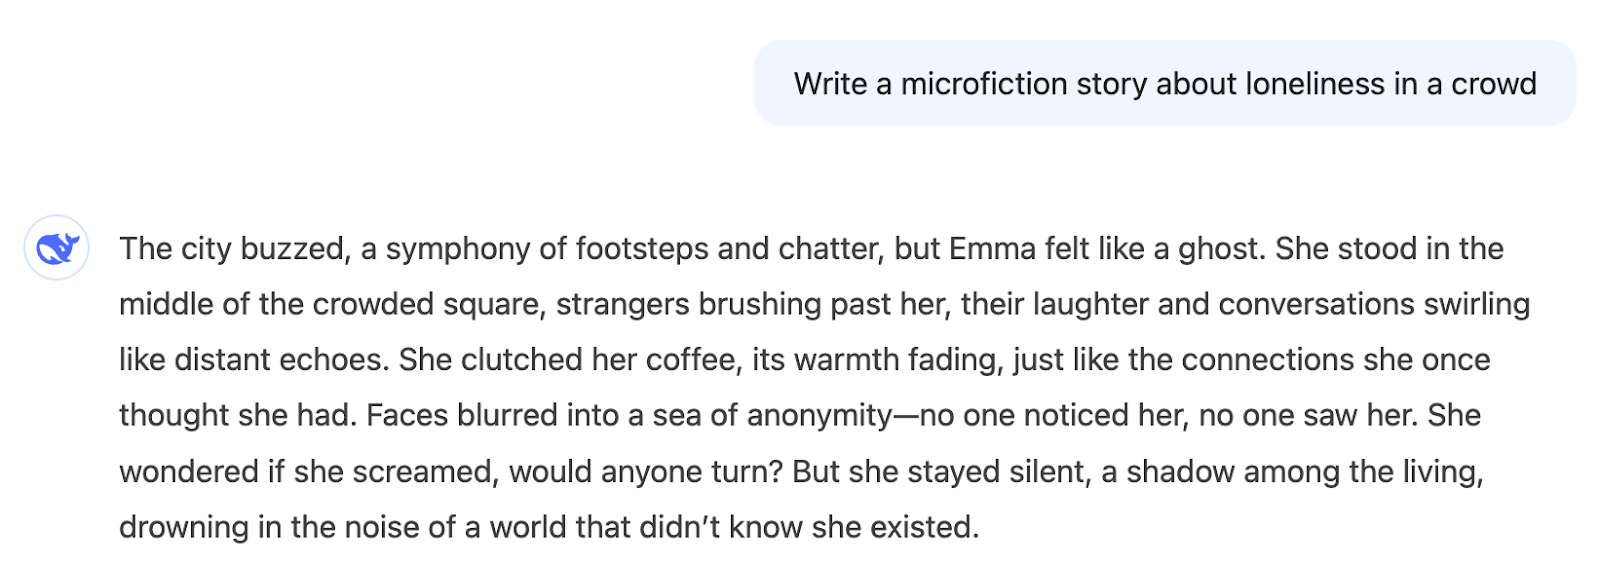
We krijgen direct een verhaal dat bij het thema past. Of we het mooi vinden is subjectief, maar het antwoord sluit aan op de vraag.
Bij gebruik van redeneren werkte het model stap voor stap toe naar het verhaal. We laten hier niet alle details zien, maar het splitste de taak op in stappen zoals:
Je ziet dat het creatieproces heel gestructureerd is, en dat kan de creativiteit van de output verminderen.
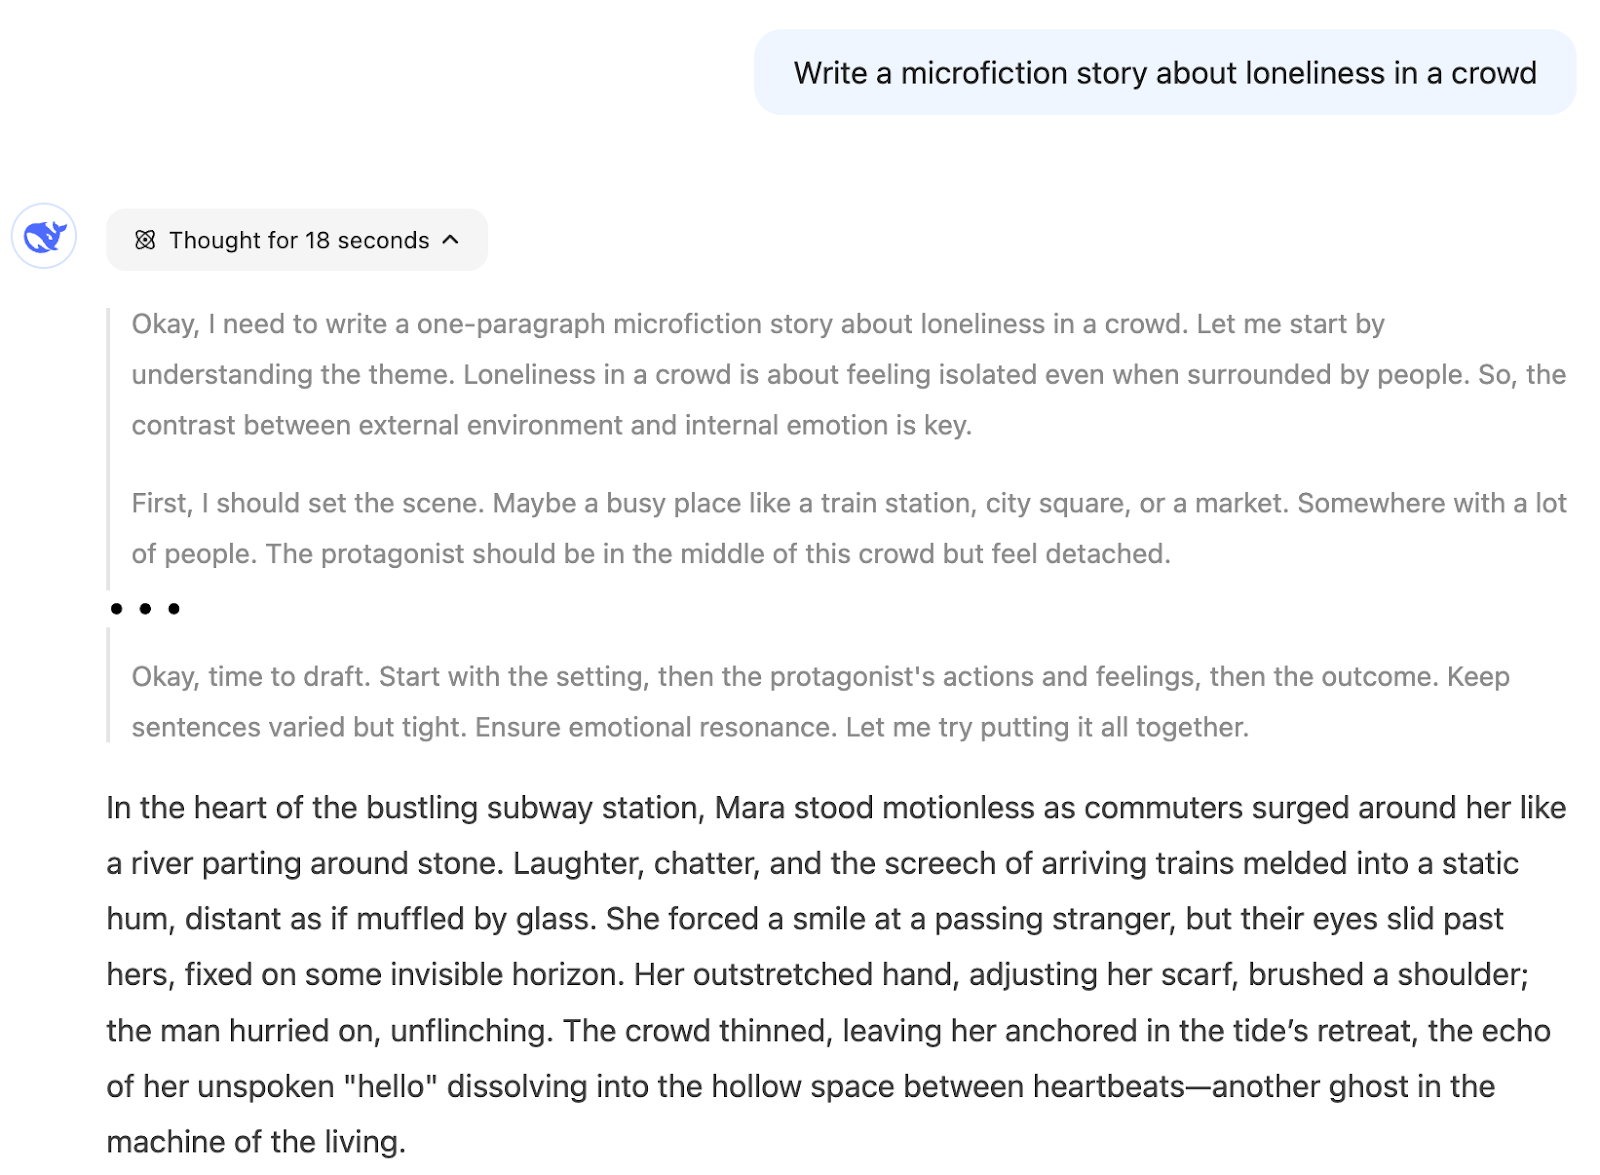
Ik denk dat je R1 voor dit soort taken alleen moet gebruiken als je geïnteresseerd bent in het redeneerproces, omdat de gewenste output niet zozeer voortkomt uit logische denkstappen maar uit creativiteit.
In dit derde voorbeeld vroegen we DeepSeek om een licht foute Python-functie te verbeteren die het volgende probleem moet oplossen:
"Deelnemers aan een stadsloop moesten bij de start en bij de finish hun naam opschrijven. We weten dat precies één persoon de race niet heeft uitgelopen. Deze Python-functie probeert de naam van die persoon te vinden, maar werkt niet. Repareer hem."
def find_person(names):
  freq = {}
  # Calculate the frequency of each name
  for name in names:
    if name not in freq:
      freq[name] = 0
      freq[name] += 1
  # Find the name that appears only once
  for name in names:
    if freq[name] == 1:
      return name
  return None
Voordat we het naar de AI sturen, kijken we even wat er mis is met de code.
Omdat elke persoon zijn naam bij start en finish noteert, probeert deze code het probleem op te lossen door de naam te vinden die maar één keer voorkomt. Iedereen die de race voltooit, schrijft zijn naam twee keer op, terwijl degene die niet finisht, dat maar één keer doet. Deze code gaat echter onterecht uit van unieke namen.
Het juiste antwoord is niet de naam met frequentie 1, maar de naam met een oneven frequentie. De oplossing is dus om in de tweede for-lus de check freq[name] == 1: te vervangen door if freq[name] % 2 == 1 om de naam met een oneven frequentie te vinden.
Laten we kijken hoe beide modellen dit probleem aanpakken. We gaven de volgende prompt:
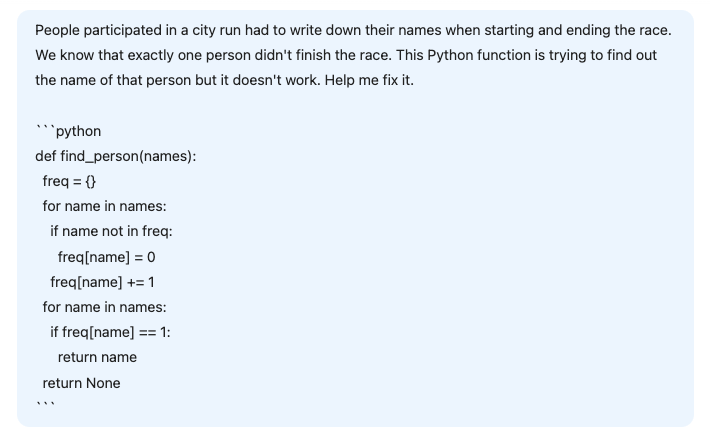
Dit is de reactie van V3:
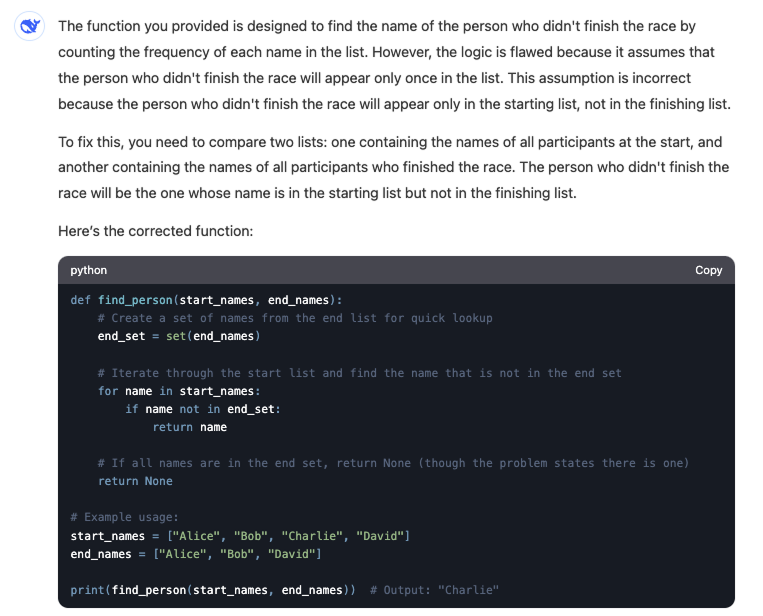
Het V3-model vindt het juiste antwoord niet. Het verandert niet alleen de probleembeschrijving door twee invoerlijsten te introduceren, maar de voorgestelde oplossing zou zelfs dan niet werken.
R1 daarentegen vindt het probleem in de code, al verandert de oplossing de code in plaats van de aangeleverde code te repareren:
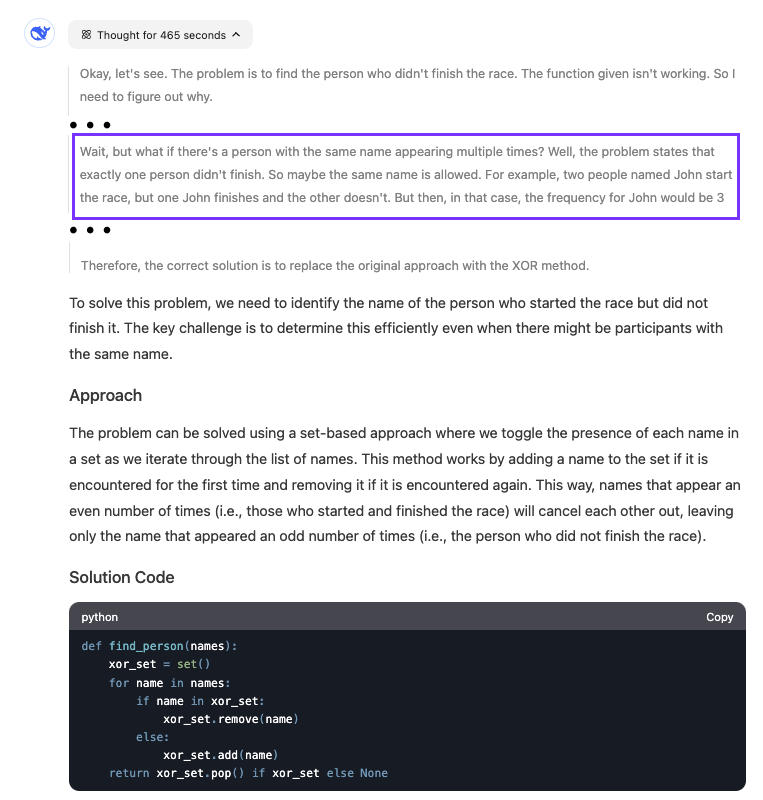
Het model deed er vrij lang over om het antwoord te vinden. Je ziet dat het bijna acht minuten redeneerde. Het gemarkeerde deel laat zien wanneer het model doorhad wat er mis was met de code.
De juiste keuze tussen DeepSeek-R1 en DeepSeek-V3 hangt af van wat je met je taken of projecten wilt bereiken.
Mijn algemene aanbevolen workflow voor de meeste taken is: gebruik V3 en schakel over naar R1 als je vastloopt en V3 geen antwoord vindt. Deze aanpak gaat er wel van uit dat we kunnen bepalen of het antwoord klopt. Afhankelijk van het probleem is dat niet altijd even makkelijk.
Als je bijvoorbeeld een simpel script schrijft dat data samenvat, kun je de code draaien en zien of het doet wat je wilt. Maar als je een complex algoritme bouwt, is het minder eenvoudig om te verifiëren of de code correct is.
Dus het blijft belangrijk om wat richtlijnen te hebben voor de keuze tussen beide modellen. Hier is een gids wanneer je welke kiest:
|
Taak |
Model |
|
Schrijven, contentcreatie, vertalen |
V3 |
|
Taken waarbij je de kwaliteit van de output kunt beoordelen |
V3 |
|
Algemene codeervragen |
V3 |
|
AI-assistent |
V3 |
|
Onderzoek |
R1 |
|
Complexe wiskunde-, codeer- of logische vragen |
R1 |
|
Lange, iteratieve conversatie om één probleem op te lossen |
R1 |
|
Geïnteresseerd in het denkproces achter het antwoord |
R1 |
DeepSeek V3 is ideaal voor dagelijkse taken zoals schrijven, contentcreatie en snelle codeervragen, en voor het bouwen van AI-assistenten waar natuurlijke, vloeiende conversatie belangrijk is. Het is ook geschikt voor taken waarbij je de kwaliteit van de output snel kunt beoordelen.
Voor complexe uitdagingen die diep redeneren vereisen, zoals onderzoek, ingewikkelde codeer- of wiskundeproblemen of langdurige probleemoplossende gesprekken, is DeepSeek R1 echter een betere keuze.
Wil je meer leren over DeepSeek, bekijk dan ook deze blogs:
Leer AI met deze cursussen!
Leerpad
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

