

什么是 Claude 3.7 Sonnet?
Claude 3.7 Sonnet 是 Anthropic 最新的 AI 模型,在推理、编码及真实世界问题求解方面迈出重要一步。最大的变化是新增思考模式,允许我们看到模型的逐步推理过程。它是如何工作的?我们来看看:
推理模型的重要性与普及度正在上升,原因也不难理解。下图显示,根据Anthropic Economic Index,有 37.2% 的用户依赖 Claude 处理编码与数学问题。这说明一件事——强大的推理模型可以带来实际的业务价值,尤其是在企业对 AI 的采用度仍然不高的当下。
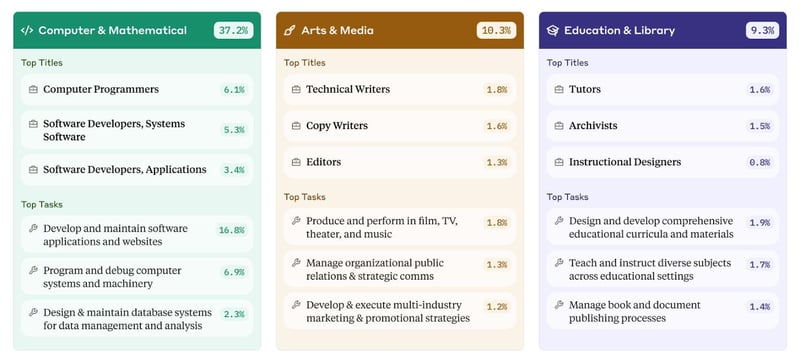
同时,Claude 3.7 不仅是推理模型——它是混合型。我们可以在思考模式(用于结构化推理任务)与标准聊天模式(用于日常对话、写作与总结)之间切换。
Claude 3.7 Sonnet 与 Claude 3.5 Sonnet 对比
Claude 3.7 Sonnet 的升级幅度远超版本号所暗示的。基准数据表明,它在推理、编码和真实任务执行上全面优于 Claude 3.5 Sonnet。
软件工程表现
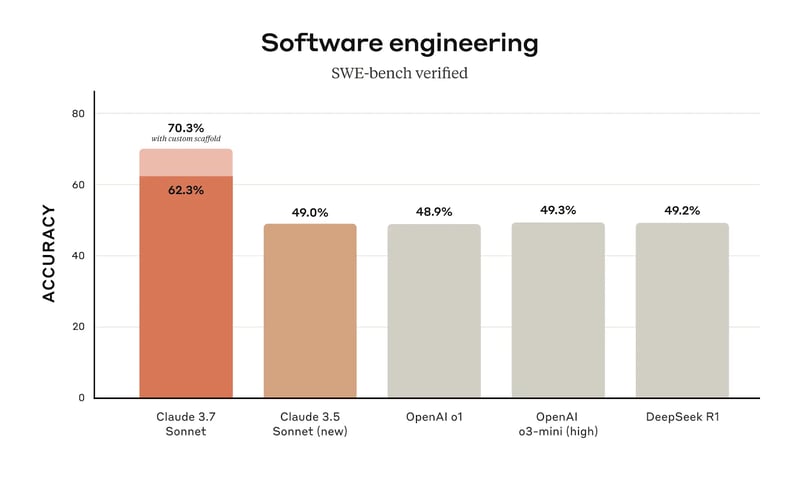
在 SWE-bench Verified 中,Claude 3.7 Sonnet 的准确率达到 62.3%,相较 Claude 3.5 Sonnet 的 49.0% 有显著提升。使用自定义脚手架(即通过结构化提示或额外上下文引导模型生成更准确的解答)后,准确率进一步提升至 70.3%,成为该类别表现最好的模型。
来源:Anthropic
两个版本间近 13% 的准确率提升绝非微调优化那么简单。这表明 Claude 3.7 Sonnet 在理解与执行编程相关任务上做了深入打磨。对于依赖 Claude 进行软件工程、调试或自动化的用户而言,这次升级能带来实实在在的改善。
代理式工具使用
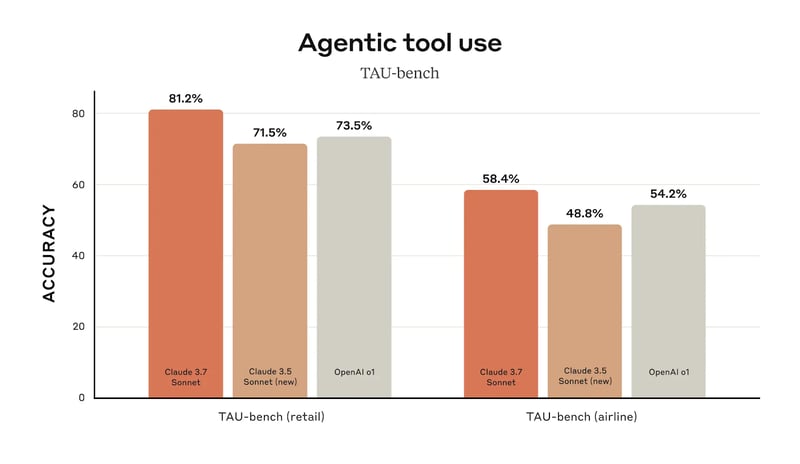
在代理式工具使用方面,Claude 3.7 Sonnet 同样超越前代。在零售相关任务中,它达成 81.2% 的准确率,高于 Claude 3.5 Sonnet 的 71.5%。在航空相关任务中,它取得 58.4%,比前代版本提升近 10 个百分点。
来源:Anthropic
总体基准
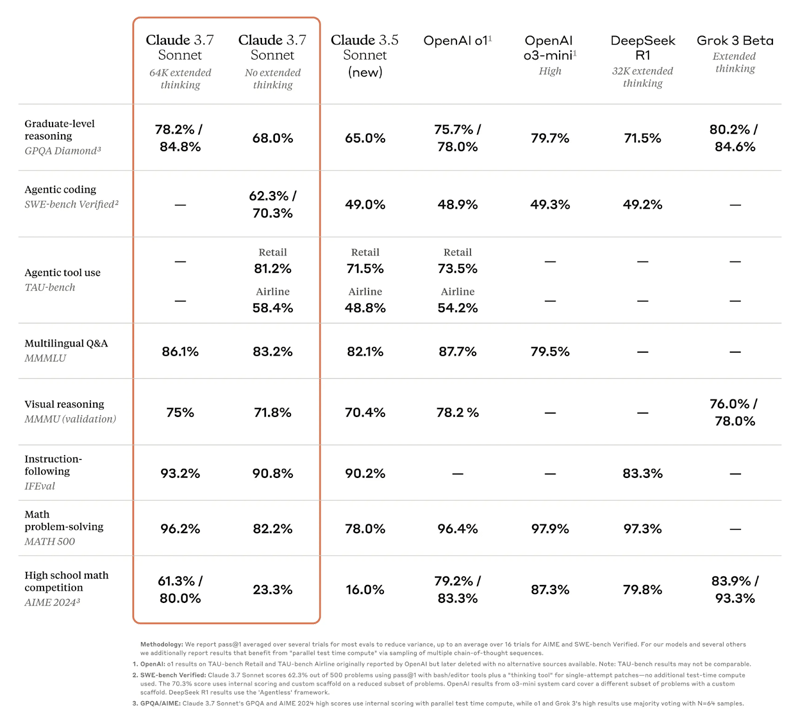
在各项基准中,提升最大的来自扩展思考模式,使 Claude 3.7 能在复杂推理任务中大幅提升表现。依赖 AI 完成结构化流程、编码或问题求解的用户,尤其在启用扩展思考时,会清晰感受到 Claude 3.5 与 3.7 的差异。
来源:Anthropic
这些进步大多来自 Claude 的扩展思考功能,下面我们来进一步了解。
Claude 的扩展思考
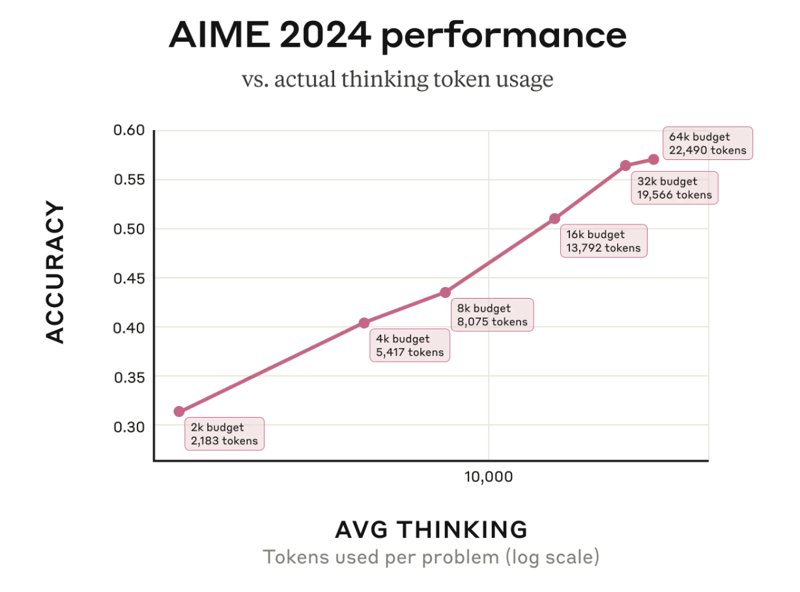
启用后,扩展思考模式会增加 Claude 在给出最终答案前的推理步数。开发者可以通过设置“思考预算”来细化该过程,即限定模型在求解问题时可使用的 token 数量。如下方 AIME 2024 表现实验所示,分配的 token 越多,准确率越高,且呈对数增长趋势。
来源:Anthropic
这一方法类似人类的认知投入:简单任务快速作答即可,但复杂任务需要更深入的分析才能获得更好的结果。Claude 现可自行决定何时暂停、复盘并优化推理,而非默认立刻作答。
扩展思考模式最有趣的一点在于,Claude 的推理过程对用户可见。但这也带来一些挑战。虽然它提供了对 AI 推理的洞察,但展示的思考过程未必与模型实际的决策机制完全一致。“忠实性问题”——即 AI 自述的思考是否准确反映其内部机理——仍是一个未解的研究问题。
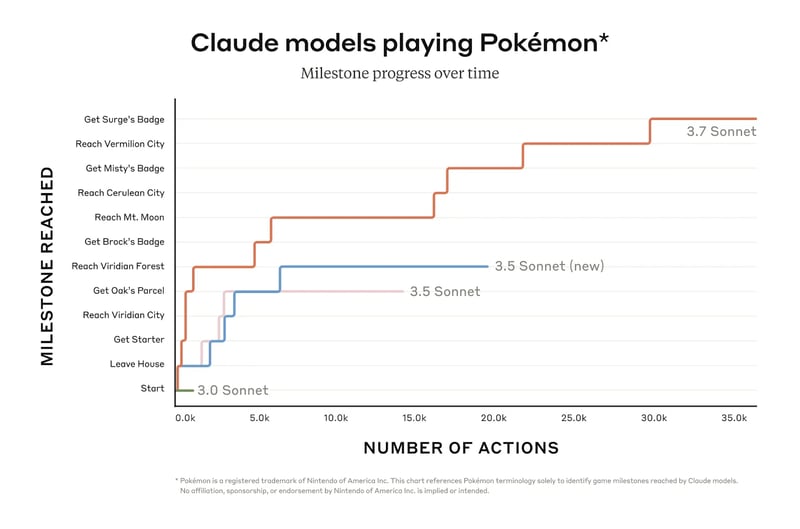
Claude 3.7 Sonnet 在长期、迭代式推理方面的能力已通过 OSWorld 与《精灵宝可梦 红》游戏等评测验证。以《精灵宝可梦 红》为例,Claude 3.7 Sonnet 的游戏推进明显优于前代,能够达成多个里程碑,而早期模型则在前期就会卡关。
来源:Anthropic
Claude 3.7 Sonnet 基准测试
我们已经看到 Claude 3.7 Sonnet 相较前代的表现,那么与 OpenAI 的 o3-mini、DeepSeek-R1 或 Grok 3 相比如何?
从最新的基准结果看,Claude 3.7 Sonnet 将自己定位为顶尖模型之一,尤其在重推理任务、编码及代理式工具使用方面表现出色。
推理与数学
在研究生级别推理(GPQA Diamond)中,Claude 3.7 Sonnet 在标准模式下得分 68.0%,在扩展思考模式下得分 84.8%,成为该类别最强模型之一。它显著超越 OpenAI 的 o1(78.0%)与 DeepSeek-R1(71.5%),与 Grok 3 Beta(84.6%)仅有微弱差距。
|
基准 |
Claude 3.7 Sonnet(标准) |
Claude 3.7 Sonnet(扩展思考) |
OpenAI o1 |
OpenAI o3-mini(高) |
DeepSeek R1 |
Grok 3 Beta |
|
GPQA Diamond(研究生级推理) |
68.0% |
84.8% |
78.0% |
79.7% |
71.5% |
84.6% |
|
AIME 2024(高中数学竞赛) |
23.3% |
80.0% |
83.3% |
87.3% |
79.8% |
93.3% |
|
数学问题求解(MATH 500) |
82.2% |
96.2% |
96.4% |
97.9% |
97.3% |
- |
AIME 2024 基准(测试高中数学竞赛题)也呈现类似趋势。启用扩展思考后,Claude 3.7 Sonnet 从前代大幅跃升至 80.0%。尽管它以微弱优势领先 DeepSeek-R1(79.8%),但仍落后于 OpenAI 的 o3-mini(87.3%)与 Grok 3 Beta(93.3%)。
在数学问题求解(MATH 500)中,Claude 3.7 Sonnet 取得 96.2%,与 OpenAI 的 o3-mini(97.9%)和 DeepSeek R1(97.3%)非常接近。
编码与代理式工具使用
Claude 3.7 Sonnet 在编码基准上的提升最大。在 SWE-bench Verified(评估 AI 处理软件工程任务的能力)上,Claude 3.7 Sonnet 得分 62.3%,在自定义脚手架下提升至 70.3%。这使其明显领先 OpenAI 的 o1(48.9%)与 o3-mini(49.3%),以及以编码为目标训练的 DeepSeek R1(49.2%)。这也印证了 Claude 3.7 现已成为编程相关任务的最佳 AI 模型之一。
|
基准 |
Claude 3.7 Sonnet(标准) |
Claude 3.7 Sonnet(自定义脚手架) |
OpenAI o1 |
OpenAI o3-mini(高) |
DeepSeek R1 |
|
SWE-bench Verified(编码) |
62.3% |
70.3% |
48.9% |
49.3% |
49.2% |
|
TAU-bench 零售(工具使用) |
81.2% |
- |
73.5% |
- |
- |
|
TAU-bench 航空(工具使用) |
58.4% |
- |
54.2% |
- |
- |
除编码之外,Claude 3.7 Sonnet 在代理式工具使用方面同样领先,是自动化与工作流执行的有力之选。在 TAU-bench(测试 AI 在结构化环境中与外部工具交互的能力)上,Claude 3.7 在零售相关任务中得分 81.2%,超过 OpenAI o1(73.5%)。在航空相关任务中,Claude 3.7 取得 58.4%,同样领先于 OpenAI o1(54.2%)。
这表明 Claude 3.7 非常适合商业应用与结构化工作流,对于希望将 AI 融入决策与运营流程的企业用户来说,是一个强有力的选择。
如何访问 Claude 3.7 Sonnet
Claude 3.7 Sonnet 可通过多种渠道使用,包括 Anthropic 的网页端、集成于各类应用中的 Claude,以及供开发者使用的 API。尽管模型升级幅度明显,但在可用性上仍有一些限制——尤其是思考模式目前被付费档位锁定。
网页与应用端
对普通用户而言,可通过 Anthropic 官方网站(claude.ai)与 Claude 应用访问。免费档可用,但有以下限制:
- 免费用户可在写作、总结与常规问答等基础任务中使用 Claude 3.7 Sonnet,但思考模式不可用。
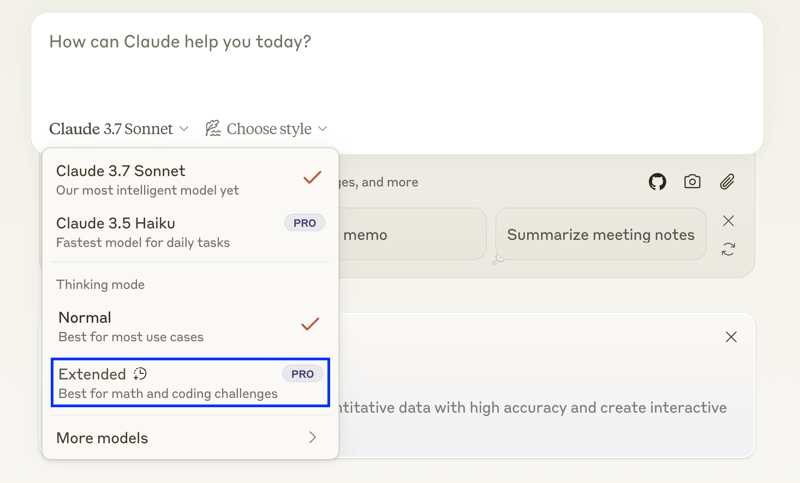
- Claude Pro 用户(每月 20 美元的付费计划)可完整使用思考模式,并享有更高消息限额及高峰期优先通道。
要启用思考模式,您需要在模型下拉菜单中点击Extended:
Claude 3.7 Sonnet API 访问
开发者可通过 Anthropic 的 API 将 Claude 3.7 Sonnet 集成到应用中,API 可在Anthropic 开发者门户获取。计费采用按量付费,基于 token 使用量。
以下是 Anthropic API 的概览:
|
功能 |
Claude 3.7 Sonnet |
Claude 3.5 Sonnet |
Claude 3.5 Haiku |
Claude 3 Opus |
Claude 3 Haiku |
|
描述 |
我们最智能的模型 |
我们此前最智能的模型 |
我们最快的模型 |
适用于复杂任务的强大模型 |
最快且最紧凑,几乎即时响应 |
|
优势 |
最高级别的智能与能力,并可切换扩展思考 |
高水平的智能与能力 |
以极快速度提供智能 |
顶级的智能、流畅度与理解力 |
快速且准确的定向表现 |
|
多语种 |
是 |
是 |
是 |
是 |
是 |
|
视觉 |
是 |
是 |
是 |
是 |
是 |
|
是 |
否 |
否 |
否 |
否 | |
|
API 模型名称 |
claude-3-7-sonnet-20250219 |
升级版本:claude-3-5-sonnet-20241022 先前版本:claude-3-5-sonnet-20240620 |
claude-3-5-haiku-20241022 |
claude-3-opus-20240229 |
claude-3-haiku-20240307 |
|
相对延迟 |
快 |
快 |
最快 |
中等偏快 |
最快 |
|
上下文窗口 |
200K |
200K |
200K |
200K |
200K |
|
最大输出 |
常规:8192 tokens 扩展思考:64000 tokens |
8192 tokens |
8192 tokens |
4096 tokens |
4096 tokens |
|
费用(每百万 Token 的输入/输出) |
$3.00 / $15.00 |
$3.00 / $15.00 |
$0.80 / $4.00 |
$15.00 / $75.00 |
$0.25 / $1.25 |
|
训练数据截止 |
Oct 2024 |
Apr 2024 |
July 2024 |
Aug 2023 |
Aug 2023 |
来源: Anthropic
请务必随时查看最新的 API 定价。
结论
Anthropic 以 Claude 3.7 Sonnet 迈出了近来最大的一步,这一模型终于将其带入推理型 AI 领域。基于基准测试,我们可以看到它是 OpenAI 的 o3-mini、DeepSeek-R1 与 Grok 3 的有力竞争者,在编码、结构化问题求解与代理式工具使用方面表现强劲。
可在通用与推理模式之间切换使其更具通用性,但将思考模式置于付费墙后或许并非明智之举,尤其当有免费的替代品可用时。总体而言,Claude 3.7 是一次重要的前进。
准备好迈出下一步了吗?欢迎观看我们的Claude 3.7 Sonnet API 视频,我们将展示如何构建您自己的多模态研究助手。

我是一名编辑和撰稿人,专注于 AI 博客、教程与新闻,确保内容契合成熟的内容策略并遵循 SEO 最佳实践。我编写过关于 Python、统计学、概率和数据可视化的数据科学课程。我的长篇小说曾获奖,业余时间从事影视剧本创作和电影导演。

作者
Josef Waples
我是数据科学编辑,曾为科学期刊发表的研究论文撰稿。我的兴趣领域包括线性代数、统计学、R 等相关主题。
常见问题
什么是 Claude Code?它与 Claude 3.7 Sonnet 有何不同?
Claude Code 是一个单独的、针对软件开发优化的模型,不同于 Claude 3.7 Sonnet。虽然 Claude 3.7 是一款具备强大编码能力的通用 LLM,但 Claude Code 专门为编程任务、调试与代理式工具使用进行了微调。
相较以往型号,Claude 3.7 Sonnet 如何处理更长的上下文?
Claude 3.7 Sonnet 仍然保留 200K token 的上下文窗口,但扩展思考让它在长文档上的推理更有效。尽管其他模型(如 Gemini 2.0)宣称具备更长的上下文能力,Anthropic 更强调 结构化推理而非单纯的记忆长度。
Claude 3.7 Sonnet 是否支持多模态输入?
是的,Claude 3.7 Sonnet 具备 多模态能力,可以处理并分析图像。
Claude 3.7 Sonnet 在安全性方面有哪些改进?
Anthropic 扩展了 对齐压力测试并完善了 宪法式 AI 原则,以更好地防范 偏见、错误信息与滥用。不过, 越狱尝试仍值得关注,因为可见思考模式可能暴露潜在漏洞。
是否有 Claude 移动端应用?
是的,您可以在 iOS 与 Android 上使用 Claude。
Anthropic 刚刚发布了他们近期最大的一次更新——Claude 3.7 Sonnet。尽管版本号看起来像是小幅升级,但我们认为这相较于Claude 3.5 Sonnet是一次重要升级。
首先,Claude 3.7 Sonnet 引入了“思考模式”(Thinking Mode),让我们可以看到模型的思考过程。这意味着 Anthropic 正式进入推理模型赛道;从基准测试看,它与OpenAI 的 o3-mini、DeepSeek-R1 和 Grok 3不相上下。
其次,Claude 3.7 Sonnet 可一键在推理模式与通用模式之间切换(后文会详细说明)。虽然 Anthropic 称其有“不同的理念”,但这一变化反映了聊天式 LLM 用户体验正在趋同。Grok 3 已采用类似方式,Sam Altman 也表示 ChatGPT 将走向相同方向。
让人失望的是,思考模式被付费墙锁住。鉴于推理模型已越来越普及,当 Grok、DeepSeek、Qwen 甚至 ChatGPT 都能以免费(尽管有时有限)的形式访问时,这一决策就显得难以让人信服。
下面我们来梳理 Claude 3.7 Sonnet 的要点——也别错过我们关于 Claude 3.7 Sonnet 的视频解读: