我分析了数百个 GitHub 仓库,试图理解为什么 AI 编码代理在软件工程中往往显得更有能力,而在数据科学工作中则不然。我的发现表明,这不只是工具差距的问题,而是反映了两类代码在“意义”所寄居的地方存在更深层次的差异。
本文关注什么
如果您曾在软件工程的代码库中使用过 AI 编码代理,您很可能见识过它的高效。代理能够在架构中穿梭、遵循抽象,并做出与整个系统惊人契合的修改。
但当您打开一个数据科学笔记本时,体验往往就变了。
代理依然能写出有效代码,也能遵循指令。但它常常无法完全理解关键之处:为什么是这个数据集、为什么用这个筛选、为什么是这个时间窗口、为什么这个输出改变了分析的方向。
它把笔记本当作一个软件项目来处理,而这只是它的一部分属性。
我想弄清原因,因此对数据科学与软件工程领域的数百个 GitHub 仓库进行了分析,测量了熵、引用模式和耦合行为。
结果让我颇为意外,我认为这对任何构建或使用 AI 代理开展分析工作的人都具有现实意义。
熵的反转:数据科学代码并非表面看起来那样
我实际测量了什么
我在三个抽象层级上对每个仓库测量了香农熵:字符层、词元层和 AST(抽象语法树)层。每个层级捕捉代码变异性的不同维度。
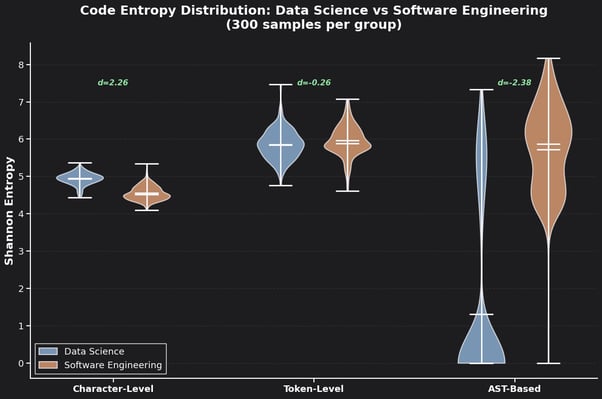
代码熵分布:数据科学 vs 软件工程 小提琴图
呈现出的模式可称为“熵的反转”。
表面看起来更复杂,结构却往往不是
在字符层,数据科学代码往往比软件工程代码具有更高的熵。这合乎直觉。数据科学工作充斥着多样的列名、数据集标签、临时变量以及领域特定的标识符,使得代码看起来嘈杂而不规则。
在词元层,两者差距要小得多。它们依赖许多相同的语法构件。
但在关注结构多样性的 AST 层,画风却反转了。
软件工程代码往往在结构上编码了更多变化。它通过抽象、接口、模块和内部逻辑,创造出更多彼此区分的行为。
相比之下,数据科学代码常常是在变化的上下文中复用较小的一组操作:加载、筛选、分组、聚合、可视化、检视、调整。
简言之,数据科学代码的表层往往更显复杂,而软件工程代码的复杂性更多地承载在结构之中。
这并非纯粹的风格差异,而是指向两类工作如何存储“意义”的更深层差别。
指示性 vs 符号性:意义安在何处
两种不同的代码
当您思考每种代码实际在做什么时,“熵的反转”就更容易理解了。
在软件工程中,意义常被压缩进结构里。函数、接口、模块、类型和类边界承担了大量工作。一旦这些抽象建立起来,它们会稳定行为并降低未来的不确定性。
许多意义蕴含在代码自身之中。
在数据科学中,意义则更紧密地系于外部语境。它依赖于数据集、列、阶段性输出、某个变换背后的假设,以及分析者试图回答的不断演化的问题。代码不仅是在表达逻辑,它是在指向一个特定的分析情境。
这一差异是理解为什么代理在两大领域表现迥异的最有用方式之一。
从代码“指向”的对象可见端倪
我还测量了两组代码中每 100 行的外部与内部引用密度。
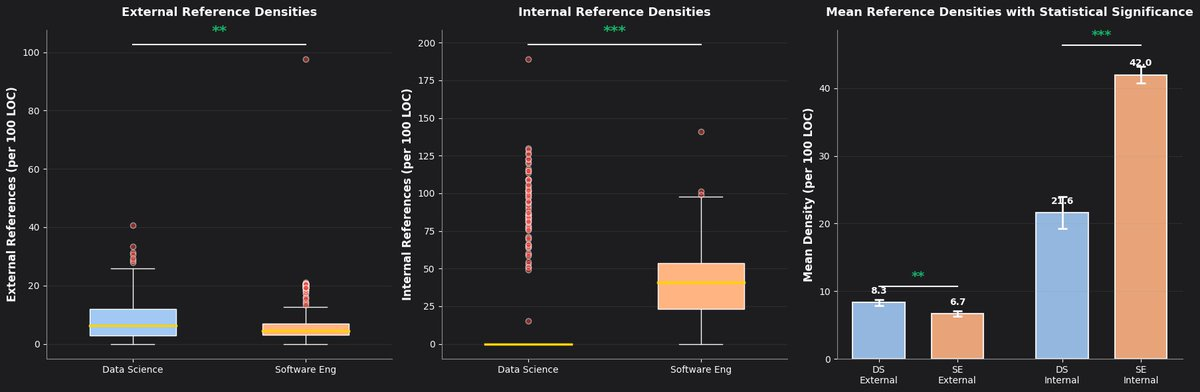
外部与内部引用密度及统计显著性
差异非常清楚。数据科学代码更频繁地向外部指涉:数据集、表、列、临时对象以及存在于代码之外的状态。
软件工程代码则更倾向于内部自我指涉。它更常通过指向代码库中其他地方定义的函数、类、模块和抽象来构建意义。
数据代码向外指,软件代码向内指。
这对代理很重要。在一种情况下,大部分相关上下文在代码库内部;在另一种情况下,大部分上下文存在于周边的分析状态中。
这为何让抽象表现不同
笔记本中的耦合问题
一个颇有意思的发现与耦合相关。与软件工程代码库相比,笔记本式工作流在每 100 行代码中的耦合明显更紧。
这并不一定是糟糕的设计。它反映了探索性分析的根本特点:问题本身常在变化中。您在检验假设、追踪异常结果、核查边界情况,并在学习中不断调整方向。
在这种情境下,抽象往往无法像在软件工程中那样带来同等收益。过早的结构化可能在您尚未弄清关键点之前就降低了选择空间。更紧的耦合往往是探索的结果,而不只是糟糕工程实践的产物。
注释与状态的作用
两大领域在“如何自我解释”方面也存在重要差异。
在软件工程中,代码常通过结构自我解释。类型、接口和抽象承载了大量意义,注释通常是次要的。
在数据科学中,注释、输出和状态往往承载着部分意义。诸如“移除了高于第 99 百分位的离群点,确认这不影响主队列”这样的备注,并不只是额外文档。
它记录了一项仅凭代码可能无法还原的分析决策。笔记本中途的一张表或一幅图,可能就解释了下一段分析存在的理由。
这对代理同样重要。忽略注释、行内结果和不断演化的状态,就会错过分析的一部分。在软件工程代码库中,这些信息往往是补充性的;在数据科学工作中,却常常不是。
这对 AI 代理意味着什么
默认情况下,代理与其中一个领域更“匹配”
实际含义是:当工具与“意义”的栖身之处相匹配时,代理的效果最佳。
在软件工程中,高效的代理会在架构中导航,沿着调用图前进,遵循接口,并在整个代码库中保持改动一致。这奏效是因为大量意义已被编码进结构。
在数据科学中,高效的代理需要做的不止是浏览代码。它需要理解数据实际包含什么,在各步骤间跟踪状态,追溯变量的来源,并能推理为何在几步之前应用了某个变换或筛选。
为软件工程打造的代理并不会自然而然地迁移到数据科学工作中。问题不只是语法,而是底层的信息结构不同。
笔记本式工作流为何长盛不衰
这也有助于解释一个常令工程师困惑的现象:尽管笔记本有明显局限,为何仍处于中心位置。
答案在于:在分析问题仍在演变时,笔记本让意义贴近数据。笔记本并非结构糟糕的 Python 模块,而是为不同工作阶段打造的不同产物。它在分析成形的过程中,让代码、输出与决策彼此贴近。
这就是为什么对深处其境的分析者而言,笔记本直观易用,而对只看代码的代理来说却显得别扭。
在分析问题尚未定型前,就将笔记本重构为整洁、模块化的代码,往往并非改进。它可能会把逻辑和赋予其意义的上下文割裂开来。
机会所在:弥合“走向生产”的鸿沟
AI 代理在数据科学中的真正机会,并非简单复制软件工程中已奏效的做法,而是帮助弥合“走向生产”的鸿沟:即从探索中获得的洞见到可复现、可部署工作流之间的距离。
这一鸿沟之所以存在,是因为笔记本以牺牲结构整洁为代价来保留分析语境。若代理既能理解分析语境,也能理解生产系统的结构要求,就能在不迫使人类分析者过早退出探索模式的情况下,架起这座桥梁。
这比在代码库中导航更难,但也更重要。
要点回顾
对所研究仓库的分析总结如下:
- 数据科学代码在表层往往具有更高的熵,而软件工程代码在结构层往往具有更高的熵。
- 数据科学代码更常引用外部状态,如数据集、列、表和中间输出;软件工程代码则更倾向于内部自我指涉。
- 笔记本式工作流往往呈现更紧的耦合,而这通常是探索造成的后果,而非单纯的不良实践。
- 注释、输出与不断演化的状态是数据科学工作语义内容的一部分,而非边角料。
- 为软件工程场景优化的代理,若不能同时在代码结构之外对数据、输出和上下文进行推理,在数据科学中往往表现不佳。
结语
开始这项分析时,我原以为会发现数据科学代码只是比软件工程代码结构更差。结果却发现,前者出于充分理由而采用了不同的结构,且其意义常常安放在不同的地方。
这对任何构建或评估用于分析工作的 AI 代理的人都有实际影响。真正的问题不是代理能否写出正确的 Python,而是它是否理解数据是什么、为何分析呈现出这样的形态,以及有哪些仅凭代码无法看到的沿途决策。
数据科学代码并不是不成熟的软件工程,而是完全不同的优化:在探索阶段更依赖外部状态,较少依靠持久的内部结构,并且同样受上下文塑造如同受代码塑造。
一旦意识到这一点,笔记本看起来就不再像失败的软件项目,而更像其真实面貌:用于在变化数据上进行推理的工作界面。
我正用 1,000 个或更多仓库与附加指标扩展此分析。如果您想更深入了解 AI 代理如何在上下文中与数据协作(包括在会话间保持数据状态的持久化执行架构),DataCamp 的 AI Agent 基础路径是一个很好的起点。


我分析了数百个 GitHub 仓库,试图理解为什么 AI 编码代理在软件工程中往往显得更有能力,而在数据科学工作中则不然。我的发现表明,这不只是工具差距的问题,而是反映了两类代码在“意义”所寄居的地方存在更深层次的差异。
本文关注什么
如果您曾在软件工程的代码库中使用过 AI 编码代理,您很可能见识过它的高效。代理能够在架构中穿梭、遵循抽象,并做出与整个系统惊人契合的修改。
但当您打开一个数据科学笔记本时,体验往往就变了。
代理依然能写出有效代码,也能遵循指令。但它常常无法完全理解关键之处:为什么是这个数据集、为什么用这个筛选、为什么是这个时间窗口、为什么这个输出改变了分析的方向。
它把笔记本当作一个软件项目来处理,而这只是它的一部分属性。
我想弄清原因,因此对数据科学与软件工程领域的数百个 GitHub 仓库进行了分析,测量了熵、引用模式和耦合行为。
结果让我颇为意外,我认为这对任何构建或使用 AI 代理开展分析工作的人都具有现实意义。
熵的反转:数据科学代码并非表面看起来那样
我实际测量了什么
我在三个抽象层级上对每个仓库测量了香农熵:字符层、词元层和 AST(抽象语法树)层。每个层级捕捉代码变异性的不同维度。
代码熵分布:数据科学 vs 软件工程 小提琴图
呈现出的模式可称为“熵的反转”。
表面看起来更复杂,结构却往往不是
在字符层,数据科学代码往往比软件工程代码具有更高的熵。这合乎直觉。数据科学工作充斥着多样的列名、数据集标签、临时变量以及领域特定的标识符,使得代码看起来嘈杂而不规则。
在词元层,两者差距要小得多。它们依赖许多相同的语法构件。
但在关注结构多样性的 AST 层,画风却反转了。
软件工程代码往往在结构上编码了更多变化。它通过抽象、接口、模块和内部逻辑,创造出更多彼此区分的行为。
相比之下,数据科学代码常常是在变化的上下文中复用较小的一组操作:加载、筛选、分组、聚合、可视化、检视、调整。
简言之,数据科学代码的表层往往更显复杂,而软件工程代码的复杂性更多地承载在结构之中。
这并非纯粹的风格差异,而是指向两类工作如何存储“意义”的更深层差别。
指示性 vs 符号性:意义安在何处
两种不同的代码
当您思考每种代码实际在做什么时,“熵的反转”就更容易理解了。
在软件工程中,意义常被压缩进结构里。函数、接口、模块、类型和类边界承担了大量工作。一旦这些抽象建立起来,它们会稳定行为并降低未来的不确定性。
许多意义蕴含在代码自身之中。
在数据科学中,意义则更紧密地系于外部语境。它依赖于数据集、列、阶段性输出、某个变换背后的假设,以及分析者试图回答的不断演化的问题。代码不仅是在表达逻辑,它是在指向一个特定的分析情境。
这一差异是理解为什么代理在两大领域表现迥异的最有用方式之一。
从代码“指向”的对象可见端倪
我还测量了两组代码中每 100 行的外部与内部引用密度。
外部与内部引用密度及统计显著性
差异非常清楚。数据科学代码更频繁地向外部指涉:数据集、表、列、临时对象以及存在于代码之外的状态。
软件工程代码则更倾向于内部自我指涉。它更常通过指向代码库中其他地方定义的函数、类、模块和抽象来构建意义。
数据代码向外指,软件代码向内指。
这对代理很重要。在一种情况下,大部分相关上下文在代码库内部;在另一种情况下,大部分上下文存在于周边的分析状态中。
这为何让抽象表现不同
笔记本中的耦合问题
一个颇有意思的发现与耦合相关。与软件工程代码库相比,笔记本式工作流在每 100 行代码中的耦合明显更紧。
这并不一定是糟糕的设计。它反映了探索性分析的根本特点:问题本身常在变化中。您在检验假设、追踪异常结果、核查边界情况,并在学习中不断调整方向。
在这种情境下,抽象往往无法像在软件工程中那样带来同等收益。过早的结构化可能在您尚未弄清关键点之前就降低了选择空间。更紧的耦合往往是探索的结果,而不只是糟糕工程实践的产物。
注释与状态的作用
两大领域在“如何自我解释”方面也存在重要差异。
在软件工程中,代码常通过结构自我解释。类型、接口和抽象承载了大量意义,注释通常是次要的。
在数据科学中,注释、输出和状态往往承载着部分意义。诸如“移除了高于第 99 百分位的离群点,确认这不影响主队列”这样的备注,并不只是额外文档。
它记录了一项仅凭代码可能无法还原的分析决策。笔记本中途的一张表或一幅图,可能就解释了下一段分析存在的理由。
这对代理同样重要。忽略注释、行内结果和不断演化的状态,就会错过分析的一部分。在软件工程代码库中,这些信息往往是补充性的;在数据科学工作中,却常常不是。
这对 AI 代理意味着什么
默认情况下,代理与其中一个领域更“匹配”
实际含义是:当工具与“意义”的栖身之处相匹配时,代理的效果最佳。
在软件工程中,高效的代理会在架构中导航,沿着调用图前进,遵循接口,并在整个代码库中保持改动一致。这奏效是因为大量意义已被编码进结构。
在数据科学中,高效的代理需要做的不止是浏览代码。它需要理解数据实际包含什么,在各步骤间跟踪状态,追溯变量的来源,并能推理为何在几步之前应用了某个变换或筛选。
为软件工程打造的代理并不会自然而然地迁移到数据科学工作中。问题不只是语法,而是底层的信息结构不同。
笔记本式工作流为何长盛不衰
这也有助于解释一个常令工程师困惑的现象:尽管笔记本有明显局限,为何仍处于中心位置。
答案在于:在分析问题仍在演变时,笔记本让意义贴近数据。笔记本并非结构糟糕的 Python 模块,而是为不同工作阶段打造的不同产物。它在分析成形的过程中,让代码、输出与决策彼此贴近。
这就是为什么对深处其境的分析者而言,笔记本直观易用,而对只看代码的代理来说却显得别扭。
在分析问题尚未定型前,就将笔记本重构为整洁、模块化的代码,往往并非改进。它可能会把逻辑和赋予其意义的上下文割裂开来。
机会所在:弥合“走向生产”的鸿沟
AI 代理在数据科学中的真正机会,并非简单复制软件工程中已奏效的做法,而是帮助弥合“走向生产”的鸿沟:即从探索中获得的洞见到可复现、可部署工作流之间的距离。
这一鸿沟之所以存在,是因为笔记本以牺牲结构整洁为代价来保留分析语境。若代理既能理解分析语境,也能理解生产系统的结构要求,就能在不迫使人类分析者过早退出探索模式的情况下,架起这座桥梁。
这比在代码库中导航更难,但也更重要。
要点回顾
对所研究仓库的分析总结如下:
结语
开始这项分析时,我原以为会发现数据科学代码只是比软件工程代码结构更差。结果却发现,前者出于充分理由而采用了不同的结构,且其意义常常安放在不同的地方。
这对任何构建或评估用于分析工作的 AI 代理的人都有实际影响。真正的问题不是代理能否写出正确的 Python,而是它是否理解数据是什么、为何分析呈现出这样的形态,以及有哪些仅凭代码无法看到的沿途决策。
数据科学代码并不是不成熟的软件工程,而是完全不同的优化:在探索阶段更依赖外部状态,较少依靠持久的内部结构,并且同样受上下文塑造如同受代码塑造。
一旦意识到这一点,笔记本看起来就不再像失败的软件项目,而更像其真实面貌:用于在变化数据上进行推理的工作界面。
我正用 1,000 个或更多仓库与附加指标扩展此分析。如果您想更深入了解 AI 代理如何在上下文中与数据协作(包括在会话间保持数据状态的持久化执行架构),DataCamp 的 AI Agent 基础路径是一个很好的起点。