Lernpfad
KI-Agent-Grundlagen
6 Std.
Ich habe Hunderte GitHub-Repositories analysiert, um zu verstehen, warum KI-Coding-Agenten sich in der Softwareentwicklung oft deutlich fähiger anfühlen als in der Data-Science-Arbeit. Die Ergebnisse deuten darauf hin, dass es nicht nur um Tools geht. Dahinter steckt ein grundlegender Unterschied darin, wo in beiden Codearten Bedeutung verankert ist.
Wenn du KI-Coding-Agenten in einer Software-Engineering-Codebasis genutzt hast, hast du wahrscheinlich erlebt, wie effektiv sie sein können. Der Agent navigiert durch die Architektur, folgt Abstraktionen und nimmt Änderungen vor, die erstaunlich gut zum restlichen System passen.
Dann öffnest du ein Data-Science-Notebook – und plötzlich ist das Erlebnis oft ein anderes.
Der Agent kann weiterhin gültigen Code schreiben. Er kann Anweisungen befolgen. Aber oft versteht er nicht wirklich, worauf es ankommt: Warum dieses Dataset, warum dieser Filter, warum dieses Zeitfenster, warum dieser Output die Richtung der Analyse geändert hat.
Er behandelt das Notebook wie ein Softwareprojekt – und das ist nur ein Teil dessen, was es ist.
Ich wollte herausfinden, warum. Deshalb habe ich Hunderte Repositories aus Data Science und Software Engineering untersucht und Entropie, Referenzmuster und Kopplungsverhalten gemessen.
Die Ergebnisse haben mich überrascht – und sie haben aus meiner Sicht handfeste Konsequenzen für alle, die KI-Agenten in der Analyse einsetzen oder entwickeln.
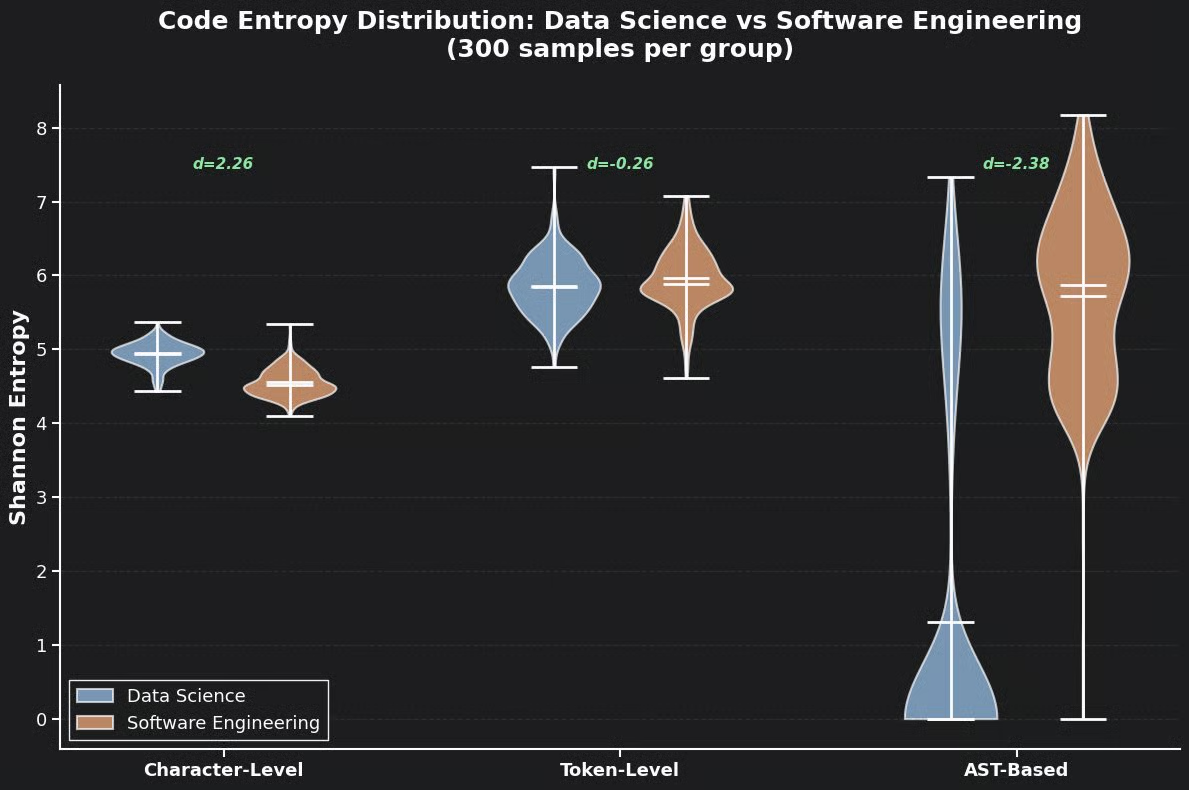
Ich habe die Shannon-Entropie auf drei Abstraktionsebenen für jedes Repository gemessen: Zeichenebene, Tokenebene und AST-Ebene. Jede Ebene erfasst eine andere Dimension der Variation im Code.
Verteilung der Code-Entropie: Data Science vs. Software Engineering (Violin Plots)
Es zeigte sich ein Muster, das ich als Entropie-Umkehr bezeichne.
Auf Zeichenebene weist Data-Science-Code tendenziell höhere Entropie auf als Software-Engineering-Code. Das ist intuitiv: Data Science ist voller variierender Spaltennamen, Dataset-Labels, ad-hoc Variablen und domänenspezifischer Bezeichner, die den Code unregelmäßig und „laut“ wirken lassen.
Auf Tokenebene liegen beide Bereiche deutlich näher beieinander. Sie nutzen viele der gleichen syntaktischen Bausteine.
Auf AST-Ebene, also dort, wo wir strukturelle Vielfalt betrachten, dreht sich das Bild jedoch um.
Software-Engineering-Code bildet deutlich mehr strukturelle Variation ab. Er erzeugt mehr unterschiedliche Verhaltensweisen durch Abstraktionen, Schnittstellen, Module und interne Logik.
Data-Science-Code hingegen nutzt häufig einen kleineren Satz an Operationen in wechselndem Kontext immer wieder: laden, filtern, gruppieren, aggregieren, visualisieren, inspizieren, anpassen.
Kurz gesagt: Data-Science-Code wirkt oft an der Oberfläche komplexer, während Software-Engineering-Code die Komplexität häufiger in der Struktur trägt.
Das ist nicht nur ein Stilunterschied. Er verweist auf einen tieferen Unterschied darin, wie beide Arbeitsformen Bedeutung speichern.
Die Entropie-Umkehr wird verständlicher, wenn man betrachtet, was jede Codeart eigentlich tut.
In der Softwareentwicklung wird Bedeutung häufig in Struktur komprimiert. Funktionen, Schnittstellen, Module, Typen und Klassenabgrenzungen leisten hier viel Arbeit. Sind diese Abstraktionen einmal etabliert, stabilisieren sie Verhalten und reduzieren zukünftige Unsicherheit.
Viel Bedeutung steckt im Code selbst.
In Data Science bleibt Bedeutung viel enger an externen Kontext gebunden. Sie hängt vom Dataset, den Spalten, Zwischenoutputs, Annahmen hinter einer Transformation und der sich entwickelnden Frage ab, die die Analystin oder der Analyst beantworten will. Der Code drückt nicht nur Logik aus. Er verweist auf eine konkrete analytische Situation.
Dieser Unterschied hilft stark zu verstehen, warum Agenten sich in beiden Domänen so unterschiedlich verhalten.
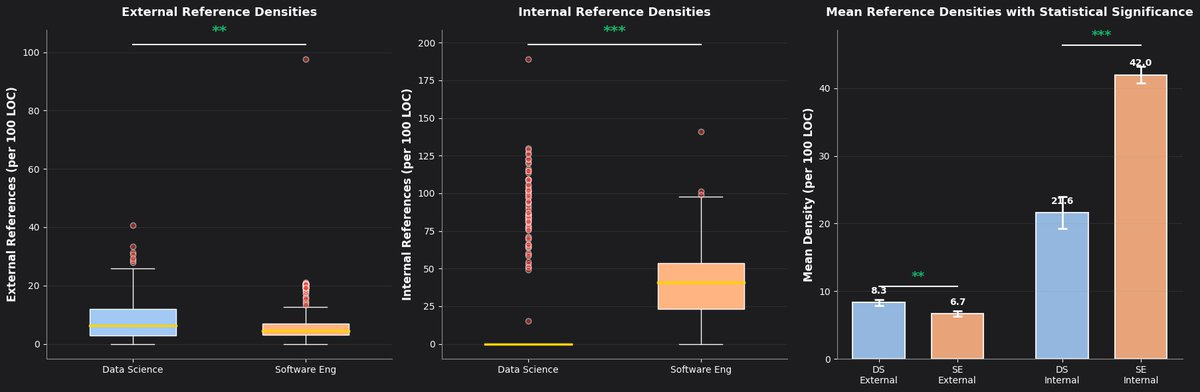
Ich habe zudem externe und interne Referenzdichten pro 100 Zeilen Code in beiden Gruppen gemessen.
Externe und interne Referenzdichten mit statistischer Signifikanz
Die Unterscheidung ist klar: Data-Science-Code verweist häufiger nach außen – auf Datasets, Tabellen, Spalten, temporäre Objekte und Zustände, die außerhalb des Codes existieren.
Software-Engineering-Code ist stärker intern selbstreferenziell. Er baut Bedeutung häufiger auf, indem er auf Funktionen, Klassen, Module und Abstraktionen verweist, die anderswo in der Codebasis definiert sind.
Daten-Code zeigt nach außen. Software-Code zeigt nach innen.
Für Agenten ist das entscheidend: In einem Fall steckt viel relevanter Kontext in der Codebasis. Im anderen liegt er größtenteils im umgebenden analytischen Zustand.
Eine der interessanteren Beobachtungen betraf die Kopplung. Notebook-Workflows zeigten pro 100 Zeilen Code eine deutlich engere Kopplung als Software-Engineering-Codebasen.
Das ist nicht zwingend schlechtes Design. Es spiegelt etwas Grundsätzliches an explorativer Analyse wider: Die Fragestellung ist oft noch in Bewegung. Du testest Annahmen, gehst ungewöhnlichen Ergebnissen nach, prüfst Edge Cases und änderst die Richtung, während du lernst.
In diesem Setting zahlt sich Abstraktion oft nicht so aus wie in der Softwareentwicklung. Vorauseilende Struktur kann die Handlungsoptionen reduzieren, bevor klar ist, was zählt. Engere Kopplung ist häufig eine Folge der Exploration – nicht einfach nur schlechte Ingenieurspraxis.
Es gibt auch einen wichtigen Unterschied darin, wie sich beide Domänen erklären.
In der Softwareentwicklung erklärt sich Code häufig durch Struktur. Typen, Schnittstellen und Abstraktionen tragen einen Großteil der Bedeutung, Kommentare sind meist nachrangig.
In Data Science tragen Kommentare, Outputs und Zustand oft einen Teil der Bedeutung. Eine Notiz wie „Ausreißer oberhalb des 99. Perzentils entfernt, bestätigt: keine Auswirkung auf die Hauptkohorte“ ist nicht nur zusätzliche Doku.
Sie hält eine analytische Entscheidung fest, die sich aus dem Code allein womöglich nicht rekonstruieren lässt. Eine Tabelle oder ein Plot mitten im Notebook kann erklären, warum der nächste Analyseschritt überhaupt existiert.
Für Agenten ist das relevant: Ein Agent, der Kommentare, Inline-Ergebnisse und den sich entwickelnden Zustand in einem Notebook ignoriert, verpasst einen Teil der Analyse. In einer Software-Codebasis sind diese Informationen oft ergänzend. In Data-Science-Arbeit oft nicht.
Praktisch heißt das: Agenten funktionieren am besten, wenn ihre Werkzeuge dort ansetzen, wo die Bedeutung lebt.
In der Softwareentwicklung navigiert ein effektiver Agent die Architektur. Er folgt dem Call-Graphen, respektiert Schnittstellen und hält Änderungen in der gesamten Codebasis konsistent. Das funktioniert, weil viel Bedeutung in der Struktur kodiert ist.
In Data Science muss ein effektiver Agent mehr tun als nur Code zu durchqueren. Er muss verstehen, was in den Daten tatsächlich steckt, Zustand über Schritte hinweg verfolgen, die Herkunft von Variablen nachzeichnen und begründen, warum eine Transformation oder ein Filter mehrere Schritte zuvor angewandt wurde.
Ein für Software Engineering gebauter Agent überträgt sich nicht automatisch gut auf Data-Science-Arbeit. Das Problem ist nicht nur Syntax. Die zugrunde liegende Informationsstruktur ist eine andere.
Das erklärt auch etwas, was viele Engineers wundert: warum Notebooks trotz offensichtlicher Limitierungen so zentral bleiben.
Der Grund: Notebooks halten die Bedeutung nahe an den Daten, solange die analytische Fragestellung sich noch entwickelt. Ein Notebook ist nicht nur ein schlecht strukturiertes Python-Modul. Es ist ein anderes Artefakt für eine andere Arbeitsphase. Es hält Code, Outputs und Entscheidungen eng beieinander, während die Analyse Form annimmt.
Darum fühlt sich ein Notebook für die Person intuitiv an, die im Kontext „lebt“, und für einen Agenten, der nur den Code sieht, holprig.
Ein Notebook in sauberen, modularen Code zu refaktorisieren, bevor die analytische Frage geklärt ist, ist oft keine Verbesserung. Es trennt die Logik vom Kontext, der ihr ursprünglich Bedeutung gegeben hat.
Die echte Chance für KI-Agenten in Data Science ist nicht, einfach zu kopieren, was in der Softwareentwicklung funktioniert. Sie liegt darin, die Produktionslücke zu schließen: die Distanz zwischen einem Insight aus der Exploration und einem reproduzierbaren, deploybaren Workflow.
Diese Lücke existiert, weil Notebooks analytischen Kontext bewahren – auf Kosten sauberer Struktur. Ein Agent, der sowohl den analytischen Kontext als auch die strukturellen Anforderungen produktiver Systeme versteht, könnte diese Lücke überbrücken, ohne die menschliche Analystin oder den Analysten zu früh aus dem Explorationsmodus zu reißen.
Das ist schwieriger, als nur eine Codebasis zu durchqueren. Aber es ist auch wichtiger.
Zusammengefasst legen die Analysen über die untersuchten Repositories nahe:
Als ich diese Analyse begann, erwartete ich, dass Data-Science-Code einfach schlechter strukturiert sei als Software-Engineering-Code. Stattdessen fand ich: Er ist aus guten Gründen anders strukturiert – die Bedeutung liegt oft an einem anderen Ort.
Das hat praktische Konsequenzen für alle, die KI-Agenten für analytische Arbeit bauen oder bewerten. Die eigentliche Frage ist nicht, ob ein Agent korrektes Python schreiben kann. Sondern ob er versteht, was die Daten sind, warum die Analyse diese Form hat und welche Entscheidungen unterwegs getroffen wurden, die im Code allein nicht sichtbar sind.
Data-Science-Code ist keine unreife Softwareentwicklung. Es ist eine ganz andere Optimierung: stärker abhängig von externem Zustand, während der Exploration weniger auf dauerhafte interne Struktur gestützt und ebenso sehr vom Kontext geprägt wie vom Code.
Sobald du das siehst, hören Notebooks auf, wie gescheiterte Softwareprojekte auszusehen – und wirken mehr wie das, was sie sind: Arbeitsflächen, um über sich verändernde Daten nachzudenken.
Ich führe diese Analyse mit einem größeren Datensatz von 1.000+ Repositories und zusätzlichen Metriken fort. Wenn du tiefer einsteigen willst, wie KI-Agenten mit Daten im Kontext arbeiten (einschließlich persistenter Ausführungsarchitekturen, die den Datenzustand über Sessions hinweg erhalten), ist DataCamps AI agent fundamentals track ein guter Startpunkt.
Top DataCamp Courses
Lernpfad
Kurs
Kurs