Yapay zekâ kodlama ajanlarının veri bilimi çalışmalarında neden yazılım mühendisliğine göre daha az yetkin göründüğünü anlamak için yüzlerce GitHub deposunu inceledim. Elde ettiğim bulgular bunun yalnızca bir araç seti açığı olmadığını gösteriyor. Her tür koddaki anlamın nerede yaşadığına dair daha derin bir farkı yansıtıyor.
Bu Makale Ne Hakkında
Bir yazılım mühendisliği kod tabanında bir yapay zekâ kodlama ajanı kullandıysanız, ne kadar etkili olabileceğini muhtemelen görmüşsünüzdür. Ajan mimaride gezinir, soyutlamaları takip eder ve sistemin geri kalanıyla şaşırtıcı derecede uyumlu değişiklikler yapar.
Sonra bir veri bilimi defterini açarsınız ve deneyim çoğu zaman değişir.
Ajan hâlâ geçerli kod yazabilir. Hâlâ talimatları takip edebilir. Ancak çoğu zaman asıl önemli olanı tam olarak kavrayamaz: neden bu veri kümesi, neden bu filtre, neden bu zaman penceresi, neden bu çıktı analizin yönünü değiştirdi.
Defteri bir yazılım projesi gibi ele alır ve bu, onun yalnızca bir parçasıdır.
Bunun nedenini anlamak istedim. Bu yüzden veri bilimi ve yazılım mühendisliği arasında yüzlerce GitHub deposunu analiz ederek entropi, referans örüntüleri ve bağlaşım (coupling) davranışını ölçtüm.
Bulgular beni şaşırttı ve bence analitik işlerde yapay zekâ ajanları geliştiren veya kullanan herkes için gerçek etkileri var.
Entropi Tersine Dönüşü: Veri Bilimi Kodu Göründüğü Gibi Değil
Gerçekte neyi ölçtüm
Her depo için üç soyutlama düzeyinde Shannon entropisini ölçtüm: karakter düzeyi, token düzeyi ve AST düzeyi. Her biri koddaki farklı bir değişkenlik boyutunu yakalar.
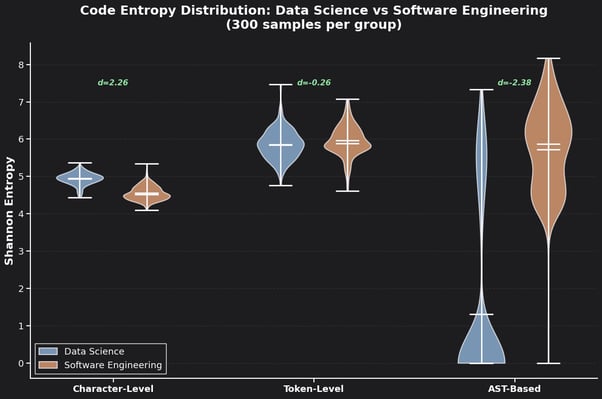
Kod Entropisi Dağılımı: Veri Bilimi vs Yazılım Mühendisliği viyolin grafikleri
Ortaya çıkan örüntü, entropi tersine dönüşü diye adlandırdığım şeydi.
Yüzey karmaşık görünüyor, yapı çoğu zaman öyle değil
Karakter düzeyinde, veri bilimi kodu genellikle yazılım mühendisliği kodundan daha yüksek entropiye sahiptir. Bu sezgisel olarak mantıklıdır. Veri bilimi çalışması, kodu gürültülü ve düzensiz gösteren çeşitli sütun adları, veri kümesi etiketleri, doğaçlama değişkenler ve alana özgü tanımlayıcılarla doludur.
Token düzeyinde, iki alan birbirine çok daha yakındır. Aynı sözdizimsel yapı taşlarının çoğuna dayanırlar.
Ama yapısal çeşitliliğe baktığımız AST düzeyinde tablo tersine döner.
Yazılım mühendisliği kodu, yapıda çok daha fazla çeşitlilik kodlama eğilimindedir. Soyutlamalar, arayüzler, modüller ve iç mantık aracılığıyla daha farklı davranışlar üretir.
Buna karşılık veri bilimi kodu, değişen bağlamlarda daha küçük bir işlem kümesini tekrar kullanır: yükle, filtrele, grupla, topla, görselleştir, incele, ayarla.
Kısacası, veri bilimi kodu genellikle yüzeyde daha karmaşık görünürken, yazılım mühendisliği kodu sıklıkla daha fazla yapısal karmaşıklık taşır.
Bu yalnızca üslup farkı değildir. İki tür çalışmanın anlamı nasıl depoladığına dair daha derin bir farka işaret eder.
Gösterge Değerli (İndeksik) vs Sembolik: Anlam Nerede Yaşar
İki farklı kod türü
Entropi tersine dönüşü, her kod türünün aslında ne yaptığı düşünüldüğünde daha anlaşılır hale gelir.
Yazılım mühendisliğinde anlam çoğu zaman yapıya sıkıştırılmıştır. Fonksiyonlar, arayüzler, modüller, tipler ve sınıf sınırları işin büyük kısmını yapar. Bu soyutlamalar bir kez kurulduğunda davranışı dengeler ve gelecekteki belirsizliği azaltır.
Anlamın büyük bölümü bizzat kodun içindedir.
Veri biliminde ise anlam dış bağlama çok daha sıkı bağlı kalır. Veri kümesine, sütunlara, ara çıktılara, bir dönüşümün arkasındaki varsayımlara ve analistin yanıtlamaya çalıştığı evrilen soruya bağlıdır. Kod yalnızca mantığı ifade etmez. Belirli bir analitik duruma işaret eder.
Bu fark, ajanların iki alanda neden çoğu zaman bu kadar farklı davrandığını anlamanın en yararlı yollarından biridir.
Kodun nereye “işaret ettiğinde” görebilirsiniz
Her iki grupta da 100 satır kod başına haricî ve dahili referans yoğunluklarını ölçtüm.
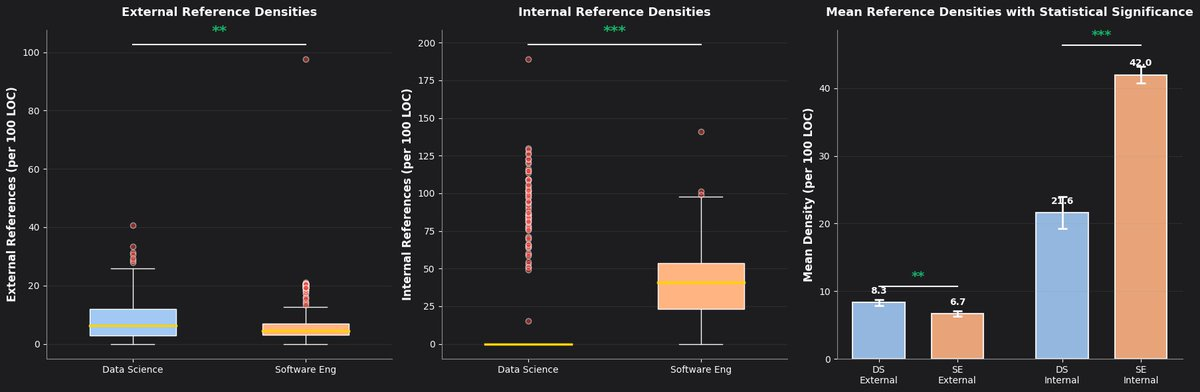
İstatistiksel anlamlılıkla Haricî ve Dahili Referans Yoğunlukları
Ayrım nettir. Veri bilimi kodu dışa daha sık atıfta bulunur: veri kümelerine, tablolara, sütunlara, geçici nesnelere ve kodun dışında var olan durumlara.
Yazılım mühendisliği kodu ise daha çok kendi içine referans verir. Anlamı daha sık, kod tabanının başka yerlerinde tanımlı fonksiyonlara, sınıflara, modüllere ve soyutlamalara işaret ederek inşa eder.
Veri kodu dışa işaret eder. Yazılım kodu içe işaret eder.
Bu, ajanlar için önemlidir. Birinde ilgili bağlamın büyük bölümü kod tabanındadır. Diğerinde ise büyük bölümü çevredeki analitik durumda yer alır.
Bu Neden Soyutlamanın Farklı Davranmasına Yol Açar
Defterlerde bağlaşım (coupling) sorunu
Daha ilginç bulgulardan biri bağlaşım etrafındaydı. Defter tarzı iş akışları, 100 satır kod başına yazılım mühendisliği kod tabanlarından çok daha sıkı bağlaşım gösterdi.
Bu mutlaka kötü tasarım değildir. Keşif amaçlı analize dair temel bir şeyi yansıtır: Sorunun kendisi çoğu zaman hâlâ hareket halindedir. Varsayımları test eder, tuhaf sonuçların peşinden gider, sınır durumlarını kontrol eder ve öğrendikçe yön değiştirirsiniz.
Bu ortamda, soyutlama yazılım mühendisliğindekiyle aynı şekilde karşılığını vermez. Erken yapılandırma, neyin önemli olduğunu anlamadan önce seçenekliliği azaltabilir. Daha sıkı bağlaşım, çoğu zaman yalnızca zayıf mühendisliğin değil, keşfin bir sonucudur.
Açıklama satırlarının ve durumun rolü
İki alanın kendini nasıl açıkladığı konusunda da önemli bir fark vardır.
Yazılım mühendisliğinde kod, çoğu zaman kendini yapıyla açıklar. Tipler, arayüzler ve soyutlamalar anlamın büyük kısmını taşır ve açıklama satırları genellikle ikincildir.
Veri biliminde ise açıklama satırları, çıktılar ve durum çoğu zaman anlamın bir kısmını taşır. “Yüzdelik 99’un üzerindeki aykırı değerler çıkarıldı, bunun ana kohortu etkilemediği doğrulandı” gibi bir not yalnızca ek dokümantasyon değildir.
Bu, tek başına koddan geri kazanılamayabilecek bir analitik kararı yakalar. Defterin yarısındaki bir tablo veya grafik, sonraki analizin neden var olduğunu açıklayabilir.
Bu ajanlar için önemlidir. Bir defterde açıklama satırlarını, satıriçi sonuçları ve evrilen durumu yok sayan bir ajan, analizin bir kısmını kaçırır. Bir yazılım mühendisliği kod tabanında bu bilgiler genellikle tamamlayıcıdır. Veri bilimi işinde ise çoğu zaman değildir.
Bu, Yapay Zekâ Ajanları İçin Ne Anlama Geliyor
Ajanlar varsayılan olarak bir alana daha iyi uyumludur
Pratik çıkarım şu: Ajanlar, araçları anlamın yaşadığı yere uyduğunda en iyi çalışır.
Yazılım mühendisliğinde etkili bir ajan mimaride gezinir. Çağrı grafiğini takip eder, arayüzlere saygı duyar ve değişiklikleri kod tabanı genelinde tutarlı kılar. Bu işe yarar çünkü anlamın büyük bölümü yapıya kodlanmıştır.
Veri biliminde etkili bir ajanın kodda gezinmekten fazlasını yapması gerekir. Verinin gerçekte ne içerdiğini anlamalı, adımlar arasında durumu takip etmeli, değişkenlerin kökenini izlemeli ve birkaç adım önce neden bir dönüşüm veya filtrenin uygulandığını muhakeme etmelidir.
Yazılım mühendisliği için inşa edilmiş bir ajan, kendiliğinden veri bilimi işine iyi aktarılamaz. Sorun yalnızca sözdizimi değildir. Temel bilgi yapısı farklıdır.
Defter tarzı iş akışları neden sürüyor
Bu aynı zamanda mühendisleri sıkça şaşırtan bir şeyi de açıklar: bariz sınırlamalarına rağmen defterlerin neden hâlâ bu kadar merkezi olduğu.
Yanıt şu ki defterler, analitik soru hâlâ evrilirken anlamı veriye yakın tutar. Bir defter yalnızca kötü yapılandırılmış bir Python modülü değildir. Farklı bir iş aşaması için üretilmiş farklı bir eserdir. Analiz hâlâ şekillenirken kodu, çıktıları ve kararları birbirine yakın tutar.
Bu nedenle, bağlamın içinde yaşayan analiste sezgisel gelebilirken, yalnızca kodu gören bir ajana garip gelebilir.
Analitik soru netleşmeden bir defteri temiz, modüler koda yeniden düzenlemek çoğu zaman bir iyileştirme değildir. Mantığı, ona ilk anlamını veren bağlamdan ayırabilir.
Fırsat: üretim boşluğunu kapatmak
Veri biliminde yapay zekâ ajanları için gerçek fırsat, yazılım mühendisliğinde zaten işe yarayanı kopyalamak değildir. Üretim boşluğunu kapatmaya yardım etmektir: keşifte bulunan bir içgörü ile yeniden üretilebilir, devreye alınabilir bir iş akışı arasındaki mesafe.
Bu boşluk, defterlerin yapısal temizliği pahasına analitik bağlamı korumasından kaynaklanır. Hem analitik bağlamı hem de üretim sistemlerinin yapısal gereksinimlerini anlayabilen bir ajan, insan analistin keşif modundan çok erken çıkmasına gerek kalmadan bu boşluğu köprüleyebilir.
Bu, bir kod tabanında gezinmekten daha zor bir problemdir. Ama aynı zamanda daha önemli olandır.
Temel Çıkarımlar
İncelenen depolar genelinde analizden çıkanların özeti:
- Veri bilimi kodu genellikle yüzey düzeyinde daha yüksek entropiye sahipken, yazılım mühendisliği kodu genellikle daha yüksek yapısal entropiye sahiptir.
- Veri bilimi kodu, veri kümeleri, sütunlar, tablolar ve ara çıktılar gibi haricî duruma daha sık atıfta bulunurken, yazılım mühendisliği kodu daha fazla kendi içine referans verir.
- Defter tarzı iş akışları, genellikle yalnızca zayıf uygulamanın değil, keşfin bir sonucu olan daha sıkı bağlaşım eğilimi gösterir.
- Açıklama satırları, çıktılar ve evrilen durum, veri bilimi işinin anlamsal içeriğinin parçasıdır; yalnızca çevresel ayrıntı değildir.
- Yazılım mühendisliği bağlamları için optimize edilmiş ajanlar, kod yapısının yanı sıra veri, çıktılar ve bağlam üzerinde mantık yürütecek şekilde tasarlanmadıkça veri biliminde genellikle düşük performans gösterecektir.
Sonuç
Bu analize başladığımda, veri bilimi kodunun yalnızca yazılım mühendisliği kodundan daha az iyi yapılandırılmış olduğunu bulacağımı sanıyordum. Bunun yerine, anlamın çoğu zaman farklı bir yerde yaşadığı, iyi nedenlerle farklı şekilde yapılandırıldığını gördüm.
Bu, analitik işler için yapay zekâ ajanları geliştiren veya değerlendiren herkes için pratik sonuçlar doğurur. Asıl soru, bir ajanın doğru Python yazıp yazamayacağı değildir. Verinin ne olduğunu, analizin neden bu şekli aldığını ve yalnızca koddan görünmeyen yolda hangi kararların alındığını anlayıp anlamadığıdır.
Veri bilimi kodu, olgunlaşmamış yazılım mühendisliği değildir. Tamamen farklı bir optimizasyondur: haricî duruma daha bağımlı, keşif sırasında kalıcı iç yapıya daha az dayalı ve en az kod kadar bağlam tarafından şekillendirilen.
Bunu bir kez gördüğünüzde, defterler başarısız yazılım projeleri gibi görünmeyi bırakır ve gerçekte olduklarına daha çok benzemeye başlar: değişen veriler üzerinde akıl yürütmeye yönelik çalışma yüzeyleri.
Bu analizi 1.000 veya daha fazla depo ve ek metrikten oluşan daha büyük bir veri setiyle sürdürüyorum. Ajanların bağlam içindeki verilerle nasıl çalışmak üzere inşa edildiğine (oturumlar arasında veri durumunu koruyan kalıcı yürütme mimarileri dahil) daha derinlemesine inmek isterseniz, DataCamp'in AI agent fundamentals track programı sağlam bir başlangıç noktasıdır.





Yapay zekâ kodlama ajanlarının veri bilimi çalışmalarında neden yazılım mühendisliğine göre daha az yetkin göründüğünü anlamak için yüzlerce GitHub deposunu inceledim. Elde ettiğim bulgular bunun yalnızca bir araç seti açığı olmadığını gösteriyor. Her tür koddaki anlamın nerede yaşadığına dair daha derin bir farkı yansıtıyor.
Bu Makale Ne Hakkında
Bir yazılım mühendisliği kod tabanında bir yapay zekâ kodlama ajanı kullandıysanız, ne kadar etkili olabileceğini muhtemelen görmüşsünüzdür. Ajan mimaride gezinir, soyutlamaları takip eder ve sistemin geri kalanıyla şaşırtıcı derecede uyumlu değişiklikler yapar.
Sonra bir veri bilimi defterini açarsınız ve deneyim çoğu zaman değişir.
Ajan hâlâ geçerli kod yazabilir. Hâlâ talimatları takip edebilir. Ancak çoğu zaman asıl önemli olanı tam olarak kavrayamaz: neden bu veri kümesi, neden bu filtre, neden bu zaman penceresi, neden bu çıktı analizin yönünü değiştirdi.
Defteri bir yazılım projesi gibi ele alır ve bu, onun yalnızca bir parçasıdır.
Bunun nedenini anlamak istedim. Bu yüzden veri bilimi ve yazılım mühendisliği arasında yüzlerce GitHub deposunu analiz ederek entropi, referans örüntüleri ve bağlaşım (coupling) davranışını ölçtüm.
Bulgular beni şaşırttı ve bence analitik işlerde yapay zekâ ajanları geliştiren veya kullanan herkes için gerçek etkileri var.
Entropi Tersine Dönüşü: Veri Bilimi Kodu Göründüğü Gibi Değil
Gerçekte neyi ölçtüm
Her depo için üç soyutlama düzeyinde Shannon entropisini ölçtüm: karakter düzeyi, token düzeyi ve AST düzeyi. Her biri koddaki farklı bir değişkenlik boyutunu yakalar.
Kod Entropisi Dağılımı: Veri Bilimi vs Yazılım Mühendisliği viyolin grafikleri
Ortaya çıkan örüntü, entropi tersine dönüşü diye adlandırdığım şeydi.
Yüzey karmaşık görünüyor, yapı çoğu zaman öyle değil
Karakter düzeyinde, veri bilimi kodu genellikle yazılım mühendisliği kodundan daha yüksek entropiye sahiptir. Bu sezgisel olarak mantıklıdır. Veri bilimi çalışması, kodu gürültülü ve düzensiz gösteren çeşitli sütun adları, veri kümesi etiketleri, doğaçlama değişkenler ve alana özgü tanımlayıcılarla doludur.
Token düzeyinde, iki alan birbirine çok daha yakındır. Aynı sözdizimsel yapı taşlarının çoğuna dayanırlar.
Ama yapısal çeşitliliğe baktığımız AST düzeyinde tablo tersine döner.
Yazılım mühendisliği kodu, yapıda çok daha fazla çeşitlilik kodlama eğilimindedir. Soyutlamalar, arayüzler, modüller ve iç mantık aracılığıyla daha farklı davranışlar üretir.
Buna karşılık veri bilimi kodu, değişen bağlamlarda daha küçük bir işlem kümesini tekrar kullanır: yükle, filtrele, grupla, topla, görselleştir, incele, ayarla.
Kısacası, veri bilimi kodu genellikle yüzeyde daha karmaşık görünürken, yazılım mühendisliği kodu sıklıkla daha fazla yapısal karmaşıklık taşır.
Bu yalnızca üslup farkı değildir. İki tür çalışmanın anlamı nasıl depoladığına dair daha derin bir farka işaret eder.
Gösterge Değerli (İndeksik) vs Sembolik: Anlam Nerede Yaşar
İki farklı kod türü
Entropi tersine dönüşü, her kod türünün aslında ne yaptığı düşünüldüğünde daha anlaşılır hale gelir.
Yazılım mühendisliğinde anlam çoğu zaman yapıya sıkıştırılmıştır. Fonksiyonlar, arayüzler, modüller, tipler ve sınıf sınırları işin büyük kısmını yapar. Bu soyutlamalar bir kez kurulduğunda davranışı dengeler ve gelecekteki belirsizliği azaltır.
Anlamın büyük bölümü bizzat kodun içindedir.
Veri biliminde ise anlam dış bağlama çok daha sıkı bağlı kalır. Veri kümesine, sütunlara, ara çıktılara, bir dönüşümün arkasındaki varsayımlara ve analistin yanıtlamaya çalıştığı evrilen soruya bağlıdır. Kod yalnızca mantığı ifade etmez. Belirli bir analitik duruma işaret eder.
Bu fark, ajanların iki alanda neden çoğu zaman bu kadar farklı davrandığını anlamanın en yararlı yollarından biridir.
Kodun nereye “işaret ettiğinde” görebilirsiniz
Her iki grupta da 100 satır kod başına haricî ve dahili referans yoğunluklarını ölçtüm.
İstatistiksel anlamlılıkla Haricî ve Dahili Referans Yoğunlukları
Ayrım nettir. Veri bilimi kodu dışa daha sık atıfta bulunur: veri kümelerine, tablolara, sütunlara, geçici nesnelere ve kodun dışında var olan durumlara.
Yazılım mühendisliği kodu ise daha çok kendi içine referans verir. Anlamı daha sık, kod tabanının başka yerlerinde tanımlı fonksiyonlara, sınıflara, modüllere ve soyutlamalara işaret ederek inşa eder.
Veri kodu dışa işaret eder. Yazılım kodu içe işaret eder.
Bu, ajanlar için önemlidir. Birinde ilgili bağlamın büyük bölümü kod tabanındadır. Diğerinde ise büyük bölümü çevredeki analitik durumda yer alır.
Bu Neden Soyutlamanın Farklı Davranmasına Yol Açar
Defterlerde bağlaşım (coupling) sorunu
Daha ilginç bulgulardan biri bağlaşım etrafındaydı. Defter tarzı iş akışları, 100 satır kod başına yazılım mühendisliği kod tabanlarından çok daha sıkı bağlaşım gösterdi.
Bu mutlaka kötü tasarım değildir. Keşif amaçlı analize dair temel bir şeyi yansıtır: Sorunun kendisi çoğu zaman hâlâ hareket halindedir. Varsayımları test eder, tuhaf sonuçların peşinden gider, sınır durumlarını kontrol eder ve öğrendikçe yön değiştirirsiniz.
Bu ortamda, soyutlama yazılım mühendisliğindekiyle aynı şekilde karşılığını vermez. Erken yapılandırma, neyin önemli olduğunu anlamadan önce seçenekliliği azaltabilir. Daha sıkı bağlaşım, çoğu zaman yalnızca zayıf mühendisliğin değil, keşfin bir sonucudur.
Açıklama satırlarının ve durumun rolü
İki alanın kendini nasıl açıkladığı konusunda da önemli bir fark vardır.
Yazılım mühendisliğinde kod, çoğu zaman kendini yapıyla açıklar. Tipler, arayüzler ve soyutlamalar anlamın büyük kısmını taşır ve açıklama satırları genellikle ikincildir.
Veri biliminde ise açıklama satırları, çıktılar ve durum çoğu zaman anlamın bir kısmını taşır. “Yüzdelik 99’un üzerindeki aykırı değerler çıkarıldı, bunun ana kohortu etkilemediği doğrulandı” gibi bir not yalnızca ek dokümantasyon değildir.
Bu, tek başına koddan geri kazanılamayabilecek bir analitik kararı yakalar. Defterin yarısındaki bir tablo veya grafik, sonraki analizin neden var olduğunu açıklayabilir.
Bu ajanlar için önemlidir. Bir defterde açıklama satırlarını, satıriçi sonuçları ve evrilen durumu yok sayan bir ajan, analizin bir kısmını kaçırır. Bir yazılım mühendisliği kod tabanında bu bilgiler genellikle tamamlayıcıdır. Veri bilimi işinde ise çoğu zaman değildir.
Bu, Yapay Zekâ Ajanları İçin Ne Anlama Geliyor
Ajanlar varsayılan olarak bir alana daha iyi uyumludur
Pratik çıkarım şu: Ajanlar, araçları anlamın yaşadığı yere uyduğunda en iyi çalışır.
Yazılım mühendisliğinde etkili bir ajan mimaride gezinir. Çağrı grafiğini takip eder, arayüzlere saygı duyar ve değişiklikleri kod tabanı genelinde tutarlı kılar. Bu işe yarar çünkü anlamın büyük bölümü yapıya kodlanmıştır.
Veri biliminde etkili bir ajanın kodda gezinmekten fazlasını yapması gerekir. Verinin gerçekte ne içerdiğini anlamalı, adımlar arasında durumu takip etmeli, değişkenlerin kökenini izlemeli ve birkaç adım önce neden bir dönüşüm veya filtrenin uygulandığını muhakeme etmelidir.
Yazılım mühendisliği için inşa edilmiş bir ajan, kendiliğinden veri bilimi işine iyi aktarılamaz. Sorun yalnızca sözdizimi değildir. Temel bilgi yapısı farklıdır.
Defter tarzı iş akışları neden sürüyor
Bu aynı zamanda mühendisleri sıkça şaşırtan bir şeyi de açıklar: bariz sınırlamalarına rağmen defterlerin neden hâlâ bu kadar merkezi olduğu.
Yanıt şu ki defterler, analitik soru hâlâ evrilirken anlamı veriye yakın tutar. Bir defter yalnızca kötü yapılandırılmış bir Python modülü değildir. Farklı bir iş aşaması için üretilmiş farklı bir eserdir. Analiz hâlâ şekillenirken kodu, çıktıları ve kararları birbirine yakın tutar.
Bu nedenle, bağlamın içinde yaşayan analiste sezgisel gelebilirken, yalnızca kodu gören bir ajana garip gelebilir.
Analitik soru netleşmeden bir defteri temiz, modüler koda yeniden düzenlemek çoğu zaman bir iyileştirme değildir. Mantığı, ona ilk anlamını veren bağlamdan ayırabilir.
Fırsat: üretim boşluğunu kapatmak
Veri biliminde yapay zekâ ajanları için gerçek fırsat, yazılım mühendisliğinde zaten işe yarayanı kopyalamak değildir. Üretim boşluğunu kapatmaya yardım etmektir: keşifte bulunan bir içgörü ile yeniden üretilebilir, devreye alınabilir bir iş akışı arasındaki mesafe.
Bu boşluk, defterlerin yapısal temizliği pahasına analitik bağlamı korumasından kaynaklanır. Hem analitik bağlamı hem de üretim sistemlerinin yapısal gereksinimlerini anlayabilen bir ajan, insan analistin keşif modundan çok erken çıkmasına gerek kalmadan bu boşluğu köprüleyebilir.
Bu, bir kod tabanında gezinmekten daha zor bir problemdir. Ama aynı zamanda daha önemli olandır.
Temel Çıkarımlar
İncelenen depolar genelinde analizden çıkanların özeti:
Sonuç
Bu analize başladığımda, veri bilimi kodunun yalnızca yazılım mühendisliği kodundan daha az iyi yapılandırılmış olduğunu bulacağımı sanıyordum. Bunun yerine, anlamın çoğu zaman farklı bir yerde yaşadığı, iyi nedenlerle farklı şekilde yapılandırıldığını gördüm.
Bu, analitik işler için yapay zekâ ajanları geliştiren veya değerlendiren herkes için pratik sonuçlar doğurur. Asıl soru, bir ajanın doğru Python yazıp yazamayacağı değildir. Verinin ne olduğunu, analizin neden bu şekli aldığını ve yalnızca koddan görünmeyen yolda hangi kararların alındığını anlayıp anlamadığıdır.
Veri bilimi kodu, olgunlaşmamış yazılım mühendisliği değildir. Tamamen farklı bir optimizasyondur: haricî duruma daha bağımlı, keşif sırasında kalıcı iç yapıya daha az dayalı ve en az kod kadar bağlam tarafından şekillendirilen.
Bunu bir kez gördüğünüzde, defterler başarısız yazılım projeleri gibi görünmeyi bırakır ve gerçekte olduklarına daha çok benzemeye başlar: değişen veriler üzerinde akıl yürütmeye yönelik çalışma yüzeyleri.
Bu analizi 1.000 veya daha fazla depo ve ek metrikten oluşan daha büyük bir veri setiyle sürdürüyorum. Ajanların bağlam içindeki verilerle nasıl çalışmak üzere inşa edildiğine (oturumlar arasında veri durumunu koruyan kalıcı yürütme mimarileri dahil) daha derinlemesine inmek isterseniz, DataCamp'in AI agent fundamentals track programı sağlam bir başlangıç noktasıdır.