Ik analyseerde honderden GitHub-repositories om te begrijpen waarom AI-codeeragents vaak veel capabeler aanvoelen in software-engineering dan in datasciencewerk. Wat ik vond, suggereert dat dit niet alleen een toolingkloof is. Het weerspiegelt een dieper verschil in waar betekenis leeft in elk soort code.
Waar dit artikel over gaat
Als je een AI-codeeragent hebt gebruikt in een software-engineeringcodebase, heb je waarschijnlijk gezien hoe effectief die kan zijn. De agent navigeert door architectuur, volgt abstracties en voert wijzigingen door die verrassend goed passen bij de rest van het systeem.
Dan open je een datasciencenotebook, en de ervaring verandert vaak.
De agent kan nog steeds geldige code schrijven. Hij kan nog steeds instructies volgen. Maar vaak begrijpt hij niet volledig wat ertoe doet: waarom deze dataset, waarom deze filter, waarom dit tijdvenster, waarom deze output de richting van de analyse heeft veranderd.
Hij behandelt het notebook als een softwareproject, en dat is het maar deels.
Ik wilde begrijpen waarom. Dus analyseerde ik honderden GitHub-repositories in datascience en software-engineering, waarbij ik entropie, referentiepatronen en koppelingsgedrag mat.
Wat ik vond, verbaasde me, en ik denk dat het echte implicaties heeft voor iedereen die AI-agents bouwt of gebruikt in analytisch werk.
De entropie-inversie: datasciencecode is niet wat het lijkt
Wat ik daadwerkelijk heb gemeten
Ik mat Shannon-entropie op drie abstractieniveaus voor elke repository: tekenniveau, tokenniveau en AST-niveau. Elk vangt een andere dimensie van variatie in code.
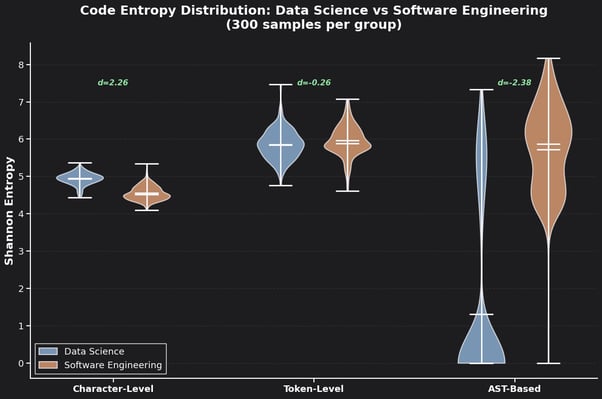
Verdeling van code-entropie: vioolplots voor Data Science vs Software Engineering
Het patroon dat naar voren kwam, is wat ik een entropie-inversie noem.
Het oppervlak oogt complex, de structuur vaak niet
Op tekenniveau heeft datasciencecode de neiging hogere entropie te hebben dan software-engineeringcode. Dat is intuïtief logisch. Datasciencewerk zit vol met uiteenlopende kolomnamen, datasetlabels, ad-hocvariabelen en domeinspecifieke identifiers die de code rommelig en onregelmatig doen lijken.
Op tokenniveau liggen de twee domeinen veel dichter bij elkaar. Ze vertrouwen op veel van dezelfde syntactische bouwstenen.
Maar op AST-niveau, waar we naar structurele diversiteit kijken, draait het beeld om.
Software-engineeringcode encodeert doorgaans veel meer variatie in structuur. Ze creëert meer onderscheidend gedrag via abstracties, interfaces, modules en interne logica.
Datasciencecode daarentegen hergebruikt vaak een kleinere set bewerkingen in wisselende context: laden, filteren, groeperen, aggregeren, visualiseren, inspecteren, bijstellen.
Kort gezegd: datasciencecode oogt vaak complexer aan de oppervlakte, terwijl software-engineeringcode vaak meer complexiteit in de structuur draagt.
Dit is niet alleen een stilistisch verschil. Het wijst op een dieper verschil in hoe de twee soorten werk betekenis opslaan.
Indexicaal vs symbolisch: waar betekenis leeft
Twee verschillende soorten code
De entropie-inversie wordt begrijpelijker als je bedenkt wat elk type code daadwerkelijk doet.
In software-engineering wordt betekenis vaak gecomprimeerd in structuur. Functies, interfaces, modules, types en klassegrenzen doen een groot deel van het werk. Zodra die abstracties zijn vastgesteld, stabiliseren ze gedrag en verminderen ze toekomstige onzekerheid.
Veel van de betekenis zit in de code zelf.
In data science blijft betekenis veel nauwer verbonden met externe context. Het hangt af van de dataset, de kolommen, de tussenresultaten, de aannames achter een transformatie en de zich ontwikkelende vraag die de analist probeert te beantwoorden. De code drukt niet alleen logica uit. Ze wijst naar een specifieke analytische situatie.
Dat verschil is een van de nuttigste manieren om te begrijpen waarom agents zich vaak zo anders gedragen in de twee domeinen.
Je ziet het aan waar de code naartoe “wijst”
Ik mat ook externe en interne referentiedichtheden per 100 regels code in beide groepen.
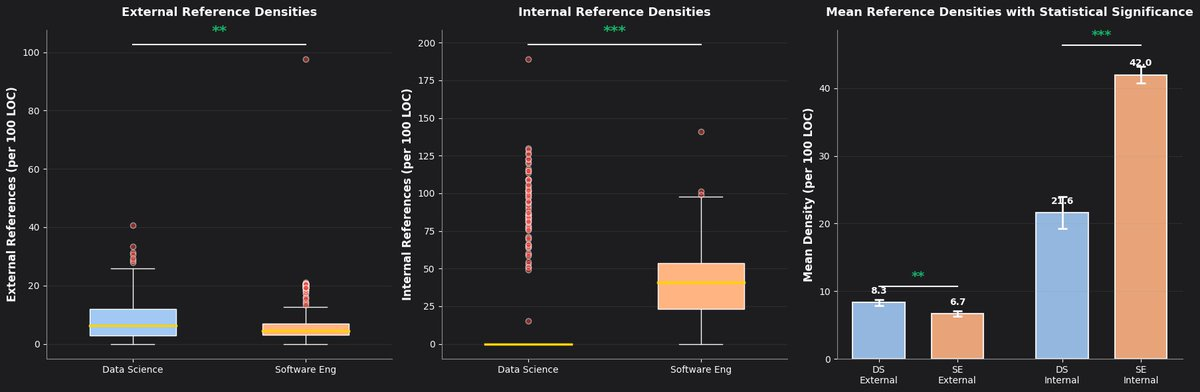
Externe en interne referentiedichtheden met statistische significantie
Het onderscheid is duidelijk. Datasciencecode verwijst vaker naar buiten: naar datasets, tabellen, kolommen, tijdelijke objecten en toestanden die buiten de code zelf bestaan.
Software-engineeringcode is intern meer zelf-referentieel. Ze bouwt vaker betekenis op door te verwijzen naar functies, klassen, modules en abstracties die elders in de codebase zijn gedefinieerd.
Datacode wijst naar buiten. Softwarecode wijst naar binnen.
Dat is belangrijk voor agents. In het ene geval zit veel van de relevante context in de codebase. In het andere zit veel ervan in de omringende analytische toestand.
Waarom dit abstractie anders laat werken
Het koppelingsprobleem in notebooks
Een van de interessantere bevindingen had te maken met koppeling. Werkstromen in notebook-stijl vertoonden veel hechtere koppeling per 100 regels code dan software-engineeringcodebases.
Dat is niet per se slecht ontwerp. Het weerspiegelt iets fundamenteels aan verkennende analyse: de vraag zelf is vaak nog in beweging. Je test aannames, volgt opmerkelijke resultaten, controleert randgevallen en verandert van richting naarmate je leert.
In die setting loont abstractie vaak niet op dezelfde manier als in software-engineering. Voortijdige structuur kan de optionaliteit verminderen voordat je begrijpt wat ertoe doet. Hechtere koppeling is vaak een gevolg van exploratie, niet simpelweg van slechte engineering.
Er is ook een belangrijk verschil in hoe de twee domeinen zichzelf uitleggen.
In software-engineering legt code zichzelf vaak uit via structuur. Types, interfaces en abstracties dragen een groot deel van de betekenis, en comments zijn meestal secundair.
In data science dragen comments, outputs en state vaak een deel van de betekenis. Een aantekening als “uitschieters boven het 99e percentiel verwijderd, bevestigd dat dit de hoofdcategorie niet beïnvloedt” is niet alleen extra documentatie.
Het legt een analytische beslissing vast die mogelijk niet uit de code alleen te herleiden is. Een tabel of plot halverwege het notebook kan verklaren waarom het volgende deel van de analyse überhaupt bestaat.
Dit is belangrijk voor agents. Een agent die comments, inline resultaten en een evoluerende state in een notebook negeert, mist een deel van de analyse. In een software-engineeringcodebase is die informatie vaak aanvullend. In datasciencewerk vaak niet.
Wat dit betekent voor AI-agents
Agents passen standaard goed bij één domein
De praktische implicatie is deze: agents werken het best wanneer hun tools aansluiten op waar de betekenis leeft.
In software-engineering navigeert een effectieve agent door architectuur. Hij volgt de callgraph, respecteert interfaces en houdt wijzigingen consistent in een codebase. Dat werkt omdat veel van de betekenis in de structuur is gecodeerd.
In data science moet een effectieve agent meer doen dan code navigeren. Hij moet begrijpen wat de data daadwerkelijk bevat, state over stappen heen volgen, de herkomst van variabelen traceren en redeneren over waarom een transformatie of filter meerdere stappen eerder is toegepast.
Een agent gebouwd voor software-engineering zal niet automatisch goed overdragen naar datasciencewerk. Het probleem is niet alleen syntax. De onderliggende informatiestructuur is anders.
Waarom werkstromen in notebook-stijl blijven bestaan
Dit helpt ook iets te verklaren dat engineers vaak verbaast: waarom notebooks zo centraal blijven ondanks hun duidelijke beperkingen.
Het antwoord is dat notebooks de betekenis dicht bij de data houden terwijl de analytische vraag nog in ontwikkeling is. Een notebook is niet gewoon een slecht gestructureerde Pythonmodule. Het is een ander artefact, gemaakt voor een andere fase van het werk. Het houdt code, outputs en beslissingen dicht bij elkaar terwijl de analyse nog vorm krijgt.
Daarom kan een notebook intuïtief aanvoelen voor de analist die in de context heeft geleefd, en ongemakkelijk voor een agent die alleen de code ziet.
Een notebook refactoren naar schone, modulaire code voordat de analytische vraag is uitgekristalliseerd, is vaak geen verbetering. Het kan de logica scheiden van de context die haar in de eerste plaats betekenis gaf.
De kans: de productiekloof dichten
De echte kans voor AI-agents in data science is niet simpelweg kopiëren wat al werkt in software-engineering. Het is helpen de productiekloof te dichten: de afstand tussen een inzicht dat in exploratie is gevonden en een reproduceerbare, implementeerbare workflow.
Die kloof bestaat omdat notebooks analytische context behouden ten koste van structurele netheid. Een agent die zowel de analytische context als de structurele vereisten van productiesystemen kan begrijpen, kan die kloof helpen overbruggen zonder de menselijke analist te dwingen te vroeg de verkenningsmodus te verlaten.
Dat is een moeilijker probleem dan navigeren door een codebase. Maar het is ook het belangrijkere.
Belangrijkste inzichten
Samengevat suggereren de analyses over de bestudeerde repositories het volgende:
- Datasciencecode heeft vaak hogere entropie aan de oppervlakte, terwijl software-engineeringcode vaak hogere structurele entropie heeft.
- Datasciencecode verwijst vaker naar externe state, zoals datasets, kolommen, tabellen en tussenresultaten, terwijl software-engineeringcode intern meer zelf-referentieel is.
- Werkstromen in notebook-stijl vertonen de neiging tot hechtere koppeling, wat vaak een gevolg is van exploratie in plaats van simpelweg slechte praktijk.
- Comments, outputs en een evoluerende state maken deel uit van de semantische inhoud van datasciencewerk, niet slechts perifere details.
- Agents die geoptimaliseerd zijn voor software-engineeringcontexten zullen in data science vaak onderpresteren, tenzij ze zijn ontworpen om over data, outputs en context te redeneren naast de codestructuur.
Conclusie
Toen ik met deze analyse begon, verwachtte ik te ontdekken dat datasciencecode simpelweg minder goed gestructureerd was dan software-engineeringcode. In plaats daarvan bleek dat ze om goede redenen anders is gestructureerd, waarbij betekenis vaak op een andere plek leeft.
Dat heeft praktische consequenties voor iedereen die AI-agents bouwt of beoordeelt voor analytisch werk. De echte vraag is niet of een agent correcte Python kan schrijven. Het is of hij begrijpt wat de data is, waarom de analyse de vorm heeft die ze heeft, en welke beslissingen onderweg zijn genomen die niet zichtbaar zijn in alleen de code.
Datasciencecode is geen onvolwassen software-engineering. Het is een heel andere optimalisatie: meer afhankelijk van externe state, minder leunend op duurzame interne structuur tijdens exploratie, en evenzeer gevormd door context als door code.
Als je dat eenmaal ziet, stoppen notebooks met eruitzien als mislukte softwareprojecten en beginnen ze meer te lijken op wat ze echt zijn: werkvlakken om te redeneren over veranderende data.
Ik zet deze analyse voort met een groter dataset van 1.000 of meer repositories en extra metrics. Als je dieper wilt ingaan op hoe AI-agents worden gebouwd om met data in context te werken (inclusief persistente uitvoeringsarchitecturen die datastate over sessies heen behouden), is DataCamp’s AI agent fundamentals track een solide startpunt.




Ik analyseerde honderden GitHub-repositories om te begrijpen waarom AI-codeeragents vaak veel capabeler aanvoelen in software-engineering dan in datasciencewerk. Wat ik vond, suggereert dat dit niet alleen een toolingkloof is. Het weerspiegelt een dieper verschil in waar betekenis leeft in elk soort code.
Waar dit artikel over gaat
Als je een AI-codeeragent hebt gebruikt in een software-engineeringcodebase, heb je waarschijnlijk gezien hoe effectief die kan zijn. De agent navigeert door architectuur, volgt abstracties en voert wijzigingen door die verrassend goed passen bij de rest van het systeem.
Dan open je een datasciencenotebook, en de ervaring verandert vaak.
De agent kan nog steeds geldige code schrijven. Hij kan nog steeds instructies volgen. Maar vaak begrijpt hij niet volledig wat ertoe doet: waarom deze dataset, waarom deze filter, waarom dit tijdvenster, waarom deze output de richting van de analyse heeft veranderd.
Hij behandelt het notebook als een softwareproject, en dat is het maar deels.
Ik wilde begrijpen waarom. Dus analyseerde ik honderden GitHub-repositories in datascience en software-engineering, waarbij ik entropie, referentiepatronen en koppelingsgedrag mat.
Wat ik vond, verbaasde me, en ik denk dat het echte implicaties heeft voor iedereen die AI-agents bouwt of gebruikt in analytisch werk.
De entropie-inversie: datasciencecode is niet wat het lijkt
Wat ik daadwerkelijk heb gemeten
Ik mat Shannon-entropie op drie abstractieniveaus voor elke repository: tekenniveau, tokenniveau en AST-niveau. Elk vangt een andere dimensie van variatie in code.
Verdeling van code-entropie: vioolplots voor Data Science vs Software Engineering
Het patroon dat naar voren kwam, is wat ik een entropie-inversie noem.
Het oppervlak oogt complex, de structuur vaak niet
Op tekenniveau heeft datasciencecode de neiging hogere entropie te hebben dan software-engineeringcode. Dat is intuïtief logisch. Datasciencewerk zit vol met uiteenlopende kolomnamen, datasetlabels, ad-hocvariabelen en domeinspecifieke identifiers die de code rommelig en onregelmatig doen lijken.
Op tokenniveau liggen de twee domeinen veel dichter bij elkaar. Ze vertrouwen op veel van dezelfde syntactische bouwstenen.
Maar op AST-niveau, waar we naar structurele diversiteit kijken, draait het beeld om.
Software-engineeringcode encodeert doorgaans veel meer variatie in structuur. Ze creëert meer onderscheidend gedrag via abstracties, interfaces, modules en interne logica.
Datasciencecode daarentegen hergebruikt vaak een kleinere set bewerkingen in wisselende context: laden, filteren, groeperen, aggregeren, visualiseren, inspecteren, bijstellen.
Kort gezegd: datasciencecode oogt vaak complexer aan de oppervlakte, terwijl software-engineeringcode vaak meer complexiteit in de structuur draagt.
Dit is niet alleen een stilistisch verschil. Het wijst op een dieper verschil in hoe de twee soorten werk betekenis opslaan.
Indexicaal vs symbolisch: waar betekenis leeft
Twee verschillende soorten code
De entropie-inversie wordt begrijpelijker als je bedenkt wat elk type code daadwerkelijk doet.
In software-engineering wordt betekenis vaak gecomprimeerd in structuur. Functies, interfaces, modules, types en klassegrenzen doen een groot deel van het werk. Zodra die abstracties zijn vastgesteld, stabiliseren ze gedrag en verminderen ze toekomstige onzekerheid.
Veel van de betekenis zit in de code zelf.
In data science blijft betekenis veel nauwer verbonden met externe context. Het hangt af van de dataset, de kolommen, de tussenresultaten, de aannames achter een transformatie en de zich ontwikkelende vraag die de analist probeert te beantwoorden. De code drukt niet alleen logica uit. Ze wijst naar een specifieke analytische situatie.
Dat verschil is een van de nuttigste manieren om te begrijpen waarom agents zich vaak zo anders gedragen in de twee domeinen.
Je ziet het aan waar de code naartoe “wijst”
Ik mat ook externe en interne referentiedichtheden per 100 regels code in beide groepen.
Externe en interne referentiedichtheden met statistische significantie
Het onderscheid is duidelijk. Datasciencecode verwijst vaker naar buiten: naar datasets, tabellen, kolommen, tijdelijke objecten en toestanden die buiten de code zelf bestaan.
Software-engineeringcode is intern meer zelf-referentieel. Ze bouwt vaker betekenis op door te verwijzen naar functies, klassen, modules en abstracties die elders in de codebase zijn gedefinieerd.
Datacode wijst naar buiten. Softwarecode wijst naar binnen.
Dat is belangrijk voor agents. In het ene geval zit veel van de relevante context in de codebase. In het andere zit veel ervan in de omringende analytische toestand.
Waarom dit abstractie anders laat werken
Het koppelingsprobleem in notebooks
Een van de interessantere bevindingen had te maken met koppeling. Werkstromen in notebook-stijl vertoonden veel hechtere koppeling per 100 regels code dan software-engineeringcodebases.
Dat is niet per se slecht ontwerp. Het weerspiegelt iets fundamenteels aan verkennende analyse: de vraag zelf is vaak nog in beweging. Je test aannames, volgt opmerkelijke resultaten, controleert randgevallen en verandert van richting naarmate je leert.
In die setting loont abstractie vaak niet op dezelfde manier als in software-engineering. Voortijdige structuur kan de optionaliteit verminderen voordat je begrijpt wat ertoe doet. Hechtere koppeling is vaak een gevolg van exploratie, niet simpelweg van slechte engineering.
De rol van comments en state
Er is ook een belangrijk verschil in hoe de twee domeinen zichzelf uitleggen.
In software-engineering legt code zichzelf vaak uit via structuur. Types, interfaces en abstracties dragen een groot deel van de betekenis, en comments zijn meestal secundair.
In data science dragen comments, outputs en state vaak een deel van de betekenis. Een aantekening als “uitschieters boven het 99e percentiel verwijderd, bevestigd dat dit de hoofdcategorie niet beïnvloedt” is niet alleen extra documentatie.
Het legt een analytische beslissing vast die mogelijk niet uit de code alleen te herleiden is. Een tabel of plot halverwege het notebook kan verklaren waarom het volgende deel van de analyse überhaupt bestaat.
Dit is belangrijk voor agents. Een agent die comments, inline resultaten en een evoluerende state in een notebook negeert, mist een deel van de analyse. In een software-engineeringcodebase is die informatie vaak aanvullend. In datasciencewerk vaak niet.
Wat dit betekent voor AI-agents
Agents passen standaard goed bij één domein
De praktische implicatie is deze: agents werken het best wanneer hun tools aansluiten op waar de betekenis leeft.
In software-engineering navigeert een effectieve agent door architectuur. Hij volgt de callgraph, respecteert interfaces en houdt wijzigingen consistent in een codebase. Dat werkt omdat veel van de betekenis in de structuur is gecodeerd.
In data science moet een effectieve agent meer doen dan code navigeren. Hij moet begrijpen wat de data daadwerkelijk bevat, state over stappen heen volgen, de herkomst van variabelen traceren en redeneren over waarom een transformatie of filter meerdere stappen eerder is toegepast.
Een agent gebouwd voor software-engineering zal niet automatisch goed overdragen naar datasciencewerk. Het probleem is niet alleen syntax. De onderliggende informatiestructuur is anders.
Waarom werkstromen in notebook-stijl blijven bestaan
Dit helpt ook iets te verklaren dat engineers vaak verbaast: waarom notebooks zo centraal blijven ondanks hun duidelijke beperkingen.
Het antwoord is dat notebooks de betekenis dicht bij de data houden terwijl de analytische vraag nog in ontwikkeling is. Een notebook is niet gewoon een slecht gestructureerde Pythonmodule. Het is een ander artefact, gemaakt voor een andere fase van het werk. Het houdt code, outputs en beslissingen dicht bij elkaar terwijl de analyse nog vorm krijgt.
Daarom kan een notebook intuïtief aanvoelen voor de analist die in de context heeft geleefd, en ongemakkelijk voor een agent die alleen de code ziet.
Een notebook refactoren naar schone, modulaire code voordat de analytische vraag is uitgekristalliseerd, is vaak geen verbetering. Het kan de logica scheiden van de context die haar in de eerste plaats betekenis gaf.
De kans: de productiekloof dichten
De echte kans voor AI-agents in data science is niet simpelweg kopiëren wat al werkt in software-engineering. Het is helpen de productiekloof te dichten: de afstand tussen een inzicht dat in exploratie is gevonden en een reproduceerbare, implementeerbare workflow.
Die kloof bestaat omdat notebooks analytische context behouden ten koste van structurele netheid. Een agent die zowel de analytische context als de structurele vereisten van productiesystemen kan begrijpen, kan die kloof helpen overbruggen zonder de menselijke analist te dwingen te vroeg de verkenningsmodus te verlaten.
Dat is een moeilijker probleem dan navigeren door een codebase. Maar het is ook het belangrijkere.
Belangrijkste inzichten
Samengevat suggereren de analyses over de bestudeerde repositories het volgende:
Conclusie
Toen ik met deze analyse begon, verwachtte ik te ontdekken dat datasciencecode simpelweg minder goed gestructureerd was dan software-engineeringcode. In plaats daarvan bleek dat ze om goede redenen anders is gestructureerd, waarbij betekenis vaak op een andere plek leeft.
Dat heeft praktische consequenties voor iedereen die AI-agents bouwt of beoordeelt voor analytisch werk. De echte vraag is niet of een agent correcte Python kan schrijven. Het is of hij begrijpt wat de data is, waarom de analyse de vorm heeft die ze heeft, en welke beslissingen onderweg zijn genomen die niet zichtbaar zijn in alleen de code.
Datasciencecode is geen onvolwassen software-engineering. Het is een heel andere optimalisatie: meer afhankelijk van externe state, minder leunend op duurzame interne structuur tijdens exploratie, en evenzeer gevormd door context als door code.
Als je dat eenmaal ziet, stoppen notebooks met eruitzien als mislukte softwareprojecten en beginnen ze meer te lijken op wat ze echt zijn: werkvlakken om te redeneren over veranderende data.
Ik zet deze analyse voort met een groter dataset van 1.000 of meer repositories en extra metrics. Als je dieper wilt ingaan op hoe AI-agents worden gebouwd om met data in context te werken (inclusief persistente uitvoeringsarchitecturen die datastate over sessies heen behouden), is DataCamp’s AI agent fundamentals track een solide startpunt.