Cursus
Principes fondamentaux des agents IA
6 h
J’ai analysé des centaines de dépôts GitHub pour comprendre pourquoi les agents de codage IA paraissent souvent beaucoup plus compétents en génie logiciel qu’en data science. Ce que j’ai découvert montre qu’il ne s’agit pas seulement d’un écart d’outillage. Cela renvoie à une différence plus profonde : l’endroit où se loge le sens dans chaque type de code.
Si vous avez utilisé un agent de codage IA sur une base de code de génie logiciel, vous avez sans doute constaté son efficacité. L’agent navigue dans l’architecture, suit les abstractions et apporte des modifications qui s’intègrent étonnamment bien au reste du système.
Puis vous ouvrez un notebook de data science, et l’expérience change souvent.
L’agent sait toujours écrire du code valide. Il sait toujours suivre des instructions. Mais il ne saisit pas toujours l’essentiel : pourquoi ce jeu de données, pourquoi ce filtre, pourquoi cette fenêtre temporelle, pourquoi cette sortie a changé l’orientation de l’analyse.
Il traite le notebook comme un projet logiciel, alors que ce n’en est qu’une partie.
Je voulais comprendre pourquoi. J’ai donc analysé des centaines de dépôts GitHub en data science et en génie logiciel, en mesurant l’entropie, les schémas de référence et les comportements de couplage.
Mes conclusions m’ont surpris, et je pense qu’elles ont de vraies implications pour quiconque construit ou utilise des agents d’IA dans des travaux analytiques.
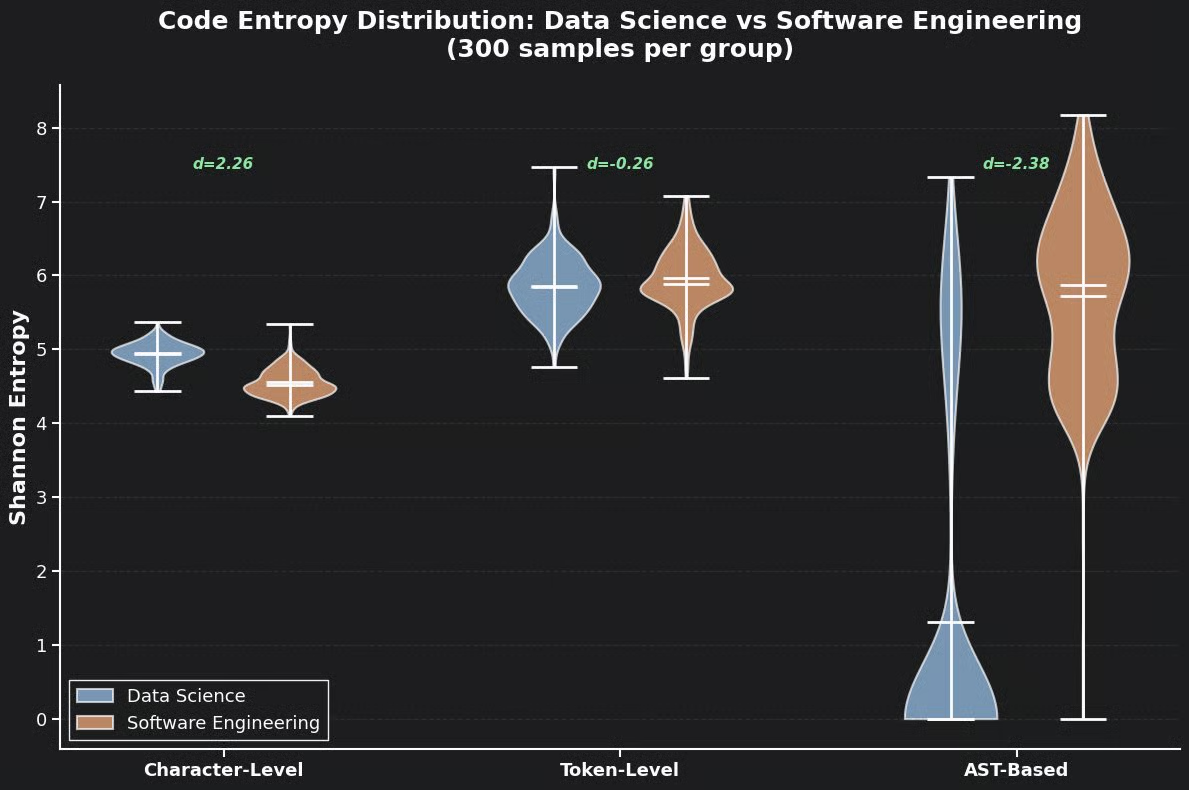
J’ai mesuré l’entropie de Shannon à trois niveaux d’abstraction pour chaque dépôt : au niveau caractère, au niveau jeton, et au niveau AST. Chacun capture une dimension différente de la variation du code.
Distribution de l’entropie du code : data science vs génie logiciel (violons)
Le motif qui émerge est ce que j’appelle une inversion d’entropie.
Au niveau caractère, le code de data science a tendance à présenter une entropie plus élevée que le code de génie logiciel. Cela paraît intuitif. La data science fourmille de noms de colonnes variés, d’étiquettes de jeux de données, de variables ad hoc et d’identifiants spécifiques au domaine qui rendent le code bruyant et irrégulier.
Au niveau jeton, les deux domaines sont bien plus proches. Ils s’appuient en grande partie sur les mêmes briques syntaxiques.
Mais au niveau AST, où l’on observe la diversité structurelle, l’image s’inverse.
Le code de génie logiciel encode généralement bien plus de variation structurelle. Il crée des comportements distincts via des abstractions, interfaces, modules et une logique interne.
Le code de data science, à l’inverse, réutilise souvent un plus petit ensemble d’opérations dans des contextes changeants : charger, filtrer, grouper, agréger, visualiser, inspecter, ajuster.
En bref, le code de data science paraît souvent plus complexe en surface, tandis que le code de génie logiciel porte davantage de complexité dans sa structure.
Ce n’est pas qu’une différence de style. Cela révèle une divergence plus profonde dans la manière dont chaque type de travail stocke le sens.
L’inversion d’entropie s’explique mieux si l’on considère ce que fait réellement chaque type de code.
En génie logiciel, le sens est souvent compressé dans la structure. Fonctions, interfaces, modules, types et frontières des classes font l’essentiel du travail. Une fois ces abstractions établies, elles stabilisent les comportements et réduisent l’incertitude future.
Une grande part du sens est à l’intérieur même du code.
En data science, le sens reste bien plus étroitement lié au contexte externe. Il dépend du jeu de données, des colonnes, des sorties intermédiaires, des hypothèses derrière une transformation et de la question qui évolue au fil de l’analyse. Le code n’exprime pas seulement une logique ; il renvoie à une situation analytique précise.
Cette différence aide à comprendre pourquoi les agents se comportent souvent si différemment dans les deux domaines.
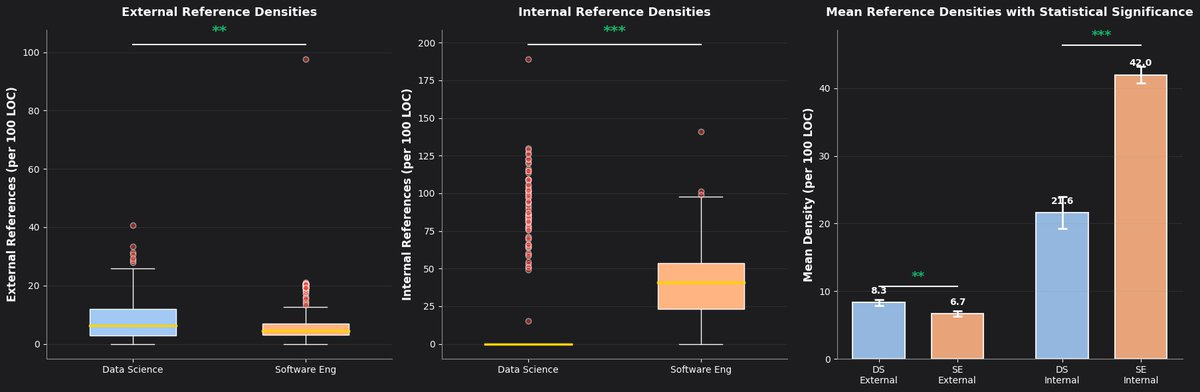
J’ai également mesuré les densités de références externes et internes pour 100 lignes de code dans les deux groupes.
Densités de références externes et internes avec significativité statistique
La différence est nette. Le code de data science renvoie plus souvent vers l’extérieur : jeux de données, tables, colonnes, objets temporaires et états qui existent en dehors du code lui‑même.
Le code de génie logiciel est plus auto‑référentiel. Il construit plus souvent le sens en pointant vers des fonctions, classes, modules et abstractions définis ailleurs dans la base de code.
Le code « data » pointe vers l’extérieur. Le code logiciel pointe vers l’intérieur.
Et cela compte pour les agents. Dans un cas, une grande partie du contexte pertinent est dans la base de code. Dans l’autre, il réside dans l’état analytique environnant.
L’une des observations intéressantes concerne le couplage. Les workflows de type notebook montrent un couplage nettement plus serré pour 100 lignes de code que les bases de code en génie logiciel.
Ce n’est pas nécessairement une mauvaise conception. Cela reflète quelque chose de fondamental dans l’exploration : la question elle‑même évolue encore. Vous testez des hypothèses, suivez des résultats inattendus, vérifiez des cas limites et changez de direction au fur et à mesure que vous apprenez.
Dans ce contexte, l’abstraction ne paie pas forcément comme en génie logiciel. Structurer trop tôt peut réduire les options avant même de comprendre l’essentiel. Un couplage plus serré est souvent une conséquence de l’exploration, pas simplement d’une mauvaise ingénierie.
Il existe aussi une différence importante dans la manière dont les deux domaines s’expliquent.
En génie logiciel, le code s’explique souvent par sa structure. Les types, interfaces et abstractions portent l’essentiel du sens, et les commentaires sont généralement secondaires.
En data science, les commentaires, les sorties et l’état portent souvent une partie du sens. Une note du type « suppression des valeurs aberrantes au‑delà du 99e percentile, confirmé que cela n’affecte pas la cohorte principale » n’est pas une simple documentation.
Elle capture une décision analytique qui peut ne pas être récupérable à partir du seul code. Une table ou un graphique au milieu du notebook peut expliquer pourquoi la suite de l’analyse existe tout court.
Cela compte pour les agents. Un agent qui ignore les commentaires, les résultats en ligne et l’état évolutif d’un notebook passe à côté d’une partie de l’analyse. Dans une base de code logicielle, ces informations sont souvent périphériques. En data science, souvent non.
Conséquence pratique : les agents fonctionnent au mieux lorsque leurs outils correspondent à l’endroit où se trouve le sens.
En génie logiciel, un agent efficace navigue dans l’architecture. Il suit le graphe d’appels, respecte les interfaces et maintient la cohérence des changements dans toute la base de code. Cela fonctionne parce qu’une grande partie du sens est encodée dans la structure.
En data science, un agent efficace doit faire plus que naviguer dans le code. Il doit comprendre ce que contiennent réellement les données, suivre l’état au fil des étapes, retracer la provenance des variables et raisonner sur les raisons d’une transformation ou d’un filtre appliqué plusieurs étapes plus tôt.
Un agent conçu pour le génie logiciel ne se transpose pas automatiquement à la data science. Le problème n’est pas seulement syntaxique. La structure informationnelle sous‑jacente est différente.
Cela aide aussi à expliquer ce qui déroute souvent les ingénieurs : pourquoi les notebooks restent centraux malgré leurs limites évidentes.
La raison est que les notebooks gardent le sens au plus près des données tant que la question analytique évolue. Un notebook n’est pas simplement un module Python mal structuré. C’est un artefact différent, conçu pour une phase de travail différente. Il maintient code, sorties et décisions au même endroit tant que l’analyse se construit.
C’est pourquoi un notebook peut sembler intuitif à l’analyste immergé dans le contexte, et maladroit pour un agent qui ne voit que le code.
Refactorer un notebook en code propre et modulaire avant que la question analytique ne soit stabilisée n’est pas toujours une amélioration. Cela peut détacher la logique du contexte qui lui donnait son sens.
La vraie opportunité pour les agents d’IA en data science n’est pas de copier ce qui marche en génie logiciel. C’est d’aider à combler le fossé de mise en production : la distance entre un insight découvert en exploration et un workflow reproductible et déployable.
Ce fossé existe parce que les notebooks préservent le contexte analytique au prix d’une propreté structurelle. Un agent capable de comprendre à la fois le contexte analytique et les exigences structurelles des systèmes de production pourrait combler ce fossé sans forcer l’analyste humain à quitter trop tôt le mode exploratoire.
C’est un problème plus difficile que de naviguer dans une base de code. Mais c’est aussi le plus important.
En résumé, ce que suggère l’analyse des dépôts étudiés :
Au lancement de cette analyse, je m’attendais à constater que le code de data science était simplement moins bien structuré que le code de génie logiciel. J’ai au contraire trouvé qu’il est structuré différemment pour de bonnes raisons, le sens résidant souvent ailleurs.
Cela a des conséquences concrètes pour quiconque conçoit ou évalue des agents d’IA pour des travaux analytiques. La vraie question n’est pas de savoir si un agent peut écrire du Python correct, mais s’il comprend ce que sont les données, pourquoi l’analyse prend telle forme et quelles décisions ont été prises en chemin et qui ne sont pas visibles dans le seul code.
Le code de data science n’est pas un génie logiciel immature. C’est une optimisation d’une autre nature : plus dépendante de l’état externe, moins tributaire d’une structure interne durable pendant l’exploration, et façonnée autant par le contexte que par le code.
Une fois que l’on voit cela, les notebooks cessent de ressembler à des projets logiciels ratés et apparaissent pour ce qu’ils sont : des surfaces de travail pour raisonner sur des données changeantes.
Je poursuis cette analyse avec un corpus élargi d’au moins 1 000 dépôts et des métriques supplémentaires. Si vous souhaitez approfondir la manière dont les agents d’IA sont conçus pour travailler avec les données dans leur contexte (y compris des architectures d’exécution persistantes qui maintiennent l’état des données entre les sessions), le parcours AI agent fundamentals de DataCamp est un excellent point de départ.
Les meilleurs cours DataCamp
Cursus
Cours
Cours