Tôi đã phân tích hàng trăm kho GitHub để hiểu vì sao các tác nhân lập trình AI thường tỏ ra tự tin hơn nhiều trong kỹ thuật phần mềm so với công việc khoa học dữ liệu. Những gì tôi tìm thấy cho thấy đây không chỉ là khoảng trống về công cụ. Nó phản ánh một khác biệt sâu hơn về nơi mà ý nghĩa "sống" trong từng loại mã.
Bài viết này nói về điều gì
Nếu bạn đã dùng một tác nhân lập trình AI trong một codebase kỹ thuật phần mềm, có lẽ bạn đã thấy nó hiệu quả thế nào. Tác nhân điều hướng kiến trúc, tuân theo các trừu tượng và thực hiện những thay đổi hòa hợp đáng ngạc nhiên với phần còn lại của hệ thống.
Sau đó bạn mở một notebook khoa học dữ liệu, và trải nghiệm thường thay đổi.
Tác nhân vẫn có thể viết mã hợp lệ. Nó vẫn có thể làm theo hướng dẫn. Nhưng thường không nắm bắt được điều cốt yếu: vì sao là bộ dữ liệu này, vì sao là bộ lọc này, vì sao là khung thời gian này, vì sao đầu ra này lại thay đổi hướng của phân tích.
Nó coi notebook như một dự án phần mềm, trong khi đó chỉ là một phần của bản chất notebook.
Tôi muốn hiểu lý do. Vì vậy, tôi đã phân tích hàng trăm kho GitHub ở cả khoa học dữ liệu và kỹ thuật phần mềm, đo lường entropy, các mẫu tham chiếu và hành vi ghép nối.
Những gì tôi tìm thấy khiến tôi bất ngờ, và tôi nghĩ nó có hàm ý thực tế cho bất kỳ ai đang xây dựng hoặc sử dụng tác nhân AI trong công việc phân tích.
Sự đảo ngược entropy: Mã Khoa học Dữ liệu không như bề ngoài
Tôi thực sự đã đo gì
Tôi đo entropy Shannon ở ba mức trừu tượng cho mỗi kho: cấp ký tự, cấp token và cấp AST. Mỗi mức phản ánh một chiều biến thiên khác nhau trong mã.
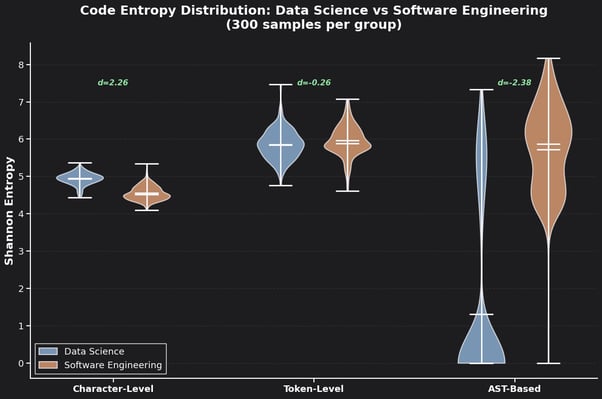
Phân bố Entropy của Mã: Khoa học Dữ liệu vs Kỹ thuật Phần mềm (biểu đồ violin)
Mẫu hình xuất hiện là điều tôi gọi là sự đảo ngược entropy.
Bề mặt trông phức tạp, cấu trúc thì thường không
Ở cấp ký tự, mã khoa học dữ liệu có xu hướng có entropy cao hơn mã kỹ thuật phần mềm. Điều đó khá trực quan. Công việc khoa học dữ liệu đầy những tên cột đa dạng, nhãn bộ dữ liệu, biến ad hoc và định danh theo miền khiến mã trông ồn ào và bất quy tắc.
Ở cấp token, hai lĩnh vực gần nhau hơn nhiều. Chúng dựa vào nhiều khối xây dựng cú pháp giống nhau.
Nhưng ở cấp AST, nơi ta nhìn vào tính đa dạng cấu trúc, bức tranh lại đảo chiều.
Mã kỹ thuật phần mềm có xu hướng mã hóa nhiều biến thiên về cấu trúc hơn. Nó tạo ra nhiều hành vi khác biệt thông qua các trừu tượng, giao diện, mô-đun và logic nội bộ.
Ngược lại, mã khoa học dữ liệu thường tái sử dụng một tập thao tác nhỏ trong các ngữ cảnh thay đổi: nạp, lọc, nhóm, tổng hợp, trực quan hóa, kiểm tra, điều chỉnh.
Nói ngắn gọn, mã khoa học dữ liệu thường trông phức tạp hơn ở bề mặt, trong khi mã kỹ thuật phần mềm thường mang nhiều phức tạp ở cấu trúc.
Đây không chỉ là khác biệt về phong cách. Nó chỉ ra một khác biệt sâu hơn về cách hai loại công việc lưu trữ ý nghĩa.
Chỉ xuất vs Ký hiệu: Nơi ý nghĩa trú ngụ
Hai kiểu mã khác nhau
Sự đảo ngược entropy trở nên dễ hiểu hơn khi bạn nghĩ về việc mỗi loại mã thực sự đang làm gì.
Trong kỹ thuật phần mềm, ý nghĩa thường được nén vào cấu trúc. Hàm, giao diện, mô-đun, kiểu và ranh giới lớp đảm đương phần lớn công việc. Một khi các trừu tượng đó được thiết lập, chúng ổn định hành vi và giảm bất định trong tương lai.
Phần lớn ý nghĩa nằm bên trong chính mã nguồn.
Trong khoa học dữ liệu, ý nghĩa gắn chặt với ngữ cảnh bên ngoài hơn nhiều. Nó phụ thuộc vào bộ dữ liệu, các cột, các đầu ra trung gian, các giả định đằng sau một phép biến đổi và câu hỏi đang phát triển mà nhà phân tích cố gắng trả lời. Mã không chỉ biểu đạt logic. Nó đang chỉ đến một tình huống phân tích cụ thể.
Khác biệt đó là một trong những cách hữu ích nhất để hiểu vì sao tác nhân thường hành xử rất khác nhau ở hai miền.
Bạn có thể thấy điều đó ở chỗ mã "chỉ" đến
Tôi cũng đo mật độ tham chiếu bên ngoài và bên trong trên mỗi 100 dòng mã ở cả hai nhóm.
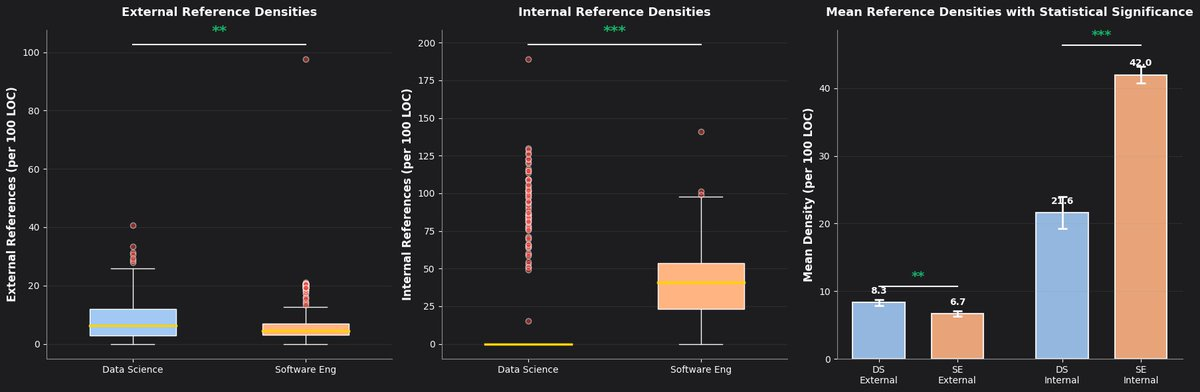
Mật độ Tham chiếu Bên ngoài và Bên trong với ý nghĩa thống kê
Sự khác biệt rất rõ ràng. Mã khoa học dữ liệu thường tham chiếu ra bên ngoài nhiều hơn: tới các bộ dữ liệu, bảng, cột, đối tượng tạm và các trạng thái tồn tại ngoài bản thân mã.
Mã kỹ thuật phần mềm mang tính tự tham chiếu nội bộ nhiều hơn. Nó xây dựng ý nghĩa thường xuyên hơn bằng cách trỏ tới các hàm, lớp, mô-đun và trừu tượng được định nghĩa ở nơi khác trong codebase.
Mã dữ liệu trỏ ra ngoài. Mã phần mềm trỏ vào trong.
Điều đó quan trọng với tác nhân. Trong một trường hợp, phần lớn ngữ cảnh liên quan nằm trong codebase. Ở trường hợp kia, phần lớn lại nằm trong trạng thái phân tích bao quanh.
Vì sao điều này khiến trừu tượng vận hành khác đi
Vấn đề ghép nối trong notebook
Một phát hiện thú vị là về ghép nối. Quy trình kiểu notebook cho thấy mức ghép nối chặt chẽ hơn trên mỗi 100 dòng mã so với codebase kỹ thuật phần mềm.
Điều đó không nhất thiết là thiết kế tệ. Nó phản ánh điều cốt lõi của phân tích khám phá: bản thân câu hỏi thường vẫn đang dịch chuyển. Bạn đang kiểm định giả định, lần theo các kết quả lạ, kiểm tra trường hợp biên và đổi hướng khi học thêm điều mới.
Trong bối cảnh đó, trừu tượng thường không mang lại lợi ích theo cách như trong kỹ thuật phần mềm. Cấu trúc sớm có thể làm giảm tính linh hoạt trước khi bạn hiểu điều gì là quan trọng. Ghép nối chặt chẽ thường là hệ quả của khám phá, chứ không đơn thuần là kỹ nghệ kém.
Vai trò của chú thích và trạng thái
Cũng có một khác biệt quan trọng trong cách hai lĩnh vực tự giải thích.
Trong kỹ thuật phần mềm, mã thường tự giải thích qua cấu trúc. Kiểu dữ liệu, giao diện và trừu tượng mang phần lớn ý nghĩa, và chú thích thường là thứ yếu.
Trong khoa học dữ liệu, chú thích, đầu ra và trạng thái thường mang một phần ý nghĩa. Một ghi chú như “loại bỏ ngoại lệ trên bách phân vị 99, xác nhận điều này không ảnh hưởng nhóm chính” không chỉ là tài liệu bổ sung.
Nó ghi lại một quyết định phân tích có thể không khôi phục được chỉ từ mã. Một bảng hoặc biểu đồ giữa chừng notebook có thể giải thích vì sao phần tiếp theo của phân tích tồn tại.
Điều này quan trọng với tác nhân. Một tác nhân bỏ qua chú thích, kết quả nội tuyến và trạng thái đang tiến hóa trong notebook là bỏ sót một phần của phân tích. Trong codebase kỹ thuật phần mềm, thông tin đó thường mang tính bổ trợ. Trong công việc khoa học dữ liệu, thường không phải vậy.
Điều này có ý nghĩa gì cho tác nhân AI
Tác nhân mặc định phù hợp với một miền
Hệ quả thực tế là: tác nhân hoạt động tốt nhất khi công cụ của chúng phù hợp với nơi ý nghĩa trú ngụ.
Trong kỹ thuật phần mềm, một tác nhân hiệu quả điều hướng kiến trúc. Nó theo đồ thị lời gọi, tôn trọng giao diện và giữ cho các thay đổi nhất quán trong toàn codebase. Điều đó hiệu quả vì phần lớn ý nghĩa được mã hóa trong cấu trúc.
Trong khoa học dữ liệu, một tác nhân hiệu quả cần làm nhiều hơn điều hướng mã. Nó cần hiểu dữ liệu thực sự chứa gì, theo dõi trạng thái qua các bước, lần theo nguồn gốc biến và lý giải vì sao một biến đổi hay bộ lọc đã được áp dụng từ vài bước trước.
Một tác nhân xây cho kỹ thuật phần mềm sẽ không tự động chuyển giao tốt sang công việc khoa học dữ liệu. Vấn đề không chỉ là cú pháp. Cấu trúc thông tin nền tảng là khác nhau.
Vì sao quy trình kiểu notebook vẫn tồn tại
Điều này cũng giúp giải thích một điều thường làm kỹ sư thắc mắc: vì sao notebook vẫn giữ vai trò trung tâm dù có những hạn chế rõ ràng.
Câu trả lời là notebook giữ ý nghĩa gần với dữ liệu khi câu hỏi phân tích vẫn đang tiến hóa. Notebook không chỉ là một mô-đun Python có cấu trúc tệ. Nó là một tạo phẩm khác, được xây cho một giai đoạn công việc khác. Nó giữ mã, đầu ra và quyết định cạnh nhau khi phân tích còn đang định hình.
Đó là lý do notebook có thể trực quan với nhà phân tích đang sống trong ngữ cảnh đó, nhưng lại gượng gạo với một tác nhân chỉ nhìn thấy mã.
Tái cấu trúc một notebook thành mã sạch, mô-đun trước khi câu hỏi phân tích được chốt thường không phải là cải tiến. Nó có thể tách logic khỏi ngữ cảnh vốn mang lại ý nghĩa cho nó ngay từ đầu.
Cơ hội: thu hẹp khoảng cách sản xuất
Cơ hội thực sự cho tác nhân AI trong khoa học dữ liệu không chỉ là sao chép những gì đã hiệu quả trong kỹ thuật phần mềm. Đó là giúp thu hẹp khoảng cách sản xuất: quãng đường giữa một phát hiện trong khám phá và một quy trình có thể tái lập, có thể triển khai.
Khoảng cách đó tồn tại vì notebook bảo toàn ngữ cảnh phân tích với cái giá là sự gọn gàng cấu trúc. Một tác nhân có thể hiểu cả ngữ cảnh phân tích và yêu cầu cấu trúc của hệ thống sản xuất có thể giúp bắc cầu khoảng cách đó mà không buộc nhà phân tích rời chế độ khám phá quá sớm.
Đó là bài toán khó hơn việc điều hướng một codebase. Nhưng cũng là bài toán quan trọng hơn.
Điểm chính rút ra
Tóm lược những gì phân tích gợi ý trên các kho đã nghiên cứu:
- Mã khoa học dữ liệu thường có entropy cấp bề mặt cao hơn, trong khi mã kỹ thuật phần mềm thường có entropy cấp cấu trúc cao hơn.
- Mã khoa học dữ liệu thường tham chiếu đến trạng thái bên ngoài như bộ dữ liệu, cột, bảng và đầu ra trung gian thường xuyên hơn, trong khi mã kỹ thuật phần mềm mang tính tự tham chiếu nội bộ hơn.
- Quy trình kiểu notebook có xu hướng thể hiện ghép nối chặt chẽ hơn, điều này thường là hệ quả của khám phá chứ không đơn thuần là thực hành kém.
- Chú thích, đầu ra và trạng thái tiến hóa là một phần nội dung ngữ nghĩa của công việc khoa học dữ liệu, không chỉ là chi tiết ngoại vi.
- Các tác nhân được tối ưu cho bối cảnh kỹ thuật phần mềm sẽ thường hoạt động kém trong khoa học dữ liệu trừ khi chúng được thiết kế để suy luận trên dữ liệu, đầu ra và ngữ cảnh song song với cấu trúc mã.
Kết luận
Khi bắt đầu phân tích này, tôi kỳ vọng sẽ thấy mã khoa học dữ liệu đơn giản là kém cấu trúc hơn mã kỹ thuật phần mềm. Thay vào đó, tôi nhận ra nó được cấu trúc khác đi vì những lý do chính đáng, với ý nghĩa thường trú ở một nơi khác.
Điều đó có hệ quả thực tế cho bất kỳ ai đang xây dựng hoặc đánh giá tác nhân AI cho công việc phân tích. Câu hỏi thực sự không phải là liệu một tác nhân có thể viết Python đúng hay không. Mà là liệu nó có hiểu dữ liệu là gì, vì sao phân tích có hình hài như vậy, và những quyết định nào đã được đưa ra trên đường đi mà không thể nhìn thấy chỉ từ mã.
Mã khoa học dữ liệu không phải là kỹ thuật phần mềm chưa trưởng thành. Đó là một tối ưu hóa hoàn toàn khác: phụ thuộc nhiều hơn vào trạng thái bên ngoài, ít dựa vào cấu trúc nội bộ bền vững trong giai đoạn khám phá, và được định hình bởi ngữ cảnh cũng như bởi mã.
Khi bạn thấy điều đó, notebook sẽ không còn giống những dự án phần mềm thất bại, mà đúng hơn là những bề mặt làm việc để suy luận trên dữ liệu đang thay đổi.
Tôi đang tiếp tục phân tích này với một bộ dữ liệu lớn hơn gồm từ 1.000 kho trở lên và các chỉ số bổ sung. Nếu bạn muốn tìm hiểu sâu hơn về cách các tác nhân AI được xây dựng để làm việc với dữ liệu trong ngữ cảnh (bao gồm các kiến trúc thực thi bền bỉ duy trì trạng thái dữ liệu qua nhiều phiên), lộ trình nền tảng về tác nhân AI của DataCamp là một điểm khởi đầu vững chắc.


Tôi đã phân tích hàng trăm kho GitHub để hiểu vì sao các tác nhân lập trình AI thường tỏ ra tự tin hơn nhiều trong kỹ thuật phần mềm so với công việc khoa học dữ liệu. Những gì tôi tìm thấy cho thấy đây không chỉ là khoảng trống về công cụ. Nó phản ánh một khác biệt sâu hơn về nơi mà ý nghĩa "sống" trong từng loại mã.
Bài viết này nói về điều gì
Nếu bạn đã dùng một tác nhân lập trình AI trong một codebase kỹ thuật phần mềm, có lẽ bạn đã thấy nó hiệu quả thế nào. Tác nhân điều hướng kiến trúc, tuân theo các trừu tượng và thực hiện những thay đổi hòa hợp đáng ngạc nhiên với phần còn lại của hệ thống.
Sau đó bạn mở một notebook khoa học dữ liệu, và trải nghiệm thường thay đổi.
Tác nhân vẫn có thể viết mã hợp lệ. Nó vẫn có thể làm theo hướng dẫn. Nhưng thường không nắm bắt được điều cốt yếu: vì sao là bộ dữ liệu này, vì sao là bộ lọc này, vì sao là khung thời gian này, vì sao đầu ra này lại thay đổi hướng của phân tích.
Nó coi notebook như một dự án phần mềm, trong khi đó chỉ là một phần của bản chất notebook.
Tôi muốn hiểu lý do. Vì vậy, tôi đã phân tích hàng trăm kho GitHub ở cả khoa học dữ liệu và kỹ thuật phần mềm, đo lường entropy, các mẫu tham chiếu và hành vi ghép nối.
Những gì tôi tìm thấy khiến tôi bất ngờ, và tôi nghĩ nó có hàm ý thực tế cho bất kỳ ai đang xây dựng hoặc sử dụng tác nhân AI trong công việc phân tích.
Sự đảo ngược entropy: Mã Khoa học Dữ liệu không như bề ngoài
Tôi thực sự đã đo gì
Tôi đo entropy Shannon ở ba mức trừu tượng cho mỗi kho: cấp ký tự, cấp token và cấp AST. Mỗi mức phản ánh một chiều biến thiên khác nhau trong mã.
Phân bố Entropy của Mã: Khoa học Dữ liệu vs Kỹ thuật Phần mềm (biểu đồ violin)
Mẫu hình xuất hiện là điều tôi gọi là sự đảo ngược entropy.
Bề mặt trông phức tạp, cấu trúc thì thường không
Ở cấp ký tự, mã khoa học dữ liệu có xu hướng có entropy cao hơn mã kỹ thuật phần mềm. Điều đó khá trực quan. Công việc khoa học dữ liệu đầy những tên cột đa dạng, nhãn bộ dữ liệu, biến ad hoc và định danh theo miền khiến mã trông ồn ào và bất quy tắc.
Ở cấp token, hai lĩnh vực gần nhau hơn nhiều. Chúng dựa vào nhiều khối xây dựng cú pháp giống nhau.
Nhưng ở cấp AST, nơi ta nhìn vào tính đa dạng cấu trúc, bức tranh lại đảo chiều.
Mã kỹ thuật phần mềm có xu hướng mã hóa nhiều biến thiên về cấu trúc hơn. Nó tạo ra nhiều hành vi khác biệt thông qua các trừu tượng, giao diện, mô-đun và logic nội bộ.
Ngược lại, mã khoa học dữ liệu thường tái sử dụng một tập thao tác nhỏ trong các ngữ cảnh thay đổi: nạp, lọc, nhóm, tổng hợp, trực quan hóa, kiểm tra, điều chỉnh.
Nói ngắn gọn, mã khoa học dữ liệu thường trông phức tạp hơn ở bề mặt, trong khi mã kỹ thuật phần mềm thường mang nhiều phức tạp ở cấu trúc.
Đây không chỉ là khác biệt về phong cách. Nó chỉ ra một khác biệt sâu hơn về cách hai loại công việc lưu trữ ý nghĩa.
Chỉ xuất vs Ký hiệu: Nơi ý nghĩa trú ngụ
Hai kiểu mã khác nhau
Sự đảo ngược entropy trở nên dễ hiểu hơn khi bạn nghĩ về việc mỗi loại mã thực sự đang làm gì.
Trong kỹ thuật phần mềm, ý nghĩa thường được nén vào cấu trúc. Hàm, giao diện, mô-đun, kiểu và ranh giới lớp đảm đương phần lớn công việc. Một khi các trừu tượng đó được thiết lập, chúng ổn định hành vi và giảm bất định trong tương lai.
Phần lớn ý nghĩa nằm bên trong chính mã nguồn.
Trong khoa học dữ liệu, ý nghĩa gắn chặt với ngữ cảnh bên ngoài hơn nhiều. Nó phụ thuộc vào bộ dữ liệu, các cột, các đầu ra trung gian, các giả định đằng sau một phép biến đổi và câu hỏi đang phát triển mà nhà phân tích cố gắng trả lời. Mã không chỉ biểu đạt logic. Nó đang chỉ đến một tình huống phân tích cụ thể.
Khác biệt đó là một trong những cách hữu ích nhất để hiểu vì sao tác nhân thường hành xử rất khác nhau ở hai miền.
Bạn có thể thấy điều đó ở chỗ mã "chỉ" đến
Tôi cũng đo mật độ tham chiếu bên ngoài và bên trong trên mỗi 100 dòng mã ở cả hai nhóm.
Mật độ Tham chiếu Bên ngoài và Bên trong với ý nghĩa thống kê
Sự khác biệt rất rõ ràng. Mã khoa học dữ liệu thường tham chiếu ra bên ngoài nhiều hơn: tới các bộ dữ liệu, bảng, cột, đối tượng tạm và các trạng thái tồn tại ngoài bản thân mã.
Mã kỹ thuật phần mềm mang tính tự tham chiếu nội bộ nhiều hơn. Nó xây dựng ý nghĩa thường xuyên hơn bằng cách trỏ tới các hàm, lớp, mô-đun và trừu tượng được định nghĩa ở nơi khác trong codebase.
Mã dữ liệu trỏ ra ngoài. Mã phần mềm trỏ vào trong.
Điều đó quan trọng với tác nhân. Trong một trường hợp, phần lớn ngữ cảnh liên quan nằm trong codebase. Ở trường hợp kia, phần lớn lại nằm trong trạng thái phân tích bao quanh.
Vì sao điều này khiến trừu tượng vận hành khác đi
Vấn đề ghép nối trong notebook
Một phát hiện thú vị là về ghép nối. Quy trình kiểu notebook cho thấy mức ghép nối chặt chẽ hơn trên mỗi 100 dòng mã so với codebase kỹ thuật phần mềm.
Điều đó không nhất thiết là thiết kế tệ. Nó phản ánh điều cốt lõi của phân tích khám phá: bản thân câu hỏi thường vẫn đang dịch chuyển. Bạn đang kiểm định giả định, lần theo các kết quả lạ, kiểm tra trường hợp biên và đổi hướng khi học thêm điều mới.
Trong bối cảnh đó, trừu tượng thường không mang lại lợi ích theo cách như trong kỹ thuật phần mềm. Cấu trúc sớm có thể làm giảm tính linh hoạt trước khi bạn hiểu điều gì là quan trọng. Ghép nối chặt chẽ thường là hệ quả của khám phá, chứ không đơn thuần là kỹ nghệ kém.
Vai trò của chú thích và trạng thái
Cũng có một khác biệt quan trọng trong cách hai lĩnh vực tự giải thích.
Trong kỹ thuật phần mềm, mã thường tự giải thích qua cấu trúc. Kiểu dữ liệu, giao diện và trừu tượng mang phần lớn ý nghĩa, và chú thích thường là thứ yếu.
Trong khoa học dữ liệu, chú thích, đầu ra và trạng thái thường mang một phần ý nghĩa. Một ghi chú như “loại bỏ ngoại lệ trên bách phân vị 99, xác nhận điều này không ảnh hưởng nhóm chính” không chỉ là tài liệu bổ sung.
Nó ghi lại một quyết định phân tích có thể không khôi phục được chỉ từ mã. Một bảng hoặc biểu đồ giữa chừng notebook có thể giải thích vì sao phần tiếp theo của phân tích tồn tại.
Điều này quan trọng với tác nhân. Một tác nhân bỏ qua chú thích, kết quả nội tuyến và trạng thái đang tiến hóa trong notebook là bỏ sót một phần của phân tích. Trong codebase kỹ thuật phần mềm, thông tin đó thường mang tính bổ trợ. Trong công việc khoa học dữ liệu, thường không phải vậy.
Điều này có ý nghĩa gì cho tác nhân AI
Tác nhân mặc định phù hợp với một miền
Hệ quả thực tế là: tác nhân hoạt động tốt nhất khi công cụ của chúng phù hợp với nơi ý nghĩa trú ngụ.
Trong kỹ thuật phần mềm, một tác nhân hiệu quả điều hướng kiến trúc. Nó theo đồ thị lời gọi, tôn trọng giao diện và giữ cho các thay đổi nhất quán trong toàn codebase. Điều đó hiệu quả vì phần lớn ý nghĩa được mã hóa trong cấu trúc.
Trong khoa học dữ liệu, một tác nhân hiệu quả cần làm nhiều hơn điều hướng mã. Nó cần hiểu dữ liệu thực sự chứa gì, theo dõi trạng thái qua các bước, lần theo nguồn gốc biến và lý giải vì sao một biến đổi hay bộ lọc đã được áp dụng từ vài bước trước.
Một tác nhân xây cho kỹ thuật phần mềm sẽ không tự động chuyển giao tốt sang công việc khoa học dữ liệu. Vấn đề không chỉ là cú pháp. Cấu trúc thông tin nền tảng là khác nhau.
Vì sao quy trình kiểu notebook vẫn tồn tại
Điều này cũng giúp giải thích một điều thường làm kỹ sư thắc mắc: vì sao notebook vẫn giữ vai trò trung tâm dù có những hạn chế rõ ràng.
Câu trả lời là notebook giữ ý nghĩa gần với dữ liệu khi câu hỏi phân tích vẫn đang tiến hóa. Notebook không chỉ là một mô-đun Python có cấu trúc tệ. Nó là một tạo phẩm khác, được xây cho một giai đoạn công việc khác. Nó giữ mã, đầu ra và quyết định cạnh nhau khi phân tích còn đang định hình.
Đó là lý do notebook có thể trực quan với nhà phân tích đang sống trong ngữ cảnh đó, nhưng lại gượng gạo với một tác nhân chỉ nhìn thấy mã.
Tái cấu trúc một notebook thành mã sạch, mô-đun trước khi câu hỏi phân tích được chốt thường không phải là cải tiến. Nó có thể tách logic khỏi ngữ cảnh vốn mang lại ý nghĩa cho nó ngay từ đầu.
Cơ hội: thu hẹp khoảng cách sản xuất
Cơ hội thực sự cho tác nhân AI trong khoa học dữ liệu không chỉ là sao chép những gì đã hiệu quả trong kỹ thuật phần mềm. Đó là giúp thu hẹp khoảng cách sản xuất: quãng đường giữa một phát hiện trong khám phá và một quy trình có thể tái lập, có thể triển khai.
Khoảng cách đó tồn tại vì notebook bảo toàn ngữ cảnh phân tích với cái giá là sự gọn gàng cấu trúc. Một tác nhân có thể hiểu cả ngữ cảnh phân tích và yêu cầu cấu trúc của hệ thống sản xuất có thể giúp bắc cầu khoảng cách đó mà không buộc nhà phân tích rời chế độ khám phá quá sớm.
Đó là bài toán khó hơn việc điều hướng một codebase. Nhưng cũng là bài toán quan trọng hơn.
Điểm chính rút ra
Tóm lược những gì phân tích gợi ý trên các kho đã nghiên cứu:
Kết luận
Khi bắt đầu phân tích này, tôi kỳ vọng sẽ thấy mã khoa học dữ liệu đơn giản là kém cấu trúc hơn mã kỹ thuật phần mềm. Thay vào đó, tôi nhận ra nó được cấu trúc khác đi vì những lý do chính đáng, với ý nghĩa thường trú ở một nơi khác.
Điều đó có hệ quả thực tế cho bất kỳ ai đang xây dựng hoặc đánh giá tác nhân AI cho công việc phân tích. Câu hỏi thực sự không phải là liệu một tác nhân có thể viết Python đúng hay không. Mà là liệu nó có hiểu dữ liệu là gì, vì sao phân tích có hình hài như vậy, và những quyết định nào đã được đưa ra trên đường đi mà không thể nhìn thấy chỉ từ mã.
Mã khoa học dữ liệu không phải là kỹ thuật phần mềm chưa trưởng thành. Đó là một tối ưu hóa hoàn toàn khác: phụ thuộc nhiều hơn vào trạng thái bên ngoài, ít dựa vào cấu trúc nội bộ bền vững trong giai đoạn khám phá, và được định hình bởi ngữ cảnh cũng như bởi mã.
Khi bạn thấy điều đó, notebook sẽ không còn giống những dự án phần mềm thất bại, mà đúng hơn là những bề mặt làm việc để suy luận trên dữ liệu đang thay đổi.
Tôi đang tiếp tục phân tích này với một bộ dữ liệu lớn hơn gồm từ 1.000 kho trở lên và các chỉ số bổ sung. Nếu bạn muốn tìm hiểu sâu hơn về cách các tác nhân AI được xây dựng để làm việc với dữ liệu trong ngữ cảnh (bao gồm các kiến trúc thực thi bền bỉ duy trì trạng thái dữ liệu qua nhiều phiên), lộ trình nền tảng về tác nhân AI của DataCamp là một điểm khởi đầu vững chắc.