Ho analizzato centinaia di repository GitHub per capire perché gli agenti AI per il coding spesso sembrano molto più capaci nell’ingegneria del software che nel lavoro di data science. Quello che ho trovato suggerisce che non si tratta solo di un gap di strumenti. Riflette una differenza più profonda su dove risiede il significato in ciascun tipo di codice.
Di cosa parla questo articolo
Se hai usato un agente AI in una codebase di ingegneria del software, probabilmente hai visto quanto può essere efficace. L’agente naviga l’architettura, segue le astrazioni e apporta modifiche che si integrano sorprendentemente bene con il resto del sistema.
Poi apri un notebook di data science e spesso l’esperienza cambia.
L’agente sa ancora scrivere codice valido. Sa ancora seguire le istruzioni. Ma spesso non coglie davvero ciò che conta: perché questo dataset, perché questo filtro, perché questa finestra temporale, perché questo output ha cambiato la direzione dell’analisi.
Tratta il notebook come un progetto software, e questo è solo in parte ciò che è.
Volevo capirne il motivo. Così ho analizzato centinaia di repository GitHub tra data science e ingegneria del software, misurando entropia, pattern di riferimenti e comportamento di accoppiamento.
Quello che ho trovato mi ha sorpreso, e penso abbia implicazioni reali per chiunque stia costruendo o usando agenti AI nel lavoro analitico.
L’inversione dell’entropia: il codice di data science non è ciò che sembra
Cosa ho effettivamente misurato
Ho misurato l’entropia di Shannon a tre livelli di astrazione per ciascun repository: a livello di caratteri, di token e di AST. Ognuno cattura una dimensione diversa della variazione nel codice.
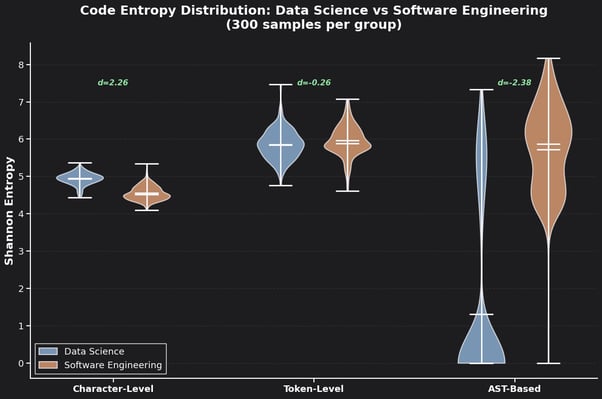
Distribuzione dell’entropia del codice: violini Data Science vs Ingegneria del Software
Lo schema emerso è ciò che considero un’inversione dell’entropia.
La superficie sembra complessa, la struttura spesso no
A livello di caratteri, il codice di data science tende ad avere entropia più alta rispetto al codice di ingegneria del software. Ha senso intuitivamente. Il lavoro di data science è pieno di nomi di colonne vari, etichette di dataset, variabili ad hoc e identificatori specifici di dominio che rendono il codice rumoroso e irregolare.
A livello di token, i due domini sono molto più vicini. Si basano su molti degli stessi mattoni sintattici.
Ma a livello di AST, dove osserviamo la diversità strutturale, il quadro si ribalta.
Il codice di ingegneria del software tende a codificare molta più variazione nella struttura. Crea comportamenti più distinti attraverso astrazioni, interfacce, moduli e logica interna.
Il codice di data science, al contrario, spesso riutilizza un set più piccolo di operazioni in contesti che cambiano: caricare, filtrare, raggruppare, aggregare, visualizzare, ispezionare, regolare.
In poche parole, il codice di data science spesso appare più complesso in superficie, mentre quello di ingegneria del software porta più complessità nella struttura.
Non è solo una differenza di stile. Indica una differenza più profonda nel modo in cui i due tipi di lavoro conservano il significato.
Indessicale vs simbolico: dove vive il significato
Due tipi di codice diversi
L’inversione dell’entropia diventa più facile da capire se pensi a cosa fa realmente ciascun tipo di codice.
Nell’ingegneria del software, il significato è spesso compresso nella struttura. Funzioni, interfacce, moduli, tipi e confini di classe fanno gran parte del lavoro. Una volta stabilite, queste astrazioni stabilizzano il comportamento e riducono l’incertezza futura.
Gran parte del significato è dentro il codice stesso.
Nella data science, il significato resta molto più legato al contesto esterno. Dipende dal dataset, dalle colonne, dagli output intermedi, dalle assunzioni dietro a una trasformazione e dalla domanda in evoluzione a cui l’analista sta cercando di rispondere. Il codice non esprime solo logica. Indica una situazione analitica specifica.
Questa differenza è uno dei modi più utili per capire perché gli agenti spesso si comportano in modo così diverso nei due domini.
Lo vedi da dove il codice “punta”
Ho anche misurato le densità di riferimenti esterni e interni per 100 righe di codice in entrambi i gruppi.
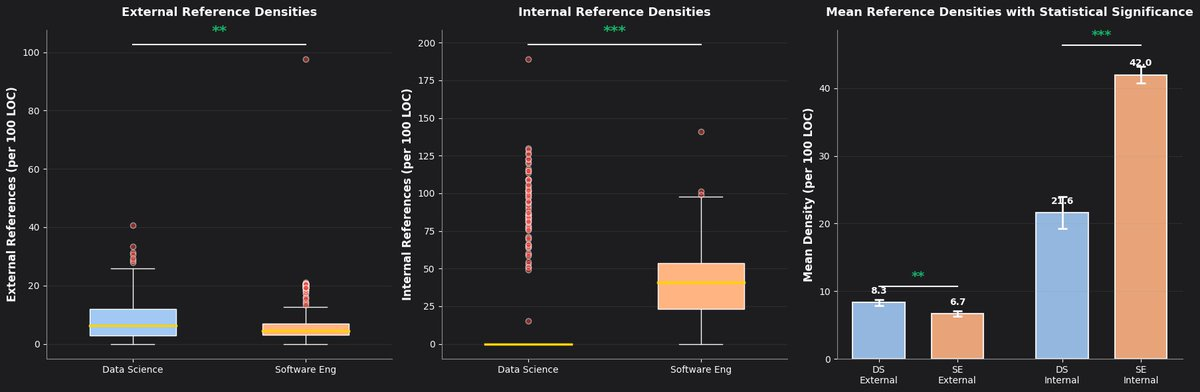
Densità di riferimenti esterni e interni con significatività statistica
La distinzione è chiara. Il codice di data science fa più spesso riferimento verso l’esterno: a dataset, tabelle, colonne, oggetti temporanei e stati che esistono fuori dal codice stesso.
Il codice di ingegneria del software è più auto-referenziale internamente. Costruisce il significato più spesso indicando funzioni, classi, moduli e astrazioni definite altrove nella codebase.
Il codice dei dati punta verso l’esterno. Il codice software punta verso l’interno.
Questo conta per gli agenti. In un caso, gran parte del contesto rilevante è nella codebase. Nell’altro, gran parte si trova nello stato analitico circostante.
Perché questo fa comportare diversamente le astrazioni
Il problema dell’accoppiamento nei notebook
Una delle scoperte più interessanti riguardava l’accoppiamento. I workflow in stile notebook mostravano un accoppiamento molto più stretto per 100 righe di codice rispetto alle codebase di ingegneria del software.
Non è necessariamente una cattiva progettazione. Riflette qualcosa di fondamentale nell’analisi esplorativa: spesso la domanda è ancora in movimento. Stai testando assunzioni, seguendo risultati strani, controllando edge case e cambiando direzione man mano che impari.
In quel contesto, l’astrazione spesso non ripaga nello stesso modo in cui lo fa nell’ingegneria del software. Strutturare prematuramente può ridurre l’opzionalità prima di capire cosa conta. Un accoppiamento più stretto è spesso una conseguenza dell’esplorazione, non semplicemente di cattive pratiche ingegneristiche.
C’è anche una differenza importante nel modo in cui i due domini si spiegano.
Nell’ingegneria del software, il codice spesso si spiega tramite la struttura. Tipi, interfacce e astrazioni portano gran parte del significato, e i commenti di solito sono secondari.
Nella data science, commenti, output e stato spesso portano parte del significato. Una nota come “rimossi gli outlier sopra il 99º percentile, confermato che non influisce sulla coorte principale” non è solo documentazione extra.
Cattura una decisione analitica che potrebbe non essere recuperabile dal solo codice. Una tabella o un grafico a metà del notebook può spiegare perché esista la parte successiva dell’analisi.
Questo conta per gli agenti. Un agente che ignora commenti, risultati inline e stato in evoluzione in un notebook si perde parte dell’analisi. In una codebase di ingegneria del software, quell’informazione è spesso accessoria. Nel lavoro di data science, spesso non lo è.
Cosa significa questo per gli agenti AI
Gli agenti sono abbinati bene a un dominio per impostazione predefinita
L’implicazione pratica è questa: gli agenti funzionano meglio quando i loro strumenti corrispondono a dove vive il significato.
Nell’ingegneria del software, un agente efficace naviga l’architettura. Segue il call graph, rispetta le interfacce e mantiene coerenti le modifiche in tutta la codebase. Funziona perché gran parte del significato è codificata nella struttura.
Nella data science, un agente efficace deve fare più che navigare il codice. Deve capire cosa contiene davvero il dato, tracciare lo stato tra i passaggi, seguire la provenienza delle variabili e ragionare sul perché una trasformazione o un filtro siano stati applicati diversi passaggi prima.
Un agente costruito per l’ingegneria del software non si trasferirà automaticamente bene al lavoro di data science. Il problema non è solo la sintassi. È che la struttura informativa sottostante è diversa.
Perché i workflow in stile notebook persistono
Questo aiuta anche a spiegare qualcosa che spesso stupisce gli ingegneri: perché i notebook restano così centrali nonostante le loro ovvie limitazioni.
La risposta è che i notebook mantengono il significato vicino ai dati mentre la domanda analitica è ancora in evoluzione. Un notebook non è semplicemente un modulo Python strutturato male. È un artefatto diverso, costruito per una fase di lavoro diversa. Mantiene vicino codice, output e decisioni mentre l’analisi sta ancora prendendo forma.
Ecco perché un notebook può risultare intuitivo all’analista che ha vissuto dentro il contesto, e goffo per un agente che vede solo il codice.
Refactoring di un notebook in codice pulito e modulare prima che la domanda analitica sia definita spesso non è un miglioramento. Può separare la logica dal contesto che le dava significato in primo luogo.
L’opportunità: chiudere il gap verso la produzione
La vera opportunità per gli agenti AI nella data science non è semplicemente copiare ciò che già funziona nell’ingegneria del software. È aiutare a chiudere il gap verso la produzione: la distanza tra un insight trovato in esplorazione e un workflow riproducibile e distribuibile.
Quel gap esiste perché i notebook preservano il contesto analitico a costo della pulizia strutturale. Un agente che sappia comprendere sia il contesto analitico sia i requisiti strutturali dei sistemi di produzione potrebbe colmarlo senza costringere l’analista umano a uscire troppo presto dalla modalità esplorativa.
È un problema più difficile che navigare una codebase. Ma è anche quello più importante.
Punti chiave
Per riassumere ciò che l’analisi suggerisce nei repository studiati:
- Il codice di data science ha spesso entropia più alta a livello di superficie, mentre il codice di ingegneria del software ha spesso entropia più alta a livello strutturale.
- Il codice di data science fa più spesso riferimento a stati esterni come dataset, colonne, tabelle e output intermedi, mentre il codice di ingegneria del software è più auto-referenziale internamente.
- I workflow in stile notebook tendono a mostrare un accoppiamento più stretto, spesso conseguenza dell’esplorazione più che di semplici cattive pratiche.
- Commenti, output e stato in evoluzione fanno parte del contenuto semantico del lavoro di data science, non solo dettagli periferici.
- Gli agenti ottimizzati per contesti di ingegneria del software spesso renderanno meno nella data science a meno che non siano progettati per ragionare su dati, output e contesto oltre che sulla struttura del codice.
Conclusione
Quando ho iniziato questa analisi, mi aspettavo di trovare che il codice di data science fosse semplicemente meno ben strutturato rispetto a quello di ingegneria del software. Invece ho scoperto che è strutturato diversamente per buone ragioni, con il significato che spesso vive in un posto diverso.
Questo ha conseguenze pratiche per chiunque costruisca o valuti agenti AI per il lavoro analitico. La vera domanda non è se un agente sa scrivere Python corretto. È se capisce cosa sono i dati, perché l’analisi ha quella forma e quali decisioni sono state prese lungo il percorso che non sono visibili dal solo codice.
Il codice di data science non è un’ingegneria del software immatura. È un’ottimizzazione del tutto diversa: più dipendente dallo stato esterno, meno affidata a una struttura interna durevole durante l’esplorazione e plasmata dal contesto tanto quanto dal codice.
Una volta che lo vedi, i notebook smettono di sembrare progetti software falliti e iniziano ad assomigliare a ciò che sono davvero: superfici di lavoro per ragionare su dati che cambiano.
Sto proseguendo questa analisi con un dataset più ampio di 1.000 o più repository e metriche aggiuntive. Se vuoi approfondire come si stanno costruendo agenti AI per lavorare con i dati nel loro contesto (incluse architetture di esecuzione persistenti che mantengono lo stato dei dati tra le sessioni), il percorso AI agent fundamentals di DataCamp è un ottimo punto di partenza.







Ho analizzato centinaia di repository GitHub per capire perché gli agenti AI per il coding spesso sembrano molto più capaci nell’ingegneria del software che nel lavoro di data science. Quello che ho trovato suggerisce che non si tratta solo di un gap di strumenti. Riflette una differenza più profonda su dove risiede il significato in ciascun tipo di codice.
Di cosa parla questo articolo
Se hai usato un agente AI in una codebase di ingegneria del software, probabilmente hai visto quanto può essere efficace. L’agente naviga l’architettura, segue le astrazioni e apporta modifiche che si integrano sorprendentemente bene con il resto del sistema.
Poi apri un notebook di data science e spesso l’esperienza cambia.
L’agente sa ancora scrivere codice valido. Sa ancora seguire le istruzioni. Ma spesso non coglie davvero ciò che conta: perché questo dataset, perché questo filtro, perché questa finestra temporale, perché questo output ha cambiato la direzione dell’analisi.
Tratta il notebook come un progetto software, e questo è solo in parte ciò che è.
Volevo capirne il motivo. Così ho analizzato centinaia di repository GitHub tra data science e ingegneria del software, misurando entropia, pattern di riferimenti e comportamento di accoppiamento.
Quello che ho trovato mi ha sorpreso, e penso abbia implicazioni reali per chiunque stia costruendo o usando agenti AI nel lavoro analitico.
L’inversione dell’entropia: il codice di data science non è ciò che sembra
Cosa ho effettivamente misurato
Ho misurato l’entropia di Shannon a tre livelli di astrazione per ciascun repository: a livello di caratteri, di token e di AST. Ognuno cattura una dimensione diversa della variazione nel codice.
Distribuzione dell’entropia del codice: violini Data Science vs Ingegneria del Software
Lo schema emerso è ciò che considero un’inversione dell’entropia.
La superficie sembra complessa, la struttura spesso no
A livello di caratteri, il codice di data science tende ad avere entropia più alta rispetto al codice di ingegneria del software. Ha senso intuitivamente. Il lavoro di data science è pieno di nomi di colonne vari, etichette di dataset, variabili ad hoc e identificatori specifici di dominio che rendono il codice rumoroso e irregolare.
A livello di token, i due domini sono molto più vicini. Si basano su molti degli stessi mattoni sintattici.
Ma a livello di AST, dove osserviamo la diversità strutturale, il quadro si ribalta.
Il codice di ingegneria del software tende a codificare molta più variazione nella struttura. Crea comportamenti più distinti attraverso astrazioni, interfacce, moduli e logica interna.
Il codice di data science, al contrario, spesso riutilizza un set più piccolo di operazioni in contesti che cambiano: caricare, filtrare, raggruppare, aggregare, visualizzare, ispezionare, regolare.
In poche parole, il codice di data science spesso appare più complesso in superficie, mentre quello di ingegneria del software porta più complessità nella struttura.
Non è solo una differenza di stile. Indica una differenza più profonda nel modo in cui i due tipi di lavoro conservano il significato.
Indessicale vs simbolico: dove vive il significato
Due tipi di codice diversi
L’inversione dell’entropia diventa più facile da capire se pensi a cosa fa realmente ciascun tipo di codice.
Nell’ingegneria del software, il significato è spesso compresso nella struttura. Funzioni, interfacce, moduli, tipi e confini di classe fanno gran parte del lavoro. Una volta stabilite, queste astrazioni stabilizzano il comportamento e riducono l’incertezza futura.
Gran parte del significato è dentro il codice stesso.
Nella data science, il significato resta molto più legato al contesto esterno. Dipende dal dataset, dalle colonne, dagli output intermedi, dalle assunzioni dietro a una trasformazione e dalla domanda in evoluzione a cui l’analista sta cercando di rispondere. Il codice non esprime solo logica. Indica una situazione analitica specifica.
Questa differenza è uno dei modi più utili per capire perché gli agenti spesso si comportano in modo così diverso nei due domini.
Lo vedi da dove il codice “punta”
Ho anche misurato le densità di riferimenti esterni e interni per 100 righe di codice in entrambi i gruppi.
Densità di riferimenti esterni e interni con significatività statistica
La distinzione è chiara. Il codice di data science fa più spesso riferimento verso l’esterno: a dataset, tabelle, colonne, oggetti temporanei e stati che esistono fuori dal codice stesso.
Il codice di ingegneria del software è più auto-referenziale internamente. Costruisce il significato più spesso indicando funzioni, classi, moduli e astrazioni definite altrove nella codebase.
Il codice dei dati punta verso l’esterno. Il codice software punta verso l’interno.
Questo conta per gli agenti. In un caso, gran parte del contesto rilevante è nella codebase. Nell’altro, gran parte si trova nello stato analitico circostante.
Perché questo fa comportare diversamente le astrazioni
Il problema dell’accoppiamento nei notebook
Una delle scoperte più interessanti riguardava l’accoppiamento. I workflow in stile notebook mostravano un accoppiamento molto più stretto per 100 righe di codice rispetto alle codebase di ingegneria del software.
Non è necessariamente una cattiva progettazione. Riflette qualcosa di fondamentale nell’analisi esplorativa: spesso la domanda è ancora in movimento. Stai testando assunzioni, seguendo risultati strani, controllando edge case e cambiando direzione man mano che impari.
In quel contesto, l’astrazione spesso non ripaga nello stesso modo in cui lo fa nell’ingegneria del software. Strutturare prematuramente può ridurre l’opzionalità prima di capire cosa conta. Un accoppiamento più stretto è spesso una conseguenza dell’esplorazione, non semplicemente di cattive pratiche ingegneristiche.
Il ruolo dei commenti e dello stato
C’è anche una differenza importante nel modo in cui i due domini si spiegano.
Nell’ingegneria del software, il codice spesso si spiega tramite la struttura. Tipi, interfacce e astrazioni portano gran parte del significato, e i commenti di solito sono secondari.
Nella data science, commenti, output e stato spesso portano parte del significato. Una nota come “rimossi gli outlier sopra il 99º percentile, confermato che non influisce sulla coorte principale” non è solo documentazione extra.
Cattura una decisione analitica che potrebbe non essere recuperabile dal solo codice. Una tabella o un grafico a metà del notebook può spiegare perché esista la parte successiva dell’analisi.
Questo conta per gli agenti. Un agente che ignora commenti, risultati inline e stato in evoluzione in un notebook si perde parte dell’analisi. In una codebase di ingegneria del software, quell’informazione è spesso accessoria. Nel lavoro di data science, spesso non lo è.
Cosa significa questo per gli agenti AI
Gli agenti sono abbinati bene a un dominio per impostazione predefinita
L’implicazione pratica è questa: gli agenti funzionano meglio quando i loro strumenti corrispondono a dove vive il significato.
Nell’ingegneria del software, un agente efficace naviga l’architettura. Segue il call graph, rispetta le interfacce e mantiene coerenti le modifiche in tutta la codebase. Funziona perché gran parte del significato è codificata nella struttura.
Nella data science, un agente efficace deve fare più che navigare il codice. Deve capire cosa contiene davvero il dato, tracciare lo stato tra i passaggi, seguire la provenienza delle variabili e ragionare sul perché una trasformazione o un filtro siano stati applicati diversi passaggi prima.
Un agente costruito per l’ingegneria del software non si trasferirà automaticamente bene al lavoro di data science. Il problema non è solo la sintassi. È che la struttura informativa sottostante è diversa.
Perché i workflow in stile notebook persistono
Questo aiuta anche a spiegare qualcosa che spesso stupisce gli ingegneri: perché i notebook restano così centrali nonostante le loro ovvie limitazioni.
La risposta è che i notebook mantengono il significato vicino ai dati mentre la domanda analitica è ancora in evoluzione. Un notebook non è semplicemente un modulo Python strutturato male. È un artefatto diverso, costruito per una fase di lavoro diversa. Mantiene vicino codice, output e decisioni mentre l’analisi sta ancora prendendo forma.
Ecco perché un notebook può risultare intuitivo all’analista che ha vissuto dentro il contesto, e goffo per un agente che vede solo il codice.
Refactoring di un notebook in codice pulito e modulare prima che la domanda analitica sia definita spesso non è un miglioramento. Può separare la logica dal contesto che le dava significato in primo luogo.
L’opportunità: chiudere il gap verso la produzione
La vera opportunità per gli agenti AI nella data science non è semplicemente copiare ciò che già funziona nell’ingegneria del software. È aiutare a chiudere il gap verso la produzione: la distanza tra un insight trovato in esplorazione e un workflow riproducibile e distribuibile.
Quel gap esiste perché i notebook preservano il contesto analitico a costo della pulizia strutturale. Un agente che sappia comprendere sia il contesto analitico sia i requisiti strutturali dei sistemi di produzione potrebbe colmarlo senza costringere l’analista umano a uscire troppo presto dalla modalità esplorativa.
È un problema più difficile che navigare una codebase. Ma è anche quello più importante.
Punti chiave
Per riassumere ciò che l’analisi suggerisce nei repository studiati:
Conclusione
Quando ho iniziato questa analisi, mi aspettavo di trovare che il codice di data science fosse semplicemente meno ben strutturato rispetto a quello di ingegneria del software. Invece ho scoperto che è strutturato diversamente per buone ragioni, con il significato che spesso vive in un posto diverso.
Questo ha conseguenze pratiche per chiunque costruisca o valuti agenti AI per il lavoro analitico. La vera domanda non è se un agente sa scrivere Python corretto. È se capisce cosa sono i dati, perché l’analisi ha quella forma e quali decisioni sono state prese lungo il percorso che non sono visibili dal solo codice.
Il codice di data science non è un’ingegneria del software immatura. È un’ottimizzazione del tutto diversa: più dipendente dallo stato esterno, meno affidata a una struttura interna durevole durante l’esplorazione e plasmata dal contesto tanto quanto dal codice.
Una volta che lo vedi, i notebook smettono di sembrare progetti software falliti e iniziano ad assomigliare a ciò che sono davvero: superfici di lavoro per ragionare su dati che cambiano.
Sto proseguendo questa analisi con un dataset più ampio di 1.000 o più repository e metriche aggiuntive. Se vuoi approfondire come si stanno costruendo agenti AI per lavorare con i dati nel loro contesto (incluse architetture di esecuzione persistenti che mantengono lo stato dei dati tra le sessioni), il percorso AI agent fundamentals di DataCamp è un ottimo punto di partenza.