Saya menganalisis ratusan repositori GitHub untuk memahami mengapa agen pengodean AI sering terasa jauh lebih mumpuni dalam rekayasa perangkat lunak dibandingkan dalam pekerjaan data science. Temuan saya menunjukkan ini bukan sekadar kesenjangan alat. Ini mencerminkan perbedaan yang lebih mendasar tentang di mana makna tinggal dalam masing-masing jenis kode.
Isi Artikel Ini
Jika Anda pernah menggunakan agen pengodean AI dalam codebase rekayasa perangkat lunak, Anda mungkin melihat betapa efektifnya ia bekerja. Agen menavigasi arsitektur, mengikuti abstraksi, dan melakukan perubahan yang ternyata selaras dengan baik dengan sistem lainnya.
Lalu Anda membuka notebook data science, dan pengalamannya sering kali berubah.
Agen tersebut tetap dapat menulis kode yang valid. Ia tetap dapat mengikuti instruksi. Namun sering kali ia tidak sepenuhnya memahami hal-hal yang penting: mengapa dataset ini, mengapa penyaring ini, mengapa jendela waktu ini, mengapa keluaran ini mengubah arah analisis.
Agen memperlakukan notebook seperti proyek perangkat lunak, dan itu hanya sebagian dari apa adanya.
Saya ingin memahami alasannya. Jadi saya menganalisis ratusan repositori GitHub di bidang data science dan rekayasa perangkat lunak, mengukur entropi, pola referensi, dan perilaku coupling.
Hasilnya mengejutkan saya, dan menurut saya ini memiliki implikasi nyata bagi siapa pun yang membangun atau menggunakan agen AI dalam pekerjaan analitis.
Pembalikan Entropi: Kode Data Science Tidak Seperti Tampaknya
Apa yang sebenarnya saya ukur
Saya mengukur entropi Shannon pada tiga tingkat abstraksi untuk setiap repositori: tingkat karakter, tingkat token, dan tingkat AST. Masing-masing menangkap dimensi variasi kode yang berbeda.
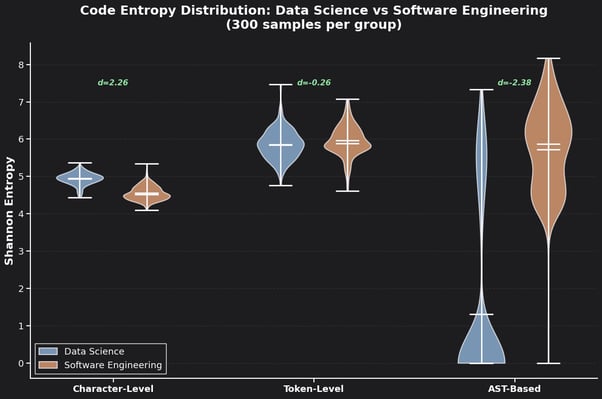
Distribusi Entropi Kode: plot biola Data Science vs Rekayasa Perangkat Lunak
Pola yang muncul adalah apa yang saya sebut sebagai pembalikan entropi.
Permukaannya tampak kompleks, strukturnya sering kali tidak
Pada tingkat karakter, kode data science cenderung memiliki entropi lebih tinggi daripada kode rekayasa perangkat lunak. Itu terasa masuk akal. Pekerjaan data science dipenuhi dengan nama kolom yang beragam, label dataset, variabel ad hoc, dan pengenal spesifik domain yang membuat kode tampak bising dan tidak beraturan.
Pada tingkat token, kedua domain jauh lebih dekat. Keduanya bergantung pada banyak blok bangunan sintaktis yang sama.
Namun pada tingkat AST, saat kita melihat keragaman struktural, gambarnya berbalik.
Kode rekayasa perangkat lunak cenderung memuat variasi struktur yang jauh lebih besar. Ia menciptakan perilaku yang lebih beragam melalui abstraksi, antarmuka, modul, dan logika internal.
Sebaliknya, kode data science sering menggunakan kembali seperangkat operasi yang lebih kecil di berbagai konteks yang berubah: memuat, menyaring, mengelompokkan, mengagregasi, memvisualisasikan, memeriksa, menyesuaikan.
Singkatnya, kode data science sering tampak lebih kompleks di permukaan, sementara kode rekayasa perangkat lunak sering membawa lebih banyak kompleksitas dalam struktur.
Ini bukan sekadar perbedaan gaya. Ini menyoroti perbedaan yang lebih dalam tentang bagaimana kedua jenis pekerjaan menyimpan makna.
Indeksikal vs Simbolik: Di Mana Makna Tinggal
Dua jenis kode yang berbeda
Pembalikan entropi menjadi lebih mudah dipahami ketika Anda memikirkan apa yang sebenarnya dilakukan oleh masing-masing jenis kode.
Dalam rekayasa perangkat lunak, makna sering dikompresi ke dalam struktur. Fungsi, antarmuka, modul, tipe, dan batasan kelas melakukan banyak pekerjaan. Setelah abstraksi tersebut ditetapkan, mereka menstabilkan perilaku dan mengurangi ketidakpastian di masa depan.
Sebagian besar makna berada di dalam kode itu sendiri.
Dalam data science, makna tetap jauh lebih terkait erat dengan konteks eksternal. Makna bergantung pada dataset, kolom, keluaran antara, asumsi di balik sebuah transformasi, dan pertanyaan yang terus berkembang yang coba dijawab analis. Kodenya bukan hanya mengekspresikan logika. Ia menunjuk pada situasi analitis tertentu.
Perbedaan itu adalah salah satu cara paling berguna untuk memahami mengapa agen sering berperilaku sangat berbeda di kedua domain.
Anda dapat melihatnya dari ke mana kode itu “menunjuk”
Saya juga mengukur kepadatan referensi eksternal dan internal per 100 baris kode di kedua kelompok.
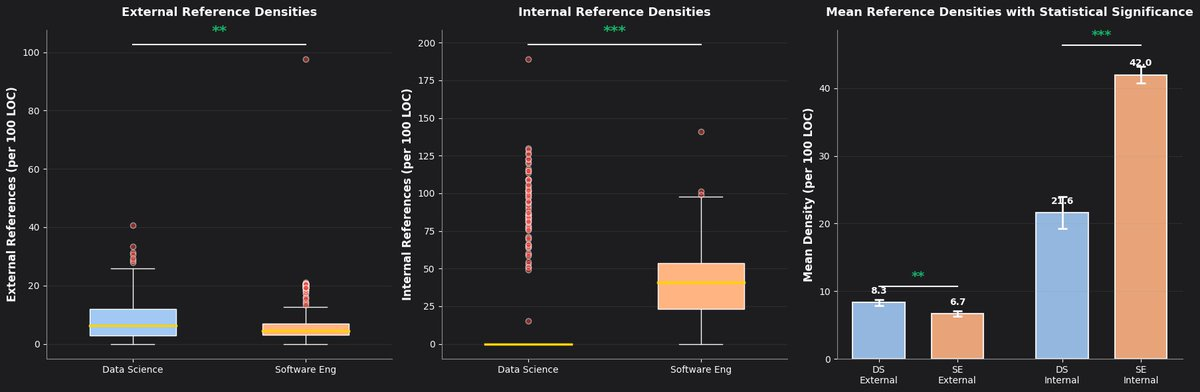
Kepadatan Referensi Eksternal dan Internal dengan signifikansi statistik
Perbedaannya jelas. Kode data science lebih sering merujuk ke luar: ke dataset, tabel, kolom, objek sementara, dan status yang ada di luar kode itu sendiri.
Kode rekayasa perangkat lunak lebih bersifat merujuk diri secara internal. Ia membangun makna lebih sering dengan menunjuk pada fungsi, kelas, modul, dan abstraksi yang didefinisikan di tempat lain dalam codebase.
Kode data menunjuk ke luar. Kode perangkat lunak menunjuk ke dalam.
Itu penting bagi agen. Dalam satu kasus, sebagian besar konteks relevan ada di dalam codebase. Dalam kasus lain, sebagian besar berada pada status analitis di sekitarnya.
Mengapa Ini Membuat Abstraksi Berperilaku Berbeda
Masalah coupling di notebook
Salah satu temuan yang lebih menarik berkaitan dengan coupling. Alur kerja bergaya notebook menunjukkan coupling yang jauh lebih ketat per 100 baris kode dibanding codebase rekayasa perangkat lunak.
Itu tidak selalu merupakan desain yang buruk. Ini mencerminkan sesuatu yang mendasar tentang analisis eksploratif: pertanyaannya sendiri sering masih bergerak. Anda menguji asumsi, mengikuti hasil yang janggal, memeriksa kasus tepi, dan mengubah arah saat Anda belajar.
Dalam konteks itu, abstraksi sering tidak memberi imbal hasil yang sama seperti dalam rekayasa perangkat lunak. Struktur yang terlalu dini dapat mengurangi opsi sebelum Anda memahami apa yang penting. Coupling yang lebih ketat sering merupakan konsekuensi dari eksplorasi, bukan semata praktik teknik yang buruk.
Peran komentar dan status
Ada juga perbedaan penting dalam cara kedua domain menjelaskan dirinya sendiri.
Dalam rekayasa perangkat lunak, kode sering menjelaskan dirinya melalui struktur. Tipe, antarmuka, dan abstraksi membawa sebagian besar makna, dan komentar biasanya bersifat sekunder.
Dalam data science, komentar, keluaran, dan status sering memuat sebagian makna. Catatan seperti “menghapus outlier di atas persentil ke-99, dikonfirmasi ini tidak memengaruhi kohort utama” bukan sekadar dokumentasi tambahan.
Itu menangkap keputusan analitis yang mungkin tidak dapat dipulihkan dari kode saja. Sebuah tabel atau plot di tengah notebook dapat menjelaskan mengapa bagian analisis berikutnya ada sama sekali.
Ini penting bagi agen. Agen yang mengabaikan komentar, hasil inline, dan status yang berkembang dalam notebook melewatkan sebagian analisis. Dalam codebase rekayasa perangkat lunak, informasi itu sering bersifat pelengkap. Dalam pekerjaan data science, sering kali tidak demikian.
Apa Artinya Ini bagi Agen AI
Agen secara bawaan lebih cocok untuk satu domain
Implikasi praktisnya adalah: agen bekerja terbaik ketika alatnya selaras dengan tempat makna berada.
Dalam rekayasa perangkat lunak, agen yang efektif menavigasi arsitektur. Ia mengikuti call graph, menghormati antarmuka, dan menjaga konsistensi perubahan di seluruh codebase. Itu berhasil karena sebagian besar makna dikodekan dalam struktur.
Dalam data science, agen yang efektif perlu melakukan lebih dari sekadar menavigasi kode. Ia perlu memahami apa yang sebenarnya dikandung data, melacak status lintas langkah, mengikuti asal-usul variabel, dan menalar mengapa sebuah transformasi atau penyaring diterapkan beberapa langkah sebelumnya.
Agen yang dibangun untuk rekayasa perangkat lunak tidak akan otomatis berpindah dengan baik ke pekerjaan data science. Masalahnya bukan hanya sintaks. Struktur informasi yang mendasarnya berbeda.
Mengapa alur kerja bergaya notebook tetap bertahan
Ini juga membantu menjelaskan sesuatu yang sering membingungkan para insinyur: mengapa notebook tetap begitu sentral meskipun ada keterbatasan yang jelas.
Jawabannya adalah notebook menjaga makna tetap dekat dengan data saat pertanyaan analitis masih berkembang. Notebook bukan sekadar modul Python yang strukturnya buruk. Ini adalah artefak berbeda yang dibangun untuk tahap pekerjaan yang berbeda. Ia menjaga kode, keluaran, dan keputusan tetap berdekatan saat analisis masih terbentuk.
Itulah sebabnya notebook dapat terasa intuitif bagi analis yang hidup di dalam konteksnya, dan terasa canggung bagi agen yang hanya melihat kodenya.
Melakukan refactor notebook menjadi kode yang bersih dan modular sebelum pertanyaan analitisnya matang sering kali bukan perbaikan. Itu dapat memisahkan logika dari konteks yang awalnya memberinya makna.
Peluang nyata bagi agen AI dalam data science bukan sekadar menyalin apa yang sudah berhasil dalam rekayasa perangkat lunak. Melainkan membantu menutup kesenjangan produksi: jarak antara wawasan yang ditemukan dalam eksplorasi dan alur kerja yang dapat direproduksi serta dapat di-deploy.
Kesenjangan itu ada karena notebook mempertahankan konteks analitis dengan mengorbankan kerapian struktur. Agen yang dapat memahami baik konteks analitis maupun kebutuhan struktural sistem produksi dapat membantu menjembatani kesenjangan itu tanpa memaksa analis manusia keluar dari mode eksplorasi terlalu dini.
Itu masalah yang lebih sulit daripada menavigasi codebase. Namun juga yang lebih penting.
Inti Pembahasan
Sebagai ringkasan dari yang disarankan analisis di seluruh repositori yang diteliti:
- Kode data science sering memiliki entropi tingkat permukaan yang lebih tinggi, sementara kode rekayasa perangkat lunak sering memiliki entropi struktural yang lebih tinggi.
- Kode data science lebih sering merujuk pada status eksternal seperti dataset, kolom, tabel, dan keluaran antara, sementara kode rekayasa perangkat lunak lebih banyak merujuk diri secara internal.
- Alur kerja bergaya notebook cenderung menunjukkan coupling yang lebih ketat, yang sering merupakan konsekuensi dari eksplorasi, bukan semata praktik yang buruk.
- Komentar, keluaran, dan status yang berkembang adalah bagian dari konten semantik pekerjaan data science, bukan sekadar detail periferal.
- Agen yang dioptimalkan untuk konteks rekayasa perangkat lunak sering berkinerja kurang baik dalam data science kecuali dirancang untuk menalar atas data, keluaran, dan konteks bersamaan dengan struktur kode.
Kesimpulan
Saat memulai analisis ini, saya memperkirakan akan menemukan bahwa kode data science sekadar kurang terstruktur dibandingkan kode rekayasa perangkat lunak. Namun yang saya temukan justru bahwa kodenya tersusun secara berbeda karena alasan yang kuat, dengan makna yang sering tinggal di tempat yang berbeda.
Itu memiliki konsekuensi praktis bagi siapa pun yang membangun atau mengevaluasi agen AI untuk pekerjaan analitis. Pertanyaan yang sebenarnya bukan apakah agen dapat menulis Python yang benar. Melainkan apakah ia memahami apa itu data, mengapa analisis berbentuk seperti itu, dan keputusan apa yang dibuat sepanjang jalan yang tidak terlihat dari kode saja.
Kode data science bukanlah rekayasa perangkat lunak yang belum matang. Ini adalah optimasi yang sepenuhnya berbeda: lebih bergantung pada status eksternal, kurang bertumpu pada struktur internal yang tahan lama selama eksplorasi, dan dibentuk oleh konteks sama besarnya dengan oleh kode.
Setelah Anda melihat itu, notebook berhenti terlihat seperti proyek perangkat lunak yang gagal dan mulai lebih tampak seperti apa adanya: permukaan kerja untuk bernalar atas data yang berubah.
Saya melanjutkan analisis ini dengan dataset yang lebih besar berisi 1.000 repositori atau lebih dan metrik tambahan. Jika Anda ingin menggali lebih dalam tentang bagaimana agen AI dibangun untuk bekerja dengan data dalam konteks (termasuk arsitektur eksekusi persisten yang mempertahankan status data lintas sesi), AI agent fundamentals track dari DataCamp adalah tempat yang tepat untuk memulai.




Saya menganalisis ratusan repositori GitHub untuk memahami mengapa agen pengodean AI sering terasa jauh lebih mumpuni dalam rekayasa perangkat lunak dibandingkan dalam pekerjaan data science. Temuan saya menunjukkan ini bukan sekadar kesenjangan alat. Ini mencerminkan perbedaan yang lebih mendasar tentang di mana makna tinggal dalam masing-masing jenis kode.
Isi Artikel Ini
Jika Anda pernah menggunakan agen pengodean AI dalam codebase rekayasa perangkat lunak, Anda mungkin melihat betapa efektifnya ia bekerja. Agen menavigasi arsitektur, mengikuti abstraksi, dan melakukan perubahan yang ternyata selaras dengan baik dengan sistem lainnya.
Lalu Anda membuka notebook data science, dan pengalamannya sering kali berubah.
Agen tersebut tetap dapat menulis kode yang valid. Ia tetap dapat mengikuti instruksi. Namun sering kali ia tidak sepenuhnya memahami hal-hal yang penting: mengapa dataset ini, mengapa penyaring ini, mengapa jendela waktu ini, mengapa keluaran ini mengubah arah analisis.
Agen memperlakukan notebook seperti proyek perangkat lunak, dan itu hanya sebagian dari apa adanya.
Saya ingin memahami alasannya. Jadi saya menganalisis ratusan repositori GitHub di bidang data science dan rekayasa perangkat lunak, mengukur entropi, pola referensi, dan perilaku coupling.
Hasilnya mengejutkan saya, dan menurut saya ini memiliki implikasi nyata bagi siapa pun yang membangun atau menggunakan agen AI dalam pekerjaan analitis.
Pembalikan Entropi: Kode Data Science Tidak Seperti Tampaknya
Apa yang sebenarnya saya ukur
Saya mengukur entropi Shannon pada tiga tingkat abstraksi untuk setiap repositori: tingkat karakter, tingkat token, dan tingkat AST. Masing-masing menangkap dimensi variasi kode yang berbeda.
Distribusi Entropi Kode: plot biola Data Science vs Rekayasa Perangkat Lunak
Pola yang muncul adalah apa yang saya sebut sebagai pembalikan entropi.
Permukaannya tampak kompleks, strukturnya sering kali tidak
Pada tingkat karakter, kode data science cenderung memiliki entropi lebih tinggi daripada kode rekayasa perangkat lunak. Itu terasa masuk akal. Pekerjaan data science dipenuhi dengan nama kolom yang beragam, label dataset, variabel ad hoc, dan pengenal spesifik domain yang membuat kode tampak bising dan tidak beraturan.
Pada tingkat token, kedua domain jauh lebih dekat. Keduanya bergantung pada banyak blok bangunan sintaktis yang sama.
Namun pada tingkat AST, saat kita melihat keragaman struktural, gambarnya berbalik.
Kode rekayasa perangkat lunak cenderung memuat variasi struktur yang jauh lebih besar. Ia menciptakan perilaku yang lebih beragam melalui abstraksi, antarmuka, modul, dan logika internal.
Sebaliknya, kode data science sering menggunakan kembali seperangkat operasi yang lebih kecil di berbagai konteks yang berubah: memuat, menyaring, mengelompokkan, mengagregasi, memvisualisasikan, memeriksa, menyesuaikan.
Singkatnya, kode data science sering tampak lebih kompleks di permukaan, sementara kode rekayasa perangkat lunak sering membawa lebih banyak kompleksitas dalam struktur.
Ini bukan sekadar perbedaan gaya. Ini menyoroti perbedaan yang lebih dalam tentang bagaimana kedua jenis pekerjaan menyimpan makna.
Indeksikal vs Simbolik: Di Mana Makna Tinggal
Dua jenis kode yang berbeda
Pembalikan entropi menjadi lebih mudah dipahami ketika Anda memikirkan apa yang sebenarnya dilakukan oleh masing-masing jenis kode.
Dalam rekayasa perangkat lunak, makna sering dikompresi ke dalam struktur. Fungsi, antarmuka, modul, tipe, dan batasan kelas melakukan banyak pekerjaan. Setelah abstraksi tersebut ditetapkan, mereka menstabilkan perilaku dan mengurangi ketidakpastian di masa depan.
Sebagian besar makna berada di dalam kode itu sendiri.
Dalam data science, makna tetap jauh lebih terkait erat dengan konteks eksternal. Makna bergantung pada dataset, kolom, keluaran antara, asumsi di balik sebuah transformasi, dan pertanyaan yang terus berkembang yang coba dijawab analis. Kodenya bukan hanya mengekspresikan logika. Ia menunjuk pada situasi analitis tertentu.
Perbedaan itu adalah salah satu cara paling berguna untuk memahami mengapa agen sering berperilaku sangat berbeda di kedua domain.
Anda dapat melihatnya dari ke mana kode itu “menunjuk”
Saya juga mengukur kepadatan referensi eksternal dan internal per 100 baris kode di kedua kelompok.
Kepadatan Referensi Eksternal dan Internal dengan signifikansi statistik
Perbedaannya jelas. Kode data science lebih sering merujuk ke luar: ke dataset, tabel, kolom, objek sementara, dan status yang ada di luar kode itu sendiri.
Kode rekayasa perangkat lunak lebih bersifat merujuk diri secara internal. Ia membangun makna lebih sering dengan menunjuk pada fungsi, kelas, modul, dan abstraksi yang didefinisikan di tempat lain dalam codebase.
Kode data menunjuk ke luar. Kode perangkat lunak menunjuk ke dalam.
Itu penting bagi agen. Dalam satu kasus, sebagian besar konteks relevan ada di dalam codebase. Dalam kasus lain, sebagian besar berada pada status analitis di sekitarnya.
Mengapa Ini Membuat Abstraksi Berperilaku Berbeda
Masalah coupling di notebook
Salah satu temuan yang lebih menarik berkaitan dengan coupling. Alur kerja bergaya notebook menunjukkan coupling yang jauh lebih ketat per 100 baris kode dibanding codebase rekayasa perangkat lunak.
Itu tidak selalu merupakan desain yang buruk. Ini mencerminkan sesuatu yang mendasar tentang analisis eksploratif: pertanyaannya sendiri sering masih bergerak. Anda menguji asumsi, mengikuti hasil yang janggal, memeriksa kasus tepi, dan mengubah arah saat Anda belajar.
Dalam konteks itu, abstraksi sering tidak memberi imbal hasil yang sama seperti dalam rekayasa perangkat lunak. Struktur yang terlalu dini dapat mengurangi opsi sebelum Anda memahami apa yang penting. Coupling yang lebih ketat sering merupakan konsekuensi dari eksplorasi, bukan semata praktik teknik yang buruk.
Peran komentar dan status
Ada juga perbedaan penting dalam cara kedua domain menjelaskan dirinya sendiri.
Dalam rekayasa perangkat lunak, kode sering menjelaskan dirinya melalui struktur. Tipe, antarmuka, dan abstraksi membawa sebagian besar makna, dan komentar biasanya bersifat sekunder.
Dalam data science, komentar, keluaran, dan status sering memuat sebagian makna. Catatan seperti “menghapus outlier di atas persentil ke-99, dikonfirmasi ini tidak memengaruhi kohort utama” bukan sekadar dokumentasi tambahan.
Itu menangkap keputusan analitis yang mungkin tidak dapat dipulihkan dari kode saja. Sebuah tabel atau plot di tengah notebook dapat menjelaskan mengapa bagian analisis berikutnya ada sama sekali.
Ini penting bagi agen. Agen yang mengabaikan komentar, hasil inline, dan status yang berkembang dalam notebook melewatkan sebagian analisis. Dalam codebase rekayasa perangkat lunak, informasi itu sering bersifat pelengkap. Dalam pekerjaan data science, sering kali tidak demikian.
Apa Artinya Ini bagi Agen AI
Agen secara bawaan lebih cocok untuk satu domain
Implikasi praktisnya adalah: agen bekerja terbaik ketika alatnya selaras dengan tempat makna berada.
Dalam rekayasa perangkat lunak, agen yang efektif menavigasi arsitektur. Ia mengikuti call graph, menghormati antarmuka, dan menjaga konsistensi perubahan di seluruh codebase. Itu berhasil karena sebagian besar makna dikodekan dalam struktur.
Dalam data science, agen yang efektif perlu melakukan lebih dari sekadar menavigasi kode. Ia perlu memahami apa yang sebenarnya dikandung data, melacak status lintas langkah, mengikuti asal-usul variabel, dan menalar mengapa sebuah transformasi atau penyaring diterapkan beberapa langkah sebelumnya.
Agen yang dibangun untuk rekayasa perangkat lunak tidak akan otomatis berpindah dengan baik ke pekerjaan data science. Masalahnya bukan hanya sintaks. Struktur informasi yang mendasarnya berbeda.
Mengapa alur kerja bergaya notebook tetap bertahan
Ini juga membantu menjelaskan sesuatu yang sering membingungkan para insinyur: mengapa notebook tetap begitu sentral meskipun ada keterbatasan yang jelas.
Jawabannya adalah notebook menjaga makna tetap dekat dengan data saat pertanyaan analitis masih berkembang. Notebook bukan sekadar modul Python yang strukturnya buruk. Ini adalah artefak berbeda yang dibangun untuk tahap pekerjaan yang berbeda. Ia menjaga kode, keluaran, dan keputusan tetap berdekatan saat analisis masih terbentuk.
Itulah sebabnya notebook dapat terasa intuitif bagi analis yang hidup di dalam konteksnya, dan terasa canggung bagi agen yang hanya melihat kodenya.
Melakukan refactor notebook menjadi kode yang bersih dan modular sebelum pertanyaan analitisnya matang sering kali bukan perbaikan. Itu dapat memisahkan logika dari konteks yang awalnya memberinya makna.
Peluangnya: menutup kesenjangan produksi
Peluang nyata bagi agen AI dalam data science bukan sekadar menyalin apa yang sudah berhasil dalam rekayasa perangkat lunak. Melainkan membantu menutup kesenjangan produksi: jarak antara wawasan yang ditemukan dalam eksplorasi dan alur kerja yang dapat direproduksi serta dapat di-deploy.
Kesenjangan itu ada karena notebook mempertahankan konteks analitis dengan mengorbankan kerapian struktur. Agen yang dapat memahami baik konteks analitis maupun kebutuhan struktural sistem produksi dapat membantu menjembatani kesenjangan itu tanpa memaksa analis manusia keluar dari mode eksplorasi terlalu dini.
Itu masalah yang lebih sulit daripada menavigasi codebase. Namun juga yang lebih penting.
Inti Pembahasan
Sebagai ringkasan dari yang disarankan analisis di seluruh repositori yang diteliti:
Kesimpulan
Saat memulai analisis ini, saya memperkirakan akan menemukan bahwa kode data science sekadar kurang terstruktur dibandingkan kode rekayasa perangkat lunak. Namun yang saya temukan justru bahwa kodenya tersusun secara berbeda karena alasan yang kuat, dengan makna yang sering tinggal di tempat yang berbeda.
Itu memiliki konsekuensi praktis bagi siapa pun yang membangun atau mengevaluasi agen AI untuk pekerjaan analitis. Pertanyaan yang sebenarnya bukan apakah agen dapat menulis Python yang benar. Melainkan apakah ia memahami apa itu data, mengapa analisis berbentuk seperti itu, dan keputusan apa yang dibuat sepanjang jalan yang tidak terlihat dari kode saja.
Kode data science bukanlah rekayasa perangkat lunak yang belum matang. Ini adalah optimasi yang sepenuhnya berbeda: lebih bergantung pada status eksternal, kurang bertumpu pada struktur internal yang tahan lama selama eksplorasi, dan dibentuk oleh konteks sama besarnya dengan oleh kode.
Setelah Anda melihat itu, notebook berhenti terlihat seperti proyek perangkat lunak yang gagal dan mulai lebih tampak seperti apa adanya: permukaan kerja untuk bernalar atas data yang berubah.
Saya melanjutkan analisis ini dengan dataset yang lebih besar berisi 1.000 repositori atau lebih dan metrik tambahan. Jika Anda ingin menggali lebih dalam tentang bagaimana agen AI dibangun untuk bekerja dengan data dalam konteks (termasuk arsitektur eksekusi persisten yang mempertahankan status data lintas sesi), AI agent fundamentals track dari DataCamp adalah tempat yang tepat untuk memulai.