

设置 AWS MSK
开始使用 AWS MSK,首先创建您的 AWS 账户。若这是您首次使用 AWS,请参阅我们的综合教程,学习如何设置与配置您的 AWS 账户。
登录 AWS 管理控制台并打开 MSK 控制台。点击 "Create cluster" 开始设置流程。
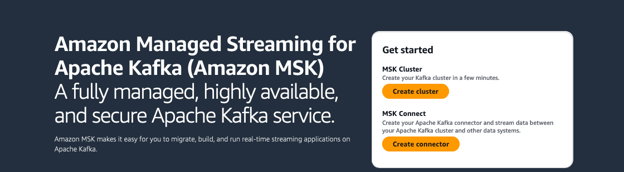
开始使用 AWS MSK。图片来源:AWS
选择 "Quick create" 采用默认设置,然后输入一个具有描述性的集群名称。
接下来,您可以根据集群的具体需求选择许多附加选项。以下是这些选项的快速概览:
- 集群类型:“Provisioned” 或 “Serverless”
- Apache Kafka 版本
- Broker 类型:“Standard” 或 “Express”
- Broker 规格
- EBS 存储容量
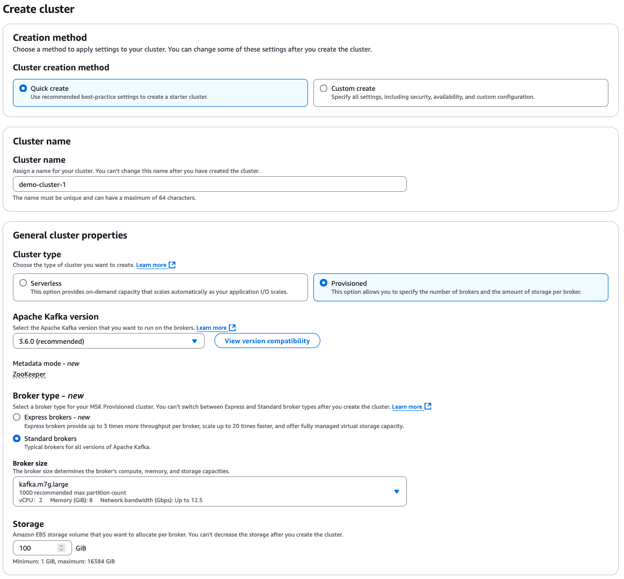
AWS MSK 配置选项
集群始终创建在 Amazon VPC 中。您可以选择使用默认 VPC,或配置并指定自定义 VPC。
现在,只需等待集群激活,这可能需要 15 至 30 分钟。您可以在集群概览页面监控状态,看到状态从 “Creating” 变为 “Active”。
使用 AWS MSK 进行数据摄取与处理
设置好 MSK 集群后,您需要创建客户端机器来在一个或多个主题间生产与消费数据。由于 Apache Kafka 能与众多数据生产者(如网站、IoT 设备、Amazon EC2 实例等)良好集成,MSK 同样具备这一优势。
Apache Kafka 以主题(topics)为单位组织数据。每个主题由一个或多个分区(partitions)构成。分区体现了 Apache Kafka 的并行度。数据通过分区策略在各个 broker 之间分布。
处理 Apache Kafka 集群时需要了解的关键术语:
- Topics 是 Kafka 组织数据的基本方式。
- Producers 是将数据发布到主题的应用——它们在 Kafka 上生成并写入数据,写入到特定主题及其分区。
- Consumers 是从主题读取并处理数据的应用。它们从所订阅的主题中拉取数据。
使用 AWS MSK 构建事件驱动架构时,您需要配置多个层级,其中 MSK 是主要的数据摄取组件。以下是可能涉及的层级概览:
- 数据摄取层
- 处理层
- 存储层
- 分析层
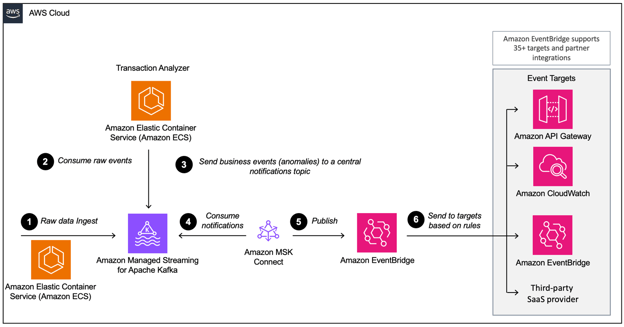
使用 Amazon MSK 与 Amazon EventBridge 的事件驱动架构示例。 图片来源:AWS
如果您希望在数据管道工作流中发挥 Python 的优势,欢迎查看我们的 Introduction to AWS Boto in Python 课程。
使用 AWS MSK 的最佳实践
AWS MSK 相对容易上手并立即投入使用。不过,一些关键的最佳实践将显著提升集群性能,并为您日后节省时间。
合理确定集群规模
您需要选择每个 broker 的合适分区数,以及每个集群的合适 broker 数量。
这里的决策会受到多种因素影响;不过,AWS 提供了实用的建议与资源,可指导您完成这一过程。
此外,AWS 还提供易用的规模与定价表,帮助您估算集群的合适规模,以及使用 AWS MSK 与类似自管 EC2 Kafka 集群的成本对比。
构建高可用集群
AWS 建议将集群设置为高可用。这在执行更新(例如升级 Apache Kafka 版本)或 AWS 替换 broker 时尤为重要。
要确保集群高度可用,您必须做到以下三点:
- 将集群部署在三个可用区(即 3-AZ 集群)。
- 将副本因子(replication factor)设置为 3 或以上。
- 将最小同步副本数(in-sync replicas)设置为 RF-1。
AWS 的优势在于其对多可用区部署承诺严格的 SLA;否则,您将获得抵扣(credits)。
监控磁盘与 CPU 使用率
通过 AWS CloudWatch 需要重点监控的两个指标是磁盘与 CPU 使用率。这样不仅能确保系统平稳运行,还有助于控制成本。
管理磁盘使用与相关存储成本的最佳方式,是设置 CloudWatch 警报:当磁盘使用超过某个阈值(如 85%)时告警,并据此调整保留策略。为日志消息设置保留时间,有助于自动释放磁盘空间。
此外,为维持集群性能并避免瓶颈,AWS 建议将各 broker 的总 CPU 使用率保持在 60% 以下。您可借助 AWS CloudWatch 进行监控,并通过调整 broker 规格等方式采取纠正措施。
使用传输中加密保护数据
默认情况下,AWS 会对 MSK 集群中 broker 之间的传输数据进行加密。如果系统出现高 CPU 使用或高延迟,您可以关闭此功能。但强烈建议始终启用传输中加密,若存在性能问题,请优先通过其他方式优化。
查看我们的 AWS Security and Cost Management 课程,深入了解如何保护与优化 AWS 云环境,并在 AWS 中管理成本与资源。
了解 AWS MSK 定价
AWS MSK 采用按需付费模式,即只为您实际使用的资源付费。但价格会因集群类型、broker 实例规格、存储与数据传输而异。下面我们将拆解关键成本要素,并介绍如何优化 MSK 支出。
AWS MSK 定价组成
| 成本组成 | 描述 | 计费方式 |
|---|---|---|
| Broker 实例小时数 | 集群中 Kafka broker 的运行时间 | 按小时计费,基于实例类型 |
| 存储 | 用于 Kafka 日志的 EBS 存储 | 按 GB/月 |
| 数据传输 | 在 broker 与客户端之间移动的数据 | 按 AWS 标准数据传输费率 |
| 预置吞吐量(可选) | 为读/写提供专用吞吐 | 按 MB/秒 |
| 无服务器请求(适用于无服务器集群) | 读写请求 | 按摄取与读取的 GB 计费 |
按集群类型划分的 AWS MSK 定价
AWS MSK 提供两种集群类型,对应不同的定价模型:
预置型 MSK 集群(标准定价模型)
- 您需为 broker 实例、存储与数据传输付费。
- 适合需要精细性能控制的工作负载。
无服务器 MSK 集群(按请求计费)
- 按处理的数据量(摄取/读取的 GB)计价。
- 适合流量模式不可预测的应用。
应如何选择?
- 选择预置型 MSK → 适用于工作负载可预测且需控制实例规格的场景。
- 选择无服务器 MSK → 适用于负载波动较大且不想管理 broker 的场景。
使用 AWS 定价计算器,基于您的工作负载估算成本。
AWS MSK 与其他流式工具对比
在为项目选型时,我们通常需要评估多个选项。以下是 AWS MSK 的常见替代方案及其对比方式。
AWS MSK vs 在 EC2 上部署 Apache Kafka
MSK 与在 EC2 上自建方案之间的主要权衡在于便利性与可控性:
- AWS MSK:
- 全托管服务,降低运维复杂度。
- 自动化资源供应与配置——无前期基础设施成本。
- 与 AWS 服务无缝集成。
- 稳健的安全特性。
- 与自建方案相比灵活性较低。
- 在 EC2 上的 Kafka:
- 需要手动搭建、配置与维护。
- 对基础设施与定制化拥有完全控制权。
- 潜在运维成本更高。
- 需要更多专业知识与持续管理。
AWS MSK vs. Kinesis
在 AWS MSK 与 Kinesis 之间进行选择取决于您的侧重点:
- 在以下情况使用 Kinesis:
- 您需要完全无服务器的架构。
- AWS 托管、运维开销极低。
- 使用分片进行数据流处理,但存在数据保留限制。
- 更适合简单的数据流需求。
- 在以下情况使用 AWS MSK:
- 您需要 Kafka 的主题与分区模型。
- 几乎无限的数据保留(取决于存储)。
- 更灵活且可定制。
- 如有需要,可从 AWS 迁移出去。
如果您不熟悉 Kinesis,我们提供了一门课程,带您实践 使用 AWS Kinesis 与 Lambda 进行流数据处理。
AWS MSK vs. Confluent
在 AWS MSK 与 Confluent 之间进行选择,取决于功能需求与云战略:
- 在以下情况使用 Confluent:
- 您需要功能完备且内置连接器的方案。
- 您倾向于更简化的部署流程。
- 您需要应对尖峰负载并进行动态扩展。
- 成本较高,但提供功能受限的免费层。
- 在以下情况使用 AWS MSK:
- 您希望在稳定工作负载下更具性价比。
- 您已深度融入 AWS 生态。
- 您具备内部的 Kafka 专业能力。
- 您可以接受通过集成额外的 AWS 服务来扩展功能。
下表对 AWS MSK 与其替代方案进行了比较:
|
功能 |
AWS MSK |
在 EC2 上的 Apache Kafka |
Kinesis |
Confluent |
|
部署方式 |
全托管 |
在 EC2 上自管 |
全托管 |
全托管或自管 |
|
易用性 |
易于设置与管理 |
需要手动设置与扩展 |
设置简单;AWS 原生 |
友好的 UI 与高级工具 |
|
可扩展性 |
自动扩展并可手动调整 |
手动扩展 |
无缝扩展 |
弹性的自动扩展 |
|
延迟 |
低延迟 |
低延迟 |
小负载下延迟更低 |
与 MSK 相当 |
|
协议支持 |
兼容 Kafka API |
兼容 Kafka API |
专有的 Kinesis 协议 |
Kafka API 与其他协议 |
|
数据保留 |
可配置(默认最长 7 天) |
可配置 |
可配置(最长 365 天) |
高度可配置 |
|
监控与指标 |
与 CloudWatch 集成 |
需要自定义设置 |
与 CloudWatch 集成 |
高级监控工具 |
|
成本 |
按需付费 |
基于 EC2 实例定价 |
按需付费 |
订阅制 |
|
安全 |
内置 AWS 安全特性 |
需手动配置安全 |
与 AWS IAM 集成 |
全面的安全功能 |
|
适用场景 |
最适合 AWS 生态中的 Kafka 用户 |
灵活,但维护成本高 |
最适合 AWS 原生应用 |
面向高级 Kafka 用户与企业 |
结语
在需要大规模、可靠、不能容忍数据丢失,并需连接多数据源或构建复杂数据管道的场景中,Apache Kafka 是首选方案。AWS MSK 免去了设置与配置 Kafka 集群的诸多烦恼,使开发者能将更多精力投入到应用的构建与改进,而非基础设施。
FAQs
AWS MSK 能否与 Lambda 和 S3 等其他 AWS 服务集成?
可以。AWS MSK 可与许多 AWS 服务集成。您可以使用 MSK Connect 运行全托管的 Kafka Connect 连接器。可使用预构建连接器或创建自定义连接器,以在 MSK 与 S3、OpenSearch、RDS 等服务之间移动数据。AWS MSK 还可以作为 Lambda 函数的事件源。您可以配置 Lambda 轮询 MSK 主题,并基于新消息自动调用函数,支持批处理与错误处理。
我可以将现有的 Kafka 集群迁移到 AWS MSK 吗?
可以。迁移到 MSK 有多种方式。您可以使用 MirrorMaker 2.0 进行集群复制、执行直接的主题迁移,或使用第三方工具。AWS 提供了详尽的迁移文档和最佳实践,以尽量减少停机时间。
AWS MSK 集群有哪些可用的监控与指标?
MSK 与 CloudWatch 集成以进行监控,提供关于 broker 健康状况、集群性能与消费者滞后等指标。关键指标包括 CPU 利用率、磁盘空间、网络吞吐量与分区数量。

许多公司选择转向 AWS MSK,以避免管理 Apache Kafka 集群所带来的运维负担。
在本教程中,我们将探讨 AWS MSK 的功能、优势与最佳实践。我们还将介绍设置 AWS MSK 的基本步骤,并将其与 Kinesis、Confluent 等热门服务进行对比。
什么是 AWS MSK?
首先,让我们了解一下 Apache Kafka,以及它为什么对数据流处理如此有用。
Apache Kafka 是一个开源的分布式流处理平台,可处理实时数据流,并构建事件驱动的应用。它能够在数据产生的同时进行摄取与处理。
根据 Kafka 官网的信息,超过 80% 的财富 100 强公司信任并使用 Kafka。
最重要的是,Kafka 具有可扩展性且速度极快。这意味着它可以处理远超单机容量的数据,并保持极低的延迟。
如果您想学习如何为数据流创建、管理和排查 Kafka,建议学习 Introduction to Kafka 课程。
何时最适合使用 Apache Kafka?
然而,管理 Kafka 实例可能会带来诸多麻烦。这正是 AWS MSK 发挥作用的地方。
作者制图
AWS MSK(Managed Streaming for Kafka)是一个全托管服务,负责 Kafka 集群的资源供应、配置、扩展与维护。您可以用它来构建对数据流即时响应的应用。
Kafka 常作为更大型数据处理体系的一部分,而 AWS MSK 进一步简化了实时数据管道的构建,让数据能在不同系统间流动。
Amazon MSK 的工作原理。图片来源:AWS
如果您是 AWS 新手,建议先学习我们的 Introduction to AWS 课程,了解基础知识。准备就绪后,您可以继续学习 AWS Cloud Technology and Services 课程,深入了解企业依赖的全套服务。
AWS MSK 的功能
AWS MSK 的优势在于其全托管特性。您无需操心服务器的搭建或更新。
不过,亮点不止于此。以下这五个关键功能使 AWS MSK 值得投资:
使用 AWS MSK 的好处
如前所述,AWS MSK 由于其可用性、可扩展性、安全性与易集成性,能够立刻带来价值。这些核心优势使其成为企业在云中运行 Kafka 工作负载的首选。
AWS MSK 解决了每个数据流项目都会面临的四大关键挑战: