
कोर्स
AWS कॉन्सेप्ट्स
2 घंटा
52.8K
कई कंपनियाँ Apache Kafka क्लस्टर्स को मैनेज करने की परिचालनिक जटिलताओं से बचने के लिए AWS MSK अपनाना चुन रही हैं।
इस ट्यूटोरियल में, हम AWS MSK की विशेषताओं, फायदों, और श्रेष्ठ तरीकों की पड़ताल करेंगे। हम AWS MSK सेट अप करने के बुनियादी चरणों से भी गुजरेंगे और देखेंगे कि यह Kinesis और Confluent जैसे अन्य लोकप्रिय सेवाओं की तुलना में कैसा है।
पहले, आइए Apache Kafka को समझें और जानें कि डेटा स्ट्रीमिंग के लिए यह इतना उपयोगी क्यों है।
Apache Kafka एक ओपन-सोर्स्ड डिस्ट्रिब्यूटेड स्ट्रीमिंग प्लेटफ़ॉर्म है जो रियल-टाइम डेटा स्ट्रीम्स को संभालता है और इवेंट-ड्रिवन ऐप्स बना सकता है। यह स्ट्रीमिंग डेटा को उसी समय इनजेस्ट और प्रोसेस कर सकता है।
Kafka की वेबसाइट के अनुसार, Fortune 100 की 80% से अधिक कंपनियाँ Kafka पर भरोसा करती हैं और उसका उपयोग करती हैं।
सबसे महत्वपूर्ण बात, Kafka स्केलेबल है और बहुत तेज़ है। इसका मतलब है कि यह एक ही मशीन में फिट होने वाले डेटा से कई गुना अधिक डेटा को बेहद कम लैटेंसी के साथ संभाल सकता है।
यदि आप डेटा स्ट्रीमिंग के लिए Kafka को बनाना, प्रबंधित करना, और ट्रबलशूट करना सीखना चाहते हैं, तो Introduction to Kafka कोर्स लेने पर विचार करें।
Apache Kafka का उपयोग सबसे अच्छा कब है?
हालाँकि, Kafka इंस्टैंसेज़ को मैनेज करना काफी सिरदर्दी ला सकता है। यहीं AWS MSK काम आता है।
छवि: लेखक द्वारा
AWS MSK (Managed Streaming for Kafka) एक फ़ुली मैनेज्ड सेवा है जो Kafka क्लस्टर्स के प्रोविजनिंग, कॉन्फ़िगरेशन, स्केलिंग, और मेंटेनेंस को संभालती है। आप इसका उपयोग ऐसी ऐप्स बनाने के लिए कर सकते हैं जो डेटा स्ट्रीम्स पर तुरंत प्रतिक्रिया दें।
Kafka का उपयोग अक्सर बड़े डेटा प्रोसेसिंग सेटअप के हिस्से के रूप में किया जाता है, और AWS MSK रियल-टाइम डेटा पाइपलाइंस बनाना और भी आसान बना देता है जो अलग-अलग सिस्टम्स के बीच डेटा को ले जाएँ।
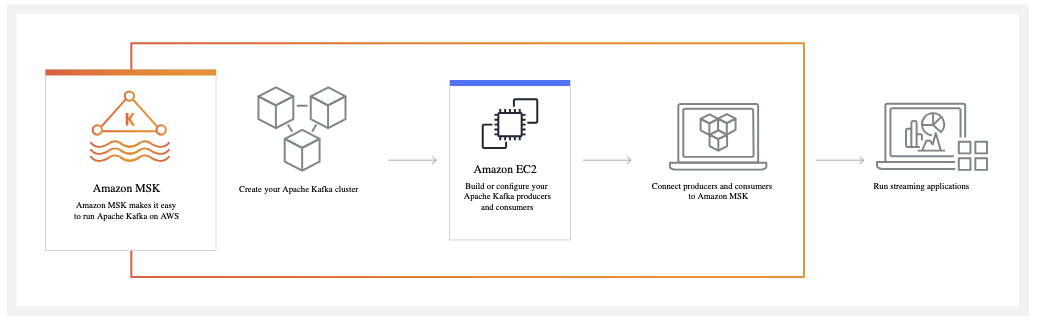
Amazon MSK कैसे काम करता है। छवि स्त्रोतe: AWS
यदि आप AWS में नए हैं, तो मूल बातें समझने के लिए हमारा Introduction to AWS कोर्स लेने पर विचार करें। जब आप तैयार हों, तो आप हमारे AWS Cloud Technology and Services कोर्स पर आगे बढ़ सकते हैं ताकि उन सभी सेवाओं का अन्वेषण कर सकें, जिन पर व्यवसाय निर्भर करते हैं।
AWS MSK प्रतिस्पर्धा से इसलिए अलग है क्योंकि यह एक फ़ुली मैनेज्ड सेवा है। आपको सर्वर सेटअप या अपडेट्स से जूझने की ज़रूरत नहीं है।
लेकिन बात यहीं खत्म नहीं होती। AWS MSK की ये पाँच प्रमुख विशेषताएँ इसे एक लाभकारी निवेश बनाती हैं:
जैसा कि हमने देखा, उपलब्धता, स्केलेबिलिटी, सुरक्षा, और आसान इंटीग्रेशन के कारण AWS MSK तुरंत मूल्य देता है। ये मुख्य लाभ क्लाउड में Kafka वर्कलोड्स चलाने वाली कंपनियों के लिए इसे पसंदीदा विकल्प बनाते हैं।
AWS MSK चार अहम चुनौतियों को हल करता है जिनका सामना हर डेटा स्ट्रीमिंग प्रोजेक्ट करता है:
AWS MSK के साथ शुरुआत करने के लिए, सबसे पहले अपना AWS अकाउंट बनाएँ। यदि आप पहली बार AWS का उपयोग कर रहे हैं, तो हमारे व्यापक ट्यूटोरियल के साथ अपना AWS अकाउंट सेट अप और कॉन्फ़िगर करना सीखें।
AWS Management Console में साइन इन करें और MSK कंसोल खोलें। सेटअप प्रक्रिया शुरू करने के लिए "Create cluster" पर क्लिक करें।
AWS MSK के साथ शुरुआत। छवि स्त्रोतe: AWS
डिफ़ॉल्ट सेटिंग्स के लिए "Quick create" चुनें, फिर एक वर्णनात्मक क्लस्टर नाम दर्ज करें।
इसके बाद, आपके पास कई अतिरिक्त विकल्प होते हैं, जो आपके क्लस्टर की आवश्यकताओं पर निर्भर करते हैं। यहाँ विकल्पों का एक त्वरित अवलोकन है:
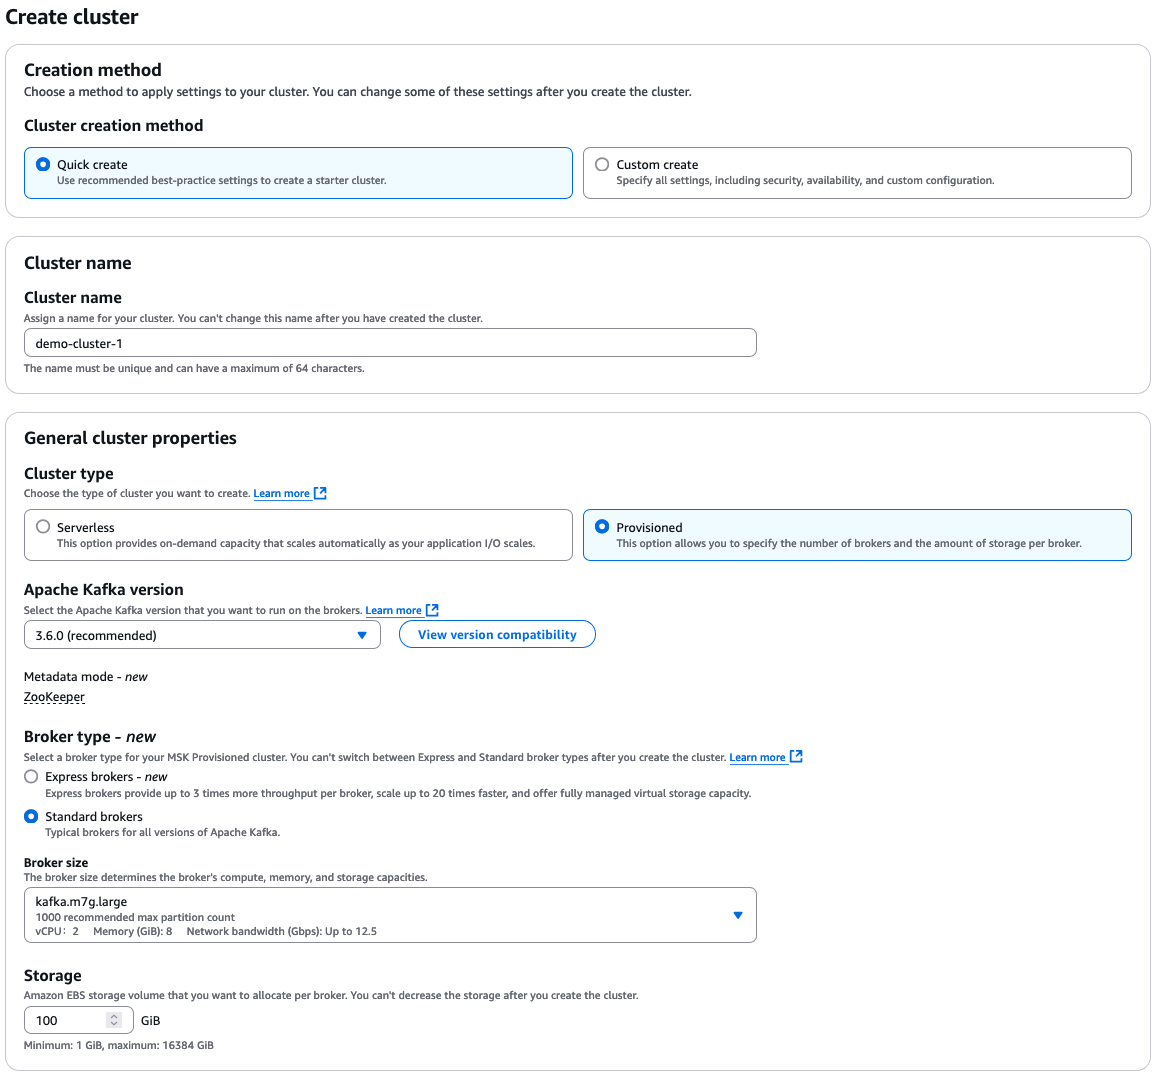
AWS MSK कॉन्फ़िगरेशन विकल्प
क्लस्टर हमेशा Amazon VPC के भीतर बनाया जाता है। आप डिफ़ॉल्ट VPC का उपयोग चुन सकते हैं या एक कस्टम VPC कॉन्फ़िगर और निर्दिष्ट कर सकते हैं।
अब, आपको बस अपने क्लस्टर के सक्रिय होने का इंतज़ार करना है, जिसमें 15 से 30 मिनट लग सकते हैं। आप क्लस्टर समरी पेज से अपने क्लस्टर की स्थिति मॉनिटर कर सकते हैं, जहाँ स्थिति “Creating” से “Active” में बदलती दिखाई देगी।
एक बार आपका MSK क्लस्टर सेट अप हो जाने के बाद, आपको एक क्लाइंट मशीन बनानी होगी जो एक या अधिक टॉपिक्स में डेटा प्रोड्यूस और कंज़्यूम करे। चूँकि Apache Kafka कई डेटा प्रोड्यूसर्स (जैसे वेबसाइट्स, IoT डिवाइसेज़, Amazon EC2 इंस्टैंसेज़ आदि) के साथ बहुत अच्छी तरह इंटीग्रेट होता है, MSK भी इस लाभ को साझा करता है।
Apache Kafka डेटा को टॉपिक्स नामक संरचनाओं में व्यवस्थित करता है। प्रत्येक टॉपिक एक या कई पार्टिशंस से बना होता है। पार्टिशंस Apache Kafka में पैरेललिज़्म की डिग्री हैं। डेटा पार्टिशनिंग का उपयोग करके डेटा ब्रोकर्स में वितरित किया जाता है।
Apache Kafka क्लस्टर्स के साथ काम करते समय जानने योग्य प्रमुख शब्दावली:
AWS MSK के साथ इवेंट-ड्रिवन आर्किटेक्चर बनाते समय, आपको कई लेयर्स कॉन्फ़िगर करनी होती हैं, जिनमें MSK मुख्य डेटा इनजेशन घटक है। यहाँ आवश्यक लेयर्स का एक अवलोकन है:
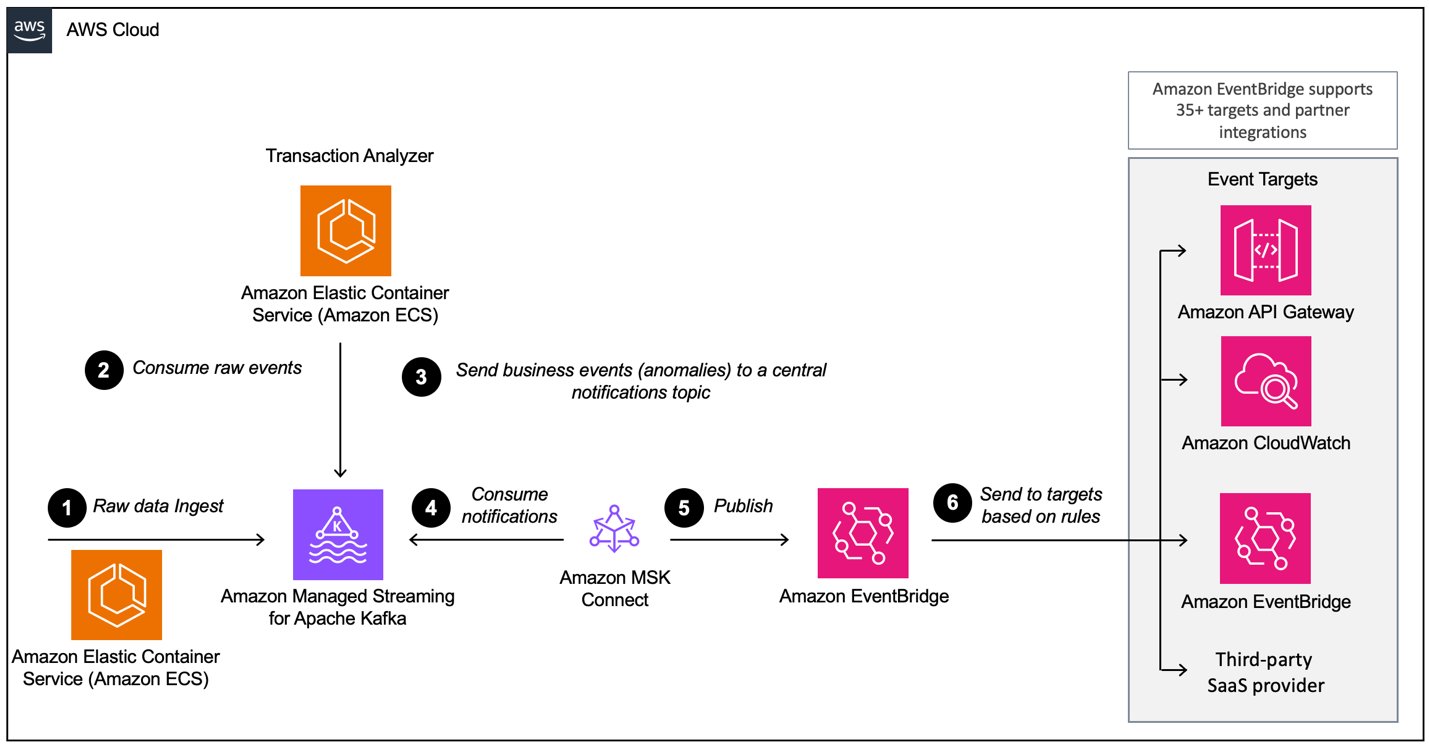
Amazon MSK और Amazon EventBridge के साथ इवेंट-ड्रिवन आर्किटेक्चर का उदाहरण। छवि स्त्रोत: AWS
यदि आप अपने डेटा पाइपलाइन वर्कफ़्लोज़ में Python का लाभ उठाने में रुचि रखते हैं, तो हमारा Introduction to AWS Boto in Python कोर्स देखें।
AWS MSK सेट अप करना अपेक्षाकृत सरल है और आप तुरंत इसका उपयोग शुरू कर सकते हैं। हालाँकि, कुछ आवश्यक श्रेष्ठ तरीके आपके क्लस्टर्स के प्रदर्शन में सुधार करेंगे और आगे चलकर आपका समय बचाएँगे।
आपको प्रति ब्रोकर्स सही पार्टिशंस की संख्या और प्रति क्लस्टर सही ब्रोकर्स की संख्या चुननी होगी.
यहाँ कई कारक आपके निर्णयों को प्रभावित कर सकते हैं; हालाँकि, AWS ने इस प्रक्रिया में मार्गदर्शन हेतु कुछ उपयोगी सिफारिशें और संसाधन प्रदान किए हैं।
इसके अलावा, AWS एक आसान साइज़िंग और प्राइसिंग स्प्रेडशीट प्रदान करता है, जिससे आप अपने क्लस्टर का सही आकार और AWS MSK के उपयोग की लागतों का अनुमान लगा सकते हैं तथा एक समान स्वयं-प्रबंधित EC2 Kafka क्लस्टर से तुलना कर सकते हैं।
AWS अनुशंसा करता है कि आप अपने क्लस्टर्स को उच्च उपलब्धता के लिए सेट अप करें। यह विशेष रूप से तब महत्वपूर्ण है जब आप कोई अपडेट कर रहे हों (जैसे Apache Kafka संस्करण अपडेट करना) या जब AWS किसी ब्रोकर्स को बदल रहा हो।
यह सुनिश्चित करने के लिए कि आपके क्लस्टर्स उच्च उपलब्धता वाले हों, आपको तीन चीज़ें करनी चाहिए:
AWS की अच्छी बात यह है कि वे मल्टी-AZ डिप्लॉयमेंट्स के लिए सख्त SLA के लिए प्रतिबद्ध हैं; अन्यथा, आपको क्रेडिट्स वापस मिलते हैं।
AWS CloudWatch के माध्यम से मॉनिटर करने के लिए दो प्रमुख मेट्रिक्स डिस्क और CPU उपयोग हैं। ऐसा करने से न केवल आपका सिस्टम सुचारू रूप से चलता रहेगा बल्कि लागतें भी नियंत्रण में रहेंगी।
डिस्क उपयोग और संबंधित स्टोरेज लागतों को प्रबंधित करने का सबसे अच्छा तरीका यह है कि एक CloudWatch अलार्म सेट करें जो डिस्क उपयोग किसी निश्चित मान, जैसे 85%, से अधिक होने पर आपको सूचित करे, और अपनी रिटेंशन नीतियों को समायोजित करें। अपने लॉग में संदेशों के लिए रिटेंशन समय सेट करना डिस्क स्पेस को स्वचालित रूप से खाली करने में काफी मदद करता है।
इसके अतिरिक्त, अपने क्लस्टर के प्रदर्शन को बनाए रखने और बॉटलनेक्स से बचने के लिए, AWS अनुशंसा करता है कि आप अपने ब्रोकर्स के लिए कुल CPU उपयोग 60% से कम रखें। आप इसे AWS CloudWatch का उपयोग करके मॉनिटर कर सकते हैं और फिर, उदाहरण के लिए, अपने ब्रोकर्स साइज़ को अपडेट करके सुधारात्मक कदम उठा सकते हैं।
डिफ़ॉल्ट रूप से, AWS आपके MSK क्लस्टर में ब्रोकर्स के बीच ट्रांजिट में डेटा को एन्क्रिप्ट करता है। यदि आपकी प्रणाली में उच्च CPU उपयोग या लैटेंसी हो रही है, तो आप इसे अक्षम कर सकते हैं। हालाँकि, सख्ती से अनुशंसा की जाती है कि आप हमेशा इन-ट्रांजिट एन्क्रिप्शन सक्षम रखें और यदि प्रदर्शन समस्या है तो उसे सुधारने के अन्य तरीकों की तलाश करें।
हमारा AWS Security and Cost Management कोर्स देखें ताकि आप अपने AWS क्लाउड वातावरण को सुरक्षित और अनुकूलित करना तथा AWS में लागतों और संसाधनों को मैनेज करना सीख सकें।
AWS MSK प्राइसिंग पे-एज़-यू-गो है, यानी आप केवल उन्हीं संसाधनों के लिए भुगतान करते हैं जिनका आप उपयोग करते हैं। हालाँकि, प्राइसिंग क्लस्टर प्रकार, ब्रोकर्स इंस्टैंस साइज़, स्टोरेज, और डेटा ट्रांसफ़र के आधार पर भिन्न होती है। नीचे, हम प्रमुख लागत कारकों और अपने MSK खर्च को ऑप्टिमाइज़ करने के तरीकों का विवरण देते हैं।
| लागत घटक | विवरण | बिलिंग कैसे होती है |
|---|---|---|
| ब्रोकर इंस्टैंस आवर्स | आपके क्लस्टर में Kafka ब्रोकर्स के चलने का समय | इंस्टैंस प्रकार के आधार पर प्रति घंटा |
| स्टोरेज | Kafka लॉग्स के लिए EBS स्टोरेज | प्रति GB प्रति माह |
| डेटा ट्रांसफ़र | ब्रोकर्स और क्लाइंट्स के बीच स्थानांतरित डेटा | मानक AWS डेटा ट्रांसफ़र दरें |
| प्रोविज़न्ड थ्रूपुट (वैकल्पिक) | रीड/राइट के लिए समर्पित थ्रूपुट | प्रति MB प्रति सेकंड |
| सर्वरलेस रिक्वेस्ट्स (सर्वरलेस क्लस्टर्स के लिए) | रीड और राइट रिक्वेस्ट्स | प्रति GB इनजेस्टेड और रिट्रीव्ड |
AWS MSK दो क्लस्टर प्रकार देता है, जिनके प्राइसिंग मॉडल अलग हैं:
प्रोविज़न्ड MSK क्लस्टर (मानक प्राइसिंग मॉडल)
सर्वरलेस MSK क्लस्टर (पे-पर-रिक्वेस्ट मॉडल)
आपको कौन सा चुनना चाहिए?
अपने वर्कलोड के आधार पर लागत का अनुमान लगाने के लिए AWS Pricing Calculator आज़माएँ।
जब यह तय करना हो कि किसी प्रोजेक्ट के लिए कौन सा टूल सबसे अच्छा है, तो हमें अक्सर कई विकल्पों का मूल्यांकन करना पड़ता है। यहाँ AWS MSK के सबसे सामान्य विकल्प हैं और उनकी तुलना।
MSK और EC2 का उपयोग करते हुए स्वयं-होस्टेड विकल्प के बीच मुख्य समझौता सुविधा और नियंत्रण के बीच है:
AWS MSK और Kinesis के बीच चुनना आपकी प्राथमिकताओं पर निर्भर करता है:
यदि आप Kinesis से परिचित नहीं हैं, तो हमारे पास एक कोर्स है जो आपको AWS Kinesis और Lambda के साथ स्ट्रीमिंग डेटा पर काम करना सिखाता है।
AWS MSK और Confluent के बीच चुनाव फीचर आवश्यकताओं और क्लाउड रणनीति पर निर्भर करता है:
निम्न तालिका AWS MSK और उसके विकल्पों की तुलना प्रस्तुत करती है:
|
फ़ीचर |
AWS MSK |
EC2 पर Apache Kafka |
Kinesis |
Confluent |
|
डिप्लॉयमेंट |
फ़ुली मैनेज्ड |
EC2 पर स्वयं-प्रबंधित |
फ़ुली मैनेज्ड |
फ़ुली मैनेज्ड या स्वयं-प्रबंधित |
|
उपयोग में आसानी |
सेट अप और प्रबंधन में आसान |
मैनुअल सेटअप और स्केलिंग की आवश्यकता |
सरल सेटअप; AWS-नेटिव |
यूज़र-फ्रेंडली UI और उन्नत टूल्स |
|
स्केलेबिलिटी |
मैनुअल समायोजनों के साथ ऑटो-स्केलिंग |
मैनुअल स्केलिंग |
सीमलेस स्केलिंग |
लचीलापन के साथ ऑटो-स्केलिंग |
|
लैटेंसी |
कम लैटेंसी |
कम लैटेंसी |
छोटे पेलोड्स के लिए कम लैटेंसी |
MSK के समान |
|
प्रोटोकॉल सपोर्ट |
Kafka API संगत |
Kafka API संगत |
प्रोप्रायटरी Kinesis प्रोटोकॉल |
Kafka API और अतिरिक्त प्रोटोकॉल |
|
डेटा रिटेंशन |
कॉन्फ़िगरेबल (डिफ़ॉल्ट रूप से 7 दिन तक) |
कॉन्फ़िगरेबल |
कॉन्फ़िगरेबल (अधिकतम 365 दिन) |
अत्यधिक कॉन्फ़िगरेबल |
|
मॉनिटरिंग और मेट्रिक्स |
CloudWatch के साथ एकीकृत |
कस्टम सेटअप की आवश्यकता |
CloudWatch के साथ एकीकृत |
उन्नत मॉनिटरिंग टूल्स |
|
लागत |
पे-एज़-यू-गो |
EC2 इंस्टैंस प्राइसिंग पर आधारित |
पे-एज़-यू-गो |
सब्सक्रिप्शन-आधारित |
|
सुरक्षा |
बिल्ट-इन AWS सुरक्षा सुविधाएँ |
सुरक्षा को मैनुअल रूप से कॉन्फ़िगर करना होगा |
AWS IAM के साथ एकीकृत |
व्यापक सुरक्षा सुविधाएँ |
|
उपयोग-प्रकरण उपयुक्तता |
AWS इकोसिस्टम में Kafka उपयोगकर्ताओं के लिए सर्वोत्तम |
लचीला, लेकिन उच्च मेंटेनेंस |
AWS-नेटिव ऐप्स के लिए सर्वोत्तम |
उन्नत Kafka उपयोगकर्ता और एंटरप्राइज़ |
Apache Kafka उन परिस्थितियों के लिए पसंदीदा विकल्प है जहाँ आपको बड़े पैमाने पर, भरोसेमंद समाधान चाहिए जिसमें डेटा लॉस की गुंजाइश न हो और कई डेटा सोर्स को जोड़ना हो या जटिल डेटा पाइपलाइंस बनानी हों। AWS MSK Kafka क्लस्टर्स को सेट अप और कॉन्फ़िगर करने की कई सिरदर्दियों से बचाता है, जिससे डेवलपर्स इन्फ्रास्ट्रक्चर के बजाय ऐप्लिकेशंस बनाने और सुधारने पर अधिक ध्यान दे सकते हैं।
AWS सर्टिफ़िकेशन पाना आपकी AWS करियर की बेहतरीन शुरुआत हो सकती है। आप हमारे कोर्स कैटलॉग देखकर अपने AWS कौशल बना सकते हैं और प्रोजेक्ट्स के माध्यम से व्यावहारिक अनुभव हासिल कर सकते हैं!
AWS के बारे में और जानें इन कोर्सेज़ के साथ!
कोर्स
कोर्स
लर्निंग पाथ