分区是 Kafka 分布式架构中的关键组件,使 Kafka 能够进行水平扩展,从而高效并行地处理数据。它们是跨 Kafka 集群组织与分发数据的基础单元。
可以将其视为主题中的独立通道,用于存储消息。每个分区可以在不同的 broker 上拥有多个副本,从而保证容错性和数据冗余。
此外,分区提供了有序性保证,确保同一分区内的消息按照生成顺序被处理。这使得 Kafka 分区在维护数据完整性与一致性方面至关重要,对于实时数据处理场景尤为关键。
在本文中,我们将深入探讨以下内容:
- Kafka 架构基础
- 分区在 Kafka 中的重要性
- 分区的设置方法
- 高级分区管理
- 常见分区问题的排查
您也可以查看我们的Kafka 与 SQS 对比,了解这两款工具的详细差异。
Kafka 架构基础
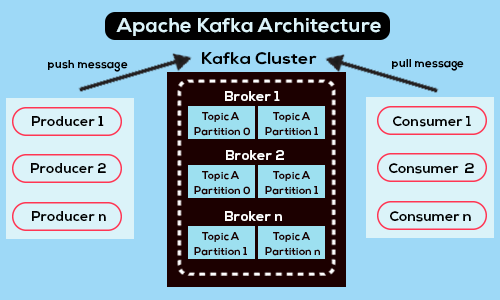
Kafka 架构概览 - 来源
Apache Kafka 是一个开源的分布式流处理平台,具备高吞吐、容错与可伸缩特性,因而广泛用于构建实时数据管道与应用。
Kafka 的核心由多个组件构成,包括生产者、消费者、broker、主题以及分区,每个组件都在整体系统中扮演关键角色。
- 生产者负责生成数据并将其发送到 Kafka 主题。它们通常以键值对的形式向 Kafka broker 发布消息。
- Broker是存储和管理 Kafka 主题的服务器,负责数据复制、分发以及在生产者与消费者之间的通信。
- 主题是 Kafka 中的逻辑类别或数据流。它们充当消息队列,生产者向其中发布数据,消费者从中获取数据。
- 分区是 Kafka 主题内的数据存储与分发的基本单元。
- 消费者是订阅 Kafka 主题以获取并处理数据的应用或进程。它们可以从一个或多个分区读取消息,并可组成消费者组以实现负载均衡与并行处理。
Kafka 分区的重要性
分区在提升 Kafka 的效率与健壮性方面发挥关键作用。它们便于将数据分布到各个 broker,从而实现水平扩展。
通过将主题划分为多个分区,Kafka 能够把数据处理负载分散到多台服务器上,高效利用资源,并在不压垮单个 broker 的情况下应对不断增长的数据量。
此外,分区还实现了数据处理的并行化。消费者可以同时从多个分区读取数据,分散计算负载并提升吞吐。这种并行消费确保了消费者资源的高效利用,并降低了数据处理管道中的延迟。
分区之所以重要的另一个原因在于其增强了平台的容错能力。每个分区可以在不同 broker 上拥有多个副本。当某个 broker 故障时,Kafka 仍可从其他 broker 上的副本提供数据,确保数据的可用性与可靠性。
总而言之,分区的重要性体现在多个方面。它们是 Kafka 架构的核心,促成了可伸缩性、容错性、并行性以及数据一致性。
Kafka 如何管理分区
如前文所述,每个分区都是一段分段的、有序的、不可变的记录序列。当生产者向 Kafka 发送数据时,会使用分区逻辑来决定数据应写入主题中的哪个分区。
该逻辑可以基于多种因素,例如与数据关联的键,或生产者实现的自定义分区器。一旦确定分区,Kafka 会将数据追加到该分区的末尾,并依据偏移量保持消息顺序。
在内部,Kafka broker 负责分区数据的存储与复制。每个分区可以在不同的 broker 上拥有多个副本,以确保容错性。
Kafka 采用主从模型:一个 broker 作为主节点负责处理该分区的读写请求,其他 broker 作为从节点从主节点复制数据。即使发生 broker 故障,此架构也能保证数据的持久性与可用性。
设置 Kafka 分区
在设置 Kafka 分区之前,请确保已在本地机器上安装、配置并运行 Apache Kafka 和 Zookeeper。为获得最佳兼容性,建议这样做。同时确认已安装并可用的 Java 8 或更高版本。
注意,Kafka 在 Windows 上安装时可能会遇到各种问题,因为该操作系统缺乏原生兼容性。因此,建议在 Windows 上通过以下方式运行 Apache Kafka:
- 在 Windows 10 或更高版本上使用 WSL2 或 Docker
- 在 Windows 8 或更早版本上使用 Docker
不建议在 Windows 上直接通过 JVM 运行 Kafka,因为其缺少 Linux 所固有的一些 POSIX 特性。若未使用 WSL2 直接在 Windows 上运行 Kafka,最终可能会遇到诸多问题。
您可以在面向初学者的 Apache Kafka 全面指南中进一步了解 Kafka 的安装与设置。
以下是分区设置的分步指南:
步骤 1:启动 Zookeeper
打开命令提示符并导航到 Kafka 根目录。在该目录下运行以下命令以启动 Zookeeper:
bin/zookeeper-server-start.sh config/zookeeper.properties技术支持
步骤 2:启动 Kafka 服务器
再打开一个命令提示符窗口,并在 Apache Kafka 根目录下运行以下命令以启动 Apache Kafka:
.\bin\windows\kafka-server-start.bat .\config\server.properties技术支持
步骤 3:创建一个包含 3 个分区的主题
要创建一个包含三个分区的主题,请在 Kafka 根目录新开一个命令提示符并运行以下命令:
bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 3 --topic my_topic技术支持
这将创建一个名为“my_topic”的 Kafka 新主题。
注意:为确认是否创建成功,执行该命令后将返回“Create topic <name of topic>.”
您也可以通过运行以下命令验证主题是否已正确创建:
bin/kafka-topics.sh --list --zookeeper localhost:2181技术支持
输出应为:
my_topic技术支持
高级分区管理
对现有主题重新分区
在 Kafka 中对现有主题重新分区涉及修改分区数量,这在应对数据量变化、提升并行度或优化资源利用时可能是必要的。
以下是对现有主题重新分区的若干技术与注意事项:
更改分区数量
- 使用
kafka-topics.sh --alter 命令增加现有主题的分区数。这将把数据重新分布到新分区中。
- 减少分区数量更为复杂,可能需要进行数据迁移或重处理,将多个分区的数据合并到更少的分区中。
数据再分布
- 目标是实现分区间的数据均匀分布,以最大化并行度与资源利用率。
- 定期监控数据分布,识别数据量不成比例的分区并采取纠正措施。
对消费者的影响
- 重新分区可能影响消费者组,尤其当消费者依赖分区分配进行工作负载分发时。需提前规划并调整消费者组配置。
数据保留与持久性
- 在重新分区过程中确保遵循数据保留策略,避免数据丢失或不一致。
- 重新分区不应削弱数据的持久性或可用性。整个过程中应妥善维护副本。
处理在途数据
- 重新分区可能导致在途数据被路由到不同分区。确保生产者与消费者能够平稳应对此情形。
测试与验证
- 在预发布环境执行重新分区操作,验证其对数据处理与消费者行为的影响,再在生产环境中实施变更。
- 在重新分区期间与之后监控 Kafka 集群性能,及时发现问题并确保性能最优。
分区均衡与优化
优化 Kafka 中的分区使用与性能,对确保高效的数据处理、资源利用与整体系统可伸缩性至关重要。
以下是分区均衡与优化的一些策略:
最优分区数量
- 根据数据量、吞吐需求与集群资源确定最优分区数,避免分区过少或过多。
- 随着数据量与处理需求演变,定期重新评估分区数量。
消费者组配置
- 确保消费者组中的分区与主题分区对齐,以最大化并行度,并在消费者之间均衡分配负载。
- 调整消费者组再均衡设置:精细化配置以在再均衡过程中尽量减少中断并优化资源使用。
生产者分区策略
- 使用基于键的分区策略,确保相关消息始终被路由到同一分区,以保持顺序并提升处理效率。
- 也可考虑随机将消息分配到分区,以在 broker 间均衡工作负载,实现负载均衡。
监控与调优
- 持续监控与分区使用、吞吐、延迟、资源利用相关的 Kafka 集群指标。
- 调整 Kafka broker 配置,如堆大小、缓冲区大小与线程池,以优化性能并有效应对突发负载。
横向扩展与硬件升级:
- 向 Kafka 集群添加更多 broker,以分散分区副本并提升整体吞吐与容错能力。
- 考虑升级 CPU、内存与存储等硬件资源,以提升集群性能并应对更高数据量。
常见分区问题排查
Kafka 已成为众多数据密集型应用的基石,但借用《蜘蛛侠》中本叔叔的话,能力越大,潜在的复杂挑战也就越多。
使用 Kafka 时可能会遇到不少常见的分区问题,原因可能包括配置错误、资源受限、数据分布不均等。
本节将深入这些常见分区问题,并讨论相应的解决方法。
数据分布不均
当数据在分区间分布不均时,部分分区可能成为热点,导致资源利用不均与潜在的性能瓶颈。解决之道是持续监控数据分布,可借助 Kafka Manager 或 Confluent Control Center 等 Kafka 监控工具。同时,考虑实施自定义分区策略或增加分区数量,以实现更均衡的数据分布。
分区体量过大
当某个分区随时间积累了大量数据,可能导致性能下降,并在数据检索与处理时增加延迟。
关键在于定期监控分区大小,将超大分区拆分为更小的分区,以更均匀地分布数据。此外,调整保留策略以控制分区中的存储数据量也有助益。
分区副本数不足
当遇到 broker 故障或网络问题,且同步副本(ISR)数量低于配置的最小值时,就会出现副本数不足的分区。
为防止此情况,应监控分区的复制状态并排查任何副本不足的分区。确保适当配置复制因子,以维持预期的容错级别。及时处理与网络连接或 broker 故障相关的问题。
分区主节点不均衡
分区主节点在 Kafka 集群中处理读写请求。若主节点在各个 broker 上分布不均,会导致资源利用不均与潜在性能问题。
可通过 Kafka Manager 或 Confluent Control Center 监控主节点分布,并在必要时进行主节点再均衡。同时,考虑调整 broker 配置,使分区主节点在 broker 间更均匀分布。
分区偏斜
当某些分区接收到的流量远高于其他分区时,就会出现分区偏斜,进而导致资源利用不均与性能下降。因此分析流量模式非常重要。
可考虑实施自定义分区策略以均匀分配数据到各分区,并优化消费者组配置,使工作负载在消费者之间更加均衡。
结论
Apache Kafka 是一个健壮的分布式流处理平台,为众多数据密集型应用提供支撑。其核心在于分区这一概念——这是在 Kafka 主题中组织与分发数据的基本单元。分区在 Kafka 生态中举足轻重,支撑了可伸缩性、容错性、并行性与高效数据处理。
通过将数据分布到多个 broker,分区使 Kafka 能在保持高吞吐与高可靠性的同时处理海量数据。此外,分区促进了并行数据处理,确保资源利用最优并降低延迟。
归根结底,理解并有效管理分区,对于最大化 Kafka 集群的性能与可靠性至关重要,它们是构建可扩展、弹性的实时数据管道与应用不可或缺的组成部分。
以下资源可帮助您继续学习:


分区是 Kafka 分布式架构中的关键组件,使 Kafka 能够进行水平扩展,从而高效并行地处理数据。它们是跨 Kafka 集群组织与分发数据的基础单元。
可以将其视为主题中的独立通道,用于存储消息。每个分区可以在不同的 broker 上拥有多个副本,从而保证容错性和数据冗余。
此外,分区提供了有序性保证,确保同一分区内的消息按照生成顺序被处理。这使得 Kafka 分区在维护数据完整性与一致性方面至关重要,对于实时数据处理场景尤为关键。
在本文中,我们将深入探讨以下内容:
您也可以查看我们的Kafka 与 SQS 对比,了解这两款工具的详细差异。
Kafka 架构基础
Kafka 架构概览 - 来源
Apache Kafka 是一个开源的分布式流处理平台,具备高吞吐、容错与可伸缩特性,因而广泛用于构建实时数据管道与应用。
Kafka 的核心由多个组件构成,包括生产者、消费者、broker、主题以及分区,每个组件都在整体系统中扮演关键角色。
Kafka 分区的重要性
分区在提升 Kafka 的效率与健壮性方面发挥关键作用。它们便于将数据分布到各个 broker,从而实现水平扩展。
通过将主题划分为多个分区,Kafka 能够把数据处理负载分散到多台服务器上,高效利用资源,并在不压垮单个 broker 的情况下应对不断增长的数据量。
此外,分区还实现了数据处理的并行化。消费者可以同时从多个分区读取数据,分散计算负载并提升吞吐。这种并行消费确保了消费者资源的高效利用,并降低了数据处理管道中的延迟。
分区之所以重要的另一个原因在于其增强了平台的容错能力。每个分区可以在不同 broker 上拥有多个副本。当某个 broker 故障时,Kafka 仍可从其他 broker 上的副本提供数据,确保数据的可用性与可靠性。
总而言之,分区的重要性体现在多个方面。它们是 Kafka 架构的核心,促成了可伸缩性、容错性、并行性以及数据一致性。
Kafka 如何管理分区
如前文所述,每个分区都是一段分段的、有序的、不可变的记录序列。当生产者向 Kafka 发送数据时,会使用分区逻辑来决定数据应写入主题中的哪个分区。
该逻辑可以基于多种因素,例如与数据关联的键,或生产者实现的自定义分区器。一旦确定分区,Kafka 会将数据追加到该分区的末尾,并依据偏移量保持消息顺序。
在内部,Kafka broker 负责分区数据的存储与复制。每个分区可以在不同的 broker 上拥有多个副本,以确保容错性。
Kafka 采用主从模型:一个 broker 作为主节点负责处理该分区的读写请求,其他 broker 作为从节点从主节点复制数据。即使发生 broker 故障,此架构也能保证数据的持久性与可用性。
设置 Kafka 分区
在设置 Kafka 分区之前,请确保已在本地机器上安装、配置并运行 Apache Kafka 和 Zookeeper。为获得最佳兼容性,建议这样做。同时确认已安装并可用的 Java 8 或更高版本。
注意,Kafka 在 Windows 上安装时可能会遇到各种问题,因为该操作系统缺乏原生兼容性。因此,建议在 Windows 上通过以下方式运行 Apache Kafka:
不建议在 Windows 上直接通过 JVM 运行 Kafka,因为其缺少 Linux 所固有的一些 POSIX 特性。若未使用 WSL2 直接在 Windows 上运行 Kafka,最终可能会遇到诸多问题。
您可以在面向初学者的 Apache Kafka 全面指南中进一步了解 Kafka 的安装与设置。
以下是分区设置的分步指南:
步骤 1:启动 Zookeeper
打开命令提示符并导航到 Kafka 根目录。在该目录下运行以下命令以启动 Zookeeper:
步骤 2:启动 Kafka 服务器
再打开一个命令提示符窗口,并在 Apache Kafka 根目录下运行以下命令以启动 Apache Kafka:
步骤 3:创建一个包含 3 个分区的主题
要创建一个包含三个分区的主题,请在 Kafka 根目录新开一个命令提示符并运行以下命令:
这将创建一个名为“my_topic”的 Kafka 新主题。
注意:为确认是否创建成功,执行该命令后将返回
“Create topic <name of topic>.”您也可以通过运行以下命令验证主题是否已正确创建:
输出应为:
高级分区管理
对现有主题重新分区
在 Kafka 中对现有主题重新分区涉及修改分区数量,这在应对数据量变化、提升并行度或优化资源利用时可能是必要的。
以下是对现有主题重新分区的若干技术与注意事项:
更改分区数量
kafka-topics.sh --alter命令增加现有主题的分区数。这将把数据重新分布到新分区中。数据再分布
对消费者的影响
数据保留与持久性
处理在途数据
测试与验证
分区均衡与优化
优化 Kafka 中的分区使用与性能,对确保高效的数据处理、资源利用与整体系统可伸缩性至关重要。
以下是分区均衡与优化的一些策略:
最优分区数量
消费者组配置
生产者分区策略
监控与调优
横向扩展与硬件升级:
常见分区问题排查
Kafka 已成为众多数据密集型应用的基石,但借用《蜘蛛侠》中本叔叔的话,能力越大,潜在的复杂挑战也就越多。
使用 Kafka 时可能会遇到不少常见的分区问题,原因可能包括配置错误、资源受限、数据分布不均等。
本节将深入这些常见分区问题,并讨论相应的解决方法。
数据分布不均
当数据在分区间分布不均时,部分分区可能成为热点,导致资源利用不均与潜在的性能瓶颈。解决之道是持续监控数据分布,可借助 Kafka Manager 或 Confluent Control Center 等 Kafka 监控工具。同时,考虑实施自定义分区策略或增加分区数量,以实现更均衡的数据分布。
分区体量过大
当某个分区随时间积累了大量数据,可能导致性能下降,并在数据检索与处理时增加延迟。
关键在于定期监控分区大小,将超大分区拆分为更小的分区,以更均匀地分布数据。此外,调整保留策略以控制分区中的存储数据量也有助益。
分区副本数不足
当遇到 broker 故障或网络问题,且同步副本(ISR)数量低于配置的最小值时,就会出现副本数不足的分区。
为防止此情况,应监控分区的复制状态并排查任何副本不足的分区。确保适当配置复制因子,以维持预期的容错级别。及时处理与网络连接或 broker 故障相关的问题。
分区主节点不均衡
分区主节点在 Kafka 集群中处理读写请求。若主节点在各个 broker 上分布不均,会导致资源利用不均与潜在性能问题。
可通过 Kafka Manager 或 Confluent Control Center 监控主节点分布,并在必要时进行主节点再均衡。同时,考虑调整 broker 配置,使分区主节点在 broker 间更均匀分布。
分区偏斜
当某些分区接收到的流量远高于其他分区时,就会出现分区偏斜,进而导致资源利用不均与性能下降。因此分析流量模式非常重要。
可考虑实施自定义分区策略以均匀分配数据到各分区,并优化消费者组配置,使工作负载在消费者之间更加均衡。
结论
Apache Kafka 是一个健壮的分布式流处理平台,为众多数据密集型应用提供支撑。其核心在于分区这一概念——这是在 Kafka 主题中组织与分发数据的基本单元。分区在 Kafka 生态中举足轻重,支撑了可伸缩性、容错性、并行性与高效数据处理。
通过将数据分布到多个 broker,分区使 Kafka 能在保持高吞吐与高可靠性的同时处理海量数据。此外,分区促进了并行数据处理,确保资源利用最优并降低延迟。
归根结底,理解并有效管理分区,对于最大化 Kafka 集群的性能与可靠性至关重要,它们是构建可扩展、弹性的实时数据管道与应用不可或缺的组成部分。
以下资源可帮助您继续学习: