
Last chance! 50% off DataCamp Premium
Sale ends in
Molte aziende scelgono di passare ad AWS MSK per evitare le complessità operative legate alla gestione di cluster Apache Kafka.
In questo tutorial esploreremo le funzionalità, i vantaggi e le best practice di AWS MSK. Vedremo anche i passaggi di base per configurare AWS MSK e come si confronta con altri servizi popolari come Kinesis e Confluent.
Per prima cosa, capiamo Apache Kafka e perché è così utile per lo streaming dei dati.
Apache Kafka è una piattaforma di streaming distribuita open source che gestisce flussi di dati in tempo reale e può supportare app event-driven. È in grado di acquisire e processare dati in streaming mentre vengono generati.
Secondo il sito web di Kafka, oltre l'80% delle aziende Fortune 100 si affida a Kafka e lo utilizza.
Soprattutto, Kafka è scalabile e molto veloce. Significa che può gestire molti più dati di quanti ne potrebbero stare su una singola macchina, con una latenza davvero bassa.
Se vuoi imparare a creare, gestire e risolvere i problemi di Kafka per lo streaming dei dati, valuta il corso Introduction to Kafka.
Quando è meglio usare Apache Kafka?
Gestire istanze Kafka, però, può comportare molti grattacapi. È qui che entra in gioco AWS MSK.
Immagine dell'autore
AWS MSK (Managed Streaming for Kafka) è un servizio completamente gestito che si occupa del provisioning, della configurazione, dello scaling e della manutenzione dei cluster Kafka. Puoi usarlo per costruire app che reagiscono istantaneamente ai flussi di dati.
Kafka è spesso parte di un sistema di elaborazione dati più ampio e AWS MSK rende ancora più semplice creare pipeline di dati in tempo reale che spostano dati tra sistemi diversi.
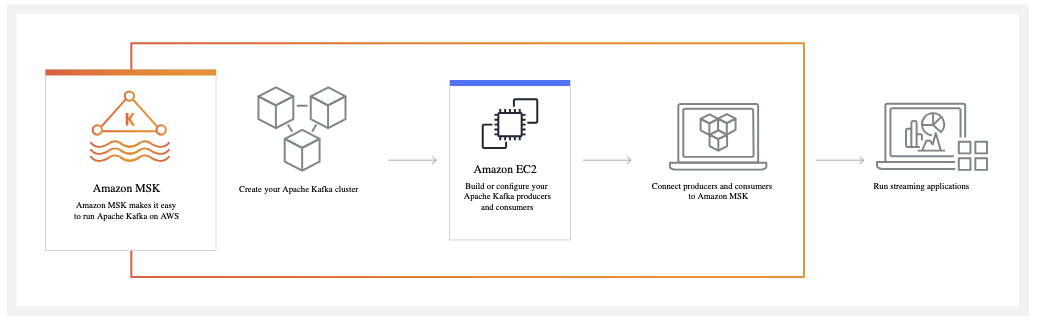
Come funziona Amazon MSK. Fonte immagine: AWS
Se sei alle prime armi con AWS, valuta il nostro corso Introduction to AWS per familiarizzare con le basi. Quando sei pronto, puoi passare al corso AWS Cloud Technology and Services per esplorare la suite completa di servizi su cui fanno affidamento le aziende.
AWS MSK si distingue dalla concorrenza perché è un servizio completamente gestito. Non devi preoccuparti di configurare server o gestire aggiornamenti.
Ma non è tutto qui. Queste cinque caratteristiche chiave rendono AWS MSK un investimento che vale la pena considerare:
Come abbiamo già visto, AWS MSK offre valore immediato grazie a disponibilità, scalabilità, sicurezza e facilità d'integrazione. Questi vantaggi fondamentali lo hanno reso la scelta preferita per le aziende che eseguono carichi Kafka nel cloud.
AWS MSK risolve quattro sfide critiche che ogni progetto di data streaming deve affrontare:
Per iniziare con AWS MSK, crea innanzitutto il tuo account AWS. Se è la tua prima volta con AWS, scopri come configurare il tuo account AWS con il nostro tutorial completo.
Accedi alla AWS Management Console e apri la console MSK. Fai clic su "Create cluster" per avviare il processo di configurazione.
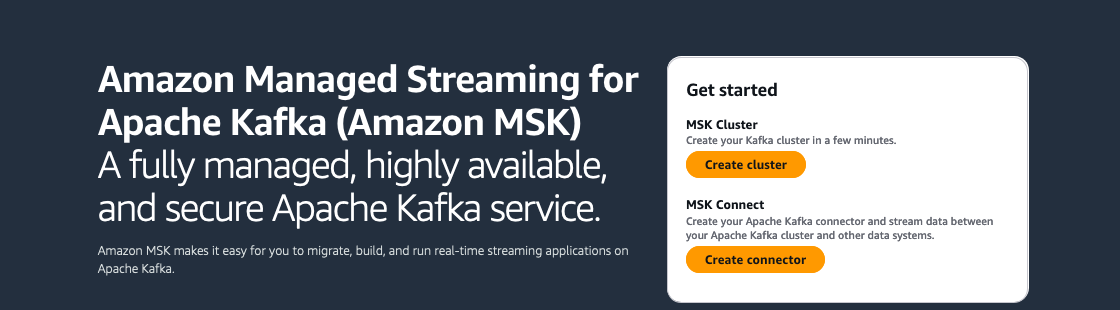
Per iniziare con AWS MSK. Fonte immagine: AWS
Seleziona "Quick create" per le impostazioni predefinite, quindi inserisci un nome descrittivo per il cluster.
Da qui, hai molte opzioni aggiuntive tra cui scegliere, tutte dipendono dai tuoi requisiti per il cluster. Ecco una rapida panoramica delle scelte:
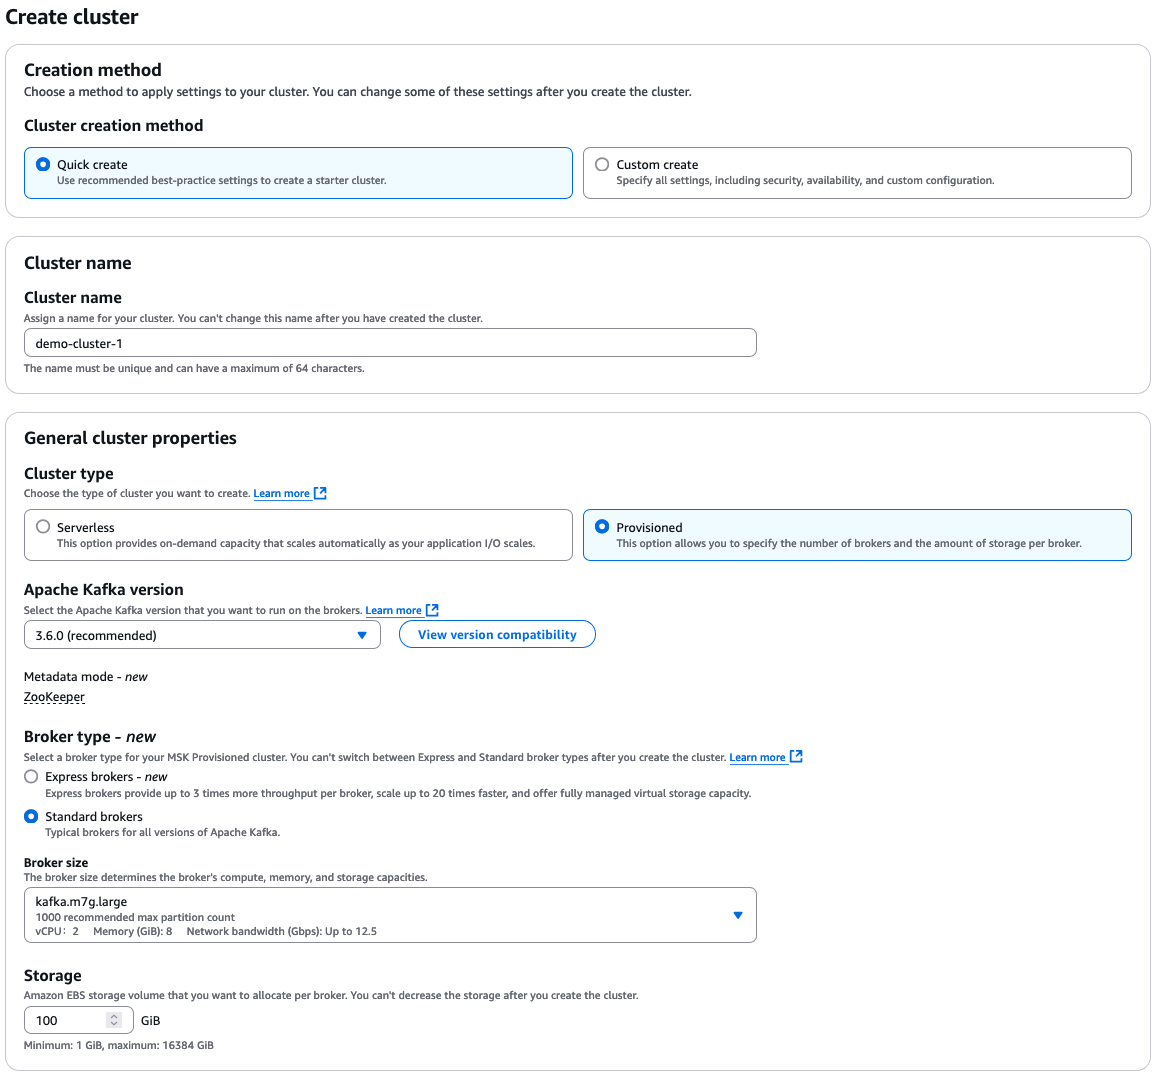
Opzioni di configurazione AWS MSK
Il cluster viene sempre creato all'interno di una Amazon VPC. Puoi scegliere di usare la VPC predefinita oppure configurare e specificare una VPC personalizzata.
Ora devi solo attendere che il tuo cluster venga attivato, cosa che può richiedere dai 15 ai 30 minuti. Puoi monitorare lo stato del cluster dalla pagina di riepilogo, dove vedrai lo stato passare da "Creating" a "Active".
Una volta configurato il cluster MSK, dovrai creare una macchina client per produrre e consumare dati su uno o più topic. Poiché Apache Kafka si integra molto bene con molti produttori di dati (come siti web, dispositivi IoT, istanze Amazon EC2, ecc.), anche MSK beneficia di questa caratteristica.
Apache Kafka organizza i dati in strutture chiamate topic. Ogni topic è composto da una o più partition. Le partition rappresentano il grado di parallelismo in Apache Kafka. I dati vengono distribuiti tra i broker tramite il partizionamento.
Termini chiave da conoscere quando si lavora con cluster Apache Kafka:
Quando costruisci un'architettura event-driven con AWS MSK, devi configurare vari livelli, di cui MSK è il principale componente di ingestione dati. Ecco una panoramica dei livelli che potrebbero servire:
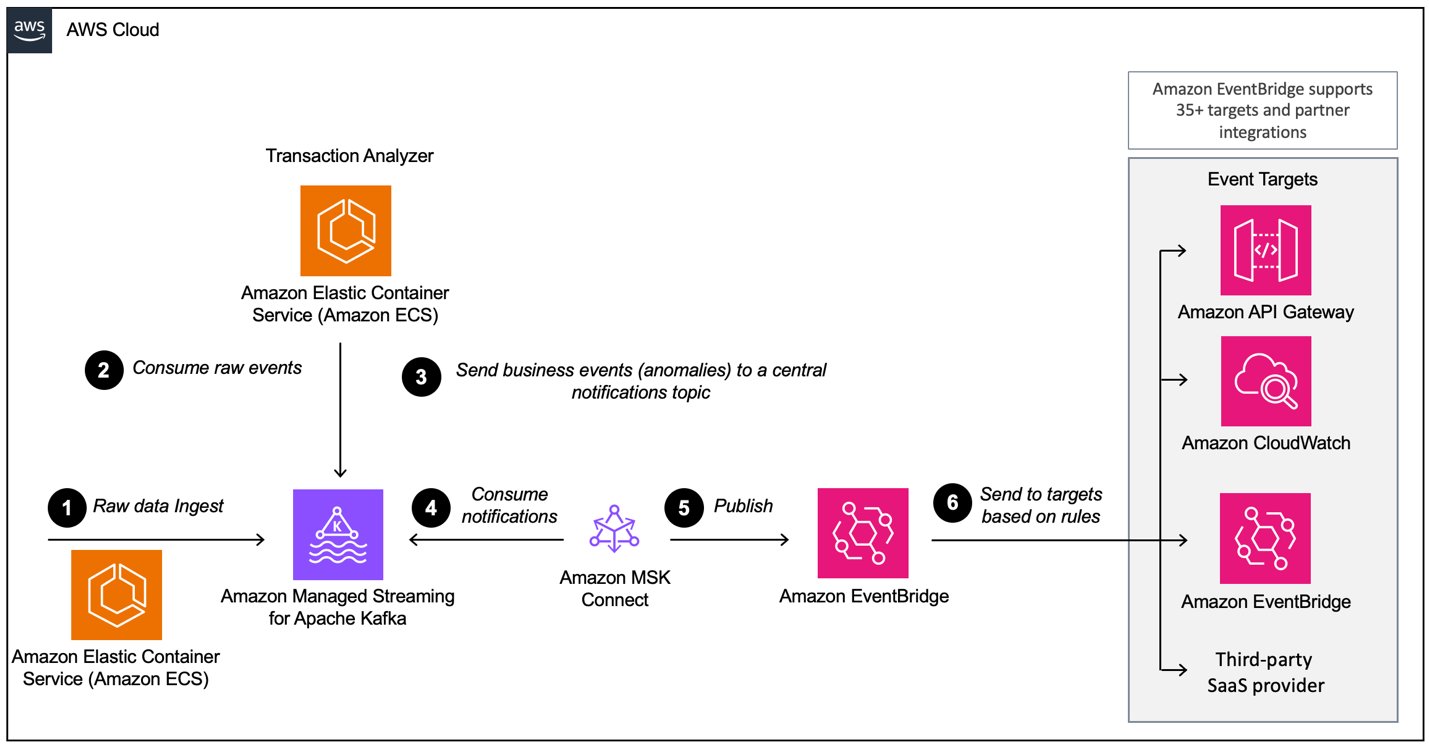
Esempio di architettura event-driven con Amazon MSK e Amazon EventBridge. Fonte immagine: AWS
Se ti interessa usare Python nelle tue pipeline di dati, dai un'occhiata al nostro corso Introduction to AWS Boto in Python.
AWS MSK è relativamente semplice da configurare e da iniziare a usare subito. Tuttavia, alcune best practice essenziali miglioreranno le prestazioni dei tuoi cluster e ti faranno risparmiare tempo in futuro.
Dovrai scegliere il giusto numero di partition per broker e il giusto numero di broker per cluster.
Diversi fattori possono influenzare queste decisioni; tuttavia, AWS ha messo a disposizione alcune utili raccomandazioni e risorse per guidarti nel processo.
Inoltre, AWS fornisce un foglio di calcolo per dimensionamento e costi facile da usare per aiutarti a stimare la dimensione corretta del tuo cluster e i costi associati all'uso di AWS MSK rispetto a un cluster Kafka autogestito su EC2 simile.
AWS raccomanda di configurare i cluster per essere altamente disponibili. Questo è particolarmente importante durante un aggiornamento (ad esempio, l'aggiornamento della versione di Apache Kafka) o quando AWS sostituisce un broker.
Per garantire un'elevata disponibilità dei cluster, ci sono tre cose da fare:
Il bello di AWS è che si impegna a rispettare rigorosi SLA per i deployment multi-AZ; altrimenti, ti restituisce i crediti.
Due metriche chiave da monitorare tramite AWS CloudWatch sono l'uso del disco e della CPU. Farlo non solo garantirà il corretto funzionamento del sistema, ma aiuterà anche a contenere i costi.
Il modo migliore per gestire l'uso del disco e i costi di storage associati è impostare un allarme CloudWatch che ti avvisi quando l'uso del disco supera un certo valore, ad esempio l'85%, e regolare le policy di retention. Impostare un tempo di conservazione per i messaggi nei log può aiutare molto a liberare spazio disco automaticamente.
Inoltre, per mantenere le prestazioni del cluster ed evitare colli di bottiglia, AWS raccomanda di mantenere l'uso totale della CPU dei broker sotto il 60%. Puoi monitorarlo con AWS CloudWatch e poi intervenire ad esempio aggiornando la dimensione dei broker.
Per impostazione predefinita, AWS crittografa i dati in transito tra i broker nel tuo cluster MSK. Puoi disabilitarla se il tuo sistema presenta un alto uso di CPU o latenza. Tuttavia, è fortemente consigliato mantenere sempre abilitata la crittografia in transito e cercare altri modi per migliorare le prestazioni, se questo è il problema.
Dai un'occhiata al nostro corso AWS Security and Cost Management per saperne di più su come mettere in sicurezza e ottimizzare il tuo ambiente cloud AWS e gestire costi e risorse in AWS.
La tariffazione di AWS MSK è pay-as-you-go, il che significa che paghi solo per le risorse che utilizzi. Tuttavia, i prezzi variano in base al tipo di cluster, alla dimensione dell'istanza broker, allo storage e al trasferimento dati. Di seguito analizziamo i principali fattori di costo e come ottimizzare la spesa per MSK.
| Componente di costo | Descrizione | Modalità di addebito |
|---|---|---|
| Ore istanza broker | Il tempo in cui i broker Kafka sono in esecuzione nel cluster | Per ora, in base al tipo di istanza |
| Storage | Storage EBS per i log Kafka | Per GB al mese |
| Trasferimento dati | Dati spostati tra broker e client | Tariffe standard di trasferimento dati AWS |
| Throughput provisionato (opzionale) | Throughput dedicato per letture/scritture | Per MB al secondo |
| Richieste serverless (per cluster serverless) | Richieste di lettura e scrittura | Per GB ingerito e recuperato |
AWS MSK offre due tipi di cluster con diversi modelli di prezzo:
Cluster MSK provisioned (modello standard)
Cluster MSK serverless (modello pay-per-request)
Quale dovresti scegliere?
Prova il Calcolatore dei prezzi AWS per stimare i costi in base al tuo carico di lavoro.
Quando si sceglie lo strumento migliore per un progetto, spesso bisogna valutare diverse opzioni. Ecco le alternative più comuni ad AWS MSK e come si confrontano.
Il principale compromesso tra MSK e un'opzione self-hosted su EC2 è tra comodità e controllo:
La scelta tra AWS MSK e Kinesis dipende dalle priorità:
Se non conosci Kinesis, abbiamo un corso che ti guida a lavorare con i dati in streaming usando AWS Kinesis e Lambda.
La scelta tra AWS MSK e Confluent dipende dalle funzionalità richieste e dalla strategia cloud:
La tabella seguente offre un confronto tra AWS MSK e le sue alternative:
|
Funzionalità |
AWS MSK |
Apache Kafka su EC2 |
Kinesis |
Confluent |
|
Deployment |
Completamente gestito |
Autogestito su EC2 |
Completamente gestito |
Completamente gestito o autogestito |
|
Facilità d'uso |
Facile da configurare e gestire |
Richiede configurazione e scaling manuali |
Configurazione semplice; nativo AWS |
UI intuitiva e strumenti avanzati |
|
Scalabilità |
Auto scaling con regolazioni manuali |
Scaling manuale |
Scaling senza interruzioni |
Auto scaling con flessibilità |
|
Latenza |
Bassa latenza |
Bassa latenza |
Latenza inferiore per payload piccoli |
Paragonabile a MSK |
|
Supporto protocollo |
Compatibile con API Kafka |
Compatibile con API Kafka |
Protocollo Kinesis proprietario |
API Kafka e protocolli aggiuntivi |
|
Retention dei dati |
Configurabile (fino a 7 giorni di default) |
Configurabile |
Configurabile (max 365 giorni) |
Altamente configurabile |
|
Monitoraggio e metriche |
Integrato con CloudWatch |
Richiede setup personalizzato |
Integrato con CloudWatch |
Strumenti di monitoraggio avanzati |
|
Costo |
Pay-as-you-go |
Basato sui prezzi delle istanze EC2 |
Pay-as-you-go |
Basato su abbonamento |
|
Sicurezza |
Funzionalità di sicurezza integrate AWS |
Sicurezza da configurare manualmente |
Integrato con AWS IAM |
Funzionalità di sicurezza complete |
|
Casi d'uso adatti |
Ideale per utenti Kafka nell'ecosistema AWS |
Flessibile, ma con alta manutenzione |
Ideale per app native AWS |
Utenti Kafka avanzati e imprese |
Apache Kafka è la scelta di riferimento quando serve una soluzione affidabile e su larga scala che non può permettersi perdite di dati e richiede di collegare più sorgenti o costruire pipeline complesse. AWS MSK evita molti dei problemi di configurazione e setup dei cluster Kafka, consentendo agli sviluppatori di concentrarsi di più sulla creazione e il miglioramento delle applicazioni invece che sull'infrastruttura.
Ottenere una certificazione AWS è un ottimo modo per iniziare la tua carriera in AWS. Puoi sviluppare le tue competenze AWS consultando il nostro catalogo corsi e facendo esperienza pratica con i progetti!
Approfondisci AWS con questi corsi!
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min




