

AWS MSK instellen
Om te beginnen met AWS MSK maak je eerst je AWS-account aan. Als het je eerste keer is met AWS, leer dan hoe je je AWS-account instelt en configureert met onze uitgebreide tutorial.
Meld je aan bij de AWS Management Console en open de MSK-console. Klik op "Create cluster" om het installatieproces te starten.
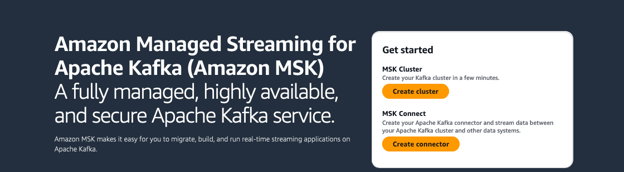
Aan de slag met AWS MSK. Afbeeldingsbron: AWS
Selecteer "Quick create" voor de standaardinstellingen en voer vervolgens een beschrijvende clusternaam in.
Vanaf daar heb je veel extra opties om te kiezen, die allemaal afhangen van jouw eigen vereisten voor je cluster. Hier is een kort overzicht van de keuzes:
- Clustertype: “Provisioned” of “Serverless”
- Apache Kafka-versie
- Brokertype: “Standard” of “Express”
- Brokergrootte
- EBS-opslagvolume
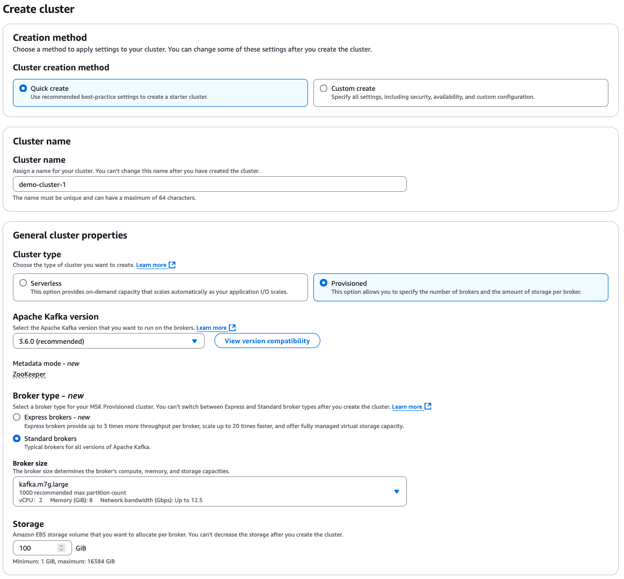
AWS MSK-configuratieopties
De cluster wordt altijd aangemaakt binnen een Amazon VPC. Je kunt ervoor kiezen de standaard-VPC te gebruiken of een aangepaste VPC te configureren en op te geven.
Nu hoef je alleen nog te wachten tot je cluster is geactiveerd, wat 15 tot 30 minuten kan duren. Je kunt de status van je cluster volgen op de cluster-overzichtspagina, waar je de status ziet veranderen van “Creating” naar “Active”.
Data opnemen en verwerken met AWS MSK
Zodra je MSK-cluster is ingesteld, moet je een clientmachine maken om data te produceren en consumeren over een of meer topics. Omdat Apache Kafka zo goed integreert met veel dataproducenten (zoals websites, IoT-apparaten, Amazon EC2-instances, enz.), profiteert MSK ook van dit voordeel.
Apache Kafka organiseert data in structuren die topics worden genoemd. Elk topic bestaat uit één of meerdere partitions. Partitions vormen de mate van parallelisme in Apache Kafka. De data wordt over brokers verdeeld via datapartitionering.
Belangrijke termen om te kennen bij het werken met Apache Kafka-clusters:
- Topics zijn de fundamentele manier om data in Kafka te organiseren.
- Producers zijn applicaties die data naar topics publiceren—ze genereren en schrijven data naar Kafka. Ze schrijven data naar specifieke topics en partitions.
- Consumers zijn applicaties die data uit topics lezen en verwerken. Ze halen data op uit de topics waarop ze zijn geabonneerd.
Bij het bouwen van een event-driven architectuur met AWS MSK moet je meerdere lagen configureren, waarvan MSK de belangrijkste data-ingestielaag is. Hier is een overzicht van de lagen die mogelijk nodig zijn:
- Data-ingestieconfiguratie
- Verwerkingslaag
- Opslaglaag
- Analytilaag
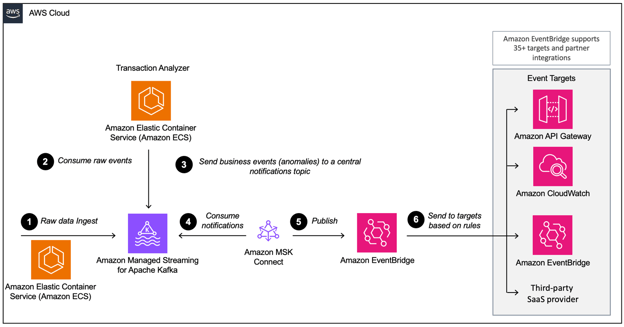
Voorbeeld van een event-driven architectuur met Amazon MSK en Amazon EventBridge. Afbeeldingsbron: AWS
Ben je geïnteresseerd in het inzetten van Python in je datapijplijn-workflows? Bekijk dan onze cursus Introduction to AWS Boto in Python.
Best practices voor het gebruik van AWS MSK
AWS MSK is relatief eenvoudig op te zetten en meteen te gebruiken. Er zijn echter een paar essentiële best practices die de prestaties van je clusters verbeteren en je later tijd besparen.
Kies de juiste grootte voor je cluster
Je moet het juiste aantal partitions per broker en het juiste aantal brokers per cluster kiezen.
Diverse factoren kunnen je keuzes beïnvloeden; AWS heeft echter handige aanbevelingen en resources om je door dit proces te begeleiden.
Daarnaast biedt AWS een gebruiksvriendelijke spreadsheet voor sizing en prijsstelling om je te helpen de juiste grootte van je cluster en de bijbehorende kosten van AWS MSK te schatten, vergeleken met een vergelijkbare zelf-beheerde EC2 Kafka-cluster.
Bouw highly available clusters
AWS raadt aan om je clusters zo in te richten dat ze highly available zijn. Dit is vooral belangrijk tijdens een update (zoals het updaten van de Apache Kafka-versie) of wanneer AWS een broker vervangt.
Om te zorgen dat je clusters highly available zijn, moet je drie dingen doen:
- Richt je clusters in over drie availability zones (ook wel een three-AZ-cluster genoemd).
- Stel de replicatiefactor in op 3 of meer.
- Stel het minimum aantal in-sync replicas in op RF-1.
Het mooie aan AWS is dat ze zich committeren aan strikte SLA's voor multi-AZ-deployments; zo niet, dan krijg je je credits terug.
Monitor schijf- en CPU-gebruik
Twee belangrijke metrics om via AWS CloudWatch te monitoren zijn schijf- en CPU-gebruik. Dit zorgt er niet alleen voor dat je systeem soepel draait, maar helpt ook om de kosten laag te houden.
De beste manier om schijfgebruik en de bijbehorende opslagkosten te beheren, is door een CloudWatch-alarm in te stellen dat je waarschuwt wanneer het schijfgebruik een bepaalde waarde overschrijdt, zoals 85%, en je retentiebeleid aan te passen. Het instellen van een retentietijd voor berichten in je log helpt veel om automatisch schijfruimte vrij te maken.
Daarnaast raadt AWS aan om, om de prestaties van je cluster te behouden en bottlenecks te vermijden, het totale CPU-gebruik voor je brokers onder de 60% te houden. Je kunt dit monitoren met AWS CloudWatch en vervolgens corrigerende maatregelen nemen door bijvoorbeeld je brokergrootte te updaten.
Bescherm je data met encryptie in transit
Standaard versleutelt AWS data in transit tussen brokers in je MSK-cluster. Je kunt dit uitschakelen als je systeem last heeft van hoog CPU-gebruik of latency. Het wordt echter sterk aanbevolen om encryptie in transit altijd ingeschakeld te laten en andere manieren te zoeken om de prestaties te verbeteren als dat een probleem is.
Bekijk onze cursus AWS Security and Cost Management om meer te leren over het beveiligen en optimaliseren van je AWS-cloudomgeving en het beheren van kosten en resources in AWS.
Inzicht in AWS MSK-prijzen
AWS MSK-prijzen zijn pay-as-you-go, wat betekent dat je alleen betaalt voor de resources die je gebruikt. De prijs varieert echter op basis van clustertype, brokerinstantie-grootte, opslag en datatransfer. Hieronder splitsen we de belangrijkste kostenfactoren uit en hoe je je MSK-uitgaven optimaliseert.
Onderdelen van AWS MSK-prijzen
| Kostencomponent | Beschrijving | Hoe wordt gefactureerd |
|---|---|---|
| Broker instance-uren | De tijd dat Kafka-brokers in je cluster draaien | Per uur, gebaseerd op instance-type |
| Opslag | EBS-opslag voor Kafka-logs | Per GB per maand |
| Datatransfer | Data verplaatst tussen brokers en clients | Standaard AWS-datatransfertarieven |
| Geprovisioneerde throughput (optioneel) | Toegewijde throughput voor lezen/schrijven | Per MB per seconde |
| Serverless-requests (voor serverless-clusters) | Lees- en schrijfbewerkingen | Per GB opgenomen en opgehaald |
AWS MSK-prijzen per clustertype
AWS MSK biedt twee clustertypes met verschillende prijsmodellen:
Provisioned MSK-cluster (standaard prijsmodel)
- Je betaalt voor brokerinstanties, opslag en datatransfer.
- Het best voor workloads die fijnafstemming van prestaties vereisen.
Serverless MSK-cluster (pay-per-request-model)
- Prijzen zijn gebaseerd op het datavolume (GB opgenomen/opgehaald).
- Het best voor applicaties met onvoorspelbare verkeerspatronen.
Welke moet je kiezen?
- Gebruik provisioned MSK → Als je voorspelbare workloads hebt en controle nodig hebt over instantiematen.
- Gebruik serverless MSK → Als je workload fluctueert en je het beheren van brokers wilt vermijden.
Probeer de AWS Pricing Calculator om kosten te schatten op basis van je workload.
AWS MSK vergelijken met andere streamingtools
Als we bepalen welke tool het beste is voor een project, moeten we vaak meerdere opties evalueren. Hier zijn de meest gebruikelijke alternatieven voor AWS MSK en hoe ze zich verhouden.
AWS MSK vs Apache Kafka op EC2
De belangrijkste afweging tussen MSK en een zelfgehoste optie met EC2 is gemak versus controle:
- AWS MSK:
- Volledig beheerde service, vermindert operationele complexiteit.
- Automatische provisioning en configuratie—geen initiële infrastructuurkosten.
- Naadloze integratie met AWS-services.
- Robuuste beveiligingsfuncties.
- Minder flexibiliteit dan zelf hosten.
- Kafka op EC2:
- Vereist handmatige installatie, configuratie en onderhoud.
- Biedt volledige controle over infrastructuur en maatwerk.
- Mogelijk hogere operationele kosten.
- Vereist meer expertise en doorlopend beheer.
AWS MSK vs. Kinesis
De keuze tussen AWS MSK en Kinesis hangt af van je prioriteiten:
- Gebruik Kinesis als:
- Je een volledig serverless architectuur nodig hebt.
- AWS-beheerde service met minimale operationele overhead.
- Gebruikt shards voor datastreaming maar heeft beperkingen op dataretentie.
- Het meest geschikt voor eenvoudige datastreamingvereisten.
- Gebruik AWS MSK als:
- Je Kafka's topic- en partitionmodel nodig hebt.
- Vrijwel onbeperkte dataretentie (afhankelijk van opslag).
- Meer flexibel en aanpasbaar.
- Maakt migratie weg van AWS mogelijk indien nodig.
Als je niet bekend bent met Kinesis, hebben we een cursus die je begeleidt bij het werken met streamingdata met AWS Kinesis en Lambda.
AWS MSK vs. Confluent
De keuze tussen AWS MSK en Confluent hangt af van functiewensen en cloudstrategie:
- Gebruik Confluent als:
- Je een uitgebreide set functies met ingebouwde connectors nodig hebt.
- Je de voorkeur geeft aan een eenvoudiger deploymentproces.
- Je te maken hebt met piekbelastingen die dynamische scaling vereisen.
- Hogere kosten maar biedt een gratis laag met beperkte functies.
- Gebruik AWS MSK als:
- Je een kostenefficiënte optie wilt voor consistente workloads.
- Je diep geïntegreerd bent in het AWS-ecosysteem.
- Je interne Kafka-expertise hebt.
- Het prima vindt om extra AWS-services te integreren voor extra functionaliteit.
De volgende tabel biedt een vergelijking van AWS MSK en de alternatieven:
|
Functie |
AWS MSK |
Apache Kafka op EC2 |
Kinesis |
Confluent |
|
Deployment |
Volledig beheerd |
Zelf-beheerd op EC2 |
Volledig beheerd |
Volledig beheerd of zelf-beheerd |
|
Gebruiksgemak |
Makkelijk op te zetten en te beheren |
Vereist handmatige setup en scaling |
Eenvoudige setup; AWS-native |
Gebruiksvriendelijke UI en geavanceerde tools |
|
Schaalbaarheid |
Auto-scaling met handmatige aanpassingen |
Handmatige scaling |
Naadloze scaling |
Auto-scaling met flexibiliteit |
|
Latency |
Lage latency |
Lage latency |
Lagere latency voor kleine payloads |
Vergelijkbaar met MSK |
|
Protocolondersteuning |
Kafka API-compatibel |
Kafka API-compatibel |
Proprietair Kinesis-protocol |
Kafka API en extra protocollen |
|
Dataretentie |
Configureerbaar (standaard tot 7 dagen) |
Configureerbaar |
Configureerbaar (max. 365 dagen) |
Zeer configureerbaar |
|
Monitoring en metrics |
Geïntegreerd met CloudWatch |
Vereist aangepaste setup |
Geïntegreerd met CloudWatch |
Geavanceerde monitoringtools |
|
Kosten |
Pay-as-you-go |
Gebaseerd op EC2-instanceprijzen |
Pay-as-you-go |
Abonnementsgebaseerd |
|
Beveiliging |
Ingebouwde AWS-beveiligingsfuncties |
Moet beveiliging handmatig configureren |
Geïntegreerd met AWS IAM |
Uitgebreide beveiligingsfuncties |
|
Geschiktheid use case |
Beste voor Kafka-gebruikers in het AWS-ecosysteem |
Flexibel, maar veel onderhoud |
Beste voor AWS-native apps |
Geavanceerde Kafka-gebruikers en enterprises |
Tot slot
Apache Kafka is de voorkeursoplossing voor situaties waarin je een grootschalige, betrouwbare oplossing nodig hebt die geen dataverlies kan veroorloven en waarbij meerdere databronnen moeten worden gekoppeld of complexe datapijplijnen moeten worden gebouwd. AWS MSK voorkomt veel van de hoofdpijn bij het opzetten en configureren van Kafka-clusters, zodat ontwikkelaars zich meer kunnen richten op het bouwen en verbeteren van applicaties in plaats van infrastructuur.
Een AWS-certificering is een uitstekende manier om je AWS-carrière te starten. Je kunt je AWS-vaardigheden opbouwen door onze cursuscatalogus te bekijken en hands-on ervaring op te doen via projecten!
FAQs
Kan AWS MSK integreren met andere AWS-services zoals Lambda en S3?
Ja, AWS MSK integreert met veel AWS-services. Je kunt MSK Connect gebruiken om volledig beheerde Kafka Connect-connectors uit te voeren. Je kunt vooraf gebouwde connectors gebruiken of aangepaste connectors maken om data te verplaatsen tussen MSK en services zoals S3, OpenSearch en RDS. AWS MSK kan ook dienen als event source voor Lambda-functies. Je kunt Lambda configureren om je MSK-topics te poll-en en automatisch functies aan te roepen op basis van nieuwe berichten, met ondersteuning voor batchverwerking en foutafhandeling.
Kan ik mijn bestaande Kafka-cluster migreren naar AWS MSK?
Ja, migreren naar MSK is op een paar verschillende manieren mogelijk. Je kunt MirrorMaker 2.0 gebruiken voor clusterreplicatie, een directe topicmigratie uitvoeren of tools van derden gebruiken. AWS biedt gedetailleerde migratiedocumentatie en best practices voor minimale downtime.
Welke monitoring en metrics zijn beschikbaar voor AWS MSK-clusters?
MSK integreert met CloudWatch voor monitoring en biedt metrics voor brokergezondheid, clusterprestaties en consumer lag. Belangrijke metrics zijn CPU-gebruik, schijfruimte, netwerkdoorvoer en het aantal partitions.



Veel bedrijven stappen over op AWS MSK om de operationele hoofdpijn van het beheren van Apache Kafka-clusters te vermijden.
In deze tutorial bespreken we de functies, voordelen en best practices van AWS MSK. We lopen ook de basisstappen door voor het opzetten van AWS MSK en vergelijken het met andere populaire services zoals Kinesis en Confluent.
Wat is AWS MSK?
Laten we eerst Apache Kafka begrijpen en waarom het zo nuttig is voor datastreaming.
Apache Kafka is een open-source, gedistribueerd streamingplatform dat realtime datastromen verwerkt en event-driven apps kan bouwen. Het kan streamingdata opnemen en verwerken terwijl het binnenkomt.
Volgens de website van Kafka vertrouwen meer dan 80% van de Fortune 100-bedrijven op Kafka en gebruiken ze het.
Het belangrijkste is dat Kafka schaalbaar en erg snel is. Dat betekent dat het veel meer data aankan dan op één machine past, en met zeer lage latency.
Wil je leren hoe je Kafka maakt, beheert en problemen oplost voor datastreaming? Volg dan de cursus Introduction to Kafka.
Wanneer gebruik je Apache Kafka het best?
Het beheren van Kafka-instanties kan echter veel hoofdpijn veroorzaken. Daar komt AWS MSK om de hoek kijken.
Afbeelding door auteur
AWS MSK (Managed Streaming for Kafka) is een volledig beheerde service die de provisioning, configuratie, schaalbaarheid en het onderhoud van Kafka-clusters regelt. Je kunt het gebruiken om apps te bouwen die direct reageren op datastromen.
Kafka wordt vaak gebruikt als onderdeel van een grotere gegevensverwerkingsopzet, en AWS MSK maakt het nog eenvoudiger om realtime datapijplijnen te creëren die data tussen verschillende systemen verplaatsen.
Hoe Amazon MSK werkt. Afbeeldingsbron: AWS
Als je nieuw bent bij AWS, overweeg dan onze cursus Introduction to AWS om de basis te leren kennen. Ben je er klaar voor, ga dan verder met onze cursus AWS Cloud Technology and Services om de volledige reeks diensten te verkennen waar bedrijven op vertrouwen.
Functies van AWS MSK
AWS MSK onderscheidt zich van de concurrentie omdat het een volledig beheerde service is. Je hoeft je geen zorgen te maken over het opzetten van servers of het afhandelen van updates.
Maar er is meer dan dat. Deze vijf kernfuncties van AWS MSK maken het een waardevolle investering:
Voordelen van het gebruik van AWS MSK
Zoals we al zagen, levert AWS MSK directe waarde dankzij de beschikbaarheid, schaalbaarheid, beveiliging en eenvoudige integratie. Deze kernvoordelen hebben het de favoriete keuze gemaakt voor bedrijven die Kafka-workloads in de cloud draaien.
AWS MSK lost vier kritieke uitdagingen op waar elk datastreamingproject mee te maken krijgt: