

Thiết lập AWS MSK
Để bắt đầu với AWS MSK, đầu tiên hãy tạo tài khoản AWS. Nếu đây là lần đầu bạn dùng AWS, hãy học cách thiết lập và cấu hình tài khoản AWS qua hướng dẫn toàn diện của chúng tôi.
Đăng nhập vào AWS Management Console và mở bảng điều khiển MSK. Nhấn "Create cluster" để bắt đầu quá trình thiết lập.
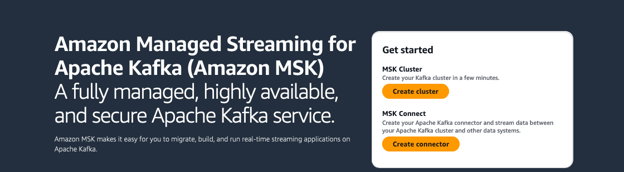
Bắt đầu với AWS MSK. Nguồn hình ảnh: AWS
Chọn "Quick create" để dùng thiết lập mặc định, sau đó nhập tên cụm dễ nhận biết.
Từ đây, bạn có nhiều tùy chọn bổ sung để chọn, tất cả phụ thuộc vào yêu cầu riêng cho cụm của bạn. Sau đây là tóm tắt nhanh các lựa chọn:
- Loại cụm: “Provisioned” hoặc “Serverless”
- Phiên bản Apache Kafka
- Loại broker: “Standard” hoặc “Express”
- Kích thước broker
- Dung lượng lưu trữ EBS
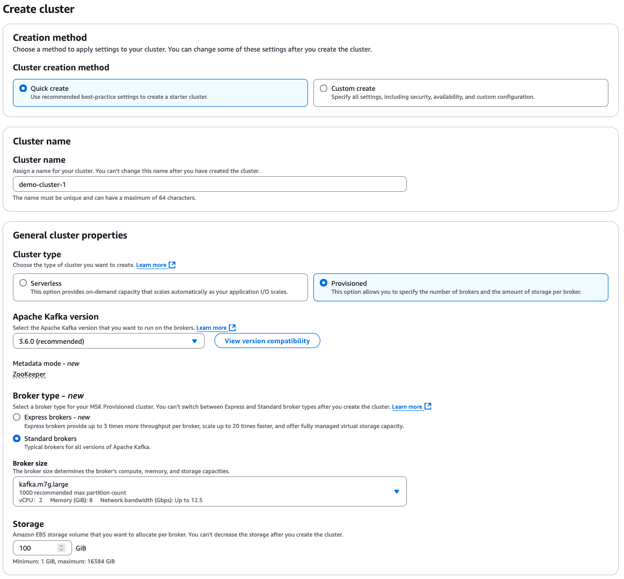
Tùy chọn cấu hình AWS MSK
Cụm luôn được tạo trong Amazon VPC. Bạn có thể chọn dùng VPC mặc định hoặc cấu hình và chỉ định VPC tùy chỉnh.
Giờ đây, bạn chỉ cần chờ cụm được kích hoạt, có thể mất 15 đến 30 phút. Bạn có thể theo dõi trạng thái cụm từ trang tóm tắt cụm, nơi trạng thái sẽ chuyển từ “Creating” sang “Active”.
Thu nhận và xử lý dữ liệu với AWS MSK
Sau khi thiết lập cụm MSK, bạn sẽ cần tạo máy khách để tạo ra và tiêu thụ dữ liệu qua một hoặc nhiều topic. Vì Apache Kafka tích hợp rất tốt với nhiều nguồn phát dữ liệu (như trang web, thiết bị IoT, phiên bản Amazon EC2, v.v.), MSK cũng thừa hưởng lợi thế này.
Apache Kafka tổ chức dữ liệu trong cấu trúc gọi là topic. Mỗi topic gồm một hoặc nhiều partition. Partition là mức độ song song trong Apache Kafka. Dữ liệu được phân phối qua các broker nhờ phân vùng dữ liệu.
Các thuật ngữ chính cần biết khi làm việc với cụm Apache Kafka:
- Topic là cách tổ chức dữ liệu cơ bản trong Kafka.
- Producer là các ứng dụng xuất bản dữ liệu lên topic — chúng tạo và ghi dữ liệu vào Kafka. Chúng ghi dữ liệu lên các topic và partition cụ thể.
- Consumer là các ứng dụng đọc và xử lý dữ liệu từ topic. Chúng kéo dữ liệu từ các topic mà chúng đăng ký.
Khi xây dựng kiến trúc hướng sự kiện với AWS MSK, bạn cần cấu hình một số lớp, trong đó MSK là thành phần thu nhận dữ liệu chính. Dưới đây là tổng quan các lớp có thể cần:
- Thiết lập thu nhận dữ liệu
- Lớp xử lý
- Lớp lưu trữ
- Lớp phân tích
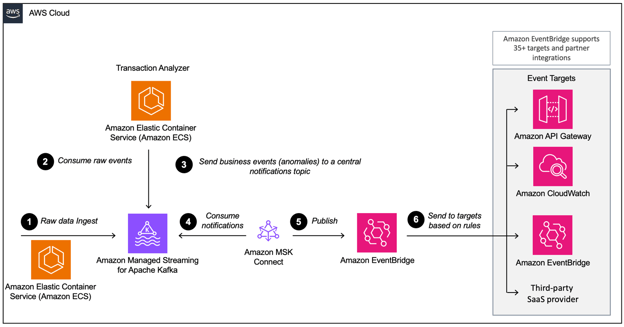
Ví dụ kiến trúc hướng sự kiện với Amazon MSK và Amazon EventBridge. Nguồn hình ảnh: AWS
Nếu bạn quan tâm tận dụng Python trong quy trình pipeline dữ liệu của mình, hãy xem khóa học Introduction to AWS Boto in Python.
Thực tiễn tốt nhất khi dùng AWS MSK
AWS MSK tương đối dễ thiết lập và bắt đầu sử dụng ngay. Tuy nhiên, một số thực tiễn thiết yếu sẽ cải thiện hiệu năng cụm của bạn và tiết kiệm thời gian về sau.
Chọn kích thước cụm phù hợp
Bạn sẽ cần chọn số partition phù hợp trên mỗi broker và số broker phù hợp cho mỗi cụm.
Có nhiều yếu tố có thể ảnh hưởng quyết định của bạn; tuy vậy, AWS đã cung cấp một số khuyến nghị và tài nguyên hữu ích để hướng dẫn bạn qua quá trình này.
Ngoài ra, AWS cung cấp một bảng tính kích cỡ và chi phí dễ sử dụng để giúp bạn ước tính kích thước cụm phù hợp và chi phí liên quan khi dùng AWS MSK so với cụm Kafka tự quản trên EC2 tương tự.
Xây dựng cụm có tính sẵn sàng cao
AWS khuyến nghị bạn thiết lập cụm có tính sẵn sàng cao. Điều này đặc biệt quan trọng khi thực hiện cập nhật (như cập nhật phiên bản Apache Kafka) hoặc khi AWS thay thế một broker.
Để đảm bảo cụm có tính sẵn sàng cao, có ba việc bạn phải làm:
- Thiết lập cụm trên ba vùng sẵn sàng (gọi là cụm ba AZ).
- Đặt hệ số sao chép (replication factor) là 3 hoặc hơn.
- Đặt số bản sao đồng bộ tối thiểu (in-sync replicas) là RF-1.
Điều tuyệt vời ở AWS là họ cam kết các SLA nghiêm ngặt cho triển khai đa AZ; nếu không, bạn sẽ được hoàn tín dụng.
Giám sát sử dụng đĩa và CPU
Hai chỉ số quan trọng cần giám sát qua AWS CloudWatch là mức sử dụng đĩa và CPU. Làm vậy không chỉ giúp hệ thống vận hành trơn tru mà còn hỗ trợ giảm chi phí.
Cách tốt nhất để quản lý sử dụng đĩa và chi phí lưu trữ liên quan là thiết lập cảnh báo CloudWatch để cảnh báo bạn khi mức sử dụng đĩa vượt một ngưỡng nhất định, như 85%, và điều chỉnh chính sách lưu giữ. Thiết lập thời gian lưu giữ cho thông điệp trong log có thể giúp giải phóng dung lượng đĩa tự động.
Ngoài ra, để duy trì hiệu năng của cụm và tránh nút thắt cổ chai, AWS khuyến nghị bạn giữ tổng mức sử dụng CPU cho các broker dưới 60%. Bạn có thể theo dõi bằng AWS CloudWatch và thực hiện biện pháp khắc phục như nâng cấp kích thước broker, chẳng hạn.
Bảo vệ dữ liệu bằng mã hóa khi truyền
Theo mặc định, AWS mã hóa dữ liệu khi truyền giữa các broker trong cụm MSK của bạn. Bạn có thể tắt tính năng này nếu hệ thống gặp mức sử dụng CPU hoặc độ trễ cao. Tuy nhiên, rất khuyến nghị bạn luôn bật mã hóa khi truyền và tìm cách khác để cải thiện hiệu năng nếu đó là vấn đề với bạn.
Xem khóa học AWS Security and Cost Management để tìm hiểu thêm cách bảo mật và tối ưu môi trường đám mây AWS cũng như quản lý chi phí và tài nguyên trong AWS.
Hiểu về giá AWS MSK
Giá AWS MSK theo mô hình trả theo mức sử dụng, nghĩa là bạn chỉ trả cho tài nguyên bạn dùng. Tuy nhiên, giá thay đổi dựa trên loại cụm, kích cỡ phiên bản broker, lưu trữ và truyền dữ liệu. Dưới đây, chúng tôi phân tích các yếu tố chi phí chính và cách tối ưu hóa chi tiêu MSK của bạn.
Thành phần giá của AWS MSK
| Thành phần chi phí | Mô tả | Cách tính phí |
|---|---|---|
| Giờ chạy Broker Instance | Thời gian các broker Kafka chạy trong cụm của bạn | Tính theo giờ, dựa trên loại phiên bản |
| Lưu trữ | Lưu trữ EBS cho log Kafka | Tính theo GB mỗi tháng |
| Truyền dữ liệu | Dữ liệu di chuyển giữa broker và client | Mức phí truyền dữ liệu chuẩn của AWS |
| Thông lượng cung cấp trước (Tùy chọn) | Thông lượng dành riêng cho đọc/ghi | Theo MB mỗi giây |
| Yêu cầu Serverless (cho cụm Serverless) | Yêu cầu đọc và ghi | Tính theo GB nạp vào và truy xuất |
Giá AWS MSK theo loại cụm
AWS MSK cung cấp hai loại cụm với mô hình giá khác nhau:
Cụm MSK provisioned (mô hình giá tiêu chuẩn)
- Bạn trả phí cho phiên bản broker, lưu trữ và truyền dữ liệu.
- Phù hợp nhất cho khối lượng công việc cần kiểm soát hiệu năng chi tiết.
Cụm MSK serverless (mô hình trả theo yêu cầu)
- Giá dựa trên khối lượng dữ liệu được xử lý (GB nạp/truy xuất).
- Phù hợp nhất cho ứng dụng có lưu lượng khó dự đoán.
Nên chọn loại nào?
- Dùng MSK provisioned → Nếu bạn có khối lượng công việc dự đoán được và cần kiểm soát kích cỡ phiên bản.
- Dùng MSK serverless → Nếu khối lượng công việc dao động và bạn muốn tránh quản lý broker.
Hãy thử AWS Pricing Calculator để ước tính chi phí dựa trên khối lượng công việc của bạn.
So sánh AWS MSK với các công cụ streaming khác
Khi quyết định công cụ nào phù hợp nhất cho một dự án, chúng ta thường cần đánh giá vài lựa chọn. Dưới đây là các phương án thay thế phổ biến nhất cho AWS MSK và cách chúng so sánh.
AWS MSK so với Apache Kafka trên EC2
Sự đánh đổi chính giữa MSK và phương án tự lưu trữ dùng EC2 nằm ở sự tiện lợi và mức độ kiểm soát:
- AWS MSK:
- Dịch vụ được quản lý toàn phần, giảm độ phức tạp vận hành.
- Cung ứng và cấu hình tự động — không có chi phí hạ tầng ban đầu.
- Tích hợp mượt mà với các dịch vụ AWS.
- Tính năng bảo mật mạnh mẽ.
- Ít linh hoạt hơn so với tự quản.
- Kafka trên EC2:
- Cần thiết lập, cấu hình và bảo trì thủ công.
- Cung cấp toàn quyền kiểm soát hạ tầng và tùy biến.
- Có thể phát sinh chi phí vận hành cao hơn.
- Yêu cầu nhiều chuyên môn và quản trị liên tục.
AWS MSK so với Kinesis
Việc chọn giữa AWS MSK và Kinesis phụ thuộc vào ưu tiên của bạn:
- Dùng Kinesis nếu:
- Bạn cần kiến trúc hoàn toàn serverless.
- Dịch vụ do AWS quản lý với chi phí vận hành tối thiểu.
- Dùng shard cho streaming dữ liệu nhưng có giới hạn lưu giữ dữ liệu.
- Phù hợp nhất cho yêu cầu streaming dữ liệu đơn giản.
- Dùng AWS MSK nếu:
- Bạn cần mô hình topic và partition của Kafka.
- Lưu giữ dữ liệu gần như không giới hạn (phụ thuộc lưu trữ).
- Linh hoạt và tùy biến hơn.
- Cho phép chuyển khỏi AWS nếu cần.
Nếu bạn chưa quen với Kinesis, chúng tôi có khóa học hướng dẫn bạn làm việc với dữ liệu streaming dùng AWS Kinesis và Lambda.
AWS MSK so với Confluent
Việc chọn giữa AWS MSK và Confluent phụ thuộc vào yêu cầu tính năng và chiến lược đám mây:
- Dùng Confluent nếu:
- Bạn cần bộ tính năng phong phú với các connector tích hợp sẵn.
- Bạn muốn quy trình triển khai đơn giản hơn.
- Bạn xử lý khối lượng công việc tăng đột biến cần mở rộng linh hoạt.
- Chi phí cao hơn nhưng có gói miễn phí với tính năng giới hạn.
- Dùng AWS MSK nếu:
- Bạn muốn lựa chọn tiết kiệm chi phí cho khối lượng công việc ổn định.
- Bạn tích hợp sâu vào hệ sinh thái AWS.
- Bạn có chuyên môn Kafka nội bộ.
- Bạn chấp nhận tích hợp thêm các dịch vụ AWS để mở rộng chức năng.
Bảng sau cung cấp so sánh giữa AWS MSK và các lựa chọn thay thế:
|
Tính năng |
AWS MSK |
Apache Kafka trên EC2 |
Kinesis |
Confluent |
|
Triển khai |
Quản lý toàn phần |
Tự quản trên EC2 |
Quản lý toàn phần |
Quản lý toàn phần hoặc tự quản |
|
Dễ sử dụng |
Dễ thiết lập và quản lý |
Cần thiết lập và mở rộng thủ công |
Thiết lập đơn giản; thuần AWS |
Giao diện thân thiện và công cụ nâng cao |
|
Khả năng mở rộng |
Tự động mở rộng kèm điều chỉnh thủ công |
Mở rộng thủ công |
Mở rộng liền mạch |
Tự động mở rộng linh hoạt |
|
Độ trễ |
Độ trễ thấp |
Độ trễ thấp |
Độ trễ thấp hơn cho payload nhỏ |
Tương đương MSK |
|
Hỗ trợ giao thức |
Tương thích API Kafka |
Tương thích API Kafka |
Giao thức Kinesis độc quyền |
API Kafka và các giao thức bổ sung |
|
Lưu giữ dữ liệu |
Cấu hình được (mặc định tới 7 ngày) |
Cấu hình được |
Cấu hình được (tối đa 365 ngày) |
Rất linh hoạt trong cấu hình |
|
Giám sát và chỉ số |
Tích hợp với CloudWatch |
Cần thiết lập tùy chỉnh |
Tích hợp với CloudWatch |
Công cụ giám sát nâng cao |
|
Chi phí |
Trả theo mức sử dụng |
Dựa trên giá phiên bản EC2 |
Trả theo mức sử dụng |
Theo gói thuê bao |
|
Bảo mật |
Tính năng bảo mật tích hợp của AWS |
Phải cấu hình bảo mật thủ công |
Tích hợp với AWS IAM |
Tính năng bảo mật toàn diện |
|
Mức độ phù hợp trường hợp sử dụng |
Tốt nhất cho người dùng Kafka trong hệ sinh thái AWS |
Linh hoạt nhưng cần bảo trì cao |
Tốt nhất cho ứng dụng thuần AWS |
Người dùng Kafka nâng cao và doanh nghiệp |
Tổng kết
Apache Kafka là lựa chọn hàng đầu cho những tình huống cần giải pháp quy mô lớn, đáng tin cậy, không chấp nhận mất dữ liệu và đòi hỏi kết nối nhiều nguồn dữ liệu hoặc xây dựng pipeline dữ liệu phức tạp. AWS MSK loại bỏ nhiều rắc rối khi thiết lập và cấu hình cụm Kafka, cho phép nhà phát triển tập trung hơn vào xây dựng và cải thiện ứng dụng thay vì hạ tầng.
Nhận một chứng chỉ AWS là cách tuyệt vời để bắt đầu sự nghiệp AWS của bạn. Bạn có thể phát triển kỹ năng AWS bằng cách xem danh mục khóa học của chúng tôi và tích lũy kinh nghiệm thực tế qua các dự án!
Câu hỏi thường gặp
AWS MSK có thể tích hợp với các dịch vụ AWS khác như Lambda và S3 không?
Có, AWS MSK tích hợp với nhiều dịch vụ AWS. Bạn có thể dùng MSK Connect để chạy các connector Kafka Connect được quản lý toàn phần. Bạn có thể dùng connector dựng sẵn hoặc tạo connector tùy chỉnh để di chuyển dữ liệu giữa MSK và các dịch vụ như S3, OpenSearch và RDS. AWS MSK cũng có thể đóng vai trò nguồn sự kiện cho Lambda. Bạn có thể cấu hình Lambda để thăm dò các topic MSK của mình và tự động gọi hàm dựa trên thông điệp mới, với hỗ trợ xử lý theo lô và xử lý lỗi.
Tôi có thể di chuyển cụm Kafka hiện có sang AWS MSK không?
Có, có thể di chuyển sang MSK theo vài cách khác nhau. Bạn có thể dùng MirrorMaker 2.0 để sao chép cụm, thực hiện di chuyển topic trực tiếp hoặc dùng công cụ bên thứ ba. AWS cung cấp tài liệu di chuyển chi tiết và thực tiễn tốt nhất để giảm thiểu thời gian ngừng hoạt động.
Những tính năng giám sát và chỉ số nào có sẵn cho cụm AWS MSK?
MSK tích hợp với CloudWatch để giám sát, cung cấp chỉ số về tình trạng broker, hiệu năng cụm và độ trễ consumer. Các chỉ số chính bao gồm mức sử dụng CPU, dung lượng đĩa, thông lượng mạng và số lượng partition.


Nhiều công ty đang chọn chuyển sang AWS MSK để tránh những rắc rối vận hành khi phải quản lý các cụm Apache Kafka.
Trong bài hướng dẫn này, chúng ta sẽ khám phá các tính năng, lợi ích và thực tiễn tốt nhất của AWS MSK. Chúng ta cũng sẽ điểm qua các bước cơ bản để thiết lập AWS MSK và xem nó so sánh thế nào với những dịch vụ phổ biến khác như Kinesis và Confluent.
AWS MSK là gì?
Trước hết, hãy hiểu Apache Kafka và vì sao nó hữu ích cho việc truyền dữ liệu theo dòng.
Apache Kafka là một nền tảng streaming phân tán mã nguồn mở xử lý các luồng dữ liệu thời gian thực và có thể xây dựng ứng dụng hướng sự kiện. Nó có thể thu nhận và xử lý dữ liệu streaming khi dữ liệu phát sinh.
Theo trang web của Kafka, hơn 80% công ty trong Fortune 100 tin dùng và sử dụng Kafka.
Quan trọng nhất, Kafka có khả năng mở rộng và rất nhanh. Điều này có nghĩa là nó có thể xử lý lượng dữ liệu lớn hơn nhiều so với những gì vừa với một máy đơn lẻ, và với độ trễ cực thấp.
Nếu bạn muốn học cách tạo, quản lý và khắc phục sự cố Kafka cho truyền dữ liệu, hãy cân nhắc khóa học Introduction to Kafka.
Khi nào là lúc thích hợp để dùng Apache Kafka?
Tuy nhiên, việc quản lý các phiên bản Kafka có thể mang lại nhiều rắc rối. Đây là lúc AWS MSK phát huy tác dụng.
Hình ảnh của Tác giả
AWS MSK (Managed Streaming for Kafka) là dịch vụ được quản lý toàn phần, đảm nhiệm việc cung ứng, cấu hình, mở rộng và bảo trì các cụm Kafka. Bạn có thể dùng nó để xây dựng ứng dụng phản hồi tức thì với các luồng dữ liệu.
Kafka thường được dùng như một phần trong hệ thống xử lý dữ liệu lớn hơn, và AWS MSK còn giúp việc tạo pipeline dữ liệu thời gian thực để di chuyển dữ liệu giữa các hệ thống khác nhau trở nên dễ dàng hơn.
Cách Amazon MSK hoạt động. Nguồn hình ảnh: AWS
Nếu bạn mới bắt đầu với AWS, hãy cân nhắc khóa học Introduction to AWS để làm quen với những điều cơ bản. Khi sẵn sàng, bạn có thể học tiếp AWS Cloud Technology and Services để khám phá trọn bộ dịch vụ mà doanh nghiệp đang dựa vào.
Các tính năng của AWS MSK
AWS MSK nổi bật so với đối thủ vì là dịch vụ được quản lý toàn phần. Bạn không cần lo lắng về việc thiết lập máy chủ hay xử lý cập nhật.
Tuy nhiên, còn nhiều điểm đáng giá hơn thế. Năm tính năng chủ chốt sau giúp AWS MSK trở thành khoản đầu tư xứng đáng:
Lợi ích khi sử dụng AWS MSK
Như chúng ta đã thấy, AWS MSK mang lại giá trị tức thì nhờ tính sẵn sàng, khả năng mở rộng, bảo mật và dễ tích hợp. Những lợi thế cốt lõi này đã khiến nó trở thành lựa chọn hàng đầu cho các công ty chạy khối lượng công việc Kafka trên đám mây.
AWS MSK giải quyết bốn thách thức trọng yếu mà mọi dự án streaming dữ liệu đều gặp phải: