数据可能复杂、繁琐,有时要发现其中的模式并不容易。设想您手头有一份公司销售数据,希望按消费者的消费能力挖掘出某种模式。如果能在数据中找出不同的群体或关联,您就可以有针对性地触达不同的群体,从而最大化销售额。这个直觉背后的基本思想叫作聚类,而 Tableau 具备一项内置功能,可以基于特定属性自动将相似的数据点聚为一类。让我们来探索 Tableau 的这一功能,并看看如何将聚类应用到真实世界的数据集。
K 均值聚类
聚类(也称为聚类分析)是一种无监督机器学习算法,它会根据某种相似度度量将相似的项目归到一起。
Tableau 在底层使用了 K 均值聚类算法。K 均值是将数据划分为 K 个簇的一类聚类技术,属于基于质心的聚类。在 K 均值聚类中,给定簇的数量 k,算法会将数据集划分为 k 个簇,每个簇都有一个质心,质心由该簇内所有点的均值计算得到。然后根据数据点到各质心的距离,将数据点归入相应的簇。
这里有两篇来自 DataCamp 的优质教程,详细讲解了聚类的概念:
如果您想进一步了解机器学习中的聚类,可学习 DataCamp 的 Python 无监督学习 或 使用 SciPy 的聚类方法课程。
下图对 K 均值算法进行了可视化,便于理解。最初,我们随机定义 4 个质心点。K 均值算法随后将每个数据点分配到其最近的簇(用叉号表示)。随着所有数据点均值的变化,质心会移动到新的位置;这一过程会不断重复,直到质心位置不再发生变化。
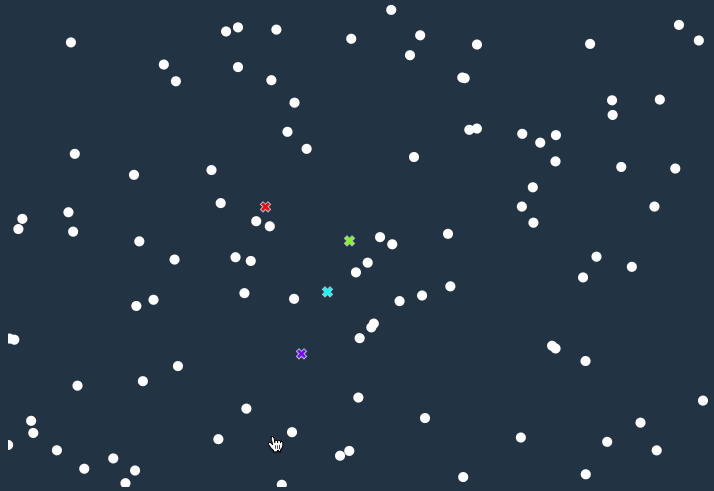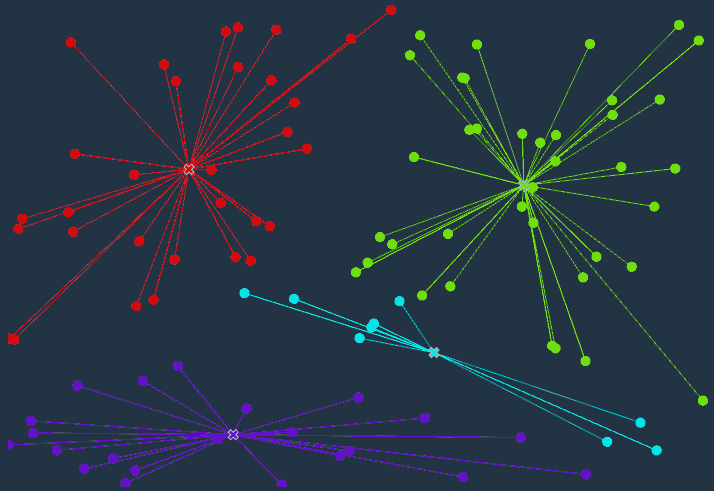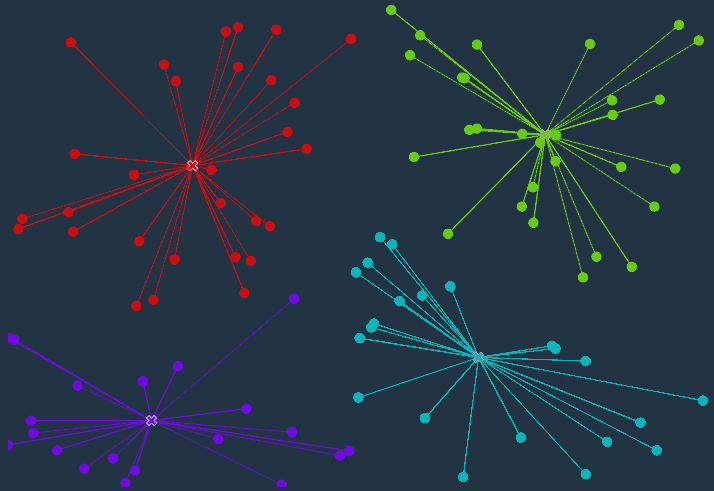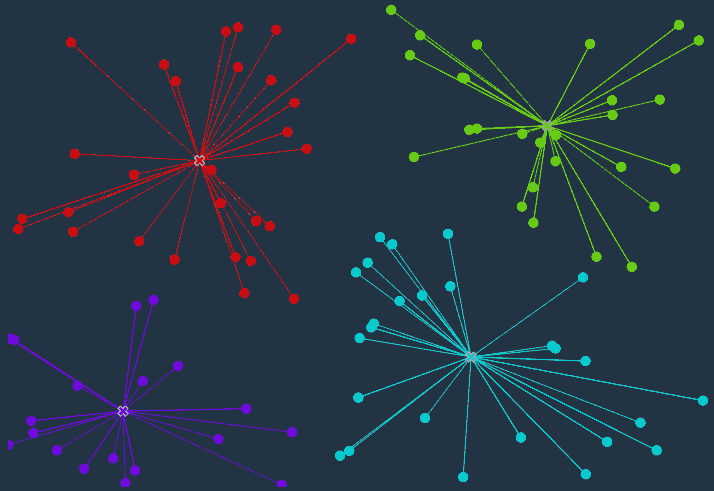
K 均值算法可视化
Tableau 中的聚类判据
在了解一些聚类方法论之后,让我们来看看 Tableau 是如何实现聚类的。Tableau 使用 Calinski-Harabasz 判据来评估簇的质量。以下是 Calinski-Harabasz 判据的数学表述:
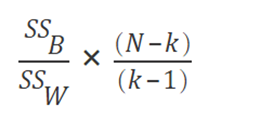
来源
“其中 SSB 为总体类间方差,SSW 为类内总体方差,k 为簇的数量,N 为观测数”(来源)。
该比值用于衡量簇的凝聚度。值越高,说明类内距离更小、类间距离更大,簇越紧密、区分越明显。
前提条件
本文假设您对Tableau 有一定了解。如果您完全是初学者,建议先阅读 DataCamp 上以下文章,作为优秀的入门材料。
使用 Tableau 进行数据可视化
Tableau 环境
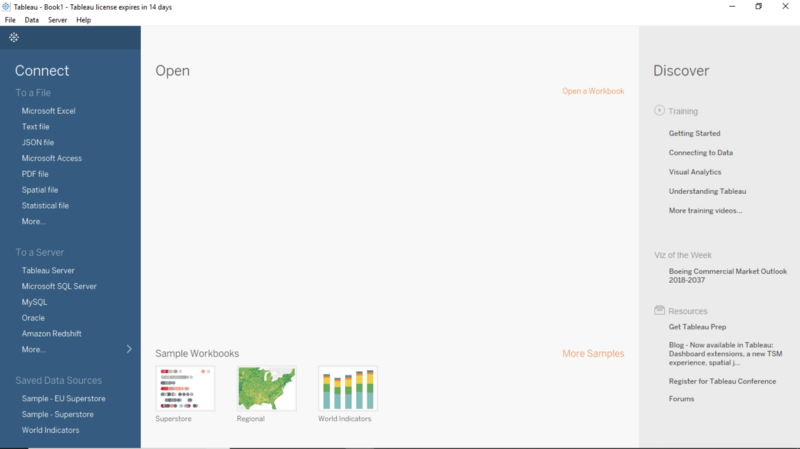
在本教程中,我们将使用 Tableau Public,这是一款完全免费的 Tableau 产品。从官方网站下载 Tableau Public 版本,按照安装说明进行安装;如果单击 Tableau 图标后出现下图界面,即表示可以开始使用。
连接到数据集
本文将使用名为世界经济指标的数据集。该数据集涵盖了一些推动经济发展的重要指标,如各国的预期寿命、营商便利度、人口等,来源于联合国。可从此处获取。
- 将数据集下载到您的计算机。
- 从本地计算机将数据导入到 Tableau 工作区。在工作表选项卡下使用 Data Interpreter(数据解释器)来修正并重新对齐数据。
进入工作表,查看“度量”和“维度”选项卡。度量选项卡下有许多字段,可以合并到同一类别中。这也有助于更好地呈现所有数据字段。
- 选择 Business Tax Rate、Days to Start Business、Ease of Business、Hours to do Tax and Lending Interest > 创建文件夹。
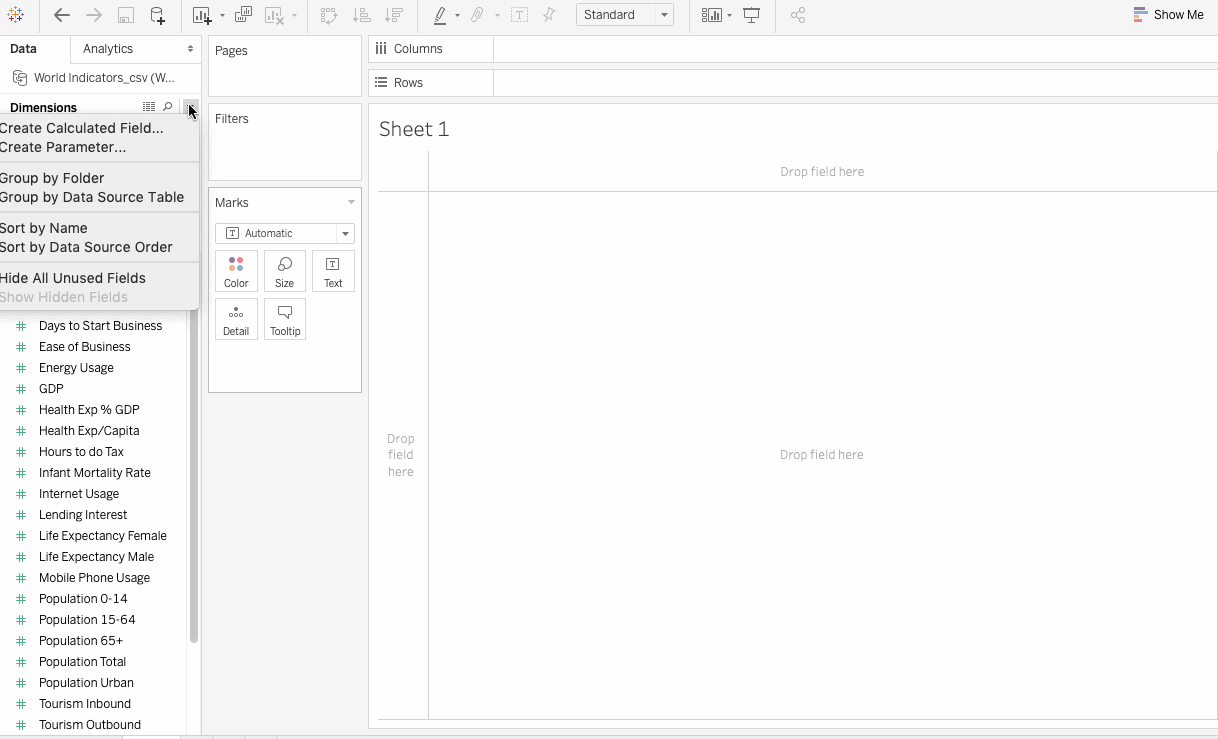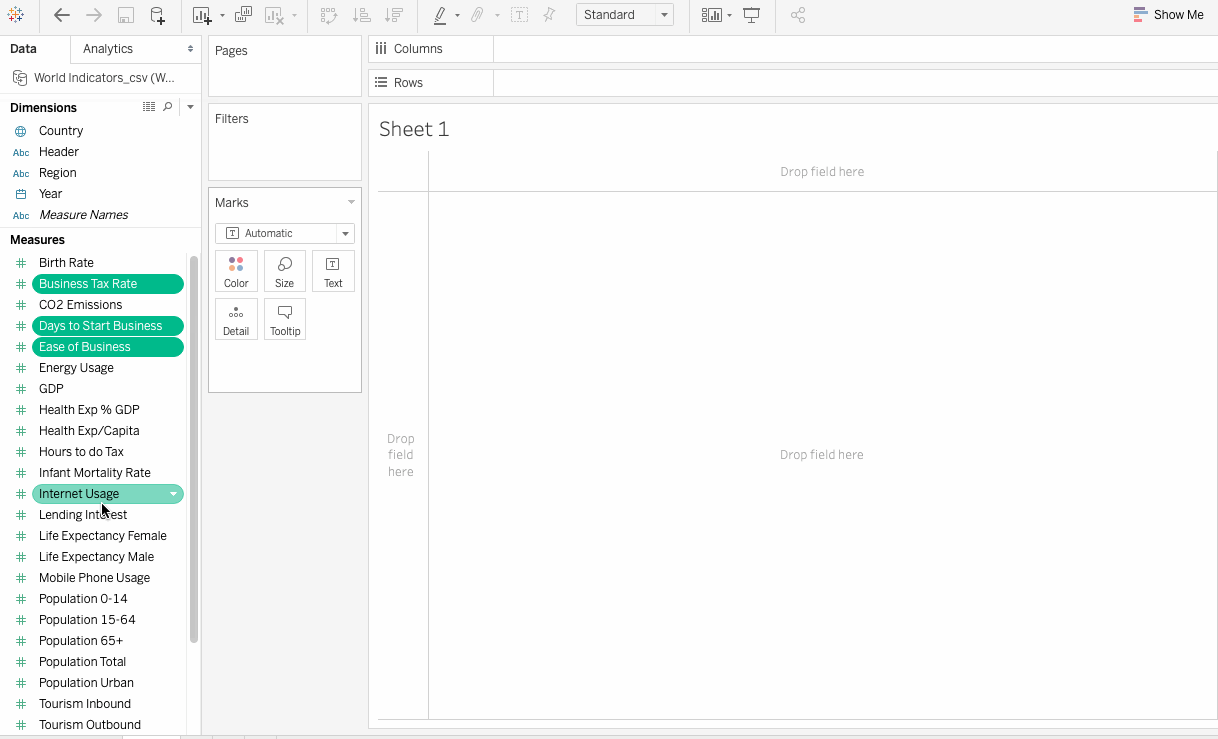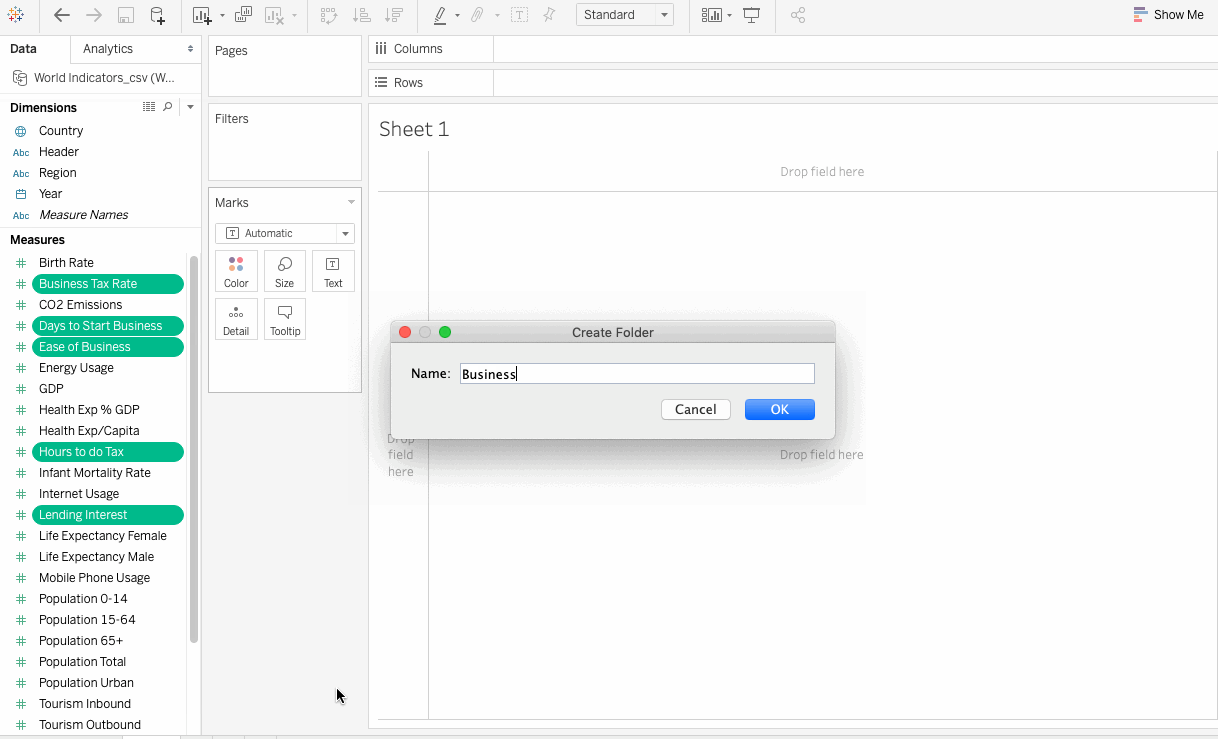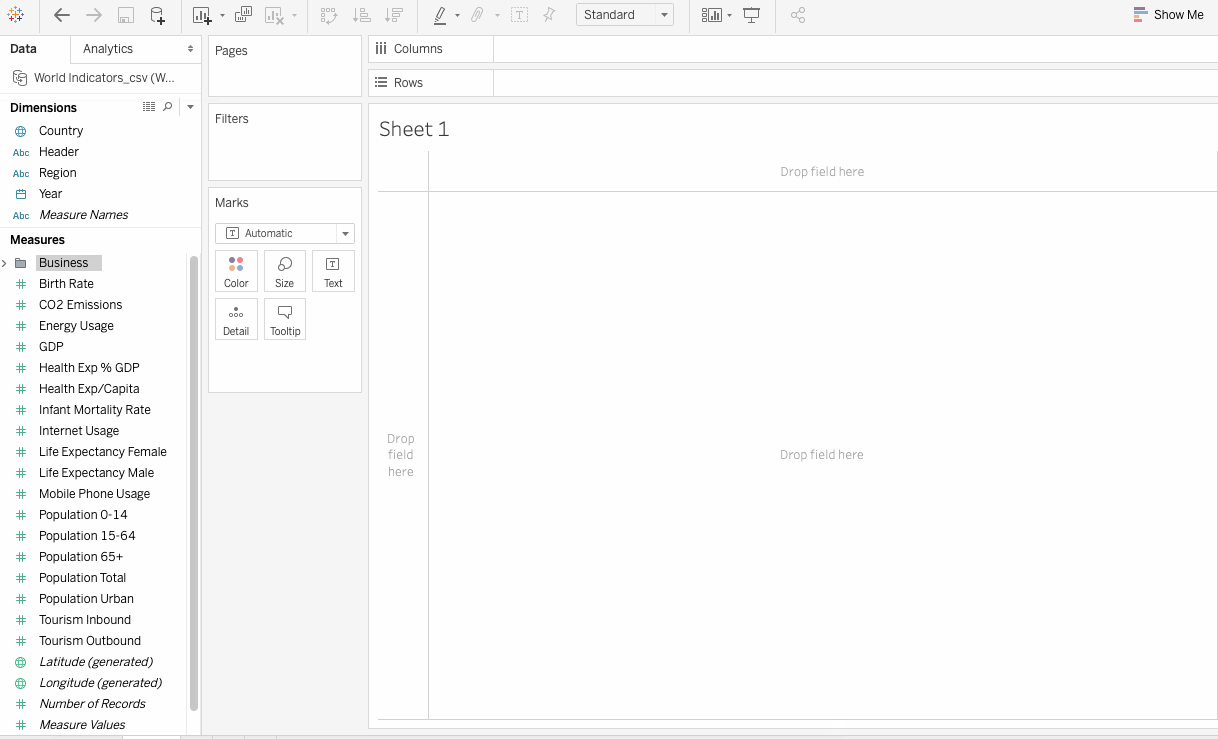
- 将该文件夹命名为 Business,上述所有字段将归入该文件夹。
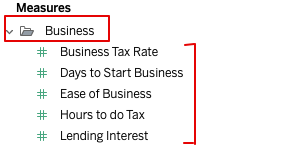
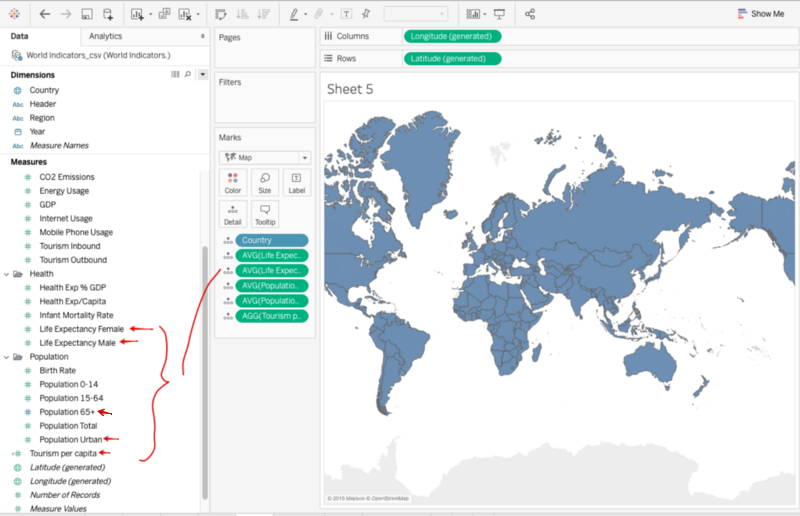
- 同样,为 Development、Health 和 Population 创建文件夹,并分别添加以下字段。格式化完成后,“度量”选项卡如下所示:
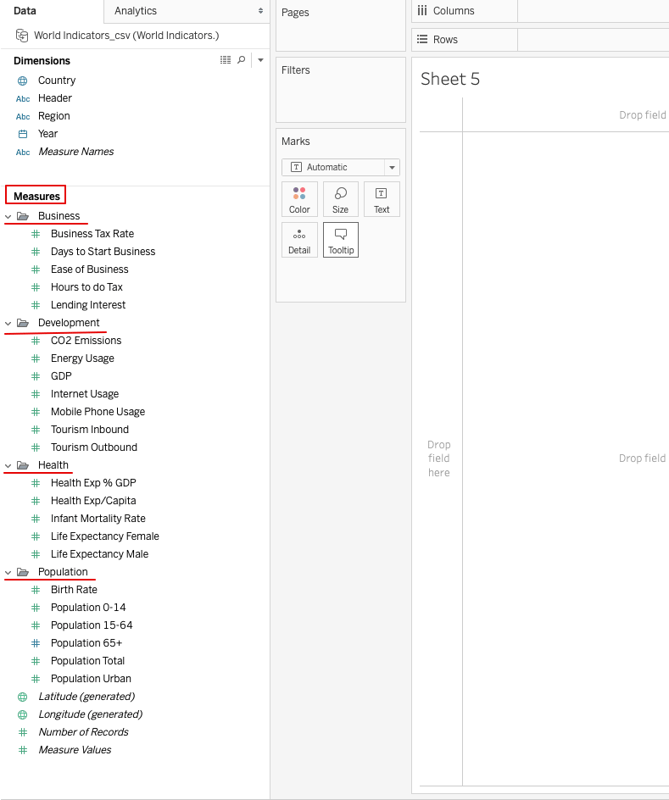
基于世界经济指标数据创建聚类
聚类有助于挖掘数据集中的模式。假设您是一家旅游公司的分析师。随着全球预期寿命的提高,银发旅游迅速增长。老年人如今更为活跃,也更愿意出行看世界。您的公司希望抓住这一趋势,而您的任务是使用世界指标示例数据,识别出拥有足够目标客户的国家。聚类正是帮助我们识别此类国家的工具。
识别银发旅游成功率高的国家
下面通过各个步骤,在数据上执行聚类分析。
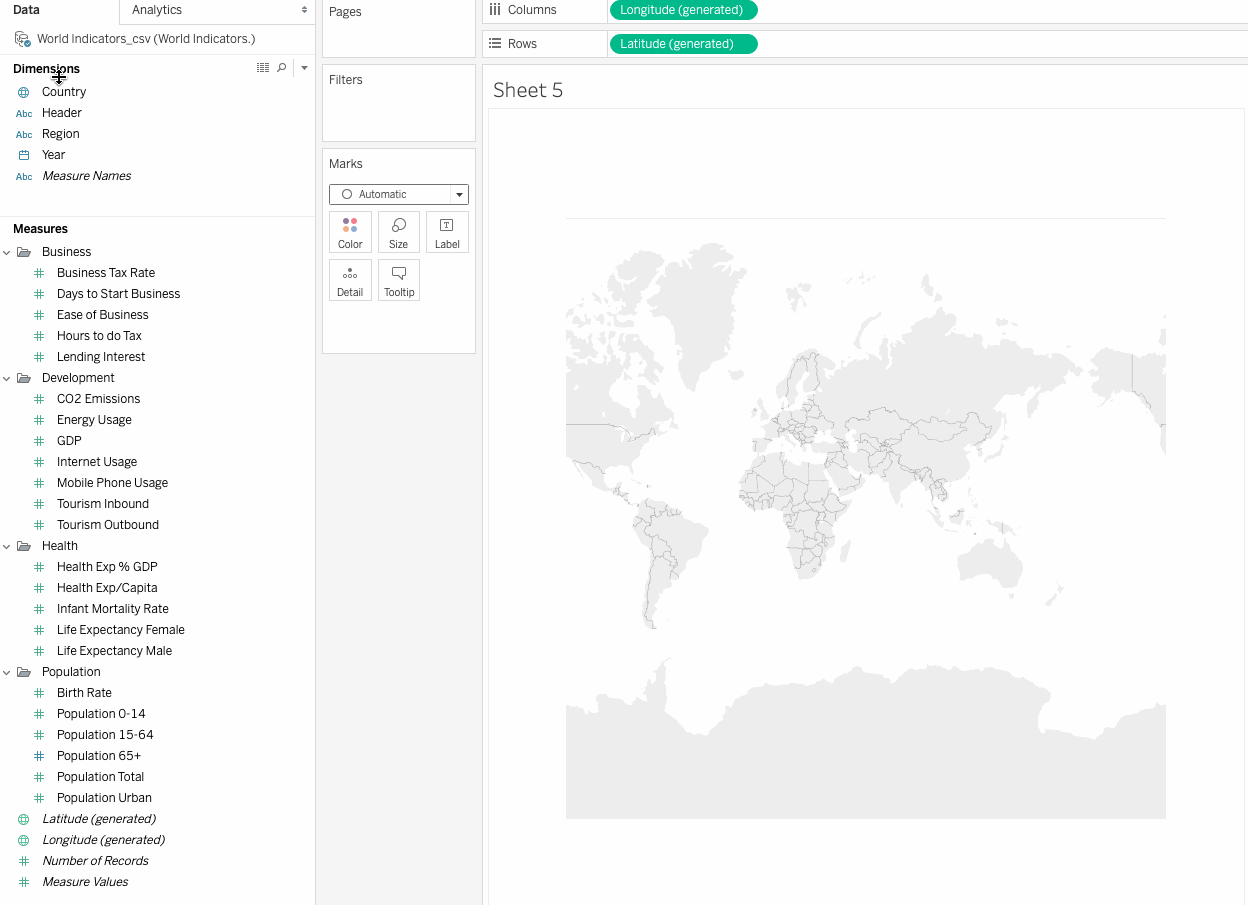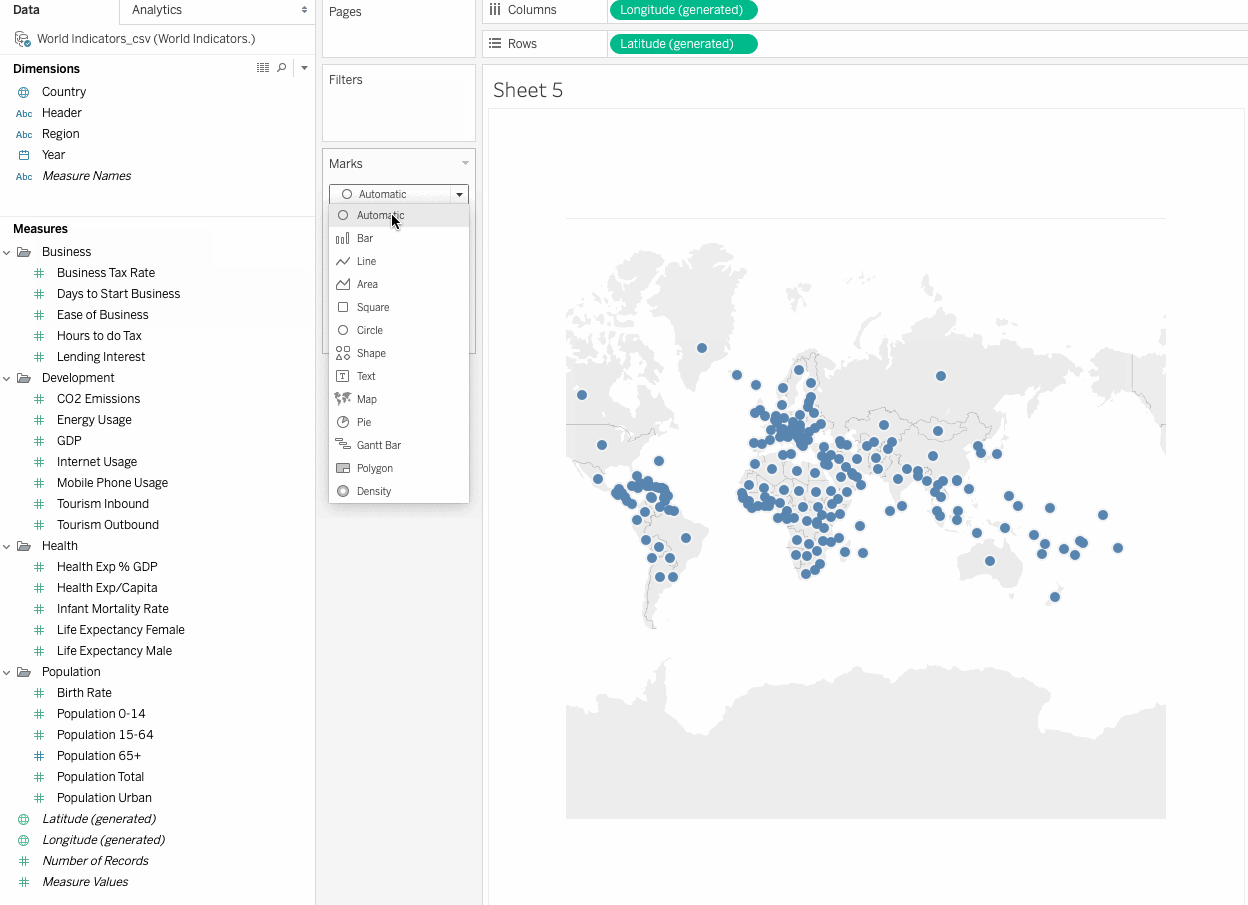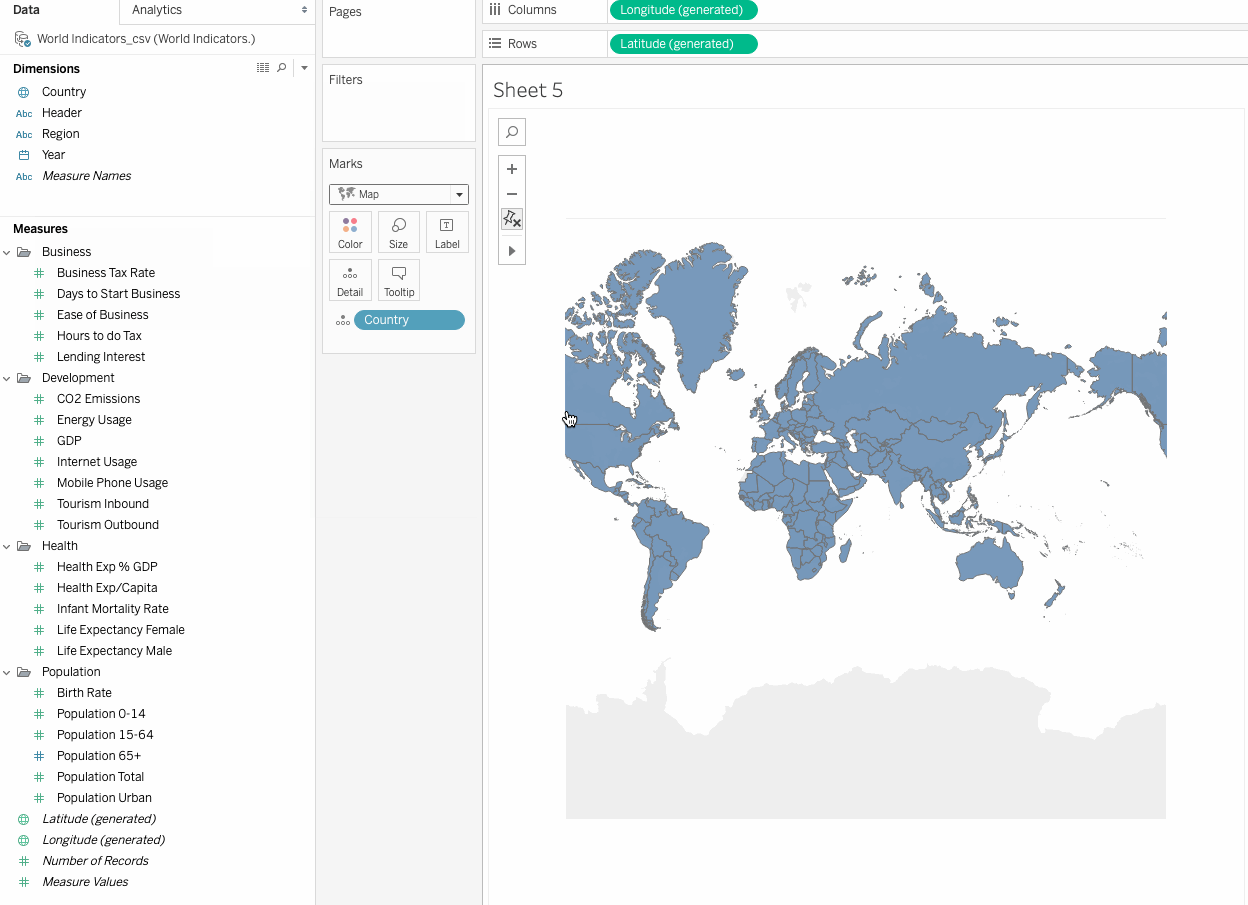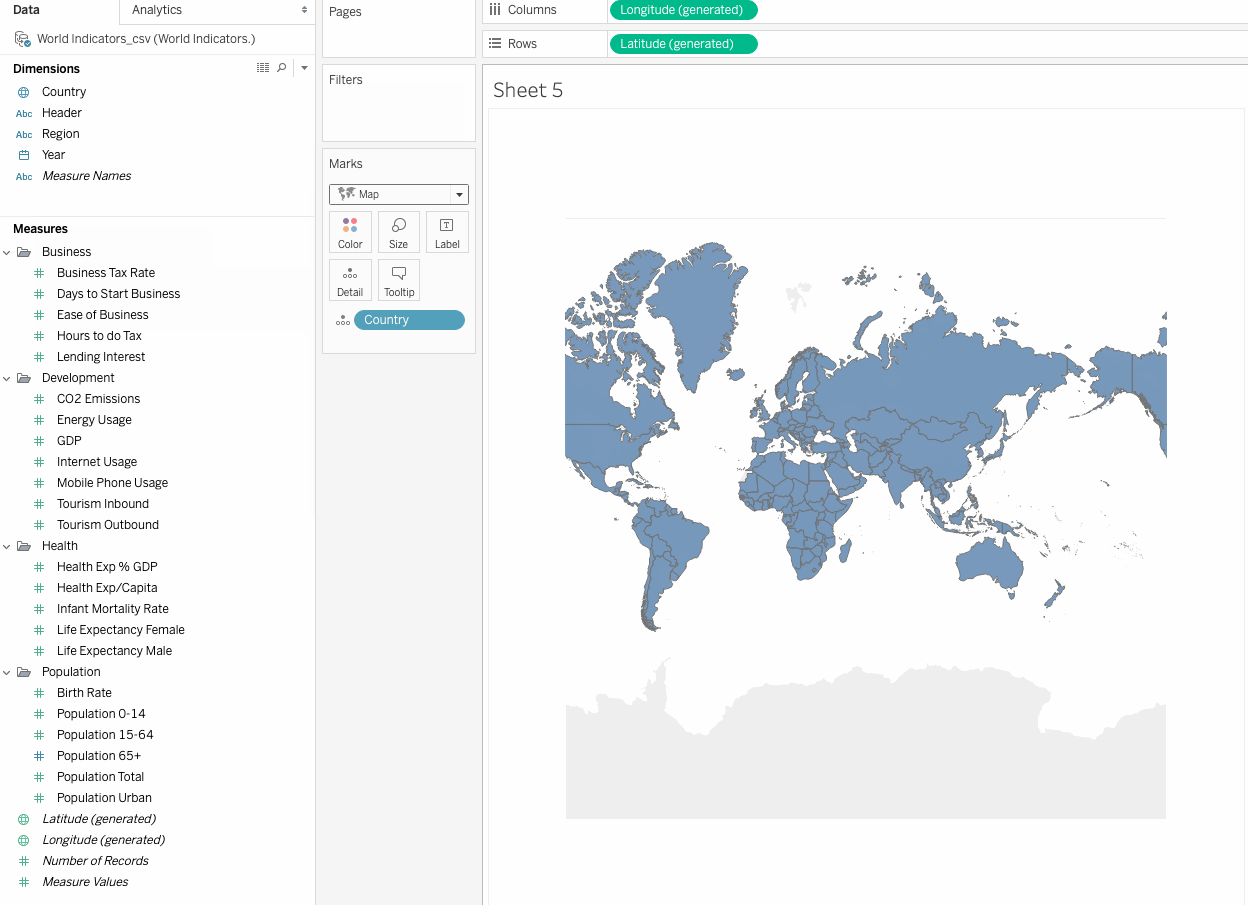
- 在数据窗格的“维度”下双击
Country。Tableau 将创建一幅地图视图,每个国家用一个实心圆表示。将标记类型更改为 Map,在 Marks 卡中进行操作。
确定用于聚类的变量
聚类的下一步是确定将用于聚类算法的变量。在 Tableau 中,变量与字段相当。并不存在能产生理想簇的“唯一最佳变量”组合,您需要尝试多种变量,以观察哪些能得到期望结果。在我们的案例中,使用以下字段:
城镇人口是衡量一国人口密度的良好指标。密度越高,意味着可获得的商业机会越多。
65 岁以上人口代表老年群体,这也是我们的目标细分。
- Life Expectancy Female 和 Life Expectancy Male
预期寿命较高的国家,意味着人们普遍更长寿,出行意愿可能更强。
该字段目前不存在,可以使用 Tourism Outbound 和 Population Total 字段创建为一个计算字段,公式如下:
Tourism Per Capita = SUM([Tourism Outbound])/SUM([Population Total])
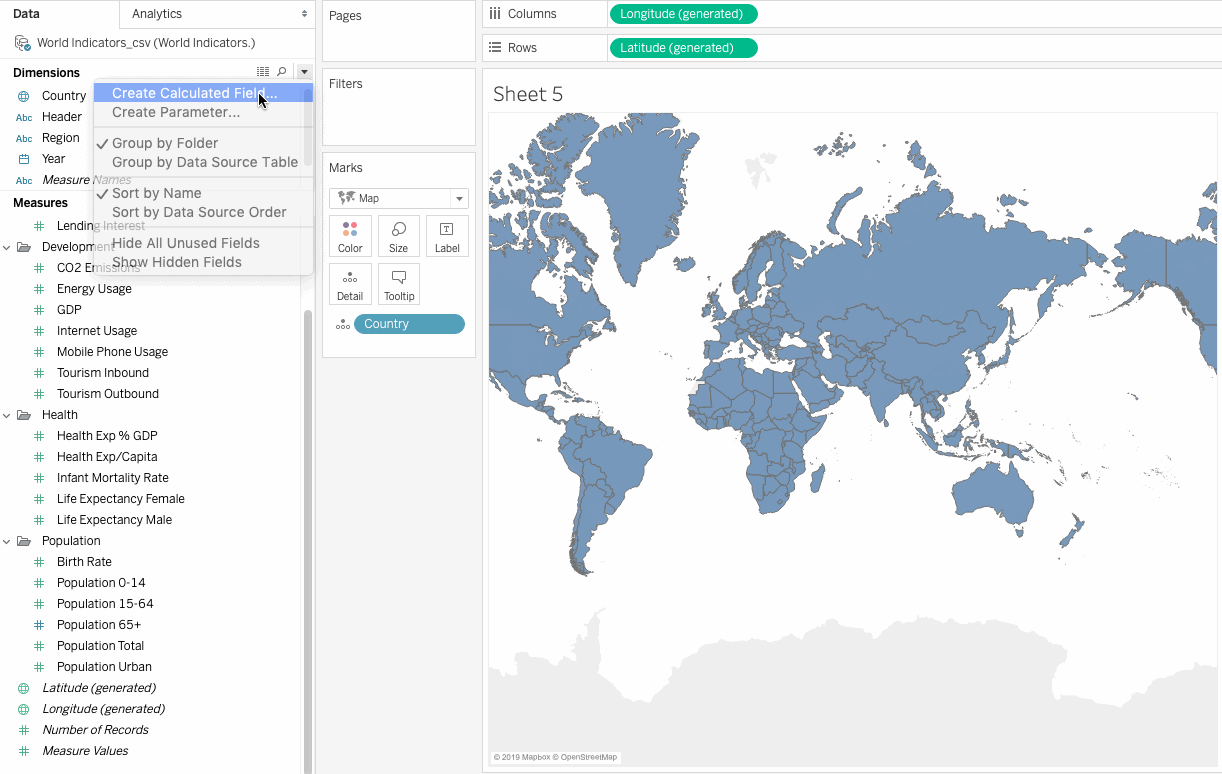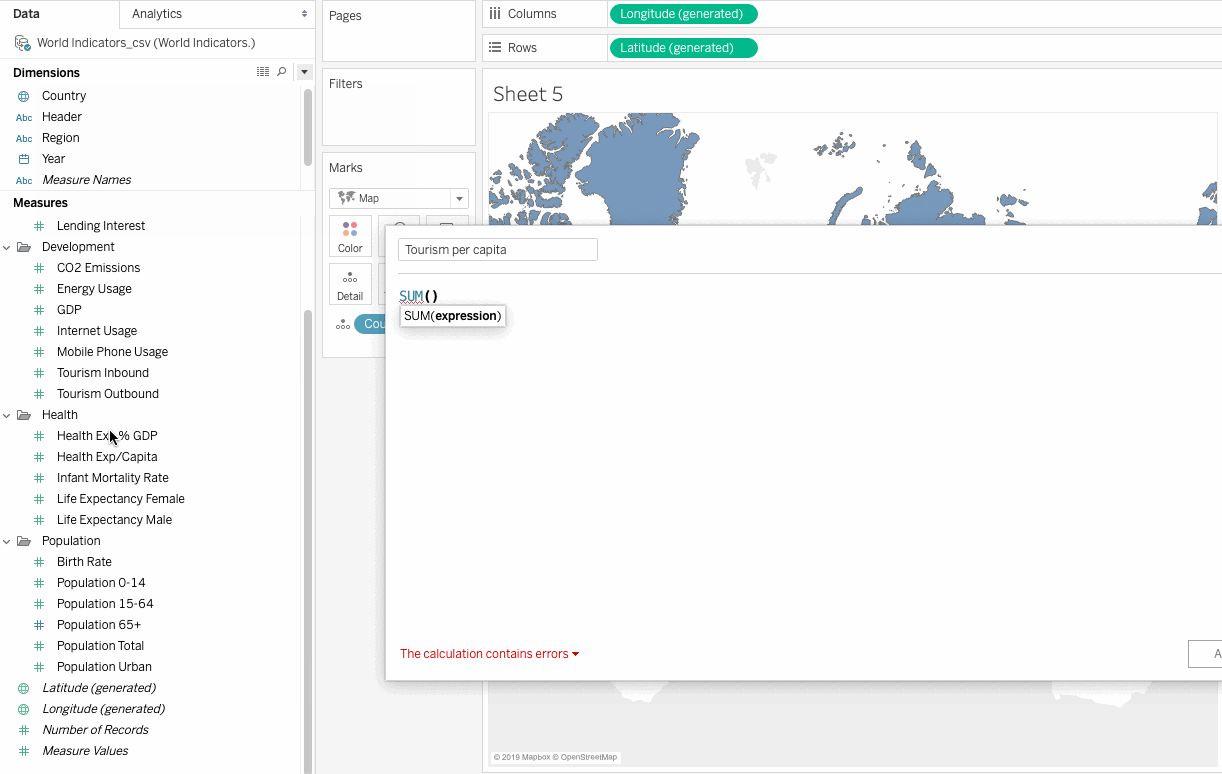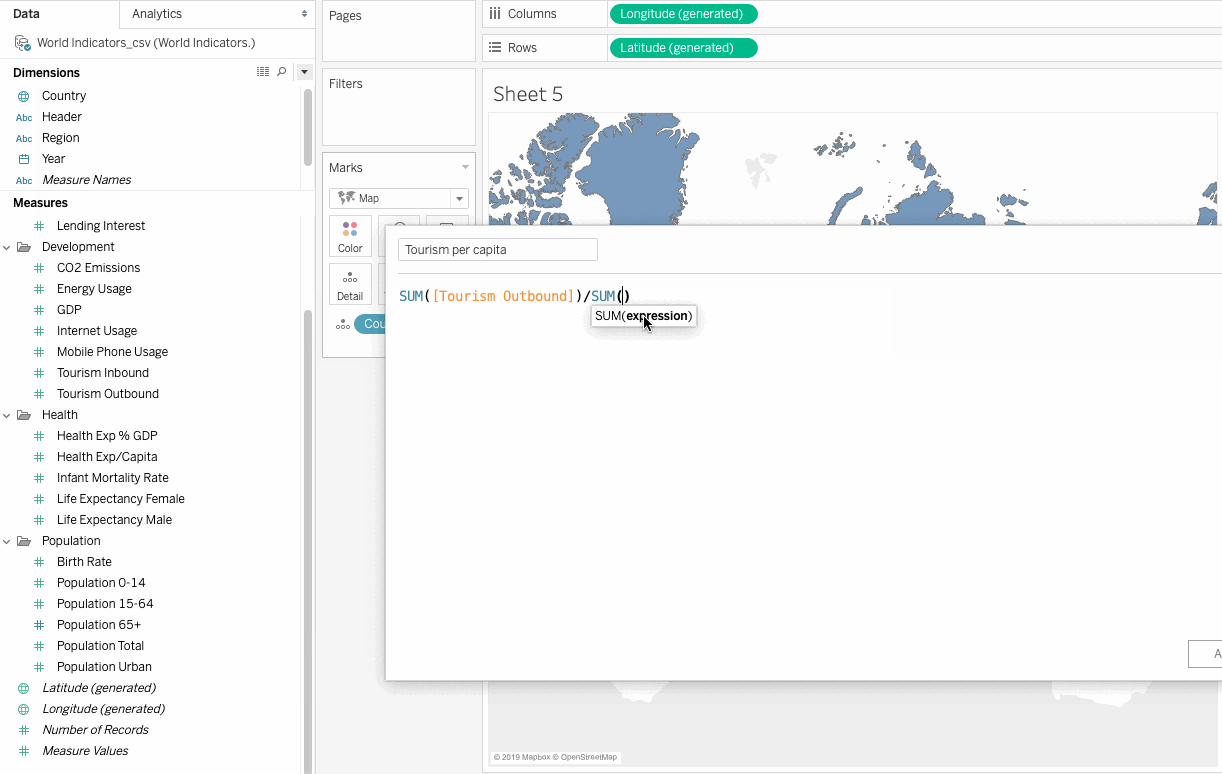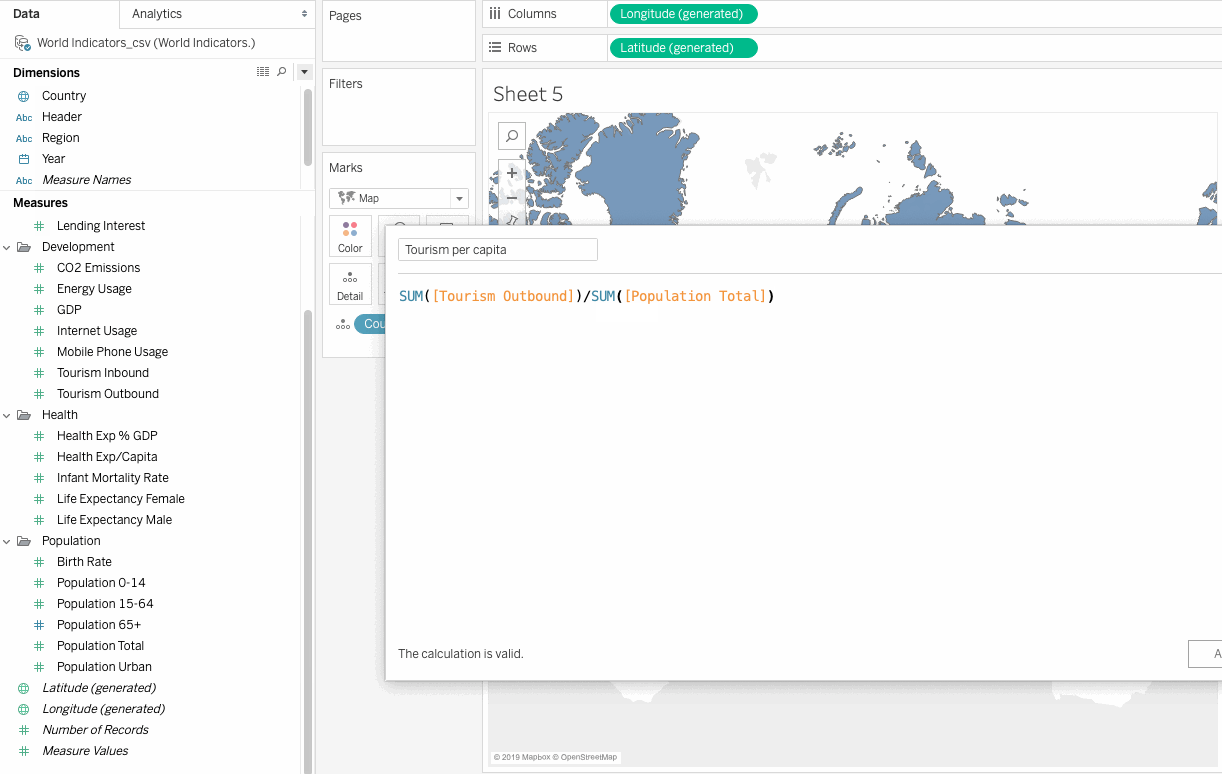
Tourism Outbound 表示一国居民每年在国际旅行上的花费(以美元计)。为了得到人均值,我们需要用该字段除以各国的人口。
将选定字段添加到视图
在继续之前,需要将默认聚合从 SUM 更改为 AVERAGE。Tableau 支持对度量或维度进行聚合,但更常见的是对度量进行聚合。每当我们将度量添加到视图中,默认都会对其应用某种聚合。应应用的聚合类型取决于视图的上下文。
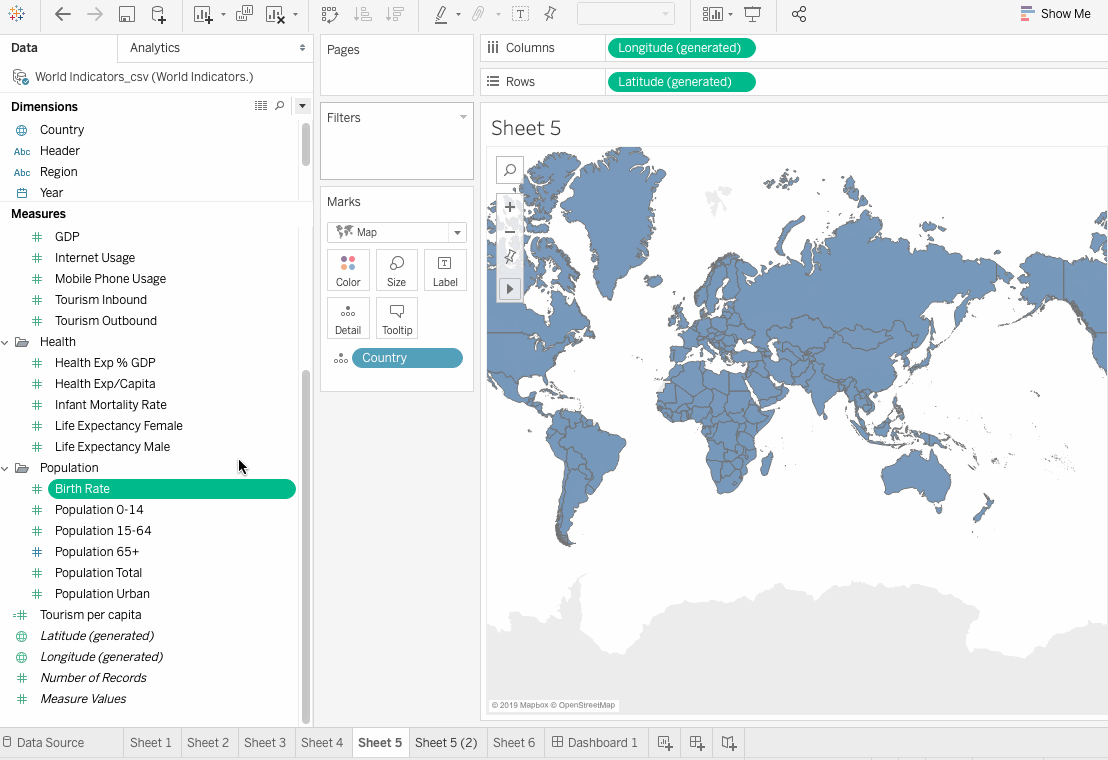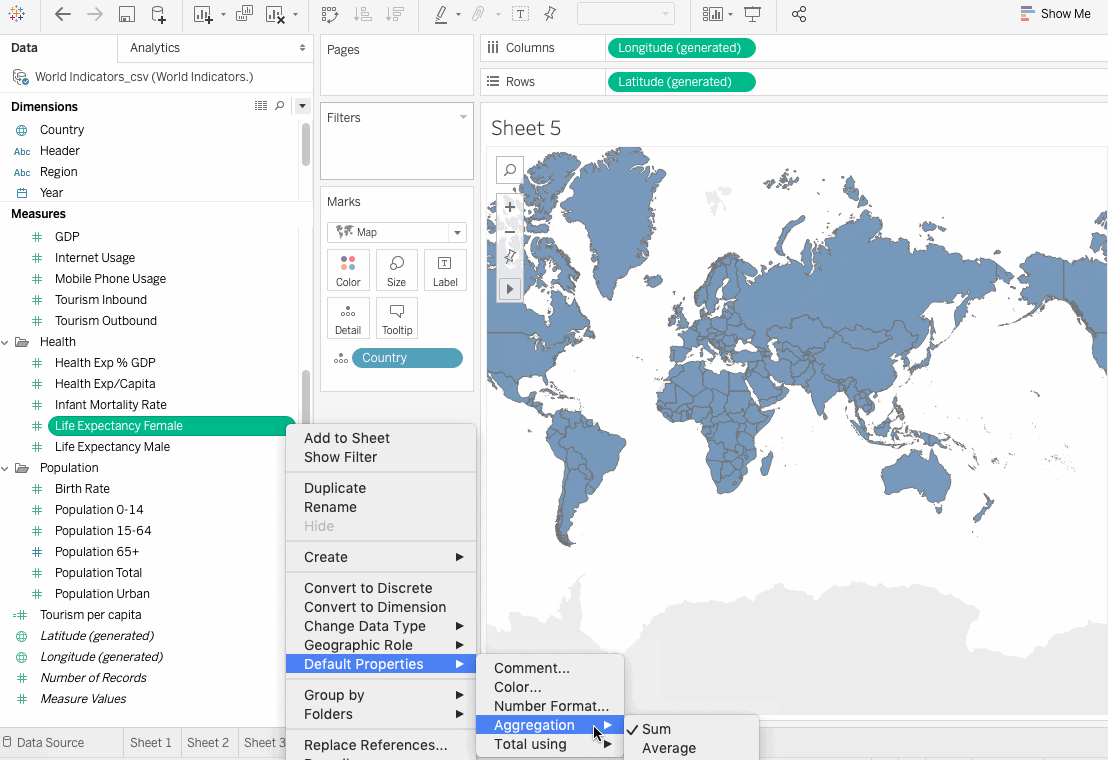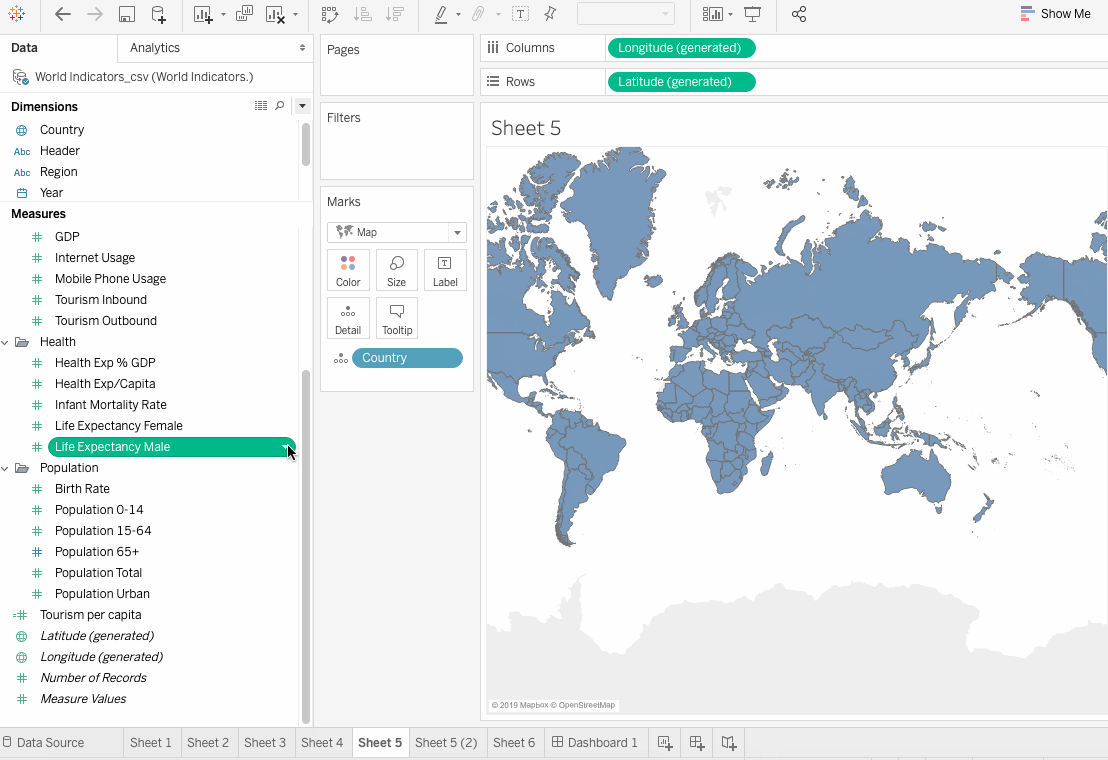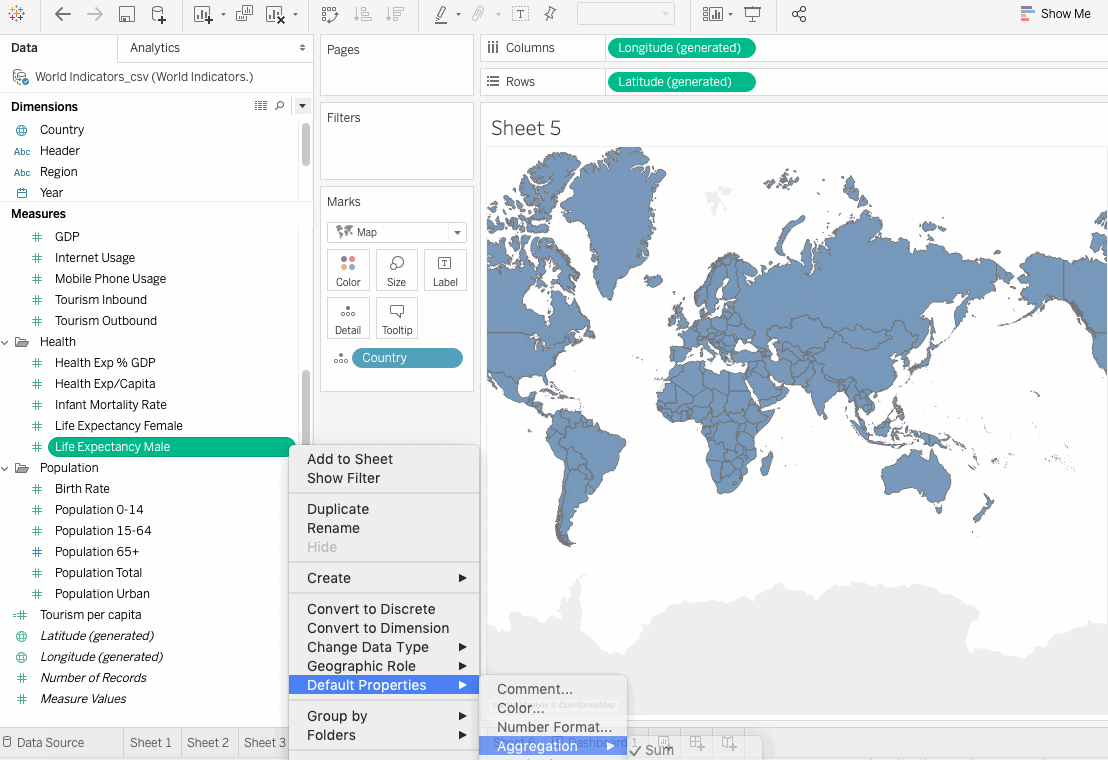
为所有选定字段更改聚合类型,然后将它们拖到 Marks 卡中的 Detail,如下所示:
聚类
在 Tableau 中,聚类是一个简单的拖放过程。步骤如下:
- 单击
Analytics 窗格,将 Cluster 拖到视图中,Tableau 会自动对数据进行聚类。
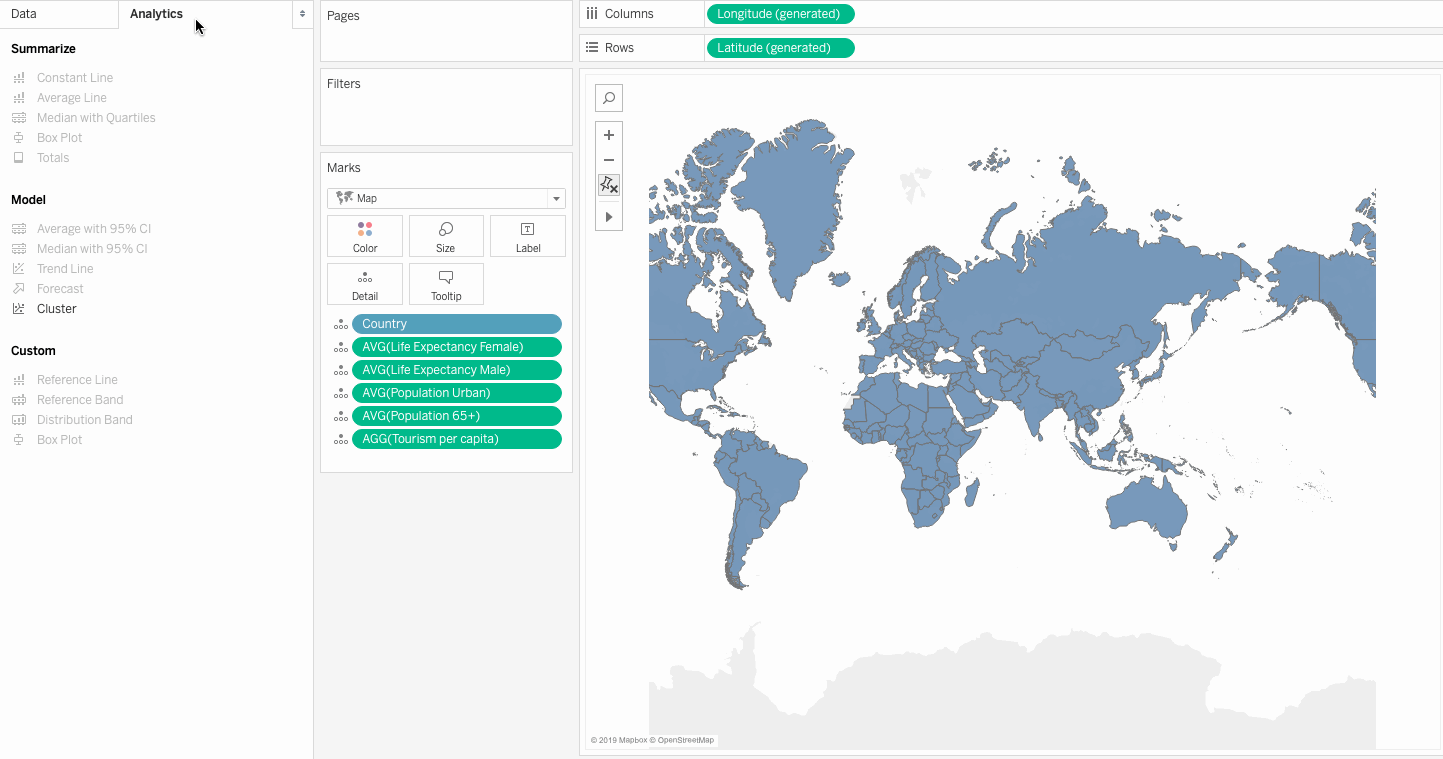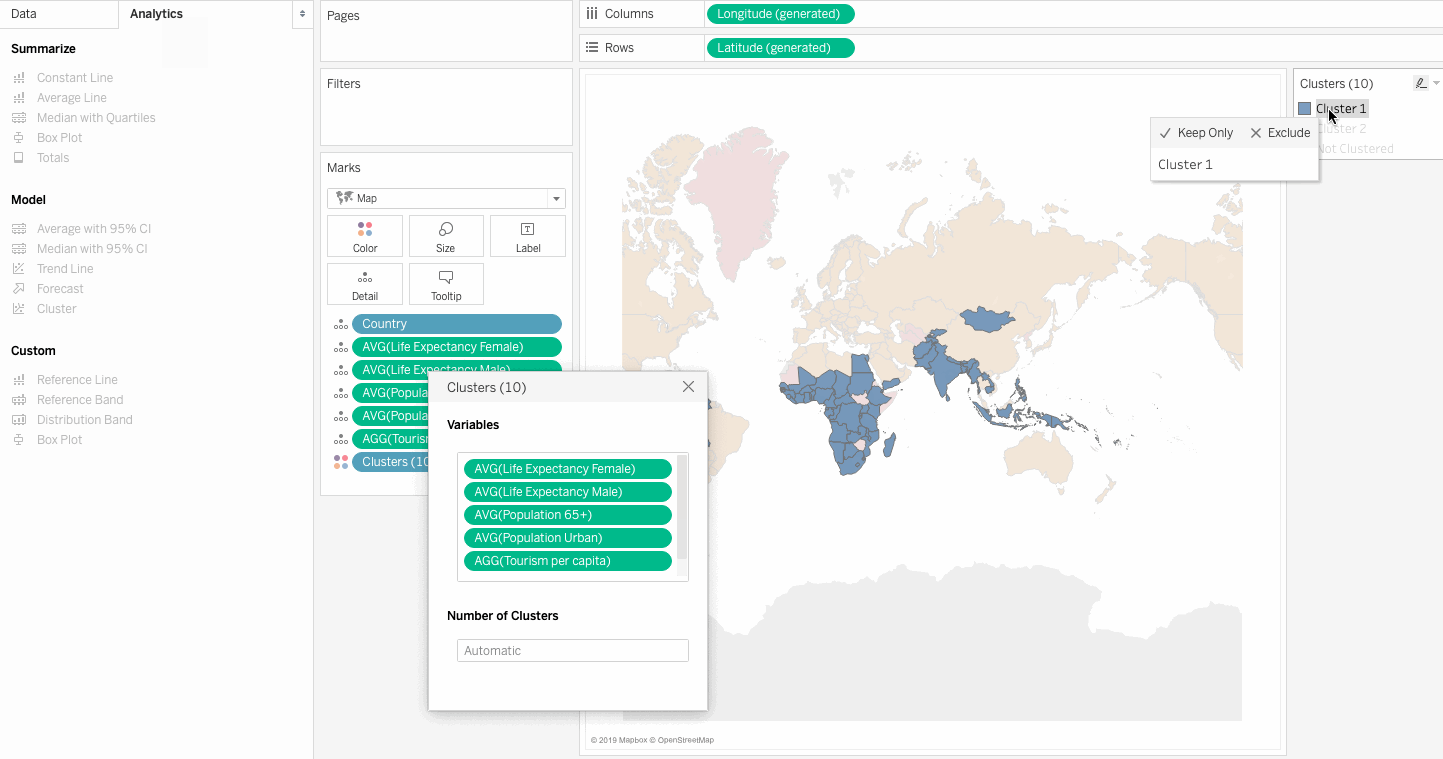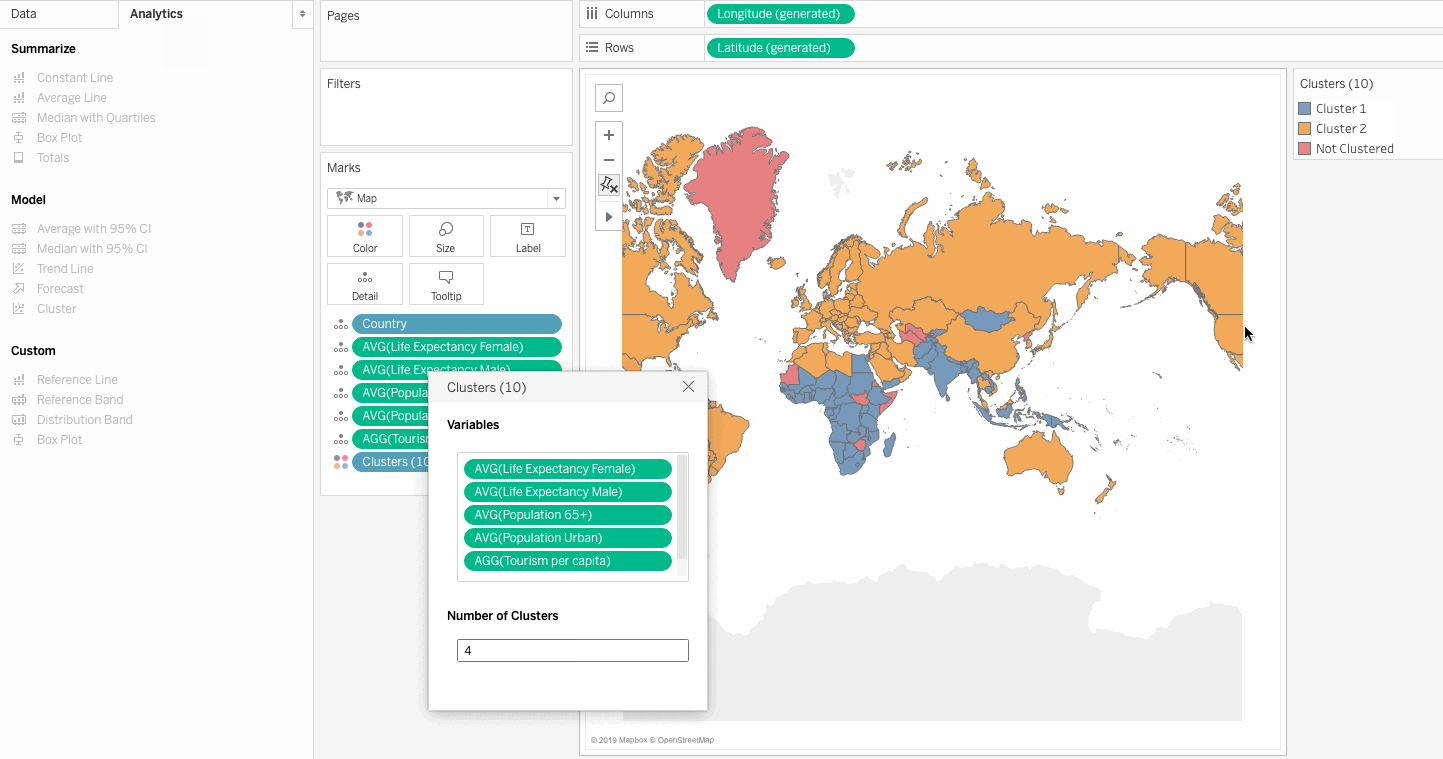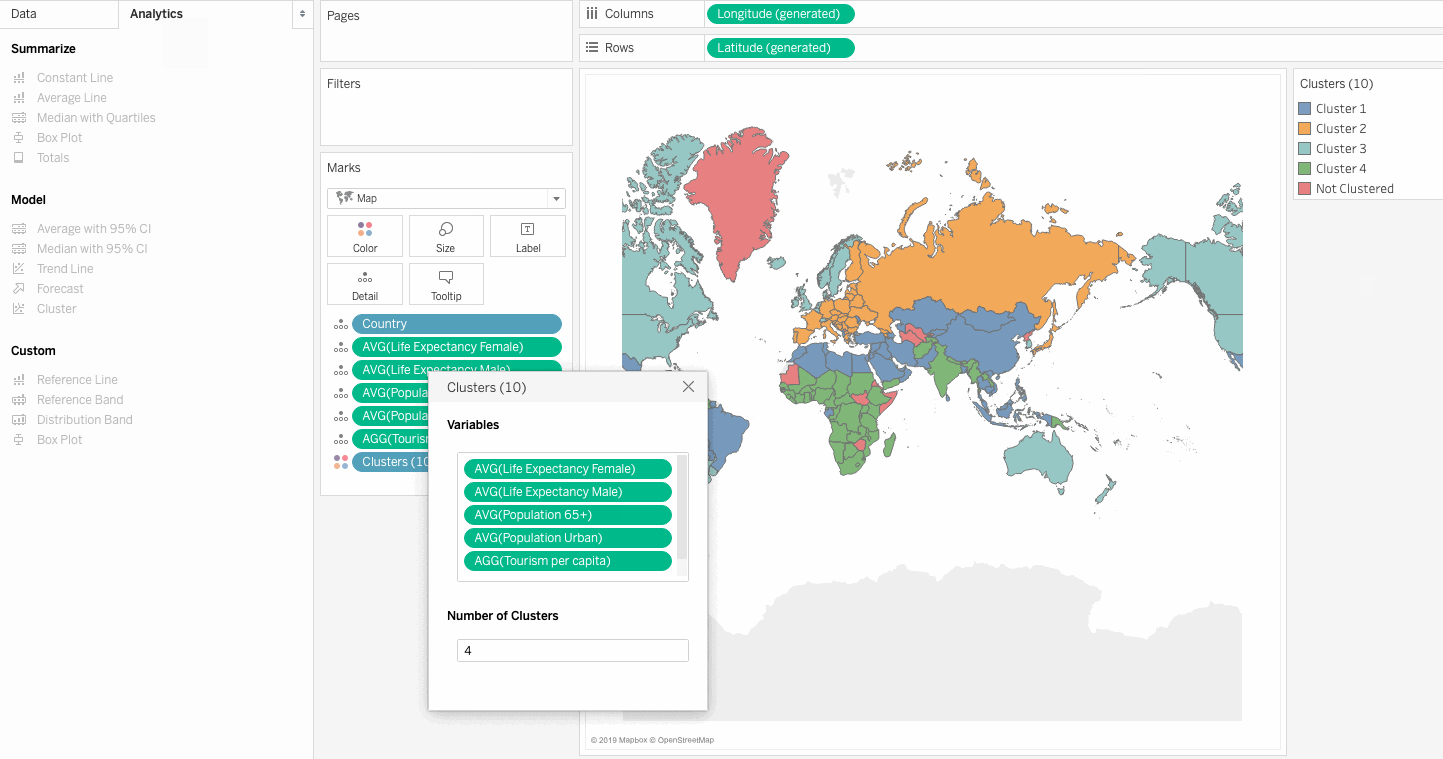
- 虽然 Tableau 能自动决定需要创建的簇数,但我们也可以控制簇的数量以及用于计算聚类的变量。只需将字段拖入框中即可将其纳入聚类算法,拖出即可排除。
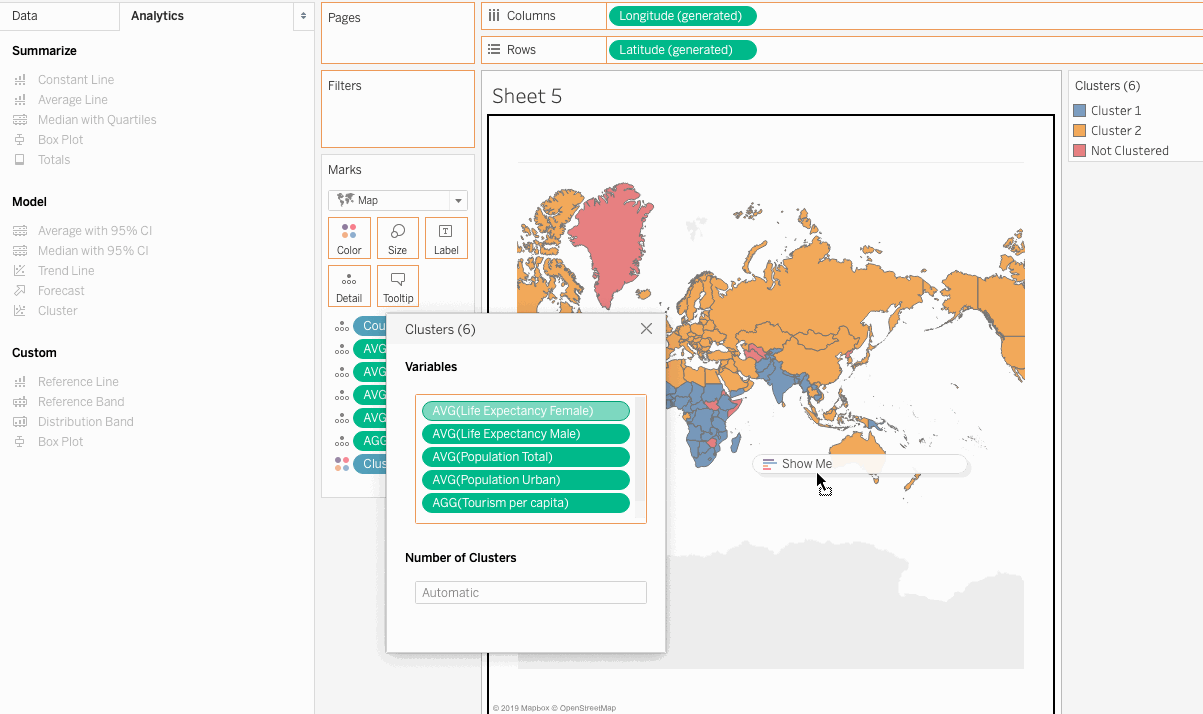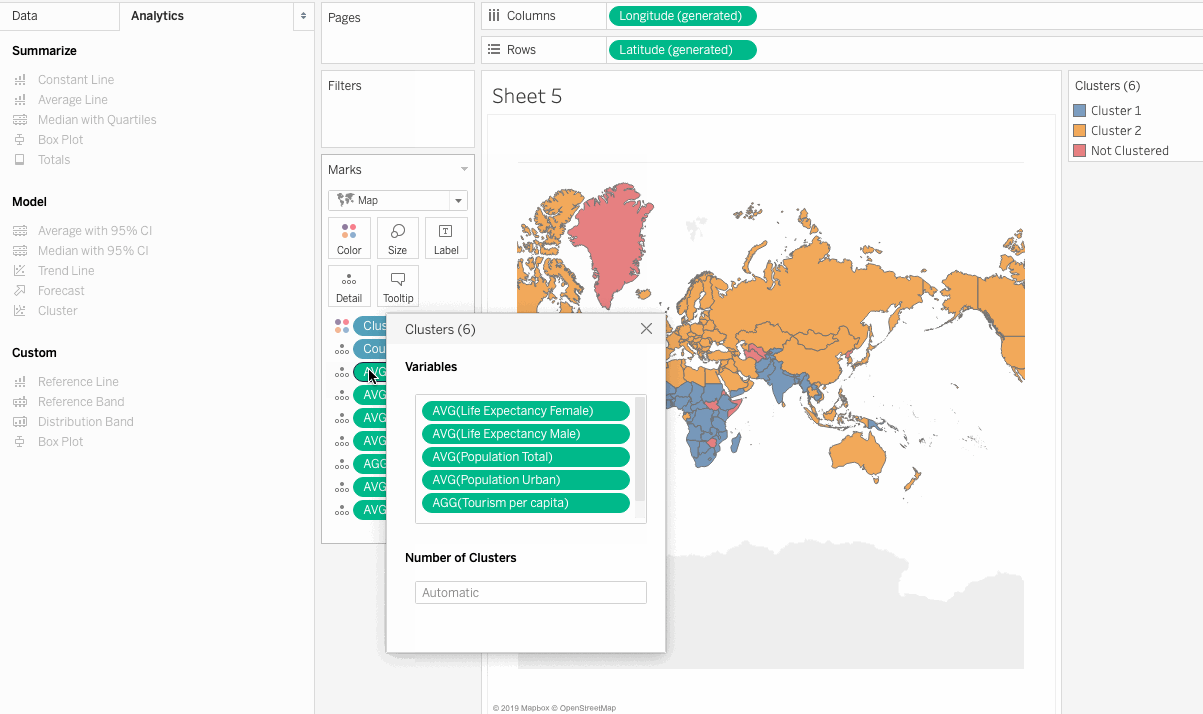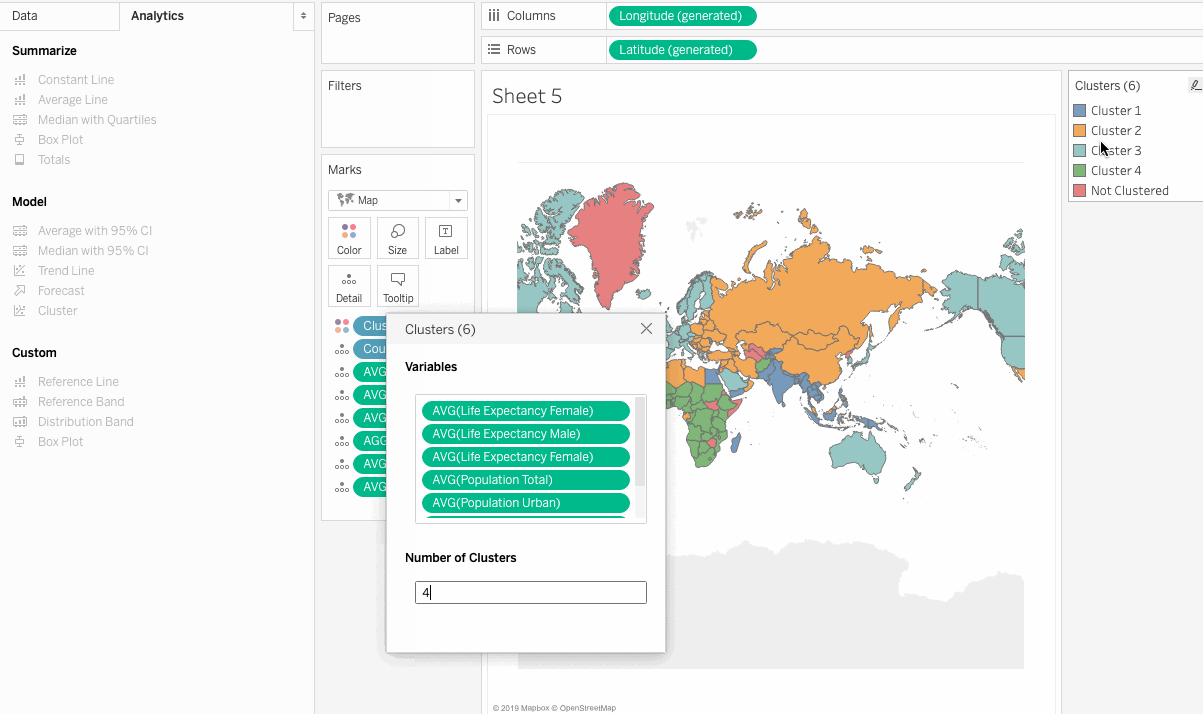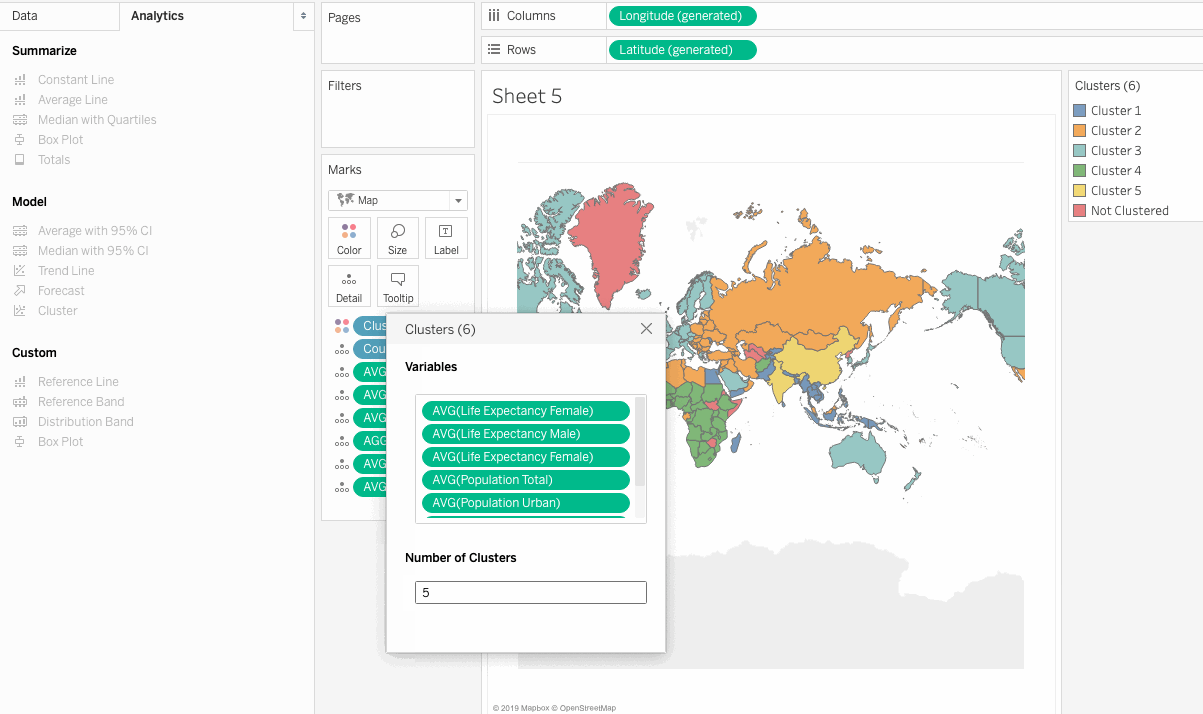
- 为了更好地分析,我们选择 4 个簇并采用默认变量。注意,部分国家未被归入任何簇,并被标记为“未聚类”。
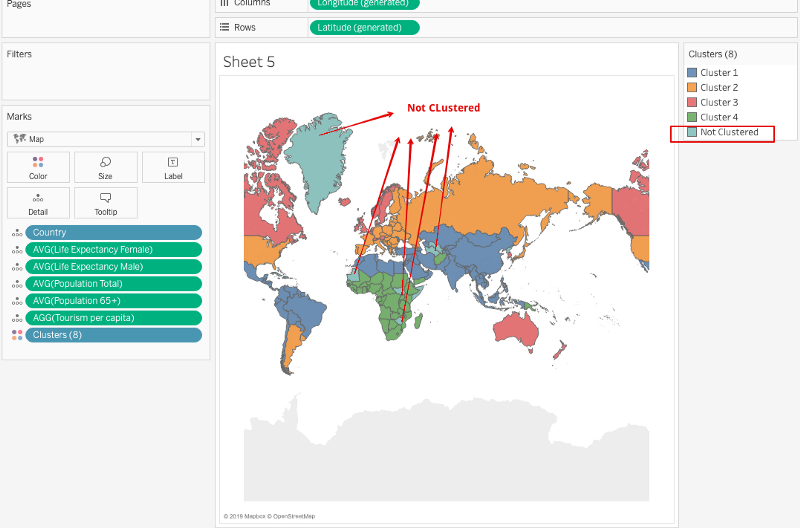
- 聚类会以一个新的胶囊(pill)形式创建,并显示在“颜色”货架上。将该胶囊拖到数据窗格中,即可保存为一个分组。
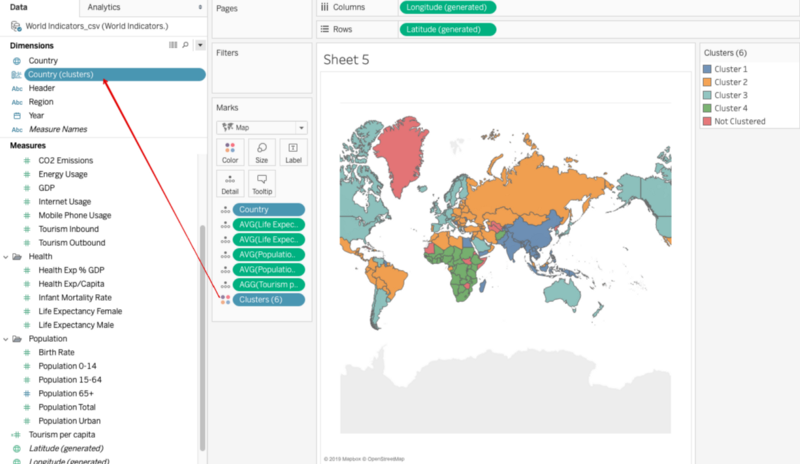
至此,我们已根据选定的度量对各国完成聚类。但如何解读这些结果,并据此做出业务决策呢?下一节将解答这些问题。
描述聚类
在 Marks 卡中单击“Clusters”字段,然后单击“Describe Clusters”(描述聚类)。
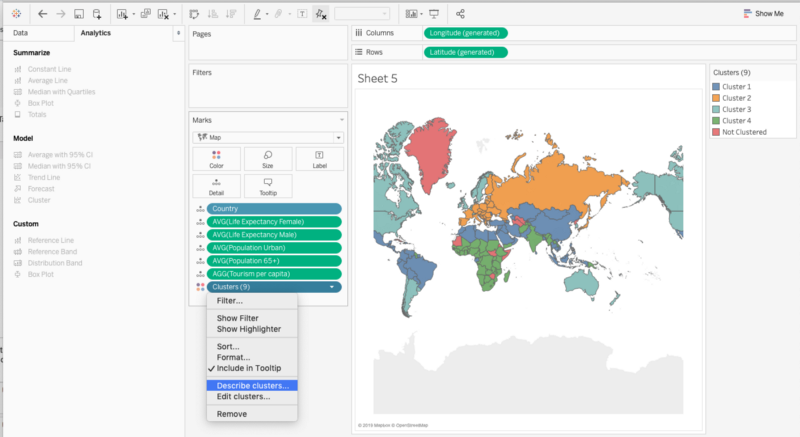
这会显示一个包含聚类详细描述的文档。该文档包含两个选项卡:
摘要
提供结果概要,并给出每个簇中各变量的平均值。
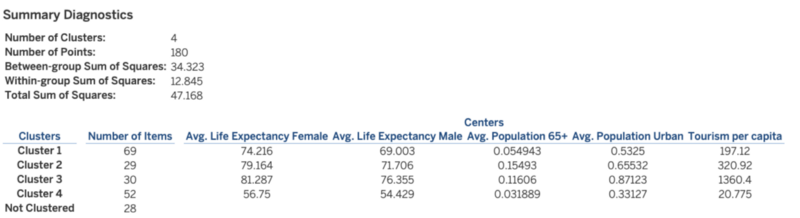
从上述结果可以推断,簇 3 具备:
- 男女均具有最高的预期寿命
- 最高的人均旅游支出
- 最高的城镇人口
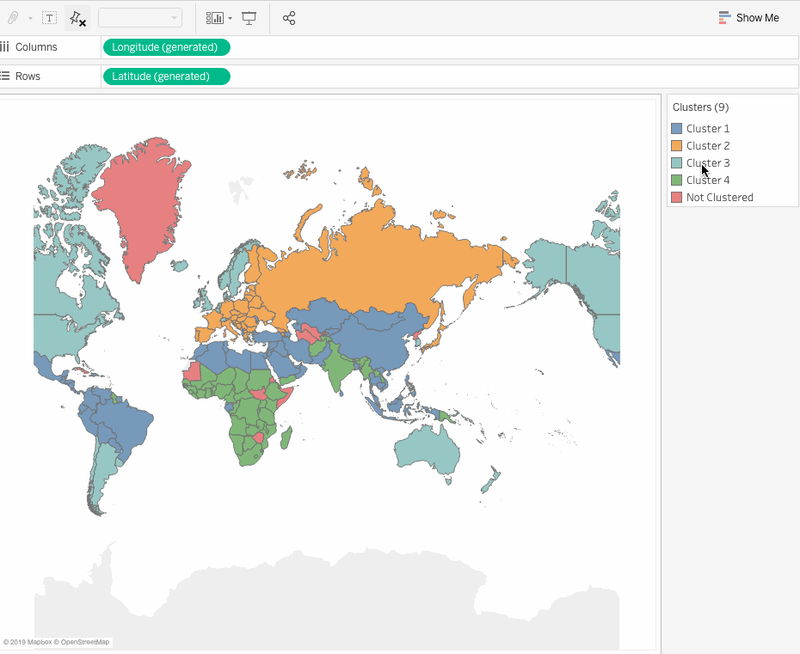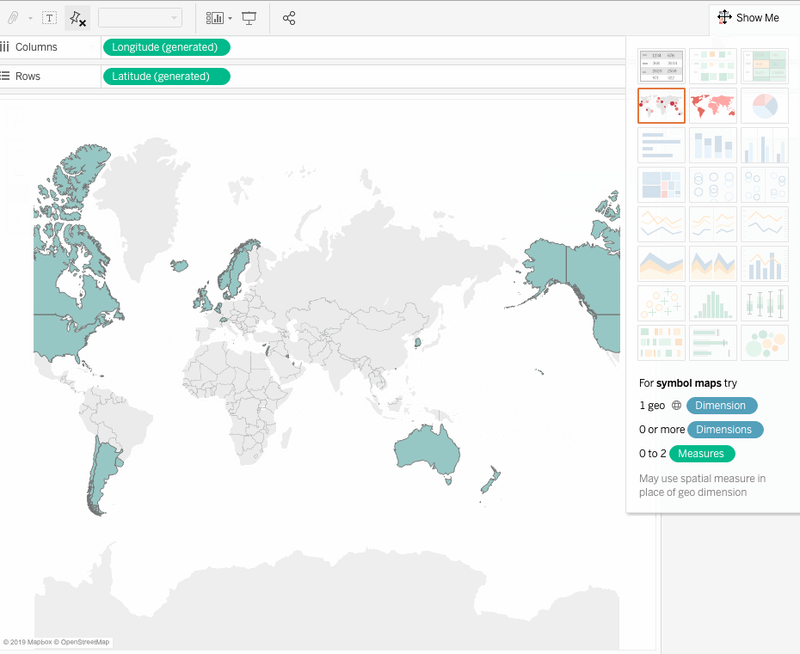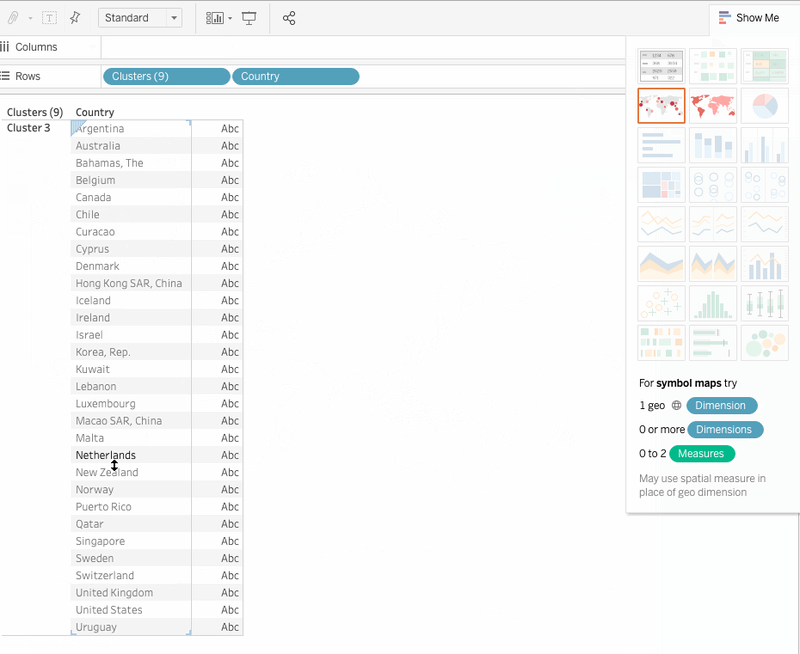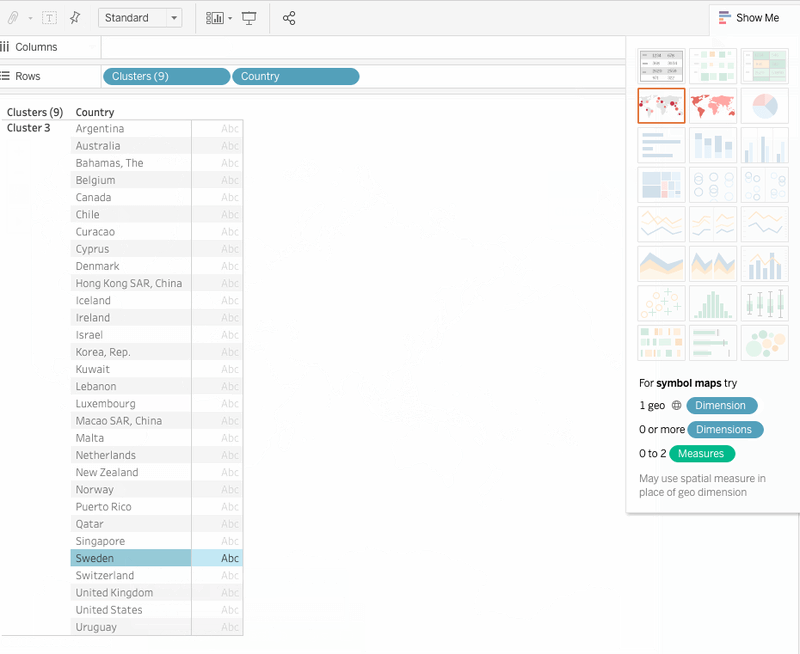
这意味着其拥有更富裕的城市人口和更长的预期寿命,因此看起来是银发旅游行业的优质市场。让我们看看该簇包含哪些国家。
模型
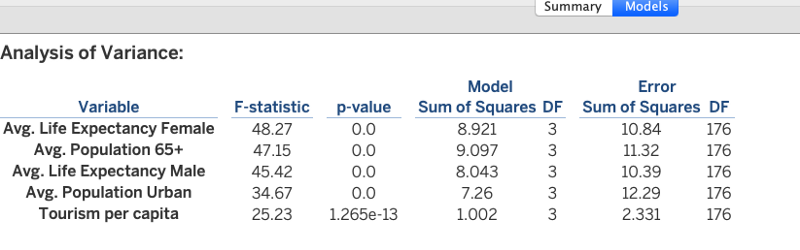
“模型”选项卡显示了所有变量/字段平均值的多种统计量及其统计显著性。
因此,作为分析师,您可以将这份名单提交给销售团队,以便他们重点关注这些潜在客户。聚类为我们提供了宝贵洞见。接下来,您可以尝试不同的字段,设置人口或收入阈值等。聚类数据的方法很多,但基本原理不变。
结论
本文介绍了如何在 Tableau 中通过简单的拖放机制,对给定数据集进行聚类分析。聚类是一种有价值的工具,与 Tableau 结合使用,能够让分析师掌握强大的统计分析方法。访问我们的 Tableau 专区,获取掌握 Tableau 所需的一切资源。
参考资料
Tableau 文档


数据可能复杂、繁琐,有时要发现其中的模式并不容易。设想您手头有一份公司销售数据,希望按消费者的消费能力挖掘出某种模式。如果能在数据中找出不同的群体或关联,您就可以有针对性地触达不同的群体,从而最大化销售额。这个直觉背后的基本思想叫作聚类,而 Tableau 具备一项内置功能,可以基于特定属性自动将相似的数据点聚为一类。让我们来探索 Tableau 的这一功能,并看看如何将聚类应用到真实世界的数据集。
K 均值聚类
聚类(也称为聚类分析)是一种无监督机器学习算法,它会根据某种相似度度量将相似的项目归到一起。
Tableau 在底层使用了 K 均值聚类算法。K 均值是将数据划分为 K 个簇的一类聚类技术,属于基于质心的聚类。在 K 均值聚类中,给定簇的数量 k,算法会将数据集划分为 k 个簇,每个簇都有一个质心,质心由该簇内所有点的均值计算得到。然后根据数据点到各质心的距离,将数据点归入相应的簇。
这里有两篇来自 DataCamp 的优质教程,详细讲解了聚类的概念:
如果您想进一步了解机器学习中的聚类,可学习 DataCamp 的 Python 无监督学习 或 使用 SciPy 的聚类方法课程。
下图对 K 均值算法进行了可视化,便于理解。最初,我们随机定义 4 个质心点。K 均值算法随后将每个数据点分配到其最近的簇(用叉号表示)。随着所有数据点均值的变化,质心会移动到新的位置;这一过程会不断重复,直到质心位置不再发生变化。
K 均值算法可视化
Tableau 中的聚类判据
在了解一些聚类方法论之后,让我们来看看 Tableau 是如何实现聚类的。Tableau 使用 Calinski-Harabasz 判据来评估簇的质量。以下是 Calinski-Harabasz 判据的数学表述:
来源
“其中 SSB 为总体类间方差,SSW 为类内总体方差,k 为簇的数量,N 为观测数”(来源)。
该比值用于衡量簇的凝聚度。值越高,说明类内距离更小、类间距离更大,簇越紧密、区分越明显。
前提条件
本文假设您对Tableau 有一定了解。如果您完全是初学者,建议先阅读 DataCamp 上以下文章,作为优秀的入门材料。
使用 Tableau 进行数据可视化
Tableau 环境
在本教程中,我们将使用 Tableau Public,这是一款完全免费的 Tableau 产品。从官方网站下载 Tableau Public 版本,按照安装说明进行安装;如果单击 Tableau 图标后出现下图界面,即表示可以开始使用。
连接到数据集
本文将使用名为世界经济指标的数据集。该数据集涵盖了一些推动经济发展的重要指标,如各国的预期寿命、营商便利度、人口等,来源于联合国。可从此处获取。
格式化数据源
进入工作表,查看“度量”和“维度”选项卡。度量选项卡下有许多字段,可以合并到同一类别中。这也有助于更好地呈现所有数据字段。
基于世界经济指标数据创建聚类
聚类有助于挖掘数据集中的模式。假设您是一家旅游公司的分析师。随着全球预期寿命的提高,银发旅游迅速增长。老年人如今更为活跃,也更愿意出行看世界。您的公司希望抓住这一趋势,而您的任务是使用世界指标示例数据,识别出拥有足够目标客户的国家。聚类正是帮助我们识别此类国家的工具。
识别银发旅游成功率高的国家
下面通过各个步骤,在数据上执行聚类分析。
Country。Tableau 将创建一幅地图视图,每个国家用一个实心圆表示。将标记类型更改为 Map,在 Marks 卡中进行操作。确定用于聚类的变量
聚类的下一步是确定将用于聚类算法的变量。在 Tableau 中,变量与字段相当。并不存在能产生理想簇的“唯一最佳变量”组合,您需要尝试多种变量,以观察哪些能得到期望结果。在我们的案例中,使用以下字段:
城镇人口是衡量一国人口密度的良好指标。密度越高,意味着可获得的商业机会越多。
65 岁以上人口代表老年群体,这也是我们的目标细分。
预期寿命较高的国家,意味着人们普遍更长寿,出行意愿可能更强。
该字段目前不存在,可以使用
Tourism Outbound和Population Total字段创建为一个计算字段,公式如下:Tourism Per Capita = SUM([Tourism Outbound])/SUM([Population Total])Tourism Outbound 表示一国居民每年在国际旅行上的花费(以美元计)。为了得到人均值,我们需要用该字段除以各国的人口。
将选定字段添加到视图
在继续之前,需要将默认聚合从
SUM更改为AVERAGE。Tableau 支持对度量或维度进行聚合,但更常见的是对度量进行聚合。每当我们将度量添加到视图中,默认都会对其应用某种聚合。应应用的聚合类型取决于视图的上下文。为所有选定字段更改聚合类型,然后将它们拖到 Marks 卡中的 Detail,如下所示:
聚类
在 Tableau 中,聚类是一个简单的拖放过程。步骤如下:
Analytics窗格,将Cluster拖到视图中,Tableau 会自动对数据进行聚类。至此,我们已根据选定的度量对各国完成聚类。但如何解读这些结果,并据此做出业务决策呢?下一节将解答这些问题。
描述聚类
在 Marks 卡中单击“Clusters”字段,然后单击“Describe Clusters”(描述聚类)。
这会显示一个包含聚类详细描述的文档。该文档包含两个选项卡:
摘要
提供结果概要,并给出每个簇中各变量的平均值。
从上述结果可以推断,簇 3 具备:
这意味着其拥有更富裕的城市人口和更长的预期寿命,因此看起来是银发旅游行业的优质市场。让我们看看该簇包含哪些国家。
模型
“模型”选项卡显示了所有变量/字段平均值的多种统计量及其统计显著性。
因此,作为分析师,您可以将这份名单提交给销售团队,以便他们重点关注这些潜在客户。聚类为我们提供了宝贵洞见。接下来,您可以尝试不同的字段,设置人口或收入阈值等。聚类数据的方法很多,但基本原理不变。
结论
本文介绍了如何在 Tableau 中通过简单的拖放机制,对给定数据集进行聚类分析。聚类是一种有价值的工具,与 Tableau 结合使用,能够让分析师掌握强大的统计分析方法。访问我们的 Tableau 专区,获取掌握 Tableau 所需的一切资源。
参考资料
Tableau 文档