

k-Means 聚类概览
聚类模型旨在将数据分成彼此独立的“簇”或组。这既可以单独用于分析,也可以作为监督学习算法中的特征。
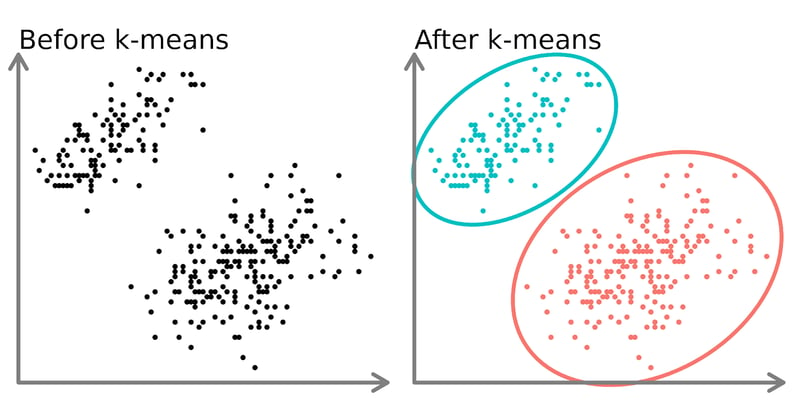
在上图左侧,我们可以看到 2 组不同的未标注点,并按相似数据点进行了着色。对该数据拟合 k-means 模型(右侧)可以揭示 2 个明确的组(通过不同的圆圈与颜色表示)。
在二维空间中,人类可以轻松分开这些簇;但在更高维度下,您就需要借助模型了。
k-means 算法
想象您要做几份水果沙拉,每份由相似的水果组成。
- 您先决定要做几份水果沙拉(k)。例如,决定做 3 份。
- 您随机从桌上选 3 个水果,作为每份沙拉的初始“代表”。
- 接着,您将每个水果分配给与其最相似的那份沙拉的代表。例如,苹果和梨分在一起,橙子和橘子分在一起,香蕉和大蕉分在一起。
- 当所有水果都分配完毕后,您通过计算每组水果特征(如大小、颜色、口味)的平均值来找到每份沙拉的新“中心”。这些新中心成为更新后的代表。
- 重复步骤 3 和 4,多次将水果分配给最相似的代表,并每次更新代表,直到分组不再变化。
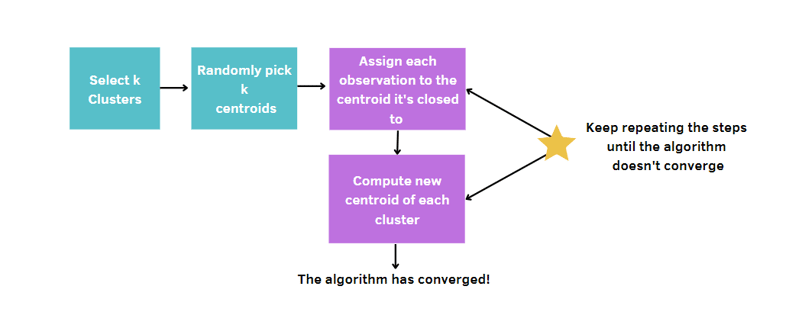
更一般地,流程为:
- 选择簇的数量 k。
- 随机选择 k 个点(大小为 1 的簇)。
- 计算每个点到各质心的距离,并将数据点分配到最近的簇。
- 为每个簇计算质心(均值位置)。
- 不断重复步骤 3–4,直到簇不再变化或达到最大迭代次数。
由于 k-means 会随机选择簇中心,该算法需要运行若干次,次数由用户设定。通过这种方式,可以通过最小化模型质量度量来找到最优解。该度量称为簇内离差平方和(WCSS),即每个簇中数据点与其对应质心之间距离的总和。确实,模型质量度量越小,越能找到更优的模型。
Airbnb 房源数据集
本教程的所有内容都围绕开普敦的Airbnb 租赁房源展开,数据可在 DataLab 获取。该数据包含多种信息,如房东、价格、评论数量、坐标等。
即使该数据集看似涵盖了度假租赁的丰富信息,仍有一些明确的问题有待解答。比如,假设 Airbnb 要求其数据科学家研究其在开普敦平台上的房源细分情况。
每座城市都彼此不同,且因当地文化而有不同需求。识别该城市中的聚类有助于提取新的洞见,从而通过合适的客户忠诚策略提升现有客户满意度,避免客户流失。同时,用恰当的促销活动吸引新用户也同样关键。
可视化 Airbnb 数据
在应用 k-means 之前,我们希望通过查看相关矩阵来进一步研究变量之间的关系。为便于展示,我们将数值保留两位小数。
library(dplyr)
airbnb |>
select(price, minimum_nights, number_of_reviews) |>
cor(use = "pairwise.complete.obs") |>
round(2)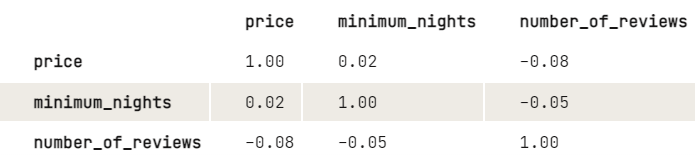
从输出结果看,价格与评论数量之间似乎存在轻微的负相关关系:价格越高,评论数量越少。最少入住晚数与评论数量之间也是如此。由于最少入住晚数对价格影响不大,我们希望进一步考察价格与评论数量的关系:
library(ggplot2)
ggplot(data, aes(number_of_reviews, price, color = room_type, shape = room_type)) +
geom_point(alpha = 0.25) +
xlab("Number of reviews") +
ylab("Price")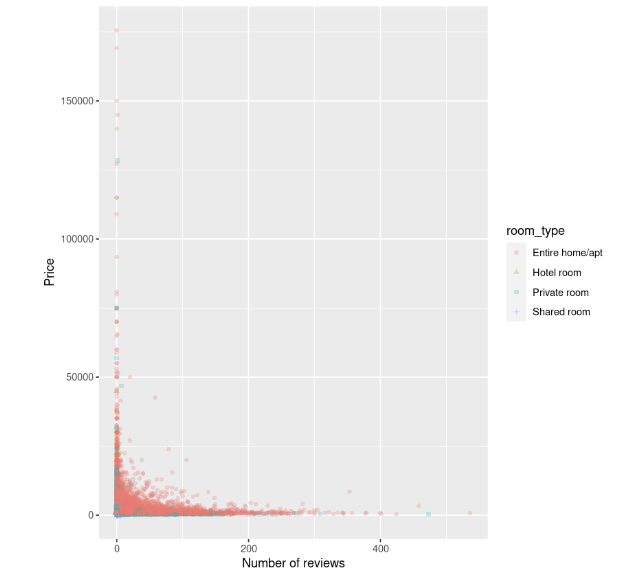
散点图显示,住宿成本(尤其是整套房源)在评论数量较少时更高,且随着评论数量的增加似乎在下降。
归一化
在拟合模型之前,还有一步需要完成。k-means 对单位不一致的变量较为敏感,可能导致误导性结果。本例中,评论数量通常为数十或数百,而价格则为数万。如果不进行任何数据处理,价格的差异看起来会大于评论数量的差异,但我们希望这些变量被同等对待。
为避免该问题,需要将变量转换到相似的尺度。这样一来,就可以用距离度量进行正确比较。
有多种方法可以解决该问题。最常见的是标准化:先用特征值减去其平均值,再除以标准差。该技术可使特征具有均值为 0、标准差为 1。
您可以使用 scale() 函数对变量进行缩放。由于其返回矩阵,采用 base R 风格编写代码会比 tidyverse 风格更简洁。
airbnb[, c("price", "number_of_reviews")] = scale(airbnb[, c("price", "number_of_reviews")])拟合与评估模型
我们终于可以用 k-means 来识别房源的聚类了。作为开始,我们尝试将簇数设为 3,并将 nstart 设为 20。这个参数用于以 20 组不同的随机初始分配来运行 k-means,随后 R 会自动选择簇内离差平方和总和最优的结果。我们还设置随机种子,以便每次运行代码都能复现相同结果。
# Get the two columns of interest
airbnb_2cols <- data[, c("price", "number_of_reviews")]
set.seed(123)
km.out <- kmeans(airbnb_2cols, centers = 3, nstart = 20)
km.out输出:
K-means clustering with 3 clusters of sizes 785, 37, 16069
Cluster means:
price number_of_reviews
1 14264.102 5.9401274
2 83051.541 0.6756757
3 1589.879 18.2649200
Clustering vector:
[1] 3 3 3 3 3 3 3 3 1 3 3 3 3 3 3 3 3 1 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3
[37] 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3
[73] 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3
[109] 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 1 3 3 3 3 3 3 3 3 3 3 3 3 3
[145] 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 1 1 3 3
...
[16777] 3 3 3 3 3 3 3 3 3 3 1 3 3 1 3 1 3 3 3 3 3 1 3 3 3 3 3 3 3 3 1 3 3 3 3 3
[16813] 3 1 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 1 3
[16849] 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 1 3 3 3 3 3 3 3 3 3 3 3
[16885] 3 3 3 3 3 3 3
Within cluster sum of squares by cluster:
[1] 41529148852 49002793251 33286433394
(between_SS / total_SS = 74.5 %)
Available components:
[1] "cluster" "centers" "totss" "withinss" "tot.withinss"
[6] "betweenss" "size" "iter" "ifault"从输出可以看到,找到了 3 个不同簇,大小分别为 785、37 和 16069。对于每个簇,都计算了观测值到质心的平方距离。因此,每条观测都会被分配到这三个簇之一。
尽管结果看起来不错,但寻找最佳模型的方式是尝试不同簇数的模型。也就是说,从单个簇的模型开始,再尝试两个簇,以此类推。整个过程需要用图形化方式跟踪,这种图称为碎石图(scree plot),在该图中,x 轴为簇的数量,y 轴为 WCSS。
在本案例中,我们构建 10 个 k-means 模型,每个模型的簇数不同,最多为 10 个簇。此外,我们只使用数据集的一部分,即仅包含价格和评论数量。为了绘制碎石图,我们需要将所有模型的簇内离差平方和总和保存到变量 wss 中。
# Decide how many clusters to look at
n_clusters <- 10
# Initialize total within sum of squares error: wss
wss <- numeric(n_clusters)
set.seed(123)
# Look over 1 to n possible clusters
for (i in 1:n) {
# Fit the model: km.out
km.out <- kmeans(airbnb_2cols, centers = i, nstart = 20)
# Save the within cluster sum of squares
wss[i] <- km.out$tot.withinss
}
# Produce a scree plot
wss_df <- tibble(clusters = 1:n, wss = wss)
scree_plot <- ggplot(wss_df, aes(x = clusters, y = wss, group = 1)) +
geom_point(size = 4)+
geom_line() +
scale_x_continuous(breaks = c(2, 4, 6, 8, 10)) +
xlab('Number of clusters')
scree_plot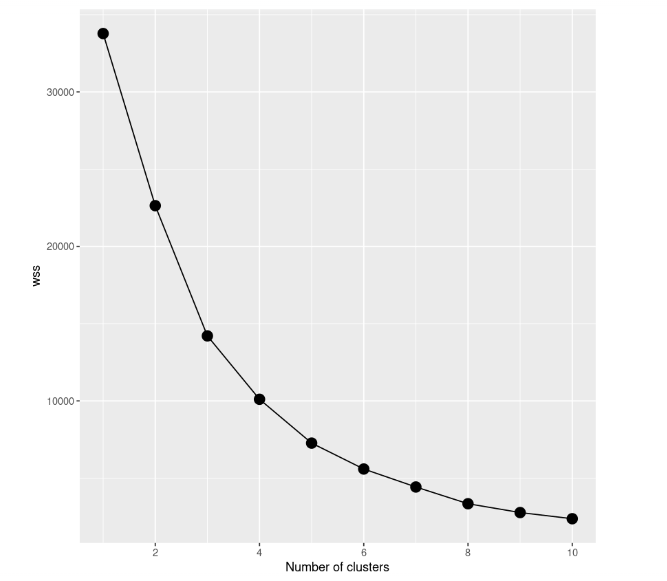
从碎石图可见,随着簇数量的增加,簇内离差平方和总和在下降。选择簇数量的准则是寻找一个“肘部”,即当再增加一个簇后,WCSS 的下降幅度明显减缓的那个点。本例中拐点不太明显,因此我们将添加水平线以帮助判断:
scree_plot +
geom_hline(
yintercept = wss,
linetype = 'dashed',
col = c(rep('#000000',4),'#FF0000', rep('#000000', 5))
)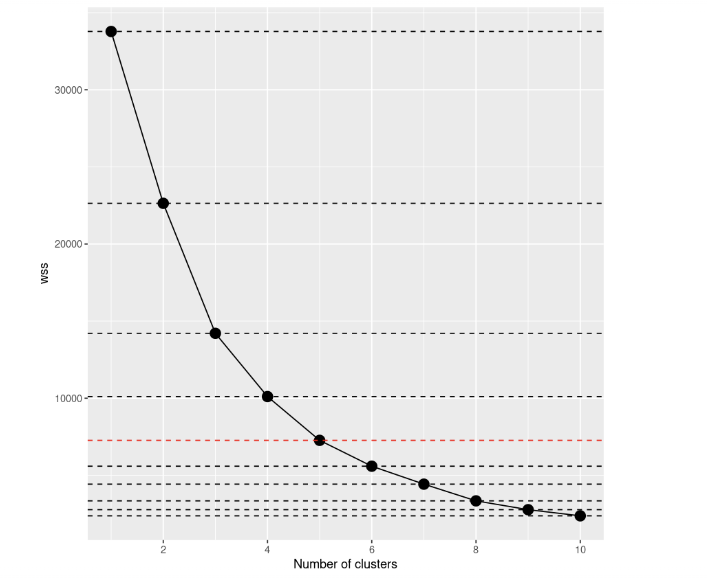
再看一眼,是否比之前清晰多了?从该可视化中,我们可以认为最佳选择是将簇数设置为 5。超过 k=5 后,模型改进幅度明显变小。
# Select number of clusters
k <- 5
set.seed(123)
# Build model with k clusters: km.out
km.out <- kmeans(airbnb_2cols, centers = k, nstart = 20)我们可以再次可视化价格与评论数量之间的散点图,并按簇 ID 对点着色:
data$cluster_id <- factor(km.out$cluster)
ggplot(data, aes(number_of_reviews, price, color = cluster_id)) +
geom_point(alpha = 0.25) +
xlab("Number of reviews") +
ylab("Price")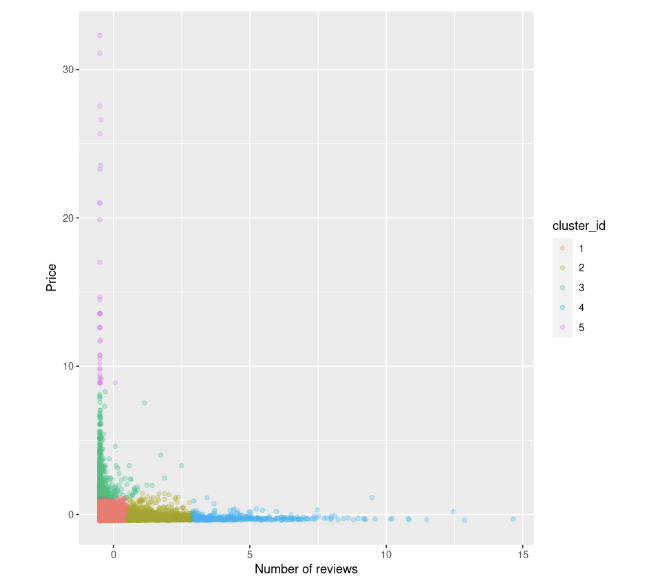
我们可以观察到:
- 有少量房源价格很高、评论很少,以绿色和紫红色标记
- 还有一组数据点价格和评论都较低,以红色标记
- 随后,随着评论数量增加,价格似乎趋于稳定。
k-means 何时会失效?
需要注意的是,k-means 简单易用,但并非总是细分数据的最佳选择,它也可能失效。该算法假设簇是球形的,因此在此类情形下表现良好;而对于大小与密度差异较大的分组,则往往难以很好地捕捉。
在不满足这些条件时,更适合考虑其他方法,如 DBSCAN 与 BIRCH。若您想深入了解聚类方法,Clustering in Machine Learning: 5 Essential Clustering Algorithms 提供了很好的综述。
更进一步
总的来说,k-means 依然是用于识别不同子群体的最常用聚类算法之一,尽管并非在所有场景都完美。现在,您已经掌握了在 R 中将其应用于其他案例的知识。
如果您想更深入地学习该方法,请查看课程Unsupervised Learning in R。另有Cluster Analysis in R 与 An Introduction to Hierarchical Clustering in Python,可帮助您全面了解现有聚类方法;当 k-means 无法从数据中提供有意义洞见时,它们会很有用。如果您还想在 R 中探索监督学习模型,推荐这门课程!

数据科学家 - CRIF
K-means 是一种常用的无监督机器学习技术,可用于识别数据中的聚类(相似数据点的分组)。在本教程中,您将学习如何在 R 中结合 tidymodels、ggplot2 和 ggmap 进行 k-means 聚类。我们将介绍:
在深入学习之前,建议您先复习一下R 编程基础,例如向量与数据框。如果您已经准备就绪,也可以直接跳过,开始我们的旅程!