要有效且正确地管理数据库,必须理解数据模型的基础知识。
在数据库管理系统(DBMS)中,数据模型就像是架构蓝图,定义了信息如何存储、关联与访问。
它们充当业务需求(“我们需要跟踪客户、订单和产品”)与技术实现(“我们将把这些存入由外键连接的四张表”)之间的翻译层。
良好设计的数据模型有助于:
- 定义系统范围
- 明确保持数据有效的规则
- 确保长期可扩展性
- 提升性能
在本指南中,我们将结合一个 PostgreSQL 电商数据集,探讨经典与现代数据模型、抽象层级、设计流程以及高级优化策略。
为何数据模型至关重要
以下是您需要了解数据模型及其重要性的几个简要理由。
- 团队桥梁:业务分析师与开发者基于同一逻辑结构协作。
- 数据完整性:约束可防止无效、不完整或重复数据。
- 性能:良好建模的数据库支持快速查询与连接。
- 可扩展性:可预见未来增长与新需求。
- 一致性:确保系统各处对数据含义的理解一致。
DBMS 中的数据模型是什么?
在数据库管理系统(DBMS)中,数据模型是数据库用于定义数据如何组织、存储与访问的蓝图。
数据模型提供一种结构化方式来表示数据元素及其关系,从而实现高效的数据管理与操作。
拥有数据模型有助于回答如下问题:
- “我们拥有哪些类型的数据?”
- “一种数据与另一种数据如何关联?”
- “这些数据必须遵循哪些规则?”
数据模型可让数据库管理员轻松理解所有必要信息并获得这些问题的答案。
数据模型的用途
数据模型用于在数据库中构建和组织信息。这确保了系统内数据处理的清晰与一致。
以下是通常需要数据模型的一些原因:
- 结构:以逻辑方式组织信息。
- 关系:映射数据元素如何交互。
- 约束:维护数据完整性并强制执行业务逻辑。
- 抽象:让用户无需关心数据物理存储方式。
重要性
如果没有明确的数据模型,您可能会面临:
- 相同数据以不同格式被重复存储。
- 孤儿记录没有有效的父实体。
- 对同一数据的解读不一致。
- 由于结构未优化而导致查询性能差。
下面是一条简单的 SQL 语句,展示了如何通过结构、关系和约束来改造数据库。
ALTER TABLE Orders
ADD CONSTRAINT fk_customer
FOREIGN KEY (CustomerID)
REFERENCES Customer(CustomerID);技术支持
这强制每个订单都必须关联到一个已存在的客户,这是维护完整性的一种简单而有效的方式。
使用 PostgreSQL 搭建示例数据集
在继续深入讲解前,我们先创建并使用一个简单的电商数据集,贯穿本指南演示相关概念。
我们将在数据集中包含以下实体。
- Customer:存储买家信息。
- Product:存储可销售的商品。
- Orders:记录每笔购买交易。
- OrderItems:存储每个订单所包含的产品明细。
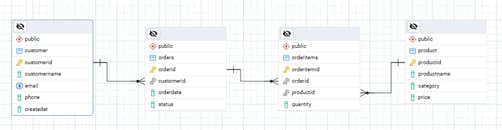
下面是一个简单的 ASCII ER 图,展示我们将创建的表之间的关系。
Customer ───< Orders ───< OrderItems >─── Product技术支持
其逻辑对应如下:
- 一个客户 → 多个订单。
- 一个订单 → 多个订单项。
- 一个产品 → 可出现在多个订单中。
创建表结构
接下来,我将创建这些表,并在 PostgreSQL 中运行以执行查询。
以下是用于创建所需表的模式和 SQL 代码。
CREATE TABLE Customer (
    CustomerID SERIAL PRIMARY KEY,
    CustomerName VARCHAR(100) NOT NULL,
    Email VARCHAR(100) UNIQUE NOT NULL,
    Phone VARCHAR(20),
    CreatedAt TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE TABLE Product (
    ProductID SERIAL PRIMARY KEY,
    ProductName VARCHAR(100) NOT NULL,
    Category VARCHAR(50),
    Price NUMERIC(10, 2) NOT NULL
);

CREATE TABLE Orders (
    OrderID SERIAL PRIMARY KEY,
    CustomerID INT NOT NULL,
    OrderDate DATE NOT NULL,
    Status VARCHAR(20) DEFAULT 'Pending',
    FOREIGN KEY (CustomerID) REFERENCES Customer(CustomerID)
);

CREATE TABLE OrderItems (
    OrderItemID SERIAL PRIMARY KEY,
    OrderID INT NOT NULL,
    ProductID INT NOT NULL,
    Quantity INT NOT NULL CHECK (Quantity > 0),
    FOREIGN KEY (OrderID) REFERENCES Orders(OrderID),
    FOREIGN KEY (ProductID) REFERENCES Product(ProductID)
);技术支持
插入示例数据
接下来,让我们插入一些基础信息到
INSERT INTO Customer (CustomerName, Email, Phone)
VALUES
('Alice Brown’, 'alice@example.com', '91234567'),
('Bob McKee', 'bob@example.com', '98765432');

INSERT INTO Product (ProductName, Category, Price)
VALUES
('Laptop', 'Electronics', 1200.00),
('Wireless Mouse', 'Electronics', 25.50),
('Office Chair', 'Furniture', 150.00);

INSERT INTO Orders (CustomerID, OrderDate, Status)
VALUES
(1, '2025-08-01', 'Shipped'),
(2, '2025-08-02', 'Pending');

INSERT INTO OrderItems (OrderID, ProductID, Quantity)
VALUES
(1, 1, 1),
(1, 2, 2),
(2, 3, 1);技术支持
您的数据库 ER 图应如下所示:
DBMS 数据模型的关键组成部分
一个健壮的数据模型由四个主要部分组成:
1. 实体(Entities)
在数据建模中,实体表示系统内我们希望存储数据的核心、独立对象或概念。实体通常在数据库中以表的形式表示。
我们数据集中的实体示例:
CustomerProductOrdersOrderItems
这些实体构成数据库的核心“名词”。
实体是基础。模型中的其他方面,如属性、关系与约束,皆以其为依托。
2. 属性(Attributes)
在数据建模中,属性是描述实体的特征或性质。它们代表定义实体的具体数据点,如客户的姓名、邮箱或地址。
示例:
- 对于
Customer:CustomerName、Email、Phone。
- 对于
Product:ProductName、Price、Category。
简单来说,属性就是您对每个实体所关心的细节。它们通常对应表中的列。
3. 关系(Relationships)
数据模型中的关系定义不同实体或表如何连接,表示它们之间的关联。可将其视为实体之间的逻辑连接。
我们数据集中的示例:
- 一个
Customer 可以有多个 Orders(一对多)。
- 一个
Order 可通过 OrderItems 包含多个 Products(多对多通过中间表解决)。
关系确保数据模型能准确反映现实世界中的关联。
4. 约束(Constraints)
在数据建模中,约束是限制数据库允许取值的规则,以确保数据的准确性、一致性与完整性。
约束有助于维护数据库的完整性,防止录入无效或不一致的数据。
示例:
Customer.Email 上的 UNIQUE 约束。OrderItems 中确保 Quantity > 0 的 CHECK 约束。
PostgreSQL 示例
以下是一个在 SQL 查询中使用多种约束的示例。
CREATE TABLE OrderItems_Constraint (
    OrderItemID SERIAL PRIMARY KEY,
    OrderID INT NOT NULL,
    ProductID INT NOT NULL,
    Quantity INT NOT NULL CHECK (Quantity > 0),
    FOREIGN KEY (OrderID) REFERENCES Orders(OrderID),
    FOREIGN KEY (ProductID) REFERENCES Product(ProductID)
);技术支持
在此示例中,我们使用了 PRIMARY、CHECK、NOT NULL 和 REFERENCES 约束。
DBMS 中的数据模型类型
数据库中存在不同类型的数据模型。这反映了根据数据性质而采用的不同存储方式。
经典模型
首先,让我们看看数据库管理系统中常见的一些经典模型。
层次模型
层次数据模型以树形结构组织数据,其中每条记录(节点)有一个父节点(根节点除外),并可拥有多个子节点。
- 结构:数据以树形存储;一个父节点可有多个子节点,但每个子节点仅有一个父节点。
- 使用场景:传统银行、航空订座系统。
- 优点:一对多查询非常快。
- 缺点:难以处理多对多关系。
示例(类 XML 表示):
<Customer id="1">
    <Name>Alice Brown</Name>
    <Orders>
        <Order id="1" date="2025-08-01"/>
    </Orders>
</Customer>技术支持
现代等价形式常见于 XML/JSON 存储,但该模型本身可追溯到早期大型机 DBMS,如 IMS。
网络模型
网络数据模型是一种灵活的方式来表示数据及其关系,特别适用于复杂的多对多连接。
它使用图结构,以节点(表示实体)与边(表示关系)来组织数据,相比层次模型提供更高效、直接的访问路径。
- 结构:通过指针连接记录的图。
- 优点:可处理复杂的多对多关系。
- 缺点:查询与维护复杂。
关系模型
关系数据模型通过将数据结构化为行与列的表,实现信息的高效存储、检索与管理。
- 结构:数据以表、行与列形式组织。
- 优点:支持 SQL、符合 ACID、可规范化。
- 缺点:在大规模下连接操作可能开销较高。
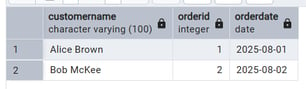
来自我们数据集的示例查询:
SELECT c.CustomerName, o.OrderID, o.OrderDate
FROM Customer c
JOIN Orders o ON c.CustomerID = o.CustomerID;技术支持
该查询演示了使用 JOIN 将 Customer 表与 Orders 表建立关系。
其结果将生成如下表格:
现代模型
随着数据库技术发展,也出现了一些现代模型。示例如下:
面向对象模型
面向对象模型将数据库与面向对象编程概念结合,支持继承与封装。
对象-关系模型
对象-关系模型是关系与面向对象的混合体。
NoSQL 模型
NoSQL 数据模型不同于传统关系型数据库严格的表结构,提供灵活的模式与多样化的数据组织方式,以处理大量非结构化与半结构化数据。
以下是一些 NoSQL 模型示例:
- 键值存储:Redis(快速查找)。
- 文档型:MongoDB(灵活的 JSON)。
- 列族型:Cassandra(宽列存储)。
- 图数据库:Neo4j(关系密集型数据)。
以下是文档数据模型的示例(MongoDB 文档):
{
    "CustomerName": "Alice Brown",
    "Orders": [
        {"ProductName": "Laptop", "Quantity": 1}
    ]
}技术支持
数据建模的抽象层级
数据建模过程分为三个层级——概念、逻辑与物理。
这些层级是设计数据库或信息系统时采用的不同细节阶段,帮助通过聚焦特定数据及其结构方面来管理复杂性。
概念层
概念数据模型是数据建模过程中最高层级、与技术无关的抽象。它关注定义系统中的关键实体及其关系,而不涉及技术细节。
此层级承载业务需求与关系。
示例:我们的 ER 图展示 Customer → Orders。
逻辑层
逻辑数据模型是第二层抽象。它在不提及任何具体数据库的情况下,勾勒实体、属性与关系。
该层将概念模型转换为与 DBMS 相关的模式。它定义表、键与关系,但不涉及存储细节。
物理层
物理数据模型层通过索引、分区与存储参数来实现模式。
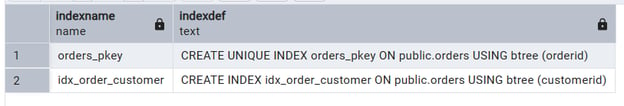
以下是一个索引示例:
CREATE INDEX idx_order_customer ON Orders(CustomerID);技术支持
现在我们通过以下查询查看该索引:
SELECT indexname, indexdef
FROM pg_indexes
WHERE tablename = 'orders';技术支持
如下方索引所示,我们创建了一个名为 idx_order_customer 的新索引。
数据建模流程
数据建模是一种结构化方法,用于将业务需求转化为技术蓝图,以规定数据如何存储、关联与检索。
若设计得当,数据建模可减少冗余、提升数据质量,并简化后续维护。
来源:数据质量维度速查表
该过程通常分阶段推进。让我们逐一拆解。
1. 需求收集
需求收集是整个数据建模过程的基石。在此阶段,您需要理解业务需求是什么以及其原因。
有多种有效收集需求的方式。
- 利益相关者访谈可让您直接与将使用或依赖数据库的人沟通,如业务分析师、经理或开发者。
- 文档审阅有助于通过查看过往报告、流程或遗留数据库模式来了解现有系统。
- 研讨会可将不同部门聚集在一起统一数据定义并识别缺口。
此阶段的输出应为一套清晰的已记录需求,描述数据实体、关系与业务规则。
例如,在我们的零售示例数据集中,相关方可能希望跟踪客户订单、产品与订单日期,以便计算每个产品品类的总销售额与复购率等指标。
2. 概念设计
概念设计将这些业务需求转化为数据的可视化、高层表达。
此阶段关注存在哪些实体以及它们如何关联,而不必考虑诸如主键类型或索引策略等技术细节。
这正是实体-关系(ER)图的用武之地。ER 图展示实体(如 Customer、Product、Order)、其属性以及它们之间的关系。
对于我们的数据集:
Customer 可能包含 CustomerID、Name、Email。Product 可能包含 ProductID、Name、Category。Order 可能包含 OrderID、OrderDate。OrderItem 可能包含 OrderItemID、OrderID、ProductID、Quantity、Price。
关系可能为:
- 一个客户可以下多个订单。
- 一个订单可包含多个订单项。
- 一个产品可出现在多个订单项中。
该图成为业务与技术团队的共同参考点。
3. 逻辑设计
逻辑设计在概念模型基础上应用数据库规则,特别是规范化。
规范化是对关系数据库进行结构化以最小化冗余与依赖的过程。通常分阶段进行(1NF、2NF、3NF),每个阶段都有特定要求。
- 在1NF 中,需确保所有字段都是原子性的(单列不含多值),且不存在重复组。
- 2NF 去除部分依赖——即若存在复合键,所有非键属性必须依赖于整个键。
- 3NF 去除传递依赖,确保非键属性只依赖主键,而不依赖其他非键属性。
在我们的示例中,客户邮箱仅应存在于 Customer 表,而不应在 Order 表中重复。类似地,产品品类信息应位于 Product 表,而不应分散在 OrderItem 的多条记录中。
4. 物理设计
物理设计将逻辑模型针对特定数据库系统(如 PostgreSQL 或 MySQL)进行落地。该阶段涉及数据类型、存储优化与性能调优的决策。
索引是这里的关键考量。例如,在 Order 表的 OrderDate 上新增索引,可显著加速按日期过滤的查询。
对于大型数据集,也可应用分区,通过按日期、范围或哈希键拆分数据来提升查询性能。
同时,您还需决定约束(如外键),以在数据库层面强制执行数据完整性。
5. 验证
设计完成后,在上线前必须进行验证。
这包括加载示例数据,最好是能反映预期体量的真实测试数据,并运行模拟真实使用场景的查询。
例如,在我们的零售数据集中,您可以运行按月统计销售总额的查询,并确保结果与业务预期一致。
同时还应测试边界情况,例如当一个订单没有任何订单项会发生什么(如果约束正确,这种情况应不可能发生)。
6. 部署
最后一步是将已验证的设计部署到生产环境。应使用受版本控制的迁移脚本来完成,以便变更可被长期追踪。
部署还包括设置性能与错误监控,并确保模式文档完善,以便未来变更可在不引发混乱的情况下进行。
部署后,通常还会随着新需求的出现定期审视设计。
数据模型的优势
良好设计的数据模型带来多重收益。
- 清晰性:数据模型为业务与技术团队提供通用语言。当大家对“Customer”的含义及其与“Orders”的关系达成共识时,误解会减少,开发更高效。
- 完整性:如外键与唯一索引等约束可确保系统不会录入无效数据。这能保护数据质量并提升报表可靠性。
- 性能:通过索引与优化连接操作,数据模型可显著提升查询速度。这对于处理大型数据集的分析型查询尤为重要。
- 可扩展性:良好的模型更易扩展。若业务后续希望跟踪促销或积分等功能,您可以新增表而不破坏现有流程。
数据模型的劣势
- 复杂性:在大型系统中,数据模型可能非常复杂,包含数百张表与关系。这会令新成员望而生畏,并需要专业技能来驾驭。
- 成本:聘请熟练的数据建模师与采购企业级建模工具可能成本高昂。对小公司而言,这可能是一笔不小的投入。
- 刚性:关系型模式不如 NoSQL 灵活。对模型的变更需要谨慎规划,以避免破坏下游应用与依赖。
- 供应商锁定:过度依赖专有数据库特性(如 Oracle 特定索引或 SQL Server 的高级分区)会使未来迁移代价高且复杂。
高级建模方法论
数据建模在实施上也可以采用更高级的方法。
1. 维度建模
维度建模在数据仓库中很常见,其目标是让分析查询直观且快速。
这通常涉及使用特定的模式:
- 星型模式:一个中心事实表(如
OrderItems)存储度量,多张维度表(如 Customer、Product、Date)存储描述性属性。该结构便于 BI 工具查询。
其外观大致如下:
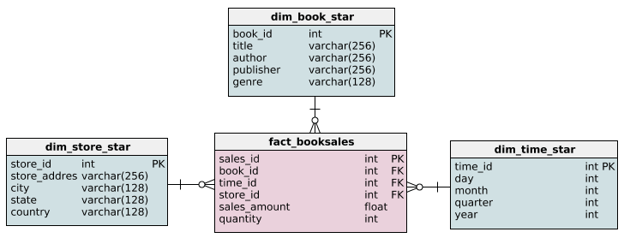
来源:查询星型模式
- 雪花模式:将维度表规范化为子表,减少存储但需要更多连接。例如,可将
Product 拆分为 Product 与 Category 表。
2. 实体-关系(ER)建模
ER 建模更常见于事务型系统。它强调通过规范化来确保数据完整性。在某些情况下,会选择性地进行反规范化以提升读取性能,尤其是针对高频访问数据。
3. 多元(Polyglot)建模
多元建模为不同负载使用不同类型的数据库。
例如,您可以使用 PostgreSQL 处理订单事务,而用 MongoDB 管理具有灵活属性的产品目录。这样可各取所长,但会增加运维复杂度。
性能优化与设计原则
1. 常见反模式
- 过度规范化:将数据拆分到过多小表会导致过多连接,查询变慢。
- 索引不足:未对常用过滤列建立索引,会导致全表扫描与性能问题。
2. NoSQL 考量
在 NoSQL 系统中,设计往往基于访问模式而非严格的规范化。数据组织旨在尽量减少常见操作所需的查询次数,并且分区对于避免瓶颈至关重要。
3. ACID 取舍
PostgreSQL 等关系型系统完全支持ACID 属性,以确保数据一致性。许多 NoSQL 数据库会放宽这些保证以提升速度与可扩展性,换取最终一致性。
结论
数据模型是数据库设计中的关键组成部分,且形式多样。然而,在现代企业中,为确保这些模型发挥最佳性能,必须进行相应优化。
技术不断演进与更新,在数据行业持续学习与适应是必要的。若想进一步了解数据库,请查看我们的数据库设计课程,或SQL 关系型数据库入门课程开始学习。
更喜欢阅读?我们关于数据建模工具或DBMS 面试问题的文章可能会有所帮助。


要有效且正确地管理数据库,必须理解数据模型的基础知识。
在数据库管理系统(DBMS)中,数据模型就像是架构蓝图,定义了信息如何存储、关联与访问。
它们充当业务需求(“我们需要跟踪客户、订单和产品”)与技术实现(“我们将把这些存入由外键连接的四张表”)之间的翻译层。
良好设计的数据模型有助于:
在本指南中,我们将结合一个 PostgreSQL 电商数据集,探讨经典与现代数据模型、抽象层级、设计流程以及高级优化策略。
为何数据模型至关重要
以下是您需要了解数据模型及其重要性的几个简要理由。
DBMS 中的数据模型是什么?
在数据库管理系统(DBMS)中,数据模型是数据库用于定义数据如何组织、存储与访问的蓝图。
数据模型提供一种结构化方式来表示数据元素及其关系,从而实现高效的数据管理与操作。
拥有数据模型有助于回答如下问题:
数据模型可让数据库管理员轻松理解所有必要信息并获得这些问题的答案。
数据模型的用途
数据模型用于在数据库中构建和组织信息。这确保了系统内数据处理的清晰与一致。
以下是通常需要数据模型的一些原因:
重要性
如果没有明确的数据模型,您可能会面临:
下面是一条简单的 SQL 语句,展示了如何通过结构、关系和约束来改造数据库。
这强制每个订单都必须关联到一个已存在的客户,这是维护完整性的一种简单而有效的方式。
使用 PostgreSQL 搭建示例数据集
在继续深入讲解前,我们先创建并使用一个简单的电商数据集,贯穿本指南演示相关概念。
我们将在数据集中包含以下实体。
下面是一个简单的 ASCII ER 图,展示我们将创建的表之间的关系。
其逻辑对应如下:
创建表结构
接下来,我将创建这些表,并在 PostgreSQL 中运行以执行查询。
以下是用于创建所需表的模式和 SQL 代码。
插入示例数据
接下来,让我们插入一些基础信息到
您的数据库 ER 图应如下所示:
DBMS 数据模型的关键组成部分
一个健壮的数据模型由四个主要部分组成:
1. 实体(Entities)
在数据建模中,实体表示系统内我们希望存储数据的核心、独立对象或概念。实体通常在数据库中以表的形式表示。
我们数据集中的实体示例:
CustomerProductOrdersOrderItems这些实体构成数据库的核心“名词”。
实体是基础。模型中的其他方面,如属性、关系与约束,皆以其为依托。
2. 属性(Attributes)
在数据建模中,属性是描述实体的特征或性质。它们代表定义实体的具体数据点,如客户的姓名、邮箱或地址。
示例:
Customer:CustomerName、Email、Phone。Product:ProductName、Price、Category。简单来说,属性就是您对每个实体所关心的细节。它们通常对应表中的列。
3. 关系(Relationships)
数据模型中的关系定义不同实体或表如何连接,表示它们之间的关联。可将其视为实体之间的逻辑连接。
我们数据集中的示例:
Customer可以有多个Orders(一对多)。Order可通过OrderItems包含多个Products(多对多通过中间表解决)。关系确保数据模型能准确反映现实世界中的关联。
4. 约束(Constraints)
在数据建模中,约束是限制数据库允许取值的规则,以确保数据的准确性、一致性与完整性。
约束有助于维护数据库的完整性,防止录入无效或不一致的数据。
示例:
Customer.Email上的UNIQUE约束。OrderItems中确保Quantity > 0的CHECK约束。PostgreSQL 示例
以下是一个在 SQL 查询中使用多种约束的示例。
在此示例中,我们使用了
PRIMARY、CHECK、NOT NULL和REFERENCES约束。DBMS 中的数据模型类型
数据库中存在不同类型的数据模型。这反映了根据数据性质而采用的不同存储方式。
经典模型
首先,让我们看看数据库管理系统中常见的一些经典模型。
层次模型
层次数据模型以树形结构组织数据,其中每条记录(节点)有一个父节点(根节点除外),并可拥有多个子节点。
示例(类 XML 表示):
现代等价形式常见于 XML/JSON 存储,但该模型本身可追溯到早期大型机 DBMS,如 IMS。
网络模型
网络数据模型是一种灵活的方式来表示数据及其关系,特别适用于复杂的多对多连接。
它使用图结构,以节点(表示实体)与边(表示关系)来组织数据,相比层次模型提供更高效、直接的访问路径。
关系模型
关系数据模型通过将数据结构化为行与列的表,实现信息的高效存储、检索与管理。
来自我们数据集的示例查询:
该查询演示了使用
JOIN将Customer表与Orders表建立关系。其结果将生成如下表格:
现代模型
随着数据库技术发展,也出现了一些现代模型。示例如下:
面向对象模型
面向对象模型将数据库与面向对象编程概念结合,支持继承与封装。
对象-关系模型
对象-关系模型是关系与面向对象的混合体。
NoSQL 模型
NoSQL 数据模型不同于传统关系型数据库严格的表结构,提供灵活的模式与多样化的数据组织方式,以处理大量非结构化与半结构化数据。
以下是一些 NoSQL 模型示例:
以下是文档数据模型的示例(MongoDB 文档):
数据建模的抽象层级
数据建模过程分为三个层级——概念、逻辑与物理。
这些层级是设计数据库或信息系统时采用的不同细节阶段,帮助通过聚焦特定数据及其结构方面来管理复杂性。
概念层
概念数据模型是数据建模过程中最高层级、与技术无关的抽象。它关注定义系统中的关键实体及其关系,而不涉及技术细节。
此层级承载业务需求与关系。
示例:我们的 ER 图展示
Customer→Orders。逻辑层
逻辑数据模型是第二层抽象。它在不提及任何具体数据库的情况下,勾勒实体、属性与关系。
该层将概念模型转换为与 DBMS 相关的模式。它定义表、键与关系,但不涉及存储细节。
物理层
物理数据模型层通过索引、分区与存储参数来实现模式。
以下是一个索引示例:
现在我们通过以下查询查看该索引:
如下方索引所示,我们创建了一个名为
idx_order_customer的新索引。数据建模流程
数据建模是一种结构化方法,用于将业务需求转化为技术蓝图,以规定数据如何存储、关联与检索。
若设计得当,数据建模可减少冗余、提升数据质量,并简化后续维护。
来源:数据质量维度速查表
该过程通常分阶段推进。让我们逐一拆解。
1. 需求收集
需求收集是整个数据建模过程的基石。在此阶段,您需要理解业务需求是什么以及其原因。
有多种有效收集需求的方式。
此阶段的输出应为一套清晰的已记录需求,描述数据实体、关系与业务规则。
例如,在我们的零售示例数据集中,相关方可能希望跟踪客户订单、产品与订单日期,以便计算每个产品品类的总销售额与复购率等指标。
2. 概念设计
概念设计将这些业务需求转化为数据的可视化、高层表达。
此阶段关注存在哪些实体以及它们如何关联,而不必考虑诸如主键类型或索引策略等技术细节。
这正是实体-关系(ER)图的用武之地。ER 图展示实体(如 Customer、Product、Order)、其属性以及它们之间的关系。
对于我们的数据集:
Customer可能包含 CustomerID、Name、Email。Product可能包含 ProductID、Name、Category。Order可能包含 OrderID、OrderDate。OrderItem可能包含 OrderItemID、OrderID、ProductID、Quantity、Price。关系可能为:
该图成为业务与技术团队的共同参考点。
3. 逻辑设计
逻辑设计在概念模型基础上应用数据库规则,特别是规范化。
规范化是对关系数据库进行结构化以最小化冗余与依赖的过程。通常分阶段进行(1NF、2NF、3NF),每个阶段都有特定要求。
在我们的示例中,客户邮箱仅应存在于
Customer表,而不应在Order表中重复。类似地,产品品类信息应位于Product表,而不应分散在OrderItem的多条记录中。4. 物理设计
物理设计将逻辑模型针对特定数据库系统(如 PostgreSQL 或 MySQL)进行落地。该阶段涉及数据类型、存储优化与性能调优的决策。
索引是这里的关键考量。例如,在
Order表的OrderDate上新增索引,可显著加速按日期过滤的查询。对于大型数据集,也可应用分区,通过按日期、范围或哈希键拆分数据来提升查询性能。
同时,您还需决定约束(如外键),以在数据库层面强制执行数据完整性。
5. 验证
设计完成后,在上线前必须进行验证。
这包括加载示例数据,最好是能反映预期体量的真实测试数据,并运行模拟真实使用场景的查询。
例如,在我们的零售数据集中,您可以运行按月统计销售总额的查询,并确保结果与业务预期一致。
同时还应测试边界情况,例如当一个订单没有任何订单项会发生什么(如果约束正确,这种情况应不可能发生)。
6. 部署
最后一步是将已验证的设计部署到生产环境。应使用受版本控制的迁移脚本来完成,以便变更可被长期追踪。
部署还包括设置性能与错误监控,并确保模式文档完善,以便未来变更可在不引发混乱的情况下进行。
部署后,通常还会随着新需求的出现定期审视设计。
数据模型的优势
良好设计的数据模型带来多重收益。
数据模型的劣势
高级建模方法论
数据建模在实施上也可以采用更高级的方法。
1. 维度建模
维度建模在数据仓库中很常见,其目标是让分析查询直观且快速。
这通常涉及使用特定的模式:
OrderItems)存储度量,多张维度表(如Customer、Product、Date)存储描述性属性。该结构便于 BI 工具查询。其外观大致如下:
来源:查询星型模式
Product拆分为Product与Category表。2. 实体-关系(ER)建模
ER 建模更常见于事务型系统。它强调通过规范化来确保数据完整性。在某些情况下,会选择性地进行反规范化以提升读取性能,尤其是针对高频访问数据。
3. 多元(Polyglot)建模
多元建模为不同负载使用不同类型的数据库。
例如,您可以使用 PostgreSQL 处理订单事务,而用 MongoDB 管理具有灵活属性的产品目录。这样可各取所长,但会增加运维复杂度。
性能优化与设计原则
1. 常见反模式
2. NoSQL 考量
在 NoSQL 系统中,设计往往基于访问模式而非严格的规范化。数据组织旨在尽量减少常见操作所需的查询次数,并且分区对于避免瓶颈至关重要。
3. ACID 取舍
PostgreSQL 等关系型系统完全支持ACID 属性,以确保数据一致性。许多 NoSQL 数据库会放宽这些保证以提升速度与可扩展性,换取最终一致性。
结论
数据模型是数据库设计中的关键组成部分,且形式多样。然而,在现代企业中,为确保这些模型发挥最佳性能,必须进行相应优化。
技术不断演进与更新,在数据行业持续学习与适应是必要的。若想进一步了解数据库,请查看我们的数据库设计课程,或SQL 关系型数据库入门课程开始学习。
更喜欢阅读?我们关于数据建模工具或DBMS 面试问题的文章可能会有所帮助。