
लर्निंग पाथ
एसोसिएट डेटा इंजीनियर में SQL
30 घंटा
किसी डेटाबेस का प्रभावी और सही प्रबंधन करने के लिए डेटा मॉडल की बुनियादी समझ आवश्यक है।
डेटाबेस मैनेजमेंट सिस्टम (DBMS) में, डेटा मॉडल ऐसे आर्किटेक्चरल ब्लूप्रिंट होते हैं जो तय करते हैं कि जानकारी कैसे संग्रहीत, संबंधित और एक्सेस की जाती है।
वे व्यवसायिक आवश्यकताओं ("हमें ग्राहकों, ऑर्डर और प्रोडक्ट्स को ट्रैक करना है") और तकनीकी कार्यान्वयन ("हम इसे फॉरेन की से जुड़े चार टेबल में स्टोर करेंगे") के बीच अनुवाद परत का काम करते हैं।
अच्छी तरह डिज़ाइन किया गया डेटा मॉडल मदद करता है:
इस गाइड में, हम पारंपरिक और आधुनिक डेटा मॉडलों, एब्स्ट्रैक्शन स्तरों, डिज़ाइन प्रक्रियाओं, और उन्नत ऑप्टिमाइज़ेशन रणनीतियों का अन्वेषण करेंगे—सभी एक PostgreSQL ई-कॉमर्स डेटासेट के साथ समझाए गए हैं।
यहाँ कुछ त्वरित कारण दिए गए हैं कि आपको डेटा मॉडलों के बारे में क्यों जानना चाहिए और वे क्यों महत्वपूर्ण हैं।
एक डेटा मॉडल डेटाबेस मैनेजमेंट सिस्टम (DBMS) में एक ब्लूप्रिंट है जिसका उपयोग डेटाबेस द्वारा किया जाता है ताकि यह परिभाषित किया जा सके कि डेटा कैसे व्यवस्थित, संग्रहीत और एक्सेस किया जाता है।
डेटा मॉडल डेटा तत्वों और उनके संबंधों का प्रतिनिधित्व करने का एक संरचित तरीका प्रदान करता है, जिससे कुशल डेटा प्रबंधन और हेरफेर संभव होता है।
डेटा मॉडल होने से निम्नलिखित प्रश्नों के उत्तर मिलते हैं:
डेटा मॉडल सभी आवश्यक जानकारी और इन प्रश्नों के उत्तर डेटाबेस प्रशासकों के लिए आसानी से समझने योग्य बना देता है।
डेटा मॉडल डेटाबेस में जानकारी को संरचना और व्यवस्थित करता है। इससे सिस्टम के भीतर डेटा को संभालने में स्पष्टता और स्थिरता रहती है।
यहाँ कुछ सामान्य कारण हैं जिनकी वजह से डेटा मॉडल की आवश्यकता होती है:
परिभाषित डेटा मॉडल के बिना, आपको निम्न जोखिम होते हैं:
यहाँ एक सरल SQL क्वेरी है जो दिखाती है कि स्ट्रक्चर, रिलेशनशिप और constraints जोड़कर डेटाबेस को कैसे संशोधित किया जा सकता है।
ALTER TABLE Orders
ADD CONSTRAINT fk_customer
FOREIGN KEY (CustomerID)
REFERENCES Customer(CustomerID);
यह सुनिश्चित करता है कि हर ऑर्डर किसी मौजूदा कस्टमर से जुड़ा हो—अखंडता बनाए रखने का सरल लेकिन सशक्त तरीका।
आगे की व्याख्याओं से पहले, आइए पूरे गाइड में अवधारणाओं को प्रदर्शित करने के लिए एक सरल ई-कॉमर्स डेटासेट बनाएँ और उपयोग करें।
हम डेटासेट में निम्न एंटिटीज़ शामिल करेंगे।
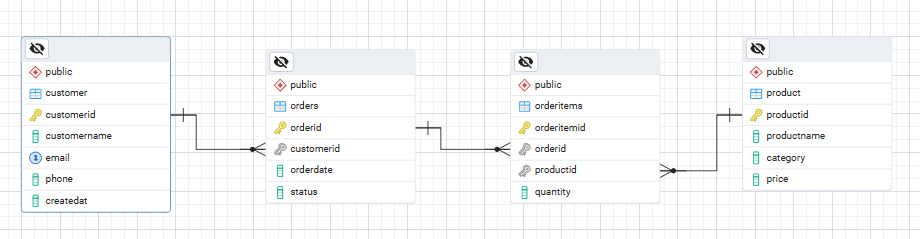
यहाँ एक सरल ASCII ER डायग्राम है जो उन टेबल्स के बीच के संबंधों को दिखाता है जिन्हें हम बनाएँगे।
Customer ───< Orders ───< OrderItems >─── Productयह निम्न लॉजिक से मेल खाता है:
अगले चरण में, मैं टेबल बनाऊँगा और क्वेरी चलाने के लिए उन्हें PostgreSQL में रन करूँगा।
यहाँ आवश्यक टेबल बनाने के लिए स्कीमा और SQL कोड दिया गया है।
CREATE TABLE Customer (
    CustomerID SERIAL PRIMARY KEY,
    CustomerName VARCHAR(100) NOT NULL,
    Email VARCHAR(100) UNIQUE NOT NULL,
    Phone VARCHAR(20),
    CreatedAt TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE TABLE Product (
    ProductID SERIAL PRIMARY KEY,
    ProductName VARCHAR(100) NOT NULL,
    Category VARCHAR(50),
    Price NUMERIC(10, 2) NOT NULL
);

CREATE TABLE Orders (
    OrderID SERIAL PRIMARY KEY,
    CustomerID INT NOT NULL,
    OrderDate DATE NOT NULL,
    Status VARCHAR(20) DEFAULT 'Pending',
    FOREIGN KEY (CustomerID) REFERENCES Customer(CustomerID)
);

CREATE TABLE OrderItems (
    OrderItemID SERIAL PRIMARY KEY,
    OrderID INT NOT NULL,
    ProductID INT NOT NULL,
    Quantity INT NOT NULL CHECK (Quantity > 0),
    FOREIGN KEY (OrderID) REFERENCES Orders(OrderID),
    FOREIGN KEY (ProductID) REFERENCES Product(ProductID)
);अब, कुछ बुनियादी जानकारी डालते हैं
INSERT INTO Customer (CustomerName, Email, Phone)
VALUES
('Alice Brown’, 'alice@example.com', '91234567'),
('Bob McKee', 'bob@example.com', '98765432');

INSERT INTO Product (ProductName, Category, Price)
VALUES
('Laptop', 'Electronics', 1200.00),
('Wireless Mouse', 'Electronics', 25.50),
('Office Chair', 'Furniture', 150.00);

INSERT INTO Orders (CustomerID, OrderDate, Status)
VALUES
(1, '2025-08-01', 'Shipped'),
(2, '2025-08-02', 'Pending');

INSERT INTO OrderItems (OrderID, ProductID, Quantity)
VALUES
(1, 1, 1),
(1, 2, 2),
(2, 3, 1);
आपके डेटाबेस के लिए ER डायग्राम इस तरह दिखना चाहिए:
एक सशक्त डेटा मॉडल चार मुख्य घटकों से मिलकर बना होता है:
डेटा मॉडलिंग में, एंटिटीज़ सिस्टम के भीतर मुख्य, भिन्न-भिन्न ऑब्जेक्ट या अवधारणाएँ होती हैं जिनके बारे में हम डेटा स्टोर करना चाहते हैं। डेटाबेस में एंटिटीज़ अक्सर टेबल के रूप में दर्शाई जाती हैं।
हमारे डेटासेट में एंटिटीज़ के उदाहरण:
CustomerProductOrdersOrderItemsये एंटिटीज़ डेटाबेस के मुख्य "संज्ञा" बन जाती हैं।
एंटिटीज़ नींव होती हैं। मॉडल के अन्य सभी पहलू—जैसे attributes, relationships, और constraints—इन्हीं पर आधारित होते हैं।
डेटा मॉडलिंग में, एट्रिब्यूट्स वे विशेषताएँ या गुण हैं जो किसी एंटिटी का वर्णन करते हैं। ये किसी एंटिटी को परिभाषित करने वाले विशिष्ट डेटा पॉइंट्स का प्रतिनिधित्व करते हैं, जैसे ग्राहक का नाम, ईमेल, या पता।
उदाहरण:
Customer के लिए: CustomerName, Email, Phone।Product के लिए: ProductName, Price, Category।संक्षेप में, एट्रिब्यूट्स वे विवरण हैं जो आप प्रत्येक एंटिटी के लिए मायने रखते हैं। ये आमतौर पर टेबल में कॉलम होते हैं।
डेटा मॉडल में रिलेशनशिप्स बताती हैं कि अलग-अलग एंटिटी या टेबल कैसे जुड़े हैं, यानी उनके बीच के एसोसिएशन का प्रतिनिधित्व करती हैं। इन्हें एंटिटीज़ के बीच लॉजिकल कनेक्शन की तरह समझें।
हमारे डेटासेट में उदाहरण:
Customer के कई Orders हो सकते हैं (1-से-अनेक)।Order में OrderItems के माध्यम से कई Products हो सकते हैं (अनेक-से-अनेक, जंक्शन टेबल के जरिए हल)।रिलेशनशिप्स सुनिश्चित करती हैं कि डेटा मॉडल वास्तविक दुनिया के एसोसिएशन का सटीक प्रतिनिधित्व करे।
डेटा मॉडलिंग में, constraints वे नियम हैं जो डेटाबेस में अनुमत मानों को सीमित करते हैं, जिससे डेटा की शुद्धता, स्थिरता और अखंडता सुनिश्चित होती है।
constraints डेटाबेस की अखंडता बनाए रखने में मदद करते हैं और अमान्य या असंगत डेटा के प्रवेश को रोकते हैं।
उदाहरण:
Customer.Email पर UNIQUE constraint।OrderItems में Quantity > 0 सुनिश्चित करने के लिए CHECK constraint।PostgreSQL उदाहरण
यहाँ SQL क्वेरी में कुछ प्रकार के constraints का उपयोग करने का उदाहरण है।
CREATE TABLE OrderItems_Constraint (
    OrderItemID SERIAL PRIMARY KEY,
    OrderID INT NOT NULL,
    ProductID INT NOT NULL,
    Quantity INT NOT NULL CHECK (Quantity > 0),
    FOREIGN KEY (OrderID) REFERENCES Orders(OrderID),
    FOREIGN KEY (ProductID) REFERENCES Product(ProductID)
);
इस उदाहरण में, हमने PRIMARY, CHECK, NOT NULL, और REFERENCES constraints का उपयोग किया।
डेटाबेस में अलग-अलग प्रकार के डेटा मॉडल होते हैं। यह इस बात को दर्शाता है कि डेटा की प्रकृति के अनुसार डेटा कैसे संग्रहीत होता है।
सबसे पहले, आइए डेटाबेस मैनेजमेंट सिस्टम में उपयोग होने वाले कुछ सामान्य शास्त्रीय मॉडलों को देखें।
हाइरार्किकल डेटा मॉडल डेटा को पेड़-नुमा संरचना में व्यवस्थित करता है, जहाँ प्रत्येक रिकॉर्ड (नोड) का एक ही पैरेंट होता है (रूट को छोड़कर) और कई चिल्ड्रन हो सकते हैं।
उदाहरण (XML-जैसा प्रतिनिधित्व):
<Customer id="1">
    <Name>Alice Brown</Name>
    <Orders>
        <Order id="1" date="2025-08-01"/>
    </Orders>
</Customer>
आधुनिक समकक्ष अक्सर XML/JSON स्टोरेज में दिखते हैं, लेकिन यह मॉडल स्वयं पुराने मेनफ्रेम DBMS जैसे IMS से आता है।
नेटवर्क डेटा मॉडल डेटा और संबंधों का प्रतिनिधित्व करने का एक लचीला तरीका है, जो खासकर जटिल, अनेक-से-अनेक कनेक्शनों के लिए उपयोगी है।
यह नोड्स (एंटिटीज़) और एजेज़ (रिलेशनशिप्स) वाले ग्राफ स्ट्रक्चर का उपयोग करता है ताकि डेटा संगठित किया जा सके, जिससे हाइरार्किकल मॉडलों की तुलना में अधिक कुशल और प्रत्यक्ष एक्सेस पथ मिलते हैं।
रिलेशनल डेटा मॉडल डेटा को तालिकाओं (rows और columns) में संरचित करता है, जिससे जानकारी का कुशल भंडारण, पुनर्प्राप्ति, और प्रबंधन संभव होता है।
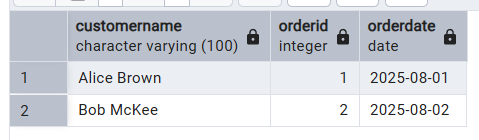
हमारे डेटासेट से उदाहरण क्वेरी:
SELECT c.CustomerName, o.OrderID, o.OrderDate
FROM Customer c
JOIN Orders o ON c.CustomerID = o.CustomerID;
यह क्वेरी JOIN फंक्शन का उपयोग दिखाती है जिससे Customer टेबल और Orders टेबल के बीच संबंध बनाया जाता है।
यह परिणामस्वरूप निम्न तालिका उत्पन्न करता है:
जैसे-जैसे डेटाबेस तकनीक विकसित हुई है, कुछ आधुनिक मॉडल भी सामने आए हैं। यहाँ कुछ उदाहरण हैं:
ऑब्जेक्ट-ओरिएंटेड मॉडल डेटाबेस और ऑब्जेक्ट-ओरिएंटेड प्रोग्रामिंग अवधारणाओं को जोड़ता है। यह इनहेरिटेंस और एन्कैप्सुलेशन का समर्थन करता है।
ऑब्जेक्ट-रिलेशनल मॉडल, रिलेशनल और ऑब्जेक्ट-ओरिएंटेड का हाइब्रिड है।
NoSQL डेटा मॉडल पारंपरिक रिलेशनल डेटाबेस की कठोर, टेबल-आधारित संरचनाओं से अलग होते हैं, और असंरचित तथा अर्ध-संरचित डेटा की बड़ी मात्रा को संभालने के लिए लचीले स्कीमा और विविध डेटा संगठन विधियाँ प्रदान करते हैं।
यहाँ NoSQL मॉडलों के कुछ उदाहरण हैं:
यहाँ एक डॉक्यूमेंट डेटा मॉडल (MongoDB डॉक्यूमेंट) का उदाहरण है:
{
    "CustomerName": "Alice Brown",
    "Orders": [
        {"ProductName": "Laptop", "Quantity": 1}
    ]
}
डेटा मॉडलिंग की प्रक्रिया तीन अलग-अलग स्तरों—कॉन्सेप्चुअल, लॉजिकल और फिजिकल—पर होती है।
ये स्तर, डेटाबेस या सूचना प्रणाली को डिज़ाइन करते समय उपयोग किए जाने वाले विवरण के अलग-अलग चरण हैं। वे डेटा और उसकी संरचना के विशिष्ट पहलुओं पर ध्यान केंद्रित करके जटिलता को प्रबंधित करने में मदद करते हैं।
कॉन्सेप्चुअल डेटा मॉडल, डेटा मॉडलिंग प्रक्रिया में सबसे उच्च-स्तरीय, तकनीक-अज्ञेय एब्स्ट्रैक्शन है। यह सिस्टम में प्रमुख एंटिटीज़ और उनके संबंधों को परिभाषित करने पर केंद्रित होता है, तकनीकी विवरण में गए बिना।
यह लेयर व्यवसायिक आवश्यकताओं और संबंधों को कैप्चर करती है।
उदाहरण: हमारा ER डायग्राम जिसमें Customer → Orders दिखाया गया है।
लॉजिकल डेटा मॉडल दूसरा एब्स्ट्रैक्शन स्तर है। यह एंटिटीज़, एट्रिब्यूट्स, और रिलेशनशिप्स का खाका देता है, बिना किसी विशिष्ट डेटाबेस का उल्लेख किए।
यह लेयर कॉन्सेप्चुअल मॉडल को DBMS-विशिष्ट स्कीमा में बदलती है। इसमें टेबल, कीज़, और रिलेशनशिप्स परिभाषित होते हैं, बिना स्टोरेज विवरण के।
फिजिकल डेटा मॉडल लेयर, इंडेक्स, पार्टिशन और स्टोरेज पैरामीटर्स के साथ स्कीमा को लागू करती है।
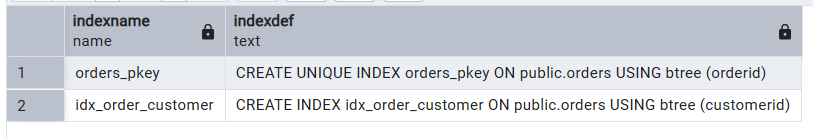
यहाँ एक इंडेक्स का उदाहरण है:
CREATE INDEX idx_order_customer ON Orders(CustomerID);अब इस क्वेरी से हम इस इंडेक्स को देखेंगे:
SELECT indexname, indexdef
FROM pg_indexes
WHERE tablename = 'orders';
जैसा कि नीचे इंडेक्स में दिख रहा है, हमने idx_order_customer नाम से नया इंडेक्स बनाया है।
डेटा मॉडलिंग एक संरचित दृष्टिकोण है जो व्यवसायिक ज़रूरतों को एक तकनीकी ब्लूप्रिंट में अनुवादित करता है, जो तय करता है कि डेटा कैसे संग्रहीत, संबंधित और प्राप्त किया जाएगा।
अच्छे से किए जाने पर, डेटा मॉडलिंग अनावश्यक दोहराव को कम करती है, डेटा गुणवत्ता में सुधार करती है, और भविष्य के रखरखाव को आसान बनाती है।
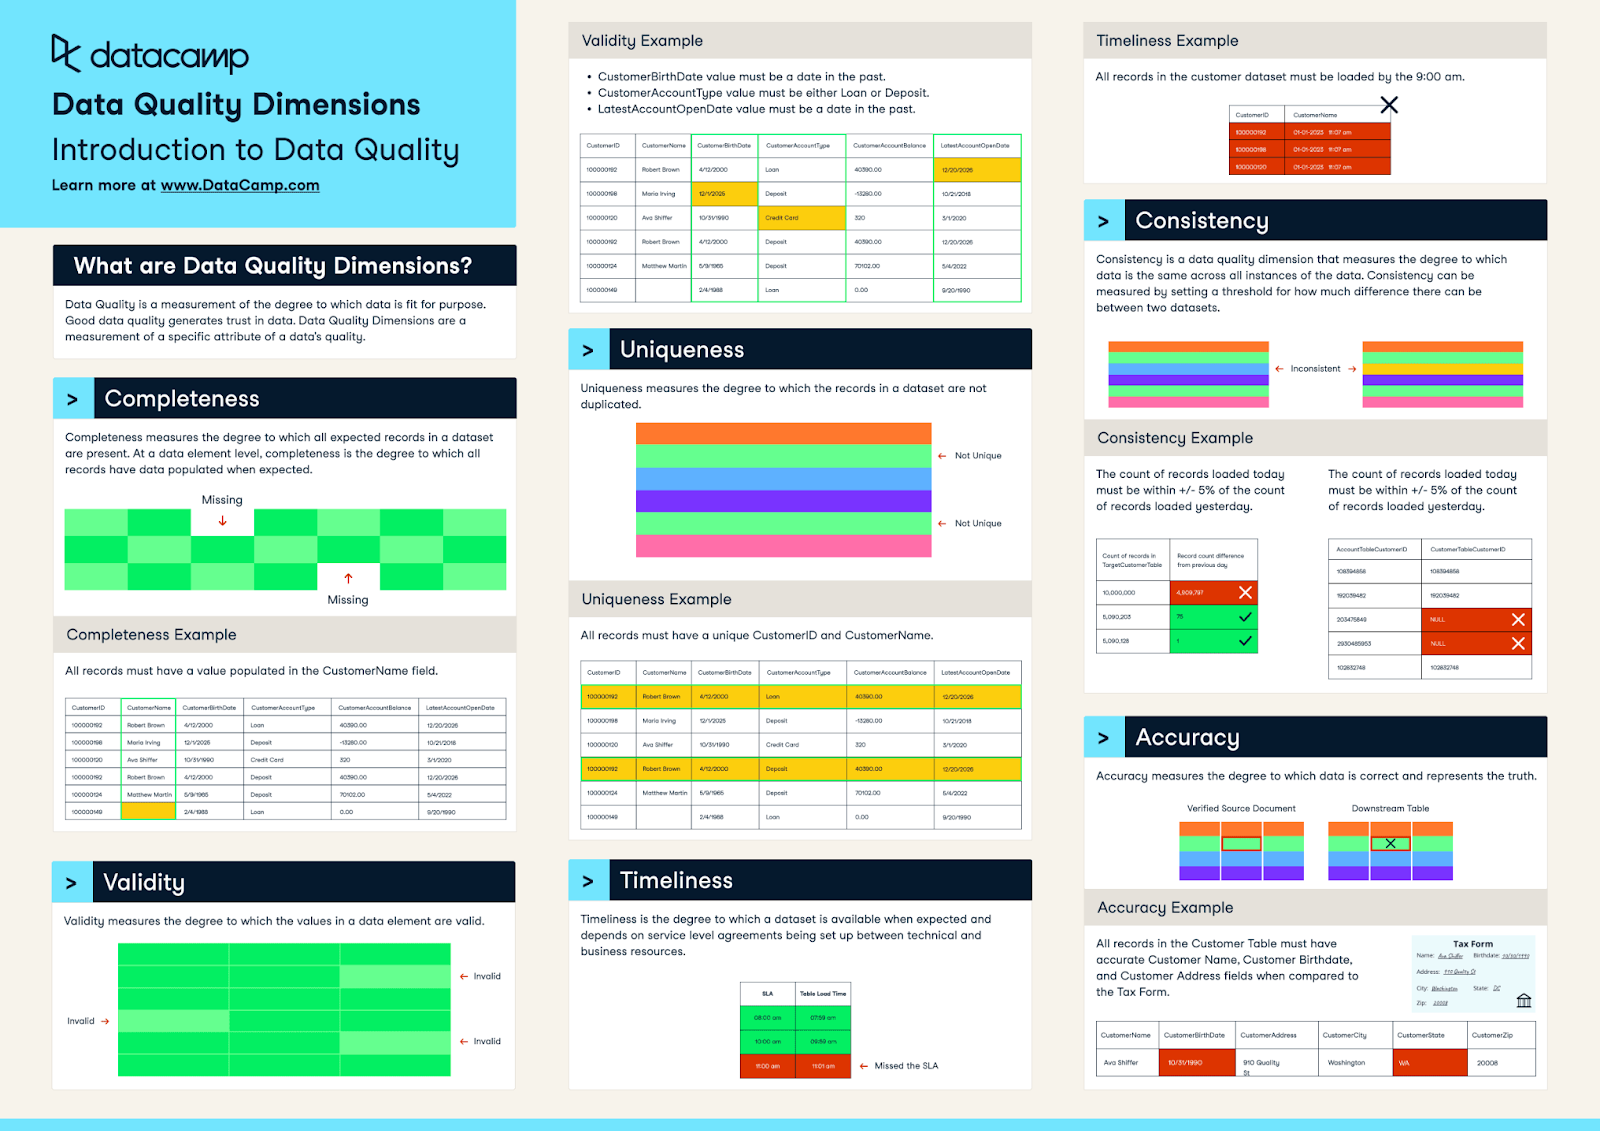
स्रोत: Data Quality Dimensions Cheat Sheet
प्रक्रिया आमतौर पर चरणों में आगे बढ़ती है। आइए इन्हें विभाजित करके देखें।
आवश्यकताओं का संकलन पूरी डेटा मॉडलिंग प्रक्रिया की नींव है। इस चरण में, आप समझने की कोशिश करते हैं कि व्यवसाय की ज़रूरतें क्या हैं और क्यों।
आवश्यकताओं को प्रभावी ढंग से इकट्ठा करने के कई तरीके हैं।
इस चरण का आउटपुट डेटा एंटिटीज़, रिलेशनशिप्स, और व्यवसायिक नियमों का वर्णन करने वाली स्पष्ट, प्रलेखित आवश्यकताओं का सेट होना चाहिए।
उदाहरण के लिए, हमारे नमूना रिटेल डेटासेट में, स्टेकहोल्डर यह कह सकते हैं कि वे ग्राहक ऑर्डर, प्रोडक्ट्स, और ऑर्डर तिथियों को ट्रैक करना चाहते हैं ताकि वे प्रति प्रोडक्ट कैटेगरी कुल बिक्री और रिपीट कस्टमर रेट जैसी मेट्रिक्स की गणना कर सकें।
कॉन्सेप्चुअल डिज़ाइन उन व्यवसायिक आवश्यकताओं को एक दृश्य, उच्च-स्तरीय डेटा प्रतिनिधित्व में बदल देता है।
इस चरण में, आप इस पर ध्यान देते हैं कि कौन-सी एंटिटीज़ मौजूद हैं और वे कैसे संबंधित हैं, तकनीकी विवरण जैसे प्राइमरी की के प्रकार या इंडेक्सिंग रणनीतियों की चिंता किए बिना।
यहीं पर Entity-Relationship (ER) डायग्राम काम आते हैं। ER डायग्राम एंटिटीज़ (जैसे, Customer, Product, Order), उनके एट्रिब्यूट्स, और उनके बीच के रिलेशनशिप्स दिखाते हैं।
हमारे डेटासेट के लिए:
Customer में CustomerID, Name, Email शामिल हो सकते हैं।Product में ProductID, Name, Category शामिल हो सकते हैं।Order में OrderID, OrderDate शामिल हो सकते हैं।OrderItem में OrderItemID, OrderID, ProductID, Quantity, Price शामिल हो सकते हैं।रिलेशनशिप्स हो सकती हैं:
यह डायग्राम व्यवसायिक और तकनीकी टीमों के लिए एक साझा संदर्भ बिंदु बन जाता है।
लॉजिकल डिज़ाइन कॉन्सेप्चुअल मॉडल पर डेटाबेस नियम, विशेषकर normalization, लागू करके आगे बनता है।
Normalization, रिलेशनल डेटाबेस को संरचित करने की प्रक्रिया है ताकि अनावश्यक दोहराव और निर्भरता को कम किया जा सके। यह अक्सर चरणों (1NF, 2NF, 3NF) में किया जाता है, प्रत्येक के विशिष्ट आवश्यकताओं के साथ।
हमारे उदाहरण में, ग्राहक का ईमेल पता केवल Customer टेबल में होना चाहिए, Order टेबल में डुप्लिकेट नहीं। इसी तरह, प्रोडक्ट कैटेगरी की जानकारी Product टेबल में रहनी चाहिए, OrderItem में कई रिकॉर्ड्स में बिखरी नहीं।
फिजिकल डिज़ाइन लॉजिकल मॉडल को किसी विशिष्ट डेटाबेस सिस्टम, जैसे PostgreSQL या MySQL, के लिए अनुकूलित करता है। इस चरण में डेटा टाइप्स, स्टोरेज ऑप्टिमाइज़ेशन, और परफॉर्मेंस ट्यूनिंग के बारे में निर्णय शामिल होते हैं।
यहाँ इंडेक्स प्रमुख विचार है। उदाहरण के लिए, Order टेबल में OrderDate पर इंडेक्स जोड़ने से तारीख के आधार पर फ़िल्टर करने वाली क्वेरियाँ काफी तेज़ हो सकती हैं।
बड़े डेटासेट के लिए पार्टिशनिंग भी लागू की जा सकती है, डेटा को तारीख, रेंज, या हैश कीज़ के आधार पर प्रबंधनीय हिस्सों में बाँटकर क्वेरी प्रदर्शन बेहतर किया जा सकता है।
आप constraints, जैसे फॉरेन की, पर भी निर्णय लेते हैं ताकि डेटाबेस स्तर पर डेटा अखंडता लागू की जा सके।
डिज़ाइन पूरा होने के बाद, लाइव जाने से पहले वैलिडेशन किए जाने चाहिए।
इसमें नमूना डेटा लोड करना शामिल है—आदर्श रूप से ऐसा यथार्थवादी परीक्षण डेटा जो अपेक्षित वॉल्यूम से मेल खाता हो—और ऐसी क्वेरियाँ चलाना जो वास्तविक दुनिया के उपयोग का अनुकरण करें।
उदाहरण के लिए, हमारे रिटेल डेटासेट में, आप प्रति माह बिक्री कुल की गणना करने के लिए क्वेरी चला सकते हैं और सुनिश्चित कर सकते हैं कि संख्या व्यवसाय की अपेक्षाओं से मेल खाती है।
आप एज केस भी टेस्ट करेंगे, जैसे जब बिना आइटम के कोई ऑर्डर प्लेस हो (जो सही constraints होने पर असंभव होना चाहिए)।
अंतिम चरण है वैलिडेटेड डिज़ाइन को प्रोडक्शन में ले जाना। यह वर्ज़न-कंट्रोल्ड माइग्रेशन स्क्रिप्ट्स का उपयोग करके किया जाना चाहिए ताकि समय के साथ बदलाव ट्रैक हों।
डिप्लॉयमेंट में परफॉर्मेंस और एरर्स की मॉनिटरिंग सेटअप करना भी शामिल है, और यह सुनिश्चित करना कि स्कीमा अच्छी तरह प्रलेखित हो ताकि भविष्य में बदलाव बिना भ्रम के किए जा सकें।
डिप्लॉयमेंट के बाद, नए आवश्यकताएँ उभरने पर डिज़ाइन की समय-समय पर समीक्षा करना सामान्य बात है।
अच्छी तरह डिज़ाइन किया गया डेटा मॉडल कई लाभ प्रदान करता है।
डेटा मॉडलिंग के कार्यान्वयन के लिए उन्नत तरीक़े भी हो सकते हैं।
डाइमेंशनल मॉडलिंग डेटा वेयरहाउसिंग में सामान्य है, जहाँ लक्ष्य विश्लेषणात्मक क्वेरियों को सहज और तेज़ बनाना होता है।
इसमें विशिष्ट स्कीमा का उपयोग शामिल है:
OrderItems) में मेट्रिक्स होते हैं, जबकि कई डाइमेंशन टेबल (उदा., Customer, Product, Date) विवरणात्मक एट्रिब्यूट्स संग्रहीत करते हैं। यह संरचना BI टूल्स के लिए क्वेरी करना आसान बनाती है।यह कुछ इस तरह दिख सकता है:
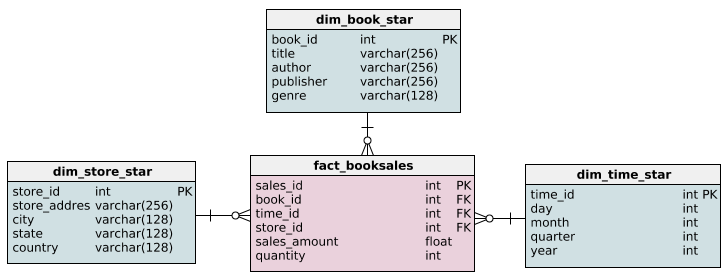
स्रोत: Querying the star schema
Product को Product और Category टेबल में विभाजित किया जा सकता है।ER मॉडलिंग लेन-देनात्मक सिस्टम में अधिक सामान्य है। यह डेटा अखंडता सुनिश्चित करने के लिए normalization पर जोर देता है। कुछ मामलों में, पढ़ने के प्रदर्शन में सुधार के लिए, विशेषकर अक्सर एक्सेस किए जाने वाले डेटा के लिए, चयनात्मक रूप से डीनार्मलाइज़ेशन लागू किया जाता है।
पॉलीग्लॉट मॉडलिंग विभिन्न वर्कलोड्स के लिए अलग-अलग डेटाबेस प्रकारों का उपयोग करती है।
उदाहरण के लिए, आप ऑर्डर लेन-देन के लिए PostgreSQL और लचीले एट्रिब्यूट्स वाले प्रोडक्ट कैटलॉग के लिए MongoDB का उपयोग कर सकते हैं। इससे आप सही कार्य के लिए सही टूल का उपयोग कर पाते हैं, लेकिन यह ऑपरेशनल जटिलता बढ़ा देता है।
NoSQL सिस्टम में, डिज़ाइन अक्सर एक्सेस पैटर्न पर आधारित होता है, न कि सख्त normalization पर। डेटा इस तरह संगठित किया जाता है कि सामान्य ऑपरेशंस के लिए आवश्यक क्वेरियों की संख्या कम हो, और बॉटलनेक्स से बचने के लिए पार्टिशनिंग आवश्यक है।
PostgreSQL जैसे रिलेशनल सिस्टम पूर्ण रूप से ACID गुणधर्मों का समर्थन करते हैं, जिससे डेटा स्थिरता सुनिश्चित होती है। कई NoSQL डेटाबेस गति और स्केलेबिलिटी में सुधार के लिए इन गारंटियों को ढीला करते हैं, और स्थिरता की कीमत पर eventual consistency अपनाते हैं।
डेटा मॉडल डेटाबेस डिज़ाइन का एक महत्वपूर्ण हिस्सा हैं और कई रूप ले सकते हैं। हालाँकि, आधुनिक एंटरप्राइज़ में, सर्वोत्तम प्रदर्शन सुनिश्चित करने के लिए इन मॉडलों का उपयुक्त रूप से अनुकूलन करना आवश्यक है।
तकनीक लगातार विकसित और अपडेट होती रहती है, और डेटा उद्योग में निरंतर सीखना और अनुकूलन आवश्यक है। डेटाबेस के बारे में अधिक जानने के लिए, हमारे Database Design या Introduction to Relational Databases in SQL कोर्स देखें और शुरुआत करें।
पढ़ना पसंद है? हमारे Data Modeling Tools या DBMS Interview Questions पर लेख सहायक हो सकते हैं।
शीर्ष DataCamp कोर्स
लर्निंग पाथ
लर्निंग पाथ
कोर्स