
Programma
Ingegnere dei dati associato in SQL
30 ore
Gestire correttamente ed efficacemente un database richiede la comprensione dei fondamenti dei modelli di dati.
Nei sistemi di gestione di database (DBMS), i modelli di dati fungono da progetti architetturali che definiscono come le informazioni vengono archiviate, correlate e accessibili.
Sono lo strato di traduzione tra i requisiti di business (“Dobbiamo tracciare clienti, ordini e prodotti”) e l’implementazione tecnica (“Lo memorizzeremo in quattro tabelle collegate da chiavi esterne”).
Un modello di dati ben progettato aiuta a:
In questa guida esploreremo modelli di dati classici e moderni, livelli di astrazione, processi di progettazione e strategie avanzate di ottimizzazione — il tutto illustrato con un dataset e-commerce in PostgreSQL.
Ecco alcuni motivi rapidi per cui dovresti conoscere i modelli di dati e perché sono importanti.
Un modello di dati in un Database Management System (DBMS) è un progetto utilizzato dai database per definire come i dati sono organizzati, archiviati e accessibili.
Il data model fornisce un modo strutturato per rappresentare gli elementi di dati e le loro relazioni, consentendo una gestione e manipolazione efficienti dei dati.
Avere un modello di dati aiuta a rispondere a domande come:
Un modello di dati rende tutte le informazioni necessarie e le risposte a queste domande facilmente comprensibili dagli amministratori di database.
Un modello di dati struttura e organizza le informazioni in un database. Questo garantisce chiarezza e coerenza nel modo in cui i dati vengono gestiti all’interno di un sistema.
Ecco alcuni motivi comuni per cui serve un modello di dati:
Senza un modello di dati definito, rischi di avere:
Ecco una semplice query SQL che mostra come un database può essere modificato per includere struttura, relazioni e vincoli.
ALTER TABLE Orders
ADD CONSTRAINT fk_customer
FOREIGN KEY (CustomerID)
REFERENCES Customer(CustomerID);
Questo impone che ogni ordine sia collegato a un cliente esistente, un modo semplice ma potente per mantenere l’integrità.
Prima di passare a ulteriori spiegazioni, creiamo e utilizziamo un semplice dataset e-commerce per illustrare i concetti in tutta la guida.
Includeremo le seguenti entità nel dataset.
Ecco un semplice diagramma ER in ASCII che mostra le relazioni tra le tabelle che creeremo.
Customer ───< Orders ───< OrderItems >─── ProductQuesto corrisponde a questa logica:
Successivamente, creerò le tabelle ed eseguirò il tutto in PostgreSQL per lanciare le query.
Ecco lo schema e il codice SQL per creare le tabelle necessarie.
CREATE TABLE Customer (
    CustomerID SERIAL PRIMARY KEY,
    CustomerName VARCHAR(100) NOT NULL,
    Email VARCHAR(100) UNIQUE NOT NULL,
    Phone VARCHAR(20),
    CreatedAt TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE TABLE Product (
    ProductID SERIAL PRIMARY KEY,
    ProductName VARCHAR(100) NOT NULL,
    Category VARCHAR(50),
    Price NUMERIC(10, 2) NOT NULL
);

CREATE TABLE Orders (
    OrderID SERIAL PRIMARY KEY,
    CustomerID INT NOT NULL,
    OrderDate DATE NOT NULL,
    Status VARCHAR(20) DEFAULT 'Pending',
    FOREIGN KEY (CustomerID) REFERENCES Customer(CustomerID)
);

CREATE TABLE OrderItems (
    OrderItemID SERIAL PRIMARY KEY,
    OrderID INT NOT NULL,
    ProductID INT NOT NULL,
    Quantity INT NOT NULL CHECK (Quantity > 0),
    FOREIGN KEY (OrderID) REFERENCES Orders(OrderID),
    FOREIGN KEY (ProductID) REFERENCES Product(ProductID)
);Ora inseriamo alcune informazioni di base nel
INSERT INTO Customer (CustomerName, Email, Phone)
VALUES
('Alice Brown’, 'alice@example.com', '91234567'),
('Bob McKee', 'bob@example.com', '98765432');

INSERT INTO Product (ProductName, Category, Price)
VALUES
('Laptop', 'Electronics', 1200.00),
('Wireless Mouse', 'Electronics', 25.50),
('Office Chair', 'Furniture', 150.00);

INSERT INTO Orders (CustomerID, OrderDate, Status)
VALUES
(1, '2025-08-01', 'Shipped'),
(2, '2025-08-02', 'Pending');

INSERT INTO OrderItems (OrderID, ProductID, Quantity)
VALUES
(1, 1, 1),
(1, 2, 2),
(2, 3, 1);
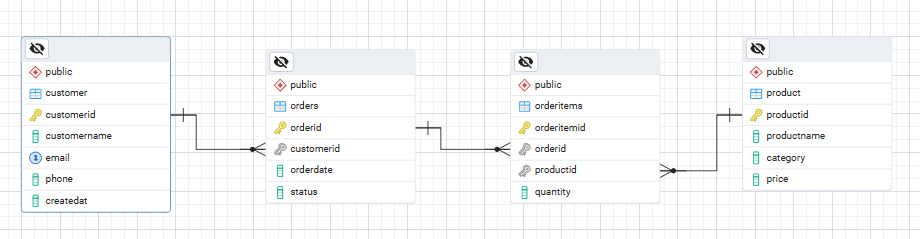
Il tuo diagramma ER per il database dovrebbe apparire così:
Un modello di dati robusto è composto da quattro componenti principali:
Nel data modeling, le entità rappresentano gli oggetti o concetti fondamentali e distinti all’interno di un sistema di cui vogliamo memorizzare i dati. Le entità sono spesso rappresentate come tabelle in un database.
Esempi di entità nel nostro dataset:
CustomerProductOrdersOrderItemsQueste entità diventano i “sostantivi” centrali del database.
Le entità sono le fondamenta. Tutto il resto del modello, come attributi, relazioni e vincoli, si costruisce su di esse.
Nel data modeling, gli attributi sono caratteristiche o proprietà che descrivono un’entità. Rappresentano i singoli punti dati che definiscono un’entità, come il nome, l’email o l’indirizzo di un cliente.
Esempi:
Customer: CustomerName, Email, Phone.Product: ProductName, Price, Category.In poche parole, gli attributi sono i dettagli che ti interessano per ciascuna entità. Tipicamente sono colonne in una tabella.
Le relazioni in un modello di dati definiscono come sono connesse le diverse entità o tabelle, rappresentando le associazioni tra di esse. Pensale come connessioni logiche tra entità.
Esempi nel nostro dataset:
Customer può avere molti Orders (1-a-molti).Order può contenere molti Products tramite OrderItems (molti-a-molti risolto tramite una tabella di giunzione).Le relazioni assicurano che il modello di dati rappresenti fedelmente le associazioni del mondo reale.
Nel data modeling, i vincoli sono regole che limitano i valori consentiti in un database, garantendo accuratezza, coerenza e integrità dei dati.
I vincoli aiutano a mantenere l’integrità del database, impedendo l’inserimento di dati non validi o incoerenti.
Esempi:
UNIQUE su Customer.Email.CHECK per garantire Quantity > 0 in OrderItems.Esempio PostgreSQL
Ecco un esempio di utilizzo di alcuni tipi di vincoli in una query SQL.
CREATE TABLE OrderItems_Constraint (
    OrderItemID SERIAL PRIMARY KEY,
    OrderID INT NOT NULL,
    ProductID INT NOT NULL,
    Quantity INT NOT NULL CHECK (Quantity > 0),
    FOREIGN KEY (OrderID) REFERENCES Orders(OrderID),
    FOREIGN KEY (ProductID) REFERENCES Product(ProductID)
);
In questo esempio abbiamo utilizzato i vincoli PRIMARY, CHECK, NOT NULL e REFERENCES.
Nei database esistono diversi tipi di modelli di dati. Ciò riflette il modo in cui i dati sono archiviati in base alla loro natura.
Per prima cosa, vediamo alcuni modelli classici comuni utilizzati nei sistemi di gestione di database.
Un modello di dati gerarchico organizza i dati in una struttura ad albero, in cui ogni record (nodo) ha un solo genitore (tranne la radice) e può avere più figli.
Esempio (rappresentazione in stile XML):
<Customer id="1">
    <Name>Alice Brown</Name>
    <Orders>
        <Order id="1" date="2025-08-01"/>
    </Orders>
</Customer>
Equivalenti moderni compaiono spesso nell’archiviazione XML/JSON, ma il modello risale ai primi DBMS su mainframe come IMS.
Un modello di dati a rete è un modo flessibile per rappresentare dati e relazioni, particolarmente utile per connessioni complesse molti-a-molti.
Usa una struttura a grafo con nodi (che rappresentano entità) e archi (che rappresentano relazioni) per organizzare i dati, consentendo percorsi di accesso più efficienti e diretti rispetto ai modelli gerarchici.
Il modello di dati relazionale struttura i dati in tabelle con righe e colonne, permettendo archiviazione, recupero e gestione efficienti delle informazioni.
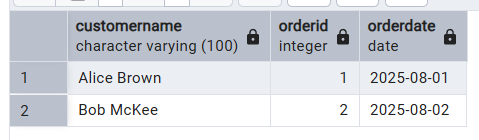
Query di esempio dal nostro dataset:
SELECT c.CustomerName, o.OrderID, o.OrderDate
FROM Customer c
JOIN Orders o ON c.CustomerID = o.CustomerID;
Questa query dimostra l’uso del JOIN per creare relazioni tra la tabella Customer e la tabella Orders.
Questo produce la seguente tabella come risultato:
Con l’avanzare della tecnologia dei database, sono emersi anche alcuni modelli moderni. Ecco alcuni esempi:
Il modello orientato agli oggetti combina concetti di database e di programmazione orientata agli oggetti. Supporta ereditarietà e incapsulamento.
Il modello object-relational è un ibrido tra relazionale e orientato agli oggetti.
I modelli di dati NoSQL si discostano dalle strutture rigide basate su tabelle dei database relazionali tradizionali, offrendo schemi flessibili e metodi diversificati di organizzazione dei dati per gestire grandi volumi di dati non strutturati e semi-strutturati.
Ecco alcuni esempi di modelli NoSQL:
Ecco un esempio di modello a documenti (documento MongoDB):
{
    "CustomerName": "Alice Brown",
    "Orders": [
        {"ProductName": "Laptop", "Quantity": 1}
    ]
}Il processo di data modeling avviene su tre livelli diversi – concettuale, logico e fisico.
Questi livelli sono le diverse fasi di dettaglio utilizzate nella progettazione di un database o sistema informativo. Aiutano a gestire la complessità concentrandosi su aspetti specifici dei dati e della loro struttura.
Il modello di dati concettuale è l’astrazione di livello più alto e indipendente dalla tecnologia nel processo di data modeling. Si concentra sulla definizione delle entità chiave e delle loro relazioni in un sistema senza entrare nei dettagli tecnici.
Questo livello cattura i requisiti di business e le relazioni.
Esempio: il nostro diagramma ER che mostra Customer → Orders.
Il modello di dati logico è il secondo livello di astrazione. Delinea entità, attributi e relazioni senza menzionare alcun database specifico.
Questo livello converte il modello concettuale in uno schema specifico per il DBMS. Definisce tabelle, chiavi e relazioni senza dettagli di archiviazione.
Il livello del modello di dati fisico implementa uno schema con indici, partizioni e parametri di storage.
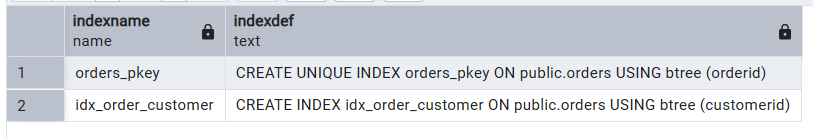
Ecco un esempio di indice:
CREATE INDEX idx_order_customer ON Orders(CustomerID);Ora visualizzeremo questo indice con questa query:
SELECT indexname, indexdef
FROM pg_indexes
WHERE tablename = 'orders';
Come puoi vedere nell’indice qui sotto, abbiamo creato un nuovo indice chiamato idx_order_customer.
Il data modeling è un approccio strutturato per tradurre le esigenze di business in un progetto tecnico che regola come i dati saranno archiviati, correlati e recuperati.
Se fatto bene, il data modeling riduce la ridondanza, migliora la qualità dei dati e rende più facile la manutenzione futura.
Fonte: Data Quality Dimensions Cheat Sheet
Il processo in genere procede per fasi. Vediamole nel dettaglio.
La raccolta dei requisiti è la base dell’intero processo di data modeling. In questa fase cerchi di capire quali sono le esigenze del business e perché.
Ci sono diversi modi per raccogliere efficacemente i requisiti.
L’output di questa fase dovrebbe essere un set chiaro di requisiti documentati che descrivono entità di dati, relazioni e regole di business.
Ad esempio, nel nostro dataset retail di esempio, gli stakeholder potrebbero voler tracciare ordini dei clienti, prodotti e date degli ordini per calcolare metriche come vendite totali per categoria di prodotto e tasso di clienti ricorrenti.
La progettazione concettuale traduce quei requisiti di business in una rappresentazione visiva e ad alto livello dei dati.
In questa fase ti concentri su quali entità esistono e come sono correlate, senza preoccuparti di dettagli tecnici come tipi di chiavi primarie o strategie di indicizzazione.
Qui entrano in gioco i diagrammi Entità-Relazione (ER). I diagrammi ER mostrano entità (ad es., Customer, Product, Order), i loro attributi e le relazioni tra loro.
Per il nostro dataset:
Customer potrebbe includere CustomerID, Name, Email.Product potrebbe includere ProductID, Name, Category.Order potrebbe includere OrderID, OrderDate.OrderItem potrebbe includere OrderItemID, OrderID, ProductID, Quantity, Price.Le relazioni potrebbero essere:
Questo diagramma diventa un riferimento comune sia per i team di business che tecnici.
La progettazione logica si basa sul modello concettuale applicando le regole dei database, in particolare la normalizzazione.
La normalizzazione è il processo di strutturazione di un database relazionale per minimizzare ridondanza e dipendenze. Spesso si esegue per fasi (1NF, 2NF, 3NF), ognuna con requisiti specifici.
Nel nostro esempio, l’indirizzo email del cliente appartiene solo alla tabella Customer, non va duplicato nella tabella Order. Allo stesso modo, le informazioni sulla categoria del prodotto devono risiedere nella tabella Product, non essere sparse in più record in OrderItem.
La progettazione fisica prende il modello logico e lo adatta a un sistema di database specifico, come PostgreSQL o MySQL. Questa fase comporta decisioni su tipi di dati, ottimizzazione dello storage e tuning delle prestazioni.
Gli indici sono un aspetto chiave. Ad esempio, aggiungere un indice a OrderDate nella tabella Order può accelerare notevolmente le query che filtrano per data.
Si può anche applicare il partitioning per dataset di grandi dimensioni, suddividendo i dati in blocchi gestibili per data, intervallo o chiavi hash per migliorare le prestazioni delle query.
Si decide anche sui vincoli, come le chiavi esterne, per far rispettare l’integrità dei dati a livello di database.
Una volta completata la progettazione, occorre effettuare le validazioni prima di andare in produzione.
Questo implica il caricamento di dati di esempio, idealmente dati di test realistici che rispecchino i volumi attesi, e l’esecuzione di query che simulano l’uso reale.
Ad esempio, nel nostro dataset retail, potresti eseguire una query per calcolare i totali di vendita per mese, assicurandoti che i numeri corrispondano alle aspettative del business.
Testeresti anche i casi limite, come cosa succede quando viene inserito un ordine senza articoli (che dovrebbe essere impossibile se i vincoli sono corretti).
Il passaggio finale è portare il design validato in produzione. Dovrebbe essere fatto usando script di migrazione versionati, in modo che le modifiche siano tracciate nel tempo.
Il deploy implica anche configurare il monitoraggio di prestazioni ed errori e assicurare che lo schema sia ben documentato, così che le modifiche future possano essere fatte senza ambiguità.
Dopo il deploy, è comune rivedere periodicamente il design man mano che emergono nuovi requisiti.
Un modello di dati ben progettato offre numerosi benefici.
Il data modeling può prevedere anche metodi avanzati di implementazione.
La modellazione dimensionale è comune nel data warehousing, dove l’obiettivo è rendere le query analitiche intuitive e veloci.
Questo comporta l’uso di schemi specifici:
OrderItems) memorizza le metriche, mentre più tabelle di dimensione (ad es., Customer, Product, Date) memorizzano gli attributi descrittivi. Questa struttura è facile da interrogare per gli strumenti di BI.Ecco come potrebbe apparire:
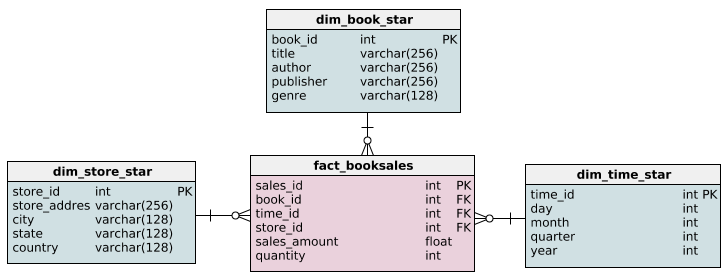
Fonte: Querying the star schema
Product potrebbe essere suddivisa in tabelle Product e Category.La modellazione ER è più tipica nei sistemi transazionali. Enfatizza la normalizzazione per garantire l’integrità dei dati. In alcuni casi, si applica selettivamente la denormalizzazione per migliorare le prestazioni in lettura, soprattutto per i dati consultati frequentemente.
La modellazione poliglotta utilizza diversi tipi di database per carichi di lavoro differenti.
Per esempio, potresti usare PostgreSQL per le transazioni degli ordini e MongoDB per un catalogo prodotti con attributi flessibili. Questo consente di usare lo strumento giusto per il compito giusto, ma aumenta la complessità operativa.
Nei sistemi NoSQL, il design è spesso basato sui pattern di accesso più che sulla normalizzazione rigorosa. I dati sono organizzati per minimizzare il numero di query necessarie alle operazioni comuni, e il partitioning è essenziale per evitare colli di bottiglia.
I sistemi relazionali come PostgreSQL supportano pienamente le proprietà ACID, garantendo coerenza dei dati. Molti database NoSQL allentano queste garanzie per migliorare velocità e scalabilità, scambiando la consistenza con la convergenza eventuale.
I modelli di dati sono una parte cruciale della progettazione dei database e possono assumere molte forme. Tuttavia, nelle aziende moderne, per garantire che questi modelli rendano al meglio, è necessario effettuare opportune ottimizzazioni.
La tecnologia evolve e si aggiorna continuamente, e nel settore dei dati c’è bisogno di apprendimento e adattamento costanti. Per saperne di più sui database, dai un’occhiata al nostro corso su Progettazione di Database o Introduzione ai Database Relazionali in SQL per iniziare.
Preferisci leggere? I nostri articoli su Strumenti di Data Modeling o Domande di Colloquio sui DBMS potrebbero esserti utili.
I migliori corsi DataCamp
Programma
Programma
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



