
什么是雪花型架构?
所谓雪花型架构,是另一种组织数据的方式。在该架构中,维度表被拆分为更小的子维度,以使数据更有条理、更细致——就像湖面上的雪花一样。
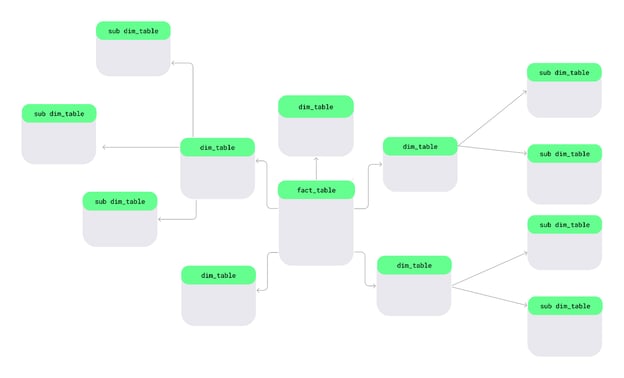
雪花型架构布局。图片来自作者。
下面来看让雪花型架构区别于其他架构的关键特性:
- 多层维度表:我们可以将维度表拆分为更小、更具体的表。例如,若要跟踪门店位置,与其把所有位置信息放在一张大表中,不如拆为国家、省/州和城市等独立表。这样每张表只包含所需信息,从而降低冗余并提升组织性。
- 为存储效率而进行规范化:不同于星型架构,雪花型架构遵循规范化设计,以避免数据重复。例如,与其在每个产品上重复
Electronics这样的产品类别,不如将类别存放在单独的表中,并与各产品建立关联。 - 适用于复杂数据环境:雪花型架构通过多层表来处理复杂关系与层级结构,因此最适合复杂的数据环境。
结合一个简单的雪花型架构图来理解。中心是包含可度量数据的事实表。它连接描述事实的维度表,而这些维度表进一步分支为子维度表,形成类似雪花的结构。
例如,此处我将 Product 拆分为 Manufacturer 和 Category 两张表,并将 Customer 表拆分为 Transaction 和 Location 两张表:
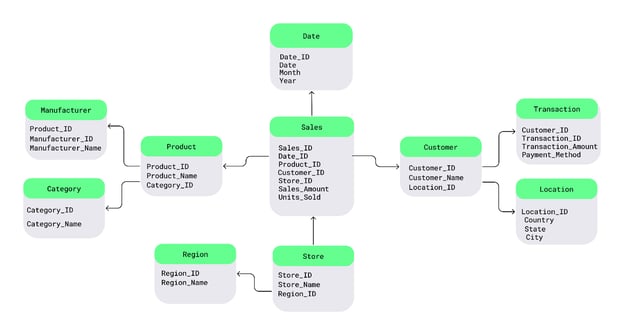
雪花型架构示例。图片来自作者。
下面是一个 SQL 示例,演示在雪花型架构中将 Product 表进一步规范化为 Category 和 Manufacturer 两张表:
-- Fact table remains the same
CREATE TABLE Sales (
Sales_ID INT PRIMARY KEY,
Product_ID INT,
Customer_ID INT,
Date_ID INT,
Sales_Amount DECIMAL(10, 2),
FOREIGN KEY (Product_ID) REFERENCES Products(Product_ID),
FOREIGN KEY (Customer_ID) REFERENCES Customers(Customer_ID),
FOREIGN KEY (Date_ID) REFERENCES Dates(Date_ID)
);
-- Dimension table: Product
CREATE TABLE Product (
Product_ID INT PRIMARY KEY,
Product_Name VARCHAR(100),
Category_ID INT,
Manufacturer_ID INT,
FOREIGN KEY (Category_ID) REFERENCES Category(Category_ID),
FOREIGN KEY (Manufacturer_ID) REFERENCES Manufacturer(Manufacturer_ID)
);
-- Sub-dimension table: Category
CREATE TABLE Category (
Category_ID INT PRIMARY KEY,
Category_Name VARCHAR(50)
);
-- Sub-dimension table: Manufacturer
CREATE TABLE Manufacturer (
Manufacturer_ID INT PRIMARY KEY,
Manufacturer_Name VARCHAR(100)
);下面的查询按产品类别统计总销售额。尽管相比星型架构需要更多连接,但在存储方面更高效:
SELECT cat.Category_Name, SUM(s.Sales_Amount) AS TotalSales
FROM Sales s
JOIN Product p ON s.Product_ID = p.Product_ID
JOIN Category cat ON p.Category_ID = cat.Category_ID
GROUP BY cat.Category_Name;雪花型架构的优点与局限
与星型架构类似,雪花型架构也有自身的优势。如下:
- 更少的数据冗余:规范化确保相同数据不会被多次存储,从而减少重复。
- 适合大型数据集的高效存储:通过避免重复数据来节省存储空间,适合管理大型数据集。
然而,尽管有这些优势,也存在一些限制。例如,查询可能更慢,因为需要在更多表之间进行连接。除此之外,其多层结构在设计和维护上也更具挑战性,不如星型架构这类更简单的模式。因此,只有在您拥有经验丰富的 DBA 团队时再采用它。
如果您想进一步学习如何更高效地组织数据以便分析,建议查看Database Design 课程。
采用混合方案
在真实项目中,常见做法是在不同层同时使用两种模式,以结合它们各自的优势:
- 在仓库层保持更规范化(雪花化)的结构,以保证一致性和更易维护
- 为 BI 和报表发布星型集市或反规范化视图
这样团队既能兼顾数据完整性与治理,又能满足快速、简洁的分析消费。
星型架构 vs 雪花型架构
星型与雪花型架构在数据仓库中都被广泛使用,但它们的独特特性使其适用于不同需求。下面从结构、性能、存储需求与使用场景来比较它们的差异。
结构
在星型架构中,所有维度表都直接连接到一张中心事实表。这意味着所有参考数据距离主数据只有一跳,易于理解和使用。
相比之下,雪花型架构将维度表拆分为更小、更具体的子维度表。例如,可以将国家、省/州、城市分别建为独立表,而不是一个位置表。这样的结构更有组织、更详尽,但也意味着访问数据需要更多连接——这正是雪花型架构比星型架构更复杂的主要原因。
性能
在速度方面,星型架构通常更胜一筹。由于所有维度表直接连接事实表,查询通常需要更少的连接,从而带来更快的性能。比如您要按区域分析销售额——这种情况下,使用星型架构能以最少的处理获取数据。
相反,雪花型架构往往更慢,因为您需要穿过多张表来取数。每一次连接都会增加处理时间,使其在需要快速查询结果的任务上效率较低。
课程Joining Data in SQL非常适合入门学习如何连接表、应用关系代数思想并使用子查询。
存储需求
星型架构因为在维度表中存放了冗余信息而占用更多存储。例如,若多个产品属于同一类别,类别名称会在每个产品上重复,增加存储需求。
而雪花型架构通过数据规范化来确保信息只存储一次。例如,不再重复存储类别名称,而是将其放入单独表中,并通过外键与产品表关联。这种设计节省存储空间,适合大型数据集。
使用场景
星型架构非常适合联机分析处理(OLAP)系统、报表和商业智能任务。其简洁性使其非常适合需要速度与易用性的场景,如快速生成看板或销售报告。
雪花型架构常用于财务分析或客户关系管理(CRM)系统。在这些场景下,组织细致的层级并节省存储空间比查询速度更重要。
对比表
下面这张表快速比较了星型与雪花型架构,帮助您决定哪种更适合您的数据需求。我在表中突出它们在结构、性能、存储和使用场景上的关键差异:
|
特性 |
星型架构 |
雪花型架构 |
混合方案 |
|
结构 |
中心事实表连接反规范化的维度 |
中心事实表连接规范化的维度 |
规范化的核心模型,加上用于消费的星型数据集市或反规范化视图 |
|
复杂度 |
简单,连接更少 |
复杂,连接更多 |
中等,部件更多,但各层对其目的而言更简洁 |
|
数据冗余 |
因反规范化而冗余更高 |
因规范化而冗余更低 |
因选择性反规范化而冗余中等 |
|
查询性能 |
因结构更简单而查询更快 |
因额外连接而查询更慢 |
对 BI 较快,因为消费层是反规范化的 |
|
存储 |
因冗余而需要更多存储 |
因规范化而需要更少存储 |
需要适中存储,因为数据集市/视图可能带来一定重复 |
|
易维护性 |
更易设计与维护 |
设计与维护更复杂 |
易于维护,因为集市可从受控核心重建 |
|
最适合 |
小到中等规模数据集 |
大型且复杂的数据集 |
既需治理又需 BI 性能的现代数据平台 |
选择合适的架构
何时使用星型架构
如果您主要希望以简单、快捷的方式组织数据,星型架构会非常合适。以下情形可考虑使用:
- 如果您要为 BI 工具(如 Power BI)构建语义模型,并希望表与关系数量较少。它支持直观的筛选/分组,并且在交互式可视化方面通常表现良好。
- 如果您想运行简单查询,如按区域统计总销售额,使用星型架构更合适。由于所有维度表直接连接事实表,它能避免不必要的复杂度,更快给出答案。
- 当速度是优先级时也可使用星型架构。它减少表连接数量,使查询运行更快。比如我曾用它生成多份销售报告,相比其他设计节省了大量时间。
- 若您的数据集规模较小或中等,星型架构的冗余并非问题。即便有重复数据,也不会对存储造成过度压力,依然能良好运行。
何时使用雪花型架构
雪花型架构更适合表示层级与共享参考数据,尤其是当多个维度属性在许多行中重复出现时。 适用情形包括:
- 当维度存在清晰层级(例如:国家 → 省/州/区域 → 城市),且您希望将这些层级干净地建模为独立表。
- 如果您想更好地控制共享参考数据(例如类别、制造商或地理等标准列表),以减少重复并更容易在整个仓库内保持定义一致。
- 当数据经常变更(如更新区域名称)时也可采用雪花型架构。它能在所有相关数据间保持一致更新,从而减少错误与维护成本。
- 若您的分析涉及多层级数据,雪花型架构有助于以清晰方式组织与表示这些关系。
云数据仓库中的架构选择
在许多现代云数据仓库中,存储相较计算更为廉价。这意味着由反规范化维度带来的“额外存储”往往不如扫描与连接数据的计算成本重要。
在星型与雪花型之间做选择时,请考虑平台的计费模式(计算 vs. 存储)、查询并发,以及您是否可以使用缓存/物化视图来降低查询成本。
结语
本文介绍了星型与雪花型架构的差异、优势及各自的适用场景。希望这些内容能为您的实际工作带来清晰的认知与实用建议!若想进一步学习,欢迎查看 DataCamp 上的以下资源:
- Introduction to Data Modeling in Snowflake 课程将帮助您夯实在 Snowflake 上开展工作的基础。
- Data Modeling in Power BI 课程,学习在 Power BI 中组织与管理数据。
- Associate Data Engineer in SQL 技能路径,帮助您将 SQL 技能更进一步。
FAQs
在这些架构中建立索引的作用是什么?
索引能加速两种架构中的查询性能,使数据检索更快。
什么是维度表和事实表?
维度表存放描述性属性(如产品名称或日期),用于描述事实表中的数据。
而事实表存放定量数据,如销售数字或交易金额,并与维度表相连接。
这些架构适用于非结构化数据吗?
不,这些架构适用于结构化数据。非结构化数据需要其他模型,如 NoSQL 或数据湖。
我该如何设计星型和雪花型架构?
要创建并可视化这些架构,您可以使用数据建模工具(ERDPlus)、BI 工具(Tableau、Power BI、QlikView)或云平台(Databricks)。
星型与雪花型架构有没有替代方案?
可以,您也可以使用 Galaxy 架构、Data Vault 建模或更复杂的维度模型。它们主要在数据组织方式以及处理不同信息之间的关系方面有所不同。

我是内容策略专家,热衷于将复杂主题化繁为简。我曾帮助 Splunk、Hackernoon 和 Tiiny Host 等公司为其受众打造兼具吸引力与信息量的内容。
如果您从事数据仓库相关工作,您一定知道以高效、易用的方式组织数据有多重要。但您是否想过,哪种数据库模式最符合您的需求?对此,常见有两种主要框架可供选择:星型架构和雪花型架构。
星型架构简单且快速——当您需要迅速提取数据用于分析时非常理想。相对地,雪花型架构更为细致,它优先考虑存储效率以及对复杂数据关系的管理。
本文将带您了解这两种架构的结构、突出其差异,并拆解各自的优势。读完后,您将知道各自适用的场景,以及如何为您的数据项目做出最佳选择。
什么是星型架构?
星型架构是一种组织数据库数据的方式,尤其是在数据仓库中,旨在让分析更简单、更快捷。中心有一张称为事实表的主表,存放可度量的数据,如销售额或营收。围绕它的是维度表,提供产品名称、客户信息或日期等细节。整体布局呈现出星形。
星型架构布局。图片来自作者。
来看一下星型架构的关键特性:
结合一个简单的星型架构图来理解。中心的事实表
Sales存放您要分析的数值数据,如销售额或利润。与其相连的是包含描述性细节的维度表,例如产品名称、客户所在地或日期:星型架构示例。图片来自作者。
下面是一个简单的 SQL 示例,展示如何设置一个包含
Sales事实表和Product、Customer和Date维度表的星型架构:这种布局因为没有复杂的连接而加速了查询。例如,下面的查询按客户所在地汇总总销售额,利用了星型架构的简单连接:
不过,您需要接受一定的数据冗余,因为维度表中可能包含重复信息。
星型架构的优点与局限
了解了星型架构后,来看它为何脱颖而出:
尽管优势明显,星型架构也有不足。正如前文所述,由于反规范化,维度表往往包含重复信息,这会增加存储占用。例如,若多个产品属于同一类别,每个产品的类别名称可能重复,从而占用更多存储空间。