
Program
Yardımcı Veri Mühendisi SQL içinde
30 sa
Bir veritabanını etkili ve doğru şekilde yönetmek, veri modellerinin temellerini anlamayı gerektirir.
Veritabanı yönetim sistemlerinde (DBMS), veri modelleri bilgilerin nasıl saklandığını, ilişkilendirildiğini ve erişildiğini tanımlayan mimari planlar olarak hizmet eder.
Bunlar, iş gereksinimleri (“Müşterileri, siparişleri ve ürünleri takip etmemiz gerekiyor”) ile teknik uygulama (“Bunu yabancı anahtarlarla bağlanan dört tabloda saklayacağız”) arasında bir çeviri katmanıdır.
İyi tasarlanmış bir veri modeli şunlara yardımcı olur:
Bu rehberde, hem klasik hem modern veri modellerini, soyutlama düzeylerini, tasarım süreçlerini ve gelişmiş optimizasyon stratejilerini — hepsini bir PostgreSQL e-ticaret veri kümesiyle örneklendirerek — inceleyeceğiz.
Veri modellerini neden bilmeniz ve neden önemli olduklarına dair bazı hızlı nedenler şunlardır.
Bir veri modeli, Veritabanı Yönetim Sistemi (DBMS) içinde verinin nasıl organize edildiğini, saklandığını ve erişildiğini tanımlamak için veritabanları tarafından kullanılan bir plandır.
Veri modeli, veri öğelerini ve bunların ilişkilerini temsil etmek için yapılandırılmış bir yol sunar; bu da verinin verimli biçimde yönetilmesini ve işlenmesini mümkün kılar.
Bir veri modeline sahip olmak şu soruları yanıtlamaya yardımcı olur:
Bir veri modeli, gerekli tüm bilgileri ve bu soruların yanıtlarını veritabanı yöneticilerinin kolayca anlayacağı hale getirir.
Bir veri modeli, bir veritabanındaki bilgiyi yapılandırır ve düzenler. Bu, bir sistem içinde verinin nasıl ele alındığına dair açıklık ve tutarlılık sağlar.
İşte bir veri modeline ihtiyaç duyulmasının yaygın nedenleri:
Tanımlı bir veri modeli olmadan şu risklerle karşılaşırsınız:
İşte bir veritabanına yapı, ilişkiler ve kısıtlar eklemenin nasıl yapılabileceğini gösteren basit bir SQL sorgusu.
ALTER TABLE Orders
ADD CONSTRAINT fk_customer
FOREIGN KEY (CustomerID)
REFERENCES Customer(CustomerID);
Bu, her siparişin mevcut bir müşteriye bağlı olmasını sağlar; bu da bütünlüğü korumanın basit ama güçlü bir yoludur.
Daha ileri açıklamalara geçmeden önce, bu rehber boyunca kavramları göstermek için basit bir e-ticaret veri kümesi oluşturalım ve kullanalım.
Veri kümesine aşağıdaki varlıkları dahil edeceğiz.
Oluşturacağımız tablolar arasındaki ilişkileri gösteren basit bir ASCII ER Diyagramı şudur.
Customer ───< Orders ───< OrderItems >─── ProductBu şu mantığa karşılık gelir:
Sonraki adımda tabloları oluşturup sorguları çalıştırmak için PostgreSQL’de çalıştıracağım.
Gerekli tabloları oluşturmak için şema ve SQL kodu aşağıdadır.
CREATE TABLE Customer (
    CustomerID SERIAL PRIMARY KEY,
    CustomerName VARCHAR(100) NOT NULL,
    Email VARCHAR(100) UNIQUE NOT NULL,
    Phone VARCHAR(20),
    CreatedAt TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE TABLE Product (
    ProductID SERIAL PRIMARY KEY,
    ProductName VARCHAR(100) NOT NULL,
    Category VARCHAR(50),
    Price NUMERIC(10, 2) NOT NULL
);

CREATE TABLE Orders (
    OrderID SERIAL PRIMARY KEY,
    CustomerID INT NOT NULL,
    OrderDate DATE NOT NULL,
    Status VARCHAR(20) DEFAULT 'Pending',
    FOREIGN KEY (CustomerID) REFERENCES Customer(CustomerID)
);

CREATE TABLE OrderItems (
    OrderItemID SERIAL PRIMARY KEY,
    OrderID INT NOT NULL,
    ProductID INT NOT NULL,
    Quantity INT NOT NULL CHECK (Quantity > 0),
    FOREIGN KEY (OrderID) REFERENCES Orders(OrderID),
    FOREIGN KEY (ProductID) REFERENCES Product(ProductID)
);Şimdi de bazı temel bilgileri ekleyelim
INSERT INTO Customer (CustomerName, Email, Phone)
VALUES
('Alice Brown’, 'alice@example.com', '91234567'),
('Bob McKee', 'bob@example.com', '98765432');

INSERT INTO Product (ProductName, Category, Price)
VALUES
('Laptop', 'Electronics', 1200.00),
('Wireless Mouse', 'Electronics', 25.50),
('Office Chair', 'Furniture', 150.00);

INSERT INTO Orders (CustomerID, OrderDate, Status)
VALUES
(1, '2025-08-01', 'Shipped'),
(2, '2025-08-02', 'Pending');

INSERT INTO OrderItems (OrderID, ProductID, Quantity)
VALUES
(1, 1, 1),
(1, 2, 2),
(2, 3, 1);
Veritabanı için ER diyagramınız şöyle görünmelidir:
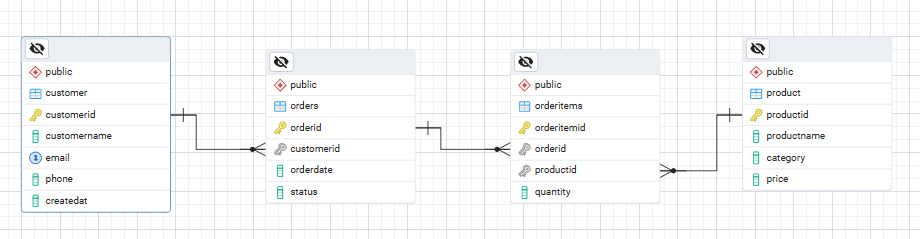
Sağlam bir veri modeli dört ana bileşenden oluşur:
Veri modellemede, varlıklar bir sistemde verisini saklamak istediğimiz temel, ayrı nesneleri veya kavramları temsil eder. Varlıklar genellikle veritabanında tablolar olarak temsil edilir.
Veri kümemizdeki varlıklara örnekler:
CustomerProductOrdersOrderItemsBu varlıklar veritabanının temel “isimleri” haline gelir.
Varlıklar temeldir. Öznitelikler, ilişkiler ve kısıtlar gibi modelin diğer tüm yönleri onların üzerine inşa edilir.
Veri modellemede öznitelikler, bir varlığı tanımlayan özellikler veya niteliklerdir. Bir müşterinin adı, e-postası veya adresi gibi bir varlığı tanımlayan belirli veri noktalarını temsil ederler.
Örnekler:
Customer için: CustomerName, Email, Phone.Product için: ProductName, Price, Category.Kısaca, öznitelikler her varlık için önemsediğiniz ayrıntılardır. Tipik olarak bir tablodaki sütunlardır.
Bir veri modelindeki ilişkiler, farklı varlıkların veya tabloların nasıl bağlandığını tanımlar; aralarındaki bağdaşıklıkları temsil eder. Bunları varlıklar arasındaki mantıksal bağlantılar olarak düşünebilirsiniz.
Veri kümemizdeki örnekler:
Customer birden çok Orders’a sahip olabilir (bire-çok).Order, OrderItems aracılığıyla birçok Products içerebilir (bağlantı tablosu üzerinden çözümlenen çoka-çok).İlişkiler, veri modelinin gerçek dünya bağdaşıklıklarını doğru yansıtmasını sağlar.
Veri modellemede kısıtlar, bir veritabanında izin verilen değerleri sınırlayan; doğruluk, tutarlılık ve bütünlüğü güvence altına alan kurallardır.
Kısıtlar, geçersiz veya tutarsız verinin girilmesini engelleyerek veritabanının bütünlüğünü korur.
Örnekler:
Customer.Email üzerinde UNIQUE kısıtı.OrderItems içinde Quantity > 0 sağlamak için CHECK kısıtı.PostgreSQL Örneği
İşte bir SQL sorgusunda bazı kısıt türlerinin kullanımına ait bir örnek.
CREATE TABLE OrderItems_Constraint (
    OrderItemID SERIAL PRIMARY KEY,
    OrderID INT NOT NULL,
    ProductID INT NOT NULL,
    Quantity INT NOT NULL CHECK (Quantity > 0),
    FOREIGN KEY (OrderID) REFERENCES Orders(OrderID),
    FOREIGN KEY (ProductID) REFERENCES Product(ProductID)
);
Bu örnekte PRIMARY, CHECK, NOT NULL ve REFERENCES kısıtlarını kullandık.
Veritabanlarında farklı türde veri modelleri vardır. Bu, verinin doğasına göre nasıl saklandığını yansıtır.
Öncelikle, veritabanı yönetim sistemlerinde kullanılan bazı yaygın klasik modellere bakalım.
Hiyerarşik veri modeli, her kaydın (düğüm) tek bir ebeveyne (kök hariç) ve birden çok çocuğa sahip olduğu ağaç benzeri bir yapıda veriyi organize eder.
Örnek (XML benzeri gösterim):
<Customer id="1">
    <Name>Alice Brown</Name>
    <Orders>
        <Order id="1" date="2025-08-01"/>
    </Orders>
</Customer>
Modern karşılıkları sıklıkla XML/JSON depolamada görülür, ancak modelin kendisi IMS gibi erken ana bilgisayar DBMS’lerine kadar uzanır.
Ağ veri modeli, özellikle karmaşık çoka-çok bağlantılar için veriyi ve ilişkileri temsil etmenin esnek bir yoludur.
Düğümlerle (varlıkları temsil eder) ve kenarlarla (ilişkileri temsil eder) bir grafik yapısı kullanarak veriyi düzenler; hiyerarşik modellere kıyasla daha verimli ve doğrudan erişim yolları sağlar.
İlişkisel veri modeli, veriyi satır ve sütunlardan oluşan tablolara yapılandırarak bilgilerin verimli saklanmasını, alınmasını ve yönetilmesini sağlar.
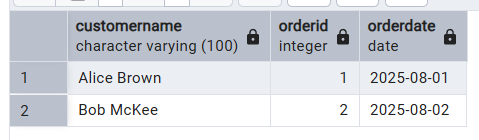
Veri kümemizden örnek sorgu:
SELECT c.CustomerName, o.OrderID, o.OrderDate
FROM Customer c
JOIN Orders o ON c.CustomerID = o.CustomerID;
Bu sorgu, Customer tablosu ile Orders tablosu arasında ilişki kurmak için JOIN işlevinin kullanımını gösterir.
Bu da aşağıdaki tabloyu sonuç olarak üretir:
Veritabanı teknolojisi ilerledikçe bazı modern modeller de ortaya çıkmıştır. İşte bazı örnekler:
Nesne yönelimli model, veritabanı ve nesne yönelimli programlama kavramlarını birleştirir. Kalıtımı ve kapsüllemeyi destekler.
Nesne-ilişkisel model, ilişkisel ve nesne yönelimli yaklaşımların bir karmasıdır.
NoSQL veri modelleri, geleneksel ilişkisel veritabanlarının katı, tablo tabanlı yapılarından uzaklaşarak; esnek şemalar ve büyük hacimli yapılandırılmamış ve yarı yapılandırılmış verileri yönetmek için çeşitli veri düzenleme yöntemleri sunar.
İşte bazı NoSQL model örnekleri:
İşte bir belge veri modeli (MongoDB belgesi) örneği:
{
    "CustomerName": "Alice Brown",
    "Orders": [
        {"ProductName": "Laptop", "Quantity": 1}
    ]
}
Veri modelleme süreci üç farklı düzeyde gerçekleşir – kavramsal, mantıksal ve fiziksel.
Bu düzeyler, bir veritabanı veya bilgi sistemi tasarlanırken kullanılan ayrıntı aşamalarıdır. Verinin ve yapısının belirli yönlerine odaklanarak karmaşıklığı yönetmeye yardımcı olur.
Kavramsal veri modeli, veri modelleme sürecindeki en üst düzey, teknoloji bağımsız soyutlamadır. Teknik ayrıntılara girmeden bir sistemdeki temel varlıkları ve bunların ilişkilerini tanımlamaya odaklanır.
Bu katman iş gereksinimlerini ve ilişkileri yakalar.
Örnek: Customer → Orders gösteren ER diyagramımız.
Mantıksal veri modeli ikinci soyutlama düzeyidir. Varlıkları, öznitelikleri ve ilişkileri belirli bir veritabanından bahsetmeden ana hatlarıyla çizer.
Bu katman, kavramsal modeli DBMS’e özgü bir şemaya dönüştürür. Depolama ayrıntıları olmadan tabloları, anahtarları ve ilişkileri tanımlar.
Fiziksel veri modeli katmanı; dizinler, bölümlemeler ve depolama parametreleriyle bir şemayı uygular.
İşte bir dizin örneği:
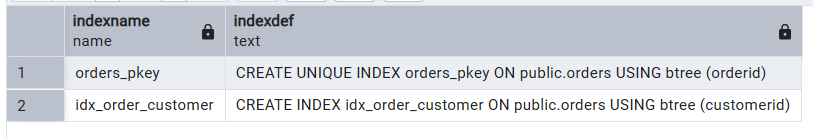
CREATE INDEX idx_order_customer ON Orders(CustomerID);Şimdi bu dizini şu sorguyla görüntüleyeceğiz:
SELECT indexname, indexdef
FROM pg_indexes
WHERE tablename = 'orders';
Aşağıdaki dizinde görülebileceği gibi idx_order_customer adlı yeni bir dizin oluşturduk.
Veri modelleme, iş ihtiyaçlarını verinin nasıl saklanacağını, ilişkilendirileceğini ve getirileceğini belirleyen teknik bir plana dönüştürmenin yapılandırılmış bir yaklaşımıdır.
İyi yapıldığında veri modelleme, yinelenmeyi azaltır, veri kalitesini iyileştirir ve gelecekteki bakımı kolaylaştırır.
Kaynak: Data Quality Dimensions Cheat Sheet
Süreç genellikle aşamalar halinde ilerler. Bunları parçalara ayıralım.
Gereksinim toplama, tüm veri modelleme sürecinin temelidir. Bu aşamada işin neye ve neden ihtiyaç duyduğunu anlamaya çalışırsınız.
Gereksinimleri etkili biçimde toplamanın birkaç yolu vardır.
Bu aşamanın çıktısı; veri varlıklarını, ilişkileri ve iş kurallarını tanımlayan net bir şekilde belgelenmiş gereksinimler kümesi olmalıdır.
Örneğin, örnek perakende veri kümemizde paydaşlar; ürün kategorisi başına toplam satışlar ve tekrar eden müşteri oranları gibi metrikleri hesaplayabilmek için müşteri siparişlerini, ürünleri ve sipariş tarihlerini takip etmek istediklerini söyleyebilir.
Kavramsal tasarım, bu iş gereksinimlerini verinin görsel, üst düzey bir temsiline dönüştürür.
Bu aşamada, teknik ayrıntılar (birincil anahtar türleri veya indeksleme stratejileri gibi) hakkında endişelenmeden hangi varlıkların bulunduğuna ve nasıl ilişkilendiklerine odaklanırsınız.
Varlık-İlişki (ER) diyagramları burada devreye girer. ER diyagramları varlıkları (ör. Customer, Product, Order), bunların özniteliklerini ve aralarındaki ilişkileri gösterir.
Veri kümemiz için:
Customer, CustomerID, Name, Email içerebilir.Product, ProductID, Name, Category içerebilir.Order, OrderID, OrderDate içerebilir.OrderItem, OrderItemID, OrderID, ProductID, Quantity, Price içerebilir.İlişkiler şu şekilde olabilir:
Bu diyagram, iş ve teknik ekipler için ortak bir başvuru noktası olur.
Mantıksal tasarım, özellikle normalizasyon olmak üzere veritabanı kurallarını uygulayarak kavramsal modelin üzerine inşa edilir.
Normalizasyon, ilişkisel bir veritabanını yinelenmeyi ve bağımlılığı en aza indirecek şekilde yapılandırma sürecidir. Genellikle her birinin belirli gereksinimleri olan aşamalarla (1NF, 2NF, 3NF) yapılır.
Örneğimizde, müşterinin e-posta adresi yalnızca Customer tablosunda bulunmalı, Order tablosunda yinelenmemelidir. Benzer şekilde, ürün kategori bilgisi Product tablosunda yer almalı, OrderItem içinde birden çok kayda dağılmamalıdır.
Fiziksel tasarım, mantıksal modeli PostgreSQL veya MySQL gibi belirli bir veritabanı sistemine uyarlar. Bu aşama, veri türleri, depolama optimizasyonu ve performans ayarlamalarıyla ilgili kararları içerir.
Dizinler burada kilit bir husustur. Örneğin, Order tablosunda OrderDate’e bir dizin eklemek, tarihe göre filtreleyen sorguları önemli ölçüde hızlandırabilir.
Büyük veri kümeleri için bölümleme de uygulanabilir; sorgu performansını iyileştirmek için veriyi tarih, aralık veya karma anahtarlarına göre yönetilebilir parçalara böler.
Ayrıca, veritabanı düzeyinde veri bütünlüğünü zorlamak için dış anahtarlar gibi kısıtlara karar verirsiniz.
Tasarım tamamlandıktan sonra, canlıya almadan önce doğrulamalar yapılmalıdır.
Bu, ideal olarak beklenen hacimleri yansıtan gerçekçi test verilerini yüklemeyi ve gerçek dünyadaki kullanımı simüle eden sorguları çalıştırmayı içerir.
Örneğin perakende veri kümemizde, ay bazında satış toplamlarını hesaplayan bir sorgu çalıştırabilir ve sayıların işletmenin bekledikleriyle eşleştiğinden emin olabilirsiniz.
Ayrıca bir siparişin öğe olmadan verilmesi gibi uç durumları da test edersiniz (kısıtlar doğruysa bu imkansız olmalıdır).
Son adım, doğrulanmış tasarımın üretime taşınmasıdır. Bu, değişikliklerin zaman içinde izlenebilmesi için sürüm kontrollü geçiş betikleri kullanılarak yapılmalıdır.
Dağıtım ayrıca performans ve hatalar için izleme kurulmasını ve gelecekteki değişikliklerin kafa karışıklığı olmadan yapılabilmesi için şemanın iyi belgelenmesini içerir.
Dağıtımdan sonra, yeni gereksinimler ortaya çıktıkça tasarımın periyodik olarak gözden geçirilmesi yaygındır.
İyi tasarlanmış bir veri modeli birçok fayda sunar.
Veri modellemenin uygulamada ileri düzey yöntemleri de olabilir.
Boyutsal modelleme, analitik sorguların sezgisel ve hızlı olmasının amaçlandığı veri ambarlarında yaygındır.
Bu, belirli şemaların kullanımını içerir:
OrderItems) metrikleri saklar; birden çok boyut tablosu (ör. Customer, Product, Date) ise tanımlayıcı öznitelikleri saklar. Bu yapı, BI araçlarının sorgulaması için kolaydır.Şöyle görünebilir:
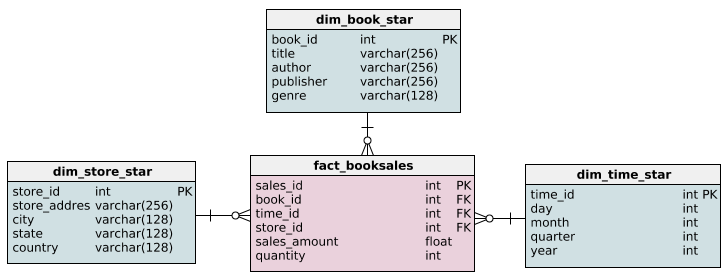
Kaynak: Yıldız şeması sorgulama
Product tablosu Product ve Category tablolara bölünebilir.ER modelleme, işlem odaklı sistemlerde daha tipiktir. Veri bütünlüğünü sağlamak için normalizasyona vurgu yapar. Bazı durumlarda, özellikle sık erişilen veriler için okuma performansını artırmak adına, seçici olarak denormalizasyon uygulanır.
Polyglot modelleme, farklı iş yükleri için farklı veritabanı türlerini kullanır.
Örneğin, sipariş işlemleri için PostgreSQL’i ve esnek özniteliklere sahip bir ürün kataloğu için MongoDB’yi kullanabilirsiniz. Bu, doğru iş için doğru aracı kullanmanıza olanak tanır; ancak operasyonel karmaşıklığı artırır.
NoSQL sistemlerinde tasarım, genellikle katı normalizasyondan ziyade erişim kalıplarına dayanır. Veri, yaygın işlemler için gereken sorgu sayısını en aza indirecek şekilde düzenlenir ve darboğazlardan kaçınmak için bölümleme esastır.
PostgreSQL gibi ilişkisel sistemler, verinin tutarlılığını güvence altına alan ACID özelliklerini tam olarak destekler. Birçok NoSQL veritabanı, hız ve ölçeklenebilirliği artırmak için bu güvenceleri gevşetir; tutarlılık yerine zamana bağlı yakınsamayı tercih eder.
Veri modelleri, veritabanı tasarımının hayati bir parçasıdır ve birçok biçim alabilir. Ancak modern işletmelerde bu modellerin en iyi performansı göstermesini sağlamak için uygun optimizasyonların yapılması gerekir.
Teknoloji sürekli evrilip güncelleniyor ve veri sektöründe sürekli öğrenme ile uyum sağlama bir ihtiyaç. Veritabanları hakkında daha fazla bilgi edinmek için Veritabanı Tasarımı veya SQL ile İlişkisel Veritabanlarına Giriş kursumuza göz atın.
Okumayı mı tercih edersiniz? Veri Modelleme Araçları veya DBMS Mülakat Soruları hakkındaki makalelerimiz faydalı olabilir.
Öne Çıkan DataCamp Kursları
Program
Program
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme




