自由度是一个常见的统计学术语,初听起来常让人觉得抽象或困惑。您或许在某本教材里见过它。
简而言之,自由度衡量的是在施加某些限制(如固定均值或总和)之后,您的数据还能有多大的“自由”去变化。如果这听起来仍有些抽象,不必担心:从下一节开始,我将详细展开,解释它为何存在,并提供清晰的示例,帮助您建立扎实的直觉。
我们所说的“自由度”是什么意思?
自由度表示在所有约束都被考虑之后,数据集或计算中可以自由变化的数值个数。
想象有人让您挑选三个数,它们的和必须正好为 30。您可以自由选择前两个数,但第三个数会被自动确定,以保证总和为 30。这样就减少了真正“自由”可变的数值个数。因此,自由度告诉我们在施加限制后,还剩下多少条彼此独立的信息。
如何求自由度
通常,自由度的计算方式为观测数 n 减去由数据估计出的约束或参数的个数。
不同的统计检验施加的约束不同,因此公式也会不同,例如单样本 t 检验中的 n-1。在实践中,您很少需要手动计算自由度,统计软件会自动完成。但理解这一基本原理将有助于您更准确地解读结果。
自由度在统计中的重要性
自由度之所以存在,是因为统计计算高度依赖估计量,例如样本均值或方差,而这些估计会“消耗”数据中的信息。因此,如果不考虑这些约束,我们对变异性的估计、置信区间、p 值等就会不准确。
一般而言,更高的自由度通常会带来更精确的估计和更窄的置信区间。自由度也出现在假设检验中,因为它决定采用哪种分布以及检验所包含的信息量,从而直接影响统计推断的可靠性。
用一个简单示例解释自由度
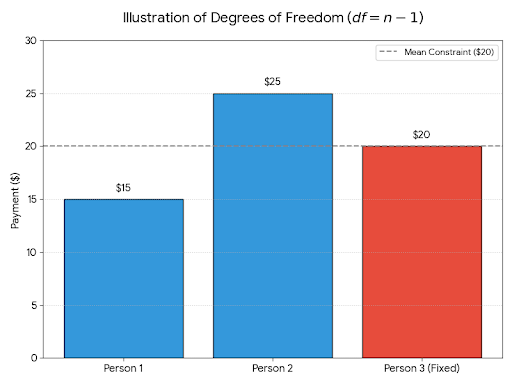
假设您和三位朋友分摊一笔 60 美元的餐费。您希望人均支付为 20 美元,因此按以下步骤进行:
- 您自由选择第一笔支付为 15 美元。
- 您自由选择第二笔支付为 25 美元。
- 第三笔支付必须为 20 美元才能保证人均 20 美元,总额因此为 60 美元。
|
人员
|
分摊金额($)
|
|
第一人
|
15
|
|
第二人
|
25
|
|
第三人
|
20
|
|
平均值
|
20
|
因此,尽管有三个数值,只有两个是自由可变的。我们说最后一个由约束(固定的均值)所决定。因此,这里的自由度等于 3-1=2。
这表明数据点的数量(3)与自由度(2)并不相同。我们说该约束“占用”了一个自由度。
常见统计检验中的自由度
本节将展示几个常见统计检验中的自由度示例,以及如何使用它们。
t 检验中的自由度
对于单样本 t 检验,自由度 = n - 1。在这种情况下,我们从数据中估计样本均值,会“占用”一个自由度。样本量越大,自由度越高,t 检验的可靠性也越强。
卡方检验中的自由度
在卡方适配度检验中,自由度 = 分类数 - 1。约束在于总观测频数必须等于总期望频数。
方差分析(ANOVA)中的自由度
在单因素方差分析(ANOVA)中,自由度在组间与组内之间拆分:组间为 k-1(k 为组数),组内为 N-k(N 为总样本量)。这同时体现了来自各组均值与总体均值的约束。
关于自由度的常见误解
本节将澄清一些关于自由度的常见误解。首先,自由度不是样本量;由于存在减少自由度的约束,自由度通常更小。
换言之,自由度也不同于变量或参数的数量。它专指在施加约束后剩余的独立信息片段个数。
另外,更高的自由度并非总是更好;在某些情境下,自由度非常高可能意味着过拟合或不切实际的假设,需要权衡。
自由度与样本量
样本量 n 是观测值的总数。虽然自由度并不等于样本量,但它深受样本量的影响。这源于自由度通常等于 n 减去约束或被估计参数的个数。因此,自由度几乎总是小于 n。二者的关系存在,是因为参数估计会对数据施加约束。
如何解读自由度
一个经验法则是:与其执着于精确计算,不如更关注这些约束究竟代表了什么。
较低的自由度意味着独立信息更少,从而导致更宽的置信区间和更低的统计功效。您应当信任软件的输出,但也要进行合理性检查,例如根据样本量和所做检验,判断报告的自由度是否合乎情理。
结语
自由度衡量的是在考虑所有约束后,您的数据中还剩下多少真正独立的信息。核心思想很简单:每当您估计一个参数或施加一条限制,就会损失一个自由度。理解这一概念能强化您的统计直觉,帮助您更有把握地解读检验结果。随着实践的积累,自由度会变得不再神秘,而更加有意义。


自由度是一个常见的统计学术语,初听起来常让人觉得抽象或困惑。您或许在某本教材里见过它。
简而言之,自由度衡量的是在施加某些限制(如固定均值或总和)之后,您的数据还能有多大的“自由”去变化。如果这听起来仍有些抽象,不必担心:从下一节开始,我将详细展开,解释它为何存在,并提供清晰的示例,帮助您建立扎实的直觉。
我们所说的“自由度”是什么意思?
自由度表示在所有约束都被考虑之后,数据集或计算中可以自由变化的数值个数。
想象有人让您挑选三个数,它们的和必须正好为 30。您可以自由选择前两个数,但第三个数会被自动确定,以保证总和为 30。这样就减少了真正“自由”可变的数值个数。因此,自由度告诉我们在施加限制后,还剩下多少条彼此独立的信息。
如何求自由度
通常,自由度的计算方式为观测数 n 减去由数据估计出的约束或参数的个数。
不同的统计检验施加的约束不同,因此公式也会不同,例如单样本 t 检验中的 n-1。在实践中,您很少需要手动计算自由度,统计软件会自动完成。但理解这一基本原理将有助于您更准确地解读结果。
自由度在统计中的重要性
自由度之所以存在,是因为统计计算高度依赖估计量,例如样本均值或方差,而这些估计会“消耗”数据中的信息。因此,如果不考虑这些约束,我们对变异性的估计、置信区间、p 值等就会不准确。
一般而言,更高的自由度通常会带来更精确的估计和更窄的置信区间。自由度也出现在假设检验中,因为它决定采用哪种分布以及检验所包含的信息量,从而直接影响统计推断的可靠性。
用一个简单示例解释自由度
假设您和三位朋友分摊一笔 60 美元的餐费。您希望人均支付为 20 美元,因此按以下步骤进行:
人员
分摊金额($)
第一人
15
第二人
25
第三人
20
平均值
20
因此,尽管有三个数值,只有两个是自由可变的。我们说最后一个由约束(固定的均值)所决定。因此,这里的自由度等于 3-1=2。
这表明数据点的数量(3)与自由度(2)并不相同。我们说该约束“占用”了一个自由度。
常见统计检验中的自由度
本节将展示几个常见统计检验中的自由度示例,以及如何使用它们。
t 检验中的自由度
对于单样本 t 检验,自由度 = n - 1。在这种情况下,我们从数据中估计样本均值,会“占用”一个自由度。样本量越大,自由度越高,t 检验的可靠性也越强。
卡方检验中的自由度
在卡方适配度检验中,自由度 = 分类数 - 1。约束在于总观测频数必须等于总期望频数。
方差分析(ANOVA)中的自由度
在单因素方差分析(ANOVA)中,自由度在组间与组内之间拆分:组间为 k-1(k 为组数),组内为 N-k(N 为总样本量)。这同时体现了来自各组均值与总体均值的约束。
关于自由度的常见误解
本节将澄清一些关于自由度的常见误解。首先,自由度不是样本量;由于存在减少自由度的约束,自由度通常更小。
换言之,自由度也不同于变量或参数的数量。它专指在施加约束后剩余的独立信息片段个数。
另外,更高的自由度并非总是更好;在某些情境下,自由度非常高可能意味着过拟合或不切实际的假设,需要权衡。
自由度与样本量
样本量 n 是观测值的总数。虽然自由度并不等于样本量,但它深受样本量的影响。这源于自由度通常等于 n 减去约束或被估计参数的个数。因此,自由度几乎总是小于 n。二者的关系存在,是因为参数估计会对数据施加约束。
如何解读自由度
一个经验法则是:与其执着于精确计算,不如更关注这些约束究竟代表了什么。
较低的自由度意味着独立信息更少,从而导致更宽的置信区间和更低的统计功效。您应当信任软件的输出,但也要进行合理性检查,例如根据样本量和所做检验,判断报告的自由度是否合乎情理。
结语
自由度衡量的是在考虑所有约束后,您的数据中还剩下多少真正独立的信息。核心思想很简单:每当您估计一个参数或施加一条限制,就会损失一个自由度。理解这一概念能强化您的统计直觉,帮助您更有把握地解读检验结果。随着实践的积累,自由度会变得不再神秘,而更加有意义。