Degrees of freedom सांख्यिकी का एक ऐसा शब्द है जो शुरुआत में अमूर्त या उलझनभरा लग सकता है। हो सकता है आपने इसे किसी पाठ्यपुस्तक में पहले से देखा हो।
संक्षेप में, degrees of freedom यह मापते हैं कि जब कुछ प्रतिबंध, जैसे कोई नियत माध्य या कुल, लगा दिए जाते हैं, तो आपके डेटा के पास बदलने की कितनी स्वतंत्रता बचती है। यदि यह अब भी उलझनभरा लगे, तो चिंता न करें: इस लेख में, अगला भाग शुरू होते ही, मैं विस्तार से समझाऊंगा। मैं बताऊंगा कि ये क्यों होते हैं, और साफ उदाहरण दूंगा ताकि आप उन्हें समझकर ठोस अंतर्दृष्टि बना सकें।
Degrees of Freedom से हमारा क्या आशय है?
Degrees of freedom उस मानों की संख्या को दर्शाते हैं जो किसी डेटा सेट या गणना में सभी बाधाओं के समायोजन के बाद स्वतंत्र रूप से बदल सकते हैं।
कल्पना कीजिए आपको ऐसे तीन संख्याएँ चुनने के लिए कहा गया है जिनका योग ठीक 30 हो। आप पहली दो संख्याएँ स्वतंत्र रूप से चुन सकते हैं, लेकिन तीसरी संख्या स्वतः 30 का कुल बनाने के लिए तय हो जाती है। इससे वे मान घट जाते हैं जो सच में स्वतंत्र रूप से बदल सकते थे। अतः degrees of freedom हमें बताते हैं कि प्रतिबंध लागू करने के बाद कितनी स्वतंत्र सूचनाएँ बची हैं।
Degrees of Freedom कैसे निकालें
सामान्यतः, degrees of freedom की गणना प्रेक्षणों की संख्या n में से बाधाओं या डेटा से अनुमानित पैरामीटरों की संख्या घटाकर की जाती है।
अलग-अलग सांख्यिकीय परीक्षण अलग-अलग प्रतिबंध लगाते हैं, इसी कारण सूत्र अलग होते हैं, जैसे एकल-सैंपल t-test के लिए n-1। व्यवहार में, आपको प्रायः degrees of freedom हाथ से नहीं निकालने पड़ते, क्योंकि सांख्यिकीय सॉफ़्टवेयर यह स्वतः करता है। फिर भी, इस सामान्य सिद्धांत को समझना परिणामों की सही व्याख्या में अवश्य मदद करता है।
सांख्यिकी में Degrees of Freedom क्यों महत्वपूर्ण हैं
Degrees of freedom इसलिए होते हैं क्योंकि सांख्यिकीय गणनाएँ बड़े पैमाने पर अनुमानों पर निर्भर करती हैं, जैसे नमूना माध्य या विचरण, जो डेटा से सूचना "खर्च" करते हैं। इसलिए यदि इन प्रतिबंधों का हिसाब न रखा जाए, तो हमारे परिवर्तनीयता के अनुमान, confidence intervals, p-values, आदि अशुद्ध हो सकते हैं।
आम तौर पर, अधिक degrees of freedom से अधिक सटीक अनुमान और संकुचित confidence intervals मिलते हैं। ये परिकल्पना परीक्षण में भी आते हैं क्योंकि वे यह निर्धारित करते हैं कि कौन-सा वितरण उपयोग करना है और परीक्षण में कितनी सूचना है। इस प्रकार, यह सांख्यिकीय निष्कर्षों की विश्वसनीयता को सीधे प्रभावित करता है।
एक सरल उदाहरण के साथ Degrees of Freedom की व्याख्या
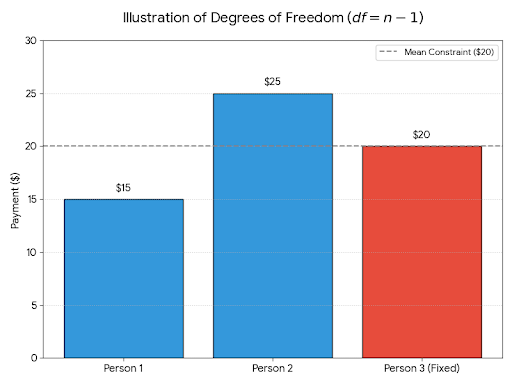
मान लीजिए आपके तीन मित्र हैं जो $60 का रेस्तरां बिल बाँट रहे हैं। आप चाहते हैं कि औसत भुगतान $20 प्रति व्यक्ति हो, तो आप ये कदम उठाते हैं:
- आप पहला भुगतान $15 स्वतंत्र रूप से चुनते हैं।
- आप दूसरा भुगतान $25 स्वतंत्र रूप से चुनते हैं।
- तीसरा भुगतान $20 होना ही चाहिए ताकि औसत $20 बने, जिससे कुल $60 हो जाता है।
|
व्यक्ति
|
योगदान ($)
|
|
पहला व्यक्ति
|
15
|
|
दूसरा व्यक्ति
|
25
|
|
तीसरा व्यक्ति
|
20
|
|
माध्य
|
20
|
तो भले ही आपके पास तीन मान हैं, केवल दो ही स्वतंत्र रूप से बदल सके। हम कहते हैं कि अंतिम मान प्रतिबंध (नियत माध्य) द्वारा निर्धारित था। इसलिए यहाँ degrees of freedom 3-1=2 के बराबर हैं।
यह दर्शाता है कि डेटा बिंदुओं की संख्या (3) degrees of freedom (2) के बराबर नहीं है। हम कहते हैं कि प्रतिबंध ने एक degree of freedom का उपयोग कर लिया।
आम सांख्यिकीय परीक्षणों में Degrees of Freedom
इस खंड में, मैं आम सांख्यिकीय परीक्षणों में degrees of freedom के कुछ उदाहरण दिखाऊंगा और उन्हें कैसे उपयोग करें, यह बताऊंगा।
t-test में degrees of freedom
एक one-sample t-test के लिए, degrees of freedom = n - 1। इस स्थिति में, एक degree of freedom इसलिए खर्च होता है क्योंकि हम डेटा से नमूना माध्य का अनुमान लगाते हैं। बड़े नमूने पर, df अधिक होते हैं और t-test अधिक विश्वसनीय होते हैं।
chi-square परीक्षणों में degrees of freedom
एक chi-square goodness-of-fit परीक्षण में degrees of freedom = श्रेणियों की संख्या - 1। यहाँ प्रतिबंध यह है कि प्रेक्षित कुल आवृत्ति अपेक्षित कुल आवृत्ति के बराबर होनी चाहिए।
ANOVA में degrees of freedom
एक-मार्ग ANOVA में, degrees of freedom को समूहों के बीच (k-1, जहाँ k समूहों की संख्या है) और समूहों के भीतर (N-k, जहाँ N=कुल नमूना आकार) बाँटा जाता है। यह समूह माध्यों और डेटा सेट के समग्र माध्य से आने वाले प्रतिबंधों को दर्शाता है।
Degrees of Freedom से जुड़ी आम भ्रांतियाँ
इस खंड में, मैं degrees of freedom के बारे में कुछ आम गलतफहमियों पर चर्चा करूंगा। सबसे पहले, degrees of freedom नमूना आकार नहीं हैं, क्योंकि प्रतिबंधों के कारण वे प्रायः छोटे होते हैं जो उन्हें घटा देते हैं।
दूसरे शब्दों में, degrees of freedom चर या पैरामीटरों की संख्या के समान नहीं होते। वे विशेष रूप से प्रतिबंध लागू करने के बाद शेष स्वतंत्र सूचनाओं की गणना करते हैं।
इसके अलावा, अधिक degrees of freedom हमेशा बेहतर नहीं होते—हमेशा एक संतुलन रहता है, क्योंकि बहुत बड़े degrees of freedom कुछ संदर्भों में overfitting या अवास्तविक मान्यताओं का संकेत दे सकते हैं।
Degrees of Freedom बनाम नमूना आकार
नमूना आकार n कुल प्रेक्षणों की संख्या है। जबकि degrees of freedom ठीक-ठीक नमूना आकार नहीं होते, वे उससे काफ़ी प्रभावित होते हैं। इसका कारण यह है कि degrees of freedom प्रायः n में से प्रतिबंधों या अनुमानित पैरामीटरों की संख्या घटाकर मिलते हैं। यही कारण है कि df लगभग हमेशा n से छोटे होते हैं। उनके बीच यह संबंध इसलिए है क्योंकि पैरामीटरों का अनुमान लगाना डेटा पर प्रतिबंध लगाता है।
Degrees of Freedom की व्याख्या कैसे करें
सामान्य सलाह यह है कि सटीक गणना पर कम, और इस पर अधिक ध्यान दें कि प्रतिबंध वास्तव में क्या दर्शाता है।
कम degrees of freedom का अर्थ है कम स्वतंत्र सूचनाएँ, जो बदले में चौड़े confidence intervals और कम सांख्यिकीय शक्ति की ओर ले जाती हैं। आपको अपने सॉफ़्टवेयर के आउटपुट पर भरोसा करना चाहिए, लेकिन सदैव यथार्थ-जांच करें, जैसे यह पूछना कि दिए गए नमूना आकार और किए जा रहे परीक्षण के संदर्भ में रिपोर्ट किए गए degrees of freedom समझ में आते हैं या नहीं।
निष्कर्ष
Degrees of freedom यह मापते हैं कि सभी प्रतिबंधों का हिसाब रखने के बाद आपके डेटा में वास्तव में कितनी स्वतंत्र सूचना उपलब्ध है। मुख्य बात सरल है: हर बार जब आप कोई पैरामीटर अनुमानित करते हैं या कोई प्रतिबंध लगाते हैं, तो आप एक degree of freedom खो देते हैं। इसलिए, इस अवधारणा को समझना आपकी सांख्यिकीय अंतर्दृष्टि को मज़बूत करता है और परीक्षण परिणामों की व्याख्या अधिक आत्मविश्वास से करने में मदद करता है। अभ्यास के साथ, degrees of freedom कहीं कम रहस्यमय और कहीं अधिक सार्थक लगेंगे।


Degrees of freedom सांख्यिकी का एक ऐसा शब्द है जो शुरुआत में अमूर्त या उलझनभरा लग सकता है। हो सकता है आपने इसे किसी पाठ्यपुस्तक में पहले से देखा हो।
संक्षेप में, degrees of freedom यह मापते हैं कि जब कुछ प्रतिबंध, जैसे कोई नियत माध्य या कुल, लगा दिए जाते हैं, तो आपके डेटा के पास बदलने की कितनी स्वतंत्रता बचती है। यदि यह अब भी उलझनभरा लगे, तो चिंता न करें: इस लेख में, अगला भाग शुरू होते ही, मैं विस्तार से समझाऊंगा। मैं बताऊंगा कि ये क्यों होते हैं, और साफ उदाहरण दूंगा ताकि आप उन्हें समझकर ठोस अंतर्दृष्टि बना सकें।
Degrees of Freedom से हमारा क्या आशय है?
Degrees of freedom उस मानों की संख्या को दर्शाते हैं जो किसी डेटा सेट या गणना में सभी बाधाओं के समायोजन के बाद स्वतंत्र रूप से बदल सकते हैं।
कल्पना कीजिए आपको ऐसे तीन संख्याएँ चुनने के लिए कहा गया है जिनका योग ठीक 30 हो। आप पहली दो संख्याएँ स्वतंत्र रूप से चुन सकते हैं, लेकिन तीसरी संख्या स्वतः 30 का कुल बनाने के लिए तय हो जाती है। इससे वे मान घट जाते हैं जो सच में स्वतंत्र रूप से बदल सकते थे। अतः degrees of freedom हमें बताते हैं कि प्रतिबंध लागू करने के बाद कितनी स्वतंत्र सूचनाएँ बची हैं।
Degrees of Freedom कैसे निकालें
सामान्यतः, degrees of freedom की गणना प्रेक्षणों की संख्या n में से बाधाओं या डेटा से अनुमानित पैरामीटरों की संख्या घटाकर की जाती है।
अलग-अलग सांख्यिकीय परीक्षण अलग-अलग प्रतिबंध लगाते हैं, इसी कारण सूत्र अलग होते हैं, जैसे एकल-सैंपल t-test के लिए n-1। व्यवहार में, आपको प्रायः degrees of freedom हाथ से नहीं निकालने पड़ते, क्योंकि सांख्यिकीय सॉफ़्टवेयर यह स्वतः करता है। फिर भी, इस सामान्य सिद्धांत को समझना परिणामों की सही व्याख्या में अवश्य मदद करता है।
सांख्यिकी में Degrees of Freedom क्यों महत्वपूर्ण हैं
Degrees of freedom इसलिए होते हैं क्योंकि सांख्यिकीय गणनाएँ बड़े पैमाने पर अनुमानों पर निर्भर करती हैं, जैसे नमूना माध्य या विचरण, जो डेटा से सूचना "खर्च" करते हैं। इसलिए यदि इन प्रतिबंधों का हिसाब न रखा जाए, तो हमारे परिवर्तनीयता के अनुमान, confidence intervals, p-values, आदि अशुद्ध हो सकते हैं।
आम तौर पर, अधिक degrees of freedom से अधिक सटीक अनुमान और संकुचित confidence intervals मिलते हैं। ये परिकल्पना परीक्षण में भी आते हैं क्योंकि वे यह निर्धारित करते हैं कि कौन-सा वितरण उपयोग करना है और परीक्षण में कितनी सूचना है। इस प्रकार, यह सांख्यिकीय निष्कर्षों की विश्वसनीयता को सीधे प्रभावित करता है।
एक सरल उदाहरण के साथ Degrees of Freedom की व्याख्या
मान लीजिए आपके तीन मित्र हैं जो $60 का रेस्तरां बिल बाँट रहे हैं। आप चाहते हैं कि औसत भुगतान $20 प्रति व्यक्ति हो, तो आप ये कदम उठाते हैं:
व्यक्ति
योगदान ($)
पहला व्यक्ति
15
दूसरा व्यक्ति
25
तीसरा व्यक्ति
20
माध्य
20
तो भले ही आपके पास तीन मान हैं, केवल दो ही स्वतंत्र रूप से बदल सके। हम कहते हैं कि अंतिम मान प्रतिबंध (नियत माध्य) द्वारा निर्धारित था। इसलिए यहाँ degrees of freedom 3-1=2 के बराबर हैं।
यह दर्शाता है कि डेटा बिंदुओं की संख्या (3) degrees of freedom (2) के बराबर नहीं है। हम कहते हैं कि प्रतिबंध ने एक degree of freedom का उपयोग कर लिया।
आम सांख्यिकीय परीक्षणों में Degrees of Freedom
इस खंड में, मैं आम सांख्यिकीय परीक्षणों में degrees of freedom के कुछ उदाहरण दिखाऊंगा और उन्हें कैसे उपयोग करें, यह बताऊंगा।
t-test में degrees of freedom
एक one-sample t-test के लिए, degrees of freedom = n - 1। इस स्थिति में, एक degree of freedom इसलिए खर्च होता है क्योंकि हम डेटा से नमूना माध्य का अनुमान लगाते हैं। बड़े नमूने पर, df अधिक होते हैं और t-test अधिक विश्वसनीय होते हैं।
chi-square परीक्षणों में degrees of freedom
एक chi-square goodness-of-fit परीक्षण में degrees of freedom = श्रेणियों की संख्या - 1। यहाँ प्रतिबंध यह है कि प्रेक्षित कुल आवृत्ति अपेक्षित कुल आवृत्ति के बराबर होनी चाहिए।
ANOVA में degrees of freedom
एक-मार्ग ANOVA में, degrees of freedom को समूहों के बीच (k-1, जहाँ k समूहों की संख्या है) और समूहों के भीतर (N-k, जहाँ N=कुल नमूना आकार) बाँटा जाता है। यह समूह माध्यों और डेटा सेट के समग्र माध्य से आने वाले प्रतिबंधों को दर्शाता है।
Degrees of Freedom से जुड़ी आम भ्रांतियाँ
इस खंड में, मैं degrees of freedom के बारे में कुछ आम गलतफहमियों पर चर्चा करूंगा। सबसे पहले, degrees of freedom नमूना आकार नहीं हैं, क्योंकि प्रतिबंधों के कारण वे प्रायः छोटे होते हैं जो उन्हें घटा देते हैं।
दूसरे शब्दों में, degrees of freedom चर या पैरामीटरों की संख्या के समान नहीं होते। वे विशेष रूप से प्रतिबंध लागू करने के बाद शेष स्वतंत्र सूचनाओं की गणना करते हैं।
इसके अलावा, अधिक degrees of freedom हमेशा बेहतर नहीं होते—हमेशा एक संतुलन रहता है, क्योंकि बहुत बड़े degrees of freedom कुछ संदर्भों में overfitting या अवास्तविक मान्यताओं का संकेत दे सकते हैं।
Degrees of Freedom बनाम नमूना आकार
नमूना आकार n कुल प्रेक्षणों की संख्या है। जबकि degrees of freedom ठीक-ठीक नमूना आकार नहीं होते, वे उससे काफ़ी प्रभावित होते हैं। इसका कारण यह है कि degrees of freedom प्रायः n में से प्रतिबंधों या अनुमानित पैरामीटरों की संख्या घटाकर मिलते हैं। यही कारण है कि df लगभग हमेशा n से छोटे होते हैं। उनके बीच यह संबंध इसलिए है क्योंकि पैरामीटरों का अनुमान लगाना डेटा पर प्रतिबंध लगाता है।
Degrees of Freedom की व्याख्या कैसे करें
सामान्य सलाह यह है कि सटीक गणना पर कम, और इस पर अधिक ध्यान दें कि प्रतिबंध वास्तव में क्या दर्शाता है।
कम degrees of freedom का अर्थ है कम स्वतंत्र सूचनाएँ, जो बदले में चौड़े confidence intervals और कम सांख्यिकीय शक्ति की ओर ले जाती हैं। आपको अपने सॉफ़्टवेयर के आउटपुट पर भरोसा करना चाहिए, लेकिन सदैव यथार्थ-जांच करें, जैसे यह पूछना कि दिए गए नमूना आकार और किए जा रहे परीक्षण के संदर्भ में रिपोर्ट किए गए degrees of freedom समझ में आते हैं या नहीं।
निष्कर्ष
Degrees of freedom यह मापते हैं कि सभी प्रतिबंधों का हिसाब रखने के बाद आपके डेटा में वास्तव में कितनी स्वतंत्र सूचना उपलब्ध है। मुख्य बात सरल है: हर बार जब आप कोई पैरामीटर अनुमानित करते हैं या कोई प्रतिबंध लगाते हैं, तो आप एक degree of freedom खो देते हैं। इसलिए, इस अवधारणा को समझना आपकी सांख्यिकीय अंतर्दृष्टि को मज़बूत करता है और परीक्षण परिणामों की व्याख्या अधिक आत्मविश्वास से करने में मदद करता है। अभ्यास के साथ, degrees of freedom कहीं कम रहस्यमय और कहीं अधिक सार्थक लगेंगे।