Serbestlik dereceleri, ilk bakışta soyut ya da kafa karıştırıcı gelebilen o istatistiksel terimlerden biridir. Bu terimi muhtemelen bir ders kitabında zaten duymuş olabilirsiniz.
Kısa cevap şu: Serbestlik dereceleri, sabit bir ortalama ya da toplam gibi belirli kısıtlar uygulandıktan sonra verilerinizin ne kadar serbestçe değişebileceğini ölçer. Kulağa kafa karıştırıcı geliyorsa endişelenmeyin: Bu makalede, bir sonraki bölümden itibaren ayrıntılı olarak açıklayacağım. Neden var olduklarını anlatacak ve üzerinde çalışıp sağlam bir sezgi geliştirebilmeniz için net örnekler sunacağım.
Serbestlik Derecesinden Ne Kastediyoruz?
Serbestlik dereceleri, tüm kısıtlar dikkate alındıktan sonra bir veri kümesinde veya bir hesaplamada serbestçe değişebilen değerlerin sayısını ifade eder.
Diyelim ki toplamı tam olarak 30 olacak şekilde üç sayı seçmeniz istendi. İlk iki sayıyı özgürce seçebilirsiniz, ancak toplamı 30 yapmak için üçüncü sayı otomatik olarak sabitlenir. Bu da gerçekten serbestçe değişebilen değerlerin sayısını azaltır. Dolayısıyla serbestlik dereceleri, kısıtlar uygulandıktan sonra geriye kaç bağımsız bilgi parçası kaldığını söyler.
Serbestlik Derecesi Nasıl Bulunur?
Genel olarak, serbestlik derecesi, gözlem sayısı n’den verilerden tahmin edilen kısıt ya da parametre sayısının çıkarılmasıyla hesaplanır.
Farklı istatistiksel testler farklı kısıtlar uygular; bu yüzden formüller değişir, tek örneklem t-testindeki n-1 ifadesinde olduğu gibi. Pratikte serbestlik derecelerini elle hesaplamanız nadiren gerekir; istatistik yazılımları bunu otomatik yapar. Ancak genel ilkeleri anlamak, sonuçları doğru yorumlamanıza kaçınılmaz olarak yardımcı olacaktır.
İstatistikte Serbestlik Dereceleri Neden Önemlidir?
Serbestlik dereceleri vardır çünkü istatistiksel hesaplamalar, verilerden elde edilen örneklem ortalaması ya da varyans gibi tahminlere büyük ölçüde dayanır ve bunlar verideki bilgiyi tüketir. Dolayısıyla bu kısıtlar hesaba katılmadan değişkenlik tahminlerimiz, güven aralıklarımız, p-değerlerimiz ve benzerleri hatalı olurdu.
Genel olarak konuşursak, daha yüksek serbestlik dereceleri çoğunlukla daha hassas tahminlere ve daha dar güven aralıklarına yol açar. Hipotez testlerinde de karşımıza çıkarlar çünkü hangi dağılımın kullanılacağını ve testin ne kadar bilgiye sahip olduğunu belirlerler. Böylece, istatistiksel çıkarımın güvenilirliğini doğrudan etkilerler.
Basit Bir Örnekle Serbestlik Dereceleri
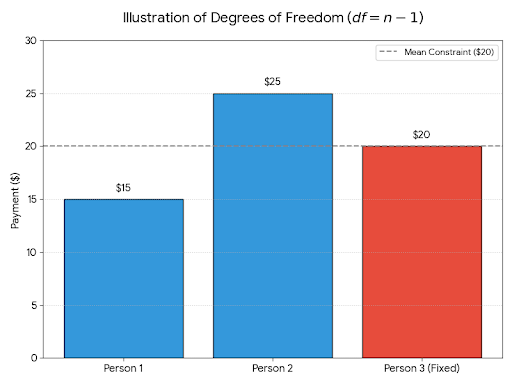
Üç arkadaşınızın 60 $ tutarındaki bir restoran hesabını paylaştığını varsayalım. Kişi başı ortalama ödemenin 20 $ olmasını istiyorsunuz, bu nedenle şu adımları izliyorsunuz:
- İlk ödemeyi 15 $ olarak özgürce seçiyorsunuz.
- İkinci ödemeyi 25 $ olarak özgürce seçiyorsunuz.
- Ortalamanın 20 $ olması için üçüncü ödemenin 20 $ olması gerekir, bu da toplamı 60 $ yapar.
|
Kişi
|
Katkı ($)
|
|
Birinci Kişi
|
15
|
|
İkinci Kişi
|
25
|
|
Üçüncü Kişi
|
20
|
|
Ortalama
|
20
|
Yani üç değere sahip olmanıza rağmen yalnızca ikisi serbestçe değişebildi. Sonuncusunun kısıt tarafından (sabit ortalama) belirlendiğini söyleriz. Bu nedenle burada serbestlik derecesi 3-1=2’dir.
Bu, veri noktası sayısının (3) serbestlik derecesiyle (2) aynı olmadığını gösterir. Kısıtın bir serbestlik derecesini tükettiğini söyleriz.
Yaygın İstatistiksel Testlerde Serbestlik Dereceleri
Bu bölümde, yaygın istatistiksel testlerde serbestlik derecelerine ve bunların nasıl kullanıldığına dair bazı örnekler göstereceğim.
t-testinde serbestlik dereceleri
Bir tek örneklem t-testinde serbestlik derecesi = n - 1’dir. Bu durumda, örneklem ortalamasını veriden tahmin ettiğimiz için bir serbestlik derecesi tüketilir. Örneklem boyutu büyüdükçe daha yüksek sd’ye (df) ve daha güvenilir t-testlerine ulaşılır.
Ki-kare testlerinde serbestlik dereceleri
Bir ki-kare uygunluk testinde serbestlik derecesi = kategori sayısı - 1’dir. Dolayısıyla kısıt, gözlenen toplam frekansın beklenen toplam frekansa eşit olmasıdır.
ANOVA’da serbestlik dereceleri
Tek yönlü ANOVA’da serbestlik dereceleri, gruplar arası (k-1, burada k grup sayısı) ve grup içi (N-k, burada N=toplam örneklem büyüklüğü) olarak bölünür. Bu, hem grup ortalamalarından hem de veri kümesinin genel ortalamasından kaynaklanan kısıtları gösterir.
Serbestlik Dereceleri Hakkındaki Yaygın Yanılgılar
Bu bölümde, serbestlik dereceleriyle ilgili en yaygın yanlış kanıları ele alacağım. Her şeyden önce, serbestlik dereceleri örneklem büyüklüğü değildir; çünkü onları azaltan kısıtlar nedeniyle genellikle daha küçüktür.
Başka bir deyişle, serbestlik dereceleri, değişken veya parametre sayısıyla aynı şey değildir. Özellikle, kısıtlardan sonra kalan bağımsız bilgi parçalarını sayarlar.
Ayrıca, daha yüksek serbestlik dereceleri her zaman daha iyi değildir; bazı bağlamlarda çok büyük serbestlik dereceleri aşırı uyuma (overfitting) ya da gerçekçi olmayan varsayımlara işaret edebilir, her zaman bir ödünleşim vardır.
Serbestlik Dereceleri ve Örneklem Büyüklüğü
Örneklem büyüklüğü n, toplam gözlem sayısıdır. Serbestlik dereceleri tam olarak örneklem büyüklüğü olmasa da ondan güçlü biçimde etkilenir. Bunun nedeni, serbestlik derecelerinin tipik olarak n’den kısıt ya da tahmin edilen parametre sayısının çıkarılmasıyla elde edilmesidir. Bu yüzden sd (df) n’den neredeyse her zaman küçüktür. Aralarındaki ilişki, parametrelerin tahmin edilmesinin veriye kısıtlar getirmesinden kaynaklanır.
Serbestlik Dereceleri Nasıl Yorumlanır?
Genel kural, kesin hesaplamaya daha az, kısıtın gerçekte neyi temsil ettiğine daha çok odaklanmaktır.
Düşük serbestlik dereceleri daha az bağımsız bilgi parçası demektir; bu da daha geniş güven aralıklarına ve daha düşük istatistiksel güce yol açar. Yazılımınızın çıktısına güvenmelisiniz, ancak her zaman sağduyu kontrolleri yapın; örneğin, raporlanan serbestlik derecelerinin, örneklem büyüklüğünüz ve uygulanan test göz önüne alındığında mantıklı olup olmadığını sorgulayın.
Sonuç
Serbestlik dereceleri, tüm kısıtlar hesaba katıldıktan sonra verinizde gerçekten ne kadar bağımsız bilgi kaldığını ölçer. Aklınızda tutmanız gereken ana fikir basittir: Her parametre tahmininde ya da her kısıt uygulandığında bir serbestlik derecesi kaybedersiniz. Bu kavramı anlamak, istatistiksel sezginizi güçlendirir ve test sonuçlarını daha büyük bir güvenle yorumlamanıza yardımcı olur. Pratik yaptıkça, serbestlik dereceleri çok daha az gizemli ve çok daha anlamlı gelecektir.






Serbestlik dereceleri, ilk bakışta soyut ya da kafa karıştırıcı gelebilen o istatistiksel terimlerden biridir. Bu terimi muhtemelen bir ders kitabında zaten duymuş olabilirsiniz.
Kısa cevap şu: Serbestlik dereceleri, sabit bir ortalama ya da toplam gibi belirli kısıtlar uygulandıktan sonra verilerinizin ne kadar serbestçe değişebileceğini ölçer. Kulağa kafa karıştırıcı geliyorsa endişelenmeyin: Bu makalede, bir sonraki bölümden itibaren ayrıntılı olarak açıklayacağım. Neden var olduklarını anlatacak ve üzerinde çalışıp sağlam bir sezgi geliştirebilmeniz için net örnekler sunacağım.
Serbestlik Derecesinden Ne Kastediyoruz?
Serbestlik dereceleri, tüm kısıtlar dikkate alındıktan sonra bir veri kümesinde veya bir hesaplamada serbestçe değişebilen değerlerin sayısını ifade eder.
Diyelim ki toplamı tam olarak 30 olacak şekilde üç sayı seçmeniz istendi. İlk iki sayıyı özgürce seçebilirsiniz, ancak toplamı 30 yapmak için üçüncü sayı otomatik olarak sabitlenir. Bu da gerçekten serbestçe değişebilen değerlerin sayısını azaltır. Dolayısıyla serbestlik dereceleri, kısıtlar uygulandıktan sonra geriye kaç bağımsız bilgi parçası kaldığını söyler.
Serbestlik Derecesi Nasıl Bulunur?
Genel olarak, serbestlik derecesi, gözlem sayısı n’den verilerden tahmin edilen kısıt ya da parametre sayısının çıkarılmasıyla hesaplanır.
Farklı istatistiksel testler farklı kısıtlar uygular; bu yüzden formüller değişir, tek örneklem t-testindeki n-1 ifadesinde olduğu gibi. Pratikte serbestlik derecelerini elle hesaplamanız nadiren gerekir; istatistik yazılımları bunu otomatik yapar. Ancak genel ilkeleri anlamak, sonuçları doğru yorumlamanıza kaçınılmaz olarak yardımcı olacaktır.
İstatistikte Serbestlik Dereceleri Neden Önemlidir?
Serbestlik dereceleri vardır çünkü istatistiksel hesaplamalar, verilerden elde edilen örneklem ortalaması ya da varyans gibi tahminlere büyük ölçüde dayanır ve bunlar verideki bilgiyi tüketir. Dolayısıyla bu kısıtlar hesaba katılmadan değişkenlik tahminlerimiz, güven aralıklarımız, p-değerlerimiz ve benzerleri hatalı olurdu.
Genel olarak konuşursak, daha yüksek serbestlik dereceleri çoğunlukla daha hassas tahminlere ve daha dar güven aralıklarına yol açar. Hipotez testlerinde de karşımıza çıkarlar çünkü hangi dağılımın kullanılacağını ve testin ne kadar bilgiye sahip olduğunu belirlerler. Böylece, istatistiksel çıkarımın güvenilirliğini doğrudan etkilerler.
Basit Bir Örnekle Serbestlik Dereceleri
Üç arkadaşınızın 60 $ tutarındaki bir restoran hesabını paylaştığını varsayalım. Kişi başı ortalama ödemenin 20 $ olmasını istiyorsunuz, bu nedenle şu adımları izliyorsunuz:
Kişi
Katkı ($)
Birinci Kişi
15
İkinci Kişi
25
Üçüncü Kişi
20
Ortalama
20
Yani üç değere sahip olmanıza rağmen yalnızca ikisi serbestçe değişebildi. Sonuncusunun kısıt tarafından (sabit ortalama) belirlendiğini söyleriz. Bu nedenle burada serbestlik derecesi 3-1=2’dir.
Bu, veri noktası sayısının (3) serbestlik derecesiyle (2) aynı olmadığını gösterir. Kısıtın bir serbestlik derecesini tükettiğini söyleriz.
Yaygın İstatistiksel Testlerde Serbestlik Dereceleri
Bu bölümde, yaygın istatistiksel testlerde serbestlik derecelerine ve bunların nasıl kullanıldığına dair bazı örnekler göstereceğim.
t-testinde serbestlik dereceleri
Bir tek örneklem t-testinde serbestlik derecesi = n - 1’dir. Bu durumda, örneklem ortalamasını veriden tahmin ettiğimiz için bir serbestlik derecesi tüketilir. Örneklem boyutu büyüdükçe daha yüksek sd’ye (df) ve daha güvenilir t-testlerine ulaşılır.
Ki-kare testlerinde serbestlik dereceleri
Bir ki-kare uygunluk testinde serbestlik derecesi = kategori sayısı - 1’dir. Dolayısıyla kısıt, gözlenen toplam frekansın beklenen toplam frekansa eşit olmasıdır.
ANOVA’da serbestlik dereceleri
Tek yönlü ANOVA’da serbestlik dereceleri, gruplar arası (k-1, burada k grup sayısı) ve grup içi (N-k, burada N=toplam örneklem büyüklüğü) olarak bölünür. Bu, hem grup ortalamalarından hem de veri kümesinin genel ortalamasından kaynaklanan kısıtları gösterir.
Serbestlik Dereceleri Hakkındaki Yaygın Yanılgılar
Bu bölümde, serbestlik dereceleriyle ilgili en yaygın yanlış kanıları ele alacağım. Her şeyden önce, serbestlik dereceleri örneklem büyüklüğü değildir; çünkü onları azaltan kısıtlar nedeniyle genellikle daha küçüktür.
Başka bir deyişle, serbestlik dereceleri, değişken veya parametre sayısıyla aynı şey değildir. Özellikle, kısıtlardan sonra kalan bağımsız bilgi parçalarını sayarlar.
Ayrıca, daha yüksek serbestlik dereceleri her zaman daha iyi değildir; bazı bağlamlarda çok büyük serbestlik dereceleri aşırı uyuma (overfitting) ya da gerçekçi olmayan varsayımlara işaret edebilir, her zaman bir ödünleşim vardır.
Serbestlik Dereceleri ve Örneklem Büyüklüğü
Örneklem büyüklüğü n, toplam gözlem sayısıdır. Serbestlik dereceleri tam olarak örneklem büyüklüğü olmasa da ondan güçlü biçimde etkilenir. Bunun nedeni, serbestlik derecelerinin tipik olarak n’den kısıt ya da tahmin edilen parametre sayısının çıkarılmasıyla elde edilmesidir. Bu yüzden sd (df) n’den neredeyse her zaman küçüktür. Aralarındaki ilişki, parametrelerin tahmin edilmesinin veriye kısıtlar getirmesinden kaynaklanır.
Serbestlik Dereceleri Nasıl Yorumlanır?
Genel kural, kesin hesaplamaya daha az, kısıtın gerçekte neyi temsil ettiğine daha çok odaklanmaktır.
Düşük serbestlik dereceleri daha az bağımsız bilgi parçası demektir; bu da daha geniş güven aralıklarına ve daha düşük istatistiksel güce yol açar. Yazılımınızın çıktısına güvenmelisiniz, ancak her zaman sağduyu kontrolleri yapın; örneğin, raporlanan serbestlik derecelerinin, örneklem büyüklüğünüz ve uygulanan test göz önüne alındığında mantıklı olup olmadığını sorgulayın.
Sonuç
Serbestlik dereceleri, tüm kısıtlar hesaba katıldıktan sonra verinizde gerçekten ne kadar bağımsız bilgi kaldığını ölçer. Aklınızda tutmanız gereken ana fikir basittir: Her parametre tahmininde ya da her kısıt uygulandığında bir serbestlik derecesi kaybedersiniz. Bu kavramı anlamak, istatistiksel sezginizi güçlendirir ve test sonuçlarını daha büyük bir güvenle yorumlamanıza yardımcı olur. Pratik yaptıkça, serbestlik dereceleri çok daha az gizemli ve çok daha anlamlı gelecektir.