Vrijheidsgraden zijn zo’n statistische term die in eerste instantie vaak abstract of verwarrend klinkt. Misschien heb je de term al eens in een leerboek gezien.
Het korte antwoord is dat vrijheidsgraden meten hoeveel vrijheid je data heeft om te variëren zodra bepaalde beperkingen, zoals een vast gemiddelde of een vast totaal, worden opgelegd. Klinkt dat nog steeds vaag? Geen zorgen: in dit artikel, vanaf de volgende sectie, ga ik er stap voor stap op in. Ik leg uit waarom ze bestaan en geef duidelijke voorbeelden zodat je ze kunt bestuderen en een stevige intuïtie kunt opbouwen.
Wat bedoelen we met vrijheidsgraden?
Vrijheidsgraden staan voor het aantal waarden in een dataset of berekening die vrij kunnen variëren zodra alle beperkingen zijn meegenomen.
Stel, je moet drie getallen kiezen die samen precies 30 zijn. Je kunt de eerste twee getallen vrij kiezen, maar het derde getal ligt automatisch vast om het totaal 30 te maken. Hierdoor daalt het aantal waarden dat echt vrij kan variëren. Vrijheidsgraden vertellen ons dus hoeveel onafhankelijke stukjes informatie er overblijven na het toepassen van de beperkingen.
Hoe vind je vrijheidsgraden
In het algemeen bereken je vrijheidsgraden als het aantal observaties n min het aantal beperkingen of parameters die uit de data worden geschat.
Verschillende statistische toetsen leggen verschillende beperkingen op, waardoor de formules variëren, zoals n-1 bij een one-sample t-test. In de praktijk hoef je vrijheidsgraden zelden handmatig te berekenen, want statistische software doet dit automatisch. Maar het begrijpen van het algemene principe helpt je onvermijdelijk om de resultaten correct te interpreteren.
Waarom vrijheidsgraden ertoe doen in de statistiek
Vrijheidsgraden bestaan omdat statistische berekeningen sterk leunen op schattingen, zoals het steekproefgemiddelde of de variantie, die informatie uit de data verbruiken. Zonder rekening te houden met deze beperkingen zouden onze schattingen van spreiding, betrouwbaarheidsintervallen, p-waarden en andere maten onnauwkeurig zijn.
Algemeen gesproken leiden hogere vrijheidsgraden meestal tot preciesere schattingen en smallere betrouwbaarheidsintervallen. Ze komen ook voor bij hypothesetoetsen, omdat ze bepalen welke verdeling je gebruikt en hoeveel informatie de toets heeft. Dit beïnvloedt direct de betrouwbaarheid van de statistische gevolgtrekking.
Vrijheidsgraden uitgelegd met een eenvoudig voorbeeld
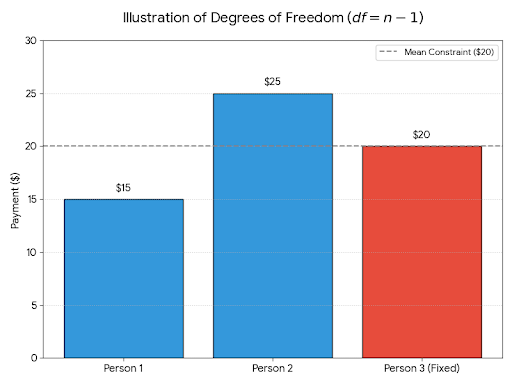
Stel, je hebt drie vrienden die samen een restaurantrekening van $60 delen. Je wilt dat de gemiddelde betaling $20 per persoon is, dus je volgt de volgende stappen:
- Je kiest vrij de eerste betaling van $15.
- Je kiest vrij de tweede betaling van $25.
- De derde betaling moet $20 zijn om het gemiddelde op $20 te krijgen, wat leidt tot een totaal van $60.
|
Persoon
|
Bijdrage ($)
|
|
Eerste persoon
|
15
|
|
Tweede persoon
|
25
|
|
Derde persoon
|
20
|
|
Gemiddelde
|
20
|
Dus ook al heb je drie waarden, slechts twee waren vrij om te variëren. We zeggen dat de laatste werd bepaald door de beperking (het vaste gemiddelde). Daarom zijn de vrijheidsgraden hier gelijk aan 3-1=2.
Dit laat zien dat het aantal datapunten (3) niet hetzelfde is als de vrijheidsgraden (2). We zeggen dat de beperking één vrijheids-graad opslokt.
Vrijheidsgraden in gangbare statistische toetsen
In deze sectie laat ik enkele voorbeelden zien van vrijheidsgraden in veelgebruikte statistische toetsen en hoe je ze gebruikt.
Vrijheidsgraden in een t-test
Voor een one-sample t-test geldt: vrijheidsgraden = n - 1. In dit geval gaat er één vrijheids-graad op omdat we het steekproefgemiddelde uit de data schatten. Bij een grotere steekproefomvang krijg je hogere df met betrouwbaardere t-tests.
Vrijheidsgraden in chi-kwadraattoetsen
Bij een chi-kwadraat goodness-of-fit-toets geldt: vrijheidsgraden = aantal categorieën - 1. De beperking is dus dat de totale geobserveerde frequentie gelijk moet zijn aan de totale verwachte frequentie.
Vrijheidsgraden in ANOVA
Bij éénweg-ANOVA worden de vrijheidsgraden opgesplitst in tussen groepen (k-1, waarbij k het aantal groepen is) en binnen groepen (N-k, waarbij N=totale steekproefgrootte). Dit weerspiegelt de beperkingen door zowel de groepsgemiddelden als het algemene gemiddelde van de dataset.
Veelvoorkomende misvattingen over vrijheidsgraden
In deze sectie bespreek ik enkele van de meest voorkomende misvattingen over vrijheidsgraden. Allereerst: vrijheidsgraden zijn niet de steekproefgrootte, want de vrijheidsgraden zijn meestal kleiner door de beperkingen die ze verminderen.
Met andere woorden, vrijheidsgraden zijn niet hetzelfde als het aantal variabelen of parameters. Ze tellen specifiek de onafhankelijke stukjes informatie na toepassing van de beperkingen.
Bovendien zijn hogere vrijheidsgraden niet altijd beter; er is altijd een afruil, omdat zeer hoge vrijheidsgraden in sommige contexten kunnen wijzen op overfitting of onrealistische aannames.
Vrijheidsgraden vs. steekproefgrootte
De steekproefgrootte n is het totale aantal observaties. Hoewel de vrijheidsgraden niet exact de steekproefgrootte zijn, worden ze er sterk door beïnvloed. Dat komt doordat vrijheidsgraden typisch n min het aantal beperkingen of geschatte parameters zijn. Daarom is df bijna altijd kleiner dan n. De relatie tussen beide bestaat omdat het schatten van parameters beperkingen op de data oplegt.
Hoe interpreteer je vrijheidsgraden
De vuistregel is om je minder te focussen op de exacte berekening en meer op wat de beperking daadwerkelijk voorstelt.
Lage vrijheidsgraden betekenen minder onafhankelijke stukjes informatie, wat op zijn beurt leidt tot bredere betrouwbaarheidsintervallen en minder statistische power. Vertrouw op de output van je software, maar doe altijd sanity checks, zoals jezelf afvragen of de gerapporteerde vrijheidsgraden logisch zijn gegeven je steekproefgrootte en de uitgevoerde toets.
Conclusie
Vrijheidsgraden meten hoeveel echt onafhankelijke informatie er in je data beschikbaar is nadat je alle beperkingen hebt meegenomen. Het belangrijkste om te onthouden is simpel: elke keer dat je een parameter schat of een beperking oplegt, verlies je één vrijheids-graad. Inzicht in dit concept versterkt je statistische intuïtie en helpt je toetsresultaten met meer vertrouwen te interpreteren. Met oefening voelen vrijheidsgraden veel minder mysterieus en juist veel betekenisvoller.


Vrijheidsgraden zijn zo’n statistische term die in eerste instantie vaak abstract of verwarrend klinkt. Misschien heb je de term al eens in een leerboek gezien.
Het korte antwoord is dat vrijheidsgraden meten hoeveel vrijheid je data heeft om te variëren zodra bepaalde beperkingen, zoals een vast gemiddelde of een vast totaal, worden opgelegd. Klinkt dat nog steeds vaag? Geen zorgen: in dit artikel, vanaf de volgende sectie, ga ik er stap voor stap op in. Ik leg uit waarom ze bestaan en geef duidelijke voorbeelden zodat je ze kunt bestuderen en een stevige intuïtie kunt opbouwen.
Wat bedoelen we met vrijheidsgraden?
Vrijheidsgraden staan voor het aantal waarden in een dataset of berekening die vrij kunnen variëren zodra alle beperkingen zijn meegenomen.
Stel, je moet drie getallen kiezen die samen precies 30 zijn. Je kunt de eerste twee getallen vrij kiezen, maar het derde getal ligt automatisch vast om het totaal 30 te maken. Hierdoor daalt het aantal waarden dat echt vrij kan variëren. Vrijheidsgraden vertellen ons dus hoeveel onafhankelijke stukjes informatie er overblijven na het toepassen van de beperkingen.
Hoe vind je vrijheidsgraden
In het algemeen bereken je vrijheidsgraden als het aantal observaties n min het aantal beperkingen of parameters die uit de data worden geschat.
Verschillende statistische toetsen leggen verschillende beperkingen op, waardoor de formules variëren, zoals n-1 bij een one-sample t-test. In de praktijk hoef je vrijheidsgraden zelden handmatig te berekenen, want statistische software doet dit automatisch. Maar het begrijpen van het algemene principe helpt je onvermijdelijk om de resultaten correct te interpreteren.
Waarom vrijheidsgraden ertoe doen in de statistiek
Vrijheidsgraden bestaan omdat statistische berekeningen sterk leunen op schattingen, zoals het steekproefgemiddelde of de variantie, die informatie uit de data verbruiken. Zonder rekening te houden met deze beperkingen zouden onze schattingen van spreiding, betrouwbaarheidsintervallen, p-waarden en andere maten onnauwkeurig zijn.
Algemeen gesproken leiden hogere vrijheidsgraden meestal tot preciesere schattingen en smallere betrouwbaarheidsintervallen. Ze komen ook voor bij hypothesetoetsen, omdat ze bepalen welke verdeling je gebruikt en hoeveel informatie de toets heeft. Dit beïnvloedt direct de betrouwbaarheid van de statistische gevolgtrekking.
Vrijheidsgraden uitgelegd met een eenvoudig voorbeeld
Stel, je hebt drie vrienden die samen een restaurantrekening van $60 delen. Je wilt dat de gemiddelde betaling $20 per persoon is, dus je volgt de volgende stappen:
Persoon
Bijdrage ($)
Eerste persoon
15
Tweede persoon
25
Derde persoon
20
Gemiddelde
20
Dus ook al heb je drie waarden, slechts twee waren vrij om te variëren. We zeggen dat de laatste werd bepaald door de beperking (het vaste gemiddelde). Daarom zijn de vrijheidsgraden hier gelijk aan 3-1=2.
Dit laat zien dat het aantal datapunten (3) niet hetzelfde is als de vrijheidsgraden (2). We zeggen dat de beperking één vrijheids-graad opslokt.
Vrijheidsgraden in gangbare statistische toetsen
In deze sectie laat ik enkele voorbeelden zien van vrijheidsgraden in veelgebruikte statistische toetsen en hoe je ze gebruikt.
Vrijheidsgraden in een t-test
Voor een one-sample t-test geldt: vrijheidsgraden = n - 1. In dit geval gaat er één vrijheids-graad op omdat we het steekproefgemiddelde uit de data schatten. Bij een grotere steekproefomvang krijg je hogere df met betrouwbaardere t-tests.
Vrijheidsgraden in chi-kwadraattoetsen
Bij een chi-kwadraat goodness-of-fit-toets geldt: vrijheidsgraden = aantal categorieën - 1. De beperking is dus dat de totale geobserveerde frequentie gelijk moet zijn aan de totale verwachte frequentie.
Vrijheidsgraden in ANOVA
Bij éénweg-ANOVA worden de vrijheidsgraden opgesplitst in tussen groepen (k-1, waarbij k het aantal groepen is) en binnen groepen (N-k, waarbij N=totale steekproefgrootte). Dit weerspiegelt de beperkingen door zowel de groepsgemiddelden als het algemene gemiddelde van de dataset.
Veelvoorkomende misvattingen over vrijheidsgraden
In deze sectie bespreek ik enkele van de meest voorkomende misvattingen over vrijheidsgraden. Allereerst: vrijheidsgraden zijn niet de steekproefgrootte, want de vrijheidsgraden zijn meestal kleiner door de beperkingen die ze verminderen.
Met andere woorden, vrijheidsgraden zijn niet hetzelfde als het aantal variabelen of parameters. Ze tellen specifiek de onafhankelijke stukjes informatie na toepassing van de beperkingen.
Bovendien zijn hogere vrijheidsgraden niet altijd beter; er is altijd een afruil, omdat zeer hoge vrijheidsgraden in sommige contexten kunnen wijzen op overfitting of onrealistische aannames.
Vrijheidsgraden vs. steekproefgrootte
De steekproefgrootte n is het totale aantal observaties. Hoewel de vrijheidsgraden niet exact de steekproefgrootte zijn, worden ze er sterk door beïnvloed. Dat komt doordat vrijheidsgraden typisch n min het aantal beperkingen of geschatte parameters zijn. Daarom is df bijna altijd kleiner dan n. De relatie tussen beide bestaat omdat het schatten van parameters beperkingen op de data oplegt.
Hoe interpreteer je vrijheidsgraden
De vuistregel is om je minder te focussen op de exacte berekening en meer op wat de beperking daadwerkelijk voorstelt.
Lage vrijheidsgraden betekenen minder onafhankelijke stukjes informatie, wat op zijn beurt leidt tot bredere betrouwbaarheidsintervallen en minder statistische power. Vertrouw op de output van je software, maar doe altijd sanity checks, zoals jezelf afvragen of de gerapporteerde vrijheidsgraden logisch zijn gegeven je steekproefgrootte en de uitgevoerde toets.
Conclusie
Vrijheidsgraden meten hoeveel echt onafhankelijke informatie er in je data beschikbaar is nadat je alle beperkingen hebt meegenomen. Het belangrijkste om te onthouden is simpel: elke keer dat je een parameter schat of een beperking oplegt, verlies je één vrijheids-graad. Inzicht in dit concept versterkt je statistische intuïtie en helpt je toetsresultaten met meer vertrouwen te interpreteren. Met oefening voelen vrijheidsgraden veel minder mysterieus en juist veel betekenisvoller.