

学习路径
面向开发者的 AI 工程师助理
26 小时
实践并学习路径你的进步。
使用 Google 继续Qwen3.6-35B-A3B 是一款轻量级的专家混合(MoE)模型,专为强大的编码、推理和长上下文任务而构建。它总参数为 350 亿,每个 token 激活 30 亿参数,使其在保持强劲性能的同时更高效地运行。它还支持 262K token 的上下文窗口,适用于更大的代码库、长文档和多步骤工作流。
该模型在编码与智能体风格的基准上表现尤为出色,在 SWE-bench、Terminal-Bench 和 Claw-Eval 上取得了优异成绩。同时,它在更广泛的推理与知识基准(如 GPQA、AIME 2026、MMLU-Pro 和 C-Eval)上也具备竞争力,这使其成为进行微调实验的有力基础模型,既能兼顾实际任务表现,又具备通用推理能力。
在本指南中,我们将设置 RunPod H100 NVL 环境,准备项目,加载并清洗医疗问答数据集,以 4 位量化方式运行 Qwen3.6,格式化提示词,构建评估辅助工具,在微调前测试基座模型,训练并保存适配器,最后在微调后再次对比模型。
免责声明: 本教程仅为教育目的演示技术性微调流程。所得模型不适用于医疗或临床用途,且不应被用于诊断、决策或患者护理。
在第一部分,我们将启动一个 RunPod H100 NVL 实例,安装所需库,连接 Hugging Face,并定义项目的核心配置。
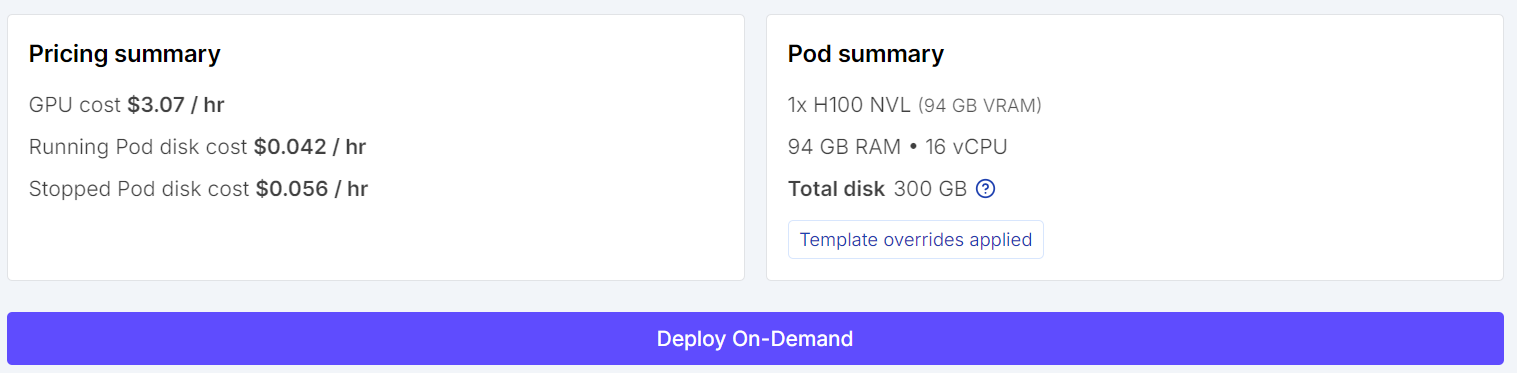
首先前往 RunPod,选择一台 H100 NVL GPU 机器。该 GPU 约有 94 GB 显存和 94 GB 系统内存,足以支持本次 Qwen3.6 微调流程。
选择最新的 PyTorch 模板,然后在部署前编辑 pod 配置。将容器磁盘大小设为 100 GB,卷磁盘大小设为 200 GB。这样即可有足够空间下载模型、缓存依赖并在本地保存微调后的适配器。
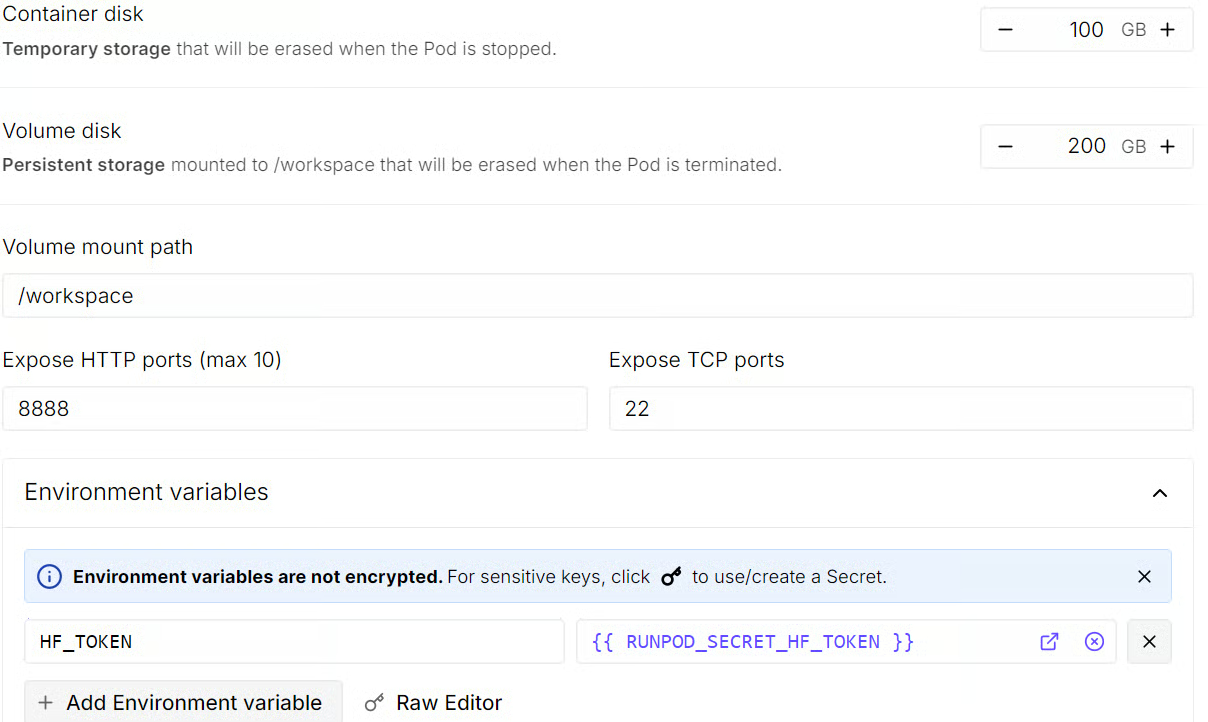
您还应在此阶段添加一个 HF_TOKEN 环境变量。这样稍后即可登录 Hugging Face、提升模型下载权限,并便于在训练后将微调模型推送到 Hub。
在启动实例前,请查看 pod 摘要以核对预估成本。确认无误后,部署该 pod。
Pod 就绪后,从 RunPod 仪表板打开 Jupyter Notebook 链接以启动 JupyterLab。新建一个 Python 笔记本,然后安装量化微调、数据集加载以及使用 TRL 进行监督微调所需的库。
pip install -q -U transformers accelerate peft trl bitsandbytes datasets sentencepiece接下来,使用您在创建 pod 时添加的 HF_TOKEN 环境变量登录 Hugging Face。这样无需在笔记本中硬编码令牌,流程也更清晰。
import os
from huggingface_hub import login

hf_token = os.getenv("HF_TOKEN")
login(token=hf_token)现在导入所需库,并定义整个教程中将使用的配置值。这包括模型 ID、数据集名称、样本大小、输出目录以及随机种子。
import os
import random
import re

import torch
from datasets import load_dataset
from peft import LoraConfig, prepare_model_for_kbit_training
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    set_seed,
)
from trl import SFTConfig, SFTTrainer

MODEL_ID = "Qwen/Qwen3.6-35B-A3B"
DATASET_ID = "keivalya/MedQuad-MedicalQnADataset"
SAMPLE_SIZE = 240
EVAL_SIZE = 24
COMPARISON_SAMPLE_COUNT = 3
MAX_SEQ_LENGTH = 768
OUTPUT_DIR = "qwen36-medquad-quick"
SEED = 42

set_seed(SEED)
random.seed(SEED)


def supports_bf16() -> bool:
    return torch.cuda.is_available() and torch.cuda.get_device_capability(0)[0] >= 8


print(f"PyTorch: {torch.__version__}")
print(f"CUDA available: {torch.cuda.is_available()}")
if torch.cuda.is_available():
    print(f"GPU: {torch.cuda.get_device_name(0)}")
    print(
        f"GPU memory (GB): {torch.cuda.get_device_properties(0).total_memory / 1024**3:.1f}"
    )
运行此单元后,您应能看到输出确认 CUDA 可用,且笔记本已连接到 NVIDIA H100 NVL GPU。
PyTorch: 2.8.0+cu128
CUDA available: True
GPU: NVIDIA H100 NVL
GPU memory (GB): 93.1本部分将加载 MedQuad 医疗问答数据集,清洗文本字段,过滤较低质量样本,并创建小型训练与评估切分以进行快速微调。
我们首先从 Hugging Face 加载 MedQuad 数据集的训练切分。加载后,我们查看数据集结构、列名和首个样本,以了解我们将处理的医疗问答对类型。
raw_dataset = load_dataset(DATASET_ID, split="train")
print(raw_dataset)
print("First example:", raw_dataset[0])
输出显示 MedQuad 数据集包含 16,407 个医疗问答样本,分布在三个字段:qtype、Question 和 Answer。
Dataset({
features: ['qtype', 'Question', 'Answer'],
num_rows: 16407
})
First example: {'qtype': 'susceptibility', 'Question': 'Who is at risk for Lymphocytic Choriomeningitis (LCM)? ?', 'Answer': 'LCMV infections can occur after exposure to fresh urine, droppings, saliva, or nesting materials from infected rodents. Transmission may also occur when these materials are directly introduced into broken skin, the nose, the eyes, or the mouth, or presumably, via the bite of an infected rodent. Person-to-person transmission has not been reported, with the exception of vertical transmission from infected mother to fetus, and rarely, through organ transplantation.'}接着,我们定义一个简短的文本清洗函数和过滤规则来移除低质量样本。清洗步骤用于规范多余空白;过滤步骤会去除问题过短、回答过短、回答过长,或带有泛化模板、对训练帮助不大的回答样本。
def clean_text(text):
    text = re.sub(r"\s+", " ", str(text)).strip()
    return text


BAD_ANSWER_PREFIXES = (
    "These resources address",
    "These resources from MedlinePlus",
    "For more information, go to",
    "For more information go to",
)


def keep_example(example):
    question = clean_text(example["Question"])
    answer = clean_text(example["Answer"])

    if len(question) < 12 or len(answer) < 40:
        return False
    if len(answer) > 900:
        return False
    if any(answer.startswith(prefix) for prefix in BAD_ANSWER_PREFIXES):
        return False
    return True


filtered_dataset = raw_dataset.filter(keep_example)过滤后,我们对数据集进行打乱,选取较小子集用于本次快速教程,并将其划分为训练集与评估集。这样可保持运行轻量,同时仍能在微调前后对模型进行对比。
subset = filtered_dataset.shuffle(seed=SEED).select(range(SAMPLE_SIZE))
split_dataset = subset.train_test_split(test_size=EVAL_SIZE, seed=SEED)

train_dataset = split_dataset["train"]
eval_dataset = split_dataset["test"]

print(f"Filtered dataset size: {len(filtered_dataset)}")
print(f"Train size: {len(train_dataset)}")
print(f"Eval size: {len(eval_dataset)}")
过滤后,共剩余 7,355 个较高质量样本,我们从中抽取 216 个训练样本和 24 个评估样本用于本次快速微调。
Filtered dataset size: 7355
Train size: 216
Eval size: 24在此步骤中,我们将使用 BitsAndBytes 配置 4 位量化,加载 Qwen3.6 的分词器,然后加载基座模型,使其在 H100 NVL GPU 上更高效运行。
Qwen3.6 仍是一个大型模型,若以全精度加载会占用更多内存。为提高微调效率,我们使用 BitsAndBytes 以 4 位精度加载模型。这在保持 QLoRA 微调可行性的同时降低了内存占用。
这里我们使用 nf4 量化,启用双重量化,并在 GPU 支持时将计算 dtype 设为 bfloat16。
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_use_double_quant=True,
    bnb_4bit_compute_dtype=torch.bfloat16 if supports_bf16() else torch.float16,
)接下来我们加载 Qwen3.6 的分词器。同时检查是否已定义了填充 token;若缺失,则将序列结束 token 复用为填充 token,以确保后续训练与生成中的批处理正常工作。
tokenizer = AutoTokenizer.from_pretrained(
    MODEL_ID,
    trust_remote_code=True,
    use_fast=False,
)

if tokenizer.pad_token is None:
tokenizer.pad_token = tokenizer.eos_token现在以先前定义的 4 位量化设置加载 Qwen3.6 基座模型。我们使用 device_map="auto" 以便自动将模型放置到可用 GPU 上,并在支持时使用 bfloat16 以提高计算效率。
加载模型后,我们设置填充 token ID 并禁用缓存。缓存对推理有帮助,但在微调期间会干扰训练并增加内存占用,因此需要关闭。
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    quantization_config=bnb_config,
    device_map="auto",
    dtype=torch.bfloat16 if supports_bf16() else torch.float16,
    trust_remote_code=True,
)

model.config.pad_token_id = tokenizer.pad_token_id
model.config.use_cache = False本步骤我们将定义 Qwen3.6 的提示结构、清洗模型输出、创建训练与推理辅助函数,并准备一些预览样本用于微调前后的对比。
我们先定义一段简短的系统提示,告知模型回答方式。鉴于这是医疗问答任务,我们希望回答直截了当、基于事实且简明扼要。
SYSTEM_PROMPT = "Answer the medical question directly in 2-4 factual sentences."Qwen3.6 使用聊天式输入格式,因此需要一个辅助函数将消息转换为正确的提示结构。该函数会应用分词器的聊天模板,并禁用推理输出,使模型专注于最终答案。
def apply_chat_template(messages, add_generation_prompt=False):
    kwargs = {
        "tokenize": False,
        "add_generation_prompt": add_generation_prompt,
    }
    try:
        return tokenizer.apply_chat_template(
            messages,
            enable_thinking=False,
            **kwargs,
        )
    except TypeError:
        return tokenizer.apply_chat_template(
            messages,
            chat_template_kwargs={"enable_thinking": False},
            **kwargs,
)接着我们定义一个简短的清洗函数来规范生成文本。它会去除多余空白,并删除输出中可能出现的前缀 answer:。
def clean_answer_text(answer):
    answer = clean_text(answer)
    answer = re.sub(r"^answer\s*:\s*", "", answer, flags=re.IGNORECASE)
return answer我们还创建了一个用户提示的辅助函数。它可在训练与评估中保持问题格式一致,并指示模型仅返回答案而不重复问题。
def make_user_prompt(question):
    return (
        f"Question: {clean_text(question)}\n\n"
        "Respond with only the answer. Do not restate the question."
)现在我们可以将每个数据集样本格式化为完整的聊天对话,包含系统消息、用户问题和期望的助手回答。这就是我们进行监督微调所使用的结构。
def format_training_example(example):
    messages = [
        {"role": "system", "content": SYSTEM_PROMPT},
        {
            "role": "user",
            "content": make_user_prompt(example["Question"]),
        },
        {
            "role": "assistant",
            "content": clean_answer_text(example["Answer"]),
        },
    ]
return {"text": apply_chat_template(messages, add_generation_prompt=False)}在开始训练前,我们需要一个可从基座模型生成答案的辅助函数。我们将用它来对比模型在微调前后的回答。
下方的函数会构建提示、进行分词、执行生成,然后移除输出中的 <think> 痕迹和多余格式。
@torch.inference_mode()
def generate_answer(question, max_new_tokens=160):
    messages = [
        {"role": "system", "content": SYSTEM_PROMPT},
        {
            "role": "user",
            "content": make_user_prompt(question),
        },
    ]
    prompt = apply_chat_template(messages, add_generation_prompt=True)
    model_inputs = tokenizer(prompt, return_tensors="pt").to(model.device)

    generated = model.generate(
        **model_inputs,
        max_new_tokens=max_new_tokens,
        do_sample=False,
        pad_token_id=tokenizer.pad_token_id,
        eos_token_id=tokenizer.eos_token_id,
    )

    new_tokens = generated[0][model_inputs["input_ids"].shape[1] :]
    text = tokenizer.decode(new_tokens, skip_special_tokens=True).strip()
    return clean_answer_text(re.sub(r"<think>.*?</think>", " ", text, flags=re.DOTALL))
我们还添加了一个小函数,用于在打印预览示例时截断过长输出。
def clip_text(text, max_chars=600):
    text = re.sub(r"<think>.*?</think>", " ", text, flags=re.DOTALL)
    text = re.sub(r"\s+", " ", text).strip()
return text if len(text) <= max_chars else text[:max_chars] + "..."最后,我们构建一个辅助函数来创建若干并排预览行。每行包含问题、模型预测以及参考答案。这样便于我们在微调前后进行简单的性能检查。
def generate_preview_rows(dataset, sample_count=COMPARISON_SAMPLE_COUNT):
    sample_count = min(sample_count, len(dataset))
    subset = dataset.select(range(sample_count))
    previews = []

    for row in subset:
        previews.append(
            {
                "question": row["Question"],
                "prediction": generate_answer(row["Question"]),
                "reference": clean_answer_text(row["Answer"]),
            }
        )

    return previews


formatted_train_dataset = train_dataset.map(
    format_training_example,
    remove_columns=train_dataset.column_names,
)

comparison_examples = eval_dataset.shuffle(seed=SEED).select(
    range(COMPARISON_SAMPLE_COUNT)
)

print(formatted_train_dataset[0])
当您打印首个格式化训练样本时,应能看到一个使用 Qwen 模板封装好的聊天式样本,包含系统提示、用户问题和助手回答。
{'text': '<|im_start|>system\nAnswer the medical question directly in 2-4 factual sentences.<|im_end|>\n<|im_start|>user\nQuestion: What is (are) COPD ?\n\nRespond with only the answer. Do not restate the question.<|im_end|>\n<|im_start|>assistant\n<think>\n\n</think>\n\nMore information on COPD is available at: What is COPD? and at the Learn More, Breathe Better Campaign For information on quitting smoking, visit http://www.surgeongeneral.gov/tobacco/ or Smokefree.gov. For information on the H1N1 flu and COPD, go to The Centers for Disease Control and Prevention.<|im_end|>\n'}在训练开始前,我们将在若干评估样本上测试 Qwen3.6 基座模型。这将作为基线,便于之后比较微调后的变化。
我们先为评估集中抽样的几个样本生成预览答案。
每个预览都包含问题、微调前的模型答案,以及数据集中的参考答案。
baseline_previews = generate_preview_rows(comparison_examples)

for idx, sample in enumerate(baseline_previews, start=1):
    print(f"\n--- Preview {idx} ---")
    print("Question:", sample["question"])
    print("Model answer (before fine-tuning):", clip_text(sample["prediction"]))
    print("Reference answer:", clip_text(sample["reference"]))
以下是模型当前响应与参考答案的并排对比。这些示例有助于我们在进行任何任务特定训练之前把握模型的起点。
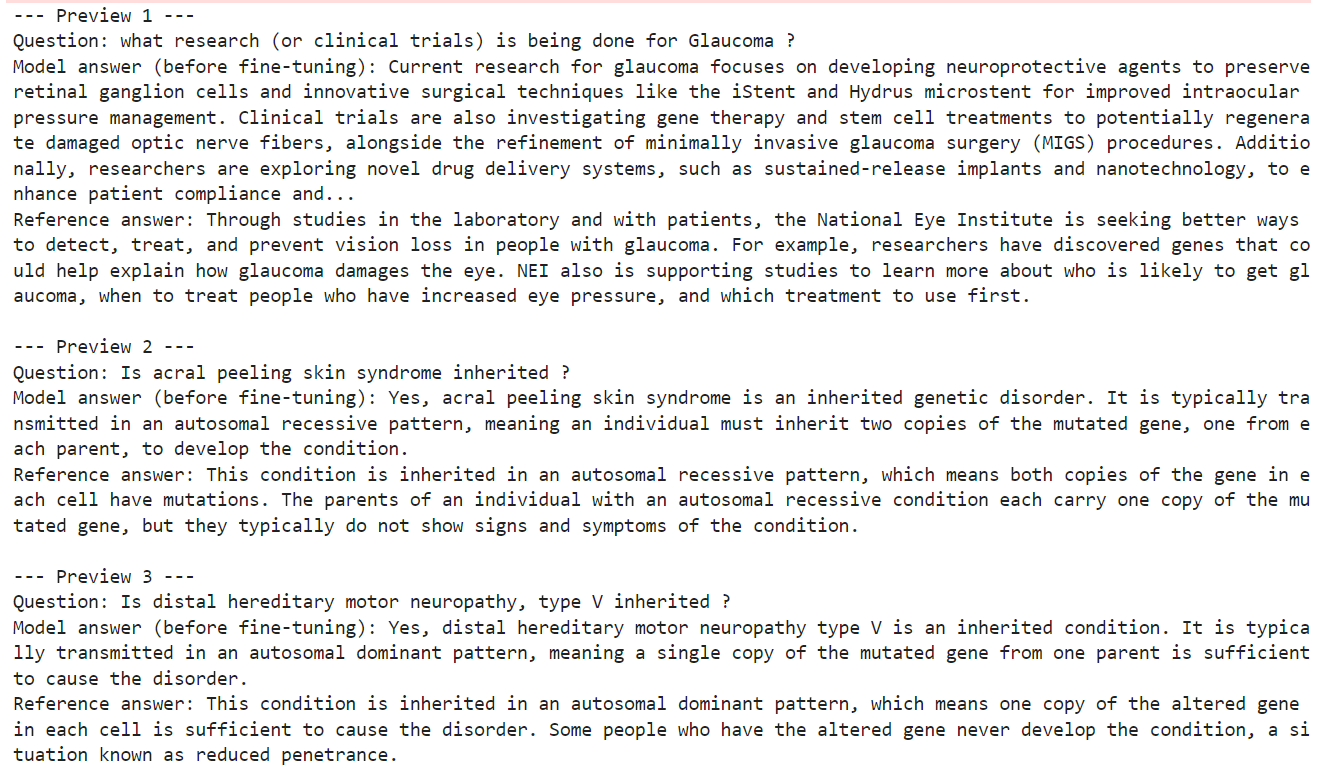
从这些示例中可以看出,基座模型已经能够给出与医学相关且总体正确的回答。
然而,其回答的风格、细节程度或措辞并不总是与数据集中的参考答案一致。某些情况下,模型给出了更广泛或更通用的解释,而参考答案更具体,更贴近目标格式。
本部分我们将定义 LoRA 适配器设置,配置监督微调参数,并初始化负责 QLoRA 训练过程的训练器。
与更新全部模型参数不同,QLoRA 仅微调一小部分可训练的适配器权重。这样在保持模型对新任务的适应性的同时,大幅降低了训练的内存消耗。
在此我们定义 rank 为 8、缩放因子为 16、并设置较小的 dropout 值。同时将目标设为所有线性层,使适配器广泛应用于整个模型。
lora_config = LoraConfig(
    r=8,
    lora_alpha=16,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules="all-linear",
)接着使用 SFTConfig 定义训练配置。这些设置控制监督微调的运行方式,包括批大小、梯度累积、学习率、日志频率和精度模式。
本教程采用轻量配置:1 个训练 epoch 和较小的批大小,以便演示更为实际。我们还启用梯度检查点与分页 8 位 AdamW,以降低训练期间的内存占用。
trainer_config = SFTConfig(
    output_dir=OUTPUT_DIR,
    dataset_text_field="text",
    max_length=MAX_SEQ_LENGTH,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=2,
    num_train_epochs=1,
    learning_rate=1e-4,
    warmup_steps=5,
    logging_steps=5,
    save_strategy="epoch",
    report_to="none",
    packing=False,
    gradient_checkpointing=True,
    optim="paged_adamw_8bit",
    bf16=supports_bf16(),
    fp16=not supports_bf16(),
)在适配器设置与训练参数就绪后,我们即可初始化 SFTTrainer。该训练器将基座模型、格式化训练数据集、LoRA 配置与分词器整合起来,使模型准备好进行监督微调。
trainer = SFTTrainer(
    model=model,
    train_dataset=formatted_train_dataset,
    peft_config=lora_config,
    args=trainer_config,
    processing_class=tokenizer,
)
在开始训练前,确认实际将更新多少参数是很有帮助的。QLoRA 的一大优势就在于仅有极小比例的参数需要训练。
trainer.model.print_trainable_parameters()输出显示仅约 0.03% 的模型参数参与训练。这正是 QLoRA 使得在有限硬件上微调大型语言模型更为可行的原因。
trainable params: 11,238,720 || all params: 34,671,849,408 || trainable%: 0.0324本节我们将启动监督微调、在本地保存训练好的适配器,然后将其推送至 Hugging Face,以便后续复用。
在模型、数据集与训练器准备就绪后,我们即可开始微调流程。训练器将遍历格式化后的训练集,仅更新 LoRA 适配器权重,而非整个模型。
train_result = trainer.train()
train_result
随着训练进行,您应能看到 loss 逐步下降。这表明模型正在学习任务格式,并适应医疗问答数据。
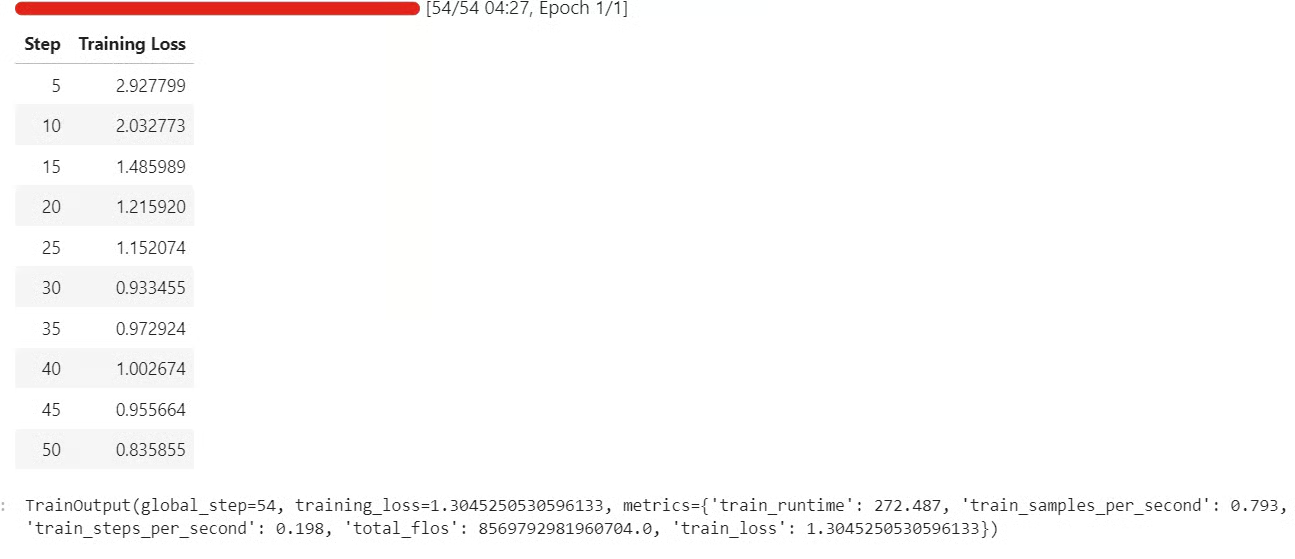
训练结束后,在本地保存微调适配器与分词器。这样您就有了可复用的检查点,无需重复完整训练即可再次加载。
trainer.model.save_pretrained(OUTPUT_DIR)
tokenizer.save_pretrained(OUTPUT_DIR)在本地保存适配器后,您可以将其上传至 Hugging Face。这样更便于共享、版本管理,以及在未来的笔记本或部署工作流中重新加载微调模型。
HF_REPO_ID = "kingabzpro/qwen36-medquad-quick"

trainer.model.push_to_hub(HF_REPO_ID)
tokenizer.push_to_hub(HF_REPO_ID)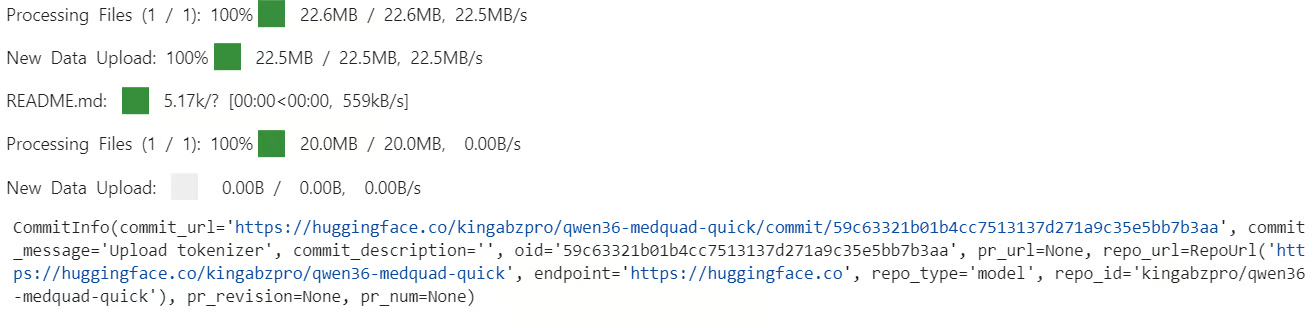 上传完成后,微调适配器将在该仓库中可用。
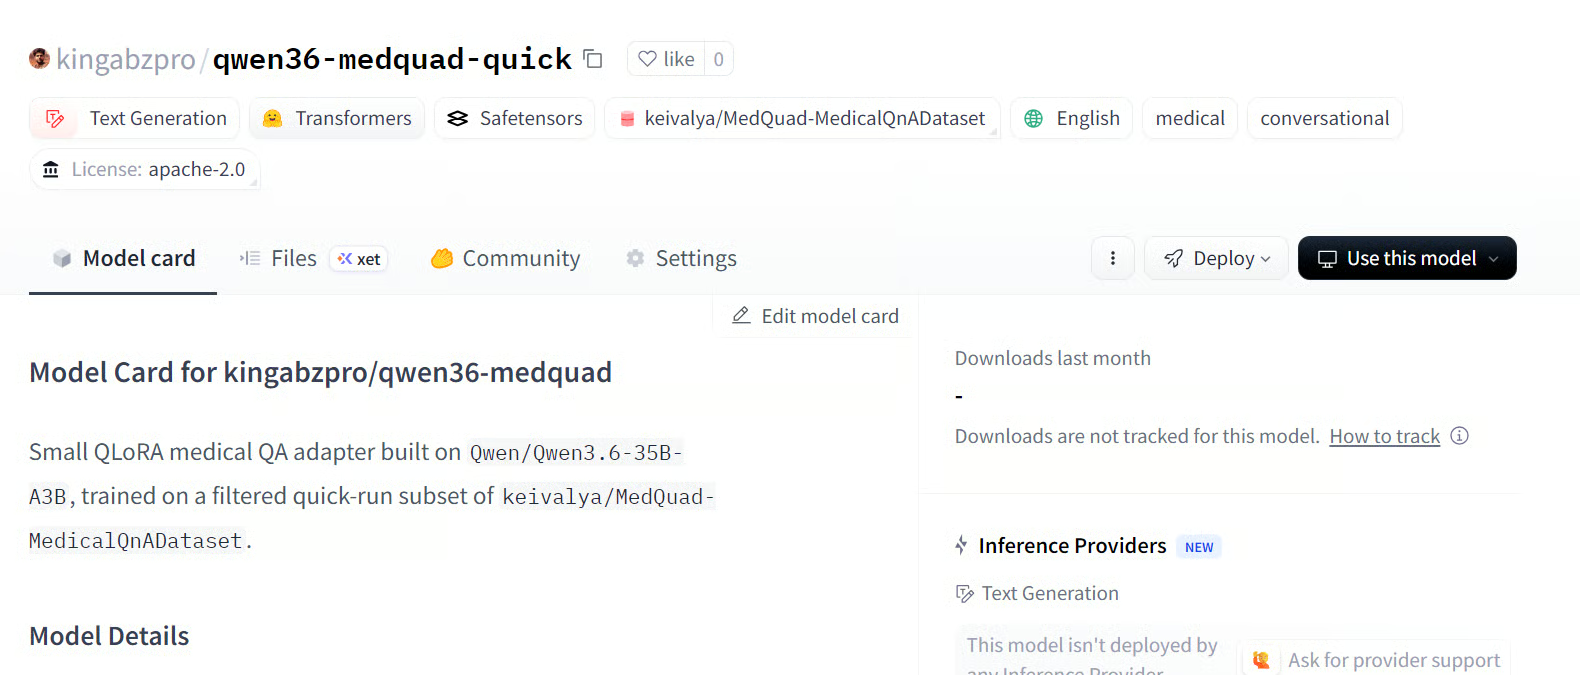
来源:kingabzpro/qwen36-medquad-quick
训练完成后,我们将在先前相同的对比样本上评估微调后的模型。这样可以在完全相同的问题上进行前后对比。
model.eval()

fine_tuned_previews = generate_preview_rows(comparison_examples)

for idx, (before, after) in enumerate(
    zip(baseline_previews, fine_tuned_previews), start=1
):
    print(f"\n{'=' * 80}")
    print(f"Sample {idx}")
    print(f"{'=' * 80}")
    print("Question:", before["question"])
    print("\nBefore fine-tuning:")
    print(clip_text(before["prediction"]))
    print("\nAfter fine-tuning:")
    print(clip_text(after["prediction"]))
    print("\nReference answer:")
    print(clip_text(before["reference"]))
对于每个样本,您将同时看到基线答案、微调后答案与参考答案。这有助于更直观地检查适配器如何改变模型的回应风格与内容。
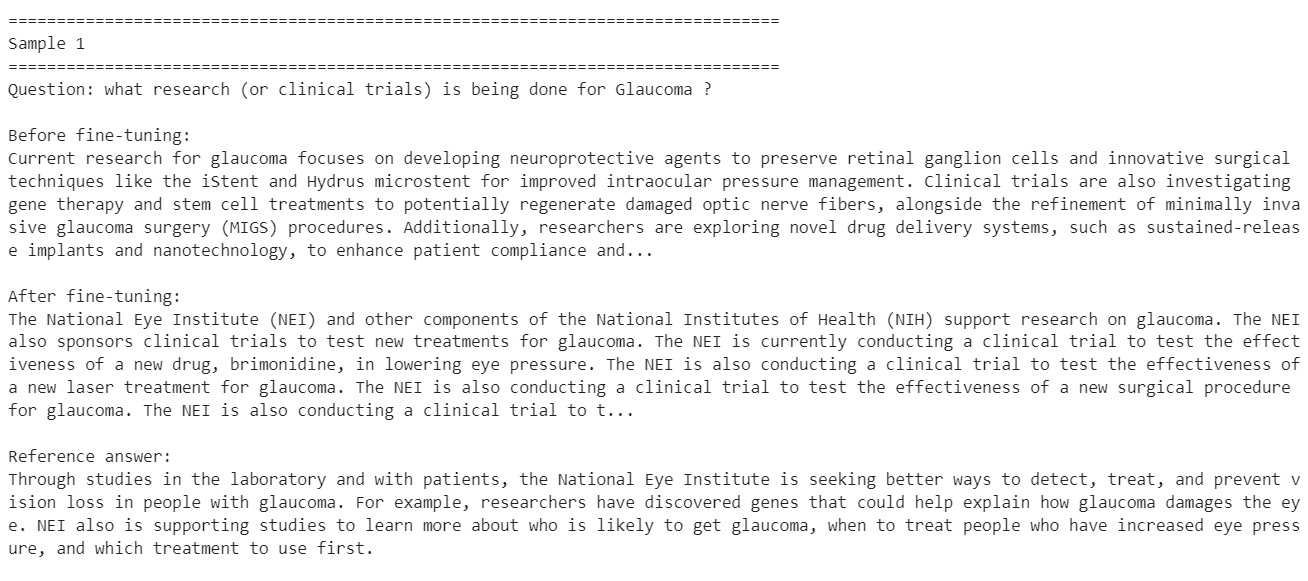
这些示例表明,微调帮助模型更贴近目标数据集的风格,尤其是在较短的、基于事实的医疗问题上。
同时,结果也显示这只是对数据集小子集的一次短暂微调,因此无法保证每个样本都有提升。有些答案会更契合训练分布,另一些则可能丢失有用细节或变得过于狭窄。
要获得更好的结果,下一步应在完整数据集上训练,而非小子集,并将微调轮次数提升至至少 3 个 epoch。您还可以提高 LoRA 的 rank 以增强适配器的学习能力,并进一步打磨系统提示,使模型更稳定地遵循所需的医疗回答风格。
这些改动很可能会在更广泛的问题范围上带来更稳定的改进。
微调一款现代语言模型并不像乍看之下那么简单。
尽管 Qwen3.6-35B-A3B 是一款高效的专家混合模型,总参数达 350 亿,但即便以 4 位模式加载并为训练做准备也需要相当可观的算力。一旦超出小规模实验子集,使用更大数据集或多轮训练时,训练本身的成本也依然不低。
硬件同样至关重要。本教程使用 H100 NVL 以保持流程可操作。在旧款 GPU 上,训练时间会显著增加。即便在 A100 上,类似设置也可能需要约一小时,更弱的 GPU 则会更久。
因此,尽管 QLoRA 和 4 位加载让微调更易上手,但并不意味着其在日常意义上是“轻量”的。同时,也值得先问一句:是否真的需要进行微调?对于许多基础任务,我并不建议一开始就直接上微调。
如果您投入时间改进提示词、优化流程设计,并使用工具、MCP 或基于检索的方法,往往无需训练也能接近目标行为。在很多情况下,这能以更快、更低成本、且更易迭代的方式,达到目标效果的 80% 左右。
当您需要模型稳定地学习某种非常具体的回答风格、领域行为或机构化格式时,微调的价值就大幅提升了。这时候它才真正有意义。如果您希望模型以某家医院、医疗体系或特定专家工作流的方式来精确回答问题,那么微调就是更优路径。
换言之,请优先使用提示与流程设计,当您确实需要模型内化一种专业化的回应方式时,再转向微调。
热门 AI 课程
学习路径
课程
实践并学习路径你的进步。
使用 Google 继续