

लर्निंग पाथ
डेवलपर्स के लिए एसोसिएट AI इंजीनियर
26 घंटा
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंQwen3.6-35B-A3B एक हल्का mixture-of-experts मॉडल है, जो कोडिंग, विवेचन, और लंबे संदर्भ वाले कार्यों में मजबूत प्रदर्शन के लिए बनाया गया है। इसमें कुल 35B पैरामीटर्स हैं, जिनमें प्रति टोकन 3B सक्रिय पैरामीटर्स होते हैं, जिससे रन करना अधिक कुशल हो जाता है, जबकि प्रदर्शन मजबूत बना रहता है। यह 262K टोकन का कॉन्टेक्स्ट विंडो भी सपोर्ट करता है, जिससे यह बड़े कोडबेस, लंबे दस्तावेज़ों और मल्टी-स्टेप वर्कफ़्लोज़ के लिए उपयोगी है।
मॉडल विशेष रूप से कोडिंग और एजेंट-शैली के बेंचमार्क्स पर अच्छा प्रदर्शन करता है, जैसे SWE-bench, Terminal-Bench, और Claw-Eval। यह GPQA, AIME 2026, MMLU-Pro, और C-Eval जैसे व्यापक विवेचन और ज्ञान बेंचमार्क्स पर भी प्रतिस्पर्धी बना रहता है, जो इसे ऐसे फाइन-ट्यूनिंग प्रयोगों के लिए एक मजबूत बेस मॉडल बनाता है जिन्हें व्यावहारिक टास्क परफॉर्मेंस के साथ-साथ सामान्य विवेचन क्षमता की भी ज़रूरत होती है।
इस गाइड में, हम RunPod H100 NVL वातावरण सेट करेंगे, प्रोजेक्ट तैयार करेंगे, एक मेडिकल Q&A डेटासेट लोड और साफ़ करेंगे, Qwen3.6 को 4-बिट क्वांटाइज़ेशन में चलाएंगे, प्रॉम्प्ट्स फॉर्मैट करेंगे, मूल्यांकन हेल्पर्स बनाएंगे, फाइन-ट्यूनिंग से पहले बेस मॉडल का परीक्षण करेंगे, एडॉप्टर को ट्रेन और सेव करेंगे, और फिर फाइन-ट्यूनिंग के बाद मॉडल की फिर से तुलना करेंगे।
अस्वीकरण: यह ट्यूटोरियल केवल शैक्षिक उद्देश्यों के लिए एक तकनीकी फाइन-ट्यूनिंग प्रक्रिया का प्रदर्शन करता है। तैयार हुआ मॉडल चिकित्सीय या क्लिनिकल उपयोग के लिए अभिप्रेत नहीं है और निदान, निर्णय-निर्माण, या रोगी देखभाल के लिए इस पर भरोसा नहीं किया जाना चाहिए।
पहले भाग में, हम RunPod H100 NVL इंस्टेंस लॉन्च करेंगे, आवश्यक लाइब्रेरियाँ इंस्टॉल करेंगे, Hugging Face से कनेक्ट करेंगे, और कोर प्रोजेक्ट कॉन्फ़िगरेशन परिभाषित करेंगे।
RunPod पर जाएँ और H100 NVL GPU मशीन चुनें। इस GPU में लगभग 94 GB VRAM और 94 GB सिस्टम RAM होती है, जो इस Qwen3.6 फाइन-ट्यूनिंग वर्कफ़्लो के लिए पर्याप्त है।
नवीनतम PyTorch टेम्पलेट चुनें, फिर डिप्लॉयमेंट से पहले पॉड कॉन्फ़िगरेशन संपादित करें। कंटेनर डिस्क आकार 100 GB और वॉल्यूम डिस्क आकार 200 GB सेट करें। इससे मॉडल डाउनलोड, डिपेंडेंसी कैशिंग, और फाइन-ट्यून किया गया एडॉप्टर लोकली सेव करने के लिए पर्याप्त स्पेस मिल जाएगा।
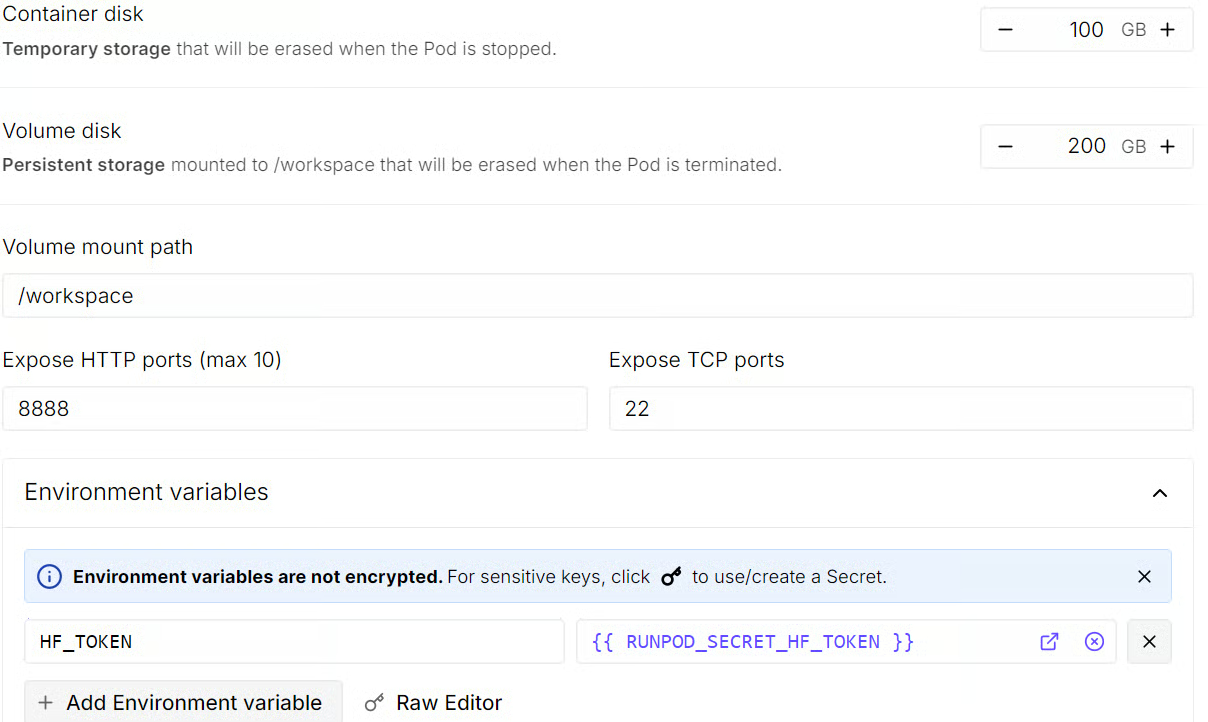
आपको इस चरण में एक HF_TOKEN environment वैरिएबल भी जोड़ना चाहिए। इससे आप बाद में Hugging Face में लॉग इन कर पाएँगे, मॉडल डाउनलोड एक्सेस बेहतर होगा, और ट्रेनिंग के बाद फाइन-ट्यून मॉडल को हब पर पुश करना आसान हो जाएगा।
इंस्टेंस लॉन्च करने से पहले, पॉड सारांश की समीक्षा करें ताकि आप अनुमानित लागत जाँच सकें। सब कुछ सही लगे तो पॉड डिप्लॉय करें।
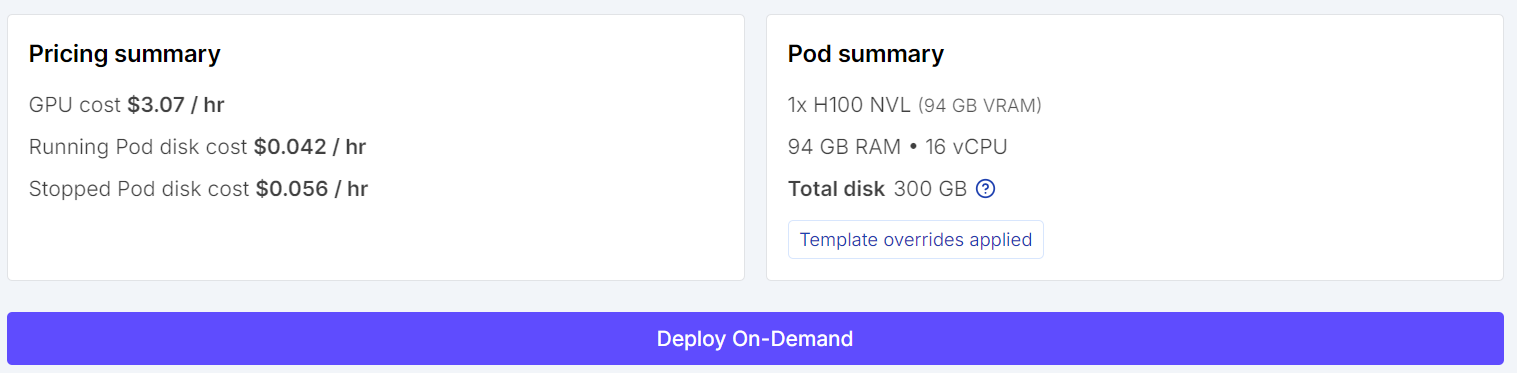
पॉड तैयार होने के बाद, RunPod डैशबोर्ड से Jupyter Notebook लिंक खोलकर JupyterLab लॉन्च करें। एक नया Python नोटबुक बनाएँ, फिर क्वांटाइज़्ड फाइन-ट्यूनिंग, डेटासेट लोडिंग, और TRL के साथ सुपरवाइज़्ड फाइन-ट्यूनिंग के लिए आवश्यक लाइब्रेरियाँ इंस्टॉल करें।
pip install -q -U transformers accelerate peft trl bitsandbytes datasets sentencepieceइसके बाद, उस HF_TOKEN environment वैरिएबल का उपयोग करके Hugging Face में लॉग इन करें जिसे आपने पॉड बनाते समय जोड़ा था। इससे आपको नोटबुक में टोकन हार्डकोड करने की ज़रूरत नहीं पड़ेगी और वर्कफ़्लो साफ़ रहेगा।
import os
from huggingface_hub import login

hf_token = os.getenv("HF_TOKEN")
login(token=hf_token)अब आवश्यक लाइब्रेरियाँ इम्पोर्ट करें और वे कॉन्फ़िगरेशन वैल्यू परिभाषित करें जिन्हें हम पूरे ट्यूटोरियल में उपयोग करेंगे। इसमें मॉडल ID, डेटासेट नाम, सैंपल साइज़, आउटपुट डायरेक्टरी, और रैंडम सीड शामिल हैं।
import os
import random
import re

import torch
from datasets import load_dataset
from peft import LoraConfig, prepare_model_for_kbit_training
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    set_seed,
)
from trl import SFTConfig, SFTTrainer

MODEL_ID = "Qwen/Qwen3.6-35B-A3B"
DATASET_ID = "keivalya/MedQuad-MedicalQnADataset"
SAMPLE_SIZE = 240
EVAL_SIZE = 24
COMPARISON_SAMPLE_COUNT = 3
MAX_SEQ_LENGTH = 768
OUTPUT_DIR = "qwen36-medquad-quick"
SEED = 42

set_seed(SEED)
random.seed(SEED)


def supports_bf16() -> bool:
    return torch.cuda.is_available() and torch.cuda.get_device_capability(0)[0] >= 8


print(f"PyTorch: {torch.__version__}")
print(f"CUDA available: {torch.cuda.is_available()}")
if torch.cuda.is_available():
    print(f"GPU: {torch.cuda.get_device_name(0)}")
    print(
        f"GPU memory (GB): {torch.cuda.get_device_properties(0).total_memory / 1024**3:.1f}"
    )
जब आप यह सेल चलाएँगे, तो आपको आउटपुट दिखेगा जो पुष्टि करेगा कि CUDA उपलब्ध है और नोटबुक NVIDIA H100 NVL GPU से जुड़ा है।
PyTorch: 2.8.0+cu128
CUDA available: True
GPU: NVIDIA H100 NVL
GPU memory (GB): 93.1इस भाग में, हम MedQuad मेडिकल Q&A डेटासेट लोड करेंगे, टेक्स्ट फ़ील्ड्स को साफ़ करेंगे, कम-गुणवत्ता वाले उदाहरणों को फ़िल्टर करेंगे, और त्वरित फाइन-ट्यूनिंग के लिए छोटे ट्रेन और इवैल्यूएशन स्प्लिट बनाएँगे।
हम Hugging Face से MedQuad डेटासेट के ट्रेनिंग स्प्लिट को लोड करके शुरू करते हैं। लोड करने के बाद, हम डेटासेट की संरचना, कॉलम नाम, और पहला उदाहरण देखते हैं ताकि यह समझ सकें कि हम किस प्रकार के मेडिकल प्रश्न-उत्तर युग्मों के साथ काम कर रहे हैं।
raw_dataset = load_dataset(DATASET_ID, split="train")
print(raw_dataset)
print("First example:", raw_dataset[0])
यह दर्शाता है कि MedQuad डेटासेट में तीन फ़ील्ड्स—qtype, Question, और Answer—में 16,407 मेडिकल प्रश्न-उत्तर उदाहरण शामिल हैं।
Dataset({
features: ['qtype', 'Question', 'Answer'],
num_rows: 16407
})
First example: {'qtype': 'susceptibility', 'Question': 'Who is at risk for Lymphocytic Choriomeningitis (LCM)? ?', 'Answer': 'LCMV infections can occur after exposure to fresh urine, droppings, saliva, or nesting materials from infected rodents. Transmission may also occur when these materials are directly introduced into broken skin, the nose, the eyes, or the mouth, or presumably, via the bite of an infected rodent. Person-to-person transmission has not been reported, with the exception of vertical transmission from infected mother to fetus, and rarely, through organ transplantation.'}इसके बाद, हम एक छोटा टेक्स्ट क्लीनिंग फ़ंक्शन और फ़िल्टरिंग नियम परिभाषित करते हैं ताकि कम-गुणवत्ता वाले सैंपल हटाए जा सकें। क्लीनिंग चरण अतिरिक्त व्हाइटस्पेस को सामान्य करता है, जबकि फ़िल्टरिंग चरण बहुत छोटे प्रश्नों, बहुत छोटे उत्तरों, बहुत लंबे उत्तरों, या ऐसे जेनेरिक उत्तर टेम्पलेट्स वाले उदाहरणों को हटाता है जो ट्रेनिंग के लिए कम उपयोगी हैं।
def clean_text(text):
    text = re.sub(r"\s+", " ", str(text)).strip()
    return text


BAD_ANSWER_PREFIXES = (
    "These resources address",
    "These resources from MedlinePlus",
    "For more information, go to",
    "For more information go to",
)


def keep_example(example):
    question = clean_text(example["Question"])
    answer = clean_text(example["Answer"])

    if len(question) < 12 or len(answer) < 40:
        return False
    if len(answer) > 900:
        return False
    if any(answer.startswith(prefix) for prefix in BAD_ANSWER_PREFIXES):
        return False
    return True


filtered_dataset = raw_dataset.filter(keep_example)फ़िल्टरिंग के बाद, हम डेटासेट को शफ़ल करते हैं, इस त्वरित ट्यूटोरियल के लिए एक छोटा सबसेट चुनते हैं, और उसे ट्रेनिंग और इवैल्यूएशन सेट्स में विभाजित करते हैं। इससे रन हल्का रहता है, जबकि हमें फाइन-ट्यूनिंग से पहले और बाद में मॉडल की तुलना करने की सुविधा मिलती है।
subset = filtered_dataset.shuffle(seed=SEED).select(range(SAMPLE_SIZE))
split_dataset = subset.train_test_split(test_size=EVAL_SIZE, seed=SEED)

train_dataset = split_dataset["train"]
eval_dataset = split_dataset["test"]

print(f"Filtered dataset size: {len(filtered_dataset)}")
print(f"Train size: {len(train_dataset)}")
print(f"Eval size: {len(eval_dataset)}")
फ़िल्टरिंग के बाद, 7,355 उच्च-गुणवत्ता वाले उदाहरण बचे, जिनमें से हम इस त्वरित फाइन-ट्यूनिंग रन के लिए 216 ट्रेनिंग उदाहरण और 24 इवैल्यूएशन उदाहरण सैंपल करते हैं।
Filtered dataset size: 7355
Train size: 216
Eval size: 24इस चरण में, हम BitsAndBytes के साथ 4-बिट क्वांटाइज़ेशन कॉन्फ़िगर करेंगे, Qwen3.6 का टोकनाइज़र लोड करेंगे, और फिर बेस मॉडल लोड करेंगे ताकि H100 NVL GPU पर यह अधिक कुशलता से चले।
Qwen3.6 अभी भी एक बड़ा मॉडल है, इसलिए इसे फुल प्रिसिशन में लोड करना कहीं अधिक मेमोरी लेगा। फाइन-ट्यूनिंग को अधिक कुशल बनाने के लिए, हम मॉडल को BitsAndBytes के साथ 4-बिट प्रिसिशन में लोड करते हैं। इससे मेमोरी उपयोग कम होता है, जबकि QLoRA-आधारित फाइन-ट्यूनिंग के लिए मॉडल व्यावहारिक बना रहता है।
यहाँ, हम nf4 क्वांटाइज़ेशन का उपयोग करते हैं, डबल क्वांटाइज़ेशन सक्षम करते हैं, और जब GPU सपोर्ट करता है तो compute dtype को bfloat16 पर सेट करते हैं।
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_use_double_quant=True,
    bnb_4bit_compute_dtype=torch.bfloat16 if supports_bf16() else torch.float16,
)इसके बाद, हम Qwen3.6 के लिए टोकनाइज़र लोड करते हैं। हम यह भी जाँचते हैं कि क्या padding टोकन पहले से परिभाषित है। यदि यह गायब है, तो हम end-of-sequence टोकन को padding टोकन के रूप में पुन: उपयोग करते हैं ताकि ट्रेनिंग और जेनरेशन के दौरान बैचिंग सही से काम करे।
tokenizer = AutoTokenizer.from_pretrained(
    MODEL_ID,
    trust_remote_code=True,
    use_fast=False,
)

if tokenizer.pad_token is None:
tokenizer.pad_token = tokenizer.eos_tokenअब हम पहले परिभाषित किए गए 4-बिट क्वांटाइज़ेशन सेटिंग्स के साथ बेस Qwen3.6 मॉडल लोड करते हैं। हम device_map="auto" का उपयोग करते हैं ताकि मॉडल उपलब्ध GPU पर स्वतः प्लेस हो जाए, और बेहतर दक्षता के लिए सपोर्ट होने पर फिर से bfloat16 का उपयोग करते हैं।
मॉडल लोड करने के बाद, हम padding टोकन ID सेट करते हैं और कैश उपयोग को निष्क्रिय करते हैं। यह महत्वपूर्ण है क्योंकि कैशिंग इनफेरेंस के लिए सहायक होती है, लेकिन फाइन-ट्यूनिंग के दौरान यह ट्रेनिंग में हस्तक्षेप कर सकती है और मेमोरी उपयोग बढ़ा सकती है।
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    quantization_config=bnb_config,
    device_map="auto",
    dtype=torch.bfloat16 if supports_bf16() else torch.float16,
    trust_remote_code=True,
)

model.config.pad_token_id = tokenizer.pad_token_id
model.config.use_cache = Falseइस चरण में, हम Qwen3.6 के लिए प्रॉम्प्ट संरचना परिभाषित करेंगे, मॉडल आउटपुट को साफ़ करेंगे, ट्रेनिंग और इनफेरेंस के लिए हेल्पर फ़ंक्शंस बनाएँगे, और कुछ प्रीव्यू सैंपल तैयार करेंगे ताकि फाइन-ट्यूनिंग से पहले और बाद में मॉडल की तुलना की जा सके।
हम एक छोटा सिस्टम प्रॉम्प्ट परिभाषित करके शुरू करते हैं जो मॉडल को बताता है कि कैसे उत्तर देना है। चूँकि यह एक मेडिकल Q&A कार्य है, हम चाहते हैं कि प्रतिक्रियाएँ सीधे, तथ्यात्मक और संक्षिप्त हों।
SYSTEM_PROMPT = "Answer the medical question directly in 2-4 factual sentences."Qwen3.6 चैट-शैली का इनपुट फॉर्मैट उपयोग करता है, इसलिए हमें एक हेल्पर फ़ंक्शन चाहिए जो हमारे संदेशों को सही प्रॉम्प्ट संरचना में बदल दे। यह फ़ंक्शन टोकनाइज़र के चैट टेम्पलेट को लागू करता है और रीजनिंग आउटपुट को निष्क्रिय करता है ताकि मॉडल अंतिम उत्तर पर केंद्रित रहे।
def apply_chat_template(messages, add_generation_prompt=False):
    kwargs = {
        "tokenize": False,
        "add_generation_prompt": add_generation_prompt,
    }
    try:
        return tokenizer.apply_chat_template(
            messages,
            enable_thinking=False,
            **kwargs,
        )
    except TypeError:
        return tokenizer.apply_chat_template(
            messages,
            chat_template_kwargs={"enable_thinking": False},
            **kwargs,
)इसके बाद, हम जेनरेट किए गए टेक्स्ट को सामान्य करने के लिए एक छोटा क्लीनअप फ़ंक्शन परिभाषित करते हैं। यह अतिरिक्त व्हाइटस्पेस हटाता है और यदि आउटपुट में शुरुआती answer: प्रिफिक्स आ गया हो तो उसे हटा देता है।
def clean_answer_text(answer):
    answer = clean_text(answer)
    answer = re.sub(r"^answer\s*:\s*", "", answer, flags=re.IGNORECASE)
return answerहम यूज़र प्रॉम्प्ट के लिए भी एक हेल्पर फ़ंक्शन बनाते हैं। यह ट्रेनिंग और इवैल्यूएशन के दौरान प्रश्न फॉर्मैट को सुसंगत रखता है और मॉडल को केवल उत्तर लौटाने के लिए कहता है, बिना प्रश्न दोहराए।
def make_user_prompt(question):
    return (
        f"Question: {clean_text(question)}\n\n"
        "Respond with only the answer. Do not restate the question."
)अब हम प्रत्येक डेटासेट उदाहरण को एक पूर्ण चैट-शैली की बातचीत में फॉर्मैट कर सकते हैं, जिसमें सिस्टम संदेश, यूज़र प्रश्न, और अपेक्षित असिस्टेंट उत्तर शामिल हैं। यही संरचना हम सुपरवाइज़्ड फाइन-ट्यूनिंग के लिए उपयोग करेंगे।
def format_training_example(example):
    messages = [
        {"role": "system", "content": SYSTEM_PROMPT},
        {
            "role": "user",
            "content": make_user_prompt(example["Question"]),
        },
        {
            "role": "assistant",
            "content": clean_answer_text(example["Answer"]),
        },
    ]
return {"text": apply_chat_template(messages, add_generation_prompt=False)}ट्रेनिंग शुरू करने से पहले, हमें एक हेल्पर फ़ंक्शन चाहिए जो बेस मॉडल से उत्तर जेनरेट कर सके। हम इसका उपयोग फाइन-ट्यूनिंग से पहले और बाद में मॉडल की प्रतिक्रियाओं की तुलना करने के लिए करेंगे।
नीचे दिया गया फ़ंक्शन प्रॉम्प्ट बनाता है, उसे टोकनाइज़ करता है, जेनरेशन चलाता है, और फिर आउटपुट से किसी भी <think> ट्रेस और अतिरिक्त फॉर्मैटिंग को हटा देता है।
@torch.inference_mode()
def generate_answer(question, max_new_tokens=160):
    messages = [
        {"role": "system", "content": SYSTEM_PROMPT},
        {
            "role": "user",
            "content": make_user_prompt(question),
        },
    ]
    prompt = apply_chat_template(messages, add_generation_prompt=True)
    model_inputs = tokenizer(prompt, return_tensors="pt").to(model.device)

    generated = model.generate(
        **model_inputs,
        max_new_tokens=max_new_tokens,
        do_sample=False,
        pad_token_id=tokenizer.pad_token_id,
        eos_token_id=tokenizer.eos_token_id,
    )

    new_tokens = generated[0][model_inputs["input_ids"].shape[1] :]
    text = tokenizer.decode(new_tokens, skip_special_tokens=True).strip()
    return clean_answer_text(re.sub(r"<think>.*?</think>", " ", text, flags=re.DOTALL))
हम प्रीव्यू उदाहरण प्रिंट करते समय लंबे आउटपुट को छोटा करने के लिए एक छोटा हेल्पर फ़ंक्शन भी जोड़ते हैं।
def clip_text(text, max_chars=600):
    text = re.sub(r"<think>.*?</think>", " ", text, flags=re.DOTALL)
    text = re.sub(r"\s+", " ", text).strip()
return text if len(text) <= max_chars else text[:max_chars] + "..."अंत में, हम एक हेल्पर फ़ंक्शन बनाते हैं जो कुछ साइड-बाय-साइड प्रीव्यू पंक्तियाँ तैयार करता है। प्रत्येक पंक्ति में प्रश्न, मॉडल की भविष्यवाणी, और संदर्भ उत्तर शामिल होता है। इससे फाइन-ट्यूनिंग से पहले और बाद में प्रदर्शन का सरल निरीक्षण करना आसान हो जाता है।
def generate_preview_rows(dataset, sample_count=COMPARISON_SAMPLE_COUNT):
    sample_count = min(sample_count, len(dataset))
    subset = dataset.select(range(sample_count))
    previews = []

    for row in subset:
        previews.append(
            {
                "question": row["Question"],
                "prediction": generate_answer(row["Question"]),
                "reference": clean_answer_text(row["Answer"]),
            }
        )

    return previews


formatted_train_dataset = train_dataset.map(
    format_training_example,
    remove_columns=train_dataset.column_names,
)

comparison_examples = eval_dataset.shuffle(seed=SEED).select(
    range(COMPARISON_SAMPLE_COUNT)
)

print(formatted_train_dataset[0])
जब आप पहला फॉर्मैट किया हुआ ट्रेनिंग उदाहरण प्रिंट करेंगे, तो आपको सिस्टम प्रॉम्प्ट, यूज़र प्रश्न, और असिस्टेंट उत्तर के साथ Qwen के टेम्पलेट फॉर्मैट में रैप्ड एक चैट-शैली का सैंপल दिखाई देगा।
{'text': '<|im_start|>system\nAnswer the medical question directly in 2-4 factual sentences.<|im_end|>\n<|im_start|>user\nQuestion: What is (are) COPD ?\n\nRespond with only the answer. Do not restate the question.<|im_end|>\n<|im_start|>assistant\n<think>\n\n</think>\n\nMore information on COPD is available at: What is COPD? and at the Learn More, Breathe Better Campaign For information on quitting smoking, visit http://www.surgeongeneral.gov/tobacco/ or Smokefree.gov. For information on the H1N1 flu and COPD, go to The Centers for Disease Control and Prevention.<|im_end|>\n'}हम ट्रेनिंग से पहले कुछ इवैल्यूएशन उदाहरणों पर बेस Qwen3.6 मॉडल का परीक्षण करेंगे। इससे हमें एक बेसलाइन मिलती है ताकि हम बाद में देख सकें कि फाइन-ट्यूनिंग के बाद मॉडल कैसे बदलता है।
हम इवैल्यूएशन सेट से सैंपल किए गए कुछ उदाहरणों के लिए प्रीव्यू उत्तर जेनरेट करके शुरू करते हैं।
हर प्रीव्यू में प्रश्न, फाइन-ट्यूनिंग से पहले मॉडल का उत्तर, और डेटासेट से संदर्भ उत्तर शामिल होता है।
baseline_previews = generate_preview_rows(comparison_examples)

for idx, sample in enumerate(baseline_previews, start=1):
    print(f"\n--- Preview {idx} ---")
    print("Question:", sample["question"])
    print("Model answer (before fine-tuning):", clip_text(sample["prediction"]))
    print("Reference answer:", clip_text(sample["reference"]))
यहाँ मॉडल की वर्तमान प्रतिक्रिया और संदर्भ उत्तर के बीच साइड-बाय-साइड तुलना दी गई है। ये उदाहरण हमें किसी भी टास्क-विशिष्ट ट्रेनिंग से पहले मॉडल के शुरुआती बिंदु को समझने में मदद करते हैं।
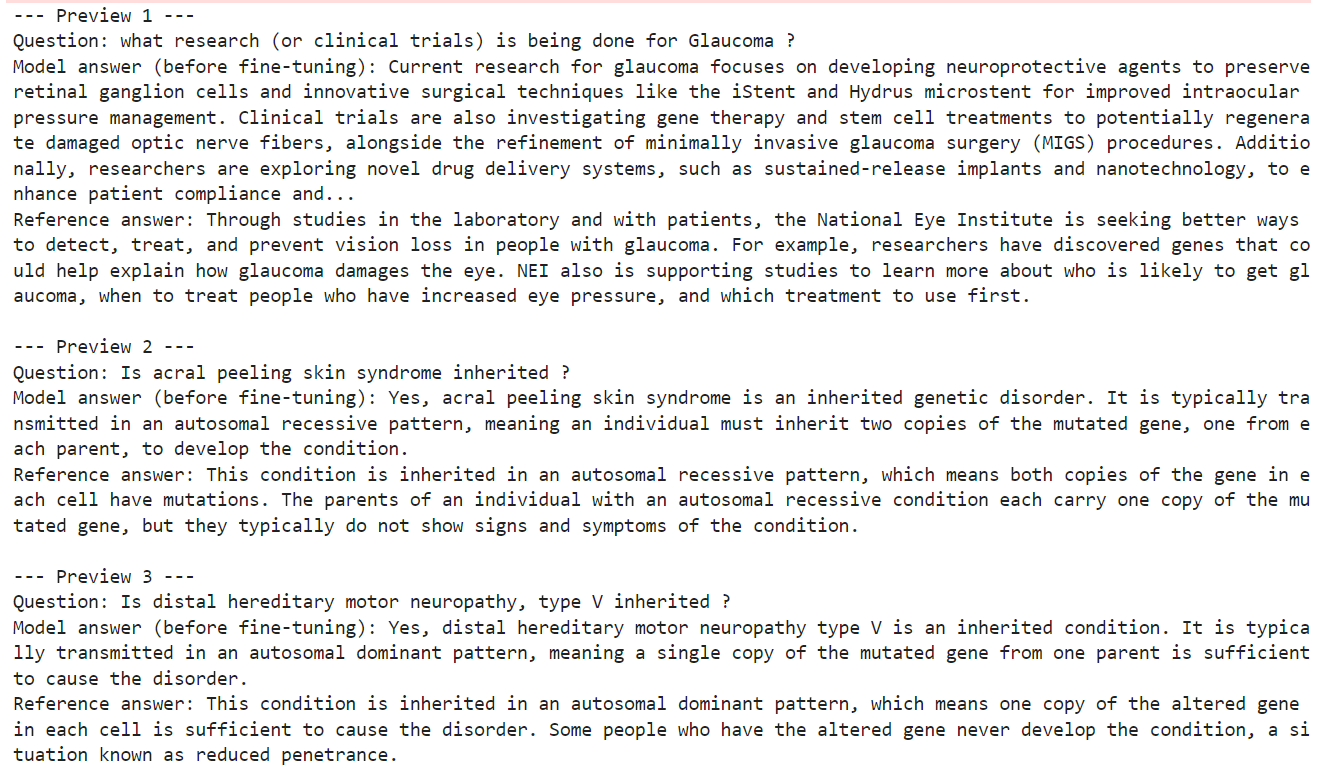
इन उदाहरणों से हम पहले ही देख सकते हैं कि बेस मॉडल चिकित्सकीय रूप से प्रासंगिक और सामान्यतः सही उत्तर देने में सक्षम है।
हालाँकि, इसकी प्रतिक्रियाएँ हमेशा डेटासेट के संदर्भ उत्तरों की शैली, विवरण स्तर, या शब्दावली से मेल नहीं खातीं। कुछ मामलों में, मॉडल व्यापक या अधिक सामान्य स्पष्टीकरण देता है, जबकि संदर्भ उत्तर अधिक विशिष्ट होते हैं और लक्ष्य फॉर्मैट के साथ बेहतर मेल खाते हैं।
इस भाग में, हम LoRA एडॉप्टर सेटिंग्स परिभाषित करेंगे, सुपरवाइज़्ड फाइन-ट्यूनिंग के लिए आर्ग्युमेंट्स कॉन्फ़िगर करेंगे, और उस ट्रेनर को इनिशियलाइज़ करेंगे जो QLoRA ट्रेनिंग प्रक्रिया को संभालेगा।
सभी मॉडल पैरामीटर्स को अपडेट करने के बजाय, QLoRA एक बहुत छोटे सेट के ट्रेन करने योग्य एडॉप्टर वेट्स को फाइन-ट्यून करता है। इससे ट्रेनिंग बहुत अधिक मेमोरी-कुशल हो जाती है, जबकि मॉडल को नए टास्क के अनुसार अनुकूलित होने की अनुमति मिलती है।
यहाँ, हम रैंक 8, स्केलिंग फ़ैक्टर 16, और एक छोटे ड्रॉपआउट मान के साथ LoRA कॉन्फ़िगरेशन परिभाषित करते हैं। हम सभी linear लेयर्स को टार्गेट करते हैं ताकि मॉडल में व्यापक रूप से एडॉप्टर लगाए जा सकें।
lora_config = LoraConfig(
    r=8,
    lora_alpha=16,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules="all-linear",
)इसके बाद, हम SFTConfig का उपयोग करके ट्रेनिंग कॉन्फ़िगरेशन परिभाषित करते हैं। ये सेटिंग्स सुपरवाइज़्ड फाइन-ट्यूनिंग रन के व्यवहार को नियंत्रित करती हैं, जिनमें बैच साइज़, ग्रेडिएंट एक्यूम्युलेशन, लर्निंग रेट, लॉगिंग फ़्रीक्वेंसी, और प्रिसिशन मोड शामिल हैं।
यह ट्यूटोरियल प्रदर्शन उद्देश्यों के लिए एक हल्के सेटअप का उपयोग करता है—एक ट्रेनिंग epoch और छोटा बैच साइज़—ताकि रन व्यावहारिक रहे। हम ट्रेनिंग के दौरान मेमोरी उपयोग कम करने के लिए gradient checkpointing और paged 8-bit AdamW भी सक्षम करते हैं।
trainer_config = SFTConfig(
    output_dir=OUTPUT_DIR,
    dataset_text_field="text",
    max_length=MAX_SEQ_LENGTH,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=2,
    num_train_epochs=1,
    learning_rate=1e-4,
    warmup_steps=5,
    logging_steps=5,
    save_strategy="epoch",
    report_to="none",
    packing=False,
    gradient_checkpointing=True,
    optim="paged_adamw_8bit",
    bf16=supports_bf16(),
    fp16=not supports_bf16(),
)एडॉप्टर सेटिंग्स और ट्रेनिंग आर्ग्युमेंट्स तैयार होने के साथ, अब हम SFTTrainer इनिशियलाइज़ कर सकते हैं। यह ट्रेनर बेस मॉडल, फॉर्मैट किया हुआ ट्रेनिंग डेटासेट, LoRA कॉन्फ़िगरेशन, और टोकनाइज़र को एक साथ लाता है ताकि मॉडल सुपरवाइज़्ड फाइन-ट्यूनिंग के लिए तैयार हो जाए।
trainer = SFTTrainer(
    model=model,
    train_dataset=formatted_train_dataset,
    peft_config=lora_config,
    args=trainer_config,
    processing_class=tokenizer,
)
ट्रेनिंग शुरू करने से पहले, यह पुष्टि करना उपयोगी है कि वास्तव में कितने पैरामीटर्स अपडेट होंगे। QLoRA के मुख्य फ़ायदों में से एक यह है कि मॉडल का केवल एक बहुत छोटा हिस्सा trainable होता है।
trainer.model.print_trainable_parameters()यह दर्शाता है कि केवल लगभग 0.03% पूर्ण मॉडल पैरामीटर्स को ट्रेन किया जा रहा है। यही QLoRA को सीमित हार्डवेयर पर बड़े भाषा मॉडलों को फाइन-ट्यून करने का एक व्यावहारिक तरीका बनाता है।
trainable params: 11,238,720 || all params: 34,671,849,408 || trainable%: 0.0324इस खंड में, हम सुपरवाइज़्ड फाइन-ट्यूनिंग रन शुरू करेंगे, प्रशिक्षित एडॉप्टर को लोकली सेव करेंगे, और फिर उसे Hugging Face पर पुश करेंगे ताकि बाद में पुन: उपयोग किया जा सके।
अब जबकि मॉडल, डेटासेट, और ट्रेनर तैयार हैं, हम फाइन-ट्यूनिंग प्रक्रिया शुरू कर सकते हैं। ट्रेनर फॉर्मैट किए गए ट्रेनिंग सेट पर चलेगा और फुल मॉडल के बजाय केवल LoRA एडॉप्टर वेट्स को अपडेट करेगा।
train_result = trainer.train()
train_result
ट्रेनिंग के दौरान, आपको लॉस में धीरे-धीरे कमी दिखाई देनी चाहिए। यह एक अच्छा संकेत है कि मॉडल टास्क फॉर्मैट सीख रहा है और मेडिकल प्रश्न-उत्तर डेटा के अनुकूल हो रहा है।
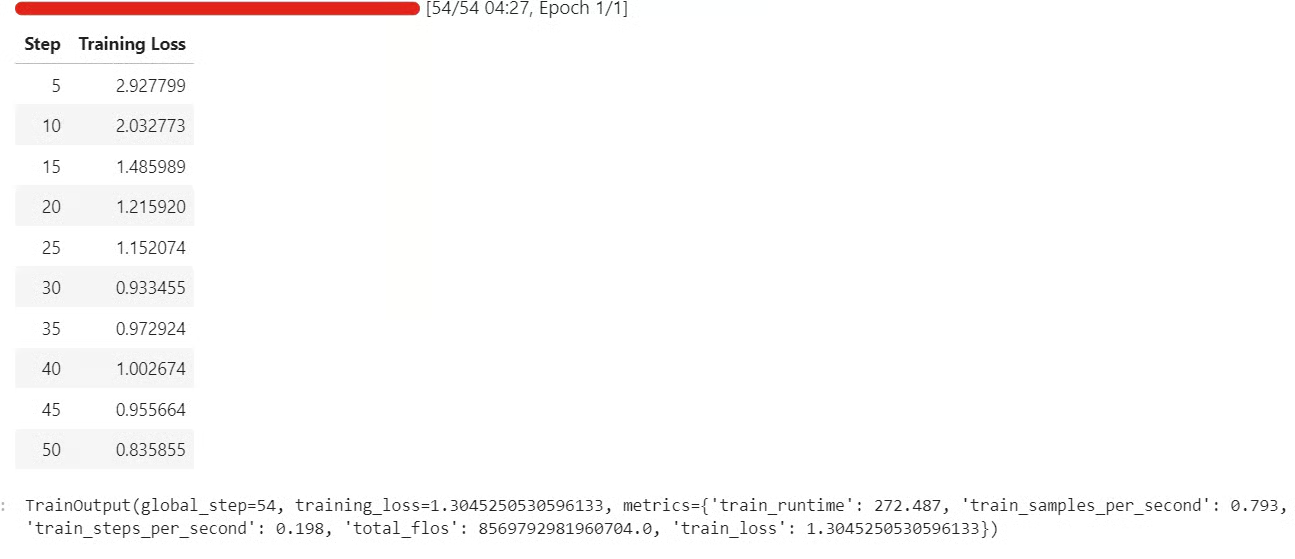
ट्रेनिंग समाप्त होने के बाद, फाइन-ट्यून किया गया एडॉप्टर और टोकनाइज़र लोकली सेव करें। इससे आपको एक पुन: उपयोग योग्य चेकपॉइंट मिलता है जिसे आप बाद में फिर से लोड कर सकते हैं, बिना पूरी ट्रेनिंग दोहराए।
trainer.model.save_pretrained(OUTPUT_DIR)
tokenizer.save_pretrained(OUTPUT_DIR)एडॉप्टर लोकली सेव होने के बाद, आप इसे Hugging Face पर अपलोड कर सकते हैं। इससे शेयर करना, वर्ज़निंग करना, और भविष्य की नोटबुक्स या डिप्लॉयमेंट वर्कफ़्लोज़ में फाइन-ट्यून मॉडल को फिर से लोड करना आसान हो जाता है।
HF_REPO_ID = "kingabzpro/qwen36-medquad-quick"
trainer.model.push_to_hub(HF_REPO_ID)
tokenizer.push_to_hub(HF_REPO_ID)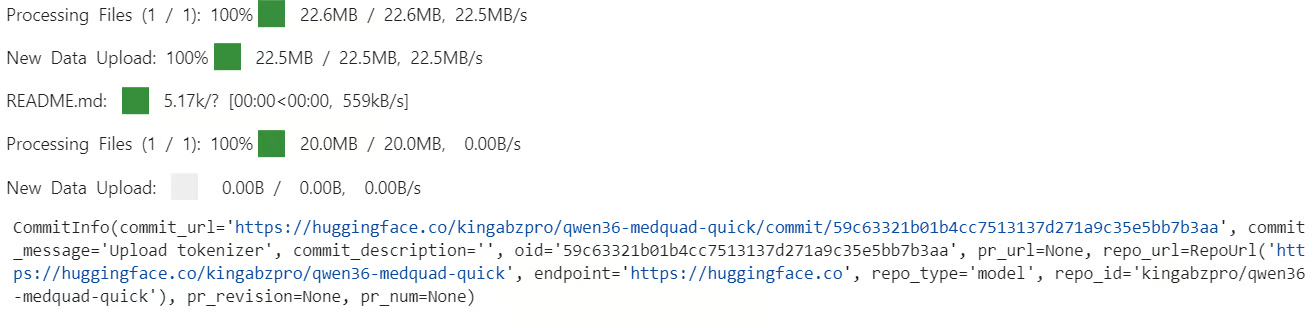 अपलोड समाप्त होने के बाद, फाइन-ट्यून किया गया एडॉप्टर इस रिपोजिटरी से उपलब्ध होगा।
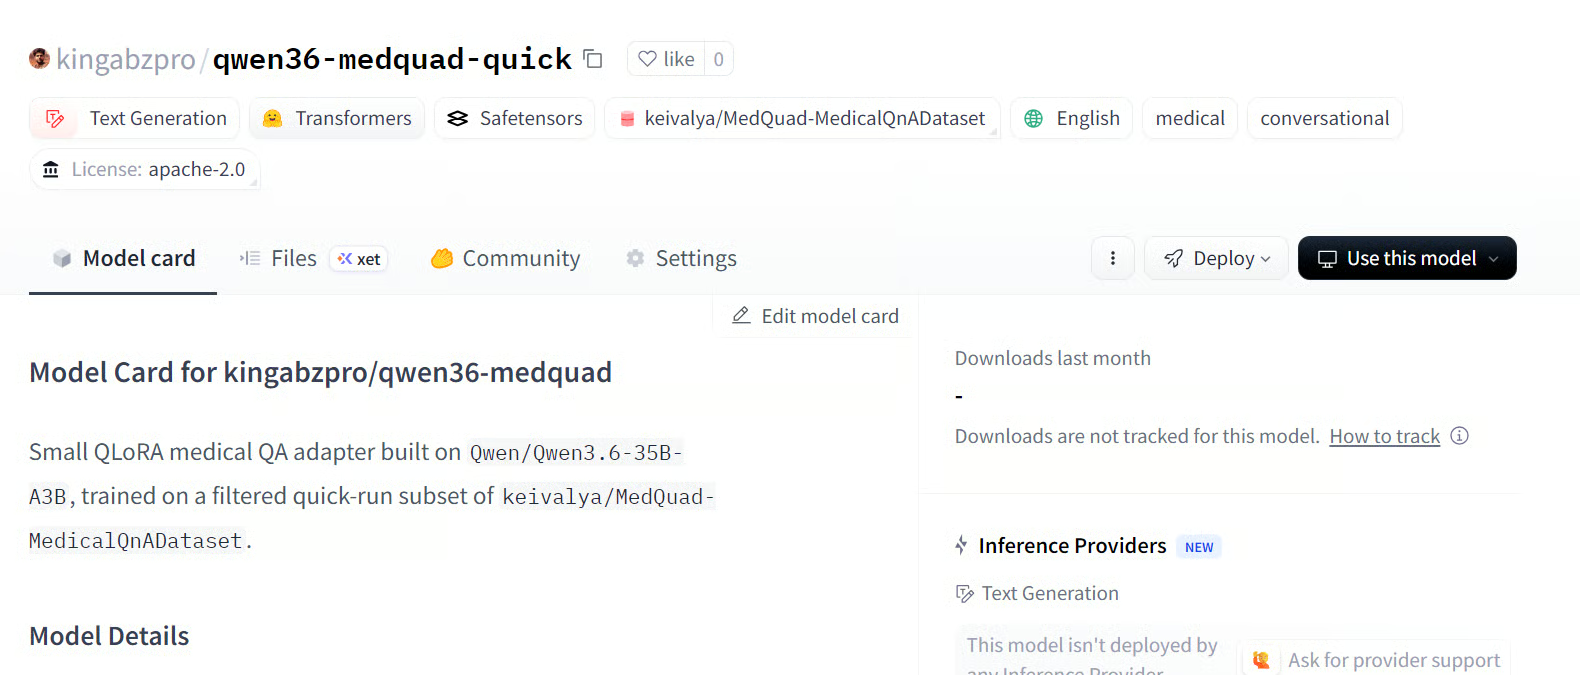
स्रोत: kingabzpro/qwen36-medquad-quick
अब जबकि ट्रेनिंग पूरी हो गई है, हम उन्हीं तुलना उदाहरणों पर फाइन-ट्यून मॉडल का मूल्यांकन कर सकते हैं जिनका उपयोग हमने पहले किया था। इससे हमें बिल्कुल वही प्रश्नों पर पहले और बाद का प्रत्यक्ष तुलना करने में मदद मिलती है।
model.eval()

fine_tuned_previews = generate_preview_rows(comparison_examples)

for idx, (before, after) in enumerate(
    zip(baseline_previews, fine_tuned_previews), start=1
):
    print(f"\n{'=' * 80}")
    print(f"Sample {idx}")
    print(f"{'=' * 80}")
    print("Question:", before["question"])
    print("\nBefore fine-tuning:")
    print(clip_text(before["prediction"]))
    print("\nAfter fine-tuning:")
    print(clip_text(after["prediction"]))
    print("\nReference answer:")
    print(clip_text(before["reference"]))
आपको प्रत्येक सैंपल के लिए बेसलाइन उत्तर, फाइन-ट्यून किया गया उत्तर, और संदर्भ उत्तर दिखना चाहिए। इससे यह देखना आसान हो जाता है कि एडॉप्टर ने मॉडल की प्रतिक्रिया शैली और सामग्री को कैसे बदला।
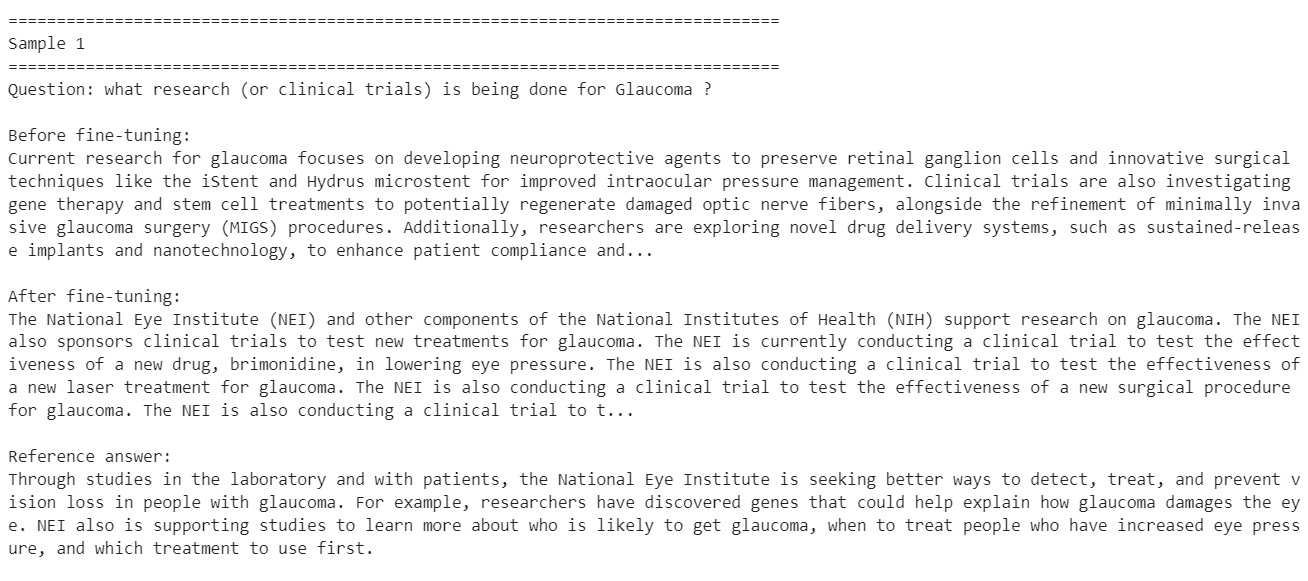
ये उदाहरण दिखाते हैं कि फाइन-ट्यूनिंग ने मॉडल को लक्षित डेटासेट की शैली के अधिक निकट अनुकूलित करने में मदद की, विशेष रूप से छोटे, तथ्यात्मक मेडिकल प्रश्नों पर।
साथ ही, परिणाम यह भी दिखाते हैं कि यह केवल डेटासेट के सीमित सबसेट पर एक छोटा फाइन-ट्यूनिंग रन था, इसलिए हर सैंपल पर सुधार की गारंटी नहीं है। कुछ उत्तर ट्रेनिंग डिस्ट्रीब्यूशन के साथ अधिक संरेखित हो जाते हैं, जबकि अन्य उपयोगी विवरण खो सकते हैं या बहुत संकीर्ण हो सकते हैं।
बेहतर परिणाम पाने के लिए, अगला कदम छोटे सबसेट के बजाय पूरे डेटासेट पर ट्रेनिंग करना होगा और कम से कम 3 epochs के लिए फाइन-ट्यूनिंग चलाना होगा। आप LoRA रैंक बढ़ाकर एडॉप्टर को अधिक सीखने की क्षमता दे सकते हैं, और सिस्टम प्रॉम्प्ट को और परिष्कृत कर सकते हैं ताकि मॉडल वांछित मेडिकल उत्तर शैली को अधिक सुसंगत रूप से फ़ॉलो करे।
इन परिवर्तनों से संभवतः प्रश्नों की एक व्यापक श्रृंखला में अधिक स्थिर सुधार प्राप्त होंगे।
एक आधुनिक भाषा मॉडल को फाइन-ट्यून करना उतना सरल नहीं है जितना पहली नज़र में लग सकता है।
यद्यपि Qwen3.6-35B-A3B 35 बिलियन कुल पैरामीटर्स वाला एक कुशल mixture-of-experts मॉडल है, फिर भी इसे 4-बिट मोड में लोड करने और ट्रेनिंग के लिए तैयार करने में गंभीर कंप्यूटिंग की आवश्यकता होती है। स्वयं ट्रेनिंग भी महँगी रहती है, खासकर जब आप छोटे प्रायोगिक सबसेट से आगे बढ़कर बड़े डेटासेट या कई epochs के साथ काम करना शुरू करते हैं।
हार्डवेयर भी बहुत मायने रखता है। इस ट्यूटोरियल में, हमने वर्कफ़्लो को व्यावहारिक बनाए रखने के लिए H100 NVL का उपयोग किया। पुराने GPU पर, ट्रेनिंग समय नाटकीय रूप से बढ़ सकता है। यहाँ तक कि A100 पर भी, समान सेटअप में आसानी से लगभग एक घंटा लग सकता है, और कमजोर GPUs पर यह समय और बढ़ जाएगा।
तो जबकि QLoRA और 4-बिट लोडिंग फाइन-ट्यूनिंग को अधिक सुलभ बनाते हैं, वे इसे रोज़मर्रा के अर्थ में हल्का नहीं बनाते। यह पूछना भी सार्थक है कि क्या पहली जगह में फाइन-ट्यूनिंग आवश्यक है। कई बुनियादी कार्यों के लिए, मैं सीधे फाइन-ट्यूनिंग पर कूदने की अनुशंसा नहीं करूँगा।
यदि आप प्रॉम्प्ट को बेहतर बनाने, वर्कफ़्लो को बेहतर संरचित करने, और टूल्स, MCPs, या रिट्रीवल-आधारित तरीकों का उपयोग करने में समय लगाते हैं, तो आप अक्सर बिना किसी ट्रेनिंग के लक्ष्य व्यवहार के काफ़ी क़रीब पहुँच सकते हैं। कई मामलों में, इससे आप उस परिणाम के लगभग 80% तक पहुँच सकते हैं जिसे आप चाहते हैं—और यह कहीं अधिक तेज़, सस्ता, और दोहराने में आसान होता है।
फाइन-ट्यूनिंग तब बहुत अधिक मूल्यवान हो जाती है जब आपको मॉडल से लगातार किसी बहुत विशिष्ट प्रतिक्रिया शैली, डोमेन व्यवहार, या संस्थागत फॉर्मैट को सीखने की आवश्यकता होती है। वहीं यह समझ में आता है। यदि आप चाहते हैं कि मॉडल बिल्कुल उसी तरह उत्तर दे जैसा किसी विशेष अस्पताल, मेडिकल सिस्टम, या विशेषज्ञ वर्कफ़्लो में प्रश्नों का उत्तर दिया जाता है, तो फाइन-ट्यूनिंग बेहतर मार्ग है।
दूसरे शब्दों में, पहले प्रॉम्प्टिंग और वर्कफ़्लो डिज़ाइन का उपयोग करें, और जब वास्तव में आपको मॉडल से किसी विशेष शैली को आंतरिक रूप से सीखवाने की ज़रूरत हो तभी फाइन-ट्यूनिंग की ओर रुख करें।
सर्वश्रेष्ठ AI कोर्स
लर्निंग पाथ
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें