使用 AI 模型进行构建,通常意味着在测试第一条提示词之前,您得先折腾 API 密钥、翻文档、写样板代码。Google AI Studio 省去了这些前期准备,直接把您带入一个基于浏览器的操练场,您可以与 Gemini 模型对话、生成多媒体,并在不写代码的情况下进行应用原型设计。
本教程涵盖 Google AI Studio 的核心功能:用于提示词测试的 Chat 模式、支持语音和视频交互的 Stream 模式、用自然语言创建应用的 Build 模式,以及面向图像、视频与音频的媒体生成工具。
您将了解针对不同任务应选择哪些 Gemini 模型,以及如何将原型导出为可用于生产的代码。关于今年 Google 最新的 AI 发布,请参阅我们关于 Gemini 3.5 Flash 和 Nano Banana 2 的指南,或阅读我们的 Google Antigravity CLI 教程。您也可以学习 如何使用 Google ADK 构建 AI Agent。
要点速览
- Google AI Studio 是一款免费的浏览器平台,可在文本、图像、视频与音频等多模态上,基于 Gemini 模型进行原型开发
- Chat 模式用于测试提示词,Build 模式可从自然语言生成完整的 React 与 Android 应用,Stream 模式支持语音/视频对话
- Gemini 3.5 Flash(于 Google I/O 2026 发布)是全新旗舰模型,提供 100 万上下文窗口与 65K 输出 Token
- Build 模式现由 Antigravity Agent 驱动,支持使用 Kotlin 与 Jetpack Compose 开发原生 Android 应用
- 免费层采用基于算力的使用上限,每五小时重置一次,所有 Gemini 3 模型均可访问
什么是 Google AI Studio?
Google AI Studio 是一款免费的、基于浏览器的 Gemini AI 模型原型平台。它提供 Chat 模式用于测试提示词、Build 模式用于从自然语言创建 React 应用、Stream 模式用于语音和视频交互,而这一切都无需编写任何初始化代码。
开始使用 Google AI Studio
上手 Google AI Studio 不到一分钟。前往 aistudio.google.com,使用任一 Google 账号登录即可。无需安装、无需信用卡、无需等待,平台完全在您的浏览器中运行。
界面左侧为导航侧栏,包含五个主要版块:Home、Playground、Build、Dashboard 和 Documentation。主页提供三个操作卡片,方便快速进入常见任务,如与模型聊天或构建应用。在侧栏底部,您会看到“Get API key”和“Settings”链接,用于管理您的账户。
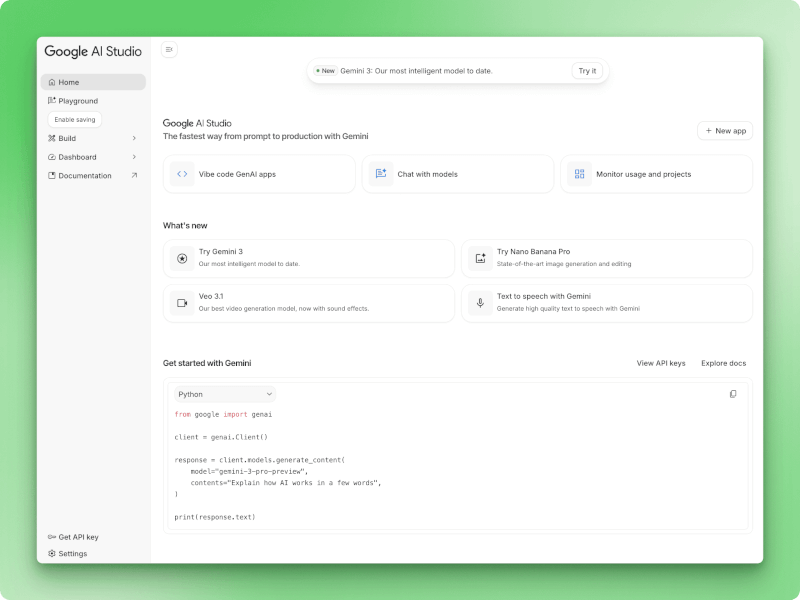
Google AI Studio 主页
若要在您自己的应用中开始使用 Gemini API,请点击左侧侧栏底部的“Get API key”。这会打开 API Keys 管理页面,您可以通过“Create API key”按钮创建新的密钥。
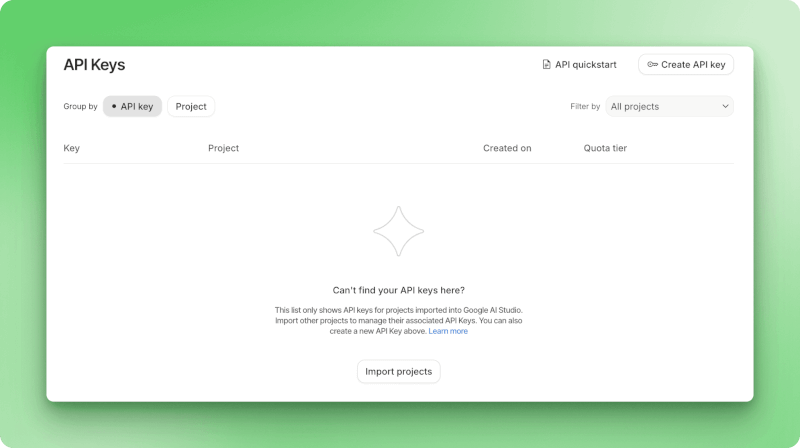
API Keys 管理页面
请妥善保管您的 API 密钥,避免将其提交到公共代码库。
在开始试验之前,先了解哪种 Gemini 模型适合您的任务很重要。AI Studio 提供多种选项,各有侧重。
Google AI Studio 提供哪些模型?
在 AI Studio 中您会发现多种 Gemini 模型,分别针对不同任务打造。您需要在推理能力、速度、成本及图像生成等专项能力之间做权衡。
Gemini 3 系列
gemini-3-pro 模型适合需要深入分析的复杂推理任务。其发布时在 Elo 榜单上得分 1501。不过,gemini-3-pro 已于 2026 年 3 月弃用并下线。其继任者 gemini-3.1-pro-preview 在编码与 Agent 能力方面有所提升。最新旗舰请见下文的 Gemini 3.5 Flash。
它提供 100 万 Token 的上下文窗口,您可以输入整套代码库或研究论文,并获得最多 65,000 个 Token 的输出。
该模型包含 thinking_level 参数,允许您根据任务调整推理深度。有关 Gemini 3 功能与基准测试的深入解读,请参阅 DataCamp 的 Gemini 3 指南。
在图像生成方面,gemini-3-pro-image(昵称为 Nano Banana Pro)可生成 2K 与 4K 图像,并能在图像中渲染可读文本。大多数图像模型在文本渲染上表现不佳,而它能很好胜任。可用 65,000 个输入 Token 与 32,000 个输出 Token。
需要注意的一点:Gemini 3 系列不支持 Google Maps grounding。如果您需要定位类能力,请选择 Gemini 2.5 Pro。
Gemini 2.5 系列
gemini-2.5-pro 模型采用“先思考”的路径,在回应前会将更多时间花在复杂分析上。它同样提供 100 万上下文与 65K 输出容量,并且是唯一支持 Google Maps grounding 的模型。
Flash 变体在一定程度上以速度和成本换取推理深度:
Gemini 3.5 系列(2026 年 5 月)
在 Google I/O 2026 上,Google 推出了 gemini-3.5-flash,它成为 Gemini 产品线的新默认模型。在编码与 Agent 基准上超越 Gemini 3.1 Pro:Terminal-Bench 2.1 得分 76.2%,MCP Atlas 得分 83.6%,GDPval-AA Elo 达到 1656。它保留 100 万 Token 的上下文窗口与 65,536 个输出 Token,推理速度约为每秒 289 Token。
该模型与 Antigravity agent 框架协同优化,是需要多步工具使用的 Agent 流程首选。API 定价为每百万输入 Token 1.50 美元、每百万输出 Token 9.00 美元,对缓存输入提供 90% 折扣。
gemini-3.5-pro 正在内部测试,预计于 2026 年 6 月推出。
如何在 Google AI Studio 中选择合适的模型
-
若您在处理编码问题、数学分析或任何需要逐步推理的任务,请先选用 gemini-3.5-flash。
-
当您需要 Maps grounding 或倾向于“思考优先”的路径时,切换到 gemini-2.5-pro。
-
多数日常任务使用 gemini-2.5-flash 即可获得稳健表现且成本更低。
-
当您需要处理大量简单请求时,请使用 gemini-2.5-flash-lite。
-
当您需要在图像中生成真正可读的文字时,选择 nano-banana-pro。
所有 Gemini 模型(包括 Gemini 3 Flash 与 Gemini 3 Pro)均提供免费层访问,使用配额每五小时刷新一次。自 I/O 2026 起,Google 将限速策略从“每分钟请求数”改为“基于算力的使用上限”,轻量请求消耗更少额度,而复杂的编码或视频请求消耗更多。
了解了模型选择后,我们继续通过 Chat 模式与模型交互,先在不写任何代码的情况下测试提示词并优化思路。
AI Studio 的 Chat 模式与 Playground
Playground 让您通过可视化控件测试提示词。您可以微调参数、切换工具开关,并在找到可行配置后,将整个设置导出为可运行的代码。
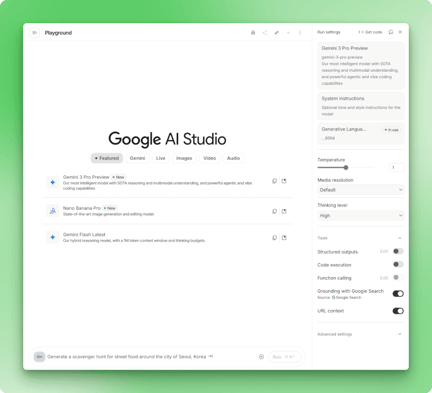
Google AI Studio 的 Playground 界面展示了系统指令、模型参数(如 temperature 与 thinking level),以及包含代码执行与 Google 搜索 grounding 在内的工具
系统指令用于设定整场对话中的模型行为,无需在每条提示词中重复相同的上下文。Temperature 控制回复的随机性:约 0.3 的低值可获得更一致的格式,约 1.5 的高值更适合创作写作。Gemini 3 模型中的思考层级下拉框可在推理深度与速度之间做权衡。
若想生成图像而非文本,可在顶部下拉菜单切换为 Nano Banana Pro。相同的参数控制依然适用,但输出将是 2K 或 4K 的图像,并包含可读的文本渲染。
除了图像,Chat 模式也支持其他媒体。Veo 3.1 可生成带原生音频的视频,支持口型同步、原生 9:16 竖屏输出,以及 1080p/4K 升尺度。
Google 还在 I/O 2026 推出了 Gemini Omni Flash,这是一个新的多模态模型,可基于文本、图像与视频的组合来生成与编辑视频。
在音频方面,您可以使用文本转语音,或使用 Lyria 3 进行音乐生成(Lyria 3 Pro 可创作最长 3 分钟的完整歌曲,Lyria 3 Clip 支持 30 秒片段)。Lyria RealTime 则支持交互式音乐创作,模型会实时响应您的输入。
诸如 Google 搜索 Grounding 等工具可在训练数据不足时补充最新信息。
代码执行可直接运行 Python 以进行计算或数据处理。其他开关可连接您的自有 API、强制输出符合 JSON 架构,或将 URL 引入对话。
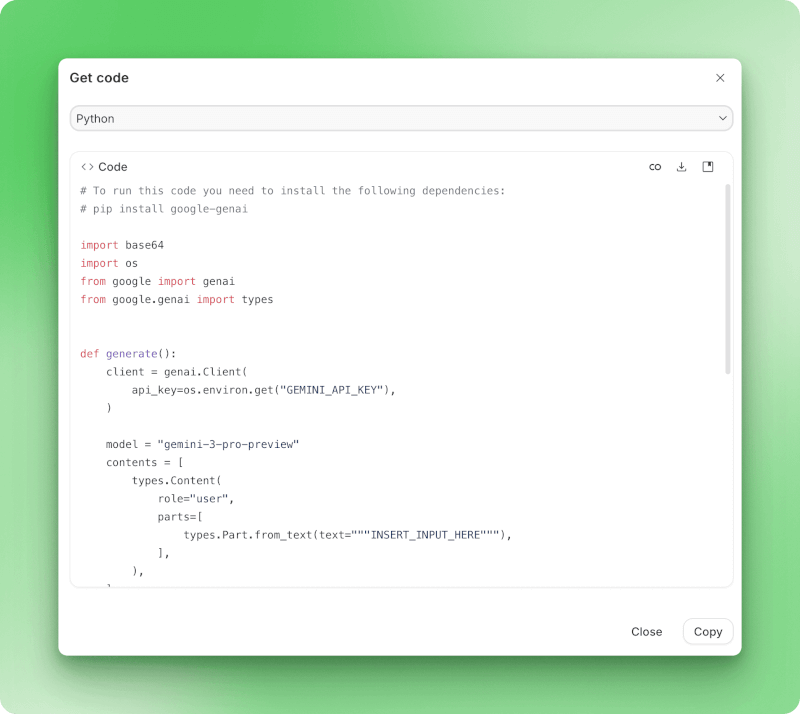
Google AI Studio 的“获取代码”对话框,展示了导出的包含 Gemini API 实现的 Python 代码
当您准备从测试转向生产时,点击“Get code”即可将全部内容导出为实现代码。
而 Stream 模式则在此基础上加入了语音与视频交互能力。
AI Studio 的 Stream 模式(Live API)
Stream 模式将基于文本的提示词变成可对话的交流,Gemini 可以“看见”和“听见”您。您通过麦克风与模型交谈、共享屏幕,并实时获得语音回复,无需打字。
要访问 Stream 模式,您可以打开 https://aistudio.google.com/live。
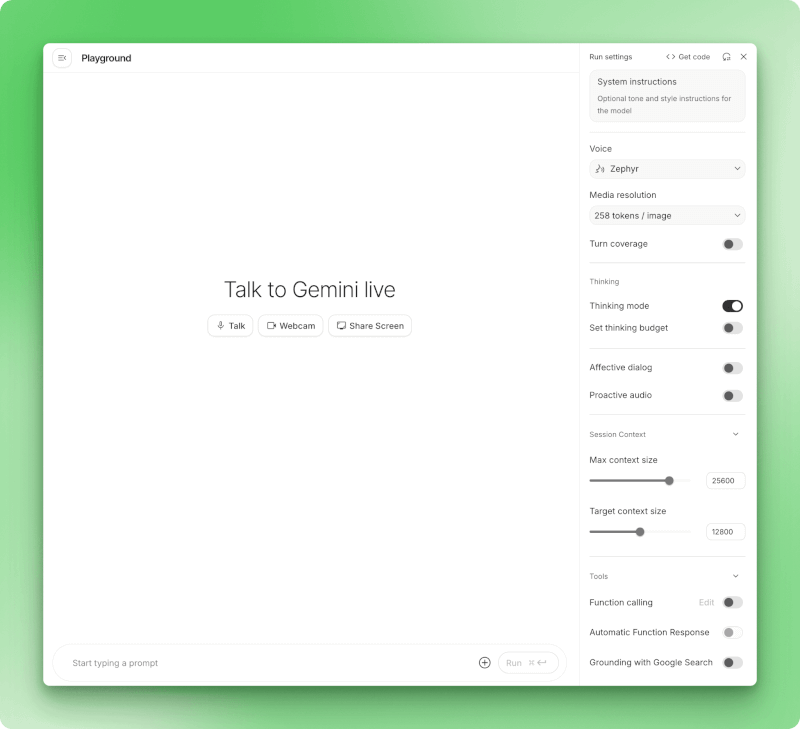
Google AI Studio 的 Stream 模式界面,展示了 Talk、Webcam 与 Share Screen 按钮,以及侧栏中的语音设置与配置选项
界面提供三种选项:Talk 用于仅语音交互,Webcam 可加入您的视频画面,Share Screen 则共享屏幕内容。
语音活动检测会自动运行。Gemini 会等待您停顿后再回答,因此您可以不间断地讲完思路,无需在轮次间点击任何控件。模型会同时处理您的语音、来自摄像头的视频,以及您所展示的内容。
您还可以为模型回复选择不同的声音,例如设置中显示的“Zephyr”音色。模型的内部推理会以可展开的 Thoughts 区块呈现,让您了解它得出答案的过程。
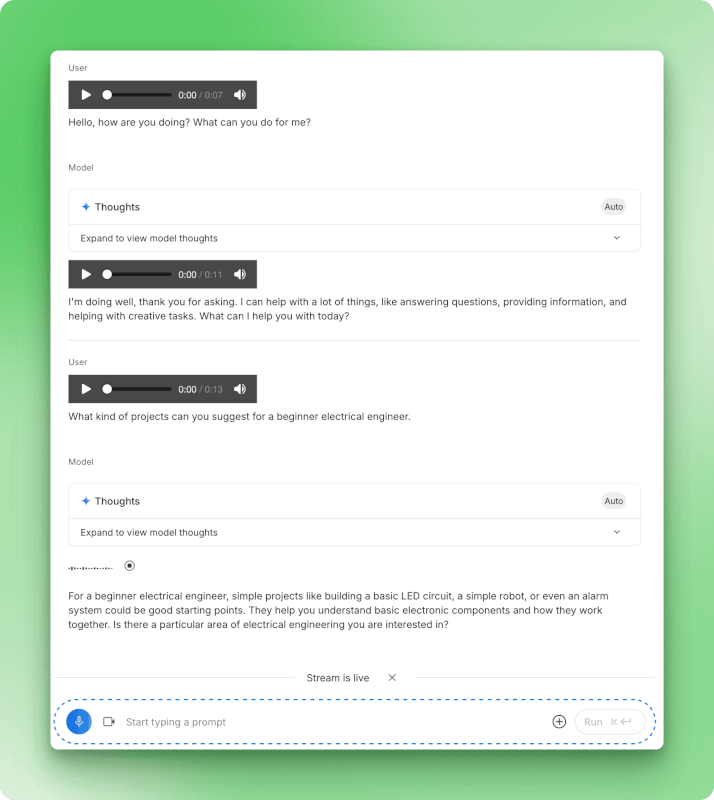
Stream 模式对话,展示了带音频波形的语音交互、模型思考过程以及用户与 Gemini 之间的实时回应
这种免手操作的交互非常适合需要当场展示并获得口头指导的实时辅导场景。
您可以在讲解思路的同时演算一道数学题,Gemini 能指出逻辑出现问题的地方。调试时,展示 IDE 并口述错误现象,会更高效。您的屏幕会以画中画形式显示,Gemini 能准确看到您所指的内容。
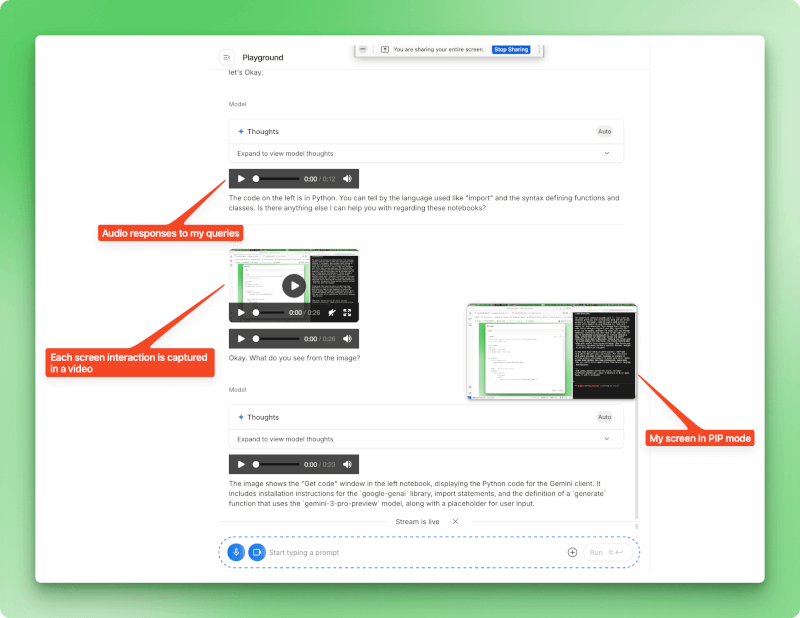
启用屏幕共享的 Stream 模式,展示了共享屏幕的画中画视图与音频回复,同时 Gemini 会分析显示内容
如果您在彩排演示或过一遍 Demo,Stream 模式可以“观看”您的幻灯片,并回答相关问题。在学习新软件时也很有帮助:您可以展示界面、询问某个功能的位置,并在导航过程中获得指引。
当您需要语音与画面的实时往返交流时,Stream 模式很合适。而在需要复制文本回复、或迭代书面提示词的文字密集型工作中,Chat 模式仍更合适。Stream 模式负责实时交互,Build 模式则允许您从自然语言描述创建完整应用。
AI Studio 的 Build 模式(Vibe Coding)
Build 模式可将描述转化为可运行的应用。您只需输入需求,Antigravity Agent 便会生成代码。Google 将此称为“vibe coding”,且自 I/O 2026 起,它的能力已远超 React Web 应用。您现在可以使用 Kotlin 与 Jetpack Compose 构建原生 Android 应用,在基于浏览器的 Android 模拟器中预览,通过 ADB 在真机上测试,甚至直接发布到 Google Play 的 Internal Test Track。
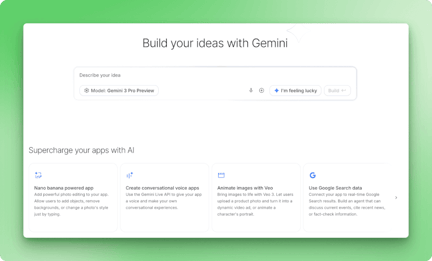
Build 模式落地页展示了包含 Gemini 3 Pro Preview 模型选择器的提示输入框、“I'm feeling lucky”按钮,以及 AI Chips 区域(包括基于 Nano Banana 的应用、对话式语音应用、Veo 视频动画与 Google 搜索数据集成)
我先浏览了入门模板库。像 Shader Pilot 这样的应用展示了可能性——交互式 3D 可视化、自定义字体的落地页,甚至是小型游戏。您可以分叉任意示例,并通过助手面板修改代码。
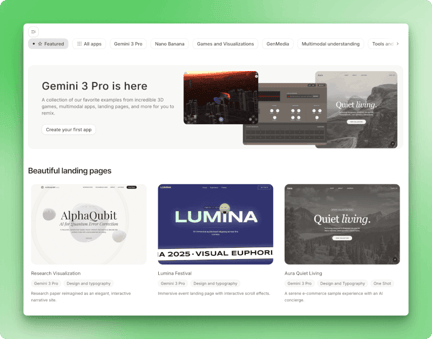
入门应用库展示了 Gemini 3 Pro 精选示例,包括 3D 游戏、多模态应用,以及“精美落地页”专区中的 AlphaQubit 研究可视化、Lumina Festival 活动页与 Aura Quiet Living 电商演示
我想从零开始,于是输入了:“一个极简却视觉冲击力强的应用,能在极坐标下可视化最多 3 个变量的任意方程。”
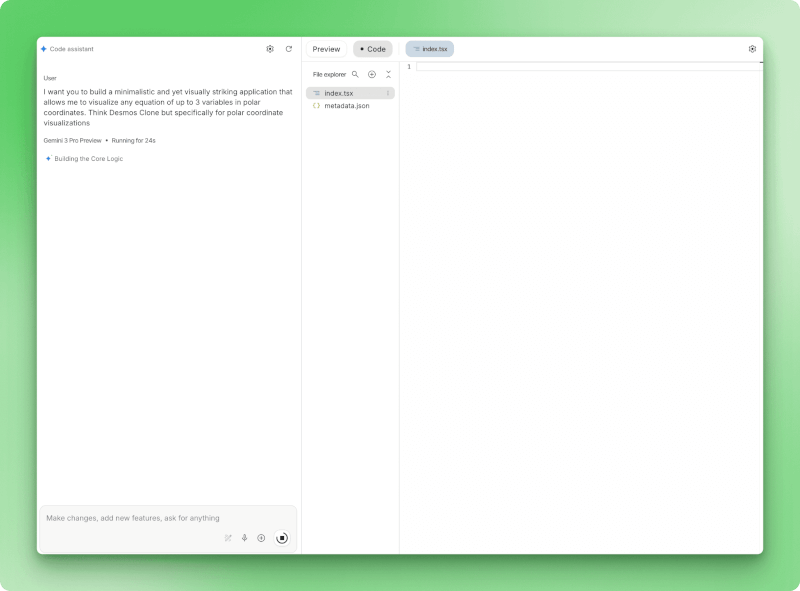
Polar.ai 构建中,显示用户请求极坐标方程可视化器,Gemini 3 Pro Preview 状态指示“Running for 24s”,进度提示“Building the Core Logic”,文件面板显示已生成的 index.tsx 与 metadata.json
大约 60 秒后,Polar.ai 生成完毕。模型创建了 React 文件(index.tsx、metadata.json),构建了方程解析器,并设置了变量滑块。我输入“a heart(心形)”,它便绘制出极坐标曲线。切换为“bat(蝙蝠)”则产生不同的形状。
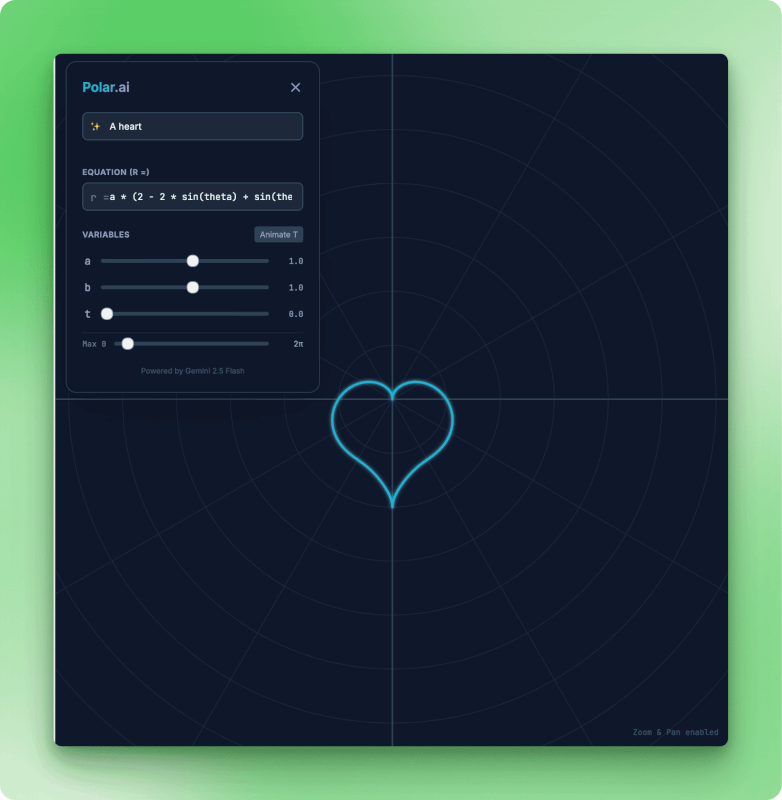
Polar.ai 应用显示青色心形极坐标曲线,置于暗色网格背景;方程编辑器显示 r 等于 a 乘以正弦公式;a、b、t 变量滑块均为 1.0;最大 θ 为 2π;带有“Animate T”按钮,并标注“Powered by Gemini 2.5 Flash”
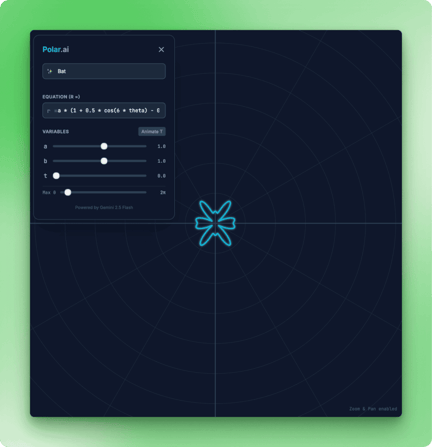
Polar.ai 应用显示蝙蝠形的极坐标可视化,呈现六瓣对称的青色图案;方程编辑器显示修改后的余弦公式,并提供变量控制以调整曲线参数,a=1.0、b=1.0、t=0.0,带有 Max theta 滑块
当蝙蝠的坐标在曲线中途消失时,我在聊天中描述了问题。模型诊断出原因(虚数导致渲染器出错),解释了修复方案,并创建了一个带“View diff”的检查点,方便我查看变更。
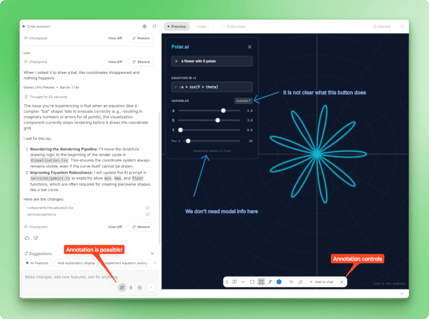
Polar.ai 调试会话:左侧显示用户关于蝙蝠坐标消失的 Bug 报告,模型以 83 秒思考时间分析了方程求值中的虚数问题,并给出重排渲染管线的详细修复方案;检查点提供“View diff”和“Restore”按钮;右侧面板为带注释工具栏的实时预览,底部可将标注“Add to chat”
注释工具栏允许您点击界面元素以请求视觉改动。完成后,您可以将应用导出为 ZIP 下载、推送到 GitHub,或部署到云托管。生成的代码遵循标准 React 模式,但在生产部署前您大概率还需要进一步打磨。
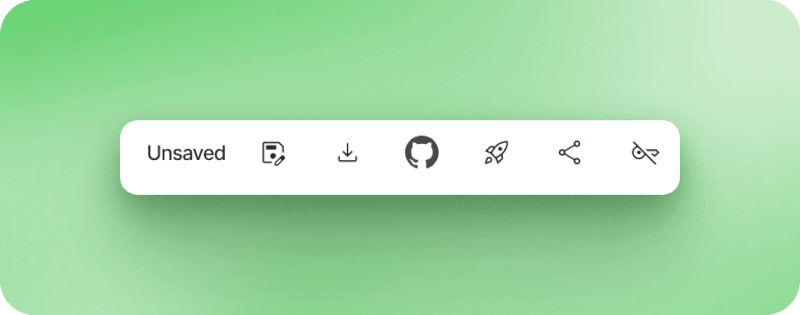
导出工具栏显示“Unsaved”状态,并提供六个操作图标:保存到 Google Drive、下载 ZIP、推送到 GitHub、部署到云托管、通过链接分享,以及项目管理选项
在 Google I/O 2026 上,Build 模式新增多项能力。Google Workspace 集成让您可将 Drive、Sheets 与 Docs 直接连接到应用中。一键部署至 Cloud Run,并支持 Firebase 作为后端以处理认证与数据库存储。您还可以将整个项目导出到 Google Antigravity 的桌面应用进行本地开发,同时保留对话历史与项目文件。
Google AI Studio 与替代方案对比
更新(2026 年 5 月): Google I/O 2026 为 AI Studio 及其竞品带来了重大变化。以下对比反映了原文撰写时的格局。关键变动:
- AI Studio 现已支持构建 Android 应用
- Gemini 3.5 Flash 成为新的默认模型
- Google 将“每分钟限速”改为“基于算力的使用上限”
当您准备将 AI 工作扩展到 Google 平台之外时,会在竞品服务中见到不同取舍。ChatGPT 拥有丰富的插件库与跨会话记忆,已成为许多用户的默认选择。
Claude 以开发者为目标,Artifacts 能将对话转化为持久化应用,并可通过 MCP 连接集成 Slack 或 Asana。
Grok 可接入 X 的实时信息流,但在复杂推理任务上略显不足。关于 Gemini 的编码能力,请参阅我们的 Gemini 3.1 Pro 编码 Agent 教程。若需在多项基准上对比 Gemini 与 ChatGPT 的表现,请查看我们的 Gemini 对比 ChatGPT 的正面交锋分析。
|
平台
|
免费层
|
付费层
|
关键优势
|
最适合
|
|
Google AI Studio
|
有限(5-15 RPM,高级模型需付费)
|
按量计费
|
Build 模式(React + Android)、Stream 模式、视频(Veo 3.1、Gemini Omni)、Maps grounding
|
多模态原型、基于 Gemini 的试验
|
|
ChatGPT
|
每 5 小时 10-60 条消息(GPT-4o)
|
$20/月
|
记忆、插件、成熟生态
|
通用任务、成熟流程
|
|
Claude
|
每日 20-40 条消息
|
$20/月
|
Artifacts、Projects(200K),编码能力强
|
应用原型、编码助手
|
|
Grok
|
每 2 小时 2-10 条提示
|
$40/月
|
实时 X 数据、Aurora 图像
|
X 集成、轻量使用
|
各平台的免费层差异较大:
- AI Studio:基于算力的上限,5 小时刷新窗口。免费层可访问全部 Gemini 3 模型。
- ChatGPT:每 5 小时 10-60 条 GPT-4o 消息,之后切换到 mini。
- Claude:每日约 20-40 条消息,5 小时重置窗口。
- Grok:每 2 小时 2-10 条提示。
ChatGPT 与 Claude 的完整网页访问订阅均为每月 20 美元。Grok 则为 40 美元。但在 API 方面,Grok 以每百万 Token 0.20 美元的价格更具优势,而 GPT-4o 为 5 美元、Claude Sonnet 为 3 美元。
预算与优先级因人而异。若您在做多模态应用的原型,AI Studio 的 Build 模式与视频生成功能,足以抵消其更紧的限速策略。
ChatGPT 生态具有动能:插件、记忆与成熟流程使得迁移成本较高。Claude 的 200K Token Projects 吸引需要大上下文处理代码的开发者。Grok 则在低价 API 访问(每百万 Token 0.20 美元)与实时 X 集成上找到了定位,同时接受推理性能上的权衡。
结语
本教程演示了 Google AI Studio 支持的三类工作流:在 Chat 模式中测试提示词、在 Build 模式中通过自然语言构建应用、以及在 Stream 模式中通过语音与视频交流解决问题。该平台最适合在无需编写初始化代码的情况下,基于 Gemini 模型快速做原型。
免费层的基于算力的使用上限非常适合前期测试。准备将 Gemini 集成到生产应用后,建议查看 Gemini API 教程,内容涵盖认证、错误处理和优化模式。您还可以探索 Gemini Deep Think(高级推理),或学习 如何使用 Gemini CLI。
AI Studio 的优势在于快速原型:您可以在 Chat 模式验证想法,在 Build 模式将其实现,待可行后导出代码。基于浏览器的界面消除了常见阻力,但在生产使用时,您仍需要完善的 API 集成。


使用 AI 模型进行构建,通常意味着在测试第一条提示词之前,您得先折腾 API 密钥、翻文档、写样板代码。Google AI Studio 省去了这些前期准备,直接把您带入一个基于浏览器的操练场,您可以与 Gemini 模型对话、生成多媒体,并在不写代码的情况下进行应用原型设计。
本教程涵盖 Google AI Studio 的核心功能:用于提示词测试的 Chat 模式、支持语音和视频交互的 Stream 模式、用自然语言创建应用的 Build 模式,以及面向图像、视频与音频的媒体生成工具。
您将了解针对不同任务应选择哪些 Gemini 模型,以及如何将原型导出为可用于生产的代码。关于今年 Google 最新的 AI 发布,请参阅我们关于 Gemini 3.5 Flash 和 Nano Banana 2 的指南,或阅读我们的 Google Antigravity CLI 教程。您也可以学习 如何使用 Google ADK 构建 AI Agent。
要点速览
什么是 Google AI Studio?
Google AI Studio 是一款免费的、基于浏览器的 Gemini AI 模型原型平台。它提供 Chat 模式用于测试提示词、Build 模式用于从自然语言创建 React 应用、Stream 模式用于语音和视频交互,而这一切都无需编写任何初始化代码。
开始使用 Google AI Studio
上手 Google AI Studio 不到一分钟。前往 aistudio.google.com,使用任一 Google 账号登录即可。无需安装、无需信用卡、无需等待,平台完全在您的浏览器中运行。
界面左侧为导航侧栏,包含五个主要版块:Home、Playground、Build、Dashboard 和 Documentation。主页提供三个操作卡片,方便快速进入常见任务,如与模型聊天或构建应用。在侧栏底部,您会看到“Get API key”和“Settings”链接,用于管理您的账户。
Google AI Studio 主页
若要在您自己的应用中开始使用 Gemini API,请点击左侧侧栏底部的“Get API key”。这会打开 API Keys 管理页面,您可以通过“Create API key”按钮创建新的密钥。
API Keys 管理页面
请妥善保管您的 API 密钥,避免将其提交到公共代码库。
在开始试验之前,先了解哪种 Gemini 模型适合您的任务很重要。AI Studio 提供多种选项,各有侧重。
Google AI Studio 提供哪些模型?
在 AI Studio 中您会发现多种 Gemini 模型,分别针对不同任务打造。您需要在推理能力、速度、成本及图像生成等专项能力之间做权衡。
Gemini 3 系列
gemini-3-pro模型适合需要深入分析的复杂推理任务。其发布时在 Elo 榜单上得分 1501。不过,gemini-3-pro已于 2026 年 3 月弃用并下线。其继任者gemini-3.1-pro-preview在编码与 Agent 能力方面有所提升。最新旗舰请见下文的 Gemini 3.5 Flash。它提供 100 万 Token 的上下文窗口,您可以输入整套代码库或研究论文,并获得最多 65,000 个 Token 的输出。
该模型包含
thinking_level参数,允许您根据任务调整推理深度。有关 Gemini 3 功能与基准测试的深入解读,请参阅 DataCamp 的 Gemini 3 指南。在图像生成方面,
gemini-3-pro-image(昵称为 Nano Banana Pro)可生成 2K 与 4K 图像,并能在图像中渲染可读文本。大多数图像模型在文本渲染上表现不佳,而它能很好胜任。可用 65,000 个输入 Token 与 32,000 个输出 Token。需要注意的一点:Gemini 3 系列不支持 Google Maps grounding。如果您需要定位类能力,请选择 Gemini 2.5 Pro。
Gemini 2.5 系列
gemini-2.5-pro模型采用“先思考”的路径,在回应前会将更多时间花在复杂分析上。它同样提供 100 万上下文与 65K 输出容量,并且是唯一支持 Google Maps grounding 的模型。Flash 变体在一定程度上以速度和成本换取推理深度:
gemini-2.5-flash:比 Pro 模型响应更快,同时保留 100 万上下文窗口。适合作为通用任务的默认选择gemini-2.5-flash-lite:为大批量、简单查询的场景而设Gemini 3.5 系列(2026 年 5 月)
在 Google I/O 2026 上,Google 推出了
gemini-3.5-flash,它成为 Gemini 产品线的新默认模型。在编码与 Agent 基准上超越 Gemini 3.1 Pro:Terminal-Bench 2.1 得分 76.2%,MCP Atlas 得分 83.6%,GDPval-AA Elo 达到 1656。它保留 100 万 Token 的上下文窗口与 65,536 个输出 Token,推理速度约为每秒 289 Token。该模型与 Antigravity agent 框架协同优化,是需要多步工具使用的 Agent 流程首选。API 定价为每百万输入 Token 1.50 美元、每百万输出 Token 9.00 美元,对缓存输入提供 90% 折扣。
gemini-3.5-pro正在内部测试,预计于 2026 年 6 月推出。如何在 Google AI Studio 中选择合适的模型
若您在处理编码问题、数学分析或任何需要逐步推理的任务,请先选用
gemini-3.5-flash。当您需要 Maps grounding 或倾向于“思考优先”的路径时,切换到
gemini-2.5-pro。多数日常任务使用
gemini-2.5-flash即可获得稳健表现且成本更低。当您需要处理大量简单请求时,请使用
gemini-2.5-flash-lite。当您需要在图像中生成真正可读的文字时,选择
nano-banana-pro。所有 Gemini 模型(包括 Gemini 3 Flash 与 Gemini 3 Pro)均提供免费层访问,使用配额每五小时刷新一次。自 I/O 2026 起,Google 将限速策略从“每分钟请求数”改为“基于算力的使用上限”,轻量请求消耗更少额度,而复杂的编码或视频请求消耗更多。
了解了模型选择后,我们继续通过 Chat 模式与模型交互,先在不写任何代码的情况下测试提示词并优化思路。
AI Studio 的 Chat 模式与 Playground
Playground 让您通过可视化控件测试提示词。您可以微调参数、切换工具开关,并在找到可行配置后,将整个设置导出为可运行的代码。
Google AI Studio 的 Playground 界面展示了系统指令、模型参数(如 temperature 与 thinking level),以及包含代码执行与 Google 搜索 grounding 在内的工具
系统指令用于设定整场对话中的模型行为,无需在每条提示词中重复相同的上下文。Temperature 控制回复的随机性:约 0.3 的低值可获得更一致的格式,约 1.5 的高值更适合创作写作。Gemini 3 模型中的思考层级下拉框可在推理深度与速度之间做权衡。
若想生成图像而非文本,可在顶部下拉菜单切换为 Nano Banana Pro。相同的参数控制依然适用,但输出将是 2K 或 4K 的图像,并包含可读的文本渲染。
除了图像,Chat 模式也支持其他媒体。Veo 3.1 可生成带原生音频的视频,支持口型同步、原生 9:16 竖屏输出,以及 1080p/4K 升尺度。
Google 还在 I/O 2026 推出了 Gemini Omni Flash,这是一个新的多模态模型,可基于文本、图像与视频的组合来生成与编辑视频。
在音频方面,您可以使用文本转语音,或使用 Lyria 3 进行音乐生成(Lyria 3 Pro 可创作最长 3 分钟的完整歌曲,Lyria 3 Clip 支持 30 秒片段)。Lyria RealTime 则支持交互式音乐创作,模型会实时响应您的输入。
诸如 Google 搜索 Grounding 等工具可在训练数据不足时补充最新信息。
代码执行可直接运行 Python 以进行计算或数据处理。其他开关可连接您的自有 API、强制输出符合 JSON 架构,或将 URL 引入对话。
Google AI Studio 的“获取代码”对话框,展示了导出的包含 Gemini API 实现的 Python 代码
当您准备从测试转向生产时,点击“Get code”即可将全部内容导出为实现代码。
而 Stream 模式则在此基础上加入了语音与视频交互能力。
AI Studio 的 Stream 模式(Live API)
Stream 模式将基于文本的提示词变成可对话的交流,Gemini 可以“看见”和“听见”您。您通过麦克风与模型交谈、共享屏幕,并实时获得语音回复,无需打字。
要访问 Stream 模式,您可以打开
https://aistudio.google.com/live。Google AI Studio 的 Stream 模式界面,展示了 Talk、Webcam 与 Share Screen 按钮,以及侧栏中的语音设置与配置选项
界面提供三种选项:Talk 用于仅语音交互,Webcam 可加入您的视频画面,Share Screen 则共享屏幕内容。
语音活动检测会自动运行。Gemini 会等待您停顿后再回答,因此您可以不间断地讲完思路,无需在轮次间点击任何控件。模型会同时处理您的语音、来自摄像头的视频,以及您所展示的内容。
您还可以为模型回复选择不同的声音,例如设置中显示的“Zephyr”音色。模型的内部推理会以可展开的 Thoughts 区块呈现,让您了解它得出答案的过程。
Stream 模式对话,展示了带音频波形的语音交互、模型思考过程以及用户与 Gemini 之间的实时回应
这种免手操作的交互非常适合需要当场展示并获得口头指导的实时辅导场景。
您可以在讲解思路的同时演算一道数学题,Gemini 能指出逻辑出现问题的地方。调试时,展示 IDE 并口述错误现象,会更高效。您的屏幕会以画中画形式显示,Gemini 能准确看到您所指的内容。
启用屏幕共享的 Stream 模式,展示了共享屏幕的画中画视图与音频回复,同时 Gemini 会分析显示内容
如果您在彩排演示或过一遍 Demo,Stream 模式可以“观看”您的幻灯片,并回答相关问题。在学习新软件时也很有帮助:您可以展示界面、询问某个功能的位置,并在导航过程中获得指引。
当您需要语音与画面的实时往返交流时,Stream 模式很合适。而在需要复制文本回复、或迭代书面提示词的文字密集型工作中,Chat 模式仍更合适。Stream 模式负责实时交互,Build 模式则允许您从自然语言描述创建完整应用。
AI Studio 的 Build 模式(Vibe Coding)
Build 模式可将描述转化为可运行的应用。您只需输入需求,Antigravity Agent 便会生成代码。Google 将此称为“vibe coding”,且自 I/O 2026 起,它的能力已远超 React Web 应用。您现在可以使用 Kotlin 与 Jetpack Compose 构建原生 Android 应用,在基于浏览器的 Android 模拟器中预览,通过 ADB 在真机上测试,甚至直接发布到 Google Play 的 Internal Test Track。
Build 模式落地页展示了包含 Gemini 3 Pro Preview 模型选择器的提示输入框、“I'm feeling lucky”按钮,以及 AI Chips 区域(包括基于 Nano Banana 的应用、对话式语音应用、Veo 视频动画与 Google 搜索数据集成)
我先浏览了入门模板库。像 Shader Pilot 这样的应用展示了可能性——交互式 3D 可视化、自定义字体的落地页,甚至是小型游戏。您可以分叉任意示例,并通过助手面板修改代码。
入门应用库展示了 Gemini 3 Pro 精选示例,包括 3D 游戏、多模态应用,以及“精美落地页”专区中的 AlphaQubit 研究可视化、Lumina Festival 活动页与 Aura Quiet Living 电商演示
我想从零开始,于是输入了:“一个极简却视觉冲击力强的应用,能在极坐标下可视化最多 3 个变量的任意方程。”
Polar.ai 构建中,显示用户请求极坐标方程可视化器,Gemini 3 Pro Preview 状态指示“Running for 24s”,进度提示“Building the Core Logic”,文件面板显示已生成的 index.tsx 与 metadata.json
大约 60 秒后,Polar.ai 生成完毕。模型创建了 React 文件(
index.tsx、metadata.json),构建了方程解析器,并设置了变量滑块。我输入“a heart(心形)”,它便绘制出极坐标曲线。切换为“bat(蝙蝠)”则产生不同的形状。Polar.ai 应用显示青色心形极坐标曲线,置于暗色网格背景;方程编辑器显示 r 等于 a 乘以正弦公式;a、b、t 变量滑块均为 1.0;最大 θ 为 2π;带有“Animate T”按钮,并标注“Powered by Gemini 2.5 Flash”
Polar.ai 应用显示蝙蝠形的极坐标可视化,呈现六瓣对称的青色图案;方程编辑器显示修改后的余弦公式,并提供变量控制以调整曲线参数,a=1.0、b=1.0、t=0.0,带有 Max theta 滑块
当蝙蝠的坐标在曲线中途消失时,我在聊天中描述了问题。模型诊断出原因(虚数导致渲染器出错),解释了修复方案,并创建了一个带“View diff”的检查点,方便我查看变更。
Polar.ai 调试会话:左侧显示用户关于蝙蝠坐标消失的 Bug 报告,模型以 83 秒思考时间分析了方程求值中的虚数问题,并给出重排渲染管线的详细修复方案;检查点提供“View diff”和“Restore”按钮;右侧面板为带注释工具栏的实时预览,底部可将标注“Add to chat”
注释工具栏允许您点击界面元素以请求视觉改动。完成后,您可以将应用导出为 ZIP 下载、推送到 GitHub,或部署到云托管。生成的代码遵循标准 React 模式,但在生产部署前您大概率还需要进一步打磨。
导出工具栏显示“Unsaved”状态,并提供六个操作图标:保存到 Google Drive、下载 ZIP、推送到 GitHub、部署到云托管、通过链接分享,以及项目管理选项
在 Google I/O 2026 上,Build 模式新增多项能力。Google Workspace 集成让您可将 Drive、Sheets 与 Docs 直接连接到应用中。一键部署至 Cloud Run,并支持 Firebase 作为后端以处理认证与数据库存储。您还可以将整个项目导出到 Google Antigravity 的桌面应用进行本地开发,同时保留对话历史与项目文件。
Google AI Studio 与替代方案对比
更新(2026 年 5 月): Google I/O 2026 为 AI Studio 及其竞品带来了重大变化。以下对比反映了原文撰写时的格局。关键变动:
当您准备将 AI 工作扩展到 Google 平台之外时,会在竞品服务中见到不同取舍。ChatGPT 拥有丰富的插件库与跨会话记忆,已成为许多用户的默认选择。
Claude 以开发者为目标,Artifacts 能将对话转化为持久化应用,并可通过 MCP 连接集成 Slack 或 Asana。
Grok 可接入 X 的实时信息流,但在复杂推理任务上略显不足。关于 Gemini 的编码能力,请参阅我们的 Gemini 3.1 Pro 编码 Agent 教程。若需在多项基准上对比 Gemini 与 ChatGPT 的表现,请查看我们的 Gemini 对比 ChatGPT 的正面交锋分析。
平台
免费层
付费层
关键优势
最适合
Google AI Studio
有限(5-15 RPM,高级模型需付费)
按量计费
Build 模式(React + Android)、Stream 模式、视频(Veo 3.1、Gemini Omni)、Maps grounding
多模态原型、基于 Gemini 的试验
ChatGPT
每 5 小时 10-60 条消息(GPT-4o)
$20/月
记忆、插件、成熟生态
通用任务、成熟流程
Claude
每日 20-40 条消息
$20/月
Artifacts、Projects(200K),编码能力强
应用原型、编码助手
Grok
每 2 小时 2-10 条提示
$40/月
实时 X 数据、Aurora 图像
X 集成、轻量使用
各平台的免费层差异较大:
ChatGPT 与 Claude 的完整网页访问订阅均为每月 20 美元。Grok 则为 40 美元。但在 API 方面,Grok 以每百万 Token 0.20 美元的价格更具优势,而 GPT-4o 为 5 美元、Claude Sonnet 为 3 美元。
预算与优先级因人而异。若您在做多模态应用的原型,AI Studio 的 Build 模式与视频生成功能,足以抵消其更紧的限速策略。
ChatGPT 生态具有动能:插件、记忆与成熟流程使得迁移成本较高。Claude 的 200K Token Projects 吸引需要大上下文处理代码的开发者。Grok 则在低价 API 访问(每百万 Token 0.20 美元)与实时 X 集成上找到了定位,同时接受推理性能上的权衡。
结语
本教程演示了 Google AI Studio 支持的三类工作流:在 Chat 模式中测试提示词、在 Build 模式中通过自然语言构建应用、以及在 Stream 模式中通过语音与视频交流解决问题。该平台最适合在无需编写初始化代码的情况下,基于 Gemini 模型快速做原型。
免费层的基于算力的使用上限非常适合前期测试。准备将 Gemini 集成到生产应用后,建议查看 Gemini API 教程,内容涵盖认证、错误处理和优化模式。您还可以探索 Gemini Deep Think(高级推理),或学习 如何使用 Gemini CLI。
AI Studio 的优势在于快速原型:您可以在 Chat 模式验证想法,在 Build 模式将其实现,待可行后导出代码。基于浏览器的界面消除了常见阻力,但在生产使用时,您仍需要完善的 API 集成。