Last chance! 50% off DataCamp Premium
Sale ends in
Lavorare con i modelli di intelligenza artificiale di solito significa destreggiarsi tra API key, leggere la documentazione e scrivere codice boilerplate prima ancora di testare un singolo prompt. Google AI Studio salta tutta questa configurazione e ti porta direttamente in un playground nel browser in cui puoi chattare con i modelli Gemini, generare media e creare prototipi di applicazioni senza toccare il codice.
Questo tutorial copre le funzionalità principali di Google AI Studio: la modalità Chat per testare i prompt, la modalità Stream per interazioni vocali e video, la modalità Build per creare app con il linguaggio naturale e gli strumenti di generazione multimediale per immagini, video e audio.
Imparerai quali modelli Gemini usare per compiti diversi e come esportare i tuoi prototipi in codice pronto per la produzione. Per le ultime novità sugli annunci AI di Google di quest’anno, vedi le nostre guide su Gemini 3.5 Flash e Nano Banana 2, o il nostro tutorial su Google Antigravity CLI. Puoi anche imparare come creare AI Agent con Google ADK.
Google AI Studio è una piattaforma gratuita, basata su browser, per creare prototipi con i modelli AI Gemini. Offre la modalità Chat per testare i prompt, la modalità Build per creare app React a partire dal linguaggio naturale e la modalità Stream per interazioni vocali e video, tutto senza scrivere codice di setup.
Per iniziare con Google AI Studio basta meno di un minuto. Vai su aistudio.google.com e accedi con un qualsiasi account Google. Niente installazione, nessuna carta di credito richiesta e nessun periodo di attesa. La piattaforma gira interamente nel tuo browser.
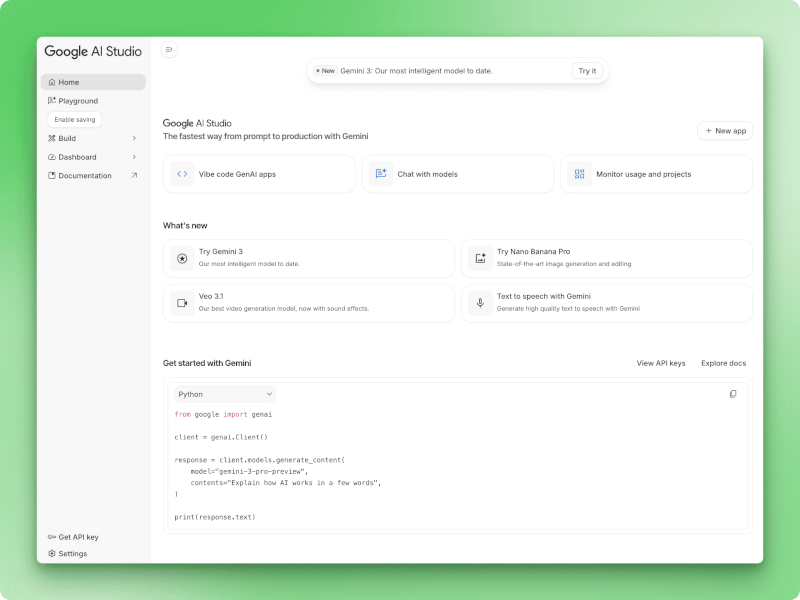
L’interfaccia usa una barra laterale sinistra per la navigazione con cinque sezioni principali: Home, Playground, Build, Dashboard e Documentation. La homepage presenta tre schede di azione per un accesso rapido ad attività comuni come chattare con i modelli o creare applicazioni. In fondo alla barra laterale trovi i link a "Get API key" e "Settings" per gestire il tuo account.
Homepage di Google AI Studio
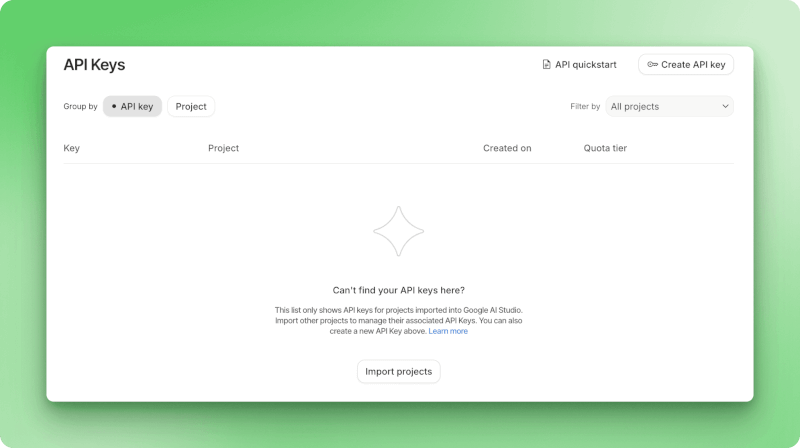
Per iniziare a usare la Gemini API nelle tue applicazioni, clicca su "Get API key" in fondo alla barra laterale sinistra. Si apre la pagina di gestione delle API Key, dove puoi crearne di nuove con il pulsante "Create API key".
Pagina di gestione delle API Key
Conserva la tua API key in modo sicuro ed evita di pubblicarla in repository pubblici.
Prima di iniziare a sperimentare, ti conviene capire quale modello Gemini si adatta meglio al tuo compito. AI Studio ti dà accesso a diverse opzioni, ognuna con punti di forza differenti.
In AI Studio troverai diversi modelli Gemini, ciascuno pensato per compiti differenti. La tua scelta dipende da ciò che ottimizzi: potenza di ragionamento, velocità, costo o funzionalità specializzate come la generazione di immagini.
Il modello gemini-3-pro gestisce compiti di ragionamento complessi in cui serve un’analisi profonda. Ha totalizzato 1501 nell’Elo leaderboard al lancio. Tuttavia, gemini-3-pro è stato deprecato e disattivato a marzo 2026. Il suo successore, gemini-3.1-pro-preview, migliora le prestazioni nel coding e nei flussi agentici. Per il modello di punta più recente, vedi Gemini 3.5 Flash qui sotto.
Con una finestra di contesto da 1 milione di token, puoi fornirgli interi codebase o articoli scientifici e ottenere fino a 65.000 token in risposta.
Il modello include un parametro thinking_level che ti permette di aumentare o ridurre la profondità di ragionamento in base al compito. Per approfondire le funzionalità e i benchmark di Gemini 3, dai un’occhiata a la guida a Gemini 3 di DataCamp.
Per la generazione di immagini, gemini-3-pro-image (soprannominato Nano Banana Pro) può creare immagini 2K e 4K con testo leggibile al loro interno. La maggior parte dei modelli di immagine fallisce nel rendering del testo, ma questo lo gestisce bene. Hai a disposizione 65.000 token in input e 32.000 in output.
Una cosa da notare: il grounding con Google Maps non è disponibile nei modelli Gemini 3. Se ti servono funzionalità di localizzazione, punta invece su Gemini 2.5 Pro.
Il modello gemini-2.5-pro adotta un approccio "thinking-first", dedicando più tempo all’analisi complessa prima di rispondere. Eguaglia il contesto da 1M e i 65K token in output di Gemini 3 Pro, ed è l’unico modello che supporta il grounding con Google Maps.
Le varianti Flash scambiano un po’ di profondità di ragionamento con velocità e costo:
gemini-2.5-flash: risposte più rapide dei modelli Pro mantenendo il contesto da 1M. Buona scelta di default per compiti generali
gemini-2.5-flash-lite: pensato per carichi elevati in cui esegui query semplici su larga scala
Al Google I/O 2026, Google ha lanciato gemini-3.5-flash, il nuovo modello predefinito nei prodotti Gemini. Supera Gemini 3.1 Pro nei benchmark di coding e agentici: 76,2% su Terminal-Bench 2.1, 83,6% su MCP Atlas e 1656 Elo su GDPval-AA. Mantiene la finestra di contesto da 1 milione di token e 65.536 token in output, e gira a circa 289 token al secondo.
Il modello è stato co-ottimizzato con il framework agentico Antigravity, diventando la scelta ideale per flussi agentici che richiedono uso di strumenti in più passaggi. I prezzi API sono di $1,50 per milione di token in input e $9,00 per milione di token in output, con uno sconto del 90% per gli input in cache.
gemini-3.5-pro è in test interni e il rilascio è previsto per giugno 2026.
Parti da gemini-3.5-flash se lavori su problemi di coding, analisi matematica o qualsiasi cosa richieda ragionamento passo-passo.
Passa a gemini-2.5-pro quando ti serve il grounding con Maps o vuoi un approccio più incentrato sul pensiero.
Per la maggior parte dei compiti quotidiani, gemini-2.5-flash offre prestazioni solide senza i costi più alti.
Usa gemini-2.5-flash-lite quando devi processare volumi elevati di richieste più semplici.
E scegli nano-banana-pro quando ti servono immagini con testo davvero leggibile.
L’accesso al livello gratuito è disponibile per tutti i modelli Gemini, inclusi Gemini 3 Flash e Gemini 3 Pro, con limiti di utilizzo che si aggiornano ogni cinque ore. A partire dallo I/O 2026, Google è passata da limiti per minuto a tetti basati sul compute, dove le query leggere consumano meno della tua quota rispetto a richieste complesse di coding o video.
Ora che sai quale modello usare, vediamo come interagirci tramite la modalità Chat, dove puoi testare i prompt e affinare l’approccio prima di scrivere qualsiasi riga di codice.
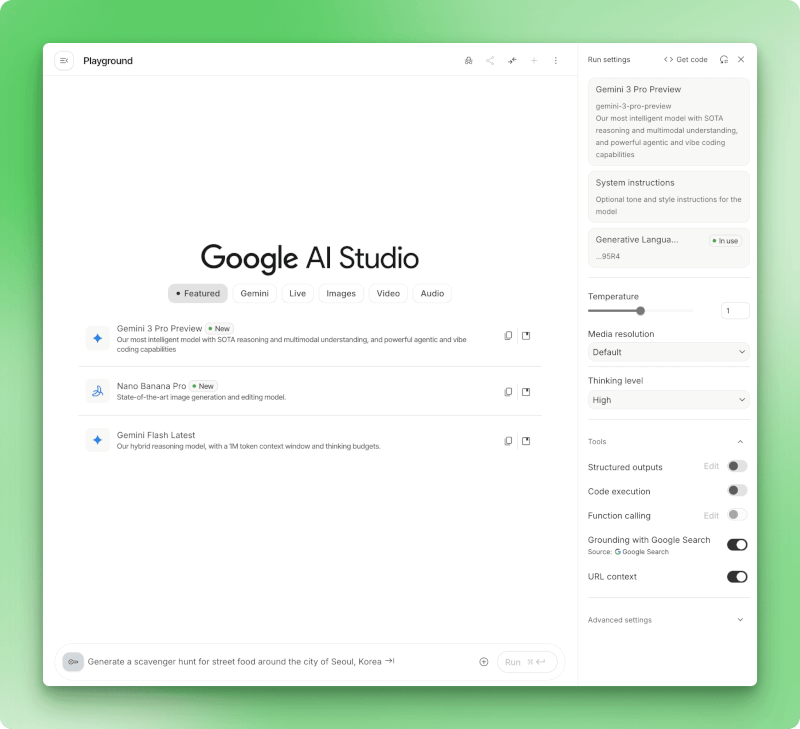
Il Playground ti permette di testare i prompt con controlli visuali per ogni impostazione. Puoi regolare i parametri, attivare o disattivare gli strumenti ed esportare l’intera configurazione come codice funzionante quando trovi qualcosa che va bene.
Interfaccia del Playground di Google AI Studio con istruzioni di sistema, parametri del modello come temperatura e livello di thinking, e strumenti tra cui esecuzione di codice e grounding con Google Search
Le istruzioni di sistema impostano il comportamento del modello per l’intera conversazione, così non devi ripetere lo stesso contesto in ogni prompt. La temperatura controlla la casualità delle risposte: valori bassi intorno a 0,3 danno formattazione coerente, mentre valori alti intorno a 1,5 funzionano meglio per la scrittura creativa. Il menu del livello di thinking nei modelli Gemini 3 ti permette di scambiare profondità di ragionamento con velocità.
Cambia modello su Nano Banana Pro dal menu a tendina in alto se vuoi generare immagini invece di testo. Si applicano gli stessi controlli dei parametri, ma otterrai immagini 2K o 4K con testo reso in modo leggibile.
Oltre alle immagini, la modalità Chat gestisce anche altri media. Veo 3.1 genera video con audio nativo, sincronizzazione labiale, output verticale nativo 9:16 e upscaling a 1080p/4K.
Google ha inoltre introdotto Gemini Omni Flash allo I/O 2026, un nuovo modello multimodale che genera e modifica video a partire da testo, immagini e input video combinati.
Per l’audio, puoi usare il text-to-speech o Lyria 3 per la generazione musicale (Lyria 3 Pro crea canzoni complete fino a 3 minuti, mentre Lyria 3 Clip gestisce clip da 30 secondi). Lyria RealTime aggiunge la creazione musicale interattiva in cui il modello risponde ai tuoi input in tempo reale.
Strumenti come il Grounding con Google Search recuperano informazioni aggiornate quando i dati di addestramento del modello non bastano.
L’esecuzione di codice fa girare direttamente Python per calcoli o lavoro sui dati. Gli altri toggle si collegano alle tue API, impongono schemi JSON o introducono URL nella conversazione.
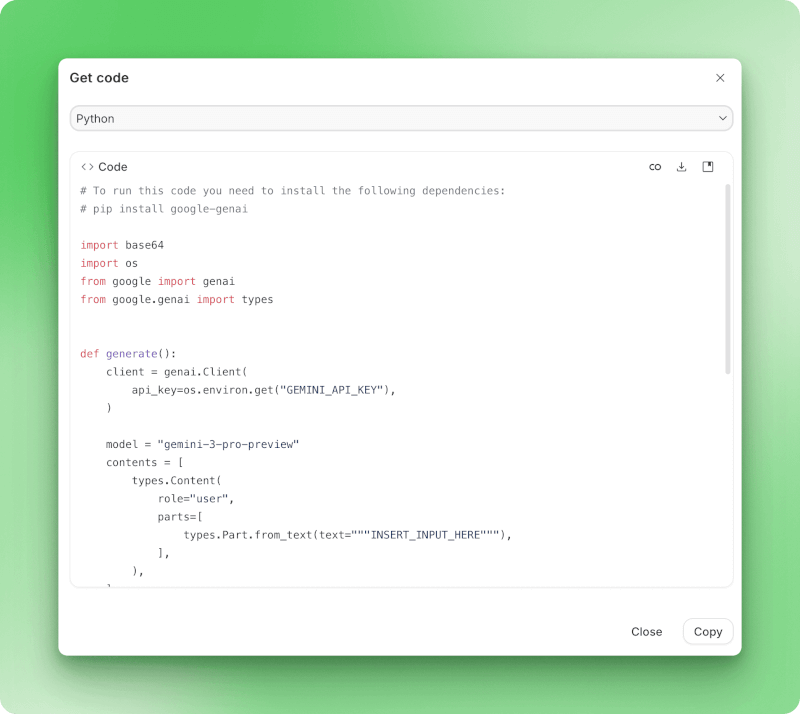
Finestra Get code in Google AI Studio che mostra l’export del codice Python con l’implementazione della Gemini API
Quando sei pronto a passare dal testing alla produzione, "Get code" esporta tutto come codice di implementazione.
La modalità Stream va oltre aggiungendo interazioni vocali e video.
La modalità Stream trasforma i prompt testuali in conversazioni in cui Gemini può vederti e sentirti. Parli al modello tramite il microfono, mostri lo schermo e ricevi risposte vocali in tempo reale senza digitare.
Per accedere alla modalità stream, puoi andare su https://aistudio.google.com/live.
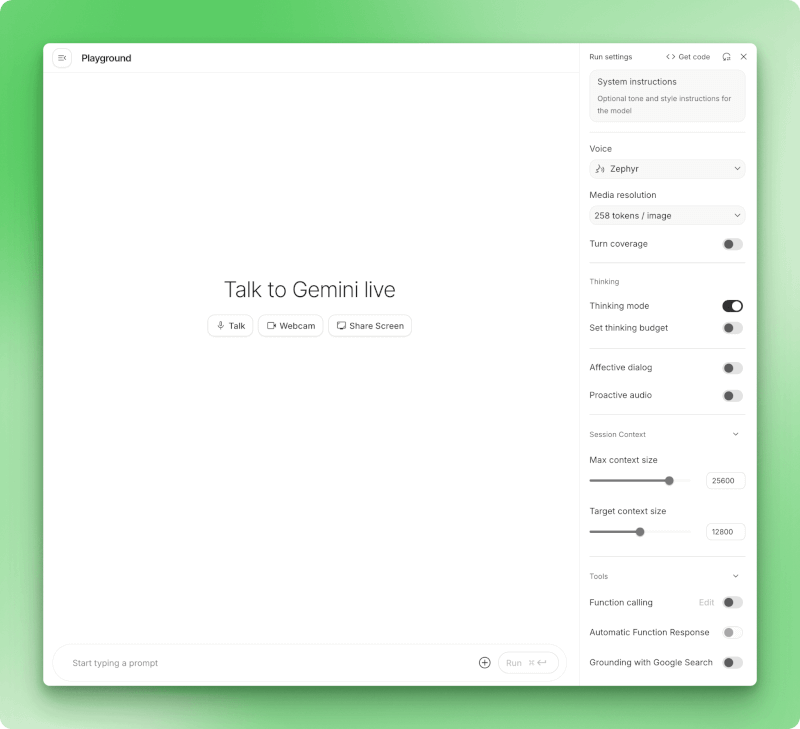
Interfaccia della modalità Stream di Google AI Studio con pulsanti Talk, Webcam e Share Screen, impostazioni della voce e opzioni di configurazione nella barra laterale
L’interfaccia offre tre opzioni: Talk per l’interazione solo voce, Webcam per includere il video di te stesso o Share Screen per mostrare ciò che hai sullo schermo.
Il rilevamento dell’attività vocale è automatico. Gemini aspetta che tu faccia una pausa prima di rispondere, così puoi spiegarti con calma senza dover cliccare nulla tra un turno e l’altro. Il modello elabora contemporaneamente la tua voce, l’eventuale video dalla webcam e ciò che stai mostrando.
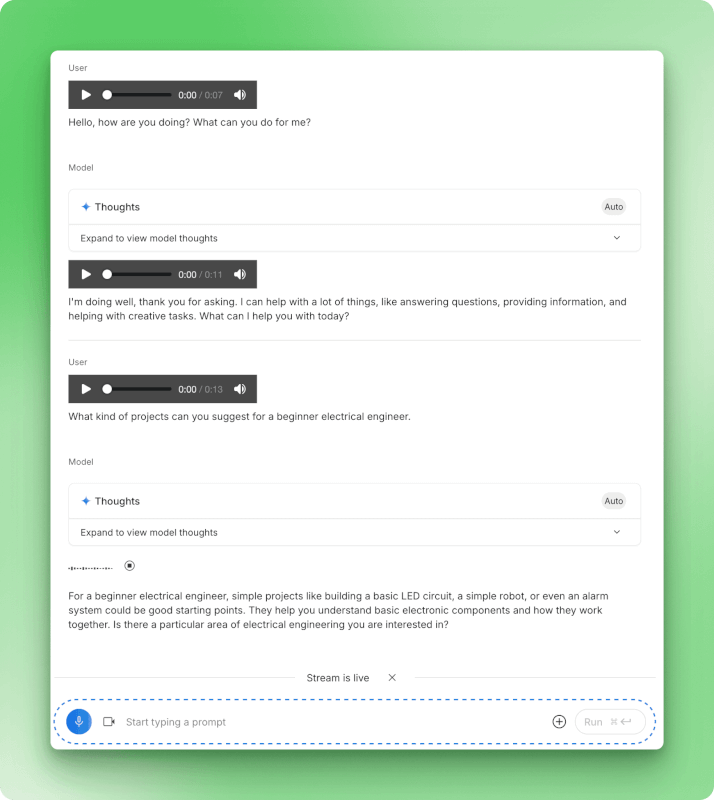
Puoi anche scegliere voci diverse per le risposte del modello, come la voce "Zephyr" mostrata nelle impostazioni. Il ragionamento interno del modello appare in sezioni Thoughts espandibili, permettendoti di vedere come è arrivato a ciascuna risposta.
Conversazione in modalità Stream che mostra interazione vocale con forme d’onda audio, pensieri del modello e risposte in tempo reale tra utente e Gemini
L’interazione a mani libere funziona bene per sessioni di tutoraggio dal vivo in cui devi mostrare il tuo lavoro e ottenere una guida verbale sul momento.
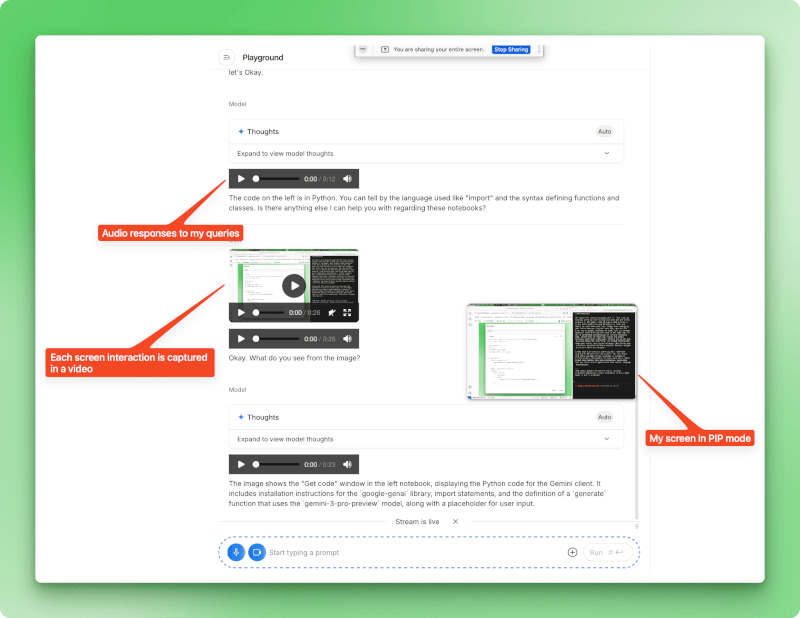
Puoi affrontare un problema di matematica spiegando ad alta voce il tuo ragionamento, e Gemini può individuare dove si rompe la logica. Il debugging è più rapido quando puoi mostrare il tuo IDE e descrivere l’errore che vedi. Il tuo schermo appare in modalità picture-in-picture, così Gemini vede esattamente a cosa ti riferisci.
Modalità Stream con condivisione schermo attiva, con vista picture-in-picture dello schermo condiviso e risposte audio mentre Gemini analizza i contenuti mostrati
Se stai provando una presentazione o una demo, la modalità Stream può osservare le tue slide e rispondere a domande sui contenuti. È utile anche quando stai imparando un nuovo software. Puoi mostrare a Gemini la tua interfaccia, chiedere dove trovare una funzione specifica e ottenere indicazioni mentre navighi.
La modalità Stream si adatta a scenari in cui vuoi un botta e risposta in tempo reale con voce e contenuti visivi. Per lavori ricchi di testo in cui ti serve copiare le risposte o iterare su prompt scritti, la modalità Chat ha ancora più senso. Mentre la modalità Stream gestisce l’interazione in tempo reale, la modalità Build ti permette di creare intere applicazioni a partire da descrizioni in linguaggio naturale.
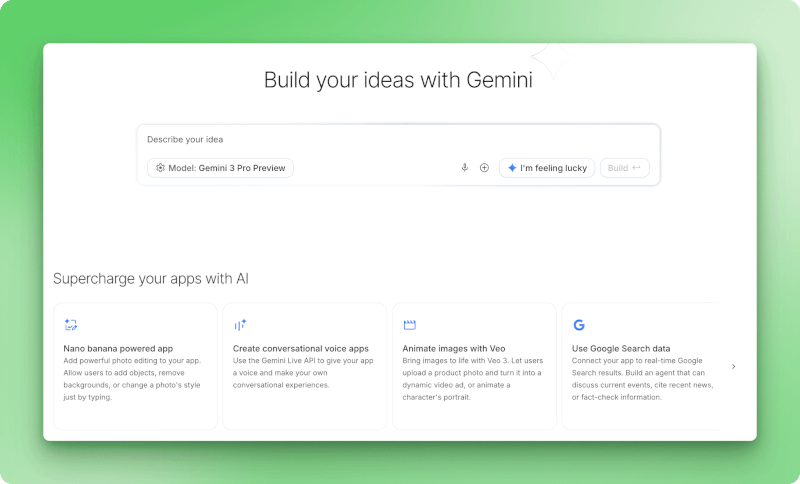
La modalità Build trasforma le descrizioni in app funzionanti. Tu scrivi cosa vuoi, e l’Antigravity Agent scrive il codice. Google lo chiama "vibe coding" e, dallo I/O 2026, va ben oltre le app web React. Ora puoi creare app Android native con Kotlin e Jetpack Compose, visualizzarle in un emulatore Android nel browser, testarle su un dispositivo fisico via ADB e perfino pubblicarle direttamente sull’Internal Test Track di Google Play.
Pagina di atterraggio della modalità Build con casella di input del prompt, selettore del modello Gemini 3 Pro Preview, pulsante I'm feeling lucky e sezione AI Chips con opzioni per app basate su Nano Banana, app vocali conversazionali, animazione video con Veo e integrazione dati da Google Search
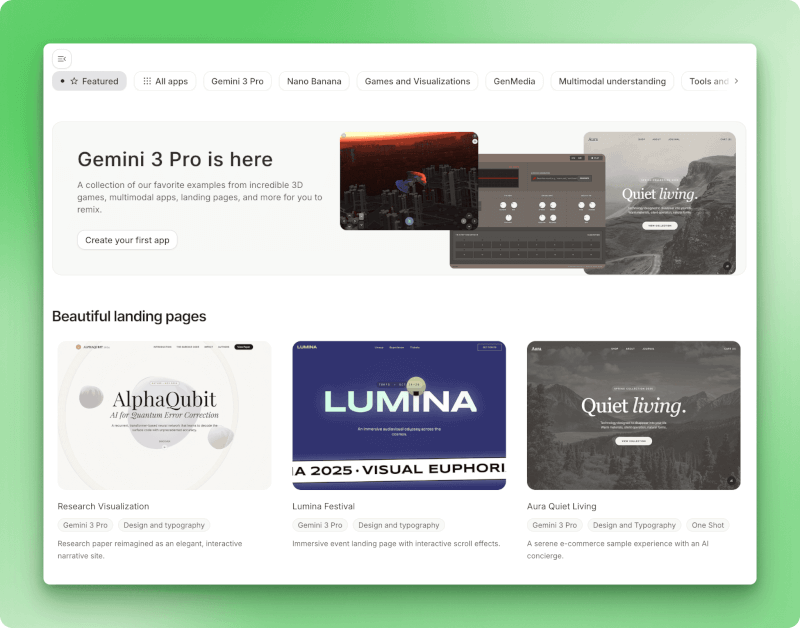
Ho dato prima un’occhiata alla galleria di progetti iniziali. App come Shader Pilot mostrano ciò che è possibile: visualizzazioni 3D interattive, landing page con tipografia personalizzata, persino piccoli giochi. Puoi forkare qualsiasi esempio e modificare il codice tramite il pannello dell’assistente.
Galleria delle app Starter con esempi in evidenza di Gemini 3 Pro tra cui giochi 3D, app multimodali e una sezione di landing page curate con AlphaQubit research visualization, pagina evento Lumina Festival e demo e-commerce Aura Quiet Living
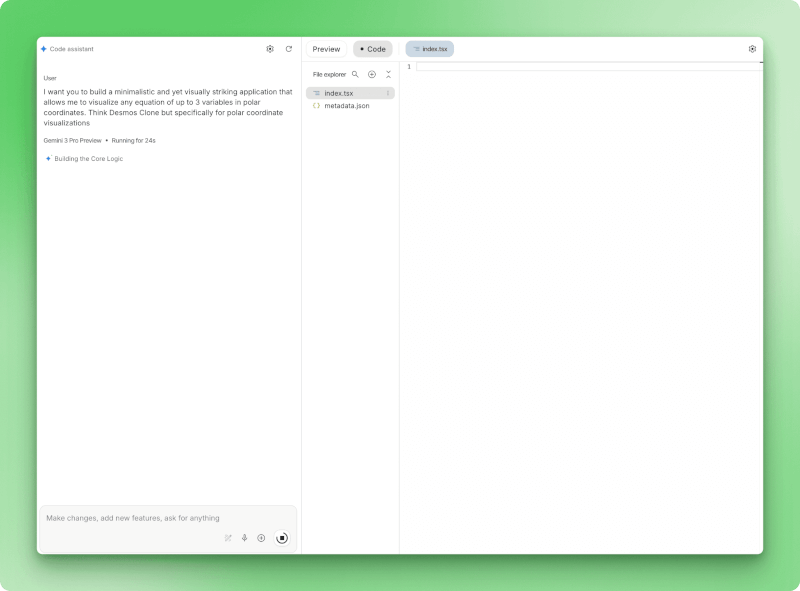
Volevo costruire da zero, quindi ho scritto: "a minimalistic and yet visually striking application that allows me to visualize any equation of up to 3 variables in polar coordinates."
Creazione di Polar.ai con prompt dell’utente che richiede un visualizzatore di equazioni in coordinate polari, indicatore di stato Gemini 3 Pro Preview che mostra Running for 24s con messaggio di progresso Building the Core Logic e pannello file con i file generati index.tsx e metadata.json
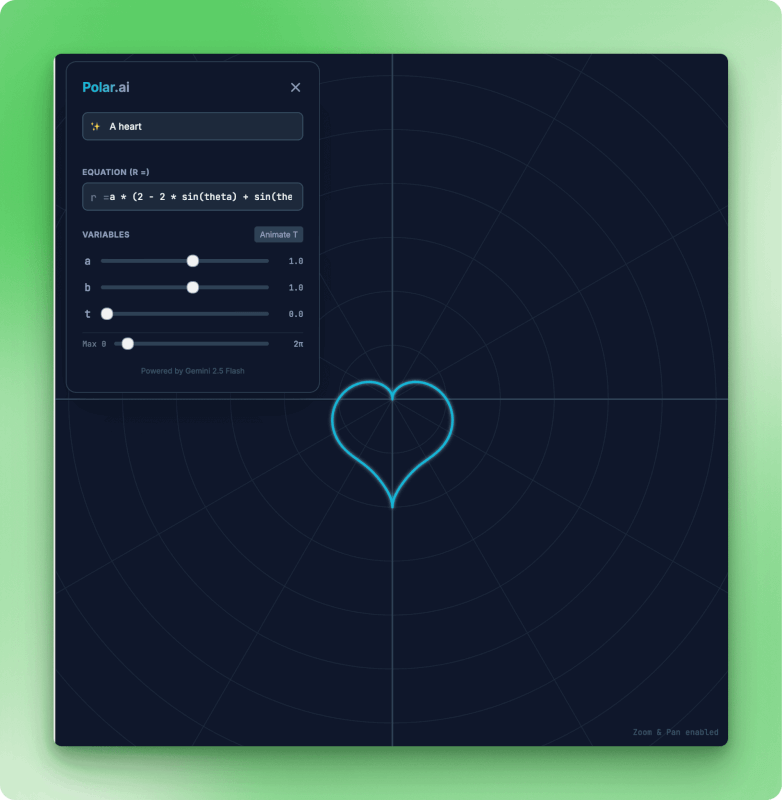
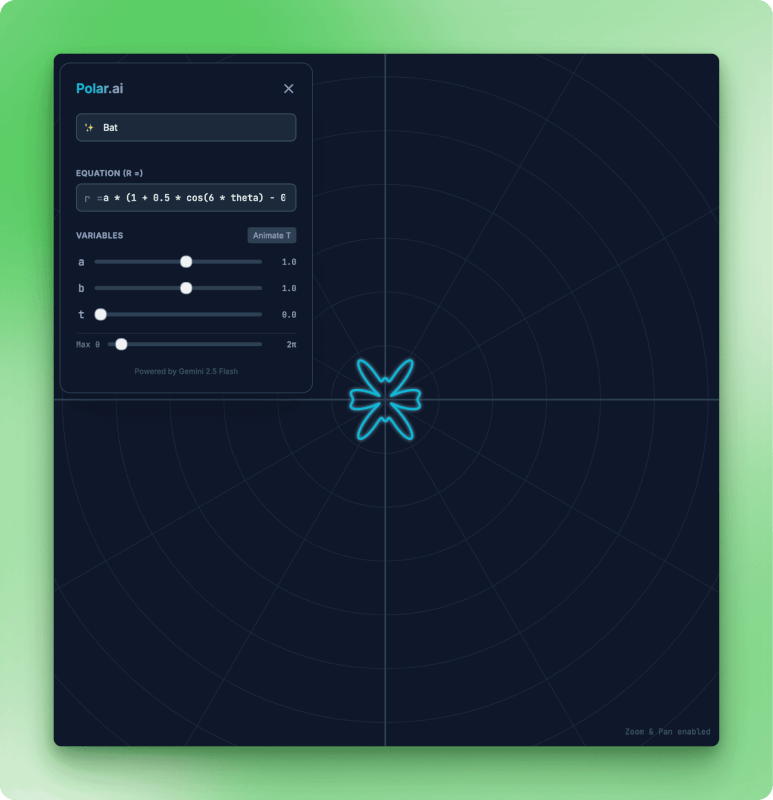
Circa 60 secondi dopo, è comparsa Polar.ai. Il modello ha generato i file React (index.tsx, metadata.json), ha costruito un parser di equazioni e impostato gli slider delle variabili. Ho digitato "a heart" e ho visto tracciare la curva polare. Passando a "bat" è uscita una forma diversa.
App Polar.ai che mostra una curva polare a forma di cuore resa in ciano su sfondo a griglia scura, con editor dell’equazione che mostra r uguale a a volte seno, slider delle variabili a, b, t impostati a 1,0, Max theta a 2 pi, pulsante Animate T e dicitura Powered by Gemini 2.5 Flash
App Polar.ai che mostra una visualizzazione polare a forma di pipistrello con pattern simmetrico a sei lobi in ciano, editor dell’equazione che visualizza una formula coseno modificata con controlli per regolare i parametri della curva: a impostato a 1,0, b a 1,0, t a 0,0, e slider Max theta
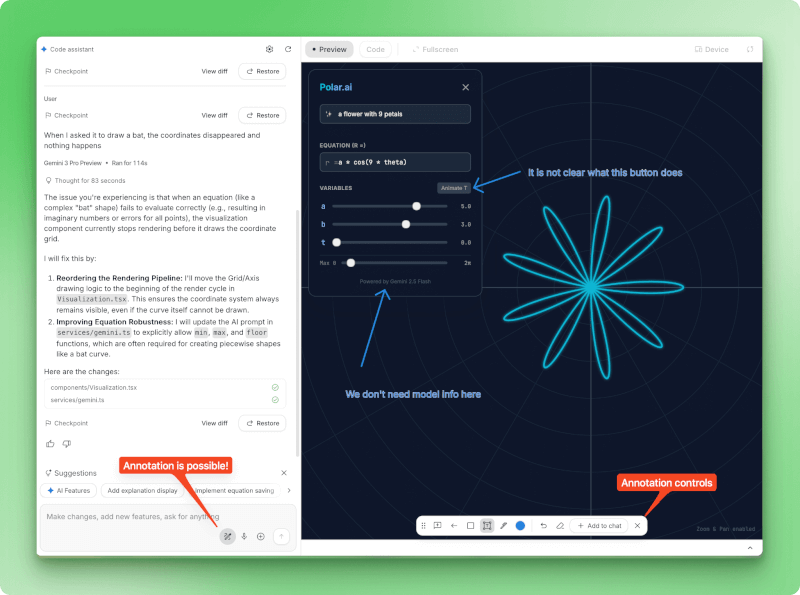
Quando le coordinate del pipistrello sono scomparse a metà curva, ho descritto il problema in chat. Il modello lo ha diagnosticato (numeri immaginari che mandavano in errore il renderer), ha spiegato la correzione e ha creato un checkpoint con "View diff" per farmi vedere cosa era cambiato.
Sessione di debugging di Polar.ai che mostra nel pannello sinistro il bug report dell’utente sulle coordinate del pipistrello che scompaiono, la risposta del modello che analizza il problema dei numeri immaginari nella valutazione dell’equazione con 83 secondi di thinking, un piano dettagliato di fix per riordinare la pipeline di rendering, controlli del checkpoint con pulsanti View diff e Restore, e nel pannello destro l’anteprima live con toolbar di annotazione in basso con strumenti di disegno e opzione Add to chat
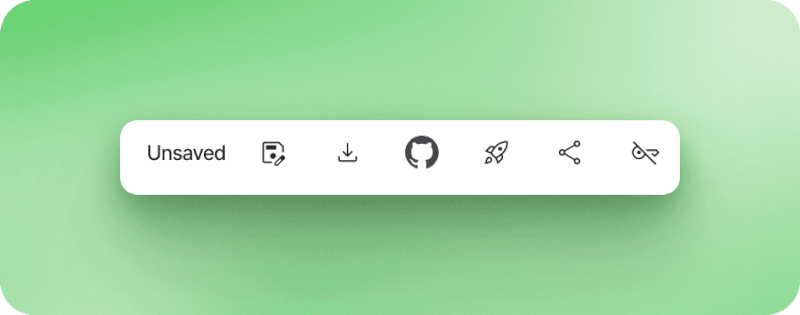
La toolbar di annotazione ti permette di cliccare sugli elementi dell’interfaccia per richiedere modifiche visive. Una volta che l’app funziona, puoi esportarla come ZIP, fare push su GitHub o distribuirla su hosting cloud. Il codice generato usa pattern React standard, anche se probabilmente vorrai affinarlo prima della messa in produzione.
Barra Export che mostra lo stato Unsaved con sei icone d’azione per salvare il progetto su Google Drive, scaricare come file ZIP, fare push su repository GitHub, distribuire su hosting cloud, condividere tramite link e opzioni di gestione progetto
Al Google I/O 2026, la modalità Build ha ottenuto diverse funzionalità. L’integrazione con Google Workspace ti consente di collegare Drive, Sheets e Docs direttamente alle tue app. Il deploy con un clic su Cloud Run con supporto backend Firebase gestisce autenticazione e archiviazione del database. Puoi anche esportare l’intero progetto nell’app desktop Google Antigravity per lo sviluppo locale, portando con te la cronologia della conversazione e i file del progetto.
Aggiornamento (maggio 2026): il Google I/O 2026 ha portato grandi cambiamenti in AI Studio e nei competitor. Il confronto qui sotto riflette il panorama all’epoca dell’articolo originale. Cambi chiave:
Quando sei pronto a portare il lavoro di AI oltre la piattaforma di Google, troverai compromessi diversi con i servizi concorrenti. La vasta libreria di plugin di ChatGPT e la memoria tra sessioni lo hanno reso la scelta di default per molti utenti.
Claude punta agli sviluppatori con gli Artifacts che trasformano le conversazioni in app persistenti, collegandosi a Slack o Asana tramite connessioni MCP.
Grok si connette al feed in tempo reale di X ma è indietro nei compiti di ragionamento complesso. Per saperne di più sulle capacità di coding di Gemini, vedi il nostro tutorial sull’agente di coding Gemini 3.1 Pro. Per un confronto dettagliato delle prestazioni tra Gemini e ChatGPT su benchmark diversi, dai un’occhiata a la nostra analisi testa a testa Gemini vs ChatGPT.
|
Piattaforma |
Livello gratuito |
Livello a pagamento |
Punti di forza |
Ideale per |
|
Google AI Studio |
Limitato (5-15 RPM, modelli premium a pagamento) |
Pay-as-you-go |
Modalità Build (React + Android), modalità Stream, Video (Veo 3.1, Gemini Omni), grounding con Maps |
Prototipazione multimodale, sperimentare con Gemini |
|
ChatGPT |
10-60 messaggi/5h (GPT-4o) |
$20/mese |
Memoria, plugin, ecosistema maturo |
Compiti generali, workflow consolidati |
|
Claude |
20-40 messaggi/giorno |
$20/mese |
Artifacts, Projects (200K), forte nel coding |
Prototipazione di app, assistenza al coding |
|
Grok |
2-10 prompt/2h |
$40/mese |
Dati in tempo reale da X, immagini Aurora |
Integrazione con X, uso leggero |
La situazione del livello gratuito varia molto tra piattaforme:
ChatGPT e Claude chiedono $20 al mese per il pieno accesso web. Grok ha raddoppiato a $40. Per il lavoro via API, però, Grok vince a $0,20 per milione di token contro i $5 di GPT-4o o i $3 di Claude Sonnet.
Budget e priorità orientano questa scelta in modo diverso per ognuno. Se stai creando prototipi di app multimodali, la modalità Build di AI Studio e la generazione video possono giustificare limiti più stretti.
L’ecosistema di ChatGPT ha slancio: plugin, memoria e workflow consolidati rendono alto il costo di cambio. I Projects da 200K token di Claude attirano gli sviluppatori che necessitano di grandi finestre di contesto per il codice. Grok ha trovato la sua nicchia nell’accesso API economico ($0,20 per milione di token) e nell’integrazione in tempo reale con X, accettando il compromesso sulle prestazioni di ragionamento.
In questo tutorial ti ho mostrato come Google AI Studio gestisce tre flussi di lavoro diversi: test dei prompt in modalità Chat, creazione di app tramite linguaggio naturale in modalità Build e risoluzione dei problemi parlando con voce e video in modalità Stream. La piattaforma dà il meglio quando devi creare prototipi con i modelli Gemini senza scrivere codice di setup.
I limiti di utilizzo basati sul compute del livello gratuito sono adatti ai test iniziali. Quando sei pronto a integrare Gemini in applicazioni in produzione, ti consiglio di consultare il tutorial sulla Gemini API, che copre autenticazione, gestione degli errori e pattern di ottimizzazione. Puoi anche esplorare Gemini Deep Think per ragionamento avanzato o imparare come usare la Gemini CLI.
Il punto di forza di AI Studio è la prototipazione rapida. Puoi testare un’idea in modalità Chat, svilupparla in modalità Build, quindi esportare il codice quando funziona. L’interfaccia nel browser elimina gli attriti abituali, ma per l’uso in produzione ti servirà comunque una corretta integrazione API.
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min