
{count, plural, other {课程}}
AI Agents 入门
{hours} 小时 {minutes} 分钟
144.6K
Google 刚刚为开发者发布了一款真正有意思的工具:一款Google Workspace 命令行界面,通过一个工具即可获得对整个 Google Workspace 的结构化、可脚本化访问,包括 Drive、Gmail、Calendar、Sheets、Docs、Chat 等。
代码库几乎完全由 Rust 编写(99.3%),但通过 npm 分发为预编译的本机二进制文件,因此无需安装 Rust 工具链。
在本教程中,您将从零开始设置 Google Workspace CLI,完成认证,并构建一个由 Gemini 驱动的 RAG 助手,让您可以用自然语言查询 Drive 文件。完成后,您将拥有:
已针对您的 Drive 安装并完成认证的 gws
包含 ChromaDB、Sentence Transformers 和 Gemini SDK 的 Python 虚拟环境
一个可用的本地 RAG 流水线:通过 gws 获取文件,使用本地模型进行嵌入,并用 Gemini 2.5 Flash 流式返回答案
注意:这不是 Google 官方支持的产品。
Google Workspace CLI(gws)是一款为整个 Google Workspace 生态系统做了 AI 优化的命令行工具。它的亮点包括:
动态命令发现:gws 并不内置一个硬编码的命令树,而是在运行时读取 Google 的 Discovery Service。当 Google 新增 API 端点时,CLI 会自动拾取,无需版本升级。
面向 Agent 的设计:CLI 内置 100+ 个预构建技能,以及 50 个针对常见工作流的精选配方,可用于摘要邮件、移动 Drive 文件、创建日历事件等。每个输出都是结构化 JSON,LLM 可直接消费。
原生 MCP 服务器支持:将 gws 作为本地 MCP 服务器运行,让您的 AI Agent 无需编写任何 API 客户端就能完整访问 Workspace 工具。
集成 Model Armor:对于在生产中读取用户可控内容的 Agent,您可以在 LLM 看到响应之前,将 API 响应通过 Google Cloud Model Armor 进行净化,抵御提示注入。
您可以在此浏览完整技能库:github.com/googleworkspace/cli/blob/main/docs/skills.md。
本教程将一步步构建 RAG 助手。从整体上看,应用会:
使用 gws CLI 针对您的 Google Drive 完成认证,并获取最近修改的 Docs、Sheets 和文本文件
将每个文档分块,并通过 ChromaDB 使用 Sentence Transformers 在本地进行嵌入
将向量索引持久化到磁盘,以便后续运行跳过已摄取的文件,直接进入聊天
接受自然语言问题,从 ChromaDB 检索最相关的前 3 个分块,并构建有据可依的上下文提示
在终端中以逐 token 的方式流式输出来自 Gemini 2.5 Flash 的带引用、仅基于上下文的答案
让我们一步步实现。
完整教程代码:https://github.com/AashiDutt/Google-Workspace-CLI-Demo
CLI 作为一个 npm 包分发,封装了预编译的 Rust 二进制文件。无需 Rust 工具链。
npm install -g @googleworkspace/cli逐条运行以下命令验证安装:
gws --version
which gws
如果安装后找不到 gws,请确保您的 npm global 可执行目录已加入 PATH。
CLI 通过 GCP 项目的 OAuth 客户端进行认证,因此登录前需要一个项目。要在 GCP 中创建或选择项目:
设置 OAuth 凭据:
进入“APIs & Services”,选择“Credentials”
点击“Create Credentials”,选择“OAuth 2.0 Client ID”
将应用类型选择为“Desktop app”
记录 Client ID 和 Client Secret,我们将用于 gws auth setup。
CLI 通过启动一个临时的本地 localhost 服务器来完成 OAuth。Desktop app 客户端会自动处理任意 localhost 端口。Web application 客户端则需要您手动将每个 http://localhost:PORT 添加到“Authorized redirect URIs”列表中。
如果您使用 Web application 客户端并遇到“Access blocked: This app's request is invalid”,请前往 Credentials,点击 OAuth client,然后在 Authorized redirect URIs 中添加报错中显示的精确 http://localhost:PORT URL。
要将 gws 连接到您的 GCP 项目,首先将 OAuth 凭据导出为环境变量,以便向导自动读取:
export GOOGLE_WORKSPACE_CLI_CLIENT_ID="CLIENT_ID"
export GOOGLE_WORKSPACE_CLI_CLIENT_SECRET="CLIENT_SECRET"
然后运行:
gws auth setup --project YOUR_PROJECT_ID --login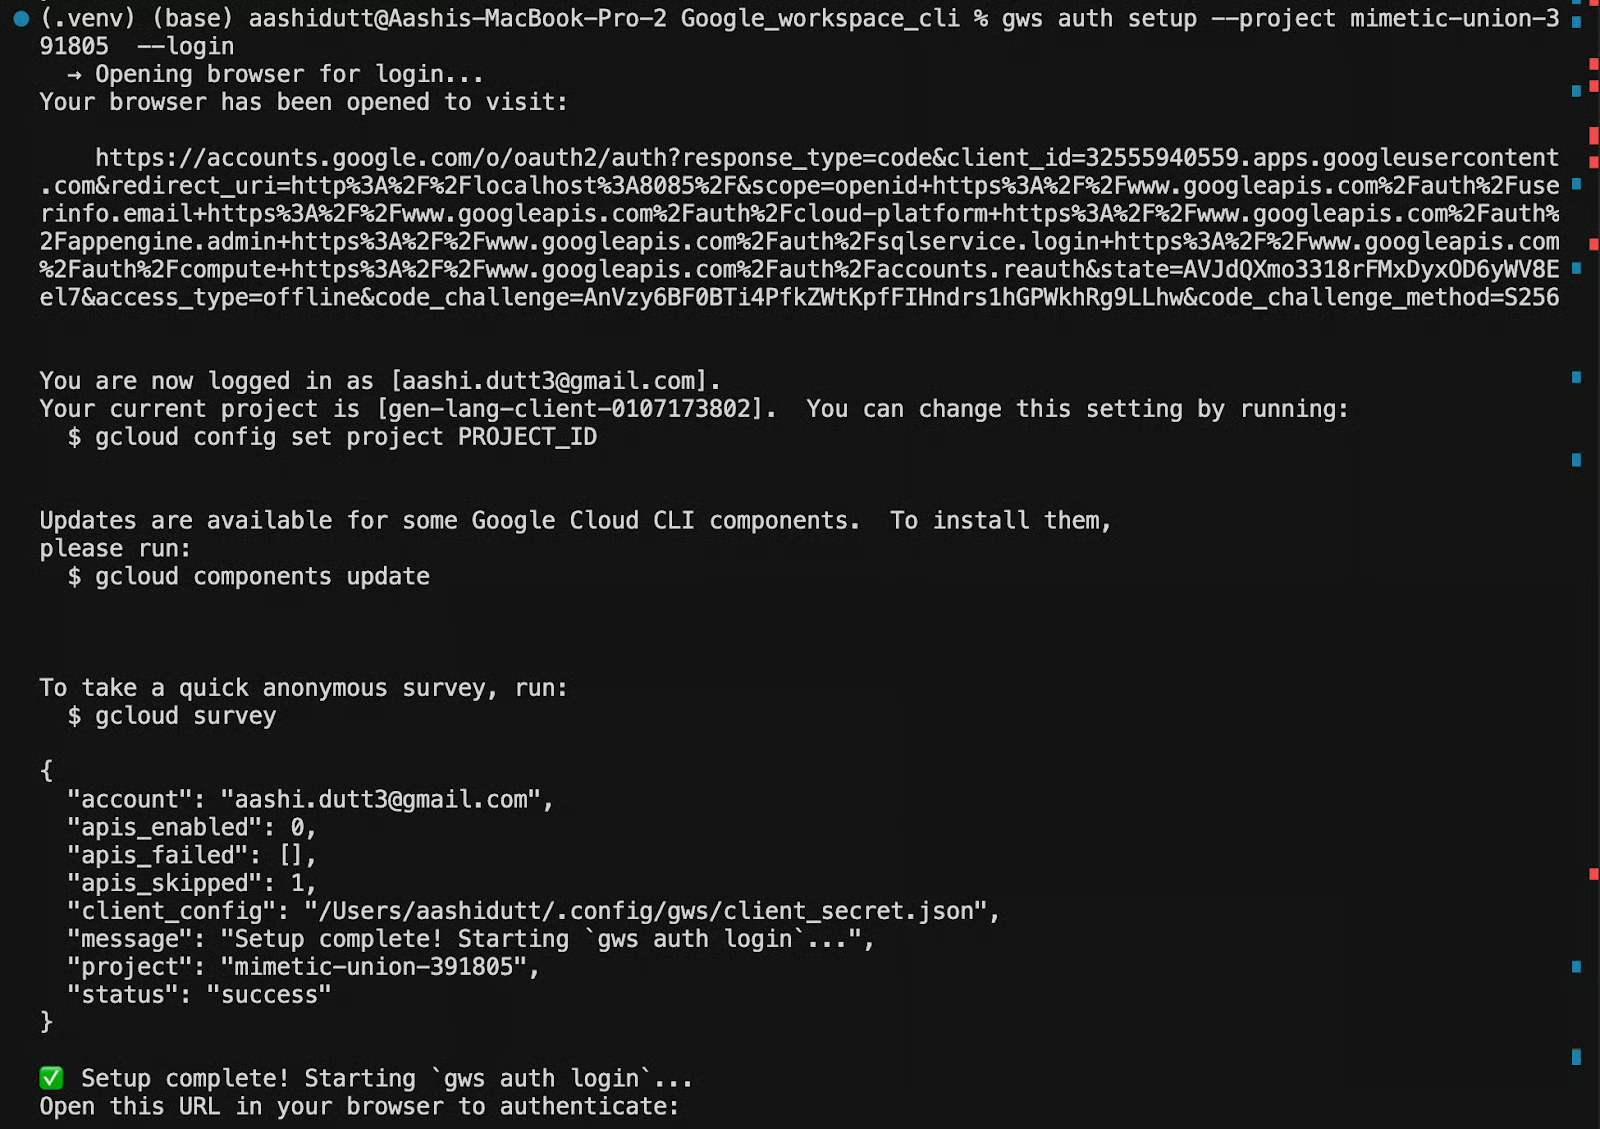
设置向导将:
完成后,您将看到:Setup complete!
凭据存储在 ~/.config/gws/。要确认一切连接正常,请运行:
gws auth status该命令会打印已认证账户、关联的 GCP 项目和激活的作用域。如果任何信息不正确,请使用正确的参数重新运行 gws auth setup,而不是手动编辑配置文件。
在编写任何 Python 代码之前,值得直接在终端快速自检,确认 CLI 已认证并能与 Drive 通信。我们快速运行以下命令,列出您最近的 5 个 Drive 文件:
gws drive files list --params '{"pageSize": 5}'--params 接受一个 JSON 字符串,直接映射到 Drive API 的查询参数。这里 pageSize: 5 将响应限制为 5 条结果,足以确认连通性而不会把整个 Drive 都输出。
如果认证正常,您将收到类似如下的结构化 JSON 响应:
{
  "files": [
    {
      "id": "1BxiMVs0XRA5nFMdKvBdBZjgmUUqptlbs74OgVE2upms",
      "name": "Q3 Strategy Doc",
      "mimeType": "application/vnd.google-apps.document"
    },
    ...
  ]
}
来自 gws 的每个响应都是结构化 JSON,无需解析、无需抓取、没有脆弱的文本输出。
如果您看到提到 serviceusage.services.use 的“403 error”,说明您的 OAuth 凭据指向了与启用计费的项目不同的 GCP 项目。使用正确的项目 ID 重新运行设置以重新关联:
gws auth setup --project YOUR_PROJECT_ID --login确认已能访问 Drive 后,我们就可以启用 API,并开始构建流水线的 Python 部分。
此时,gws 可以针对您的 GCP 项目完成认证,但还不能实际读取 Drive 文件内容。GCP 将认证(证明您是谁)与 API 启用(声明您的项目使用哪些服务)分离。即使 OAuth 凭据有效,在 Drive API 明确对项目启用前,任何尝试获取文件内容的操作都会返回 403 accessNotConfigured 错误。
要启用它,在浏览器打开以下 URL,并将 [PROJECT_ID] 替换为您的实际项目 ID,然后点击“Enable”:
https://console.developers.google.com/apis/api/drive.googleapis.com/overview?project=[PROJECT_ID]
或者,如果您已安装 gcloud CLI,也可以直接在终端启用:
gcloud services enable drive.googleapis.com --project YOUR_PROJECT_ID两种方法作用相同。对已启用的 API 再次执行该操作是安全的,因为这是幂等的,不会重置任何现有配置。
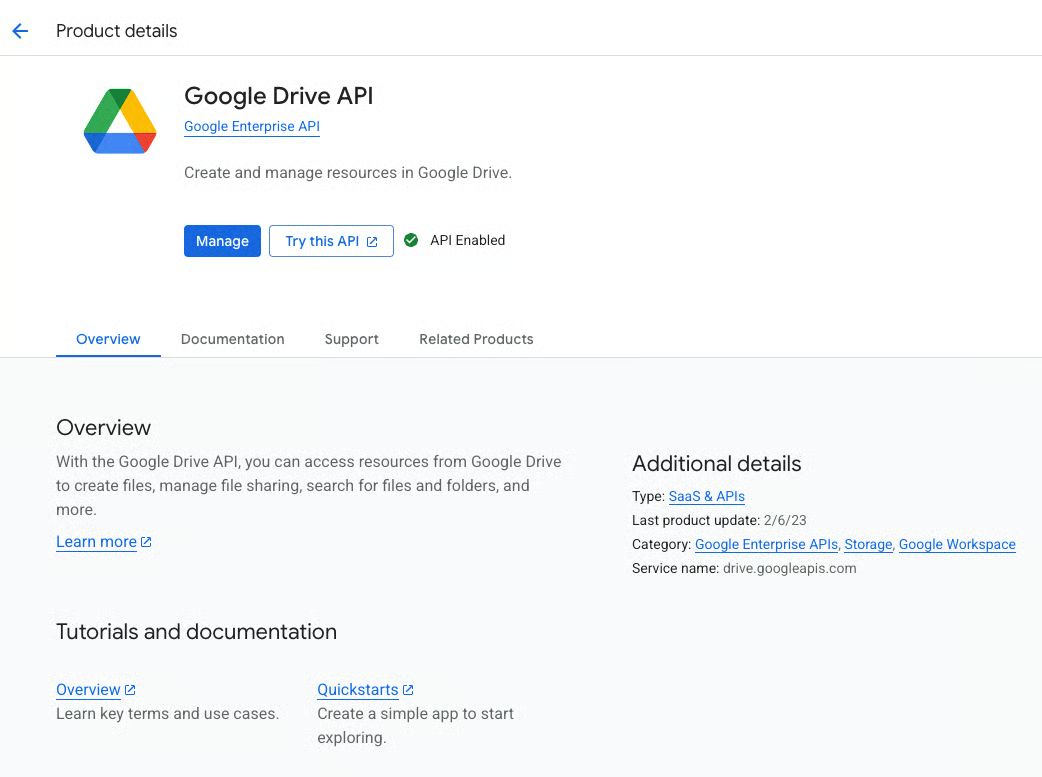
启用后,GCP 可能需要几秒钟来传播变更。如果您立刻运行 gws drive files list 仍看到 403,请等待 30 秒后再试。
CLI 端已完全配置后,我们可以开始设置负责嵌入与检索逻辑的 Python 环境。该 RAG 流水线刻意保持轻量,只需四个包,不需要 GPU,所有嵌入都在本机完成。
首先通过逐条运行以下命令创建虚拟环境:
cd /path/to/your/project
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
pip install -r requirements.txt
然后从 requirements.txt 安装依赖:
.txt
chromadb==1.5.5
google-genai==1.70.0
langchain-text-splitters==1.1.1
sentence-transformers==5.3.0
每个包在流水线中的作用如下:
chromadb:本地向量数据库,将文档嵌入存储到磁盘的 ./chroma_db,并在后续运行中加载,从而避免对已处理文件重复嵌入。
google-genai:Gemini 的官方 Python SDK。应用使用它将检索到的上下文和用户问题发送给 Gemini 2.5 Flash,并以逐 token 的方式流式返回响应。
langchain-text-splitters:提供 RecursiveCharacterTextSplitter,在嵌入前把大文档分割为重叠分块。通过重叠确保位于块边界的句子不会脱离上下文。
sentence-transformers:通过 ChromaDB 的 DefaultEmbeddingFunction 在本地运行嵌入模型。因此,每个文档分块都在本机完成嵌入,无需外部 API 调用。
注意:嵌入模型(约 90MB)会在首次使用时自动下载并在本地缓存。
Python 环境就绪后,编写代码前的最后一步是获取您的 Gemini API 密钥。
RAG 流水线使用 Gemini 作为答案生成层,它会接收检索到的文档分块和用户问题,并流式返回有据可依的响应。要连接到 Gemini,您需要从 Google AI Studio 获取 API Key。
使用您的 Google 帐号登录,点击“Get API Key”,然后选择“Create API Key”。在提示时选择您的 GCP 项目,以便配额和计费可用。在 GCP 控制台的“Billing”下关联计费账号,然后选择 Link a billing account。
获得密钥后,将其导出为环境变量:
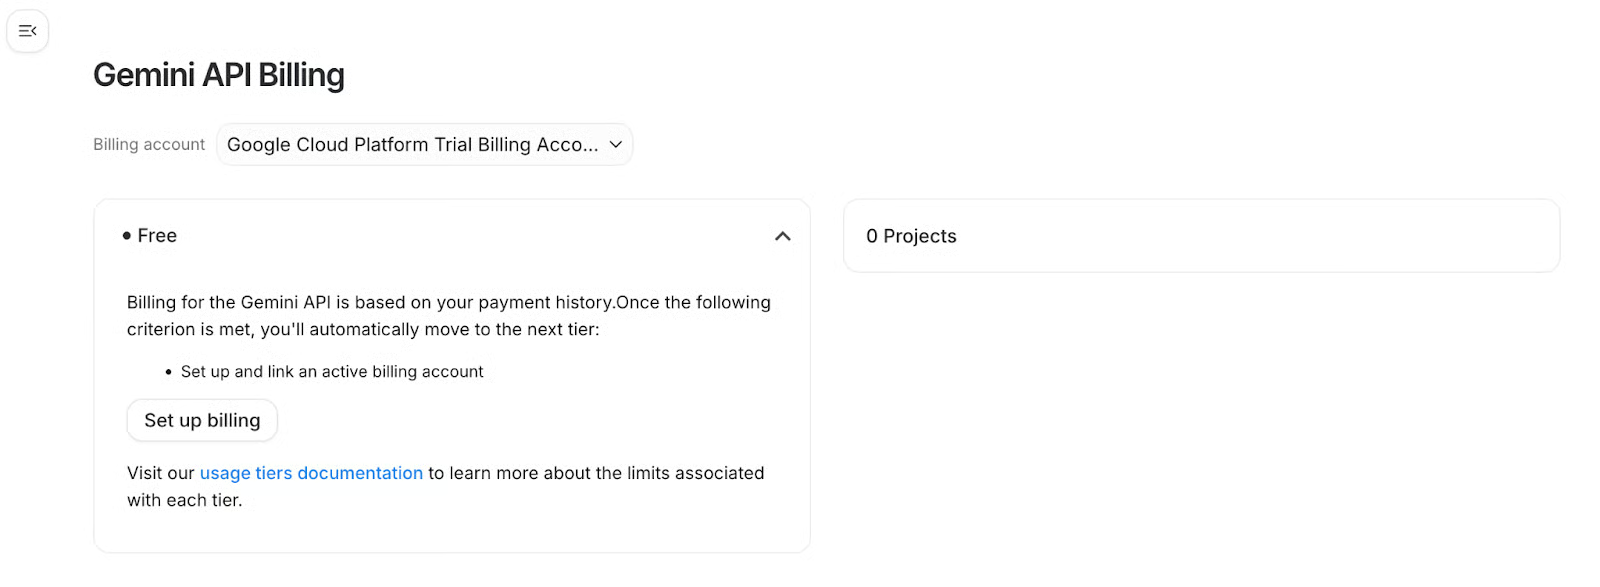
在终端导出密钥:
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"要在多个终端会话间持久保存,运行:
echo 'export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"' >> ~/.zshrc
source ~/.zshrc
应用在启动时通过 os.getenv("GEMINI_API_KEY") 读取该密钥。如果未设置变量,将提示您交互式粘贴密钥。
模型说明:应用默认使用 gemini-2.5-flash。如需在复杂文档上获得更强的推理能力,您可以通过导出 GEMINI_MODEL="gemini-2.5-pro" 覆盖。注意 gemini-2.0-flash 已对新 API Key 停用,请勿在此使用。
认证、Drive API、依赖和 Gemini 密钥均已就位,接下来构建流水线。
现在把所有部分串起来。我们将使用四个文件:fetcher.py、vector_store.py、 main.py 和 requirements.txt。每个文件各司其职,比如 fetcher.py 负责所有 CLI 交互,vector_store.py 负责嵌入与检索,main.py 协调从摄取到流式聊天的完整闭环。
首次运行时,gws 获取您的 Drive 文件,内容被本地分块并嵌入,向量索引写入磁盘的 ./chroma_db。后续运行时,ChromaDB 会从磁盘加载,只获取和嵌入新增文件,聊天循环会立即启动,无需重新处理。
我们逐个文件讲解。
fetcher.py — 通过 gws 访问 Drive该模块是 gws CLI 与 Python 之间的桥梁。所有 Drive 交互(列出文件、导出内容、检查认证)都通过对 gws 的子进程调用完成,结构化 JSON 输出则解析为 Python 字典。这样 Python 代码无需直接处理 OAuth 令牌、HTTP 客户端或 API 响应架构;gws 负责所有这些,并返回干净的 JSON。
def _gws_json_stdout(stdout: str) -> str:
    if not stdout or "{" not in stdout:
        return stdout or ""
    return stdout[stdout.find("{"):]
_gws_json_stdout 用于处理一个细节:gws 有时会在 JSON 负载前输出 keyring 或日志行。此时直接调用 json.loads(result.stdout) 会失败;该辅助函数会剥离第一个 { 之前的所有内容。
def check_auth() -> bool:
    cmd = ["gws", "drive", "about", "get", "--params", '{"fields": "user"}']
    result = subprocess.run(cmd, capture_output=True, text=True)
    payload = _gws_json_stdout(result.stdout)
    try:
        data = json.loads(payload) if payload.strip() else {}
    except json.JSONDecodeError:
        print("Error checking authentication status (could not parse gws output).")
        return False
    if "error" in data or result.returncode != 0:
        handle_error_output(result.stdout, result.stderr)
        return False
    return True
main.py 在启动时调用 check_auth(),它会发起一次轻量的 Drive API 调用并检查响应。如果认证失效或缺少作用域,应用会在尝试摄取前干净退出。
错误处理器还会捕捉特定失败模式并打印可操作的提示:
def handle_error_output(stdout, stderr):
    output = _gws_json_stdout(stdout or "") or (stderr or "")
    if "insufficientPermissions" in output or "unauthenticated" in output.lower():
        print("Please run: gws auth login -s drive")
    elif "serviceusage.services.use" in output or "serviceUsageConsumer" in output:
        print(
            "GCP quota project error: run gws auth setup --project YOUR_PROJECT_ID --login"
        )
    else:
        print(f"API Error: {output}")
文档列表获取器仅针对可导出为文本的 MIME 类型:
def fetch_document_list(limit=10) -> list[dict]:
    q = (
        "(mimeType='text/plain' or mimeType='application/vnd.google-apps.document' "
        "or mimeType='application/vnd.google-apps.spreadsheet') and trashed=false"
    )
    cmd = [
        "gws", "drive", "files", "list",
        "--params",
        json.dumps({"q": q, "pageSize": limit, "orderBy": "modifiedTime desc"}),
    ]
该查询过滤出纯文本、Google Docs 和 Google Sheets,并按最近修改排序。二进制文件(PDF、图片)被排除,因为用该方法无法干净地导出为文本。
不过,下载会根据 MIME 类型采用不同方式:
def download_document(file_id: str, mime_type: str) -> str:
    fd, out_path = tempfile.mkstemp(prefix="gws_", suffix=".bin")
    os.close(fd)
    try:
        if mime_type == "application/vnd.google-apps.document":
            cmd = ["gws", "drive", "files", "export",
                   "--params", json.dumps({"fileId": file_id, "mimeType": "text/plain"}),
                   "-o", out_path]
        elif mime_type == "application/vnd.google-apps.spreadsheet":
            cmd = ["gws", "drive", "files", "export",
                   "--params", json.dumps({"fileId": file_id, "mimeType": "text/csv"}),
                   "-o", out_path]
        else:
            cmd = ["gws", "drive", "files", "get",
                   "--params", json.dumps({"fileId": file_id, "alt": "media"}),
                   "-o", out_path]
        ...
        with open(out_path, "rb") as f:
            return f.read().decode("utf-8", errors="replace")
    finally:
        os.unlink(out_path)
gws 通过 -o 将导出的文件字节写入磁盘,而不是写入 stdout。stdout 承载的是 JSON 元数据。代码使用一个临时文件捕获二进制输出,读取后在 finally 中清理,确保即使出错也会删除临时文件。
vector_store.py — 使用 ChromaDB 的本地嵌入该模块对输入文本进行分块,使用 Sentence Transformers 在本地生成嵌入,通过 ChromaDB 将其持久化到磁盘,并暴露一个简单的 query() 方法,供聊天循环在每次用户提问时调用。
class VectorStore:
    def __init__(self, persist_directory="./chroma_db"):
        self.client = chromadb.PersistentClient(path=persist_directory)
        self.collection = self.client.get_or_create_collection(
            name="drive_documents",
            embedding_function=embedding_functions.DefaultEmbeddingFunction()
        )
        self.text_splitter = RecursiveCharacterTextSplitter(
            chunk_size=1000,
            chunk_overlap=200
        )
PersistentClient 将向量索引写入 ./chroma_db,并在后续运行中直接加载,除非您删除该目录,无需重新摄取。DefaultEmbeddingFunction 在本地使用 Sentence Transformers,嵌入在您的机器上计算,边际成本为零。
分割器采用 chunk_size=1000 与 chunk_overlap=200,通过重叠避免跨块句子丢失上下文。
def add_document(self, file_id: str, filename: str, text: str):
    chunks = self.text_splitter.split_text(text)
    ids = [f"{file_id}_{i}" for i in range(len(chunks))]
    metadatas = [{"source": filename, "file_id": file_id} for _ in chunks]
    self.collection.upsert(documents=chunks, metadatas=metadatas, ids=ids)
    print(f"-> Added {len(chunks)} chunks for {filename}")
上述代码片段中的 upsert 表明:在已摄取的文件上重新运行流水线会更新分块,而不是因 ID 重复报错。
def document_exists(self, file_id: str) -> bool:
    try:
        results = self.collection.get(where={"file_id": file_id}, limit=1)
        return len(results["ids"]) > 0
    except Exception:
        return False
在 main.py 的摄取循环中,这个快速预检查可避免重新下载您已嵌入的文件,使后续运行瞬时完成。
main.py — 摄取、检索与流式聊天main.py 负责运行认证检查、驱动摄取循环、初始化 Gemini 客户端,并运行交互式聊天循环。文件本身保持精简,重活交给 fetcher.py 和 vector_store.py。
def setup_gemini():
    api_key = os.getenv("GEMINI_API_KEY")
    if not api_key:
        print("Please enter your GEMINI_API_KEY (get one from Google AI Studio).")
        api_key = input("Key: ").strip()
    return genai.Client(api_key=api_key)
如果未设置 GEMINI_API_KEY,应用会交互式提示,而不是直接崩溃。您可以像前一步那样设置 GEMINI_API_KEY。
def ingest_documents(store, limit=10):
    files = fetch_document_list(limit)
    for file in files:
        file_id = file.get("id")
        if store.document_exists(file_id):
            print(f"Skipping {file.get('name')} (already in vector store)...")
            continue
        content = download_document(file_id, file.get("mimeType"))
        if content:
            store.add_document(file_id, file.get("name"), content)
document_exists 检查实现了增量摄取:每次运行只下载并嵌入新文件。聊天循环会检索语义最相似的前 3 个分块,并为每个分块标注其来源文件名:
def chat_loop(model, store):
    while True:
        query = input("\nYou: ")
        results = store.query(query, n_results=3)
        documents = results.get("documents", [[]])[0]
        metadatas = results.get("metadatas", [[]])[0]
        context_parts = []
        for doc, meta in zip(documents, metadatas):
            source = meta.get("source", "Unknown")
            context_parts.append(f"Source: {source}\nText:\n{doc}\n")
        full_context = "\n---\n".join(context_parts)
        prompt = f"""You are a helpful assistant. Answer the user's question based ONLY on the following context from their Google Drive. If you cannot answer from the context, say \"I don't know based on your documents.\"\nContext:\n{full_context}\nQuestion: {query}\n"""
        model_name = os.getenv("GEMINI_MODEL", "gemini-2.5-flash")
        response = model.models.generate_content_stream(model=model_name, contents=prompt)
        for chunk in response:
            if chunk.text:
                print(chunk.text, end="", flush=True)
        print()
以上提示语严格限定 LLM 只能基于提供的上下文作答,如果无法从上下文回答,就说 “I don't know based on your documents.”。这样可以避免幻觉式生成与您 Drive 中不一致的信息。响应通过 generate_content_stream 逐 token 流式输出,因此能即时显示。
四个文件就位后,使用以下命令启动应用:
python main.py首次运行时,应用会检查认证、初始化 ChromaDB、在未缓存时下载嵌入模型、获取最多 10 个 Drive 文件、对其进行嵌入并存储,然后进入聊天循环。您将看到每个文件摄取时的增量进度:
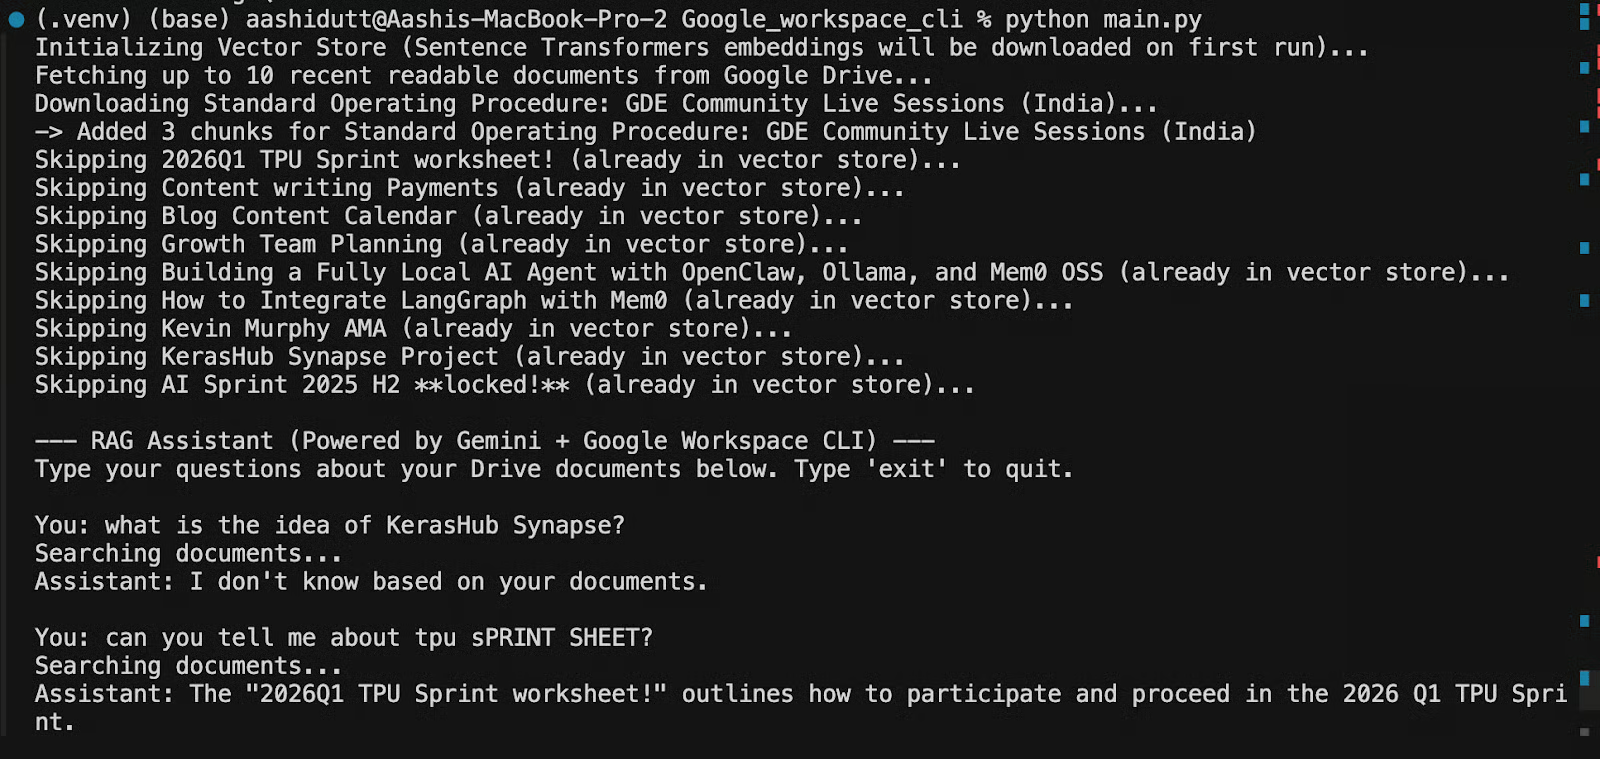
后续运行时,ChromaDB 会从磁盘加载持久化索引,已摄取文件将被跳过,您几乎会立即到达聊天提示。
不过,如果您想从头重新摄取(例如新增了希望纳入的 Drive 文件),需要删除 ChromaDB 目录然后重跑:
rm -rf ./chroma_db
python main.py
如果想在不运行完整流水线的情况下单独验证认证,可直接运行 fetcher.py:
python fetcher.py它会执行 check_auth() 并打印您的 Drive 文件列表,确认 CLI、OAuth 和 Drive API 在您进行完整摄取前均已正常工作。
我们用 Google Workspace CLI 构建的 RAG 助手刻意保持最小化:gws 负责获取,Sentence Transformers 本地嵌入,ChromaDB 存储,Gemini 流式输出答案。四个文件、零云端嵌入成本、每次运行都支持增量摄取。该架构可平滑扩展:如果您想新增 Gmail 和 Calendar 作为摄取来源、换用更大的 Gemini 模型,或用 LangGraph Agent 替代聊天循环,基础都保持不变。
与 DataCamp 一起学习
{count, plural, other {课程}}
{count, plural, other {课程}}
{count, plural, other {课程}}