
Last chance! 50% off DataCamp Premium
Sale ends in
Google baru saja merilis sesuatu yang benar-benar menarik bagi developer. Sebuah antarmuka baris perintah Google Workspace yang memberi Anda akses terstruktur dan dapat diskrip ke seluruh Google Workspace Anda termasuk Drive, Gmail, Kalender, Sheets, Docs, Chat, dan lainnya dalam satu alat.
Codebase-nya hampir seluruhnya Rust (99,3%), tetapi didistribusikan melalui npm sebagai binary native pra-bangun, jadi Anda tidak perlu memasang toolchain Rust.
Dalam tutorial ini, Anda akan menyiapkan Google Workspace CLI dari nol, melakukan autentikasi, dan membangun asisten RAG bertenaga Gemini yang memungkinkan Anda menanyakan file Drive dalam bahasa alami. Di akhir, Anda akan memiliki:
gws terpasang dan diautentikasi terhadap Drive Anda
Lingkungan virtual Python dengan ChromaDB, Sentence Transformers, dan Gemini SDK
Pipeline RAG lokal yang berfungsi yang mengambil file melalui gws, melakukan embedding dengan model lokal, dan melakukan streaming jawaban dengan Gemini 2.5 Flash
Catatan: Ini bukan produk Google yang didukung secara resmi.
Google Workspace CLI (gws) adalah alat baris perintah yang dioptimalkan untuk AI bagi seluruh ekosistem Google Workspace Anda. Berikut yang membuatnya menonjol:
Penemuan perintah dinamis: Alih-alih mengirimkan pohon perintah yang di-hardcode, gws membaca Discovery Service Google saat runtime. Saat Google menambahkan endpoint API baru, CLI akan menangkapnya secara otomatis tanpa peningkatan versi.
Desain agent-native: CLI dilengkapi 100+ skill agent bawaan dan 50 resep terkurasi untuk alur kerja umum yang meringkas email, memindahkan file Drive, membuat event kalender, dan banyak lagi. Setiap output berupa JSON terstruktur, sehingga LLM dapat mengonsumsinya langsung.
Dukungan server MCP native: Jalankan gws sebagai server MCP lokal dan berikan agen AI Anda akses penuh ke alat Workspace tanpa menulis satu pun klien API.
Integrasi Model Armor: Untuk agen produksi yang membaca konten yang dikendalikan pengguna, Anda dapat menyalurkan respons API melalui Google Cloud Model Armor untuk mensterilkan dari prompt injection sebelum dilihat LLM Anda.
Anda dapat menelusuri pustaka skill lengkap di sini: github.com/googleworkspace/cli/blob/main/docs/skills.md.
Dalam tutorial ini, kita akan membangun asisten RAG selangkah demi selangkah. Secara garis besar, inilah yang dilakukan aplikasi:
Melakukan autentikasi terhadap Google Drive Anda menggunakan CLI gws dan mengambil file Docs, Sheets, dan teks yang terakhir dimodifikasi
Memecah setiap dokumen dan melakukan embedding secara lokal menggunakan Sentence Transformers melalui ChromaDB
Menyimpan indeks vektor ke disk sehingga run berikutnya melewati file yang sudah diingest dan langsung ke percakapan
Menerima pertanyaan berbahasa alami, mengambil 3 potongan paling relevan dari ChromaDB, dan membangun prompt konteks yang terlandas
Melakukan streaming jawaban ber-sitasi berbasis konteks saja dari Gemini 2.5 Flash token demi token langsung di terminal Anda
Mari kita bangun selangkah demi selangkah.
Kode tutorial lengkap: https://github.com/AashiDutt/Google-Workspace-CLI-Demo
CLI didistribusikan sebagai paket npm yang membungkus binary Rust pra-bangun. Tidak perlu toolchain Rust.
npm install -g @googleworkspace/cliVerifikasi pemasangan dengan menjalankan perintah berikut satu per satu:
gws --version
which gws
Jika gws tidak ditemukan setelah pemasangan, pastikan direktori bin npm global ada pada PATH Anda.
CLI melakukan autentikasi melalui klien OAuth proyek GCP, jadi Anda memerlukan satu sebelum masuk. Untuk membuat atau memilih proyek dari GCP:
Siapkan kredensial OAuth:
Masuk ke APIs & Services dan pilih Credentials
Klik Create Credentials dan masuk ke OAuth 2.0 Client ID
Pilih Desktop app sebagai jenis aplikasi
Catat Client ID dan Client Secret yang akan kita gunakan untuk gws auth setup.
CLI menyelesaikan OAuth dengan menyalakan server localhost sementara. Klien Desktop app menangani port localhost apa pun secara otomatis. Klien Web application mengharuskan Anda menambahkan setiap http://localhost:PORT secara manual ke daftar authorized redirect URIs.
Jika Anda menggunakan klien Web application dan menemui "Access blocked: This app's request is invalid", buka Credentials lalu klik OAuth client diikuti Authorized redirect URIs dan tambahkan URL http://localhost:PORT persis seperti yang ditampilkan pada error.
Untuk menghubungkan gws ke proyek GCP Anda, pertama ekspor kredensial OAuth Anda sebagai variabel lingkungan agar wizard penyiapan dapat mengambilnya secara otomatis:
export GOOGLE_WORKSPACE_CLI_CLIENT_ID="CLIENT_ID"
export GOOGLE_WORKSPACE_CLI_CLIENT_SECRET="CLIENT_SECRET"
Lalu jalankan:
gws auth setup --project YOUR_PROJECT_ID --login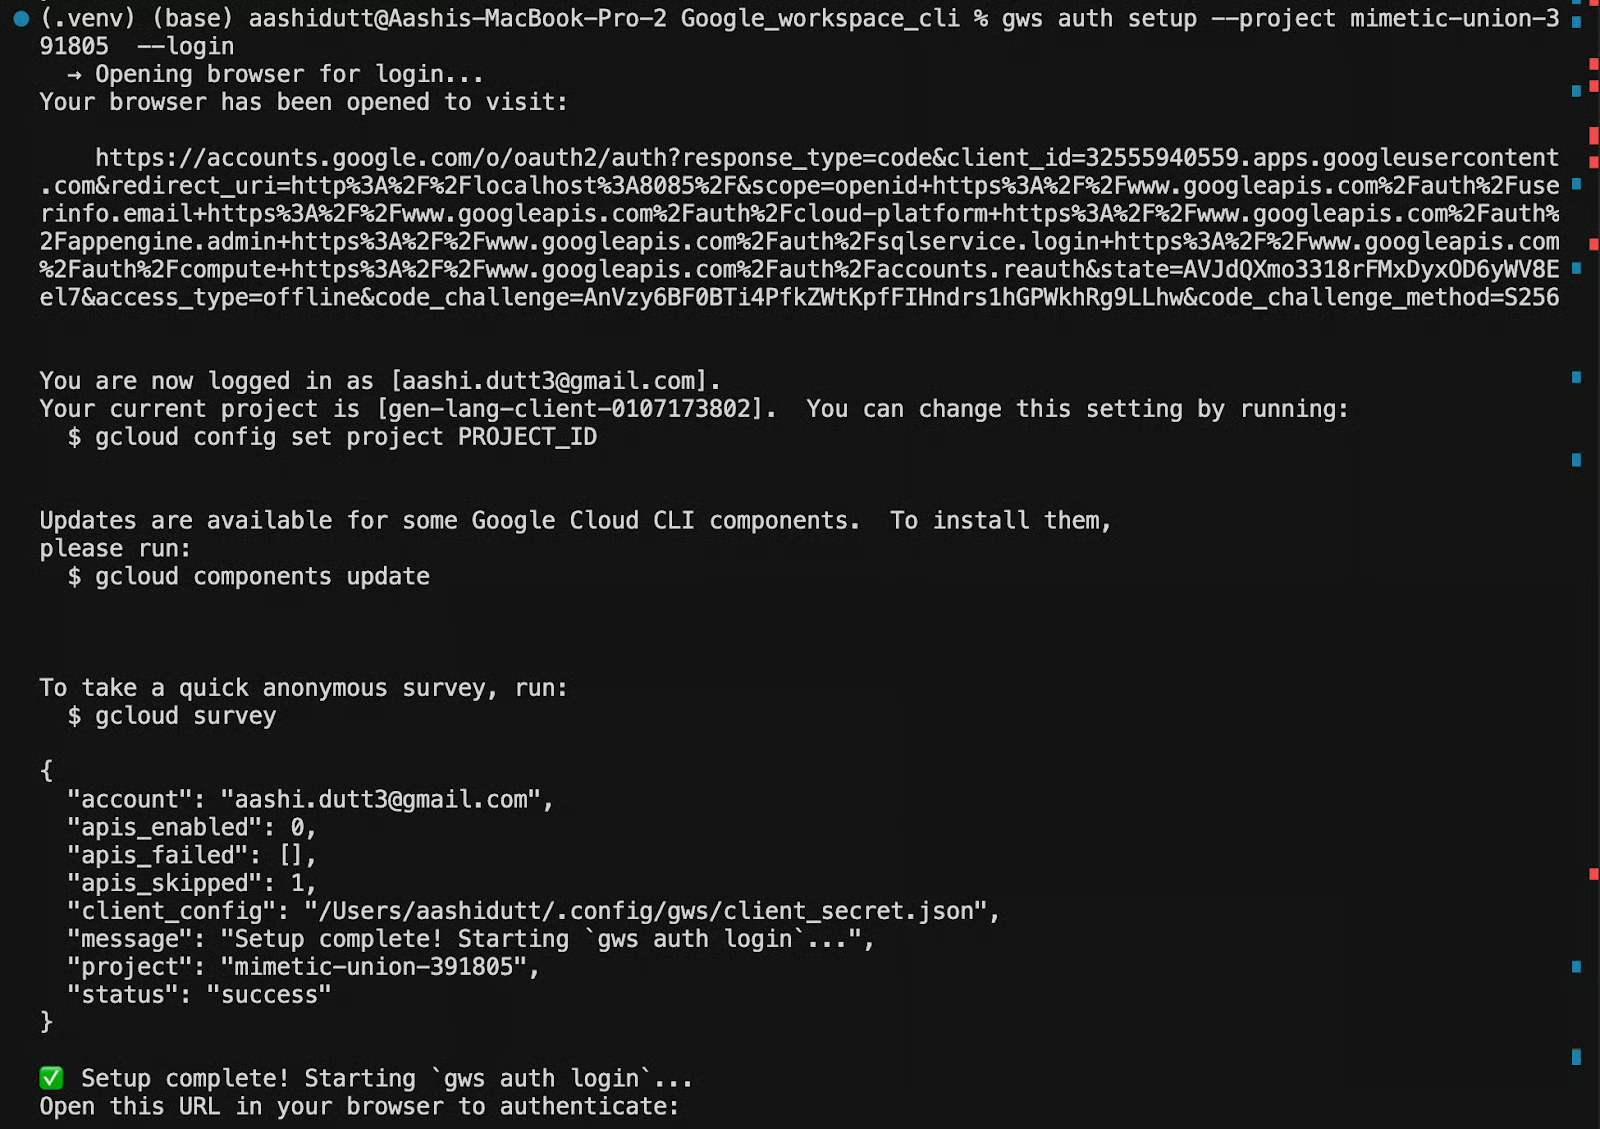
Wizard penyiapan akan:
Setelah selesai, Anda akan melihat: Setup complete!
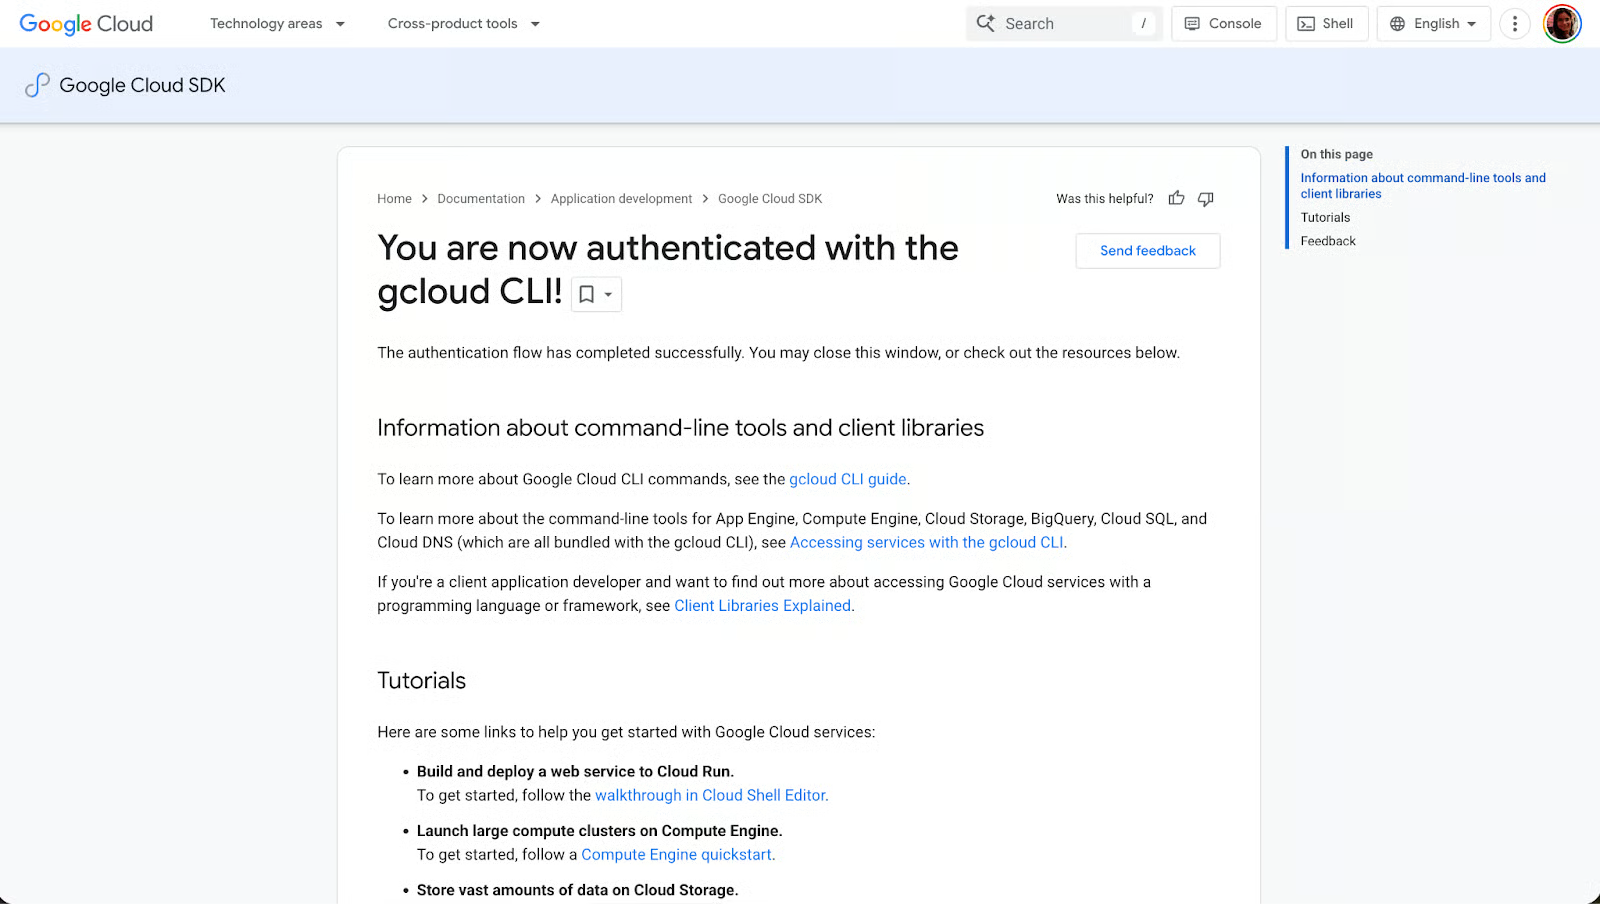
Kredensial disimpan di ~/.config/gws/. Untuk mengonfirmasi semuanya terhubung dengan benar, jalankan:
gws auth statusPerintah ini mencetak akun yang diautentikasi, proyek GCP yang ditautkan, dan scope aktif. Jika ada yang terlihat salah, jalankan kembali gws auth setup dengan flag yang benar alih-alih mencoba mengedit file konfigurasi secara manual.
Sebelum menulis Python, ada baiknya melakukan pemeriksaan cepat langsung dari terminal untuk mengonfirmasi CLI telah diautentikasi dan dapat berkomunikasi dengan Drive Anda. Mari jalankan perintah berikut untuk mencantumkan lima file Drive terbaru Anda:
gws drive files list --params '{"pageSize": 5}'Flag --params menerima string JSON yang dipetakan langsung ke parameter kueri API Drive. Di sini, pageSize: 5 membatasi respons menjadi lima hasil yang cukup untuk mengonfirmasi konektivitas tanpa menampilkan seluruh Drive Anda.
Jika autentikasi berfungsi dengan benar, Anda akan menerima respons JSON terstruktur seperti ini:
{
  "files": [
    {
      "id": "1BxiMVs0XRA5nFMdKvBdBZjgmUUqptlbs74OgVE2upms",
      "name": "Q3 Strategy Doc",
      "mimeType": "application/vnd.google-apps.document"
    },
    ...
  ]
}
Setiap respons dari gws adalah JSON terstruktur tanpa parsing, tanpa scraping, tanpa keluaran teks rapuh.
Jika Anda malah melihat “403 error” yang menyebut serviceusage.services.use, itu berarti kredensial OAuth Anda diarahkan ke proyek GCP yang berbeda dari yang memiliki penagihan diaktifkan. Jalankan kembali penyiapan dengan project ID yang benar untuk menautkan semuanya kembali:
gws auth setup --project YOUR_PROJECT_ID --loginDengan akses Drive terkonfirmasi, kita siap mengaktifkan API dan mulai membangun sisi Python dari pipeline.
Pada titik ini, gws dapat melakukan autentikasi terhadap proyek GCP Anda, tetapi belum bisa membaca konten file Drive. GCP memisahkan autentikasi (membuktikan siapa Anda) dari aktivasi API (menyatakan layanan mana yang digunakan proyek Anda). Bahkan dengan kredensial OAuth yang valid, upaya mengambil konten file akan mengembalikan error 403 accessNotConfigured sampai Drive API diaktifkan secara eksplisit pada proyek.
Untuk mengaktifkannya, buka URL ini di browser dan ganti [PROJECT_ID] dengan project ID Anda yang sebenarnya lalu klik Enable:
https://console.developers.google.com/apis/api/drive.googleapis.com/overview?project=[PROJECT_ID]
Sebagai alternatif, jika Anda memasang CLI gcloud, Anda dapat mengaktifkannya langsung dari terminal:
gcloud services enable drive.googleapis.com --project YOUR_PROJECT_IDKedua metode melakukan hal yang sama. Menjalankan salah satunya pada API yang sudah diaktifkan aman karena operasinya idempoten dan tidak akan mengatur ulang konfigurasi yang ada.
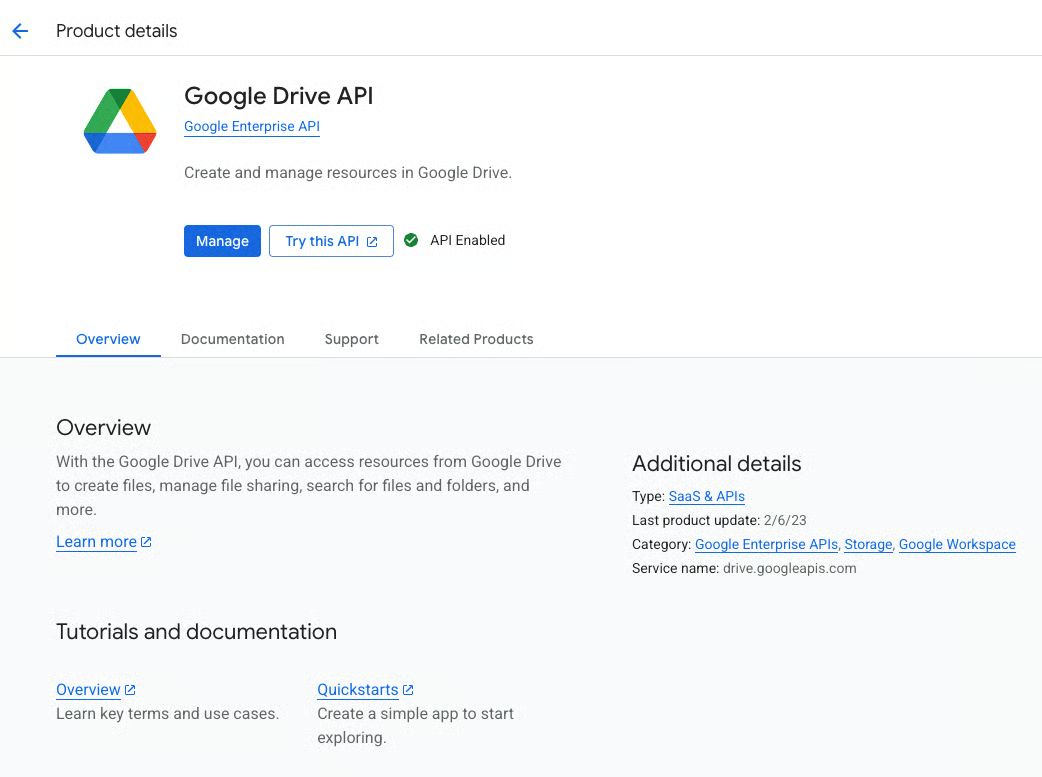
Setelah diaktifkan, GCP mungkin memerlukan beberapa detik untuk mempropagasi perubahan. Jika Anda langsung menjalankan gws drive files list dan masih melihat 403, tunggu 30 detik dan coba lagi.
Dengan sisi CLI sepenuhnya dikonfigurasi, kini kita dapat menyiapkan lingkungan Python yang menangani logika embedding dan retrieval. Pipeline RAG sengaja dibuat ringan dengan empat paket, tanpa memerlukan GPU, dan seluruh embedding terjadi secara lokal di mesin Anda.
Mulailah dengan membuat lingkungan virtual dengan menjalankan perintah berikut satu per satu:
cd /path/to/your/project
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
pip install -r requirements.txt
Lalu pasang dependensi dari requirements.txt:
.txt
chromadb==1.5.5
google-genai==1.70.0
langchain-text-splitters==1.1.1
sentence-transformers==5.3.0
Berikut kontribusi tiap paket pada pipeline:
chromadb: Basis data vektor lokal yang menyimpan embedding dokumen ke ./chroma_db di disk dan memuatnya pada run berikutnya, sehingga aplikasi tidak perlu melakukan embedding ulang file yang sudah diproses.
google-genai: SDK Python resmi untuk Gemini. Aplikasi menggunakannya untuk mengirim konteks yang diambil dan pertanyaan pengguna ke Gemini 2.5 Flash, dengan streaming respons kembali token demi token.
langchain-text-splitters: Paket ini menyediakan RecursiveCharacterTextSplitter, yang memecah dokumen besar menjadi potongan tumpang-tindih sebelum embedding. Overlap memastikan kalimat di batas potongan tidak terputus dari konteksnya.
sentence-transformers: Sentence Transformers menjalankan model embedding secara lokal melalui DefaultEmbeddingFunction milik ChromaDB. Jadi, setiap potongan dokumen di-embed di mesin tanpa panggilan API eksternal.
Catatan: Model embedding (~90MB) diunduh otomatis saat pertama kali digunakan dan di-cache secara lokal.
Dengan lingkungan Python siap, bagian terakhir sebelum menulis kode adalah mendapatkan kunci API Gemini.
Pipeline RAG menggunakan Gemini sebagai lapisan pembangkitan jawaban karena mengambil potongan dokumen yang diambil dan pertanyaan pengguna, lalu melakukan streaming respons yang terlandas. Untuk terhubung ke Gemini, Anda memerlukan kunci API dari Google AI Studio.
Masuk dengan akun Google Anda, klik Get API Key, lalu pilih Create API Key. Pilih proyek GCP Anda saat diminta agar kuota dan penagihan tercatat. Tautkan akun penagihan di dasbor GCP di bawah Billing lalu pilih Link a billing account.
Setelah Anda memiliki kunci, ekspor sebagai variabel lingkungan:
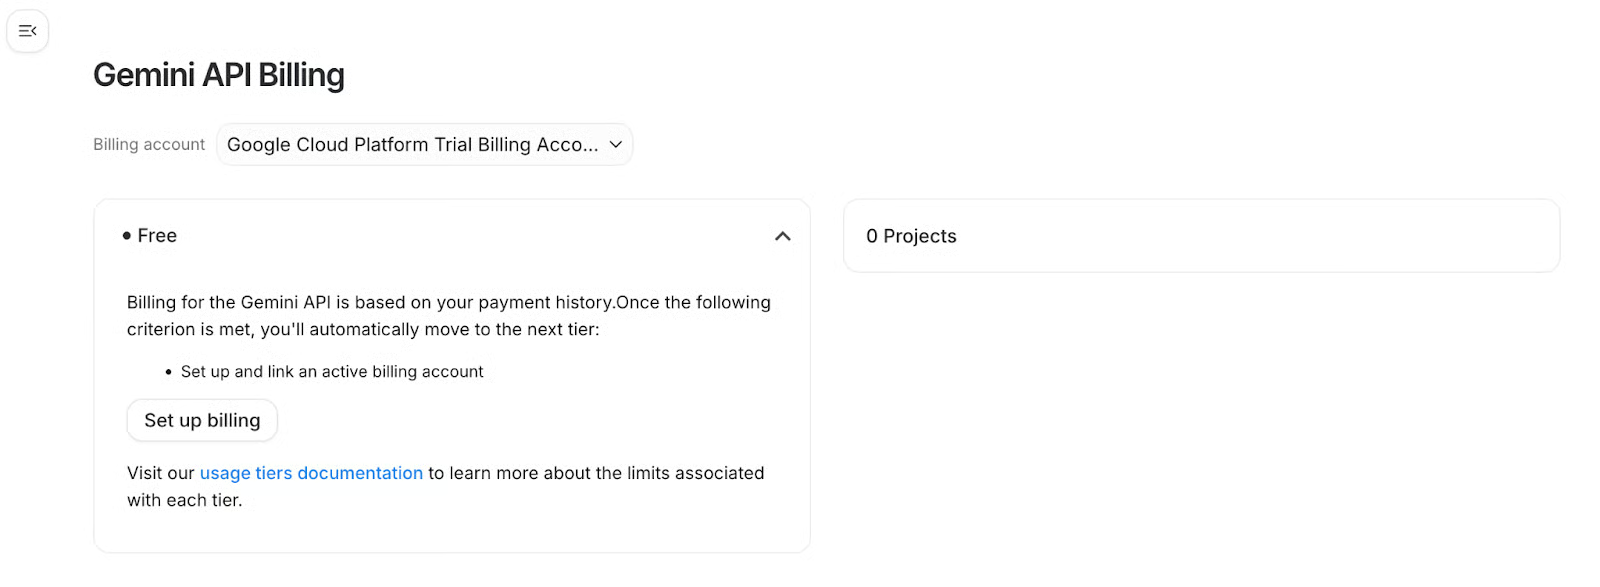
Ekspor kunci di terminal Anda:
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"Untuk mempertahankannya antar sesi terminal, jalankan:
echo 'export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"' >> ~/.zshrc
source ~/.zshrc
Aplikasi membaca kunci ini melalui os.getenv("GEMINI_API_KEY") saat startup. Jika variabel tidak disetel, aplikasi akan meminta Anda menempelkan kunci secara interaktif.
Catatan model: Aplikasi menggunakan default gemini-2.5-flash. Anda dapat menimpanya dengan mengekspor GEMINI_MODEL="gemini-2.5-pro" jika menginginkan penalaran yang lebih kuat pada dokumen kompleks. Perlu dicatat bahwa gemini-2.0-flash telah dihentikan untuk kunci API baru, jadi jangan gunakan di sini.
Dengan autentikasi, Drive API, dependensi, dan kunci Gemini siap, kita memiliki semua yang diperlukan. Mari bangun pipeline-nya.
Sekarang mari hubungkan semuanya. Kita akan bekerja dengan empat file, termasuk fetcher.py, vector_store.py, main.py, dan requirements.txt. Setiap file punya satu tanggung jawab, seperti fetcher.py menangani semua interaksi CLI, vector_store.py mengelola embedding dan retrieval, dan main.py mengorkestrasi loop penuh dari ingestion hingga streaming chat.
Pada run pertama, gws mengambil file Drive Anda, konten dipecah dan di-embed secara lokal, dan indeks vektor ditulis ke ./chroma_db di disk. Pada run berikutnya, ChromaDB memuat dari disk, hanya file baru yang diambil dan di-embed, dan loop chat segera dimulai tanpa memproses ulang apa pun.
Mari kita ulas setiap file.
fetcher.py — Akses Drive via gwsModul ini adalah jembatan antara CLI gws dan Python. Semua interaksi Drive seperti mencantumkan file, mengekspor konten, dan memeriksa autentikasi dilakukan melalui pemanggilan subprocess ke gws, dan output JSON terstruktur diurai menjadi dict Python. Hasilnya, kode Python tidak pernah perlu berurusan langsung dengan token OAuth, klien HTTP, atau skema respons API; gws menangani semua itu dan mengembalikan JSON yang bersih.
def _gws_json_stdout(stdout: str) -> str:
    if not stdout or "{" not in stdout:
        return stdout or ""
    return stdout[stdout.find("{"):]
Helper _gws_json_stdout menangani masalah halus saat gws kadang memunculkan baris keyring atau logging sebelum payload JSON. Di sini, memanggil json.loads(result.stdout) secara langsung akan gagal sehingga fungsi ini memotong semuanya sebelum { pertama.
def check_auth() -> bool:
    cmd = ["gws", "drive", "about", "get", "--params", '{"fields": "user"}']
    result = subprocess.run(cmd, capture_output=True, text=True)
    payload = _gws_json_stdout(result.stdout)
    try:
        data = json.loads(payload) if payload.strip() else {}
    except json.JSONDecodeError:
        print("Error checking authentication status (could not parse gws output).")
        return False
    if "error" in data or result.returncode != 0:
        handle_error_output(result.stdout, result.stderr)
        return False
    return True
Fungsi check_auth() dipanggil saat startup di main.py yang membuat panggilan API Drive ringan dan memeriksa respons. Jika autentikasi bermasalah atau scope kurang, aplikasi keluar dengan rapi sebelum mencoba ingestion.
Handler error juga menangkap mode kegagalan spesifik dan mencetak pesan yang dapat ditindaklanjuti:
def handle_error_output(stdout, stderr):
    output = _gws_json_stdout(stdout or "") or (stderr or "")
    if "insufficientPermissions" in output or "unauthenticated" in output.lower():
        print("Please run: gws auth login -s drive")
    elif "serviceusage.services.use" in output or "serviceUsageConsumer" in output:
        print(
            "GCP quota project error: run gws auth setup --project YOUR_PROJECT_ID --login"
        )
    else:
        print(f"API Error: {output}")
Pengambil daftar dokumen menargetkan hanya tipe MIME yang dapat diekspor sebagai teks:
def fetch_document_list(limit=10) -> list[dict]:
    q = (
        "(mimeType='text/plain' or mimeType='application/vnd.google-apps.document' "
        "or mimeType='application/vnd.google-apps.spreadsheet') and trashed=false"
    )
    cmd = [
        "gws", "drive", "files", "list",
        "--params",
        json.dumps({"q": q, "pageSize": limit, "orderBy": "modifiedTime desc"}),
    ]
Kueri memfilter ke teks biasa, Google Docs, dan Google Sheets, masing-masing diurutkan berdasarkan yang terakhir dimodifikasi. File biner (PDF, gambar) dikecualikan karena tidak dapat diekspor sebagai teks dengan pendekatan ini.
Namun, pengunduhan ditangani berbeda per tipe MIME:
def download_document(file_id: str, mime_type: str) -> str:
    fd, out_path = tempfile.mkstemp(prefix="gws_", suffix=".bin")
    os.close(fd)
    try:
        if mime_type == "application/vnd.google-apps.document":
            cmd = ["gws", "drive", "files", "export",
                   "--params", json.dumps({"fileId": file_id, "mimeType": "text/plain"}),
                   "-o", out_path]
        elif mime_type == "application/vnd.google-apps.spreadsheet":
            cmd = ["gws", "drive", "files", "export",
                   "--params", json.dumps({"fileId": file_id, "mimeType": "text/csv"}),
                   "-o", out_path]
        else:
            cmd = ["gws", "drive", "files", "get",
                   "--params", json.dumps({"fileId": file_id, "alt": "media"}),
                   "-o", out_path]
        ...
        with open(out_path, "rb") as f:
            return f.read().decode("utf-8", errors="replace")
    finally:
        os.unlink(out_path)
gws menulis byte file yang diekspor ke disk melalui -o, bukan ke stdout. Stdout membawa metadata JSON. Kode menggunakan file sementara untuk menangkap output biner, membacanya, dan membersihkan di blok finally, sehingga file sementara selalu dihapus bahkan saat error.
vector_store.py — Embedding lokal dengan ChromaDBModul ini memecah teks yang masuk, menghasilkan embedding secara lokal menggunakan Sentence Transformers, menyimpannya ke disk melalui ChromaDB, dan mengekspos metode query() sederhana yang dipanggil loop chat untuk setiap pertanyaan pengguna.
class VectorStore:
    def __init__(self, persist_directory="./chroma_db"):
        self.client = chromadb.PersistentClient(path=persist_directory)
        self.collection = self.client.get_or_create_collection(
            name="drive_documents",
            embedding_function=embedding_functions.DefaultEmbeddingFunction()
        )
        self.text_splitter = RecursiveCharacterTextSplitter(
            chunk_size=1000,
            chunk_overlap=200
        )
PersistentClient menulis indeks vektor ke ./chroma_db dan memuatnya pada run berikutnya tanpa perlu ingestion ulang kecuali Anda menghapus direktori tersebut. DefaultEmbeddingFunction menggunakan Sentence Transformers secara lokal, sementara embedding dihitung di mesin Anda dengan biaya marginal nol.
Splitter menggunakan chunk_size=1000 dengan chunk_overlap=200, sehingga overlap memastikan konteks di batas potongan tidak hilang saat kalimat terbelah di dua potongan.
def add_document(self, file_id: str, filename: str, text: str):
    chunks = self.text_splitter.split_text(text)
    ids = [f"{file_id}_{i}" for i in range(len(chunks))]
    metadatas = [{"source": filename, "file_id": file_id} for _ in chunks]
    self.collection.upsert(documents=chunks, metadatas=metadatas, ids=ids)
    print(f"-> Added {len(chunks)} chunks for {filename}")
upsert pada cuplikan kode di atas berarti menjalankan pipeline lagi pada file yang sudah diingest akan memperbarui potongan alih-alih memunculkan error ID duplikat.
def document_exists(self, file_id: str) -> bool:
    try:
        results = self.collection.get(where={"file_id": file_id}, limit=1)
        return len(results["ids"]) > 0
    except Exception:
        return False
Pemeriksaan cepat ini di loop ingestion main.py menghindari pengunduhan ulang file yang sudah Anda embed, membuat run berikutnya menjadi instan.
main.py — Ingestion, retrieval, dan streaming chatFile main.py menjalankan pemeriksaan autentikasi, menggerakkan loop ingestion, menginisialisasi klien Gemini, dan menjalankan loop chat interaktif. File ini sengaja dibuat tipis karena pekerjaan berat didelegasikan ke fetcher.py dan vector_store.py.
def setup_gemini():
    api_key = os.getenv("GEMINI_API_KEY")
    if not api_key:
        print("Please enter your GEMINI_API_KEY (get one from Google AI Studio).")
        api_key = input("Key: ").strip()
    return genai.Client(api_key=api_key)
Jika GEMINI_API_KEY tidak disetel, aplikasi meminta secara interaktif alih-alih crash. Anda dapat menyetel GEMINI_API_KEY seperti yang kita lakukan pada langkah sebelumnya.
def ingest_documents(store, limit=10):
    files = fetch_document_list(limit)
    for file in files:
        file_id = file.get("id")
        if store.document_exists(file_id):
            print(f"Skipping {file.get('name')} (already in vector store)...")
            continue
        content = download_document(file_id, file.get("mimeType"))
        if content:
            store.add_document(file_id, file.get("name"), content)
Pemeriksaan document_exists adalah mekanisme ingestion inkremental dengan hanya file baru yang diunduh dan di-embed pada setiap run. Loop chat mengambil 3 potongan yang paling mirip secara semantik dan memberi anotasi masing-masing dengan nama file sumbernya:
def chat_loop(model, store):
    while True:
        query = input("\nYou: ")
        results = store.query(query, n_results=3)
        documents = results.get("documents", [[]])[0]
        metadatas = results.get("metadatas", [[]])[0]
        context_parts = []
        for doc, meta in zip(documents, metadatas):
            source = meta.get("source", "Unknown")
            context_parts.append(f"Source: {source}\nText:\n{doc}\n")
        full_context = "\n---\n".join(context_parts)
        prompt = f"""You are a helpful assistant. Answer the user's question based ONLY on the following context from their Google Drive. If you cannot answer from the context, say "I don't know based on your documents."
Context:
{full_context}
Question: {query}
"""
        model_name = os.getenv("GEMINI_MODEL", "gemini-2.5-flash")
        response = model.models.generate_content_stream(model=model_name, contents=prompt)
        for chunk in response:
            if chunk.text:
                print(chunk.text, end="", flush=True)
        print()
Prompt di atas sepenuhnya terlandas sehingga LLM diinstruksikan untuk menjawab hanya dari konteks yang disediakan dan mengatakan "I don't know" jika jawabannya tidak ada. Ini mencegah halusinasi informasi yang tidak ada di Drive Anda. Respons distream token demi token melalui generate_content_stream, sehingga keluaran muncul seketika.
Dengan keempat file siap, mulai aplikasi dengan:
python main.pyPada run pertama, aplikasi memeriksa autentikasi, menginisialisasi ChromaDB, mengunduh model embedding jika belum di-cache, mengambil hingga 10 file Drive, melakukan embedding dan menyimpannya, lalu membawa pengguna ke loop chat. Anda akan melihat progres bertahap dicetak untuk setiap file saat diingest:
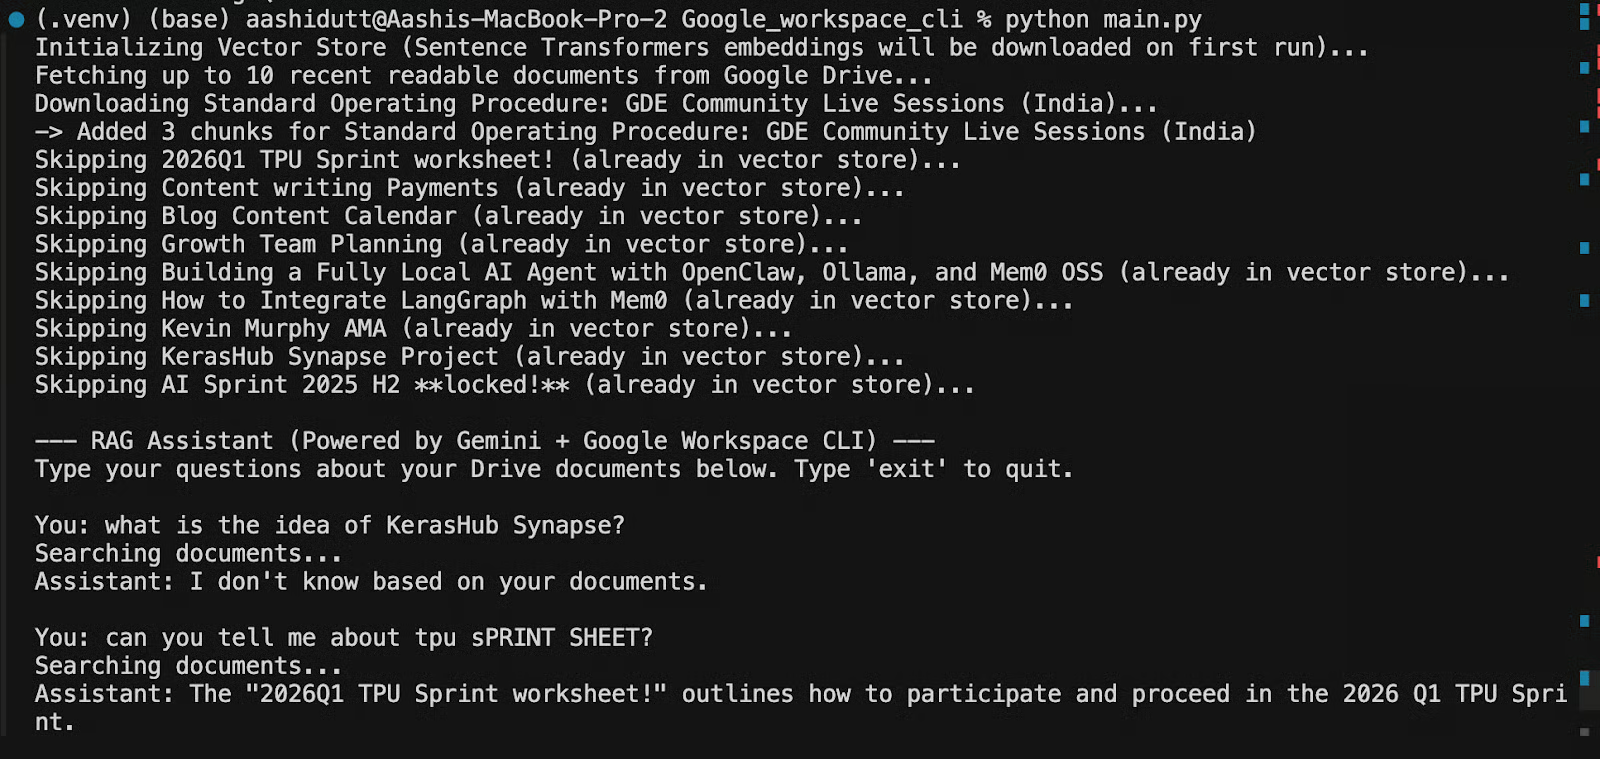
Pada run berikutnya, ChromaDB memuat indeks yang dipertahankan dari disk, file yang sudah diingest dilewati, dan Anda mencapai prompt chat hampir seketika.
Namun, untuk meng-ingest ulang semuanya dari nol, misalnya setelah menambahkan file Drive baru yang ingin Anda sertakan, Anda perlu menghapus direktori ChromaDB dan menjalankan ulang:
rm -rf ./chroma_db
python main.py
Untuk memverifikasi autentikasi secara terpisah tanpa menjalankan pipeline penuh, jalankan fetcher.py langsung:
python fetcher.pyIni mengeksekusi check_auth() dan mencetak daftar file Drive Anda untuk mengonfirmasi bahwa CLI, OAuth, dan Drive API semuanya berfungsi sebelum Anda menjalankan ingestion penuh.
Asisten RAG yang kita bangun dengan Google Workspace CLI sengaja dibuat minimal di mana gws mengambil, Sentence Transformers melakukan embedding secara lokal, ChromaDB menyimpan, Gemini melakukan streaming jawaban. Empat file, nol biaya embedding cloud, ingestion inkremental pada setiap run. Arsitektur ini diskalakan dengan bersih jika Anda ingin menambahkan Gmail dan Kalender sebagai sumber ingestion tambahan, mengganti dengan model Gemini yang lebih besar, atau mengganti loop chat dengan agen LangGraph. Fondasinya tetap sama.
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt




