
{count, plural, one {Cursus} other {Cursussen}}
Inleiding tot AI-agents
{hours} uur {minutes} min
144.8K
Google heeft iets echt interessants voor developers uitgebracht. Een Google Workspace command-line interface die je gestructureerde, scriptbare toegang geeft tot je volledige Google Workspace, inclusief Drive, Gmail, Calendar, Sheets, Docs, Chat en meer, allemaal in één tool.
De codebase is vrijwel geheel in Rust (99,3%), maar wordt via npm gedistribueerd als vooraf gebouwde native binaries, dus je hoeft nooit een Rust-toolchain te installeren.
In deze tutorial zet je de Google Workspace CLI vanaf nul op, authenticeer je deze en bouw je een door Gemini aangestuurde RAG-assistent waarmee je je Drive-bestanden in natuurlijke taal kunt bevragen. Aan het eind heb je:
gws geïnstalleerd en geauthenticeerd tegen je Drive
Een Python-virtuele omgeving met ChromaDB, Sentence Transformers en de Gemini SDK
Een werkende lokale RAG-pijplijn die bestanden ophaalt via gws, ze embed met een lokaal model en antwoorden streamt met Gemini 2.5 Flash
Let op: Dit is geen officieel ondersteund Google-product.
De Google Workspace CLI (gws) is een AI-geoptimaliseerde command-line tool voor je volledige Google Workspace-ecosysteem. Dit maakt ‘m bijzonder:
Dynamische command discovery: In plaats van een hardgecodeerde commandstructuur mee te leveren, leest gws tijdens runtime Google’s Discovery Service. Wanneer Google nieuwe API-eindpunten toevoegt, pikt de CLI die automatisch op zonder versie-upgrade.
Agent-native design: De CLI wordt geleverd met 100+ vooraf gebouwde agent-skills en 50 samengestelde recepten voor veelvoorkomende workflows die e-mails samenvatten, Drive-bestanden verplaatsen, agenda-afspraken maken en meer. Elke output is gestructureerde JSON, zodat LLM’s het direct kunnen verwerken.
Native MCP-serverondersteuning: Draai gws als een lokale MCP-server en geef je AI-agent volledige Workspace-tooltoegang zonder één enkele API-client te schrijven.
Model Armor-integratie: Voor productie-agents die door gebruikers beheerde content lezen, kun je API-responses via Google Cloud Model Armor laten lopen om te beschermen tegen prompt injection voordat je LLM ze ziet.
Je kunt de volledige skill-bibliotheek hier bekijken: github.com/googleworkspace/cli/blob/main/docs/skills.md.
In deze tutorial bouwen we stap voor stap de RAG-assistent. Op hoofdlijnen doet de app dit:
Authenticeert tegen je Google Drive met de gws-CLI en haalt je meest recent gewijzigde Docs-, Sheets- en tekstbestanden op
Hakt elk document in stukken en embedt het lokaal met Sentence Transformers via ChromaDB
Slaat de vectorindex op schijf op zodat volgende runs al ingeslikte bestanden overslaan en direct naar chat gaan
Accepteert een vraag in natuurlijke taal, haalt de top-3 meest relevante chunks uit ChromaDB op en bouwt een onderbouwde contextprompt
Streamt een beantwoord, context-only antwoord van Gemini 2.5 Flash token-voor-token rechtstreeks in je terminal
Laten we het stap voor stap bouwen.
Volledige tutorialcode: https://github.com/AashiDutt/Google-Workspace-CLI-Demo
De CLI wordt gedistribueerd als een npm-package dat vooraf gebouwde Rust-binaries verpakt. Geen Rust-toolchain nodig.
npm install -g @googleworkspace/cliVerifieer de installatie door de volgende commando’s één voor één uit te voeren:
gws --version
which gws
Als gws na installatie niet wordt gevonden, zorg dan dat je npm global bin-directory in je PATH staat.
De CLI authenticeert via de OAuth-client van een GCP-project, dus je hebt er één nodig voordat je kunt inloggen. Om een project aan te maken of te selecteren in GCP:
Stel OAuth-gegevens in:
Navigeer naar APIs & Services en selecteer Credentials
Klik op Create Credentials en ga naar OAuth 2.0 Client ID
Kies Desktop-app als application type
Noteer de Client ID en Client Secret die we gebruiken voor gws auth setup.
De CLI rondt OAuth af door tijdelijk een localhost-server te starten. Desktop-appclients verwerken automatisch willekeurige localhost-poorten. Web application-clients vereisen dat je handmatig elke http://localhost:PORT toevoegt aan de lijst met geautoriseerde redirect-URI’s.
Als je een Web application-client gebruikt en "Access blocked: This app's request is invalid" ziet, ga dan naar Credentials, klik op OAuth client gevolgd door Authorized redirect URIs en voeg exact de http://localhost:PORT-URL toe die in de foutmelding staat.
Om gws te koppelen aan je GCP-project, exporteer je eerst je OAuth-gegevens als omgevingsvariabelen zodat de setupwizard ze automatisch kan oppikken:
export GOOGLE_WORKSPACE_CLI_CLIENT_ID="CLIENT_ID"
export GOOGLE_WORKSPACE_CLI_CLIENT_SECRET="CLIENT_SECRET"
Voer daarna uit:
gws auth setup --project YOUR_PROJECT_ID --login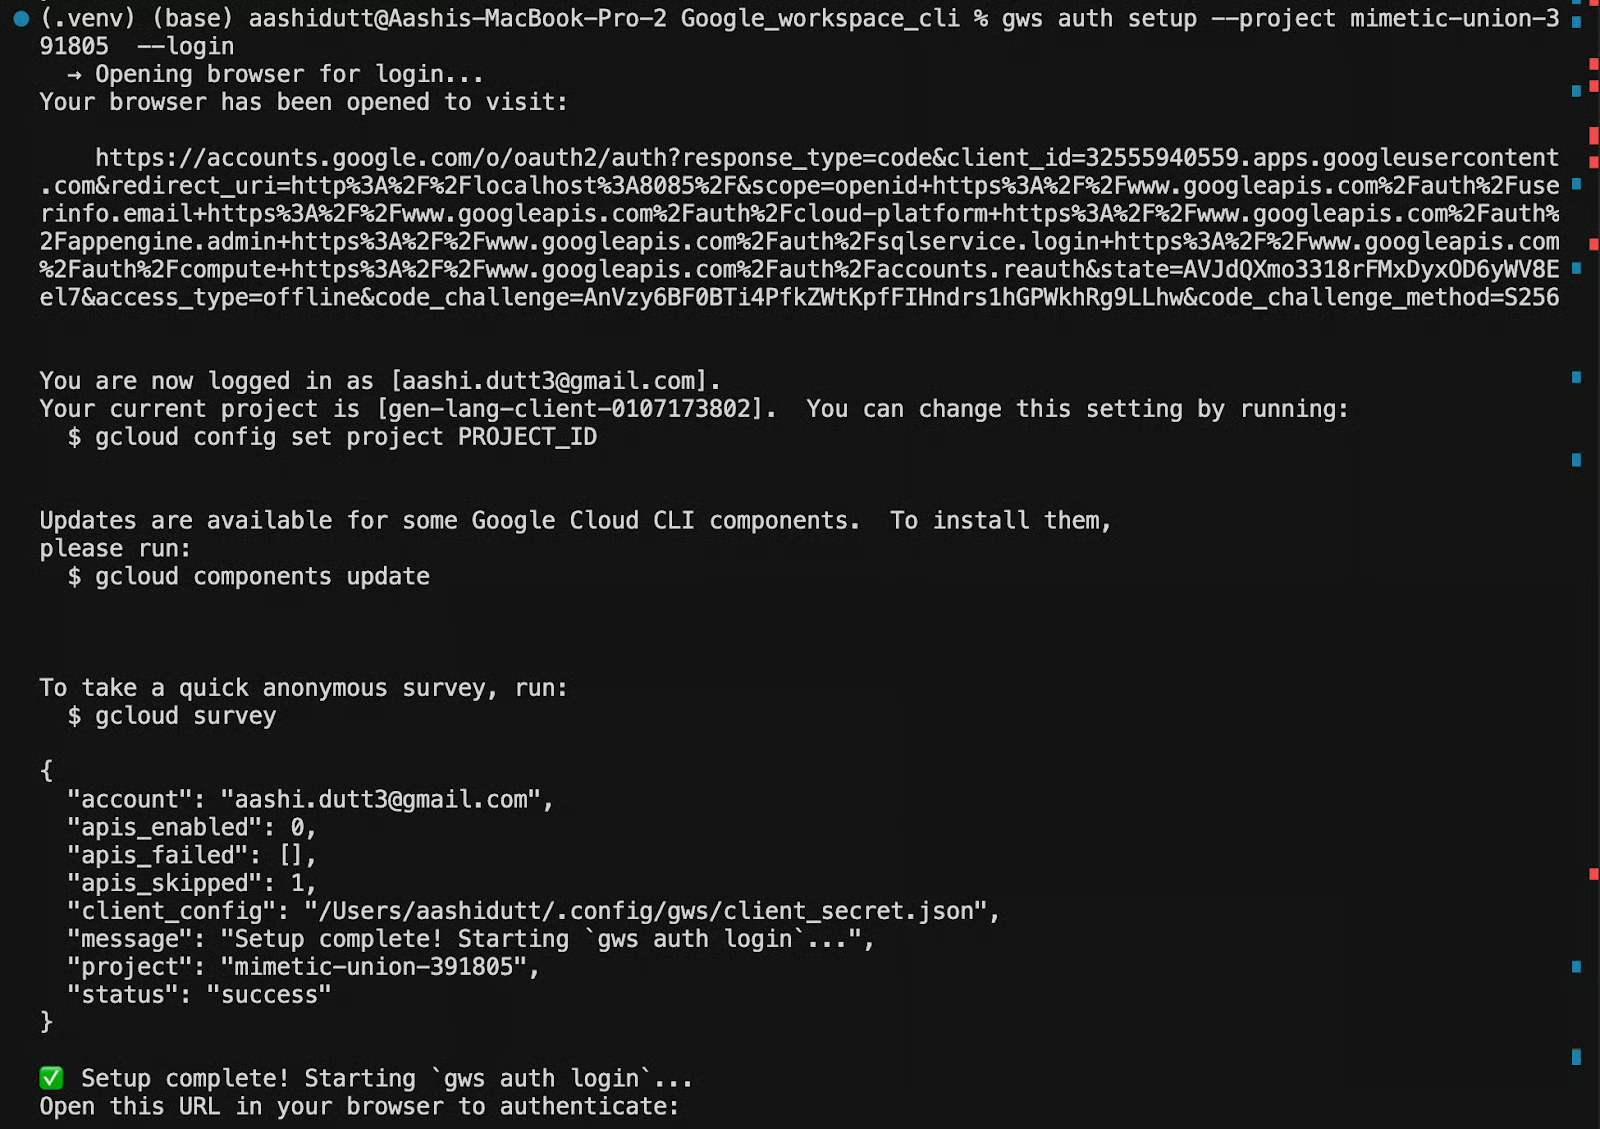
De setupwizard zal:
Na voltooiing zie je: Setup complete!
De credentials worden opgeslagen in ~/.config/gws/. Om te bevestigen dat alles correct is gekoppeld, voer je uit:
gws auth statusDit toont het geauthenticeerde account, het gekoppelde GCP-project en de actieve scopes. Als iets niet klopt, voer dan opnieuw gws auth setup uit met de juiste flags in plaats van de configbestanden handmatig te bewerken.
Voordat we Python schrijven, is het de moeite waard om een snelle sanity check te doen vanuit de terminal om te bevestigen dat de CLI geauthenticeerd is en met je Drive kan praten. Laten we snel het volgende commando uitvoeren om je vijf meest recente Drive-bestanden te tonen:
gws drive files list --params '{"pageSize": 5}'De --params-flag accepteert een JSON-string die direct mapt naar de queryparameters van de Drive API. Hier beperkt pageSize: 5 de response tot vijf resultaten, genoeg om de connectiviteit te bevestigen zonder je hele Drive te dumpen.
Als authenticatie correct werkt, krijg je een gestructureerde JSON-response zoals deze terug:
{
  "files": [
    {
      "id": "1BxiMVs0XRA5nFMdKvBdBZjgmUUqptlbs74OgVE2upms",
      "name": "Q3 Strategy Doc",
      "mimeType": "application/vnd.google-apps.document"
    },
    ...
  ]
}
Elke response van gws is gestructureerde JSON: geen parsing, geen scraping, geen kwetsbare tekstoutput.
Als je in plaats daarvan een “403 error” ziet met vermelding van serviceusage.services.use, betekent dit dat je OAuth-gegevens naar een ander GCP-project wijzen dan dat met ingeschakelde billing. Voer de setup opnieuw uit met de juiste project-ID om alles opnieuw te koppelen:
gws auth setup --project YOUR_PROJECT_ID --loginMet bevestigde Drive-toegang zijn we klaar om de API in te schakelen en te beginnen met de Python-kant van de pijplijn.
Op dit punt kan gws authenticeren tegen je GCP-project, maar het kan nog geen Drive-bestandsinhoud lezen. GCP scheidt authenticatie (bewijzen wie je bent) van API-activatie (aangeven welke services je project gebruikt). Zelfs met geldige OAuth-gegevens retourneert elke poging om bestandsinhoud op te halen een 403 accessNotConfigured-fout totdat de Drive API expliciet op het project is ingeschakeld.
Om dit in te schakelen, open je deze URL in een browser en vervang je [PROJECT_ID] door je echte project-ID en klik je op Enable:
https://console.developers.google.com/apis/api/drive.googleapis.com/overview?project=[PROJECT_ID]
Als alternatief, als je de gcloud-CLI hebt geïnstalleerd, kun je dit rechtstreeks vanuit de terminal inschakelen:
gcloud services enable drive.googleapis.com --project YOUR_PROJECT_IDBeide methoden doen hetzelfde. Het uitvoeren op een al ingeschakelde API is veilig omdat de bewerking idempotent is en geen bestaande configuratie reset.
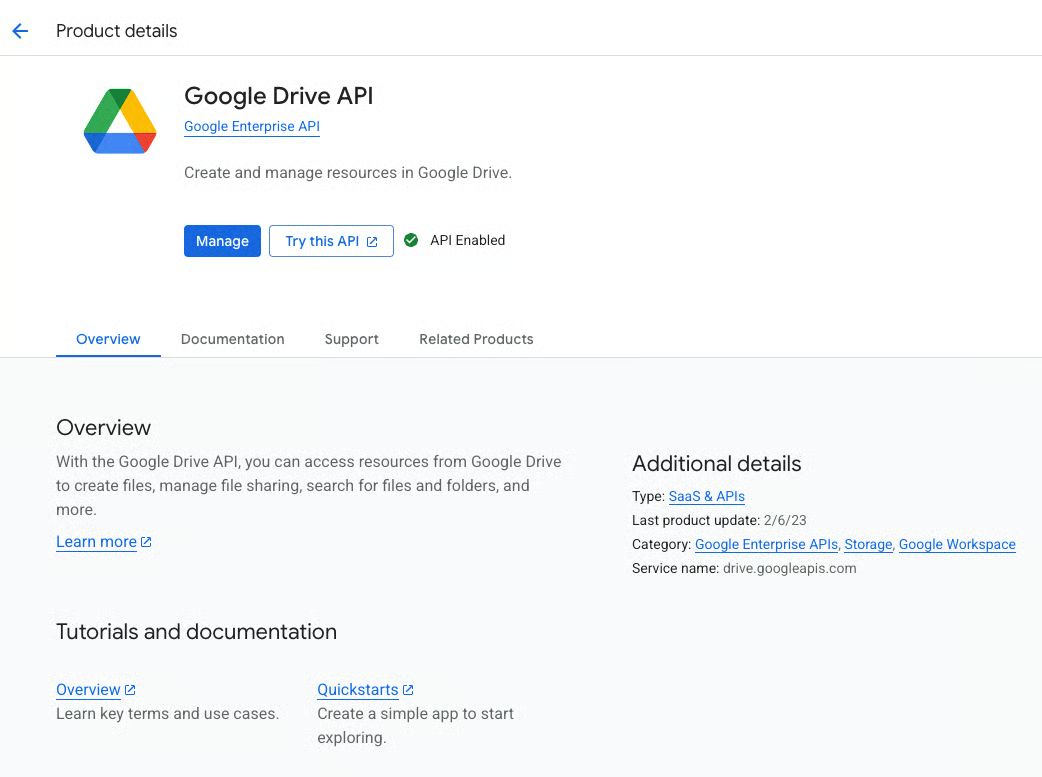
Zodra dit is ingeschakeld, kan GCP een paar seconden nodig hebben om de wijziging te propageren. Als je meteen gws drive files list uitvoert en nog steeds een 403 ziet, wacht dan 30 seconden en probeer opnieuw.
Nu de CLI-kant volledig is geconfigureerd, kunnen we de Python-omgeving opzetten die de embedding- en retrievallogica afhandelt. De RAG-pijplijn is bewust lichtgewicht met vier packages, geen GPU vereist, en alle embedding gebeurt lokaal op je machine.
Begin met het aanmaken van een virtuele omgeving door de volgende commando’s één voor één uit te voeren:
cd /path/to/your/project
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
pip install -r requirements.txt
Installeer daarna de dependencies uit requirements.txt:
.txt
chromadb==1.5.5
google-genai==1.70.0
langchain-text-splitters==1.1.1
sentence-transformers==5.3.0
Dit is wat elk package bijdraagt aan de pijplijn:
chromadb: Dit is de lokale vectordatabase die documentembeddings op schijf opslaat in ./chroma_db en ze bij volgende runs laadt, zodat de app geen bestanden opnieuw hoeft te embedden die al zijn verwerkt.
google-genai: Dit is een officiële Python-SDK voor Gemini. De app gebruikt deze om de opgehaalde context en gebruikersvraag naar Gemini 2.5 Flash te sturen en de response token-voor-token te streamen.
langchain-text-splitters: Deze package levert de RecursiveCharacterTextSplitter, die grote documenten in overlappende chunks breekt voordat er ge-embed wordt. De overlap zorgt dat zinnen op chunkgrenzen niet losraken van hun context.
sentence-transformers: De sentence transformers draait het embeddingmodel lokaal via ChromaDB’s DefaultEmbeddingFunction. Dus elke documentchunk wordt op je machine ge-embed zonder externe API-calls.
Opmerking: Het embeddingmodel (~90MB) wordt bij eerste gebruik automatisch gedownload en lokaal gecached.
Met de Python-omgeving klaar is het laatste stuk vóór het schrijven van code het ophalen van je Gemini API-sleutel.
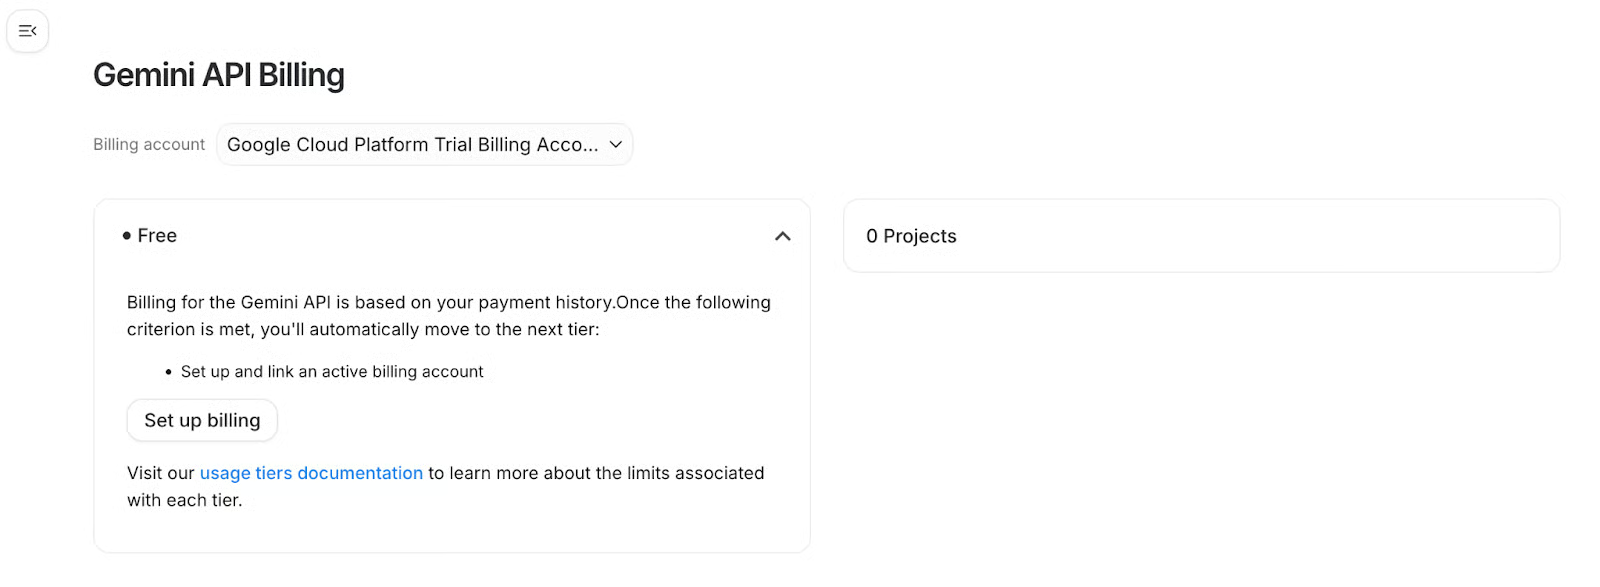
De RAG-pijplijn gebruikt Gemini als de laag voor het genereren van antwoorden, omdat het de opgehaalde documentchunks en de vraag van de gebruiker neemt en een onderbouwde response terugstreamt. Om verbinding te maken met Gemini, heb je een API-sleutel nodig van Google AI Studio.
Log in met je Google-account en klik op Get API Key, selecteer vervolgens Create API Key. Selecteer je GCP-project wanneer hierom wordt gevraagd, zodat quota en billing. Koppel een factureringsaccount in het GCP-dashboard onder Billing en selecteer daarna Link a billing account.
Zodra je je sleutel hebt, exporteer je deze als omgevingsvariabele:
Exporteer de sleutel in je terminal:
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"Om dit te behouden over terminalsessies heen, voer uit:
echo 'export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"' >> ~/.zshrc
source ~/.zshrc
De app leest deze sleutel via os.getenv("GEMINI_API_KEY") bij het opstarten. Als de variabele niet is ingesteld, vraagt de app je om de sleutel interactief te plakken.
Modelopmerking: De app gebruikt standaard gemini-2.5-flash. Je kunt dit overschrijven door GEMINI_MODEL="gemini-2.5-pro" te exporteren als je sterkere redenering wilt op complexe documenten. Let op: gemini-2.0-flash is uitgefaseerd voor nieuwe API-sleutels, gebruik die hier dus niet.
Met auth, de Drive API, dependencies en de Gemini-sleutel op hun plek hebben we alles wat we nodig hebben. Laten we de pijplijn bouwen.
Laten we nu alles aan elkaar knopen. We werken met vier bestanden: fetcher.py, vector_store.py, main.py en requirements.txt. Elk bestand heeft één verantwoordelijkheid: fetcher.py handelt alle CLI-interactie af, vector_store.py beheert embedding en retrieval, en main.py orchestreert de volledige lus van ingest tot streaming chat.
Bij de eerste run haalt gws je Drive-bestanden op, wordt de inhoud in stukken gehakt en lokaal ge-embed, en wordt de vectorindex naar ./chroma_db op schijf geschreven. Bij volgende runs laadt ChromaDB vanaf schijf, worden alleen nieuwe bestanden opgehaald en ge-embed, en start de chatlus direct zonder iets opnieuw te verwerken.
Laten we elk bestand doornemen.
fetcher.py — Toegang tot Drive via gwsDeze module is de brug tussen de gws-CLI en Python. Alle Drive-interacties zoals bestanden opvragen, content exporteren en auth controleren verlopen via subprocess-calls naar gws, en de gestructureerde JSON-output wordt geparsed naar Python-dicts. Het resultaat is dat de Python-code nooit direct met OAuth-tokens, HTTP-clients of API-responseschema’s hoeft te werken; gws handelt dat allemaal af en geeft schone JSON terug.
def _gws_json_stdout(stdout: str) -> str:
    if not stdout or "{" not in stdout:
        return stdout or ""
    return stdout[stdout.find("{"):]
De helper _gws_json_stdout behandelt een subtiel probleem waarbij gws soms keyring- of loggingregels uitstoot vóór de JSON-payload. Hier zou direct json.loads(result.stdout) aanroepen mislukken; dit stript alles vóór de eerste {.
def check_auth() -> bool:
    cmd = ["gws", "drive", "about", "get", "--params", '{"fields": "user"}']
    result = subprocess.run(cmd, capture_output=True, text=True)
    payload = _gws_json_stdout(result.stdout)
    try:
        data = json.loads(payload) if payload.strip() else {}
    except json.JSONDecodeError:
        print("Error checking authentication status (could not parse gws output).")
        return False
    if "error" in data or result.returncode != 0:
        handle_error_output(result.stdout, result.stderr)
        return False
    return True
De functie check_auth() wordt bij startup in main.py aangeroepen, doet een lichte Drive API-call en inspecteert de response. Als auth stuk is of scopes ontbreken, stopt de app netjes voordat ‘ie aan ingest begint.
De error handler vangt ook specifieke faalmodi en print acties die je kunt ondernemen:
def handle_error_output(stdout, stderr):
    output = _gws_json_stdout(stdout or "") or (stderr or "")
    if "insufficientPermissions" in output or "unauthenticated" in output.lower():
        print("Please run: gws auth login -s drive")
    elif "serviceusage.services.use" in output or "serviceUsageConsumer" in output:
        print(
            "GCP quota project error: run gws auth setup --project YOUR_PROJECT_ID --login"
        )
    else:
        print(f"API Error: {output}")
De documentlijst-ophaler richt zich alleen op MIME-types die als tekst exporteerbaar zijn:
def fetch_document_list(limit=10) -> list[dict]:
    q = (
        "(mimeType='text/plain' or mimeType='application/vnd.google-apps.document' "
        "or mimeType='application/vnd.google-apps.spreadsheet') and trashed=false"
    )
    cmd = [
        "gws", "drive", "files", "list",
        "--params",
        json.dumps({"q": q, "pageSize": limit, "orderBy": "modifiedTime desc"}),
    ]
De query filtert op platte tekst, Google Docs en Google Sheets, elk gesorteerd op meest recent gewijzigd. Binaire bestanden (pdf’s, afbeeldingen) worden uitgesloten omdat die via deze aanpak niet netjes als tekst kunnen worden geëxporteerd.
Het downloaden wordt echter per MIME-type anders afgehandeld:
def download_document(file_id: str, mime_type: str) -> str:
    fd, out_path = tempfile.mkstemp(prefix="gws_", suffix=".bin")
    os.close(fd)
    try:
        if mime_type == "application/vnd.google-apps.document":
            cmd = ["gws", "drive", "files", "export",
                   "--params", json.dumps({"fileId": file_id, "mimeType": "text/plain"}),
                   "-o", out_path]
        elif mime_type == "application/vnd.google-apps.spreadsheet":
            cmd = ["gws", "drive", "files", "export",
                   "--params", json.dumps({"fileId": file_id, "mimeType": "text/csv"}),
                   "-o", out_path]
        else:
            cmd = ["gws", "drive", "files", "get",
                   "--params", json.dumps({"fileId": file_id, "alt": "media"}),
                   "-o", out_path]
        ...
        with open(out_path, "rb") as f:
            return f.read().decode("utf-8", errors="replace")
    finally:
        os.unlink(out_path)
De gws schrijft geëxporteerde bestandsbytes naar schijf via -o, niet naar stdout. Stdout bevat JSON-metadata. De code gebruikt een tijdelijk bestand om binaire output op te vangen, leest het en ruimt op in een finally-blok, zodat tempbestanden altijd worden verwijderd, zelfs bij fouten.
vector_store.py — Lokale embeddings met ChromaDBDeze module hakt inkomende tekst in stukken, genereert lokaal embeddings met Sentence Transformers, slaat ze op schijf op via ChromaDB en biedt een eenvoudige query()-methode die de chatlus bij elke gebruikersvraag aanroept.
class VectorStore:
    def __init__(self, persist_directory="./chroma_db"):
        self.client = chromadb.PersistentClient(path=persist_directory)
        self.collection = self.client.get_or_create_collection(
            name="drive_documents",
            embedding_function=embedding_functions.DefaultEmbeddingFunction()
        )
        self.text_splitter = RecursiveCharacterTextSplitter(
            chunk_size=1000,
            chunk_overlap=200
        )
PersistentClient schrijft de vectorindex naar ./chroma_db en laadt deze bij volgende runs, zonder her-ingest nodig, tenzij je de directory verwijdert. De DefaultEmbeddingFunction gebruikt Sentence Transformers lokaal, waarbij embeddings op je eigen machine worden berekend tegen nul marginale kosten.
De splitter gebruikt chunk_size=1000 met chunk_overlap=200, zodat de overlap context op chunkgrenzen bewaart wanneer zinnen over twee chunks vallen.
def add_document(self, file_id: str, filename: str, text: str):
    chunks = self.text_splitter.split_text(text)
    ids = [f"{file_id}_{i}" for i in range(len(chunks))]
    metadatas = [{"source": filename, "file_id": file_id} for _ in chunks]
    self.collection.upsert(documents=chunks, metadatas=metadatas, ids=ids)
    print(f"-> Added {len(chunks)} chunks for {filename}")
upsert in de bovenstaande code betekent dat het opnieuw draaien van de pijplijn op een al ingeslikt bestand chunks bijwerkt in plaats van een fout met dubbele ID te geven.
def document_exists(self, file_id: str) -> bool:
    try:
        results = self.collection.get(where={"file_id": file_id}, limit=1)
        return len(results["ids"]) > 0
    except Exception:
        return False
Deze snelle pre-check in de ingestlus van main.py voorkomt dat je bestanden opnieuw downloadt die je al hebt ge-embed, waardoor volgende runs direct zijn.
main.py — Ingest, retrieval en streaming chatHet bestand main.py draait auth-checks, bestuurt de ingestlus, initialiseert de Gemini-client en draait de interactieve chatlus. Het is bewust dun, omdat het zware werk is uitbesteed aan fetcher.py en vector_store.py.
def setup_gemini():
    api_key = os.getenv("GEMINI_API_KEY")
    if not api_key:
        print("Please enter your GEMINI_API_KEY (get one from Google AI Studio).")
        api_key = input("Key: ").strip()
    return genai.Client(api_key=api_key)
Als GEMINI_API_KEY niet is ingesteld, vraagt de app hier interactief om in plaats van te crashen. Je kunt je GEMINI_API_KEY instellen zoals we in de vorige stap deden.
def ingest_documents(store, limit=10):
    files = fetch_document_list(limit)
    for file in files:
        file_id = file.get("id")
        if store.document_exists(file_id):
            print(f"Skipping {file.get('name')} (already in vector store)...")
            continue
        content = download_document(file_id, file.get("mimeType"))
        if content:
            store.add_document(file_id, file.get("name"), content)
De check document_exists is het mechanisme voor incrementele ingest: alleen nieuwe bestanden worden per run gedownload en ge-embed. De chatlus haalt de top-3 semantisch vergelijkbare chunks op en annoteert elk met de bronbestandsnaam:
def chat_loop(model, store):
    while True:
        query = input("\nYou: ")
        results = store.query(query, n_results=3)
        documents = results.get("documents", [[]])[0]
        metadatas = results.get("metadatas", [[]])[0]
        context_parts = []
        for doc, meta in zip(documents, metadatas):
            source = meta.get("source", "Unknown")
            context_parts.append(f"Source: {source}\nText:\n{doc}\n")
        full_context = "\n---\n".join(context_parts)
        prompt = f"""You are a helpful assistant. Answer the user's question based ONLY on the following context from their Google Drive. If you cannot answer from the context, say \"I don't know based on your documents.\""
Context:
{full_context}
Question: {query}
"""
        model_name = os.getenv("GEMINI_MODEL", "gemini-2.5-flash")
        response = model.models.generate_content_stream(model=model_name, contents=prompt)
        for chunk in response:
            if chunk.text:
                print(chunk.text, end="", flush=True)
        print()
De bovenstaande prompt is strikt ‘grounded’: het LLM krijgt de instructie om alleen op basis van de meegeleverde context te antwoorden en "I don't know" te zeggen als het antwoord daar niet in staat. Dit voorkomt hallucinaties van informatie die niet in je Drive staat. Responses streamen token-voor-token via generate_content_stream, dus output verschijnt direct.
Met alle vier de bestanden op hun plek start je de app met:
python main.pyBij de eerste run controleert de app auth, initialiseert ChromaDB, downloadt het embeddingmodel als het nog niet is gecached, haalt tot 10 Drive-bestanden op, embedt en slaat ze op, en zet je dan in de chatlus. Je ziet incrementele voortgang voor elk bestand dat wordt ingeslikt:
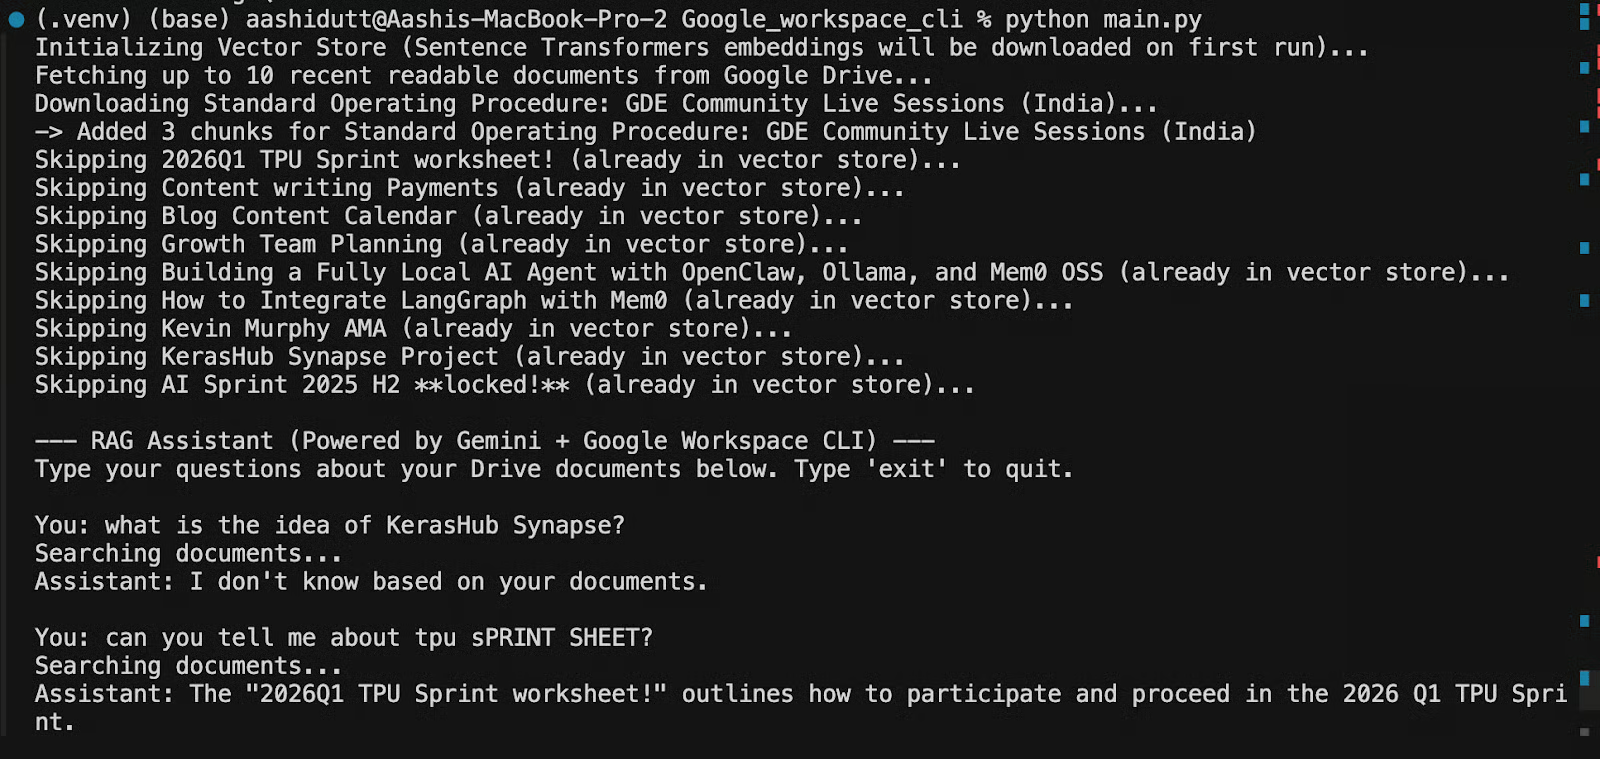
Bij volgende runs laadt ChromaDB de persistente index van schijf, worden al ingeslikte bestanden overgeslagen en kom je vrijwel direct bij de chatprompt.
Wil je echter alles opnieuw inlezen, bijvoorbeeld na het toevoegen van nieuwe Drive-bestanden die je wilt meenemen, verwijder dan de ChromaDB-directory en run opnieuw:
rm -rf ./chroma_db
python main.py
Om auth onafhankelijk te verifiëren zonder de volledige pijplijn te draaien, voer fetcher.py direct uit:
python fetcher.pyDit voert check_auth() uit en print een lijst van je Drive-bestanden om te bevestigen dat CLI, OAuth en Drive API allemaal werken voordat je aan een volledige ingest-run begint.
De RAG-assistent die we met Google Workspace CLI hebben gebouwd is bewust minimalistisch: gws haalt op, Sentence Transformers embedt lokaal, ChromaDB slaat op, Gemini streamt het antwoord. Vier bestanden, nul cloud-embeddingkosten, incrementele ingest bij elke run. De architectuur schaalt netjes als je Gmail en Calendar als extra ingest-bronnen wilt toevoegen, een groter Gemini-model wilt inzetten of de chatlus wilt vervangen door een LangGraph-agent. De basis blijft hetzelfde.
Leren met DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

