Curso
Introducción a los agentes de IA
1 h 30 min
137.2K
Google acaba de lanzar algo realmente interesante para desarrolladores: una interfaz de línea de comandos de Google Workspace que te da acceso estructurado y automatizable a todo tu Google Workspace (Drive, Gmail, Calendar, Sheets, Docs, Chat y más) en una sola herramienta.
El código está escrito casi íntegramente en Rust (99,3%), pero se distribuye vía npm como binarios nativos precompilados, así que no necesitas tener el toolchain de Rust instalado.
En este tutorial, vas a configurar Google Workspace CLI desde cero, autenticarlo y crear un asistente RAG con Gemini que te permita consultar tus archivos de Drive en lenguaje natural. Al final tendrás:
gws instalado y autenticado contra tu Drive
Un entorno virtual de Python con ChromaDB, Sentence Transformers y el SDK de Gemini
Una canalización RAG local que obtiene archivos con gws, los incrusta con un modelo local y transmite respuestas con Gemini 2.5 Flash
Nota: no es un producto oficial de Google.
La Google Workspace CLI (gws) es una herramienta de línea de comandos optimizada para IA para todo tu ecosistema de Google Workspace. Esto es lo que la hace especial:
Descubrimiento dinámico de comandos: en lugar de incluir un árbol de comandos fijo, gws lee el Discovery Service de Google en tiempo de ejecución. Cuando Google añade nuevos endpoints de API, la CLI los detecta automáticamente sin actualizar de versión.
Diseñada para agentes: la CLI incluye más de 100 habilidades de agente preconfiguradas y 50 recetas seleccionadas para flujos comunes que resumen emails, mueven archivos de Drive, crean eventos de calendario y más. Cada salida es JSON estructurado para que los LLM lo consuman directamente.
Compatibilidad nativa con servidor MCP: ejecuta gws como servidor MCP local y da a tu agente de IA acceso completo a las herramientas de Workspace sin escribir ni un solo cliente de API.
Integración con Model Armor: para agentes en producción que leen contenido controlado por usuarios, puedes canalizar las respuestas de la API por Google Cloud Model Armor para sanitizarlas contra inyección de prompts antes de que las vea tu LLM.
Puedes explorar toda la biblioteca de habilidades aquí: github.com/googleworkspace/cli/blob/main/docs/skills.md.
En este tutorial, construiremos el asistente RAG paso a paso. A alto nivel, esto es lo que hace la app:
Se autentica con tu Google Drive usando la CLI gws y obtiene tus Docs, Sheets y archivos de texto modificados más recientemente
Divide cada documento en fragmentos y los incrusta localmente con Sentence Transformers vía ChromaDB
Persiste el índice vectorial en disco para que las siguientes ejecuciones omitan los archivos ya ingeridos y pasen directamente al chat
Acepta una pregunta en lenguaje natural, recupera los 3 fragmentos más relevantes desde ChromaDB y construye un prompt con contexto fundamentado
Transmite en tu terminal una respuesta con citas y basada solo en el contexto desde Gemini 2.5 Flash, token a token
Vamos a construirlo paso a paso.
Código completo del tutorial: https://github.com/AashiDutt/Google-Workspace-CLI-Demo
La CLI se distribuye como un paquete de npm que envuelve binarios de Rust precompilados. No necesitas toolchain de Rust.
npm install -g @googleworkspace/cliVerifica la instalación ejecutando estos comandos uno a uno:
gws --version
which gws
Si gws no aparece tras la instalación, asegúrate de que el directorio bin de npm global está en tu PATH.
La CLI se autentica mediante el cliente OAuth de un proyecto de GCP, así que necesitas uno antes de iniciar sesión. Para crear o seleccionar un proyecto en GCP:
Configura las credenciales de OAuth:
Ve a APIs y servicios y selecciona Credenciales
Haz clic en Crear credenciales y selecciona ID de cliente de OAuth 2.0
Elige Aplicación de escritorio como tipo de aplicación
Anota el Client ID y el Client Secret que usaremos con gws auth setup.
La CLI completa OAuth arrancando un servidor localhost temporal. Los clientes de app de escritorio gestionan automáticamente puertos localhost arbitrarios. Los clientes de aplicación web requieren que añadas manualmente cada http://localhost:PORT a la lista de URIs de redirección autorizadas.
Si usas un cliente de aplicación web y ves "Access blocked: This app's request is invalid", ve a Credenciales, haz clic en el cliente OAuth, luego en URIs de redirección autorizadas y añade la URL exacta http://localhost:PORT mostrada en el error.
Para conectar gws con tu proyecto de GCP, primero exporta tus credenciales OAuth como variables de entorno para que el asistente de configuración las detecte automáticamente:
export GOOGLE_WORKSPACE_CLI_CLIENT_ID="CLIENT_ID"
export GOOGLE_WORKSPACE_CLI_CLIENT_SECRET="CLIENT_SECRET"
Luego ejecuta:
gws auth setup --project YOUR_PROJECT_ID --login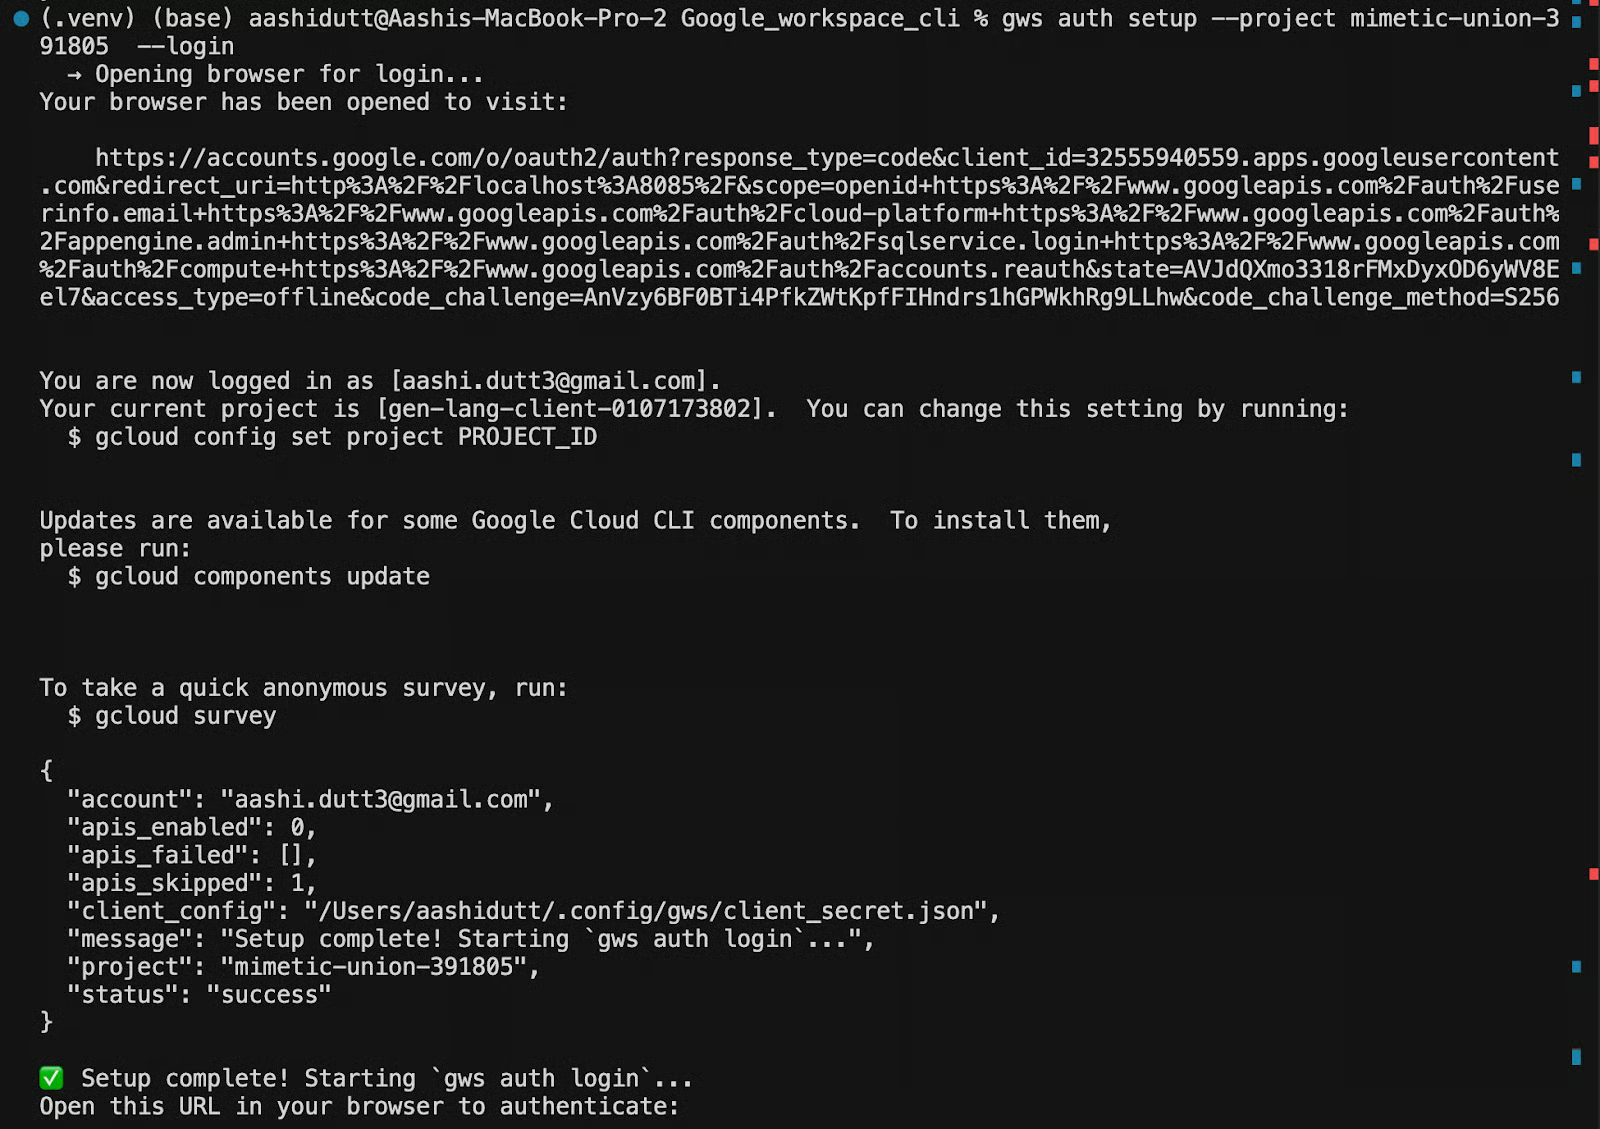
El asistente de configuración hará lo siguiente:
Al terminar, verás: ¡Configuración completada!
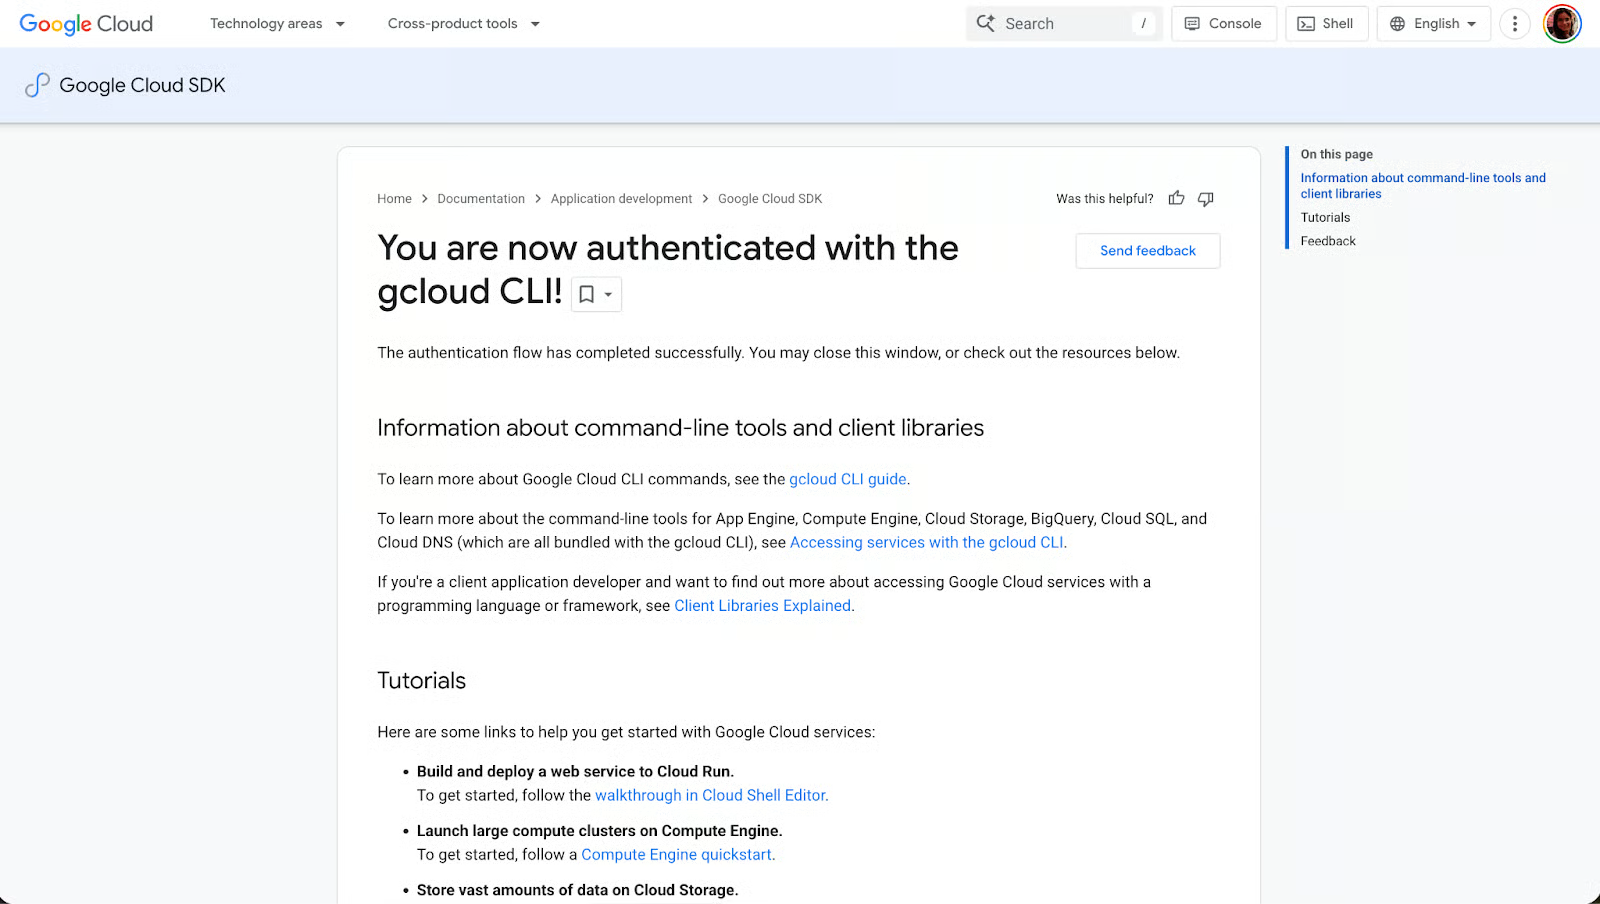
Las credenciales se guardan en ~/.config/gws/. Para confirmar que todo está bien conectado, ejecuta:
gws auth statusEsto imprime la cuenta autenticada, el proyecto de GCP vinculado y los ámbitos activos. Si algo no cuadra, vuelve a ejecutar gws auth setup con las banderas correctas en lugar de editar a mano los archivos de configuración.
Antes de escribir nada en Python, conviene hacer una comprobación rápida desde el terminal para confirmar que la CLI está autenticada y puede hablar con tu Drive. Ejecuta este comando para listar tus cinco archivos más recientes de Drive:
gws drive files list --params '{"pageSize": 5}'La bandera --params acepta una cadena JSON que mapea directamente a los parámetros de consulta de la API de Drive. Aquí, pageSize: 5 limita la respuesta a cinco resultados, suficiente para confirmar la conectividad sin volcar todo tu Drive.
Si la autenticación funciona, obtendrás una respuesta JSON estructurada como esta:
{
  "files": [
    {
      "id": "1BxiMVs0XRA5nFMdKvBdBZjgmUUqptlbs74OgVE2upms",
      "name": "Q3 Strategy Doc",
      "mimeType": "application/vnd.google-apps.document"
    },
    ...
  ]
}
Todas las respuestas de gws son JSON estructurado: sin parsing manual, sin scraping, sin salidas de texto frágiles.
Si en su lugar ves un “error 403” mencionando serviceusage.services.use, significa que tus credenciales OAuth apuntan a un proyecto de GCP distinto del que tiene la facturación habilitada. Repite la configuración con el ID de proyecto correcto para volver a vincular todo:
gws auth setup --project YOUR_PROJECT_ID --loginCon el acceso a Drive confirmado, ya podemos habilitar la API y empezar a construir la parte en Python de la canalización.
A estas alturas, gws puede autenticarse contra tu proyecto de GCP, pero aún no puede leer el contenido de los archivos de Drive. GCP separa la autenticación (probar quién eres) de la activación de APIs (declarar qué servicios usa tu proyecto). Incluso con credenciales OAuth válidas, cualquier intento de obtener contenido devolverá un 403 accessNotConfigured hasta que habilites explícitamente la API de Drive en el proyecto.
Para habilitarla, abre esta URL en el navegador, reemplaza [PROJECT_ID] por tu ID real de proyecto y haz clic en Enable:
https://console.developers.google.com/apis/api/drive.googleapis.com/overview?project=[PROJECT_ID]
De forma alternativa, si tienes instalada la CLI de gcloud, puedes habilitarla directamente desde el terminal:
gcloud services enable drive.googleapis.com --project YOUR_PROJECT_IDAmbos métodos hacen lo mismo. Ejecutarlos sobre una API ya habilitada es seguro porque la operación es idempotente y no restablece ninguna configuración existente.
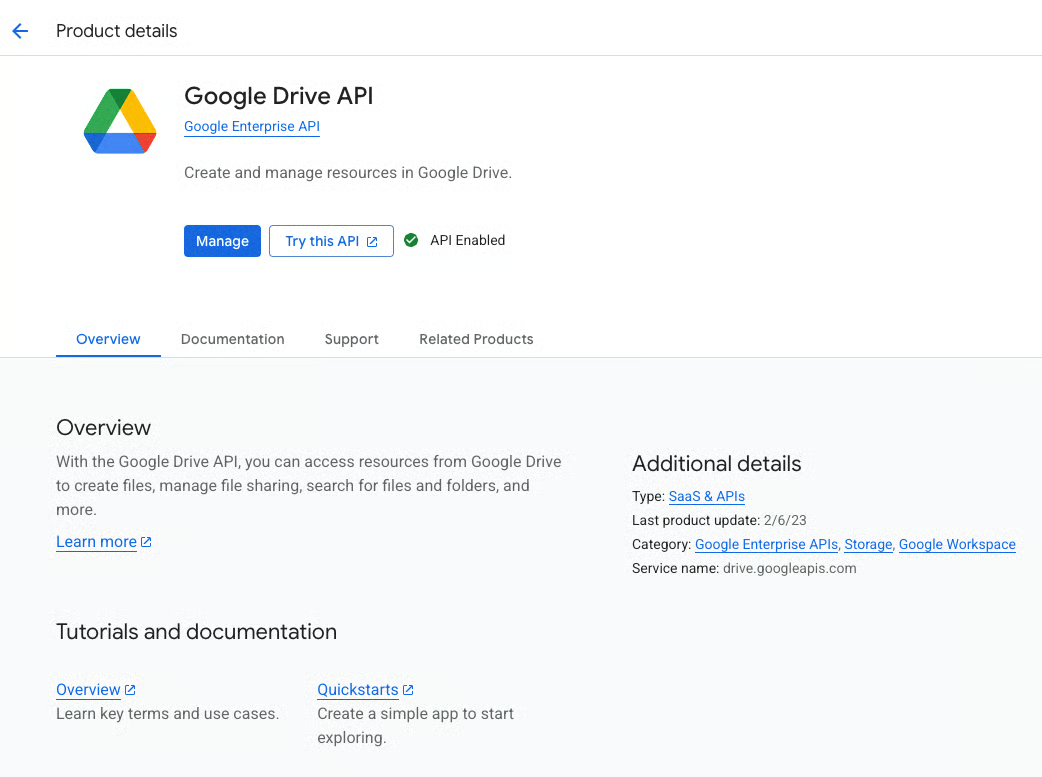
Una vez habilitada, GCP puede tardar unos segundos en propagar el cambio. Si ejecutas inmediatamente gws drive files list y aún ves un 403, espera 30 segundos y vuelve a intentarlo.
Con la parte de la CLI configurada, ahora podemos preparar el entorno de Python que gestiona la lógica de incrustación y recuperación. La canalización RAG es deliberadamente ligera: cuatro paquetes, sin GPU y todas las incrustaciones se hacen localmente en tu máquina.
Empieza creando un entorno virtual ejecutando estos comandos uno a uno:
cd /path/to/your/project
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
pip install -r requirements.txt
Luego instala las dependencias desde requirements.txt:
.txt
chromadb==1.5.5
google-genai==1.70.0
langchain-text-splitters==1.1.1
sentence-transformers==5.3.0
Esto es lo que aporta cada paquete a la canalización:
chromadb: base de datos vectorial local que guarda las incrustaciones en ./chroma_db en disco y las carga en ejecuciones posteriores, así la app no necesita re-incrustar archivos ya procesados.
google-genai: SDK oficial de Python para Gemini. La app lo usa para enviar el contexto recuperado y la pregunta del usuario a Gemini 2.5 Flash, transmitiendo la respuesta de vuelta token a token.
langchain-text-splitters: proporciona RecursiveCharacterTextSplitter, que divide documentos grandes en fragmentos solapados antes de incrustar. El solapamiento evita que se pierda contexto en los límites de fragmento.
sentence-transformers: ejecuta el modelo de incrustación localmente vía la DefaultEmbeddingFunction de ChromaDB. Así, cada fragmento se incrusta en tu máquina, sin llamadas a APIs externas.
Nota: el modelo de incrustación (~90 MB) se descarga automáticamente la primera vez y se guarda en caché localmente.
Con el entorno de Python listo, el último paso antes de escribir código es obtener tu clave de la API de Gemini.
La canalización RAG usa Gemini como capa de generación de respuestas: toma los fragmentos recuperados y la pregunta del usuario, y devuelve una respuesta fundamentada. Para conectarte a Gemini, necesitas una clave de API de Google AI Studio.
Inicia sesión con tu cuenta de Google, haz clic en Get API Key y luego en Create API Key. Selecciona tu proyecto de GCP cuando se te pida para aplicar cuota y facturación. Vincula una cuenta de facturación en el panel de GCP, en Billing, y selecciona Link a billing account.
Cuando tengas tu clave, expórtala como variable de entorno:
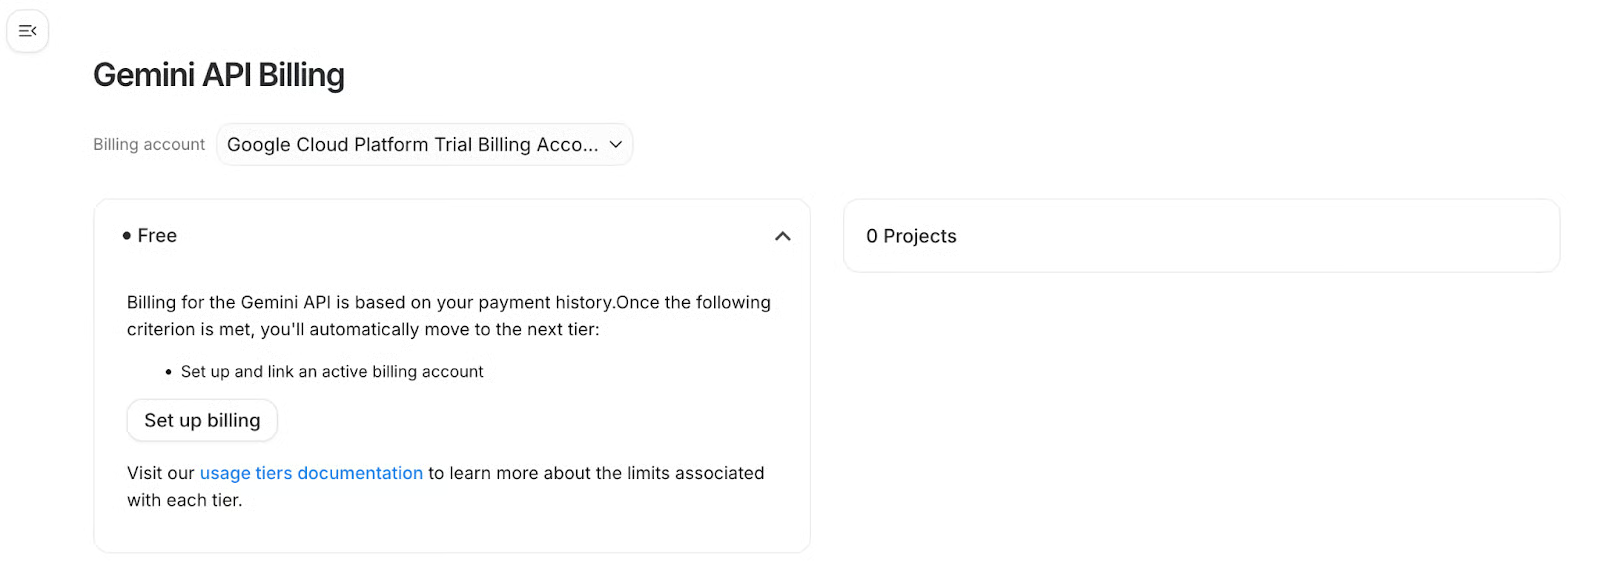
Expórtala en tu terminal:
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"Para que persista entre sesiones, ejecuta:
echo 'export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"' >> ~/.zshrc
source ~/.zshrc
La app lee esta clave con os.getenv("GEMINI_API_KEY") al inicio. Si la variable no está definida, te pedirá la clave de forma interactiva.
Nota de modelo: la app usa por defecto gemini-2.5-flash. Puedes cambiarlo exportando GEMINI_MODEL="gemini-2.5-pro" si necesitas más capacidad de razonamiento con documentos complejos. Ten en cuenta que gemini-2.0-flash se ha retirado para nuevas claves de API, así que no lo uses aquí.
Con la autenticación, la API de Drive, las dependencias y la clave de Gemini listas, tenemos todo lo necesario. Construyamos la canalización.
Ahora vamos a conectarlo todo. Trabajaremos con cuatro archivos: fetcher.py, vector_store.py, main.py y requirements.txt. Cada archivo tiene una responsabilidad única: fetcher.py gestiona toda la interacción con la CLI, vector_store.py se encarga de las incrustaciones y la recuperación, y main.py orquesta el ciclo completo desde la ingesta hasta el chat en streaming.
En la primera ejecución, gws obtiene tus archivos de Drive, el contenido se fragmenta e incrusta localmente, y el índice vectorial se escribe en ./chroma_db en disco. En ejecuciones posteriores, ChromaDB carga desde disco, solo se obtienen e incrustan archivos nuevos y el bucle de chat arranca al instante sin reprocesar nada.
Veamos cada archivo.
fetcher.py — Acceso a Drive con gwsEste módulo es el puente entre la CLI gws y Python. Todas las interacciones con Drive —listar archivos, exportar contenido y comprobar la autenticación— se hacen mediante llamadas de subprocess a gws, y la salida JSON estructurada se parsea a diccionarios de Python. Así el código en Python nunca gestiona tokens OAuth, clientes HTTP ni esquemas de respuesta de API; gws se encarga de todo y devuelve JSON limpio.
def _gws_json_stdout(stdout: str) -> str:
    if not stdout or "{" not in stdout:
        return stdout or ""
    return stdout[stdout.find("{"):]
El helper _gws_json_stdout gestiona un caso sutil en el que gws a veces emite líneas de keyring o logging antes de la carga útil JSON. Aquí, llamar a json.loads(result.stdout) directamente fallaría; por eso elimina todo lo anterior a la primera {.
def check_auth() -> bool:
    cmd = ["gws", "drive", "about", "get", "--params", '{"fields": "user"}']
    result = subprocess.run(cmd, capture_output=True, text=True)
    payload = _gws_json_stdout(result.stdout)
    try:
        data = json.loads(payload) if payload.strip() else {}
    except json.JSONDecodeError:
        print("Error checking authentication status (could not parse gws output).")
        return False
    if "error" in data or result.returncode != 0:
        handle_error_output(result.stdout, result.stderr)
        return False
    return True
La función check_auth() se llama al inicio en main.py: hace una llamada ligera a la API de Drive e inspecciona la respuesta. Si la autenticación está rota o faltan ámbitos, la app sale limpiamente antes de intentar la ingesta.
El gestor de errores también detecta fallos específicos e imprime mensajes accionables:
def handle_error_output(stdout, stderr):
    output = _gws_json_stdout(stdout or "") or (stderr or "")
    if "insufficientPermissions" in output or "unauthenticated" in output.lower():
        print("Please run: gws auth login -s drive")
    elif "serviceusage.services.use" in output or "serviceUsageConsumer" in output:
        print(
            "GCP quota project error: run gws auth setup --project YOUR_PROJECT_ID --login"
        )
    else:
        print(f"API Error: {output}")
El recolector de la lista de documentos apunta solo a tipos MIME exportables como texto:
def fetch_document_list(limit=10) -> list[dict]:
    q = (
        "(mimeType='text/plain' or mimeType='application/vnd.google-apps.document' "
        "or mimeType='application/vnd.google-apps.spreadsheet') and trashed=false"
    )
    cmd = [
        "gws", "drive", "files", "list",
        "--params",
        json.dumps({"q": q, "pageSize": limit, "orderBy": "modifiedTime desc"}),
    ]
La consulta filtra a texto plano, Google Docs y Google Sheets, ordenados por última modificación. Se excluyen binarios (PDF, imágenes) porque no se pueden exportar limpiamente a texto con este enfoque.
Sin embargo, la descarga se gestiona de forma distinta según el tipo MIME:
def download_document(file_id: str, mime_type: str) -> str:
    fd, out_path = tempfile.mkstemp(prefix="gws_", suffix=".bin")
    os.close(fd)
    try:
        if mime_type == "application/vnd.google-apps.document":
            cmd = ["gws", "drive", "files", "export",
                   "--params", json.dumps({"fileId": file_id, "mimeType": "text/plain"}),
                   "-o", out_path]
        elif mime_type == "application/vnd.google-apps.spreadsheet":
            cmd = ["gws", "drive", "files", "export",
                   "--params", json.dumps({"fileId": file_id, "mimeType": "text/csv"}),
                   "-o", out_path]
        else:
            cmd = ["gws", "drive", "files", "get",
                   "--params", json.dumps({"fileId": file_id, "alt": "media"}),
                   "-o", out_path]
        ...
        with open(out_path, "rb") as f:
            return f.read().decode("utf-8", errors="replace")
    finally:
        os.unlink(out_path)
gws escribe los bytes exportados en disco con -o, no en stdout. Stdout lleva metadatos en JSON. El código usa un archivo temporal para capturar la salida binaria, la lee y limpia en un bloque finally, así los temporales siempre se eliminan incluso si hay errores.
vector_store.py — Incrustaciones locales con ChromaDBEste módulo fragmenta el texto entrante, genera incrustaciones localmente con Sentence Transformers, las persiste en disco con ChromaDB y expone un método sencillo query() que el bucle de chat llama para cada pregunta del usuario.
class VectorStore:
    def __init__(self, persist_directory="./chroma_db"):
        self.client = chromadb.PersistentClient(path=persist_directory)
        self.collection = self.client.get_or_create_collection(
            name="drive_documents",
            embedding_function=embedding_functions.DefaultEmbeddingFunction()
        )
        self.text_splitter = RecursiveCharacterTextSplitter(
            chunk_size=1000,
            chunk_overlap=200
        )
PersistentClient escribe el índice vectorial en ./chroma_db y lo carga en ejecuciones posteriores sin necesidad de reingesta, salvo que borres el directorio. La DefaultEmbeddingFunction usa Sentence Transformers localmente, así las incrustaciones se calculan en tu máquina con coste marginal cero.
El splitter usa chunk_size=1000 con chunk_overlap=200, de forma que el solapamiento preserve el contexto en los límites de fragmento cuando una frase quede dividida.
def add_document(self, file_id: str, filename: str, text: str):
    chunks = self.text_splitter.split_text(text)
    ids = [f"{file_id}_{i}" for i in range(len(chunks))]
    metadatas = [{"source": filename, "file_id": file_id} for _ in chunks]
    self.collection.upsert(documents=chunks, metadatas=metadatas, ids=ids)
    print(f"-> Added {len(chunks)} chunks for {filename}")
El upsert del fragmento anterior significa que si vuelves a ejecutar la canalización sobre un archivo ya ingerido, se actualizan los fragmentos en lugar de lanzar un error por ID duplicado.
def document_exists(self, file_id: str) -> bool:
    try:
        results = self.collection.get(where={"file_id": file_id}, limit=1)
        return len(results["ids"]) > 0
    except Exception:
        return False
Esta comprobación rápida en el bucle de ingesta de main.py evita volver a descargar archivos ya incrustados, haciendo que las siguientes ejecuciones sean instantáneas.
main.py — Ingesta, recuperación y chat en streamingEl archivo main.py ejecuta las comprobaciones de autenticación, dirige el bucle de ingesta, inicializa el cliente de Gemini y ejecuta el bucle de chat interactivo. Es deliberadamente fino porque el trabajo pesado se delega a fetcher.py y vector_store.py.
def setup_gemini():
    api_key = os.getenv("GEMINI_API_KEY")
    if not api_key:
        print("Please enter your GEMINI_API_KEY (get one from Google AI Studio).")
        api_key = input("Key: ").strip()
    return genai.Client(api_key=api_key)
Si no está definida GEMINI_API_KEY, la app te pide la clave de forma interactiva en lugar de fallar. Puedes definir GEMINI_API_KEY como hicimos en el paso anterior.
def ingest_documents(store, limit=10):
    files = fetch_document_list(limit)
    for file in files:
        file_id = file.get("id")
        if store.document_exists(file_id):
            print(f"Skipping {file.get('name')} (already in vector store)...")
            continue
        content = download_document(file_id, file.get("mimeType"))
        if content:
            store.add_document(file_id, file.get("name"), content)
La comprobación document_exists habilita la ingesta incremental: en cada ejecución solo se descargan e incrustan los archivos nuevos. El bucle de chat recupera los 3 fragmentos más similares semánticamente y anota cada uno con su archivo de origen:
def chat_loop(model, store):
    while True:
        query = input("\nYou: ")
        results = store.query(query, n_results=3)
        documents = results.get("documents", [[]])[0]
        metadatas = results.get("metadatas", [[]])[0]
        context_parts = []
        for doc, meta in zip(documents, metadatas):
            source = meta.get("source", "Unknown")
            context_parts.append(f"Source: {source}\nText:\n{doc}\n")
        full_context = "\n---\n".join(context_parts)
        prompt = f"""You are a helpful assistant. Answer the user's question based ONLY on the following context from their Google Drive. If you cannot answer from the context, say "I don't know based on your documents."
Context:
{full_context}
Question: {query}
"""
        model_name = os.getenv("GEMINI_MODEL", "gemini-2.5-flash")
        response = model.models.generate_content_stream(model=model_name, contents=prompt)
        for chunk in response:
            if chunk.text:
                print(chunk.text, end="", flush=True)
        print()
El prompt anterior está estrictamente fundamentado: se instruye al LLM a responder solo a partir del contexto proporcionado y a decir "I don't know" si la respuesta no está en tus documentos. Esto evita alucinaciones de información que no está en tu Drive. Las respuestas se transmiten token a token con generate_content_stream, así que el texto aparece al instante.
Con los cuatro archivos listos, inicia la app con:
python main.pyEn la primera ejecución, la app comprueba la autenticación, inicializa ChromaDB, descarga el modelo de incrustación si no está en caché, obtiene hasta 10 archivos de Drive, los incrusta y los guarda, y luego te deja en el bucle de chat. Verás el progreso incremental impreso para cada archivo a medida que se ingiere:
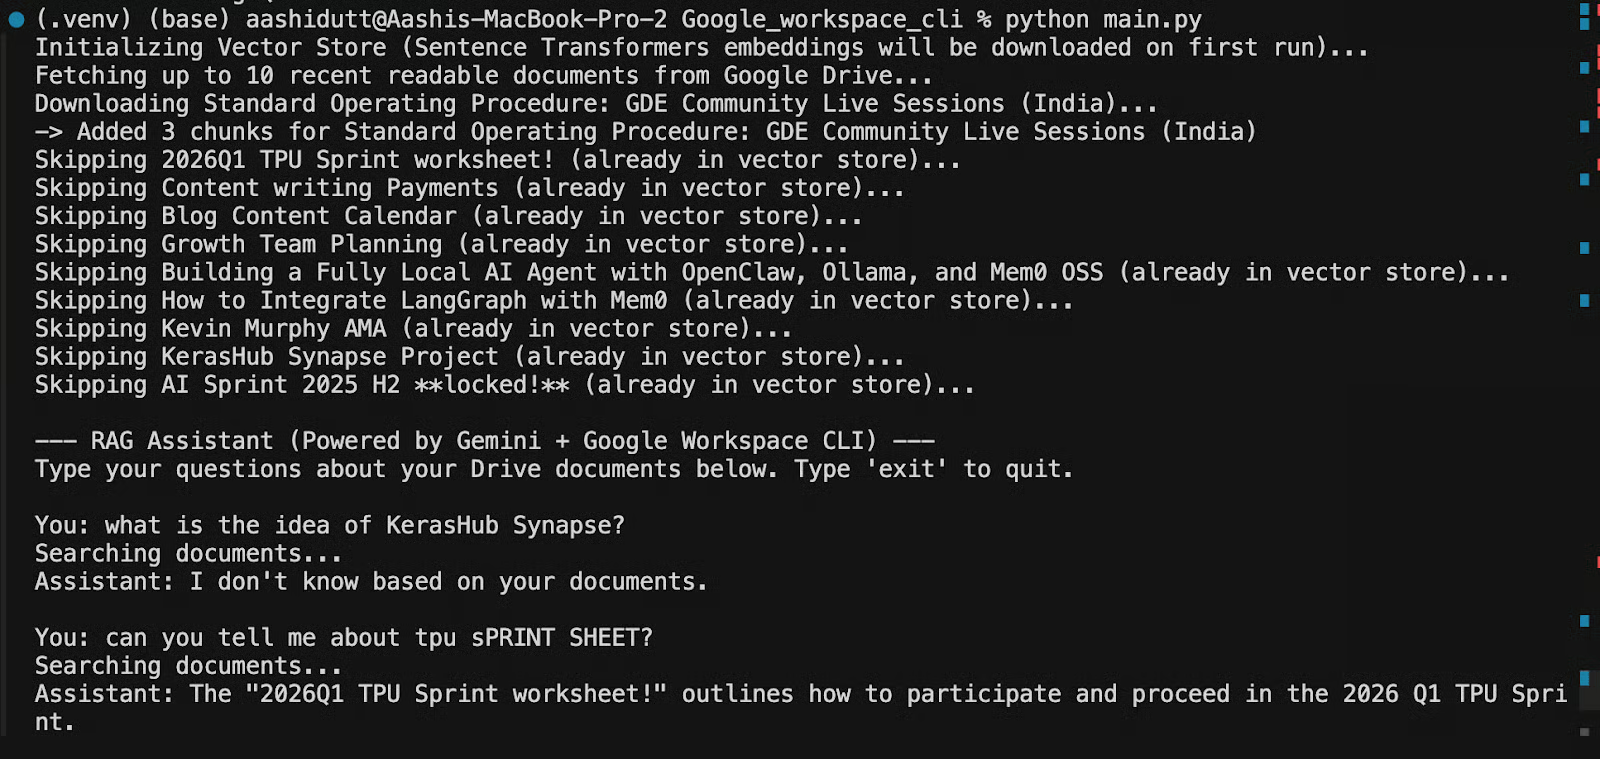
En ejecuciones posteriores, ChromaDB carga el índice persistido desde disco, se omiten los archivos ya ingeridos y llegarás al prompt de chat casi al instante.
Si quieres reingestar todo desde cero —por ejemplo, tras añadir nuevos archivos de Drive que quieras incluir—, borra el directorio de ChromaDB y vuelve a ejecutar:
rm -rf ./chroma_db
python main.py
Para verificar la autenticación de forma independiente sin ejecutar toda la canalización, ejecuta fetcher.py directamente:
python fetcher.pyEsto ejecuta check_auth() e imprime una lista de tus archivos de Drive para confirmar que la CLI, OAuth y la API de Drive funcionan antes de lanzarte a una ingesta completa.
El asistente RAG que hemos creado con Google Workspace CLI es deliberadamente minimalista: gws obtiene, Sentence Transformers incrusta localmente, ChromaDB almacena y Gemini transmite la respuesta. Cuatro archivos, cero costes de incrustación en la nube, ingesta incremental en cada ejecución. La arquitectura escala sin complicaciones si quieres añadir Gmail y Calendar como fuentes adicionales de ingesta, cambiar a un modelo Gemini más grande o sustituir el bucle de chat por un agente de LangGraph. La base no cambia.
Aprende con DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
10 min
blog
Matt Crabtree
13 min
Tutorial
Ryan Ong
12 min
Tutorial
Moez Ali
7 min
Tutorial
Zoumana Keita
14 min
Tutorial
Matt Crabtree
6 min