
Corso
Introduzione agli AI Agents
1 ore 30 min
143.7K
Google ha appena rilasciato qualcosa di davvero interessante per gli sviluppatori. Una interfaccia a riga di comando per Google Workspace che ti offre accesso strutturato e scriptabile all'intero Google Workspace, incluso Drive, Gmail, Calendar, Sheets, Docs, Chat e altro, il tutto in un unico strumento.
Il codebase è quasi interamente in Rust (99,3%), ma viene distribuito via npm come binari nativi precompilati, quindi non ti serve avere una toolchain Rust installata.
In questo tutorial imposterai la Google Workspace CLI da zero, la autenticherai e costruirai un assistente RAG basato su Gemini che ti permette di interrogare i file del tuo Drive in linguaggio naturale. Alla fine avrai:
gws installato e autenticato sul tuo Drive
Un ambiente virtuale Python con ChromaDB, Sentence Transformers e l'SDK di Gemini
Una pipeline RAG locale funzionante che recupera file tramite gws, li incorpora con un modello locale e trasmette le risposte con Gemini 2.5 Flash
Nota: questo non è un prodotto Google ufficialmente supportato.
La Google Workspace CLI (gws) è uno strumento da riga di comando ottimizzato per l'IA per l'intero ecosistema di Google Workspace. Ecco cosa la rende speciale:
Scoperta dinamica dei comandi: invece di distribuire un albero di comandi hardcoded, gws legge il Discovery Service di Google a runtime. Quando Google aggiunge nuovi endpoint API, la CLI li rileva automaticamente senza bisogno di un incremento di versione.
Design agent-native: la CLI include oltre 100 skill per agent predefinite e 50 ricette curate per flussi comuni che riassumono email, spostano file Drive, creano eventi in calendario e altro. Ogni output è JSON strutturato, così gli LLM possono consumarlo direttamente.
Supporto nativo per server MCP: esegui gws come server MCP locale e dai al tuo agente AI accesso completo agli strumenti di Workspace senza scrivere un singolo client API.
Integrazione con Model Armor: per agent in produzione che leggono contenuti controllati dagli utenti, puoi instradare le risposte API attraverso Google Cloud Model Armor per sanificarle contro la prompt injection prima che arrivino al tuo LLM.
Puoi sfogliare l'intera libreria di skill qui: github.com/googleworkspace/cli/blob/main/docs/skills.md.
In questo tutorial costruiremo l'assistente RAG passo dopo passo. A grandi linee, ecco cosa fa l'app:
Si autentica sul tuo Google Drive usando la CLI gws e recupera i tuoi Documenti, Fogli e file di testo modificati più di recente
Suddivide ogni documento in chunk e li incorpora in locale usando Sentence Transformers via ChromaDB
Memorizza l'indice vettoriale su disco così le esecuzioni successive saltano i file già ingestiti e vanno direttamente alla chat
Accetta una domanda in linguaggio naturale, recupera i 3 chunk più rilevanti da ChromaDB e costruisce un prompt contestuale fondato
Trasmette una risposta con citazioni e solo dal contesto da Gemini 2.5 Flash, token per token, direttamente nel tuo terminale
Costruiamolo passo per passo.
Codice completo del tutorial: https://github.com/AashiDutt/Google-Workspace-CLI-Demo
La CLI è distribuita come pacchetto npm che incapsula binari Rust precompilati. Non serve alcuna toolchain Rust.
npm install -g @googleworkspace/cliVerifica l'installazione eseguendo i seguenti comandi uno alla volta:
gws --version
which gws
Se gws non viene trovato dopo l'installazione, assicurati che la directory bin del tuo npm global sia nel tuo PATH.
La CLI si autentica tramite l'OAuth client di un progetto GCP, quindi te ne serve uno prima di fare login. Per creare o selezionare un progetto da GCP:
Configura le credenziali OAuth:
Vai su API e servizi e seleziona Credenziali
Clicca Crea credenziali e vai su ID client OAuth 2.0
Scegli App desktop come tipo di applicazione
Annota Client ID e Client Secret che useremo per gws auth setup.
La CLI completa l'OAuth avviando un server localhost temporaneo. I client App desktop gestiscono automaticamente porte localhost arbitrarie. I client Applicazione web richiedono di aggiungere manualmente ogni http://localhost:PORT all'elenco degli URI di reindirizzamento autorizzati.
Se usi un client Applicazione web e vedi "Accesso bloccato: la richiesta di questa app non è valida", vai su Credenziali, clicca sul client OAuth, poi su URI di reindirizzamento autorizzati e aggiungi l'URL esatto http://localhost:PORT mostrato nell'errore.
Per collegare gws al tuo progetto GCP, prima esporta le credenziali OAuth come variabili d'ambiente in modo che la procedura guidata le rilevi automaticamente:
export GOOGLE_WORKSPACE_CLI_CLIENT_ID="CLIENT_ID"
export GOOGLE_WORKSPACE_CLI_CLIENT_SECRET="CLIENT_SECRET"
Poi esegui:
gws auth setup --project YOUR_PROJECT_ID --login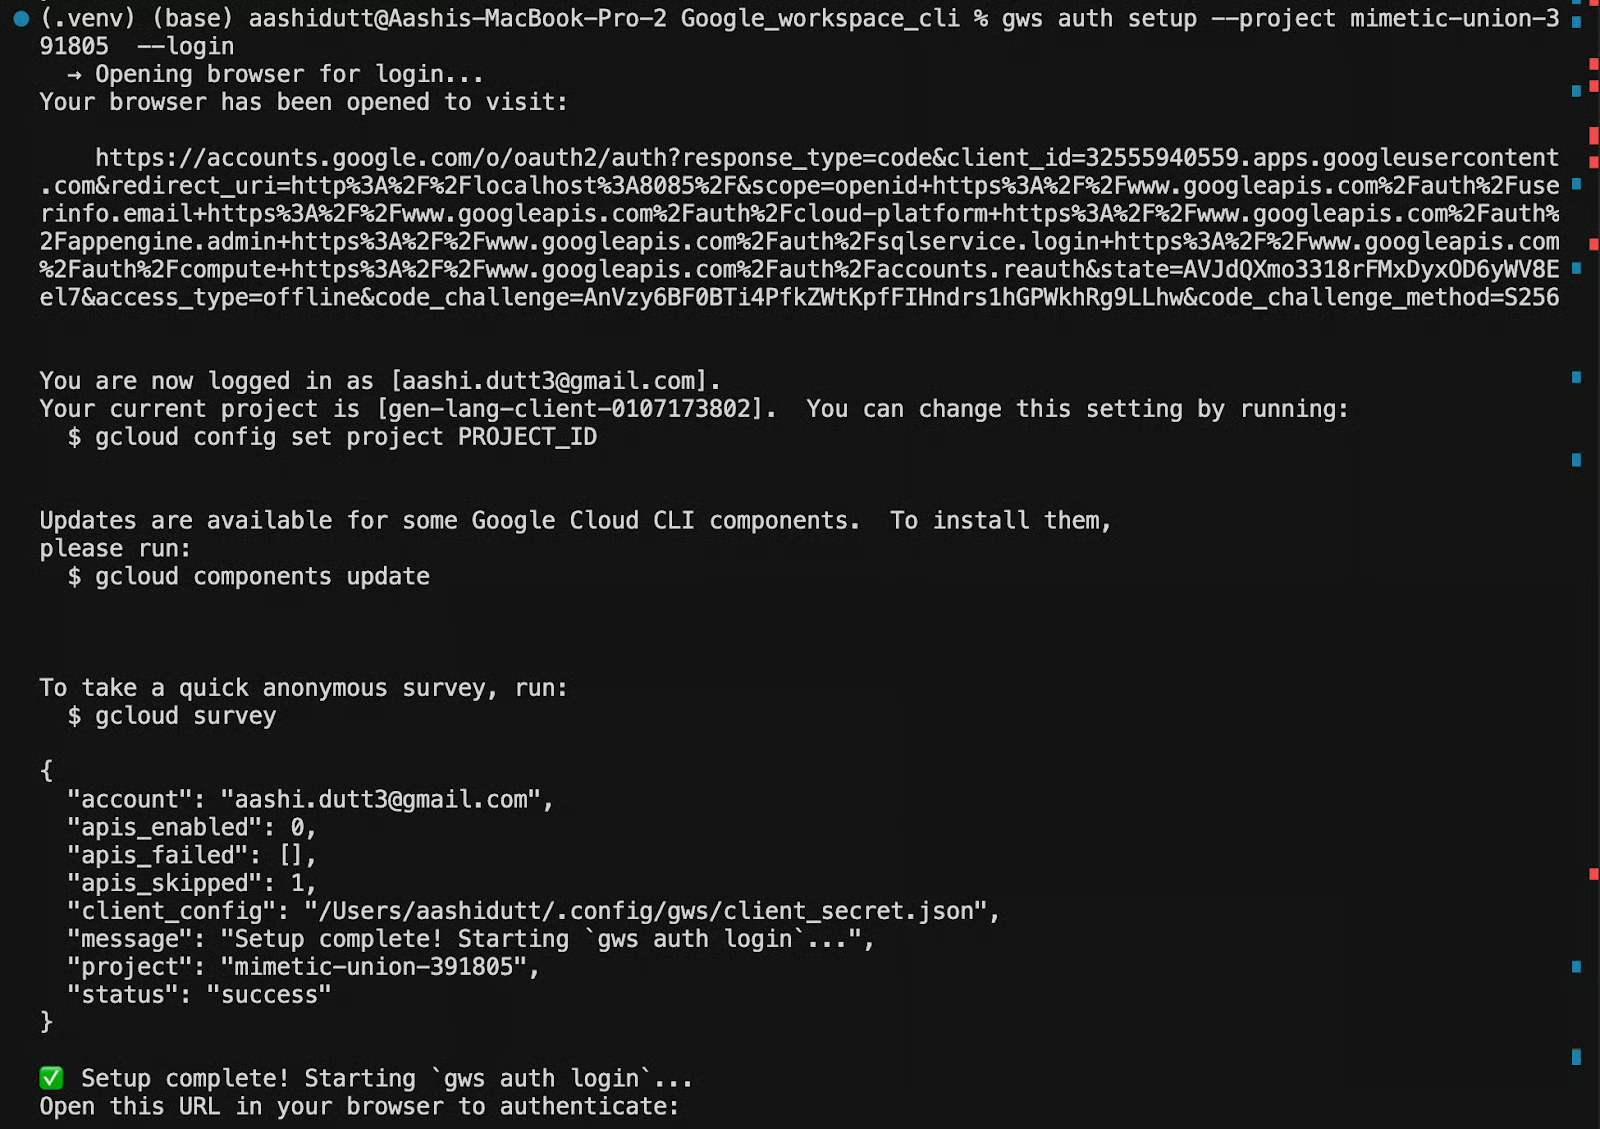
La procedura guidata:
Una volta completato, vedrai: Setup complete!
Le credenziali sono archiviate in ~/.config/gws/. Per confermare che tutto sia collegato correttamente, esegui:
gws auth statusQuesto stampa l'account autenticato, il progetto GCP collegato e gli scope attivi. Se qualcosa non torna, riesegui gws auth setup con i flag corretti invece di provare a modificare i file di configurazione manualmente.
Prima di scrivere qualsiasi Python, vale la pena fare un rapido sanity check direttamente dal terminale per confermare che la CLI sia autenticata e possa comunicare con il tuo Drive. Esegui rapidamente il seguente comando per elencare i tuoi cinque file Drive più recenti:
gws drive files list --params '{"pageSize": 5}'Il flag --params accetta una stringa JSON che mappa direttamente ai parametri di query dell'API Drive. Qui, pageSize: 5 limita la risposta a cinque risultati, sufficienti a confermare la connettività senza scaricare l'intero Drive.
Se l'autenticazione funziona correttamente, otterrai una risposta JSON strutturata come questa:
{
  "files": [
    {
      "id": "1BxiMVs0XRA5nFMdKvBdBZjgmUUqptlbs74OgVE2upms",
      "name": "Q3 Strategy Doc",
      "mimeType": "application/vnd.google-apps.document"
    },
    ...
  ]
}
Ogni risposta di gws è un JSON strutturato, senza parsing, scraping o output di testo fragile.
Se invece vedi un “errore 403” che menziona serviceusage.services.use, significa che le tue credenziali OAuth puntano a un progetto GCP diverso da quello con la fatturazione abilitata. Riesegui la configurazione con l'ID progetto corretto per ricollegare tutto:
gws auth setup --project YOUR_PROJECT_ID --loginCon l'accesso a Drive confermato, siamo pronti ad abilitare l'API e iniziare a costruire la parte Python della pipeline.
A questo punto, gws può autenticarsi con il tuo progetto GCP, ma non può ancora leggere il contenuto dei file di Drive. GCP separa l'autenticazione (dimostrare chi sei) dall'attivazione delle API (dichiarare quali servizi usa il tuo progetto). Anche con credenziali OAuth valide, qualsiasi tentativo di recuperare il contenuto dei file restituirà un errore 403 accessNotConfigured finché l'API Drive non viene esplicitamente abilitata sul progetto.
Per abilitarla, apri questo URL in un browser e sostituisci [PROJECT_ID] con il tuo ID progetto effettivo, quindi clicca Abilita:
https://console.developers.google.com/apis/api/drive.googleapis.com/overview?project=[PROJECT_ID]
In alternativa, se hai installato la CLI gcloud, puoi abilitarla direttamente dal terminale:
gcloud services enable drive.googleapis.com --project YOUR_PROJECT_IDEntrambi i metodi fanno la stessa cosa. Eseguirne uno su un'API già abilitata è sicuro perché l'operazione è idempotente e non reimposta alcuna configurazione esistente.
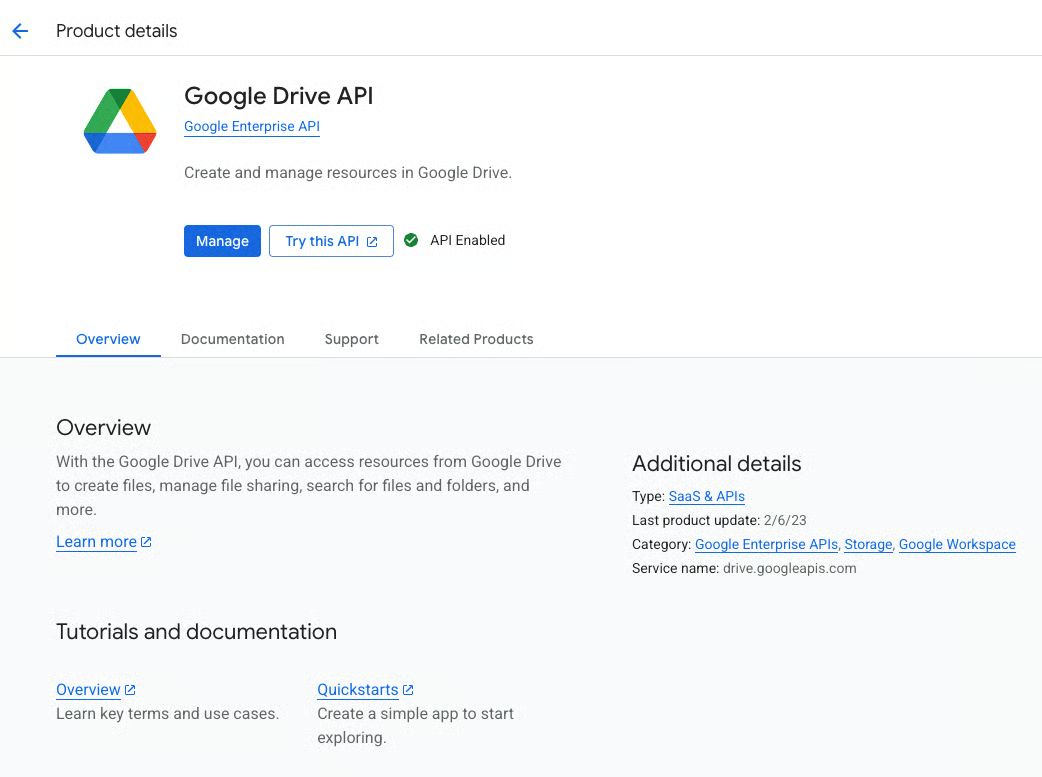
Una volta abilitata, GCP può impiegare qualche secondo per propagare la modifica. Se esegui immediatamente gws drive files list e vedi ancora un 403, attendi 30 secondi e riprova.
Con la parte CLI completamente configurata, possiamo ora impostare l'ambiente Python che gestisce la logica di embedding e retrieval. La pipeline RAG è volutamente leggera con quattro pacchetti, nessuna GPU richiesta, e tutto l'embedding avviene in locale sulla tua macchina.
Inizia creando un ambiente virtuale eseguendo i seguenti comandi uno alla volta:
cd /path/to/your/project
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
pip install -r requirements.txt
Poi installa le dipendenze da requirements.txt:
.txt
chromadb==1.5.5
google-genai==1.70.0
langchain-text-splitters==1.1.1
sentence-transformers==5.3.0
Ecco cosa apporta ciascun pacchetto alla pipeline:
chromadb: è il database vettoriale locale che archivia gli embedding dei documenti su disco in ./chroma_db e li carica nelle esecuzioni successive, così l'app non deve re-incorporare i file già elaborati.
google-genai: è un SDK Python ufficiale per Gemini. L'app lo usa per inviare il contesto recuperato e la domanda dell'utente a Gemini 2.5 Flash, trasmettendo la risposta indietro token per token.
langchain-text-splitters: questo pacchetto fornisce il RecursiveCharacterTextSplitter, che suddivide i documenti grandi in chunk sovrapposti prima dell'embedding. La sovrapposizione assicura che le frasi ai confini dei chunk non vengano separate dal loro contesto.
sentence-transformers: i sentence transformer eseguono il modello di embedding in locale tramite la DefaultEmbeddingFunction di ChromaDB. Così ogni chunk di documento viene incorporato sulla macchina senza chiamate API esterne.
Nota: il modello di embedding (~90 MB) viene scaricato automaticamente al primo utilizzo e messo in cache in locale.
Con l'ambiente Python pronto, l'ultimo pezzo prima di scrivere codice è ottenere la tua chiave API di Gemini.
La pipeline RAG usa Gemini come livello di generazione delle risposte perché prende i chunk di documento recuperati e la domanda dell'utente, e trasmette una risposta fondata. Per connetterti a Gemini, ti serve una chiave API da Google AI Studio.
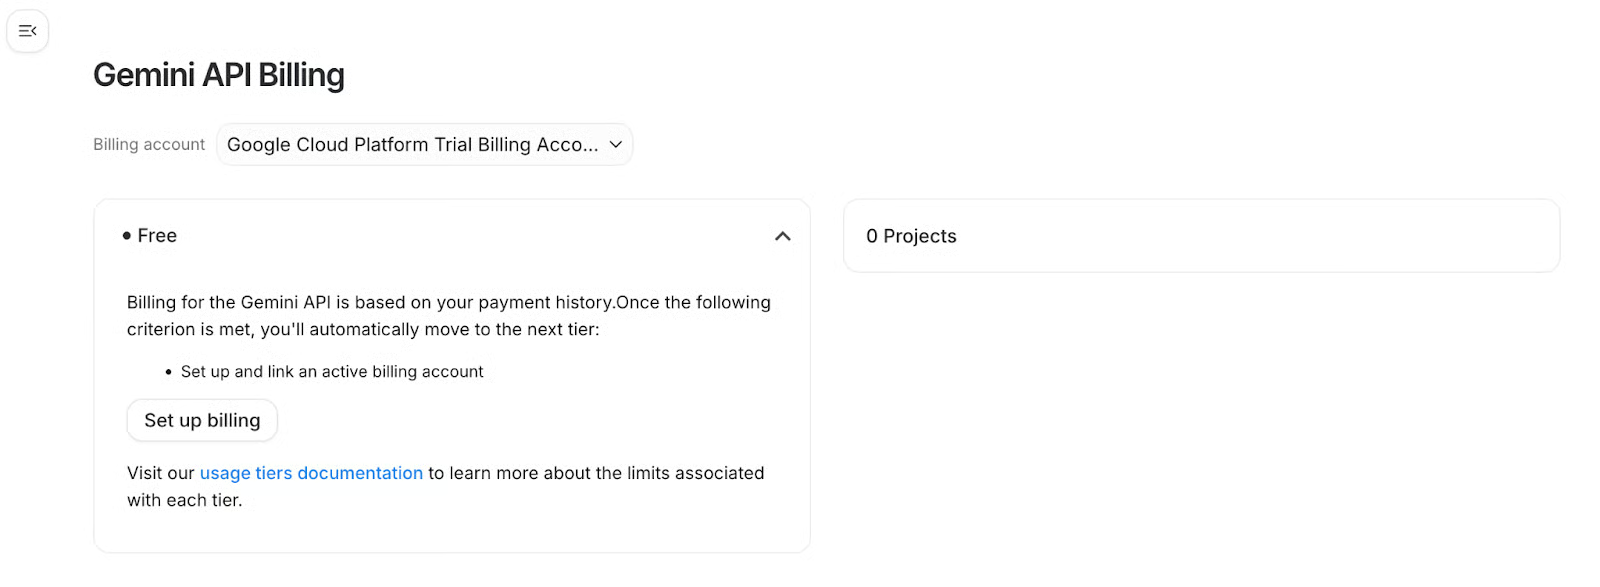
Accedi con il tuo account Google, clicca Get API Key, poi seleziona Create API Key. Seleziona il tuo progetto GCP quando richiesto così per quota e fatturazione. Collega un account di fatturazione nella dashboard GCP sotto Billing, quindi seleziona Link a billing account.
Una volta ottenuta la chiave, esportala come variabile d'ambiente:
Esporta la chiave nel tuo terminale:
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"Per mantenerla tra le sessioni del terminale, esegui:
echo 'export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"' >> ~/.zshrc
source ~/.zshrc
L'app legge questa chiave tramite os.getenv("GEMINI_API_KEY") all'avvio. Se la variabile non è impostata, ti chiederà di incollare la chiave in modo interattivo.
Nota sul modello: l'app usa di default gemini-2.5-flash. Puoi sovrascriverlo esportando GEMINI_MODEL="gemini-2.5-pro" se vuoi un ragionamento più solido su documenti complessi. Nota che gemini-2.0-flash è stato ritirato per le nuove chiavi API, quindi non usarlo qui.
Con autenticazione, Drive API, dipendenze e chiave Gemini a posto, abbiamo tutto ciò che serve. Costruiamo la pipeline.
Ora colleghiamo tutto. Lavoreremo con quattro file: fetcher.py, vector_store.py, main.py e requirements.txt. Ogni file ha una singola responsabilità: fetcher.py gestisce tutte le interazioni con la CLI, vector_store.py si occupa di embedding e retrieval, e main.py orchestra l'intero ciclo dall'ingestione alla chat in streaming.
Al primo avvio, gws recupera i tuoi file Drive, il contenuto viene suddiviso in chunk e incorporato in locale, e l'indice vettoriale viene scritto su disco in ./chroma_db. Alle esecuzioni successive, ChromaDB carica da disco, vengono recuperati e incorporati solo i file nuovi, e il loop di chat parte subito senza ri-elaborare nulla.
Vediamo ogni file.
fetcher.py — Accesso a Drive via gwsQuesto modulo è il ponte tra la CLI gws e Python. Tutte le interazioni con Drive come elencare file, esportare contenuti e verificare l'autenticazione passano tramite chiamate subprocess a gws, e l'output JSON strutturato viene analizzato in dict Python. Il risultato è che il codice Python non deve mai gestire direttamente token OAuth, client HTTP o schemi di risposta API; gws gestisce tutto e restituisce JSON pulito.
def _gws_json_stdout(stdout: str) -> str:
    if not stdout or "{" not in stdout:
        return stdout or ""
    return stdout[stdout.find("{"):]
L'helper _gws_json_stdout gestisce un problema sottile in cui gws a volte emette righe di keyring o logging prima del payload JSON. Qui, chiamare direttamente json.loads(result.stdout) fallirebbe, mentre questa funzione elimina tutto prima della prima {.
def check_auth() -> bool:
    cmd = ["gws", "drive", "about", "get", "--params", '{"fields": "user"}']
    result = subprocess.run(cmd, capture_output=True, text=True)
    payload = _gws_json_stdout(result.stdout)
    try:
        data = json.loads(payload) if payload.strip() else {}
    except json.JSONDecodeError:
        print("Error checking authentication status (could not parse gws output).")
        return False
    if "error" in data or result.returncode != 0:
        handle_error_output(result.stdout, result.stderr)
        return False
    return True
La funzione check_auth() viene chiamata all'avvio in main.py, effettua una chiamata leggera all'API Drive e ispeziona la risposta. Se l'autenticazione è interrotta o mancano gli scope, l'app esce in modo pulito prima di tentare l'ingestione.
L'handler degli errori intercetta anche modalità di errore specifiche e stampa messaggi utili all'azione:
def handle_error_output(stdout, stderr):
    output = _gws_json_stdout(stdout or "") or (stderr or "")
    if "insufficientPermissions" in output or "unauthenticated" in output.lower():
        print("Please run: gws auth login -s drive")
    elif "serviceusage.services.use" in output or "serviceUsageConsumer" in output:
        print(
            "GCP quota project error: run gws auth setup --project YOUR_PROJECT_ID --login"
        )
    else:
        print(f"API Error: {output}")
Il fetcher dell'elenco documenti mira solo a tipi MIME esportabili come testo:
def fetch_document_list(limit=10) -> list[dict]:
    q = (
        "(mimeType='text/plain' or mimeType='application/vnd.google-apps.document' "
        "or mimeType='application/vnd.google-apps.spreadsheet') and trashed=false"
    )
    cmd = [
        "gws", "drive", "files", "list",
        "--params",
        json.dumps({"q": q, "pageSize": limit, "orderBy": "modifiedTime desc"}),
    ]
La query filtra per testo semplice, Google Docs e Google Sheets, ciascuno ordinato per i più recentemente modificati. I file binari (PDF, immagini) sono esclusi poiché non possono essere esportati pulitamente come testo con questo approccio.
Tuttavia, il download viene gestito in modo diverso per tipo MIME:
def download_document(file_id: str, mime_type: str) -> str:
    fd, out_path = tempfile.mkstemp(prefix="gws_", suffix=".bin")
    os.close(fd)
    try:
        if mime_type == "application/vnd.google-apps.document":
            cmd = ["gws", "drive", "files", "export",
                   "--params", json.dumps({"fileId": file_id, "mimeType": "text/plain"}),
                   "-o", out_path]
        elif mime_type == "application/vnd.google-apps.spreadsheet":
            cmd = ["gws", "drive", "files", "export",
                   "--params", json.dumps({"fileId": file_id, "mimeType": "text/csv"}),
                   "-o", out_path]
        else:
            cmd = ["gws", "drive", "files", "get",
                   "--params", json.dumps({"fileId": file_id, "alt": "media"}),
                   "-o", out_path]
        ...
        with open(out_path, "rb") as f:
            return f.read().decode("utf-8", errors="replace")
    finally:
        os.unlink(out_path)
gws scrive i byte dei file esportati su disco tramite -o, non su stdout. Stdout trasporta i metadati JSON. Il codice usa un file temporaneo per catturare l'output binario, lo legge e fa pulizia in un blocco finally, quindi i file temporanei vengono sempre rimossi anche in caso di errore.
vector_store.py — Embedding locali con ChromaDBQuesto modulo suddivide il testo in ingresso, genera embedding in locale usando Sentence Transformers, li persiste su disco tramite ChromaDB ed espone un semplice metodo query() che il loop di chat chiama per ogni domanda dell'utente.
class VectorStore:
    def __init__(self, persist_directory="./chroma_db"):
        self.client = chromadb.PersistentClient(path=persist_directory)
        self.collection = self.client.get_or_create_collection(
            name="drive_documents",
            embedding_function=embedding_functions.DefaultEmbeddingFunction()
        )
        self.text_splitter = RecursiveCharacterTextSplitter(
            chunk_size=1000,
            chunk_overlap=200
        )
PersistentClient scrive l'indice vettoriale in ./chroma_db e lo carica nelle esecuzioni successive senza bisogno di re-ingestione, a meno che non elimini la directory. La DefaultEmbeddingFunction usa Sentence Transformers in locale, quindi gli embedding sono calcolati sulla tua macchina a costo marginale zero.
Lo splitter usa chunk_size=1000 con chunk_overlap=200, così la sovrapposizione assicura che il contesto ai confini dei chunk non vada perso quando le frasi si dividono tra due chunk.
def add_document(self, file_id: str, filename: str, text: str):
    chunks = self.text_splitter.split_text(text)
    ids = [f"{file_id}_{i}" for i in range(len(chunks))]
    metadatas = [{"source": filename, "file_id": file_id} for _ in chunks]
    self.collection.upsert(documents=chunks, metadatas=metadatas, ids=ids)
    print(f"-> Added {len(chunks)} chunks for {filename}")
upsert nel frammento di codice sopra significa che rieseguire la pipeline su un file già ingestito aggiorna i chunk invece di generare un errore di ID duplicato.
def document_exists(self, file_id: str) -> bool:
    try:
        results = self.collection.get(where={"file_id": file_id}, limit=1)
        return len(results["ids"]) > 0
    except Exception:
        return False
Questo controllo veloce preliminare nel ciclo di ingestione di main.py evita di riscaricare i file che hai già incorporato, rendendo istantanee le esecuzioni successive.
main.py — Ingestione, retrieval e chat in streamingIl file main.py esegue i controlli di autenticazione, guida il ciclo di ingestione, inizializza il client Gemini e avvia il loop di chat interattivo. È volutamente snello perché il grosso del lavoro è delegato a fetcher.py e vector_store.py.
def setup_gemini():
    api_key = os.getenv("GEMINI_API_KEY")
    if not api_key:
        print("Please enter your GEMINI_API_KEY (get one from Google AI Studio).")
        api_key = input("Key: ").strip()
    return genai.Client(api_key=api_key)
Se GEMINI_API_KEY non è impostata, l'app chiede in modo interattivo invece di andare in errore. Puoi impostare la tua GEMINI_API_KEY come fatto nel passo precedente.
def ingest_documents(store, limit=10):
    files = fetch_document_list(limit)
    for file in files:
        file_id = file.get("id")
        if store.document_exists(file_id):
            print(f"Skipping {file.get('name')} (already in vector store)...")
            continue
        content = download_document(file_id, file.get("mimeType"))
        if content:
            store.add_document(file_id, file.get("name"), content)
Il controllo document_exists è il meccanismo di ingestione incrementale, per cui a ogni esecuzione vengono scaricati e incorporati solo i file nuovi. Il loop di chat recupera i 3 chunk semanticamente più simili e annota ciascuno con il relativo nome file di origine:
def chat_loop(model, store):
    while True:
        query = input("\nYou: ")
        results = store.query(query, n_results=3)
        documents = results.get("documents", [[]])[0]
        metadatas = results.get("metadatas", [[]])[0]
        context_parts = []
        for doc, meta in zip(documents, metadatas):
            source = meta.get("source", "Unknown")
            context_parts.append(f"Source: {source}\nText:\n{doc}\n")
        full_context = "\n---\n".join(context_parts)
        prompt = f"""You are a helpful assistant. Answer the user's question based ONLY on the following context from their Google Drive. If you cannot answer from the context, say "I don't know based on your documents."
Context:
{full_context}
Question: {query}
"""
        model_name = os.getenv("GEMINI_MODEL", "gemini-2.5-flash")
        response = model.models.generate_content_stream(model=model_name, contents=prompt)
        for chunk in response:
            if chunk.text:
                print(chunk.text, end="", flush=True)
        print()
Il prompt sopra è rigidamente fondato, in modo che l'LLM sia istruito a rispondere solo dal contesto fornito e a dire "I don't know" se la risposta non è presente. Questo previene allucinazioni di informazioni non presenti nel tuo Drive. Le risposte vengono trasmesse token per token tramite generate_content_stream, quindi l'output appare immediatamente.
Con tutti e quattro i file al loro posto, avvia l'app con:
python main.pyAl primo avvio, l'app verifica l'autenticazione, inizializza ChromaDB, scarica il modello di embedding se non è già in cache, recupera fino a 10 file Drive, li incorpora e li archivia, quindi ti porta nel loop di chat. Vedrai i progressi incrementali stampati per ogni file durante l'ingestione:
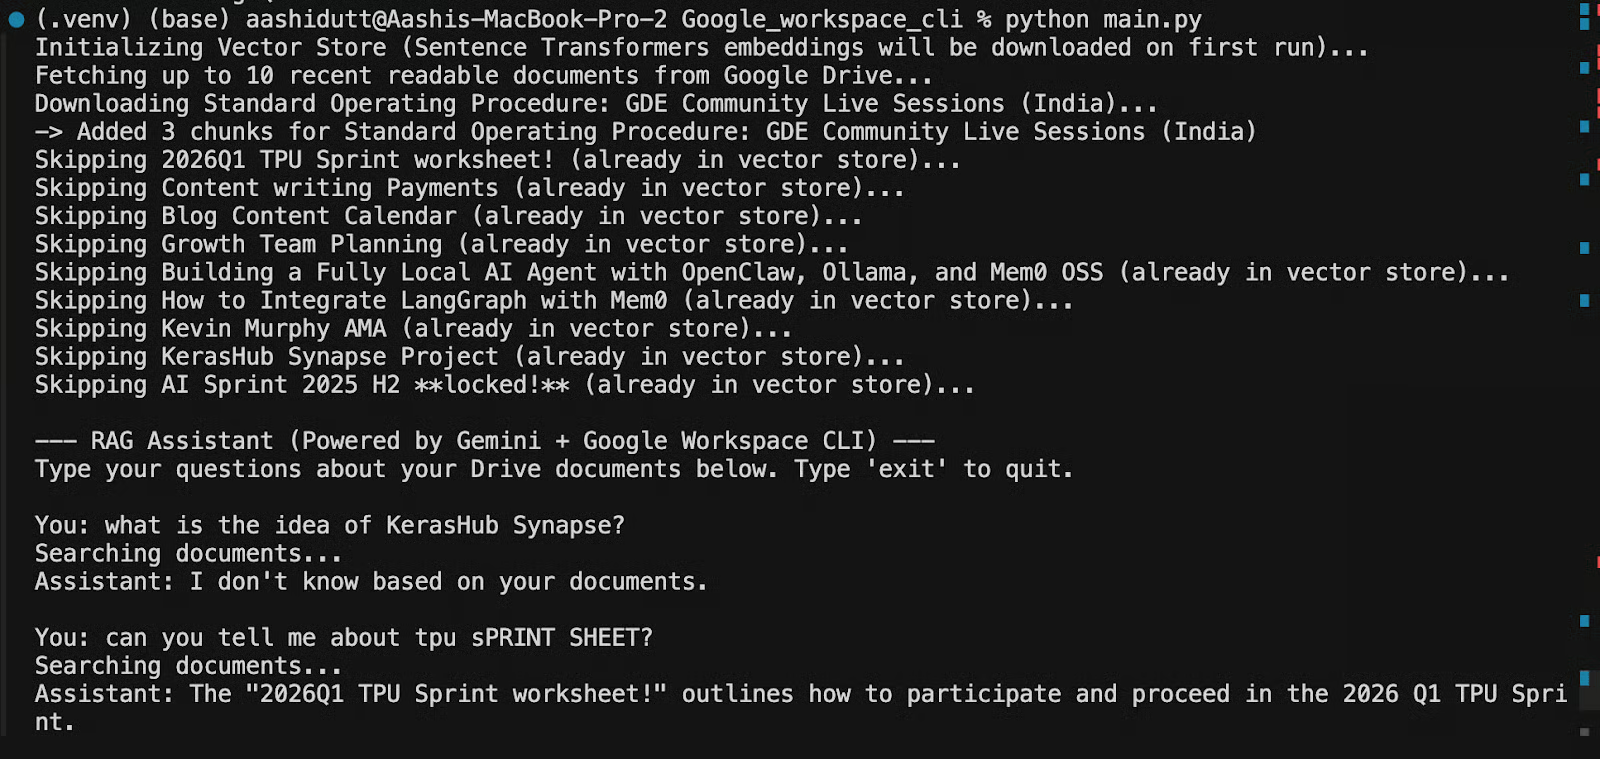
Alle esecuzioni successive, ChromaDB carica l'indice persistito da disco, i file già ingestiti vengono saltati e arrivi al prompt della chat quasi all'istante.
Tuttavia, per re-ingestire tutto da zero, ad esempio dopo aver aggiunto nuovi file Drive che vuoi includere, devi eliminare la directory ChromaDB e rieseguire:
rm -rf ./chroma_db
python main.py
Per verificare l'autenticazione in modo indipendente senza eseguire l'intera pipeline, esegui direttamente fetcher.py:
python fetcher.pyQuesto esegue check_auth() e stampa un elenco dei tuoi file Drive per confermare che CLI, OAuth e Drive API funzionino tutti prima di passare a una run di ingestione completa.
L'assistente RAG che abbiamo costruito con Google Workspace CLI è volutamente minimale: gws recupera, Sentence Transformers incorpora in locale, ChromaDB archivia, Gemini trasmette la risposta. Quattro file, zero costi di embedding nel cloud, ingestione incrementale a ogni esecuzione. L'architettura scala in modo pulito se vuoi aggiungere Gmail e Calendar come fonti di ingestione aggiuntive, sostituire con un modello Gemini più grande o rimpiazzare il loop di chat con un agente LangGraph. Le fondamenta restano le stesse.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



