Curso
Introdução a agentes de IA
1 h 30 min
137.2K
O Google acabou de lançar algo realmente interessante para desenvolvedores: uma interface de linha de comando do Google Workspace que oferece acesso estruturado e scriptável a todo o seu Google Workspace — incluindo Drive, Gmail, Calendar, Sheets, Docs, Chat e mais — em uma única ferramenta.
O código é quase todo em Rust (99,3%), mas a distribuição é via npm com binários nativos pré-compilados, então você não precisa ter o toolchain do Rust instalado.
Neste tutorial, você vai configurar o Google Workspace CLI do zero, autenticar e criar um assistente RAG com Gemini que permite consultar seus arquivos do Drive em linguagem natural. Ao final, você terá:
gws instalado e autenticado no seu Drive
Um ambiente virtual Python com ChromaDB, Sentence Transformers e o SDK do Gemini
Um pipeline RAG local funcional que busca arquivos via gws, gera embeddings com um modelo local e transmite respostas com o Gemini 2.5 Flash
Observação: este não é um produto oficial do Google.
O Google Workspace CLI (gws) é uma ferramenta de linha de comando otimizada para IA que cobre todo o seu ecossistema Google Workspace. Eis o que o diferencia:
Descoberta dinâmica de comandos: em vez de enviar uma árvore de comandos fixa, o gws lê o Discovery Service do Google em tempo de execução. Quando o Google adiciona novos endpoints de API, a CLI os incorpora automaticamente sem precisar de nova versão.
Design voltado para agentes: a CLI vem com mais de 100 habilidades pré-construídas e 50 receitas curadas para fluxos comuns como resumir e-mails, mover arquivos no Drive, criar eventos de agenda e muito mais. Toda saída é JSON estruturado, pronto para LLMs consumirem diretamente.
Suporte nativo a servidor MCP: execute o gws como um servidor MCP local e dê ao seu agente de IA acesso completo às ferramentas do Workspace sem escrever nenhum cliente de API.
Integração com Model Armor: para agentes em produção que leem conteúdo controlado pelo usuário, você pode canalizar respostas de API pelo Google Cloud Model Armor para sanitizar contra prompt injection antes que seu LLM as veja.
Você pode explorar toda a biblioteca de habilidades aqui: github.com/googleworkspace/cli/blob/main/docs/skills.md.
Neste tutorial, vamos construir o assistente RAG passo a passo. Em alto nível, o app faz o seguinte:
Autentica no seu Google Drive usando a CLI gws e busca seus Docs, Sheets e arquivos de texto mais recentes
Fragmenta cada documento e gera embeddings localmente com Sentence Transformers via ChromaDB
Persiste o índice vetorial em disco para que execuções seguintes pulem arquivos já ingeridos e entrem direto no chat
Recebe uma pergunta em linguagem natural, recupera os 3 trechos mais relevantes do ChromaDB e constrói um prompt com contexto fundamentado
Transmite, no seu terminal, uma resposta com citações e baseada apenas no contexto, vinda do Gemini 2.5 Flash, token a token
Vamos construir isso juntos.
Código completo do tutorial: https://github.com/AashiDutt/Google-Workspace-CLI-Demo
A CLI é distribuída como um pacote npm que empacota binários Rust pré-compilados. Não é necessário ter o toolchain do Rust.
npm install -g @googleworkspace/cliVerifique a instalação executando os comandos abaixo um por vez:
gws --version
which gws
Se o gws não for encontrado após a instalação, garanta que o diretório binário do npm global está no seu PATH.
A CLI autentica por meio do cliente OAuth de um projeto da GCP, então você precisa de um antes de fazer login. Para criar ou selecionar um projeto na GCP:
Configure as credenciais OAuth:
Navegue até APIs & Services e selecione Credentials
Clique em Create Credentials e escolha OAuth 2.0 Client ID
Selecione Desktop app como o tipo de aplicativo
Anote o Client ID e o Client Secret que usaremos no gws auth setup.
A CLI conclui o OAuth iniciando um servidor localhost temporário. Clientes do tipo Desktop app tratam automaticamente portas localhost arbitrárias. Clientes do tipo Web application exigem que você adicione manualmente cada http://localhost:PORT à lista de URIs de redirecionamento autorizados.
Se você estiver usando um cliente Web application e ver "Access blocked: This app's request is invalid", vá em Credentials, clique no OAuth client e depois em Authorized redirect URIs para adicionar exatamente a URL http://localhost:PORT mostrada no erro.
Para conectar o gws ao seu projeto GCP, primeiro exporte as credenciais OAuth como variáveis de ambiente para que o assistente de configuração as detecte automaticamente:
export GOOGLE_WORKSPACE_CLI_CLIENT_ID="CLIENT_ID"
export GOOGLE_WORKSPACE_CLI_CLIENT_SECRET="CLIENT_SECRET"
Depois, execute:
gws auth setup --project YOUR_PROJECT_ID --login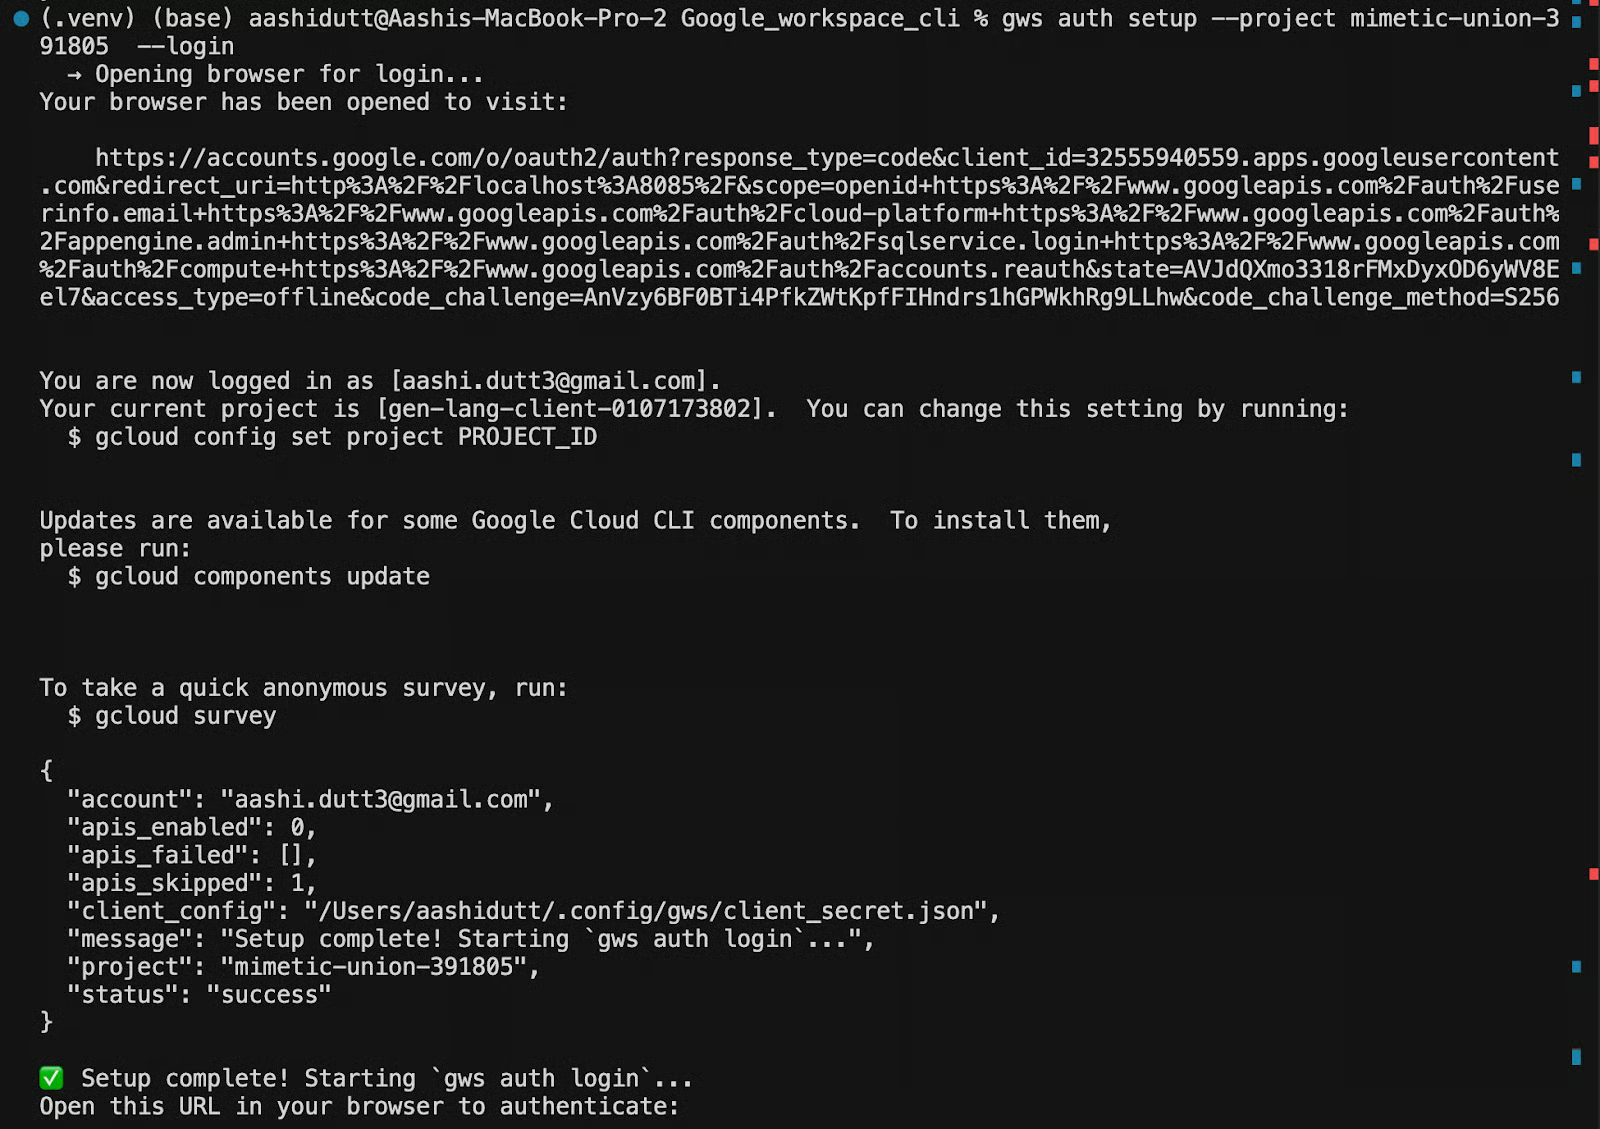
O assistente de configuração vai:
Quando finalizar, você verá: Setup complete!
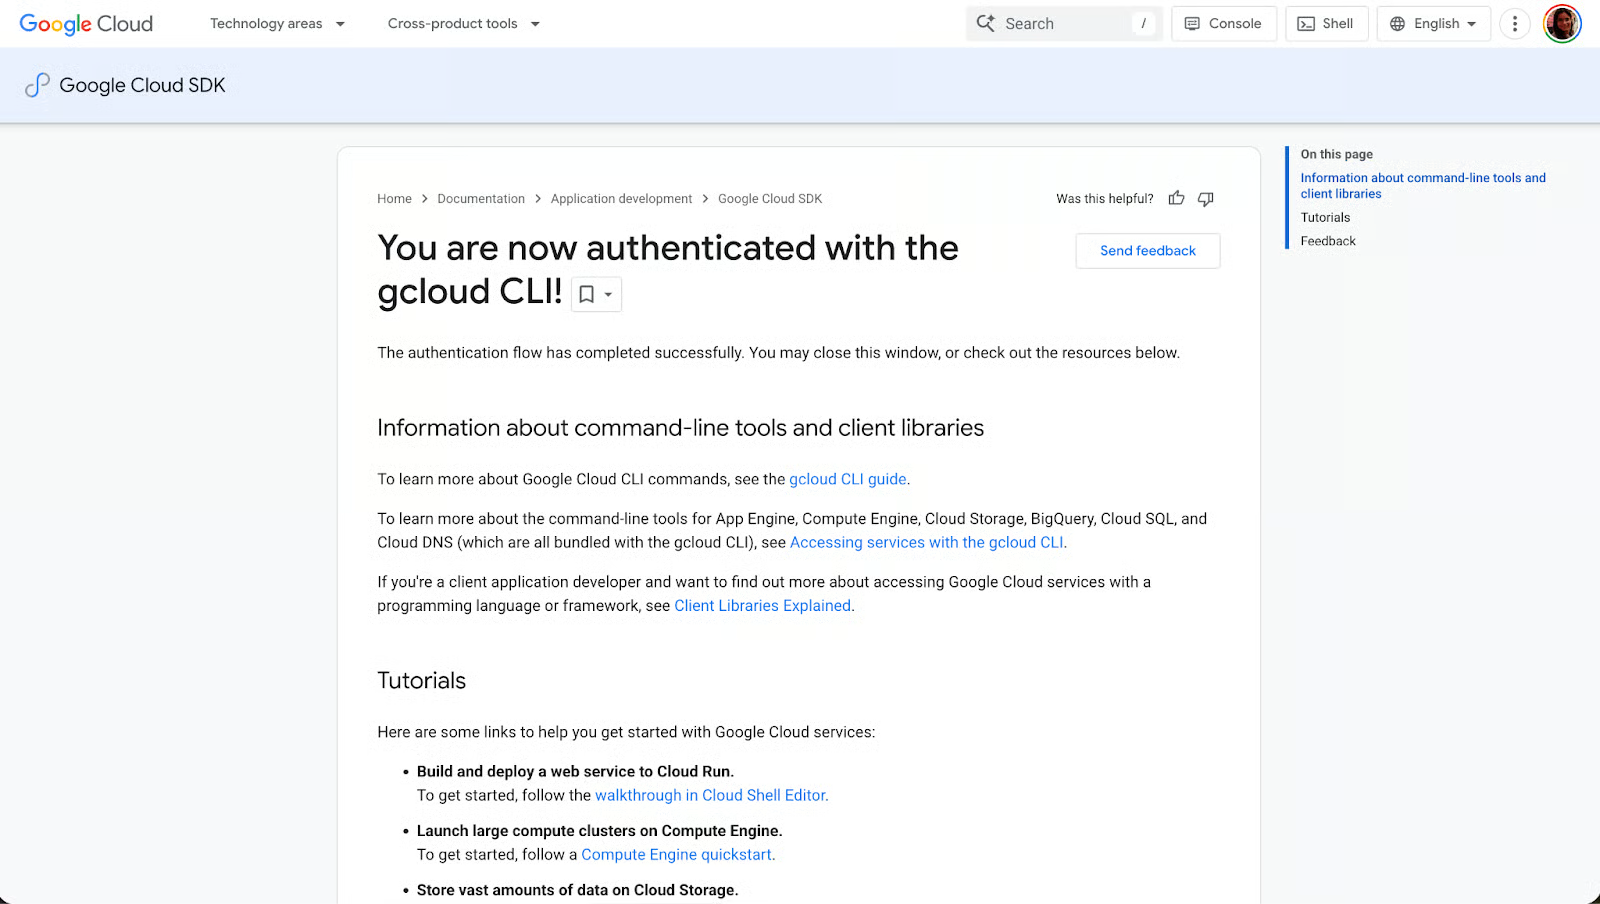
As credenciais ficam em ~/.config/gws/. Para confirmar que tudo está conectado corretamente, execute:
gws auth statusIsso imprime a conta autenticada, o projeto GCP vinculado e os escopos ativos. Se algo parecer errado, rode novamente o gws auth setup com os flags corretos, em vez de tentar editar os arquivos de configuração manualmente.
Antes de escrever qualquer Python, vale fazer um teste rápido no terminal para confirmar que a CLI está autenticada e consegue falar com o seu Drive. Vamos listar seus cinco arquivos mais recentes com o comando abaixo:
gws drive files list --params '{"pageSize": 5}'A flag --params aceita uma string JSON que mapeia diretamente para os parâmetros da API do Drive. Aqui, pageSize: 5 limita a resposta a cinco resultados — o suficiente para confirmar a conexão sem despejar todo o seu Drive.
Se a autenticação estiver funcionando, você receberá uma resposta JSON estruturada como esta:
{
  "files": [
    {
      "id": "1BxiMVs0XRA5nFMdKvBdBZjgmUUqptlbs74OgVE2upms",
      "name": "Q3 Strategy Doc",
      "mimeType": "application/vnd.google-apps.document"
    },
    ...
  ]
}
Toda resposta do gws é JSON estruturado — sem parsing frágil, sem scraping, sem saída de texto quebradiça.
Se, em vez disso, você vir um “erro 403” mencionando serviceusage.services.use, significa que suas credenciais OAuth apontam para um projeto GCP diferente daquele com cobrança habilitada. Refaça a configuração com o ID de projeto correto para religar tudo:
gws auth setup --project YOUR_PROJECT_ID --loginCom o acesso ao Drive confirmado, estamos prontos para ativar a API e começar a construir a parte em Python do pipeline.
Neste ponto, o gws já consegue se autenticar no seu projeto GCP, mas ainda não pode ler o conteúdo dos arquivos do Drive. A GCP separa autenticação (provar quem você é) de ativação de API (declarar quais serviços seu projeto usa). Mesmo com credenciais OAuth válidas, qualquer tentativa de buscar conteúdo de arquivo retornará 403 accessNotConfigured até que a API do Drive seja explicitamente ativada no projeto.
Para ativá-la, abra este URL no navegador, substitua [PROJECT_ID] pelo ID do seu projeto e clique em Enable:
https://console.developers.google.com/apis/api/drive.googleapis.com/overview?project=[PROJECT_ID]
Como alternativa, se você tiver a CLI gcloud instalada, pode habilitar diretamente pelo terminal:
gcloud services enable drive.googleapis.com --project YOUR_PROJECT_IDAmbos os métodos fazem a mesma coisa. Executar um deles em uma API já habilitada é seguro, pois a operação é idempotente e não altera a configuração existente.
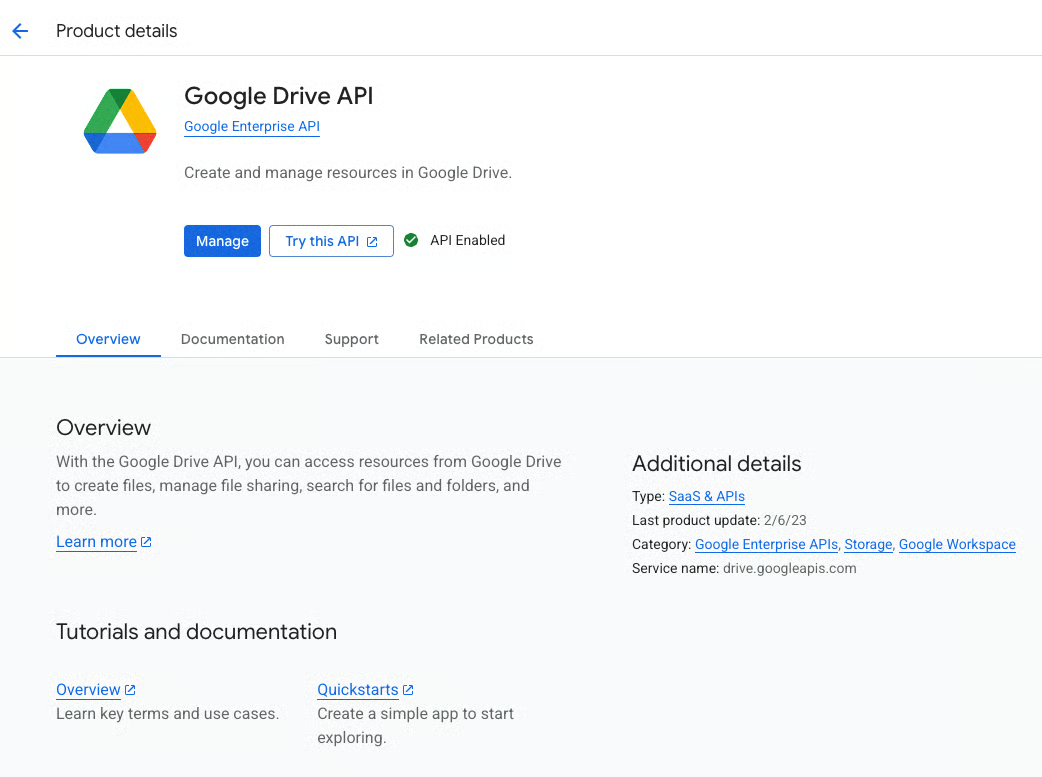
Depois de habilitar, a GCP pode levar alguns segundos para propagar a mudança. Se você rodar gws drive files list imediatamente e ainda ver 403, aguarde 30 segundos e tente novamente.
Com a parte da CLI configurada, vamos preparar o ambiente Python que cuida da lógica de embedding e recuperação. O pipeline RAG é propositalmente leve, com quatro pacotes, sem necessidade de GPU, e todos os embeddings são gerados localmente na sua máquina.
Comece criando um ambiente virtual executando os comandos abaixo, um por vez:
cd /path/to/your/project
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
pip install -r requirements.txt
Depois, instale as dependências do requirements.txt:
.txt
chromadb==1.5.5
google-genai==1.70.0
langchain-text-splitters==1.1.1
sentence-transformers==5.3.0
Veja o que cada pacote adiciona ao pipeline:
chromadb: banco de vetores local que armazena os embeddings em ./chroma_db no disco e os carrega em execuções seguintes, evitando reprocessar arquivos já tratados.
google-genai: SDK oficial em Python para o Gemini. O app o usa para enviar o contexto recuperado e a pergunta do usuário ao Gemini 2.5 Flash, transmitindo a resposta token a token.
langchain-text-splitters: fornece o RecursiveCharacterTextSplitter, que divide documentos grandes em blocos sobrepostos antes do embedding. A sobreposição garante que sentenças nas bordas dos blocos não percam contexto.
sentence-transformers: roda o modelo de embedding localmente via DefaultEmbeddingFunction do ChromaDB. Assim, cada trecho é embedado na sua máquina, sem chamadas externas de API.
Observação: o modelo de embedding (~90MB) é baixado automaticamente no primeiro uso e fica em cache local.
Com o ambiente Python pronto, o último passo antes do código é obter sua chave de API do Gemini.
O pipeline RAG usa o Gemini como camada de geração de respostas, pois ele recebe os trechos recuperados do documento e a pergunta do usuário e retorna uma resposta fundamentada. Para se conectar ao Gemini, você precisa de uma chave de API no Google AI Studio.
Faça login com sua conta Google, clique em Get API Key e depois em Create API Key. Selecione seu projeto GCP quando solicitado para vincular cota e cobrança. No painel da GCP, em Billing, selecione Link a billing account para associar uma conta de faturamento.
Com a chave em mãos, exporte-a como variável de ambiente:
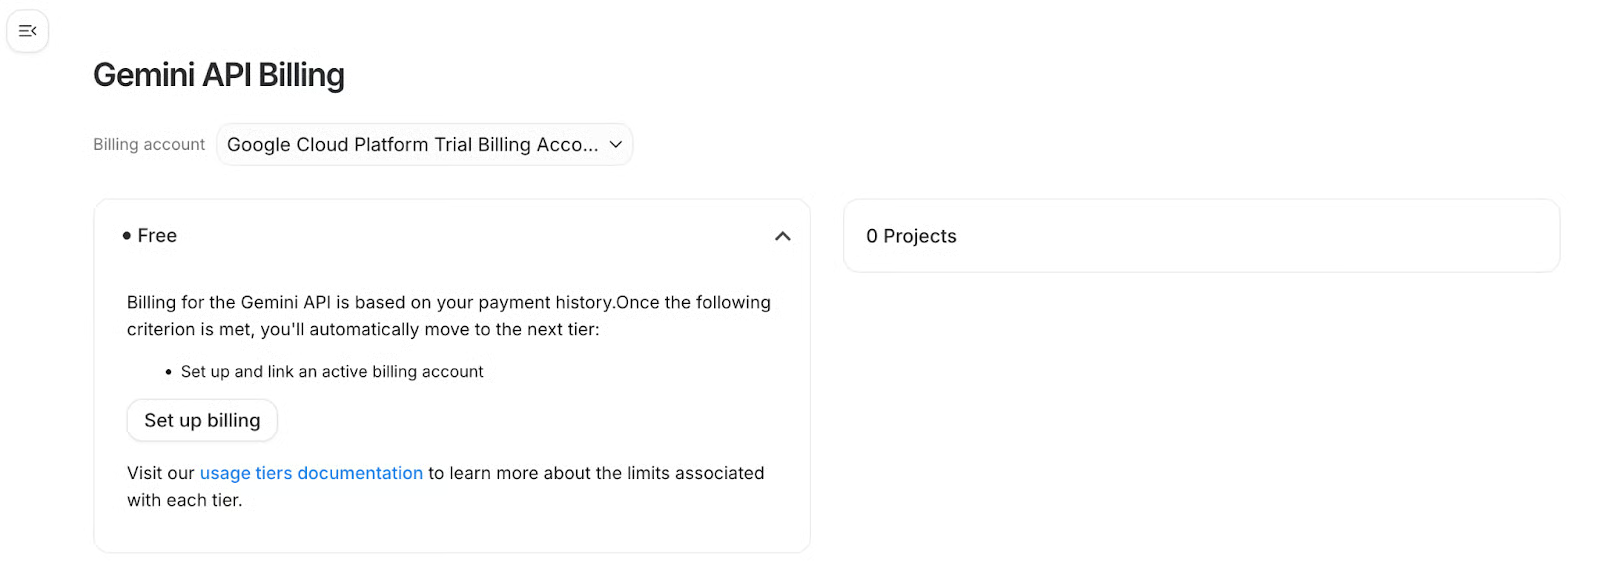
Exporte a chave no seu terminal:
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"Para persistir entre sessões do terminal, rode:
echo 'export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"' >> ~/.zshrc
source ~/.zshrc
O app lê essa chave via os.getenv("GEMINI_API_KEY") na inicialização. Se a variável não estiver definida, ele solicitará a chave interativamente.
Observação sobre modelos: o app usa por padrão o gemini-2.5-flash. Você pode sobrescrever exportando GEMINI_MODEL="gemini-2.5-pro" se quiser mais raciocínio em documentos complexos. Note que o gemini-2.0-flash foi descontinuado para novas chaves de API, então não use aqui.
Com a autenticação, a API do Drive, as dependências e a chave do Gemini prontas, temos tudo que precisamos. Vamos construir o pipeline.
Agora vamos conectar tudo. Vamos trabalhar com quatro arquivos: fetcher.py, vector_store.py, main.py e requirements.txt. Cada um tem uma responsabilidade clara: fetcher.py lida com a interação via CLI, vector_store.py cuida de embedding e recuperação, e main.py orquestra o ciclo completo da ingestão ao chat por streaming.
Na primeira execução, o gws busca seus arquivos do Drive, o conteúdo é fragmentado e embedado localmente, e o índice vetorial é salvo em ./chroma_db no disco. Nas execuções seguintes, o ChromaDB carrega do disco, apenas arquivos novos são buscados e embedados, e o chat começa imediatamente sem reprocessar nada.
Vamos ver cada arquivo.
fetcher.py — acesso ao Drive via gwsEste módulo faz a ponte entre a CLI gws e o Python. Todas as interações com o Drive — listar arquivos, exportar conteúdo e checar autenticação — passam por subprocessos que chamam o gws, e o JSON estruturado de saída é convertido em dicionários Python. Assim, o código Python não precisa lidar diretamente com tokens OAuth, clientes HTTP ou schemas de resposta da API; o gws cuida de tudo e entrega JSON limpo.
def _gws_json_stdout(stdout: str) -> str:
    if not stdout or "{" not in stdout:
        return stdout or ""
    return stdout[stdout.find("{"):]
O helper _gws_json_stdout resolve um detalhe: às vezes o gws emite linhas do keyring ou logs antes do payload JSON. Nesses casos, chamar json.loads(result.stdout) direto falharia; por isso removemos tudo antes do primeiro {.
def check_auth() -> bool:
    cmd = ["gws", "drive", "about", "get", "--params", '{"fields": "user"}']
    result = subprocess.run(cmd, capture_output=True, text=True)
    payload = _gws_json_stdout(result.stdout)
    try:
        data = json.loads(payload) if payload.strip() else {}
    except json.JSONDecodeError:
        print("Error checking authentication status (could not parse gws output).")
        return False
    if "error" in data or result.returncode != 0:
        handle_error_output(result.stdout, result.stderr)
        return False
    return True
A função check_auth() é chamada na inicialização em main.py, fazendo uma chamada leve à API do Drive e inspecionando a resposta. Se a autenticação estiver quebrada ou faltarem escopos, o app encerra de forma limpa antes de tentar ingerir dados.
O handler de erros também captura falhas específicas e imprime mensagens acionáveis:
def handle_error_output(stdout, stderr):
    output = _gws_json_stdout(stdout or "") or (stderr or "")
    if "insufficientPermissions" in output or "unauthenticated" in output.lower():
        print("Please run: gws auth login -s drive")
    elif "serviceusage.services.use" in output or "serviceUsageConsumer" in output:
        print(
            "GCP quota project error: run gws auth setup --project YOUR_PROJECT_ID --login"
        )
    else:
        print(f"API Error: {output}")
O buscador de lista de documentos mira apenas tipos MIME exportáveis como texto:
def fetch_document_list(limit=10) -> list[dict]:
    q = (
        "(mimeType='text/plain' or mimeType='application/vnd.google-apps.document' "
        "or mimeType='application/vnd.google-apps.spreadsheet') and trashed=false"
    )
    cmd = [
        "gws", "drive", "files", "list",
        "--params",
        json.dumps({"q": q, "pageSize": limit, "orderBy": "modifiedTime desc"}),
    ]
A consulta filtra por texto puro, Google Docs e Google Sheets, ordenando por última modificação. Arquivos binários (PDFs, imagens) são excluídos, já que não podem ser exportados como texto de forma limpa por esta abordagem.
O download, porém, varia conforme o tipo MIME:
def download_document(file_id: str, mime_type: str) -> str:
    fd, out_path = tempfile.mkstemp(prefix="gws_", suffix=".bin")
    os.close(fd)
    try:
        if mime_type == "application/vnd.google-apps.document":
            cmd = ["gws", "drive", "files", "export",
                   "--params", json.dumps({"fileId": file_id, "mimeType": "text/plain"}),
                   "-o", out_path]
        elif mime_type == "application/vnd.google-apps.spreadsheet":
            cmd = ["gws", "drive", "files", "export",
                   "--params", json.dumps({"fileId": file_id, "mimeType": "text/csv"}),
                   "-o", out_path]
        else:
            cmd = ["gws", "drive", "files", "get",
                   "--params", json.dumps({"fileId": file_id, "alt": "media"}),
                   "-o", out_path]
        ...
        with open(out_path, "rb") as f:
            return f.read().decode("utf-8", errors="replace")
    finally:
        os.unlink(out_path)
O gws grava os bytes exportados em arquivo via -o, e não no stdout. O stdout carrega metadados em JSON. O código usa um arquivo temporário para capturar a saída binária, lê o conteúdo e apaga no bloco finally, garantindo limpeza mesmo em caso de erro.
vector_store.py — embeddings locais com ChromaDBEste módulo fragmenta o texto, gera embeddings localmente usando Sentence Transformers, persiste em disco via ChromaDB e expõe um método simples query() que o loop de chat chama para cada pergunta do usuário.
class VectorStore:
    def __init__(self, persist_directory="./chroma_db"):
        self.client = chromadb.PersistentClient(path=persist_directory)
        self.collection = self.client.get_or_create_collection(
            name="drive_documents",
            embedding_function=embedding_functions.DefaultEmbeddingFunction()
        )
        self.text_splitter = RecursiveCharacterTextSplitter(
            chunk_size=1000,
            chunk_overlap=200
        )
PersistentClient grava o índice vetorial em ./chroma_db e o carrega em execuções futuras, sem precisar reingerir nada — a menos que você delete o diretório. A DefaultEmbeddingFunction usa Sentence Transformers localmente, então os embeddings são calculados na sua máquina a custo marginal zero.
O splitter usa chunk_size=1000 com chunk_overlap=200, garantindo que o contexto nas bordas dos blocos não se perca quando uma sentença atravessa dois trechos.
def add_document(self, file_id: str, filename: str, text: str):
    chunks = self.text_splitter.split_text(text)
    ids = [f"{file_id}_{i}" for i in range(len(chunks))]
    metadatas = [{"source": filename, "file_id": file_id} for _ in chunks]
    self.collection.upsert(documents=chunks, metadatas=metadatas, ids=ids)
    print(f"-> Added {len(chunks)} chunks for {filename}")
O upsert acima permite que, ao reexecutar o pipeline para um arquivo já ingerido, os trechos sejam atualizados em vez de gerar erro por ID duplicado.
def document_exists(self, file_id: str) -> bool:
    try:
        results = self.collection.get(where={"file_id": file_id}, limit=1)
        return len(results["ids"]) > 0
    except Exception:
        return False
Esse pré-check rápido no loop de ingestão do main.py evita baixar novamente arquivos já embedados, deixando execuções seguintes quase instantâneas.
main.py — ingestão, recuperação e chat em streamingO main.py roda as checagens de autenticação, conduz o loop de ingestão, inicializa o cliente Gemini e executa o chat interativo. Ele é propositalmente enxuto, pois o trabalho pesado fica em fetcher.py e vector_store.py.
def setup_gemini():
    api_key = os.getenv("GEMINI_API_KEY")
    if not api_key:
        print("Please enter your GEMINI_API_KEY (get one from Google AI Studio).")
        api_key = input("Key: ").strip()
    return genai.Client(api_key=api_key)
Se o GEMINI_API_KEY não estiver definido, o app pede a chave interativamente em vez de falhar. Você pode definir seu GEMINI_API_KEY como fizemos no passo anterior.
def ingest_documents(store, limit=10):
    files = fetch_document_list(limit)
    for file in files:
        file_id = file.get("id")
        if store.document_exists(file_id):
            print(f"Skipping {file.get('name')} (already in vector store)...")
            continue
        content = download_document(file_id, file.get("mimeType"))
        if content:
            store.add_document(file_id, file.get("name"), content)
A checagem document_exists é o mecanismo de ingestão incremental: a cada execução, apenas arquivos novos são baixados e embedados. O loop de chat recupera os 3 trechos semanticamente mais similares e anota cada um com o arquivo de origem:
def chat_loop(model, store):
    while True:
        query = input("\nYou: ")
        results = store.query(query, n_results=3)
        documents = results.get("documents", [[]])[0]
        metadatas = results.get("metadatas", [[]])[0]
        context_parts = []
        for doc, meta in zip(documents, metadatas):
            source = meta.get("source", "Unknown")
            context_parts.append(f"Source: {source}\nText:\n{doc}\n")
        full_context = "\n---\n".join(context_parts)
        prompt = f"""You are a helpful assistant. Answer the user's question based ONLY on the following context from their Google Drive. If you cannot answer from the context, say \"I don't know based on your documents.\"\nContext:\n{full_context}\nQuestion: {query}\n"""
        model_name = os.getenv("GEMINI_MODEL", "gemini-2.5-flash")
        response = model.models.generate_content_stream(model=model_name, contents=prompt)
        for chunk in response:
            if chunk.text:
                print(chunk.text, end="", flush=True)
        print()
O prompt acima é estritamente fundamentado: o LLM é instruído a responder apenas com base no contexto fornecido e a dizer "I don't know" se a resposta não estiver lá. Isso evita alucinações com informações que não estão no seu Drive. As respostas são transmitidas token a token via generate_content_stream, então a saída aparece imediatamente.
Com os quatro arquivos no lugar, inicie o app com:
python main.pyNa primeira execução, o app verifica a autenticação, inicializa o ChromaDB, baixa o modelo de embedding se ainda não estiver em cache, busca até 10 arquivos do Drive, gera e armazena os embeddings e, então, inicia o chat. Você verá o progresso sendo impresso para cada arquivo ingerido:
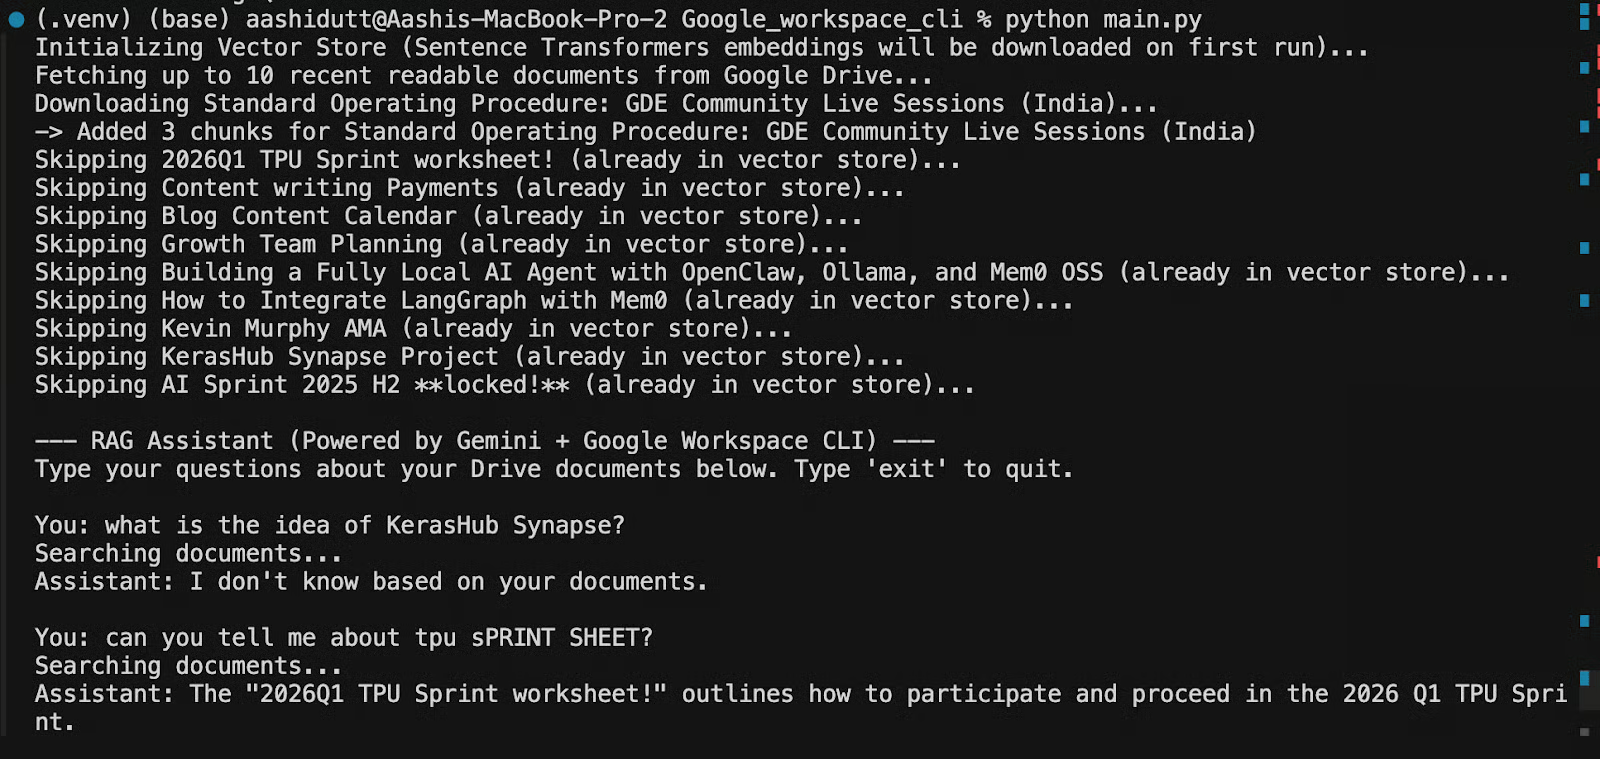
Nas execuções seguintes, o ChromaDB carrega o índice persistido do disco, arquivos já ingeridos são ignorados e você chega ao prompt do chat quase instantaneamente.
Se quiser reingerir tudo do zero — por exemplo, após adicionar novos arquivos do Drive que você quer incluir — basta deletar o diretório do ChromaDB e rodar novamente:
rm -rf ./chroma_db
python main.py
Para verificar a autenticação de forma independente, sem rodar o pipeline completo, execute o fetcher.py diretamente:
python fetcher.pyIsso executa o check_auth() e imprime uma lista de arquivos do seu Drive para confirmar que a CLI, o OAuth e a API do Drive estão funcionando antes de você partir para uma ingestão completa.
O assistente RAG que construímos com o Google Workspace CLI é deliberadamente minimalista: o gws busca, o Sentence Transformers gera embeddings localmente, o ChromaDB armazena e o Gemini transmite a resposta. Quatro arquivos, zero custo de embedding na nuvem, ingestão incremental a cada execução. A arquitetura escala de forma limpa se você quiser adicionar Gmail e Calendar como fontes de ingestão, trocar por um modelo Gemini maior ou substituir o loop de chat por um agente em LangGraph. A base permanece a mesma.
Aprenda com a DataCamp
Curso
Curso
Curso
blog
Matt Crabtree
12 min
Tutorial
Matt Crabtree
6 min
Tutorial
Zoumana Keita
14 min
Tutorial
Tutorial
Ryan Ong
12 min
Tutorial