Cours
Introduction aux agents d’IA
1 h 30 min
137.2K
Google vient de lancer quelque chose de vraiment intéressant pour les développeurs : une interface en ligne de commande Google Workspace qui offre un accès structuré et scriptable à l’ensemble de votre Google Workspace — Drive, Gmail, Agenda, Sheets, Docs, Chat, et plus — dans un seul outil.
Le code est quasi entièrement en Rust (99,3 %), mais il est distribué via npm sous forme de binaires natifs précompilés ; vous n’avez donc pas besoin d’installer une toolchain Rust.
Dans ce tutoriel, vous allez installer la Google Workspace CLI depuis zéro, l’authentifier et créer un assistant RAG propulsé par Gemini pour interroger vos fichiers Drive en langage naturel. À la fin, vous aurez :
gws installé et authentifié sur votre Drive
Un environnement virtuel Python avec ChromaDB, Sentence Transformers et le SDK Gemini
Un pipeline RAG local opérationnel qui récupère des fichiers via gws, les embarque avec un modèle local et diffuse des réponses avec Gemini 2.5 Flash
Remarque : il ne s’agit pas d’un produit officiel Google pris en charge.
La Google Workspace CLI (gws) est un outil en ligne de commande optimisé pour l’IA couvrant tout votre écosystème Google Workspace. Voici ce qui la distingue :
Découverte dynamique des commandes : plutôt que de livrer un arbre de commandes figé, gws lit le Discovery Service de Google à l’exécution. Lorsque Google ajoute de nouveaux endpoints API, la CLI les détecte automatiquement sans mise à jour de version.
Conçue pour les agents : la CLI inclut plus de 100 compétences d’agent prêtes à l’emploi et 50 recettes pour des workflows courants (résumer des e‑mails, déplacer des fichiers Drive, créer des événements d’agenda, etc.). Chaque sortie est un JSON structuré, directement exploitable par des LLM.
Prise en charge native de MCP server : exécutez gws en serveur MCP local et donnez à votre agent IA un accès complet aux outils Workspace sans écrire le moindre client API.
Intégration Model Armor : pour les agents en production lisant du contenu contrôlé par l’utilisateur, vous pouvez faire transiter les réponses API via Google Cloud Model Armor pour neutraliser les attaques d’injection de prompt avant qu’elles n’atteignent votre LLM.
Parcourez la bibliothèque complète de compétences ici : github.com/googleworkspace/cli/blob/main/docs/skills.md.
Dans ce tutoriel, nous allons construire l’assistant RAG pas à pas. En bref, l’application :
S’authentifie sur votre Google Drive avec la CLI gws et récupère vos Docs, Sheets et fichiers texte modifiés le plus récemment
Découpe chaque document et le vectorise en local via Sentence Transformers et ChromaDB
Conserve l’index vectoriel sur disque pour que les exécutions suivantes ignorent les fichiers déjà ingérés et passent directement au chat
Accepte une question en langage naturel, récupère les 3 extraits les plus pertinents depuis ChromaDB et construit un prompt contextuel fondé
Diffuse une réponse sourcée et strictement basée sur le contexte depuis Gemini 2.5 Flash, jeton par jeton, directement dans votre terminal
Passons à la construction, étape par étape.
Code complet du tutoriel : https://github.com/AashiDutt/Google-Workspace-CLI-Demo
La CLI est distribuée comme un package npm enveloppant des binaires Rust précompilés. Aucune toolchain Rust n’est nécessaire.
npm install -g @googleworkspace/cliVérifiez l’installation en exécutant ces commandes l’une après l’autre :
gws --version
which gws
Si gws est introuvable après l’installation, assurez‑vous que le répertoire des binaires npm global est bien présent dans votre PATH.
La CLI s’authentifie via le client OAuth d’un projet GCP ; vous devez donc en disposer avant de vous connecter. Pour créer ou sélectionner un projet depuis GCP :
Configurez les identifiants OAuth :
Accédez à APIs et services, puis Identifiants
Cliquez sur Créer des identifiants, puis sur ID client OAuth 2.0
Choisissez Application de bureau comme type d’application
Notez le Client ID et le Client Secret que nous utiliserons pour gws auth setup.
La CLI finalise l’OAuth en démarrant un serveur localhost temporaire. Les clients « Application de bureau » gèrent automatiquement les ports localhost arbitraires. Les clients « Application web » vous obligent à ajouter manuellement chaque http://localhost:PORT à la liste des URI de redirection autorisés.
Si vous utilisez un client « Application web » et voyez « Access blocked: This app's request is invalid », rendez‑vous dans Identifiants, cliquez sur le client OAuth puis sur URIs de redirection autorisés et ajoutez l’URL exacte http://localhost:PORT indiquée dans l’erreur.
Pour relier gws à votre projet GCP, commencez par exporter vos identifiants OAuth en variables d’environnement afin que l’assistant de configuration les détecte automatiquement :
export GOOGLE_WORKSPACE_CLI_CLIENT_ID="CLIENT_ID"
export GOOGLE_WORKSPACE_CLI_CLIENT_SECRET="CLIENT_SECRET"
Puis exécutez :
gws auth setup --project YOUR_PROJECT_ID --login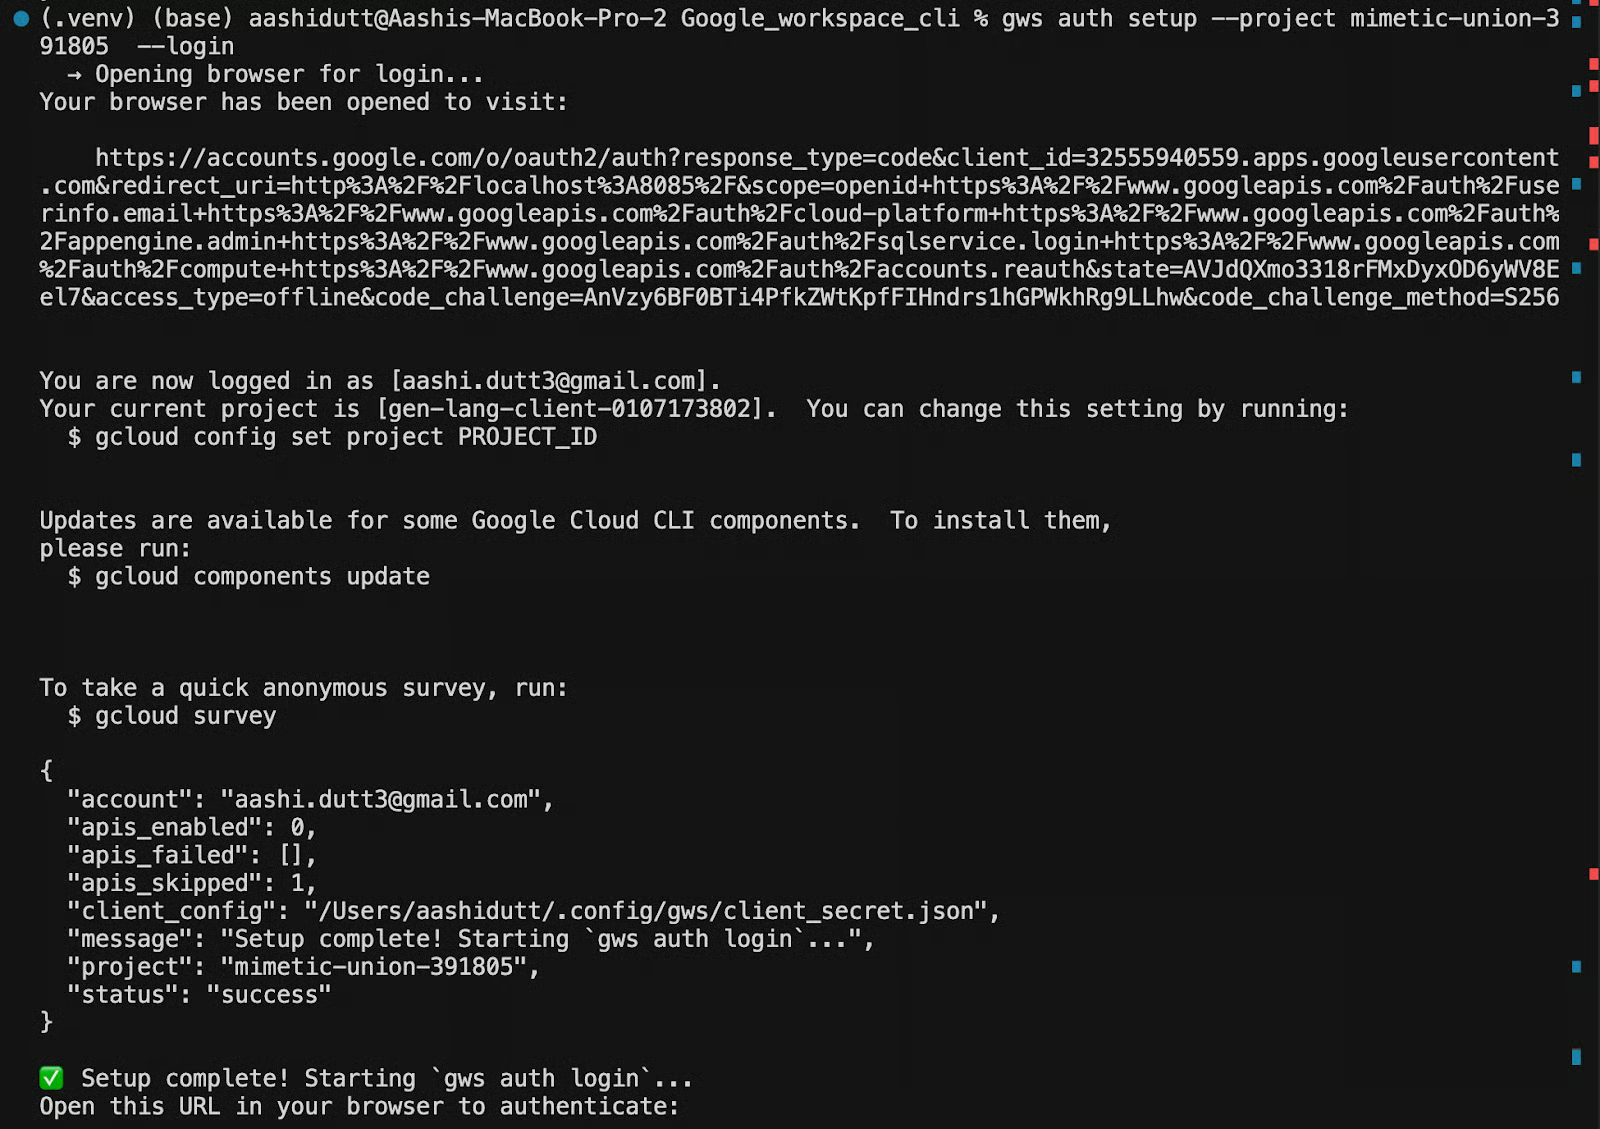
L’assistant de configuration va :
Une fois terminé, vous verrez : Setup complete !
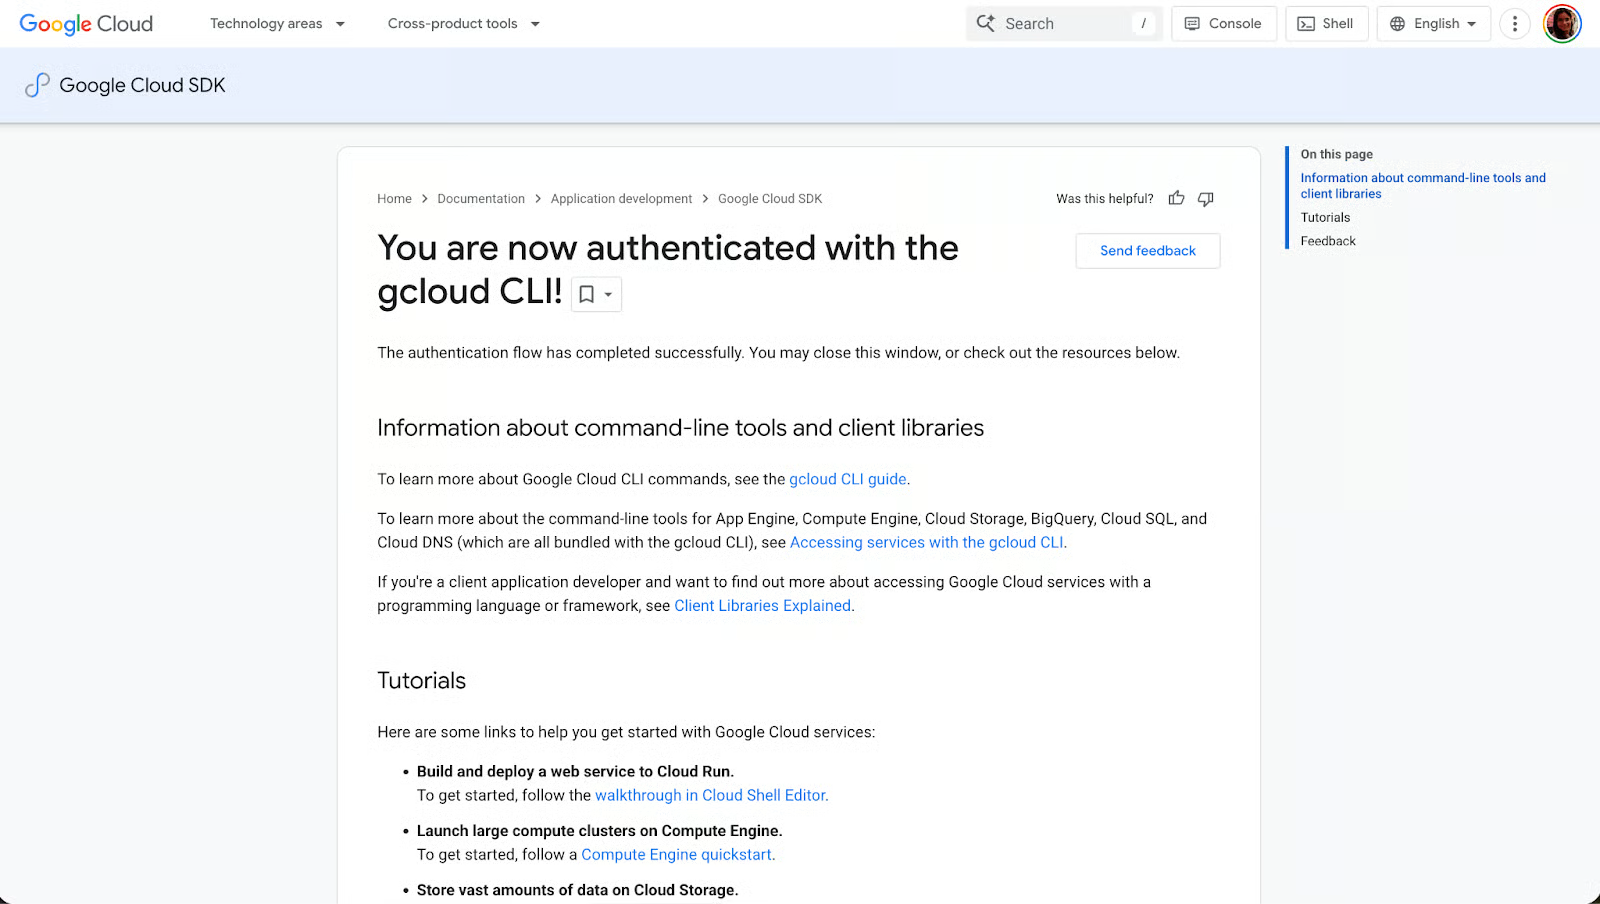
Les identifiants sont stockés dans ~/.config/gws/. Pour confirmer que tout est correctement relié, exécutez :
gws auth statusLa commande affiche le compte authentifié, le projet GCP lié et les portées actives. Si quelque chose semble anormal, relancez gws auth setup avec les bons indicateurs plutôt que d’éditer manuellement les fichiers de configuration.
Avant d’écrire la moindre ligne de Python, faites un test rapide directement depuis le terminal pour vérifier que la CLI est authentifiée et peut communiquer avec votre Drive. Exécutez cette commande pour lister vos cinq fichiers Drive les plus récents :
gws drive files list --params '{"pageSize": 5}'L’option --params accepte une chaîne JSON correspondant directement aux paramètres de requête de l’API Drive. Ici, pageSize: 5 limite la réponse à cinq résultats, suffisants pour confirmer la connectivité sans déverser l’intégralité de votre Drive.
Si l’authentification fonctionne, vous obtiendrez une réponse JSON structurée de ce type :
{
  "files": [
    {
      "id": "1BxiMVs0XRA5nFMdKvBdBZjgmUUqptlbs74OgVE2upms",
      "name": "Q3 Strategy Doc",
      "mimeType": "application/vnd.google-apps.document"
    },
    ...
  ]
}
Chaque réponse de gws est un JSON structuré — pas de parsing fragile, pas de scraping, pas de texte bancal.
Si vous voyez au contraire une « erreur 403 » mentionnant serviceusage.services.use, cela signifie que vos identifiants OAuth pointent vers un autre projet GCP que celui avec la facturation activée. Relancez la configuration avec le bon ID de projet pour tout relier à nouveau :
gws auth setup --project YOUR_PROJECT_ID --loginAvec l’accès à Drive confirmé, nous pouvons activer l’API et commencer la partie Python du pipeline.
À ce stade, gws peut s’authentifier sur votre projet GCP, mais ne peut pas encore lire le contenu des fichiers Drive. GCP sépare l’authentification (prouver votre identité) de l’activation des API (déclarer les services utilisés par le projet). Même avec des identifiants OAuth valides, toute tentative de lecture de contenu renverra une erreur 403 accessNotConfigured tant que l’API Drive n’est pas explicitement activée sur le projet.
Pour l’activer, ouvrez cette URL dans un navigateur, remplacez [PROJECT_ID] par votre ID de projet, puis cliquez sur Enable :
https://console.developers.google.com/apis/api/drive.googleapis.com/overview?project=[PROJECT_ID]
Alternativement, si vous avez installé la CLI gcloud, vous pouvez l’activer directement depuis le terminal :
gcloud services enable drive.googleapis.com --project YOUR_PROJECT_IDLes deux méthodes sont équivalentes. Les exécuter sur une API déjà activée est sans risque : l’opération est idempotente et ne réinitialise aucune configuration existante.
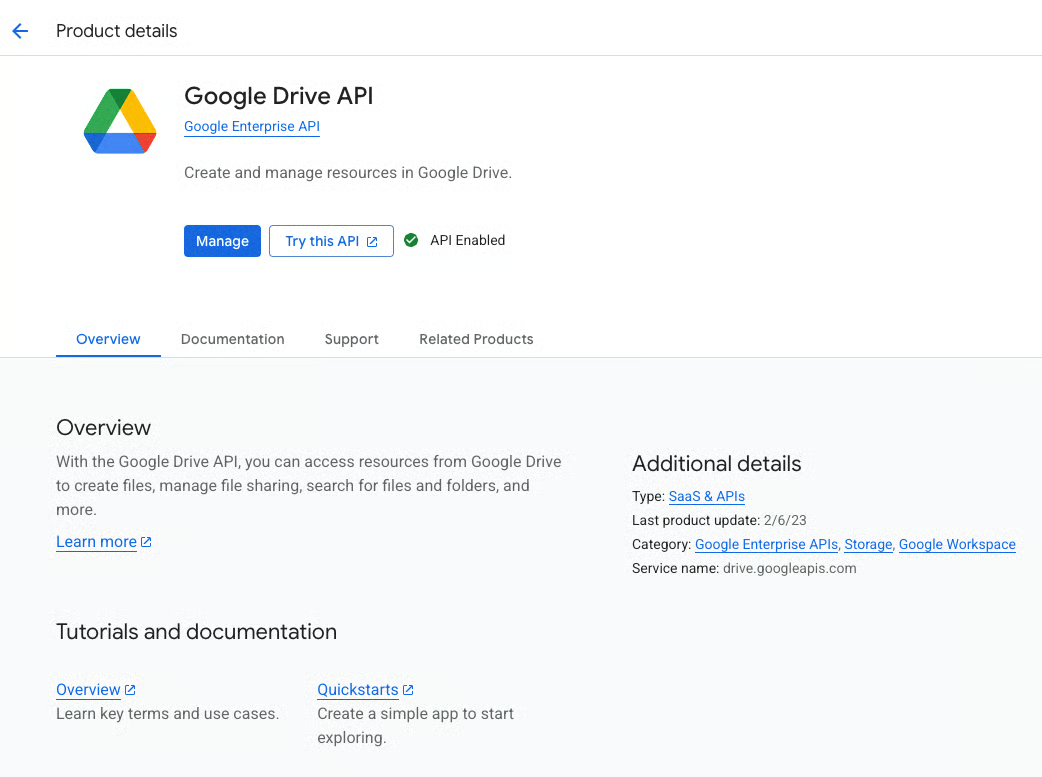
Une fois activée, GCP peut prendre quelques secondes pour propager le changement. Si vous exécutez immédiatement gws drive files list et voyez encore une 403, attendez 30 secondes et réessayez.
La partie CLI étant configurée, mettons en place l’environnement Python qui gère l’embedding et la recherche. Le pipeline RAG est volontairement léger : quatre packages, pas de GPU requis, et tout l’embedding se fait en local sur votre machine.
Commencez par créer un environnement virtuel en exécutant ces commandes l’une après l’autre :
cd /path/to/your/project
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
pip install -r requirements.txt
Puis installez les dépendances depuis requirements.txt :
.txt
chromadb==1.5.5
google-genai==1.70.0
langchain-text-splitters==1.1.1
sentence-transformers==5.3.0
Rôle de chaque package dans le pipeline :
chromadb : base vectorielle locale qui stocke les embeddings dans ./chroma_db sur disque et les recharge aux exécutions suivantes, évitant de ré‑embarquer les fichiers déjà traités.
google-genai : SDK Python officiel pour Gemini. L’app l’utilise pour envoyer le contexte récupéré et la question utilisateur à Gemini 2.5 Flash, avec streaming de la réponse jeton par jeton.
langchain-text-splitters : fournit RecursiveCharacterTextSplitter, qui découpe les documents volumineux en segments qui se chevauchent avant l’embedding. Le chevauchement préserve le contexte aux frontières de segments.
sentence-transformers : exécute le modèle d’embedding en local via DefaultEmbeddingFunction de ChromaDB. Chaque segment est donc vectorisé sur votre machine, sans appel d’API externe.
Remarque : le modèle d’embedding (~90 Mo) est téléchargé automatiquement lors de la première utilisation et mis en cache en local.
Avec l’environnement Python prêt, il ne reste plus qu’à obtenir votre clé d’API Gemini.
Le pipeline RAG utilise Gemini pour la génération de réponse : il prend les extraits récupérés et la question utilisateur, puis renvoie une réponse fondée. Pour vous connecter à Gemini, vous avez besoin d’une clé d’API depuis Google AI Studio.
Connectez‑vous avec votre compte Google, cliquez sur Get API Key, puis Create API Key. Sélectionnez votre projet GCP lorsque cela vous est demandé pour la gestion des quotas et de la facturation. Associez un compte de facturation dans la console GCP, section Facturation, puis sélectionnez Link a billing account.
Une fois votre clé obtenue, exportez‑la en variable d’environnement :
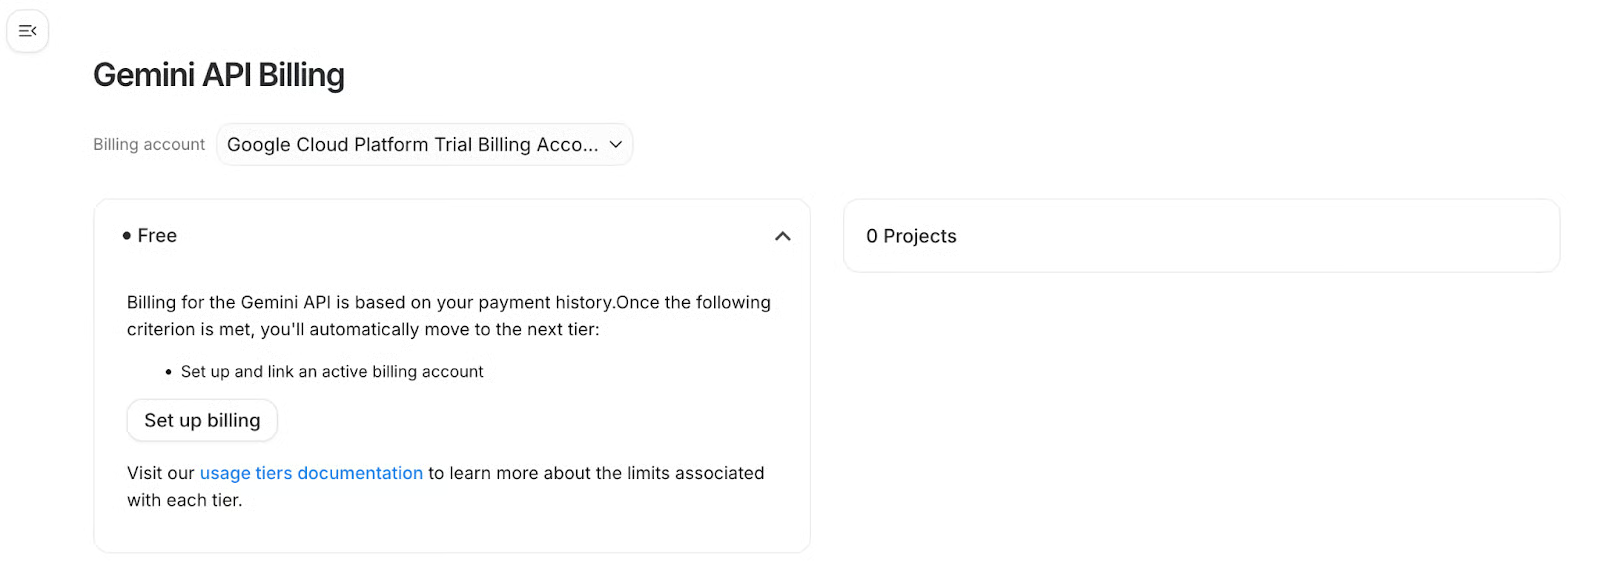
Exportez la clé dans votre terminal :
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"Pour la conserver entre les sessions, exécutez :
echo 'export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"' >> ~/.zshrc
source ~/.zshrc
L’app lit cette clé via os.getenv("GEMINI_API_KEY") au démarrage. Si la variable n’est pas définie, elle vous invitera à coller la clé de manière interactive.
Note sur les modèles : l’app utilise par défaut gemini-2.5-flash. Vous pouvez le remplacer en exportant GEMINI_MODEL="gemini-2.5-pro" si vous souhaitez un meilleur raisonnement sur des documents complexes. Notez que gemini-2.0-flash n’est plus disponible pour les nouvelles clés API ; ne l’utilisez pas ici.
Avec l’authentification, l’API Drive, les dépendances et la clé Gemini en place, nous avons tout ce qu’il faut. Construisons le pipeline.
Connectons maintenant tous les éléments. Nous allons travailler avec quatre fichiers : fetcher.py, vector_store.py, main.py et requirements.txt. Chaque fichier a une responsabilité unique : fetcher.py gère les interactions CLI, vector_store.py s’occupe de l’embedding et de la recherche, et main.py orchestre le flux complet de l’ingestion au chat en streaming.
Lors de la première exécution, gws récupère vos fichiers Drive, le contenu est découpé et embarqué en local, et l’index vectoriel est écrit sur disque dans ./chroma_db. Aux exécutions suivantes, ChromaDB charge l’index, seuls les nouveaux fichiers sont récupérés et embarqués, et la boucle de chat démarre immédiatement sans retraitement.
Passons chaque fichier en revue.
fetcher.py — accès Drive via gwsCe module fait le lien entre la CLI gws et Python. Toutes les interactions Drive — lister des fichiers, exporter du contenu, vérifier l’auth — passent par des appels subprocess à gws, et la sortie JSON structurée est parsée en dictionnaires Python. Résultat : le code Python n’a jamais à gérer les jetons OAuth, les clients HTTP ou les schémas de réponse API ; gws s’en charge et renvoie un JSON propre.
def _gws_json_stdout(stdout: str) -> str:
    if not stdout or "{" not in stdout:
        return stdout or ""
    return stdout[stdout.find("{"):]
Le helper _gws_json_stdout gère un cas subtil où gws émet parfois des lignes de keyring ou de logs avant la charge utile JSON. Ici, un json.loads(result.stdout) direct échouerait ; on supprime donc tout ce qui précède le premier {.
def check_auth() -> bool:
    cmd = ["gws", "drive", "about", "get", "--params", '{"fields": "user"}']
    result = subprocess.run(cmd, capture_output=True, text=True)
    payload = _gws_json_stdout(result.stdout)
    try:
        data = json.loads(payload) if payload.strip() else {}
    except json.JSONDecodeError:
        print("Error checking authentication status (could not parse gws output).")
        return False
    if "error" in data or result.returncode != 0:
        handle_error_output(result.stdout, result.stderr)
        return False
    return True
La fonction check_auth() est appelée au démarrage dans main.py : elle effectue un appel Drive léger et inspecte la réponse. Si l’auth est rompue ou que des portées manquent, l’app s’arrête proprement avant toute ingestion.
Le gestionnaire d’erreurs intercepte aussi des modes d’échec spécifiques et affiche des messages actionnables :
def handle_error_output(stdout, stderr):
    output = _gws_json_stdout(stdout or "") or (stderr or "")
    if "insufficientPermissions" in output or "unauthenticated" in output.lower():
        print("Please run: gws auth login -s drive")
    elif "serviceusage.services.use" in output or "serviceUsageConsumer" in output:
        print(
            "GCP quota project error: run gws auth setup --project YOUR_PROJECT_ID --login"
        )
    else:
        print(f"API Error: {output}")
Le récupérateur de liste cible uniquement les types MIME exportables en texte :
def fetch_document_list(limit=10) -> list[dict]:
    q = (
        "(mimeType='text/plain' or mimeType='application/vnd.google-apps.document' "
        "or mimeType='application/vnd.google-apps.spreadsheet') and trashed=false"
    )
    cmd = [
        "gws", "drive", "files", "list",
        "--params",
        json.dumps({"q": q, "pageSize": limit, "orderBy": "modifiedTime desc"}),
    ]
La requête filtre les fichiers texte, Google Docs et Google Sheets, triés par date de modification décroissante. Les fichiers binaires (PDF, images) sont exclus car ils ne s’exportent pas proprement en texte via cette approche.
Le téléchargement varie selon le type MIME :
def download_document(file_id: str, mime_type: str) -> str:
    fd, out_path = tempfile.mkstemp(prefix="gws_", suffix=".bin")
    os.close(fd)
    try:
        if mime_type == "application/vnd.google-apps.document":
            cmd = ["gws", "drive", "files", "export",
                   "--params", json.dumps({"fileId": file_id, "mimeType": "text/plain"}),
                   "-o", out_path]
        elif mime_type == "application/vnd.google-apps.spreadsheet":
            cmd = ["gws", "drive", "files", "export",
                   "--params", json.dumps({"fileId": file_id, "mimeType": "text/csv"}),
                   "-o", out_path]
        else:
            cmd = ["gws", "drive", "files", "get",
                   "--params", json.dumps({"fileId": file_id, "alt": "media"}),
                   "-o", out_path]
        ...
        with open(out_path, "rb") as f:
            return f.read().decode("utf-8", errors="replace")
    finally:
        os.unlink(out_path)
gws écrit les octets du fichier exporté sur disque via -o, pas sur stdout. Stdout transporte les métadonnées JSON. Le code utilise un fichier temporaire pour capter la sortie binaire, la lit, puis la nettoie dans un bloc finally pour supprimer systématiquement le temporaire, même en cas d’erreur.
vector_store.py — embeddings locaux avec ChromaDBCe module découpe le texte entrant, génère des embeddings en local via Sentence Transformers, les persiste sur disque avec ChromaDB et expose une méthode query() simple, appelée par la boucle de chat pour chaque question.
class VectorStore:
    def __init__(self, persist_directory="./chroma_db"):
        self.client = chromadb.PersistentClient(path=persist_directory)
        self.collection = self.client.get_or_create_collection(
            name="drive_documents",
            embedding_function=embedding_functions.DefaultEmbeddingFunction()
        )
        self.text_splitter = RecursiveCharacterTextSplitter(
            chunk_size=1000,
            chunk_overlap=200
        )
PersistentClient écrit l’index vectoriel dans ./chroma_db et le recharge aux exécutions suivantes sans réingestion, sauf si vous supprimez le répertoire. DefaultEmbeddingFunction utilise Sentence Transformers en local ; les embeddings sont donc calculés sur votre machine à coût marginal nul.
Le splitter utilise chunk_size=1000 et chunk_overlap=200 pour préserver le contexte aux frontières de segments lorsque des phrases se retrouvent scindées.
def add_document(self, file_id: str, filename: str, text: str):
    chunks = self.text_splitter.split_text(text)
    ids = [f"{file_id}_{i}" for i in range(len(chunks))]
    metadatas = [{"source": filename, "file_id": file_id} for _ in chunks]
    self.collection.upsert(documents=chunks, metadatas=metadatas, ids=ids)
    print(f"-> Added {len(chunks)} chunks for {filename}")
Ici, upsert signifie que relancer le pipeline sur un fichier déjà ingéré met à jour les segments plutôt que de lever une erreur d’ID dupliqué.
def document_exists(self, file_id: str) -> bool:
    try:
        results = self.collection.get(where={"file_id": file_id}, limit=1)
        return len(results["ids"]) > 0
    except Exception:
        return False
Ce pré‑contrôle rapide dans la boucle d’ingestion de main.py évite de retélécharger les fichiers déjà embarqués, rendant les exécutions suivantes quasi instantanées.
main.py — ingestion, recherche et chat en streamingLe fichier main.py réalise les vérifications d’auth, pilote l’ingestion, initialise le client Gemini et gère la boucle de chat interactive. Il est volontairement fin, la lourde charge étant déléguée à fetcher.py et vector_store.py.
def setup_gemini():
    api_key = os.getenv("GEMINI_API_KEY")
    if not api_key:
        print("Please enter your GEMINI_API_KEY (get one from Google AI Studio).")
        api_key = input("Key: ").strip()
    return genai.Client(api_key=api_key)
Si GEMINI_API_KEY n’est pas définie, l’app invite l’utilisateur au lieu de planter. Vous pouvez définir votre GEMINI_API_KEY comme à l’étape précédente.
def ingest_documents(store, limit=10):
    files = fetch_document_list(limit)
    for file in files:
        file_id = file.get("id")
        if store.document_exists(file_id):
            print(f"Skipping {file.get('name')} (already in vector store)...")
            continue
        content = download_document(file_id, file.get("mimeType"))
        if content:
            store.add_document(file_id, file.get("name"), content)
Le contrôle document_exists est le mécanisme d’ingestion incrémentale : à chaque exécution, seuls les nouveaux fichiers sont téléchargés et embarqués. La boucle de chat récupère les 3 segments les plus similaires sémantiquement et annote chacun avec le nom du fichier source :
def chat_loop(model, store):
    while True:
        query = input("\nYou: ")
        results = store.query(query, n_results=3)
        documents = results.get("documents", [[]])[0]
        metadatas = results.get("metadatas", [[]])[0]
        context_parts = []
        for doc, meta in zip(documents, metadatas):
            source = meta.get("source", "Unknown")
            context_parts.append(f"Source: {source}\nText:\n{doc}\n")
        full_context = "\n---\n".join(context_parts)
        prompt = f"""You are a helpful assistant. Answer the user's question based ONLY on the following context from their Google Drive. If you cannot answer from the context, say "I don't know based on your documents."
Context:
{full_context}
Question: {query}
"""
        model_name = os.getenv("GEMINI_MODEL", "gemini-2.5-flash")
        response = model.models.generate_content_stream(model=model_name, contents=prompt)
        for chunk in response:
            if chunk.text:
                print(chunk.text, end="", flush=True)
        print()
Le prompt ci‑dessus est strictement fondé : le LLM doit répondre uniquement à partir du contexte fourni et dire « I don't know » si la réponse n’y figure pas. Cela évite les hallucinations d’informations absentes de votre Drive. Les réponses sont diffusées jeton par jeton via generate_content_stream, pour un affichage immédiat.
Une fois les quatre fichiers en place, lancez l’app avec :
python main.pyÀ la première exécution, l’app vérifie l’auth, initialise ChromaDB, télécharge le modèle d’embedding s’il n’est pas déjà en cache, récupère jusqu’à 10 fichiers Drive, les embarque et les stocke, puis vous bascule dans la boucle de chat. Vous verrez une progression incrémentale pour chaque fichier ingéré :
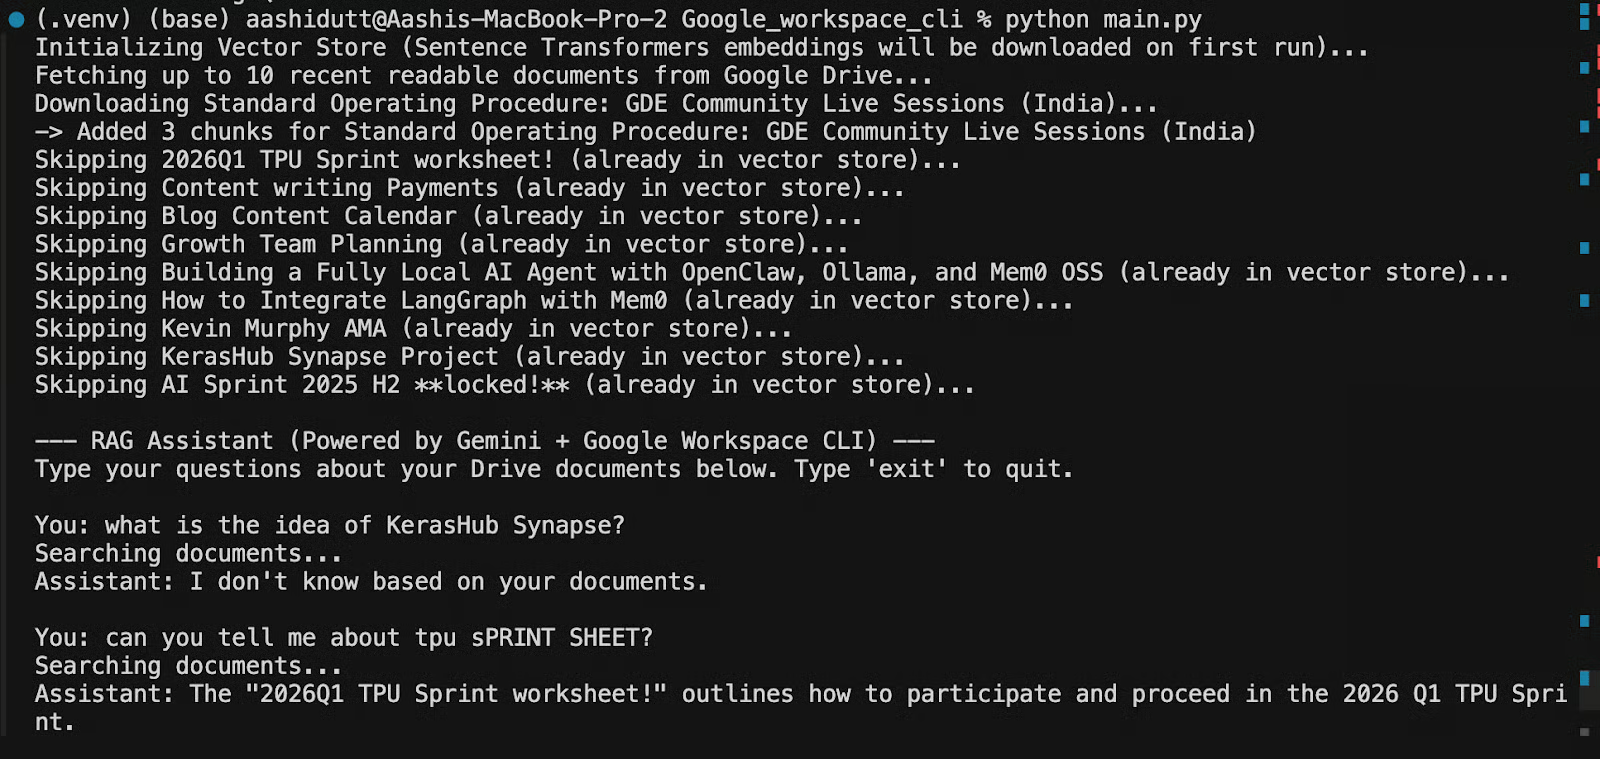
Aux exécutions suivantes, ChromaDB charge l’index persistant, les fichiers déjà ingérés sont ignorés et vous atteignez l’invite de chat presque instantanément.
Pour ré‑ingérer tout depuis zéro (par exemple après avoir ajouté de nouveaux fichiers Drive à inclure), supprimez le répertoire ChromaDB puis relancez :
rm -rf ./chroma_db
python main.py
Pour vérifier l’auth indépendamment sans lancer tout le pipeline, exécutez directement fetcher.py :
python fetcher.pyCela exécute check_auth() et affiche une liste de vos fichiers Drive pour confirmer que la CLI, l’OAuth et l’API Drive fonctionnent avant de lancer une ingestion complète.
L’assistant RAG que nous avons construit avec Google Workspace CLI est volontairement minimal : gws récupère, Sentence Transformers embarque en local, ChromaDB stocke, Gemini diffuse la réponse. Quatre fichiers, zéro coût d’embedding dans le cloud, ingestion incrémentale à chaque exécution. L’architecture s’étend proprement si vous souhaitez ajouter Gmail et Agenda comme sources d’ingestion, opter pour un modèle Gemini plus grand ou remplacer la boucle de chat par un agent LangGraph. Les fondations restent les mêmes.
Apprenez avec DataCamp
Cours
Cours
Cours