
Last chance! 50% off DataCamp Premium
Sale ends in
Google ने डेवलपर्स के लिए सचमुच दिलचस्प चीज़ जारी की है। एक Google Workspace कमांड-लाइन इंटरफेस जो आपको एक ही टूल में आपके पूरे Google Workspace—Drive, Gmail, Calendar, Sheets, Docs, Chat, और अधिक—तक संरचित, स्क्रिप्टेबल एक्सेस देता है।
कोडबेस लगभग पूरी तरह Rust (99.3%) में है, लेकिन इसे npm के जरिए प्री-बिल्ट नेटिव बाइनरी के रूप में वितरित किया गया है, इसलिए आपको Rust टूलचेन इंस्टॉल करने की ज़रूरत नहीं पड़ती।
इस ट्यूटोरियल में, आप Google Workspace CLI को शून्य से सेटअप करेंगे, इसे ऑथेंटिकेट करेंगे और एक Gemini-समर्थित RAG असिस्टेंट बनाएंगे जो आपको प्राकृतिक भाषा में अपने Drive फ़ाइलों पर क्वेरी करने देता है। अंत तक, आपके पास होगा:
gws इंस्टॉल और आपके Drive के साथ ऑथेंटिकेटेड
ChromaDB, Sentence Transformers, और Gemini SDK वाला एक Python वर्चुअल एन्वायरनमेंट
एक कार्यशील लोकल RAG पाइपलाइन जो gws से फ़ाइलें लाती है, उन्हें लोकल मॉडल से एम्बेड करती है, और Gemini 2.5 Flash के साथ उत्तर स्ट्रीम करती है
नोट: यह Google का आधिकारिक रूप से समर्थित प्रोडक्ट नहीं है।
Google Workspace CLI (gws) आपके पूरे Google Workspace इकोसिस्टम के लिए एक AI-ऑप्टिमाइज़्ड कमांड-लाइन टूल है। इसे खास बनाता है:
डायनेमिक कमांड डिस्कवरी: हार्डकोडेड कमांड ट्री शिप करने के बजाय, gws रनटाइम पर Google के Discovery Service को पढ़ता है। जब Google नए API एंडपॉइंट्स जोड़ता है, तो CLI बिना वर्ज़न बंप के उन्हें अपने-आप अपना लेता है।
एजेंट-नेटिव डिज़ाइन: CLI 100+ प्री-बिल्ट एजेंट स्किल्स और 50 क्यूरेटेड रेसिपीज़ के साथ आती है जो ईमेल का सारांश बनाती हैं, Drive फ़ाइलें मूव करती हैं, कैलेंडर इवेंट्स बनाती हैं, आदि। हर आउटपुट संरचित JSON होता है, ताकि LLMs इसे सीधे कंज्यूम कर सकें।
नेेटिव MCP सर्वर सपोर्ट: gws को लोकल MCP सर्वर की तरह चलाएँ और अपने AI एजेंट को बिना कोई API क्लाइंट लिखे, पूरा Workspace टूल एक्सेस दें।
Model Armor इंटेग्रेशन: ऐसे प्रोडक्शन एजेंट्स के लिए जो यूज़र-नियंत्रित कंटेंट पढ़ते हैं, आप API रिस्पॉन्सेज़ को Google Cloud Model Armor से पाइप कर सकते हैं ताकि आपका LLM देखने से पहले प्रॉम्प्ट इंजेक्शन के विरुद्ध सैनिटाइज़ हो जाए।
आप पूरी स्किल लाइब्रेरी यहां ब्राउज़ कर सकते हैं: github.com/googleworkspace/cli/blob/main/docs/skills.md.
इस ट्यूटोरियल में, हम RAG असिस्टेंट को चरणबद्ध तरीके से बनाएंगे। उच्च स्तर पर, ऐप ये करता है:
gws CLI का उपयोग करके आपके Google Drive के विरुद्ध ऑथेंटिकेट करता है और आपके हाल में मॉडिफ़ाए गए Docs, Sheets, और टेक्स्ट फ़ाइलें लाता है
हर डॉक्यूमेंट को चंक्स में तोड़ता है और Sentence Transformers के जरिए ChromaDB पर लोकली एम्बेड करता है
वेक्टर इंडेक्स को डिस्क पर बनाए रखता है ताकि अगली रन में पहले से इनजेस्टेड फ़ाइलों को स्किप कर सीधा चैट पर चला जाए
एक प्राकृतिक-भाषा प्रश्न लेता है, ChromaDB से टॉप-3 सबसे प्रासंगिक चंक्स निकालता है, और एक ग्राउंडेड कॉन्टेक्स्ट प्रॉम्प्ट बनाता है
आपके टर्मिनल में Gemini 2.5 Flash से उद्धृत, केवल-कॉन्टेक्स्ट पर आधारित उत्तर टोकन-दर-टोकन स्ट्रीम करता है
आइए इसे चरणबद्ध तरीके से बनाते हैं।
पूरा ट्यूटोरियल कोड: https://github.com/AashiDutt/Google-Workspace-CLI-Demo
CLI को npm पैकेज के रूप में वितरित किया गया है जो प्री-बिल्ट Rust बाइनरी को रैप करता है। Rust टूलचेन की ज़रूरत नहीं।
npm install -g @googleworkspace/cliइंस्टॉलेशन वेरिफ़ाई करने के लिए ये कमांड एक-एक करके चलाएँ:
gws --version
which gws
अगर इंस्टॉल के बाद gws नहीं मिलता, तो सुनिश्चित करें कि आपका npm global bin डायरेक्टरी आपके PATH पर है।
CLI GCP प्रोजेक्ट के OAuth क्लाइंट के जरिए ऑथेंटिकेट करता है, इसलिए लॉगिन से पहले आपको एक प्रोजेक्ट चाहिए। GCP से प्रोजेक्ट बनाने या चुनने के लिए:
OAuth क्रेडेंशियल सेट करें:
APIs & Services पर जाएँ और Credentials चुनें
Create Credentials पर क्लिक करें और OAuth 2.0 Client ID पर जाएँ
एप्लिकेशन प्रकार के रूप में Desktop app चुनें
Client ID और Client Secret नोट करें जिनका उपयोग हम gws auth setup के लिए करेंगे।
CLI OAuth को एक अस्थायी localhost सर्वर शुरू करके पूरा करता है। Desktop app क्लाइंट मनमाने localhost पोर्ट्स को अपने-आप संभाल लेते हैं। Web application क्लाइंट्स में आपको हर http://localhost:PORT को Authorized redirect URIs सूची में मैन्युअली जोड़ना पड़ता है।
अगर आप Web application क्लाइंट का उपयोग करते हैं और "Access blocked: This app's request is invalid" दिखता है, तो Credentials में जाएँ, OAuth client पर क्लिक करें, फिर Authorized redirect URIs पर जाकर एरर में दिखाए गए बिल्कुल वही http://localhost:PORT URL जोड़ें।
gws को अपने GCP प्रोजेक्ट से जोड़ने के लिए, पहले अपने OAuth क्रेडेंशियल्स को एन्वायरनमेंट वेरिएबल्स के रूप में एक्सपोर्ट करें ताकि सेटअप विज़ार्ड उन्हें अपने-आप उठा ले:
export GOOGLE_WORKSPACE_CLI_CLIENT_ID="CLIENT_ID"
export GOOGLE_WORKSPACE_CLI_CLIENT_SECRET="CLIENT_SECRET"
फिर चलाएँ:
gws auth setup --project YOUR_PROJECT_ID --login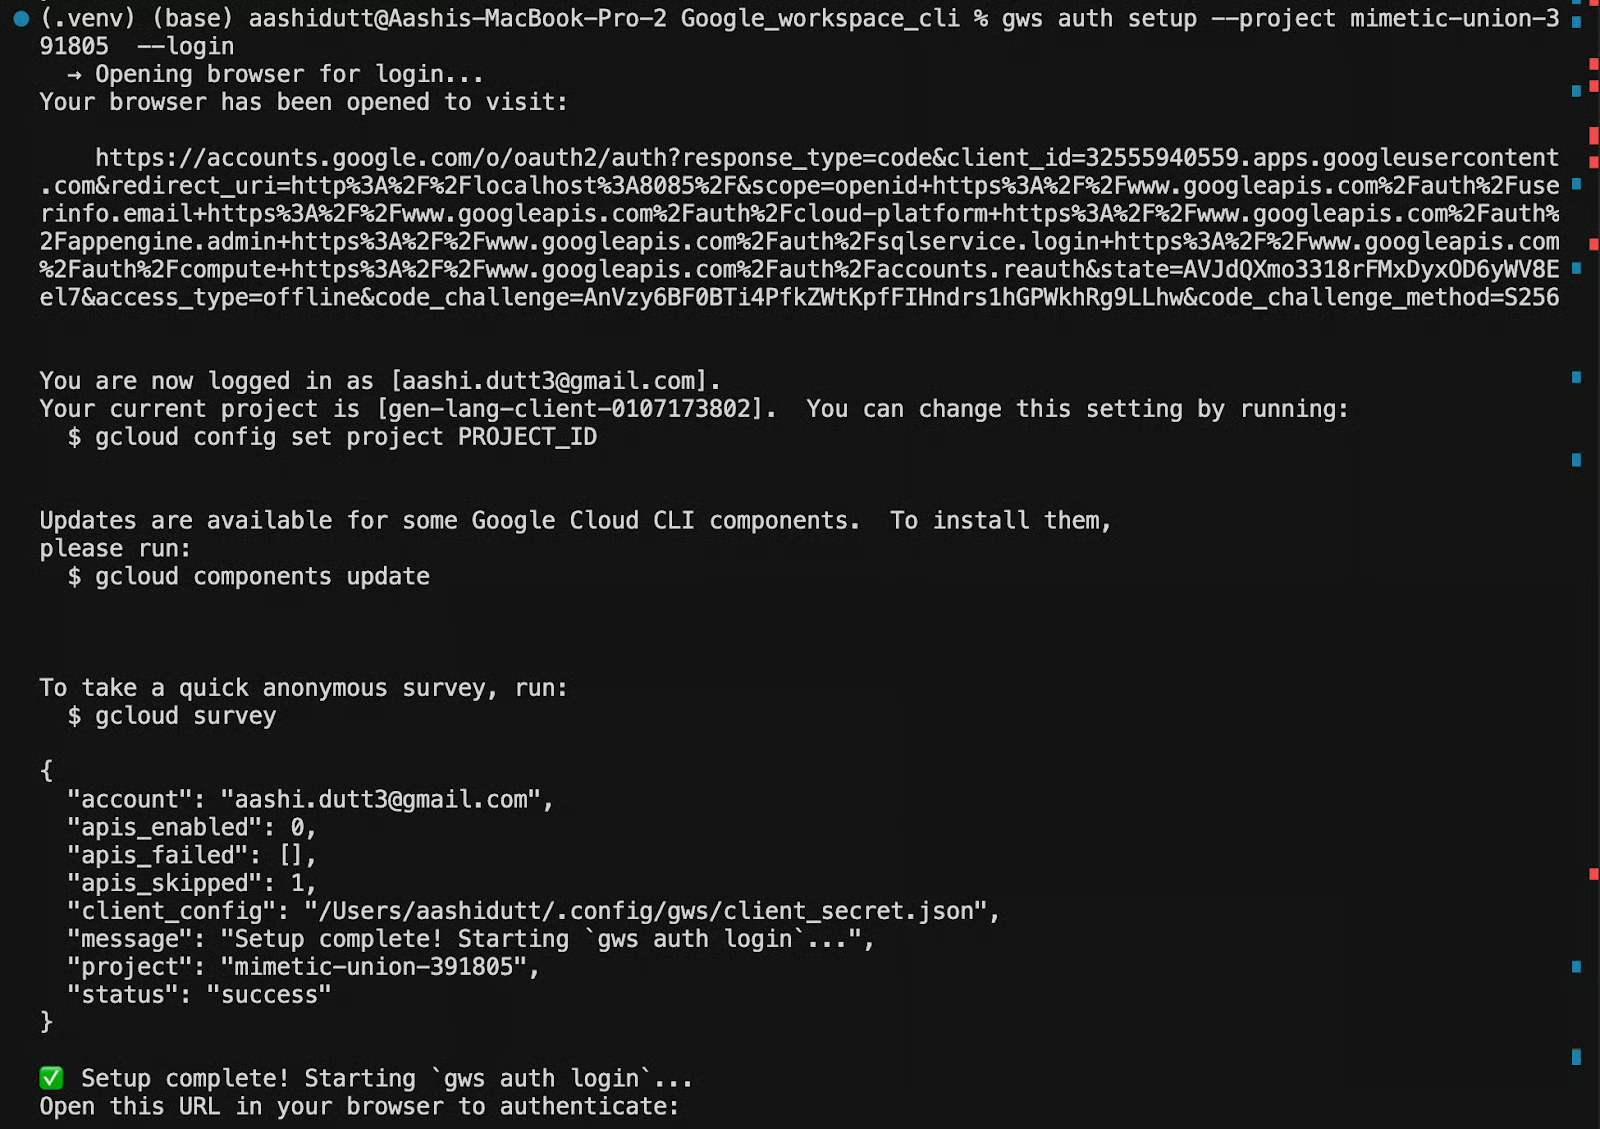
सेटअप विज़ार्ड ये करेगा:
पूरा होने पर, आप देखेंगे: Setup complete!
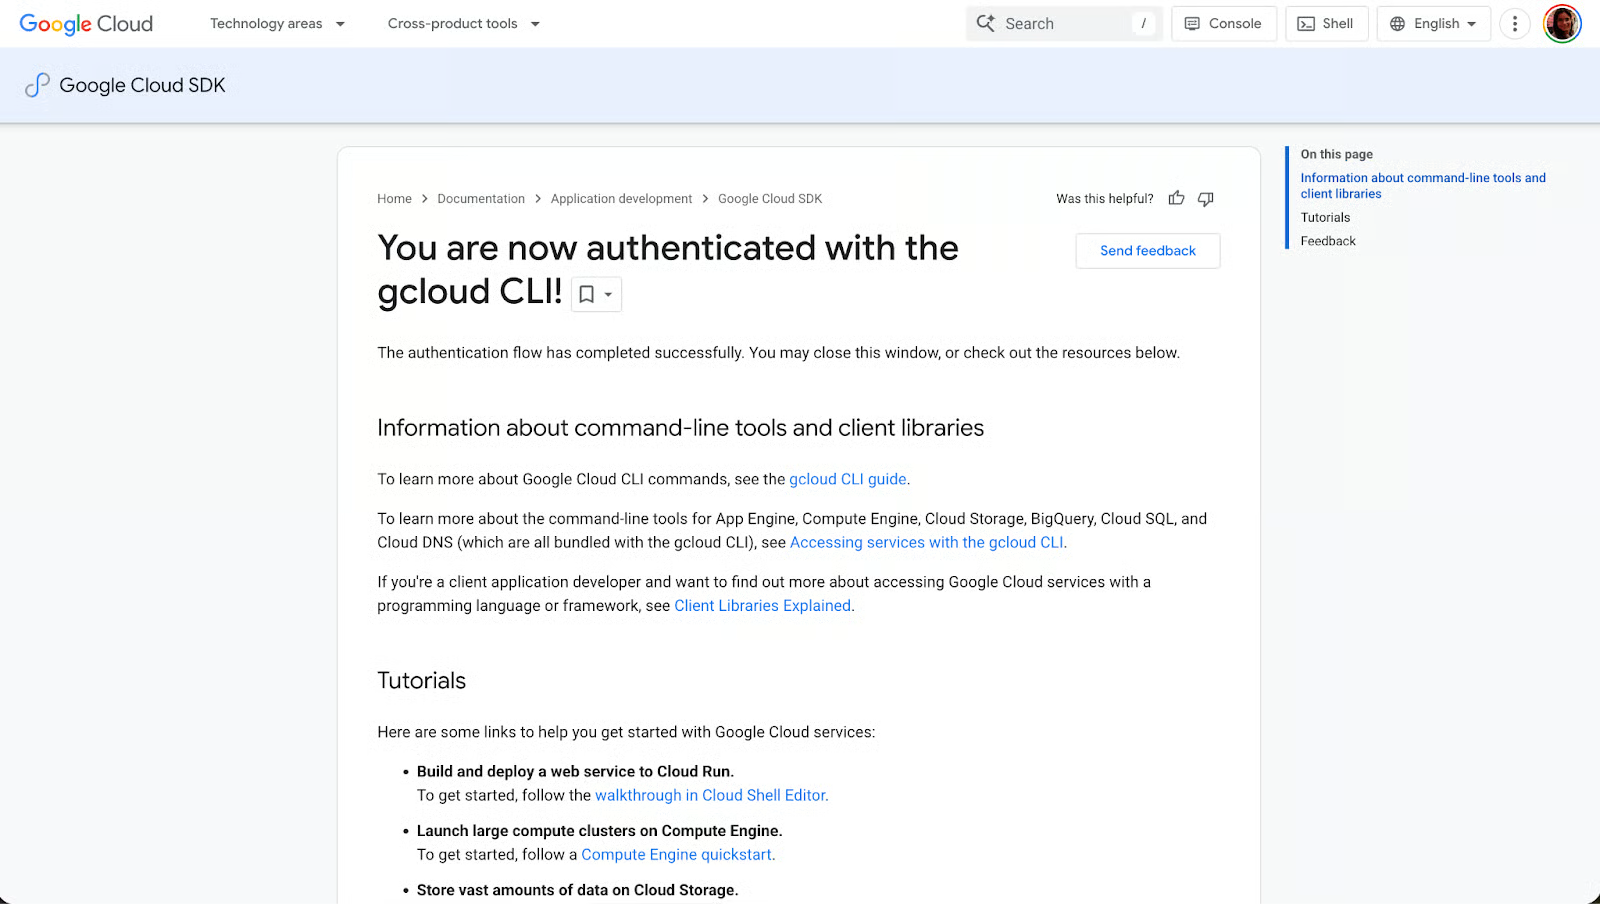
क्रेडेंशियल्स ~/.config/gws/ में स्टोर होते हैं। यह सुनिश्चित करने के लिए कि सब कुछ सही से जुड़ा है, चलाएँ:
gws auth statusयह ऑथेंटिकेटेड अकाउंट, लिंक्ड GCP प्रोजेक्ट, और एक्टिव स्कोप्स प्रिंट करता है। अगर कुछ गलत लगे, तो कॉन्फ़िग फाइलें मैन्युअली एडिट करने के बजाय सही फ़्लैग्स के साथ gws auth setup फिर से चलाएँ।
कोई भी Python लिखने से पहले, टर्मिनल से एक जल्दी-सा sanity चेक करना फायदेमंद है ताकि पक्का हो कि CLI ऑथेंटिकेटेड है और आपके Drive से बात कर सकता है। आइए आपकी पाँच सबसे हाल की Drive फ़ाइलों को सूचीबद्ध करने के लिए यह कमांड चलाएँ:
gws drive files list --params '{"pageSize": 5}'फ्लैग --params एक JSON स्ट्रिंग लेता है जो सीधे Drive API के क्वेरी पैरामीटर्स से मैप होता है। यहाँ, pageSize: 5 रिस्पॉन्स को पाँच नतीजों तक सीमित करता है—कनेक्टिविटी की पुष्टि के लिए काफी, बिना पूरा Drive डंप किए।
अगर ऑथेंटिकेशन सही है, तो आपको ऐसा संरचित JSON रिस्पॉन्स मिलेगा:
{
  "files": [
    {
      "id": "1BxiMVs0XRA5nFMdKvBdBZjgmUUqptlbs74OgVE2upms",
      "name": "Q3 Strategy Doc",
      "mimeType": "application/vnd.google-apps.document"
    },
    ...
  ]
}
gws का हर रिस्पॉन्स संरचित JSON होता है—न parsing, न scraping, न नाज़ुक टेक्स्ट आउटपुट।
अगर इसके बजाय आपको serviceusage.services.use का उल्लेख करता “403 error” दिखे, तो इसका मतलब है कि आपके OAuth क्रेडेंशियल्स उस GCP प्रोजेक्ट की ओर इशारा कर रहे हैं जिसमें बिलिंग सक्षम नहीं है। सब कुछ फिर से लिंक करने के लिए सही प्रोजेक्ट ID के साथ सेटअप फिर चलाएँ:
gws auth setup --project YOUR_PROJECT_ID --loginDrive एक्सेस की पुष्टि हो जाने पर, हम API सक्षम करने और पाइथन साइड की पाइपलाइन बनाना शुरू करने के लिए तैयार हैं।
इस बिंदु पर, gws आपके GCP प्रोजेक्ट के विरुद्ध ऑथेंटिकेट कर सकता है, लेकिन यह अभी Drive फ़ाइल कंटेंट नहीं पढ़ सकता। GCP ऑथेंटिकेशन (आप कौन हैं) को API सक्रियण (आपका प्रोजेक्ट किन सेवाओं का उपयोग करता है) से अलग रखता है। वैध OAuth क्रेडेंशियल्स होने पर भी, फ़ाइल कंटेंट लाने का कोई भी प्रयास तब तक 403 accessNotConfigured लौटाएगा जब तक प्रोजेक्ट पर Drive API स्पष्ट रूप से सक्षम न हो।
इसे सक्षम करने के लिए, ब्राउज़र में यह URL खोलें, [PROJECT_ID] को अपने वास्तविक प्रोजेक्ट ID से बदलें और Enable पर क्लिक करें:
https://console.developers.google.com/apis/api/drive.googleapis.com/overview?project=[PROJECT_ID]
वैकल्पिक रूप से, अगर आपके पास gcloud CLI है, तो आप इसे सीधे टर्मिनल से सक्षम कर सकते हैं:
gcloud services enable drive.googleapis.com --project YOUR_PROJECT_IDदोनों तरीके एक ही काम करते हैं। पहले से सक्षम API पर इनमें से कोई भी चलाना सुरक्षित है क्योंकि ऑपरेशन idempotent है और मौजूदा कॉन्फ़िगरेशन रीसेट नहीं करेगा।
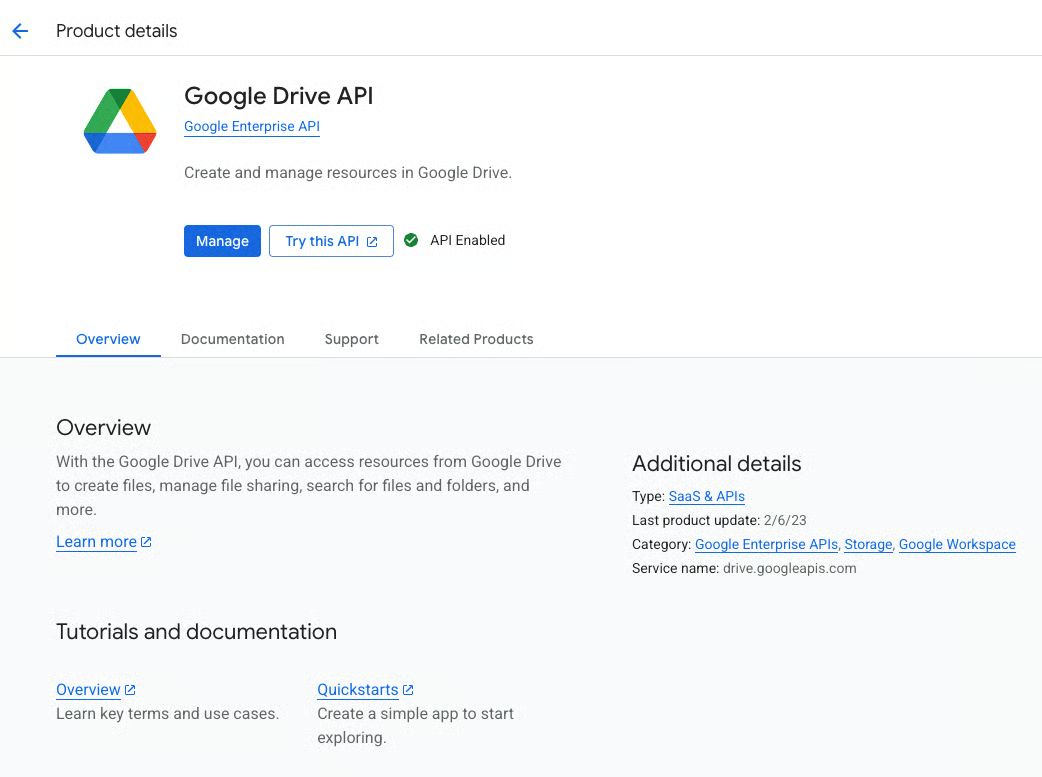
सक्षम करने के बाद, GCP को बदलाव प्रसारित करने में कुछ सेकंड लग सकते हैं। अगर आप तुरंत gws drive files list चलाते हैं और फिर भी 403 दिखता है, तो 30 सेकंड रुकें और दोबारा प्रयास करें।
CLI साइड पूरी तरह कॉन्फ़िगर होने के बाद, अब हम Python एन्वायरनमेंट सेट कर सकते हैं जो एम्बेडिंग और रिट्रीवल लॉजिक संभालेगा। RAG पाइपलाइन जानबूझकर हल्की है—चार पैकेज, GPU की ज़रूरत नहीं, और सारी एम्बेडिंग आपके मशीन पर लोकली होती है।
वर्चुअल एन्वायरनमेंट बनाने के लिए ये कमांड एक-एक करके चलाएँ:
cd /path/to/your/project
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
pip install -r requirements.txt
फिर requirements.txt से डिपेंडेंसीज़ इंस्टॉल करें:
.txt
chromadb==1.5.5
google-genai==1.70.0
langchain-text-splitters==1.1.1
sentence-transformers==5.3.0
हर पैकेज पाइपलाइन में यह योगदान देता है:
chromadb: यह लोकल वेक्टर डेटाबेस है, जो डॉक्यूमेंट एम्बेडिंग्स को डिस्क पर ./chroma_db में स्टोर करता है और अगली रन पर लोड करता है, ताकि ऐप को पहले से प्रोसेस की गई फ़ाइलों को दोबारा एम्बेड न करना पड़े।
google-genai: यह Gemini के लिए आधिकारिक Python SDK है। ऐप इसे Gemini 2.5 Flash को रिट्रीव्ड कॉन्टेक्स्ट और यूज़र के प्रश्न भेजने तथा रिस्पॉन्स टोकन-दर-टोकन स्ट्रीम करने के लिए उपयोग करता है।
langchain-text-splitters: यह पैकेज RecursiveCharacterTextSplitter देता है, जो बड़े डॉक्यूमेंट्स को एम्बेडिंग से पहले ओवरलैपिंग चंक्स में तोड़ता है। ओवरलैप सुनिश्चित करता है कि चंक सीमाओं पर वाक्य अपने कॉन्टेक्स्ट से अलग न हों।
sentence-transformers: Sentence Transformers ChromaDB के DefaultEmbeddingFunction के जरिए लोकली एम्बेडिंग मॉडल चलाता है। यानी हर डॉक्यूमेंट चंक मशीन पर ही एम्बेड होता है, कोई बाहरी API कॉल नहीं।
नोट: एम्बेडिंग मॉडल (~90MB) पहली बार उपयोग पर अपने-आप डाउनलोड होकर लोकली कैश हो जाता है।
Python एन्वायरनमेंट तैयार होने पर, कोड लिखने से पहले आख़िरी चीज़ है अपना Gemini API की लेना।
RAG पाइपलाइन उत्तर उत्पन्न करने की परत के रूप में Gemini का उपयोग करती है, क्योंकि यह रिट्रीव्ड डॉक्यूमेंट चंक्स और यूज़र के प्रश्न लेती है और एक ग्राउंडेड रिस्पॉन्स स्ट्रीम करती है। Gemini से कनेक्ट होने के लिए, आपको Google AI Studio से API की चाहिए।
अपने Google अकाउंट से साइन इन करें, Get API Key पर क्लिक करें, फिर Create API Key चुनें। प्रॉम्प्ट होने पर अपना GCP प्रोजेक्ट चुनें ताकि कोटा और बिलिंग लिंक हो सके। GCP डैशबोर्ड में Billing के अंतर्गत एक बिलिंग अकाउंट लिंक करें और Link a billing account चुनें।
की मिल जाने पर, उसे एन्वायरनमेंट वेरिएबल के रूप में एक्सपोर्ट करें:
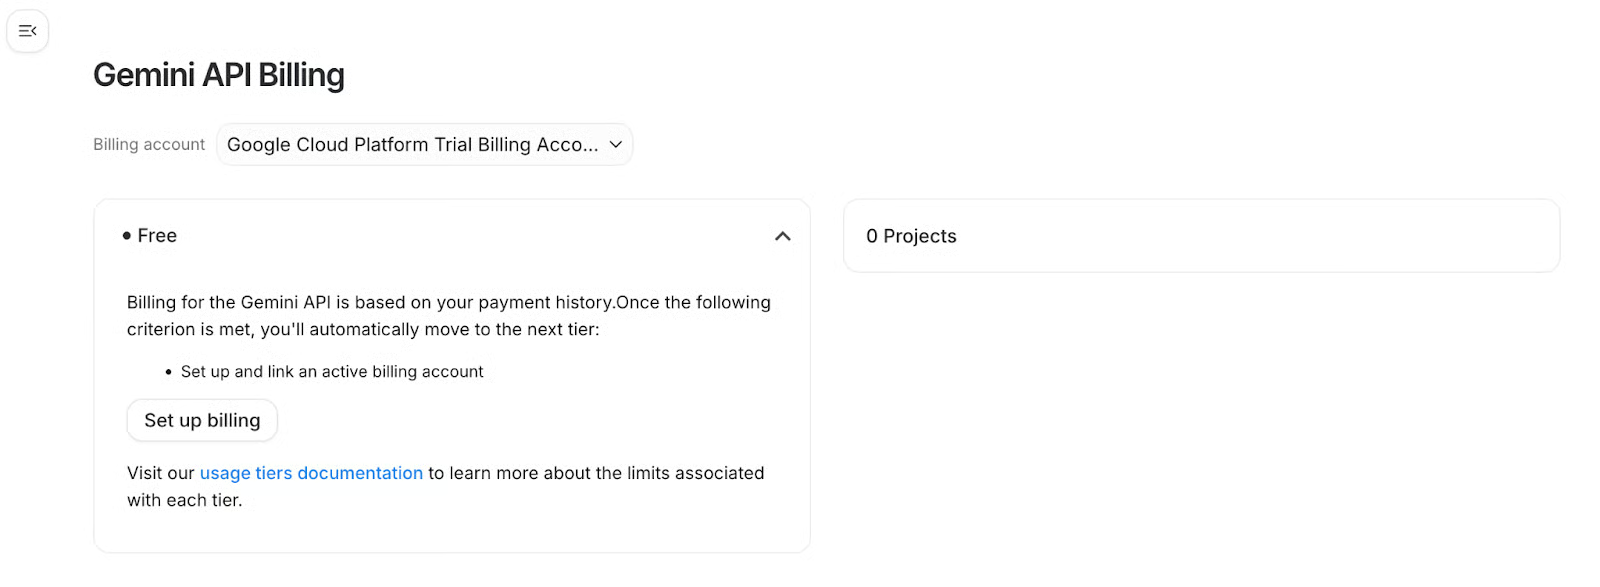
टर्मिनल में की एक्सपोर्ट करें:
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"इसे टर्मिनल सेशंस में स्थायी रखने के लिए, चलाएँ:
echo 'export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"' >> ~/.zshrc
source ~/.zshrc
ऐप स्टार्टअप पर os.getenv("GEMINI_API_KEY") के जरिए यह की पढ़ता है। अगर वेरिएबल सेट नहीं है, तो यह आपको इंटरैक्टिव रूप से की पेस्ट करने के लिए प्रॉम्प्ट करेगा।
मॉडल नोट: ऐप डिफ़ॉल्ट रूप से gemini-2.5-flash का उपयोग करता है। अगर आप जटिल डॉक्यूमेंट्स पर अधिक मज़बूत रीज़निंग चाहते हैं, तो GEMINI_MODEL="gemini-2.5-pro" एक्सपोर्ट करके इसे ओवरराइड कर सकते हैं। ध्यान दें कि gemini-2.0-flash नए API कीज़ के लिए रिटायर हो चुका है, इसलिए इसे यहाँ उपयोग न करें।
ऑथ, Drive API, डिपेंडेंसीज़, और Gemini की—all सेट होने पर, हमारे पास सब कुछ है। आइए पाइपलाइन बनाते हैं।
अब सब कुछ एक साथ वायर करते हैं। हम चार फ़ाइलों के साथ काम करेंगे—fetcher.py, vector_store.py, main.py, और requirements.txt। हर फ़ाइल की एकल ज़िम्मेदारी है—fetcher.py सारा CLI इंटरैक्शन संभालता है, vector_store.py एम्बेडिंग और रिट्रीवल का मालिक है, और main.py इन्जेशन से लेकर स्ट्रीमिंग चैट तक पूरा लूप ऑर्केस्ट्रेट करता है।
पहली रन पर, gws आपकी Drive फ़ाइलें लाता है, कंटेंट को चंक कर लोकली एम्बेड करता है, और वेक्टर इंडेक्स डिस्क पर ./chroma_db में लिखता है। अगली रन पर, ChromaDB डिस्क से लोड हो जाता है, केवल नई फ़ाइलें फ़ेच और एम्बेड होती हैं, और चैट लूप बिना री-प्रोसेसिंग के तुरंत शुरू हो जाता है।
आइए हर फ़ाइल को देखें।
fetcher.py — gws के जरिए Drive एक्सेसयह मॉड्यूल gws CLI और Python के बीच पुल है। फ़ाइल सूचीबद्ध करना, कंटेंट एक्सपोर्ट करना, और ऑथ चेक करना जैसे सभी Drive इंटरैक्शन gws को subprocess कॉल्स के जरिए होते हैं, और संरचित JSON आउटपुट को Python डिक्शनरीज़ में पार्स किया जाता है। नतीजा यह है कि Python कोड को सीधे OAuth टोकन, HTTP क्लाइंट्स, या API रिस्पॉन्स स्कीमाज़ से नहीं जूझना पड़ता; gws यह सब संभालता है और साफ़ JSON वापस देता है।
def _gws_json_stdout(stdout: str) -> str:
    if not stdout or "{" not in stdout:
        return stdout or ""
    return stdout[stdout.find("{"):]
हेल्पर _gws_json_stdout उस सूक्ष्म समस्या को संभालता है जहां gws कभी-कभी JSON पेलोड से पहले keyring या लॉगिंग लाइनें इमिट करता है। यहाँ सीधे json.loads(result.stdout) कॉल करना फेल हो जाएगा, इसलिए यह पहले { से पहले की हर चीज़ हटा देता है।
def check_auth() -> bool:
    cmd = ["gws", "drive", "about", "get", "--params", '{"fields": "user"}']
    result = subprocess.run(cmd, capture_output=True, text=True)
    payload = _gws_json_stdout(result.stdout)
    try:
        data = json.loads(payload) if payload.strip() else {}
    except json.JSONDecodeError:
        print("Error checking authentication status (could not parse gws output).")
        return False
    if "error" in data or result.returncode != 0:
        handle_error_output(result.stdout, result.stderr)
        return False
    return True
check_auth() फ़ंक्शन main.py के स्टार्टअप पर कॉल होता है जो एक हल्का-सा Drive API कॉल करता है और रिस्पॉन्स को जांचता है। अगर ऑथ टूटा हो या स्कोप्स मिसिंग हों, तो ऐप इन्जेशन की कोशिश करने से पहले साफ़-साफ़ एग्ज़िट कर जाता है।
एरर हैंडलर विशिष्ट फेल्योर मोड्स को भी पकड़ता है और कारगर संदेश प्रिंट करता है:
def handle_error_output(stdout, stderr):
    output = _gws_json_stdout(stdout or "") or (stderr or "")
    if "insufficientPermissions" in output or "unauthenticated" in output.lower():
        print("Please run: gws auth login -s drive")
    elif "serviceusage.services.use" in output or "serviceUsageConsumer" in output:
        print(
            "GCP quota project error: run gws auth setup --project YOUR_PROJECT_ID --login"
        )
    else:
        print(f"API Error: {output}")
डॉक्यूमेंट सूची फ़ेचर केवल टेक्स्ट-एक्सपोर्टेबल MIME टाइप्स को टार्गेट करता है:
def fetch_document_list(limit=10) -> list[dict]:
    q = (
        "(mimeType='text/plain' or mimeType='application/vnd.google-apps.document' "
        "or mimeType='application/vnd.google-apps.spreadsheet') and trashed=false"
    )
    cmd = [
        "gws", "drive", "files", "list",
        "--params",
        json.dumps({"q": q, "pageSize": limit, "orderBy": "modifiedTime desc"}),
    ]
क्वेरी सादा टेक्स्ट, Google Docs, और Google Sheets को फिल्टर करती है, जिन्हें सबसे हाल में मॉडिफ़ाईड के क्रम में रखा जाता है। बाइनरी फ़ाइलें (PDFs, इमेजेज़) इसमें शामिल नहीं हैं क्योंकि उन्हें इस तरीके से साफ़-सुथरे ढंग से टेक्स्ट में एक्सपोर्ट नहीं किया जा सकता।
हालाँकि, डाउनलोडिंग MIME टाइप के हिसाब से अलग तरह से हैंडल होती है:
def download_document(file_id: str, mime_type: str) -> str:
    fd, out_path = tempfile.mkstemp(prefix="gws_", suffix=".bin")
    os.close(fd)
    try:
        if mime_type == "application/vnd.google-apps.document":
            cmd = ["gws", "drive", "files", "export",
                   "--params", json.dumps({"fileId": file_id, "mimeType": "text/plain"}),
                   "-o", out_path]
        elif mime_type == "application/vnd.google-apps.spreadsheet":
            cmd = ["gws", "drive", "files", "export",
                   "--params", json.dumps({"fileId": file_id, "mimeType": "text/csv"}),
                   "-o", out_path]
        else:
            cmd = ["gws", "drive", "files", "get",
                   "--params", json.dumps({"fileId": file_id, "alt": "media"}),
                   "-o", out_path]
        ...
        with open(out_path, "rb") as f:
            return f.read().decode("utf-8", errors="replace")
    finally:
        os.unlink(out_path)
gws एक्सपोर्टेड फ़ाइल बाइट्स को stdout पर नहीं बल्कि -o के जरिए डिस्क पर लिखता है। Stdout JSON मेटाडेटा ढोता है। कोड एक temp फ़ाइल का उपयोग करता है ताकि बाइनरी आउटपुट कैप्चर हो सके, उसे पढ़ता है, और finally ब्लॉक में साफ़ कर देता है, जिससे एरर पर भी temp फ़ाइलें हमेशा हट जाएं।
vector_store.py — ChromaDB के साथ लोकल एम्बेडिंग्सयह मॉड्यूल इनकमिंग टेक्स्ट को चंक करता है, Sentence Transformers से लोकली एम्बेडिंग जेनरेट करता है, उन्हें ChromaDB के जरिए डिस्क पर पर्सिस्ट करता है, और एक सरल query() मेथड एक्सपोज़ करता है जिसे चैट लूप हर यूज़र प्रश्न पर कॉल करता है।
class VectorStore:
    def __init__(self, persist_directory="./chroma_db"):
        self.client = chromadb.PersistentClient(path=persist_directory)
        self.collection = self.client.get_or_create_collection(
            name="drive_documents",
            embedding_function=embedding_functions.DefaultEmbeddingFunction()
        )
        self.text_splitter = RecursiveCharacterTextSplitter(
            chunk_size=1000,
            chunk_overlap=200
        )
PersistentClient वेक्टर इंडेक्स को ./chroma_db में लिखता है और अगली रन पर बिना री-इन्जेशन के लोड कर लेता है (जब तक आप डायरेक्टरी डिलीट न करें)। DefaultEmbeddingFunction लोकली Sentence Transformers का उपयोग करता है, यानी एम्बेडिंग्स आपकी मशीन पर शून्य मार्जिनल लागत पर कंप्यूट होती हैं।
स्प्लिटर chunk_size=1000 और chunk_overlap=200 का उपयोग करता है, ताकि ओवरलैप सुनिश्चित करे कि चंक सीमा पर कॉन्टेक्स्ट न खोए जब वाक्य दो चंक्स में बँट जाए।
def add_document(self, file_id: str, filename: str, text: str):
    chunks = self.text_splitter.split_text(text)
    ids = [f"{file_id}_{i}" for i in range(len(chunks))]
    metadatas = [{"source": filename, "file_id": file_id} for _ in chunks]
    self.collection.upsert(documents=chunks, metadatas=metadatas, ids=ids)
    print(f"-> Added {len(chunks)} chunks for {filename}")
upsert का मतलब है कि पहले से इनजेस्टेड फ़ाइल पर पाइपलाइन फिर चलाने से चंक्स अपडेट हो जाते हैं, डुप्लीकेट ID एरर नहीं फेंकते।
def document_exists(self, file_id: str) -> bool:
    try:
        results = self.collection.get(where={"file_id": file_id}, limit=1)
        return len(results["ids"]) > 0
    except Exception:
        return False
यह तेज़ प्री-चेक main.py के इन्जेशन लूप में री-डाउनलोडिंग से बचाता है, जिससे अगली रन तुरंत हो जाती हैं।
main.py — इन्जेशन, रिट्रीवल, और स्ट्रीमिंग चैटmain.py फ़ाइल ऑथ चेक चलाती है, इन्जेशन लूप ड्राइव करती है, Gemini क्लाइंट को इनिशियलाइज़ करती है, और इंटरैक्टिव चैट लूप चलाती है। इसे जानबूझकर पतला रखा गया है क्योंकि भारी काम fetcher.py और vector_store.py संभालते हैं।
def setup_gemini():
    api_key = os.getenv("GEMINI_API_KEY")
    if not api_key:
        print("Please enter your GEMINI_API_KEY (get one from Google AI Studio).")
        api_key = input("Key: ").strip()
    return genai.Client(api_key=api_key)
अगर GEMINI_API_KEY सेट नहीं है, तो ऐप क्रैश होने के बजाय इंटरैक्टिव रूप से प्रॉम्प्ट करता है। आप पिछली स्टेप में दिखाए अनुसार अपना GEMINI_API_KEY सेट कर सकते हैं।
def ingest_documents(store, limit=10):
    files = fetch_document_list(limit)
    for file in files:
        file_id = file.get("id")
        if store.document_exists(file_id):
            print(f"Skipping {file.get('name')} (already in vector store)...")
            continue
        content = download_document(file_id, file.get("mimeType"))
        if content:
            store.add_document(file_id, file.get("name"), content)
यह document_exists चेक इन्क्रीमेंटल इन्जेशन मैकेनिज़्म है—हर रन पर केवल नई फ़ाइलें डाउनलोड और एम्बेड होती हैं। चैट लूप टॉप-3 सेमांटिकली समान चंक्स निकालता है और हर एक को उसके सोर्स फ़ाइलनाम से एनोटेट करता है:
def chat_loop(model, store):
    while True:
        query = input("\nYou: ")
        results = store.query(query, n_results=3)
        documents = results.get("documents", [[]])[0]
        metadatas = results.get("metadatas", [[]])[0]
        context_parts = []
        for doc, meta in zip(documents, metadatas):
            source = meta.get("source", "Unknown")
            context_parts.append(f"Source: {source}\nText:\n{doc}\n")
        full_context = "\n---\n".join(context_parts)
        prompt = f"""You are a helpful assistant. Answer the user's question based ONLY on the following context from their Google Drive. If you cannot answer from the context, say "I don't know based on your documents."
Context:
{full_context}
Question: {query}
"""
        model_name = os.getenv("GEMINI_MODEL", "gemini-2.5-flash")
        response = model.models.generate_content_stream(model=model_name, contents=prompt)
        for chunk in response:
            if chunk.text:
                print(chunk.text, end="", flush=True)
        print()
ऊपर दिया गया प्रॉम्प्ट सख्ती से ग्राउंडेड है—LLM को केवल दिए गए कॉन्टेक्स्ट से उत्तर देने और अगर उत्तर न मिले तो "I don't know" कहने के लिए निर्देशित करता है। यह आपके Drive में न होने वाली जानकारी का भ्रम (hallucination) रोकता है। रिस्पॉन्स generate_content_stream से टोकन-दर-टोकन स्ट्रीम होते हैं, इसलिए आउटपुट तुरंत दिखता है।
चारों फ़ाइलें होने पर, ऐप इस कमांड से शुरू करें:
python main.pyपहली रन में, ऐप ऑथ चेक करता है, ChromaDB इनिशियलाइज़ करता है, एम्बेडिंग मॉडल (यदि कैश नहीं) डाउनलोड करता है, 10 तक Drive फ़ाइलें फ़ेच करता है, एम्बेड कर स्टोर करता है, फिर आपको चैट लूप में ले आता है। हर फ़ाइल के इन्जेस्ट होते समय आपको इन्क्रीमेंटल प्रोग्रेस दिखेगा:
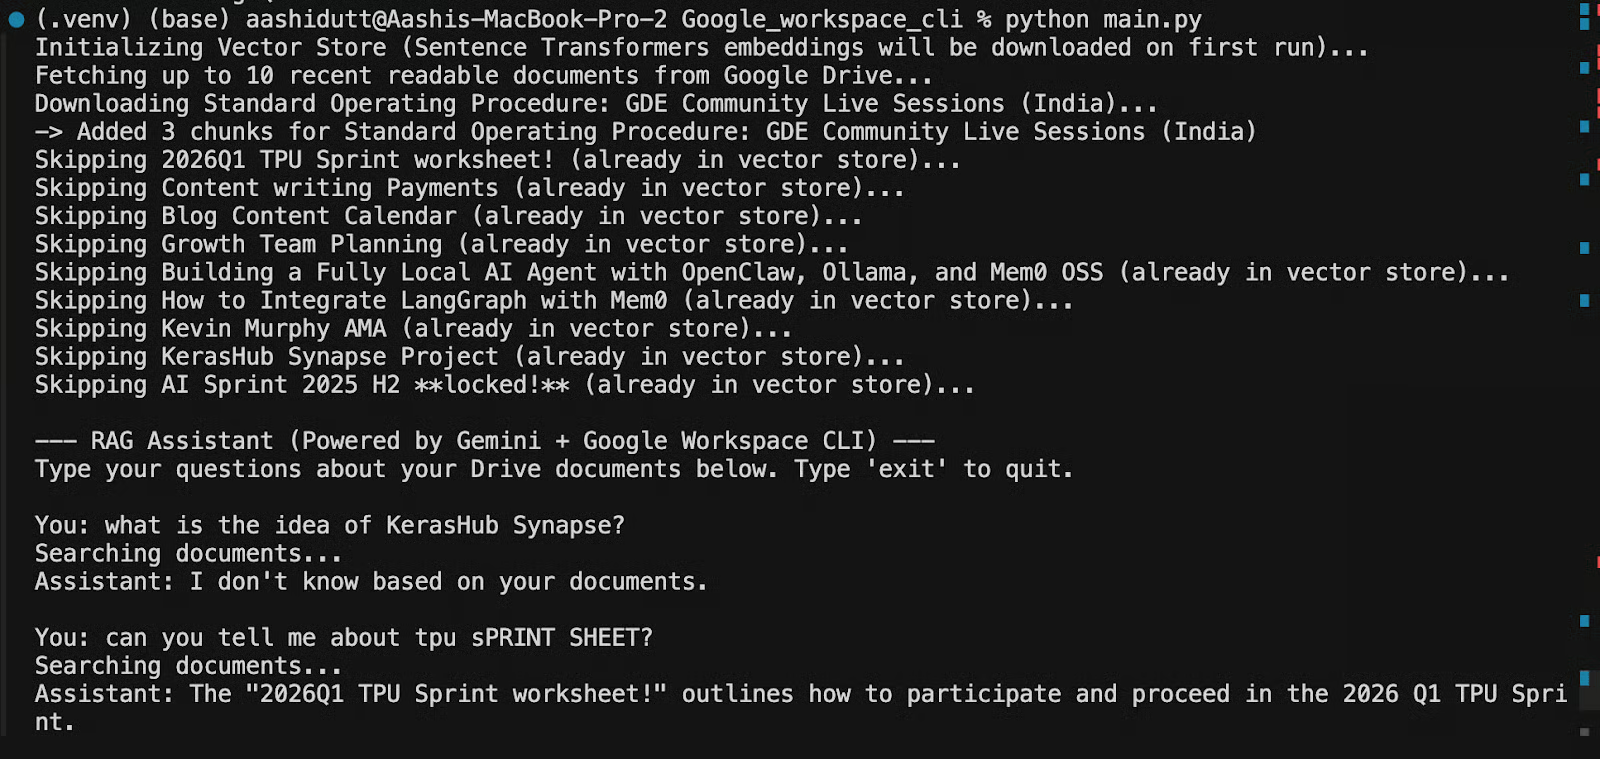
अगली रन में, ChromaDB पर्सिस्टेड इंडेक्स को डिस्क से लोड करता है, पहले से इन्जेस्टेड फ़ाइलें स्किप हो जाती हैं, और आप लगभग तुरंत चैट प्रॉम्प्ट पर पहुँच जाते हैं।
हालाँकि, सब कुछ फिर से शुरुआत से इन्जेस्ट करने के लिए—उदाहरण के लिए नए Drive फ़ाइलें जोड़ने के बाद—आपको ChromaDB डायरेक्टरी डिलीट कर के फिर से चलाना होगा:
rm -rf ./chroma_db
python main.py
पूरी पाइपलाइन चलाए बिना ऑथ को स्वतंत्र रूप से वेरिफ़ाई करने के लिए, सीधे fetcher.py चलाएँ:
python fetcher.pyयह check_auth() चलाता है और आपकी Drive फ़ाइलों की सूची प्रिंट करता है, ताकि CLI, OAuth, और Drive API के काम कर रहे होने की पुष्टि हो सके, इससे पहले कि आप फुल इन्जेशन रन करें।
हमने Google Workspace CLI के साथ जो RAG असिस्टेंट बनाया, वह जानबूझकर न्यूनतम है—gws फ़ेच करता है, Sentence Transformers लोकली एम्बेड करता है, ChromaDB स्टोर करता है, Gemini उत्तर स्ट्रीम करता है। चार फ़ाइलें, क्लाउड एम्बेडिंग की शून्य लागत, हर रन पर इन्क्रीमेंटल इन्जेशन। आर्किटेक्चर साफ़-सुथरे तरीके से स्केल होता है—आप Gmail और Calendar को अतिरिक्त इन्जेशन सोर्सेज़ के रूप में जोड़ सकते हैं, बड़ा Gemini मॉडल स्वैप कर सकते हैं, या चैट लूप को LangGraph एजेंट से बदल सकते हैं। नींव वही रहती है।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स
