Kurs
Einführung in KI-Agenten
1 Std. 30 Min.
137.2K
Google hat etwas wirklich Spannendes für Entwickler veröffentlicht: Eine Google Workspace Kommandozeilenoberfläche, die dir strukturierten, skriptfähigen Zugriff auf dein gesamtes Google Workspace gibt – inklusive Drive, Gmail, Calendar, Sheets, Docs, Chat und mehr – alles in einem Tool.
Der Code ist fast vollständig in Rust (99,3%) geschrieben, wird aber über npm als vorkompilierte Native-Binaries ausgeliefert, sodass du keine Rust-Toolchain installieren musst.
In diesem Tutorial richtest du die Google Workspace CLI von Grund auf ein, authentifizierst sie und baust einen Gemini-basierten RAG-Assistenten, mit dem du deine Drive-Dateien in natürlicher Sprache abfragen kannst. Am Ende hast du:
gws installiert und mit deinem Drive authentifiziert
Eine Python-Umgebung mit ChromaDB, Sentence Transformers und dem Gemini SDK
Eine funktionierende lokale RAG-Pipeline, die Dateien über gws abruft, lokal mit einem Modell embeddert und Antworten mit Gemini 2.5 Flash per Stream ausgibt
Hinweis: Das ist kein offiziell unterstütztes Google-Produkt.
Die Google Workspace CLI (gws) ist ein KI-optimiertes Kommandozeilentool für dein gesamtes Google-Workspace-Ökosystem. Das macht sie besonders:
Dynamische Befehlsentdeckung: Statt einen fest verdrahteten Befehlssatz auszuliefern, liest gws zur Laufzeit den Discovery Service von Google. Wenn Google neue API-Endpunkte hinzufügt, übernimmt die CLI sie automatisch – ganz ohne Versionssprung.
Agent-natives Design: Die CLI bringt über 100 vorgefertigte Agent-Skills und 50 kuratierte Rezepte für gängige Workflows mit – E-Mails zusammenfassen, Drive-Dateien verschieben, Kalendereinträge erstellen und mehr. Jeder Output ist strukturiertes JSON, damit LLMs ihn direkt verarbeiten können.
Native MCP-Server-Unterstützung: Starte gws als lokalen MCP-Server und gib deinem KI-Agenten vollen Zugriff auf Workspace-Tools – ganz ohne eigenen API-Client.
Model-Armor-Integration: Für produktive Agenten, die nutzergenerierte Inhalte lesen, kannst du API-Antworten durch Google Cloud Model Armor leiten, um sie vor Prompt-Injection zu schützen, bevor dein LLM sie sieht.
Die vollständige Skill-Bibliothek findest du hier: github.com/googleworkspace/cli/blob/main/docs/skills.md.
In diesem Tutorial bauen wir den RAG-Assistenten Schritt für Schritt. Auf hoher Ebene macht die App Folgendes:
Authentifiziert sich über die gws-CLI gegenüber deinem Google Drive und holt deine zuletzt bearbeiteten Docs, Sheets und Textdateien
Teilt jedes Dokument in Abschnitte und embeddert es lokal mit Sentence Transformers über ChromaDB
Speichert den Vektorindex auf der Festplatte, sodass spätere Durchläufe bereits eingelesene Dateien überspringen und direkt in den Chat gehen
Akzeptiert eine Frage in natürlicher Sprache, ruft die drei relevantesten Abschnitte aus ChromaDB ab und baut daraus einen fundierten Kontext-Prompt
Streamt eine zitierte, rein kontextbasierte Antwort von Gemini 2.5 Flash Token für Token direkt in deinem Terminal
Lass uns das Schritt für Schritt aufbauen.
Vollständiger Tutorial-Code: https://github.com/AashiDutt/Google-Workspace-CLI-Demo
Die CLI wird als npm-Paket mit vorkompilierten Rust-Binaries ausgeliefert. Keine Rust-Toolchain erforderlich.
npm install -g @googleworkspace/cliÜberprüfe die Installation, indem du folgende Befehle nacheinander ausführst:
gws --version
which gws
Wenn gws nach der Installation nicht gefunden wird, stelle sicher, dass dein npm global-Bin-Verzeichnis in deinem PATH liegt.
Die CLI authentifiziert sich über den OAuth-Client eines GCP-Projekts, daher brauchst du eines, bevor du dich einloggst. So erstellst oder wählst du ein Projekt in GCP aus:
Richte OAuth-Zugangsdaten ein:
Wechsle zu APIs & Dienste und wähle Zugangsdaten
Klicke auf Zugangsdaten erstellen und wähle OAuth 2.0-Client-ID
Wähle Desktop-App als Anwendungstyp
Notiere dir die Client-ID und das Client-Secret, die wir für gws auth setup verwenden.
Die CLI schließt OAuth ab, indem sie einen temporären Localhost-Server startet. Desktop-App-Clients handhaben beliebige Localhost-Ports automatisch. Bei Web-Application-Clients musst du jeden http://localhost:PORT manuell zu den autorisierten Redirect-URIs hinzufügen.
Wenn du einen Web-Application-Client nutzt und die Meldung „Zugriff blockiert: Die Anfrage dieser App ist ungültig“ erhältst, gehe zu Zugangsdaten, klicke auf den OAuth-Client, dann auf Autorisierte Weiterleitungs-URIs und füge die im Fehler angezeigte http://localhost:PORT-URL exakt hinzu.
Um gws mit deinem GCP-Projekt zu verbinden, exportiere zuerst deine OAuth-Zugangsdaten als Umgebungsvariablen, damit der Setup-Assistent sie automatisch übernimmt:
export GOOGLE_WORKSPACE_CLI_CLIENT_ID="CLIENT_ID"
export GOOGLE_WORKSPACE_CLI_CLIENT_SECRET="CLIENT_SECRET"
Führe dann aus:
gws auth setup --project YOUR_PROJECT_ID --login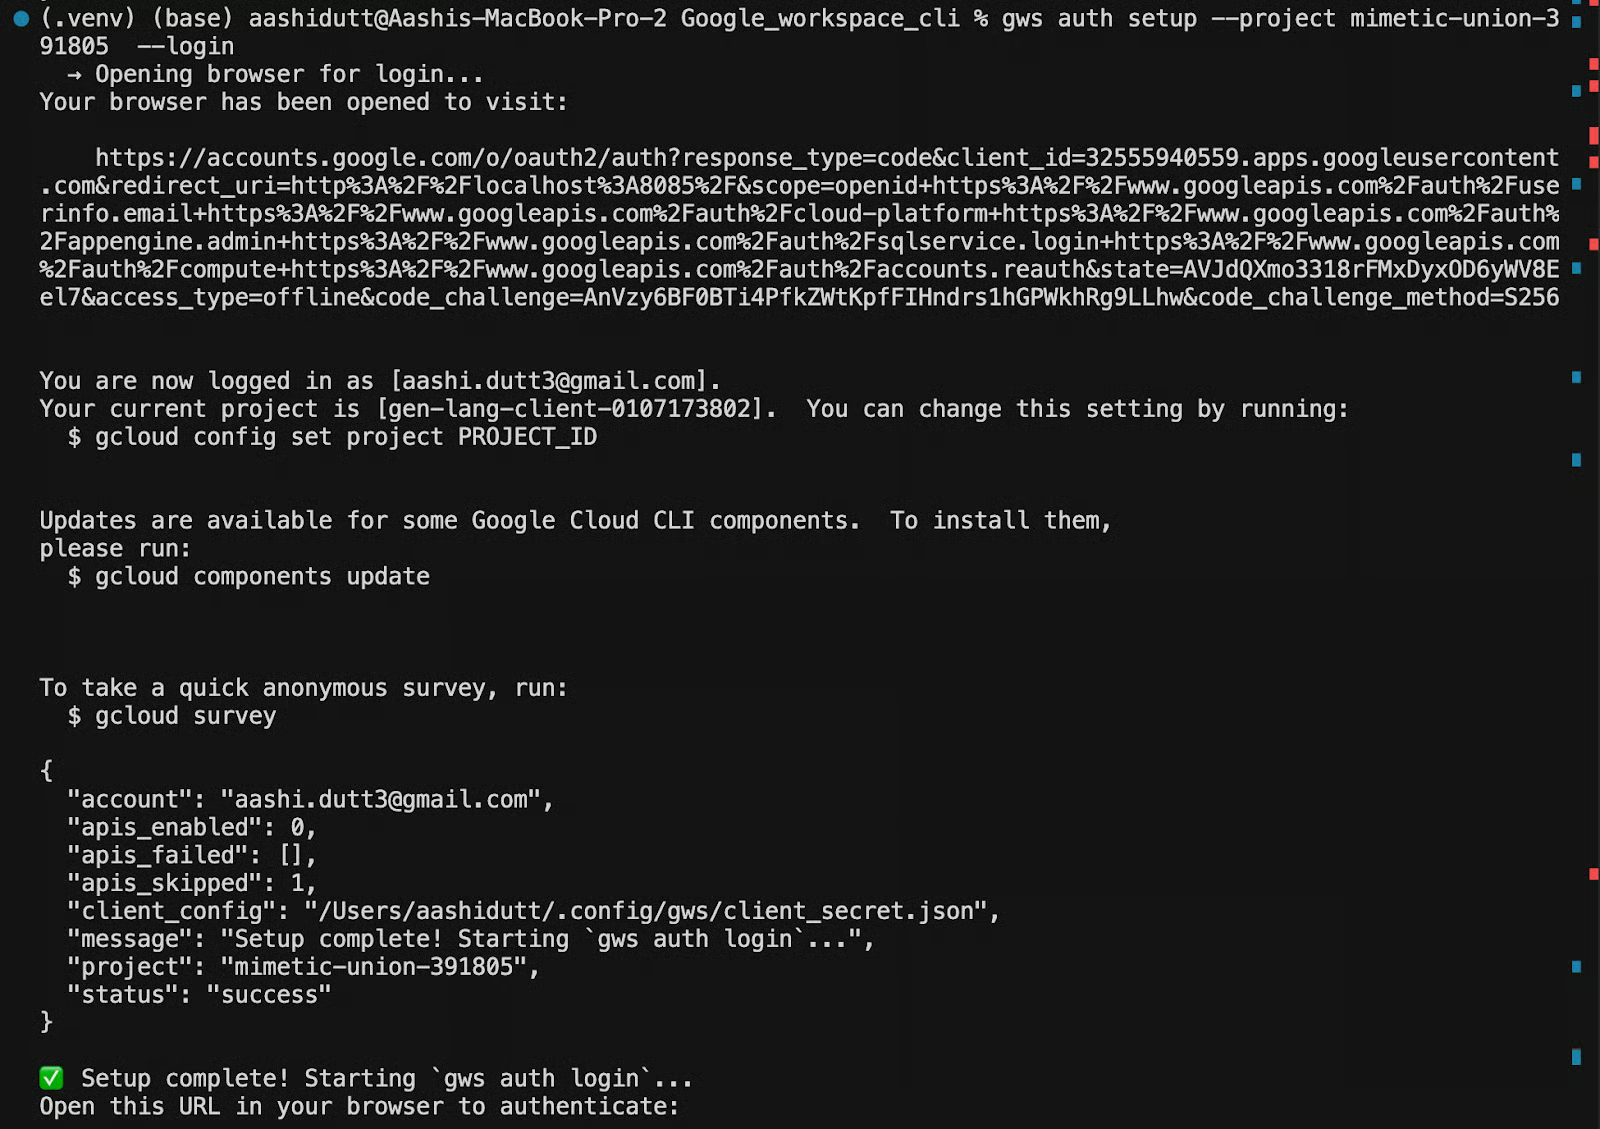
Der Setup-Assistent wird:
Nach Abschluss siehst du: Setup complete!
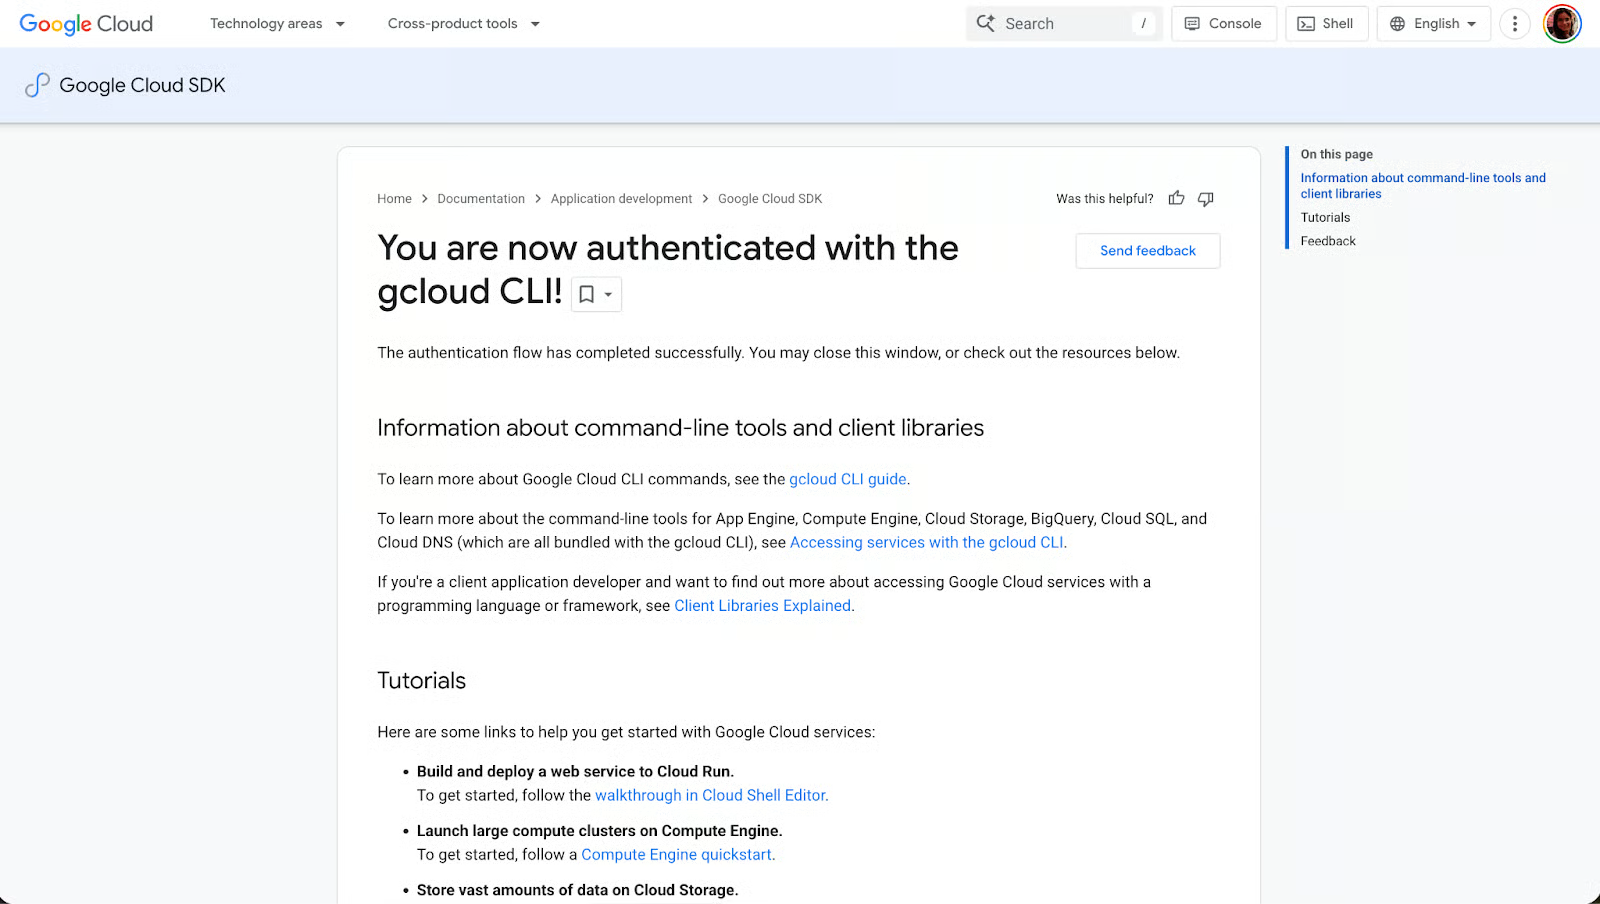
Zugangsdaten werden in ~/.config/gws/ gespeichert. Um zu prüfen, ob alles korrekt verbunden ist, führe aus:
gws auth statusDas zeigt das authentifizierte Konto, das verknüpfte GCP-Projekt und die aktiven Scopes. Wenn etwas nicht stimmt, führe gws auth setup mit den richtigen Flags erneut aus, statt die Konfigurationsdateien manuell zu bearbeiten.
Bevor wir Python schreiben, lohnt sich ein schneller Check direkt im Terminal, um sicherzustellen, dass die CLI authentifiziert ist und mit deinem Drive sprechen kann. Liste dazu kurz deine fünf aktuellsten Drive-Dateien auf:
gws drive files list --params '{"pageSize": 5}'Das Flag --params akzeptiert einen JSON-String, der direkt auf die Abfrageparameter der Drive API abbildet. Hier begrenzt pageSize: 5 die Ausgabe auf fünf Ergebnisse – genug für einen Konnektivitätscheck, ohne deinen gesamten Drive auszugeben.
Wenn die Authentifizierung korrekt funktioniert, erhältst du eine strukturierte JSON-Antwort wie diese:
{
  "files": [
    {
      "id": "1BxiMVs0XRA5nFMdKvBdBZjgmUUqptlbs74OgVE2upms",
      "name": "Q3 Strategy Doc",
      "mimeType": "application/vnd.google-apps.document"
    },
    ...
  ]
}
Jede Antwort von gws ist strukturiertes JSON – kein Parsen, kein Scrapen, keine fragilen Textausgaben.
Wenn du stattdessen einen „403-Fehler“ mit serviceusage.services.use siehst, sind deine OAuth-Zugangsdaten mit einem anderen GCP-Projekt verknüpft als dem mit aktivierter Abrechnung. Führe das Setup mit der korrekten Projekt-ID erneut aus, um alles neu zu verknüpfen:
gws auth setup --project YOUR_PROJECT_ID --loginMit bestätigtem Drive-Zugriff können wir die API aktivieren und mit dem Python-Teil der Pipeline beginnen.
An diesem Punkt kann sich gws zwar gegenüber deinem GCP-Projekt authentifizieren, aber noch keine Drive-Inhalte lesen. GCP trennt Authentifizierung (wer du bist) von API-Aktivierung (welche Dienste dein Projekt nutzt). Selbst mit gültigen OAuth-Daten führt jeder Abruf von Dateiinhalten zu 403 accessNotConfigured, bis die Drive API im Projekt explizit aktiviert wird.
Öffne dazu diese URL im Browser, ersetze [PROJECT_ID] durch deine Projekt-ID und klicke auf Enable:
https://console.developers.google.com/apis/api/drive.googleapis.com/overview?project=[PROJECT_ID]
Alternativ kannst du, falls die gcloud-CLI installiert ist, die Aktivierung direkt im Terminal vornehmen:
gcloud services enable drive.googleapis.com --project YOUR_PROJECT_IDBeide Methoden tun dasselbe. Das Ausführen auf einer bereits aktivierten API ist unkritisch, da der Vorgang idempotent ist und keine bestehende Konfiguration zurücksetzt.
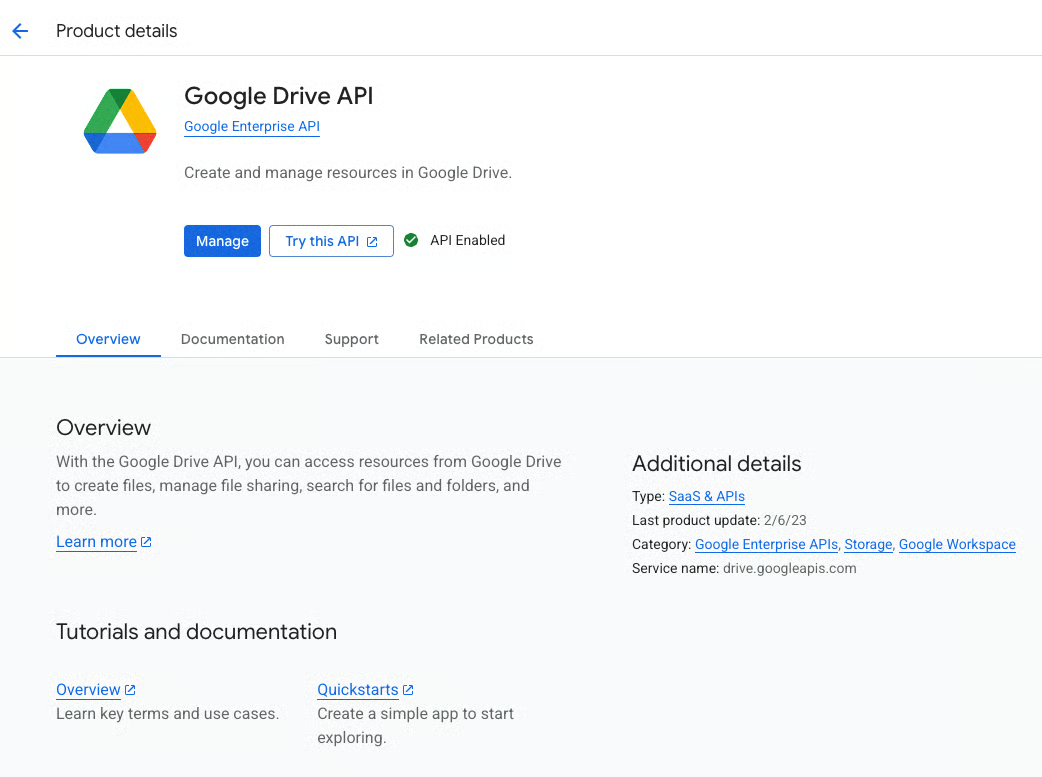
Nach der Aktivierung kann es ein paar Sekunden dauern, bis GCP die Änderung propagiert. Wenn du sofort gws drive files list ausführst und noch einen 403 siehst, warte 30 Sekunden und versuche es erneut.
Mit der vollständig konfigurierten CLI richten wir nun die Python-Umgebung ein, die das Embedding- und Retrieval-Handling übernimmt. Die RAG-Pipeline ist bewusst schlank: vier Pakete, keine GPU nötig, und alle Embeddings laufen lokal auf deinem Rechner.
Erstelle zunächst eine virtuelle Umgebung, indem du diese Befehle nacheinander ausführst:
cd /path/to/your/project
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
pip install -r requirements.txt
Installiere dann die Abhängigkeiten aus requirements.txt:
.txt
chromadb==1.5.5
google-genai==1.70.0
langchain-text-splitters==1.1.1
sentence-transformers==5.3.0
Das steuern die Pakete zur Pipeline bei:
chromadb: Lokale Vektordatenbank, die Dokument-Embeddings auf der Festplatte unter ./chroma_db speichert und bei späteren Läufen lädt, damit die App bereits verarbeitete Dateien nicht erneut embedden muss.
google-genai: Offizielles Python-SDK für Gemini. Die App nutzt es, um den abgerufenen Kontext und die Nutzerfrage an Gemini 2.5 Flash zu senden und die Antwort tokenweise zu streamen.
langchain-text-splitters: Enthält den RecursiveCharacterTextSplitter, der große Dokumente vor dem Embedding in überlappende Abschnitte zerlegt. Die Überlappung stellt sicher, dass Sätze an Abschnittsgrenzen nicht aus dem Kontext gerissen werden.
sentence-transformers: Führt das Embedding-Modell lokal über ChromaDBs DefaultEmbeddingFunction aus. Jeder Dokumentabschnitt wird also ohne externe API-Aufrufe direkt auf deiner Maschine eingebettet.
Hinweis: Das Embedding-Modell (~90 MB) wird beim ersten Gebrauch automatisch heruntergeladen und lokal zwischengespeichert.
Mit der fertigen Python-Umgebung fehlt vor dem Coden nur noch dein Gemini-API-Schlüssel.
Die RAG-Pipeline nutzt Gemini als Antwortschicht, weil es die abgerufenen Dokumentabschnitte und die Nutzerfrage nimmt und eine fundierte Antwort zurückstreamt. Um Gemini zu verbinden, brauchst du einen API-Schlüssel aus dem Google AI Studio.
Melde dich mit deinem Google-Konto an, klicke auf Get API Key und dann Create API Key. Wähle bei Aufforderung dein GCP-Projekt aus, damit Kontingente und Abrechnung greifen. Verknüpfe ein Abrechnungskonto im GCP-Dashboard unter Abrechnung und wähle dann Link a billing account.
Sobald du deinen Schlüssel hast, exportiere ihn als Umgebungsvariable:
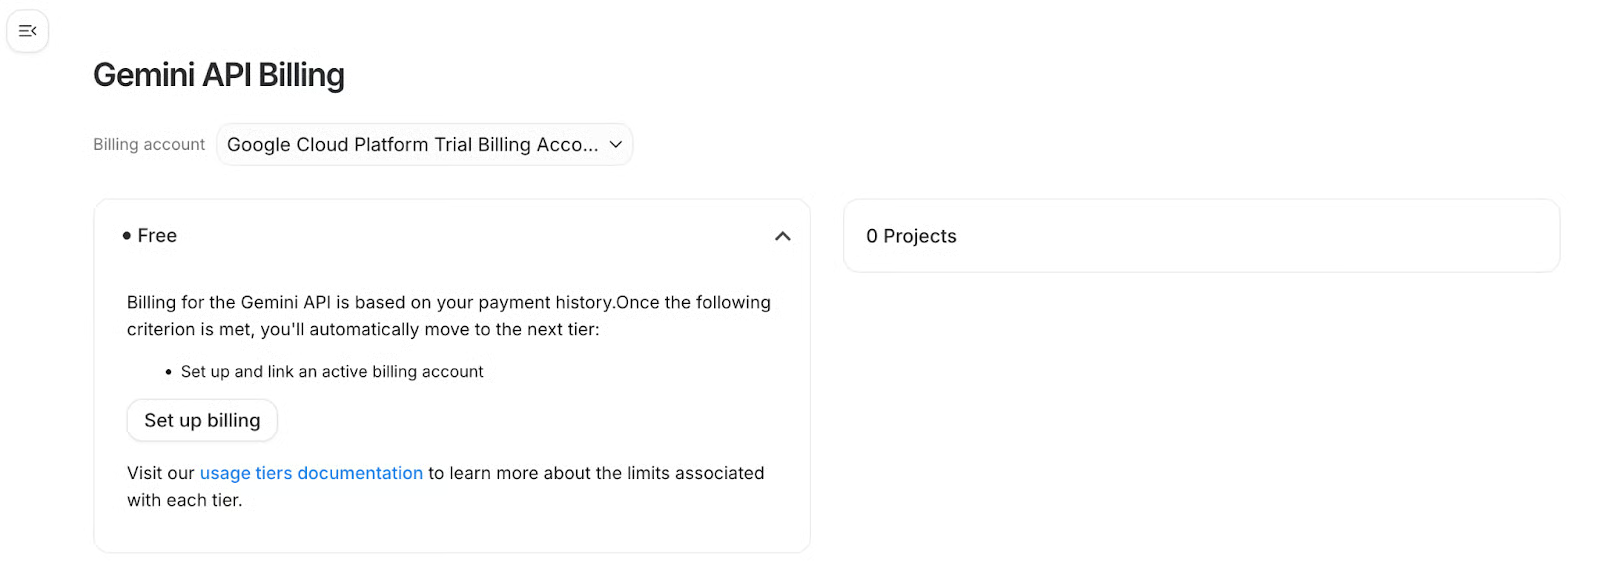
Exportiere den Schlüssel in deinem Terminal:
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"Um ihn über Terminal-Sitzungen hinweg zu behalten, führe aus:
echo 'export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"' >> ~/.zshrc
source ~/.zshrc
Die App liest diesen Schlüssel beim Start über os.getenv("GEMINI_API_KEY"). Wenn die Variable nicht gesetzt ist, wirst du aufgefordert, den Schlüssel interaktiv einzufügen.
Modellhinweis: Standard ist gemini-2.5-flash. Du kannst dies via GEMINI_MODEL="gemini-2.5-pro" überschreiben, wenn du bei komplexen Dokumenten stärkere Reasoning-Fähigkeiten willst. Beachte, dass gemini-2.0-flash für neue API-Schlüssel eingestellt wurde und hier nicht verwendet werden sollte.
Mit Auth, Drive API, Abhängigkeiten und Gemini-Schlüssel ist alles bereit. Bauen wir die Pipeline.
Jetzt verdrahten wir alles. Wir arbeiten mit vier Dateien: fetcher.py, vector_store.py, main.py und requirements.txt. Jede Datei hat eine klar umrissene Aufgabe: fetcher.py kümmert sich um alle CLI-Interaktionen, vector_store.py übernimmt Embedding und Retrieval, und main.py orchestriert den gesamten Ablauf von der Ingestion bis zum Streaming-Chat.
Beim ersten Lauf holt gws deine Drive-Dateien, der Inhalt wird in Abschnitte zerlegt und lokal eingebettet, und der Vektorindex wird unter ./chroma_db auf die Festplatte geschrieben. Bei späteren Läufen lädt ChromaDB von der Platte, nur neue Dateien werden geholt und eingebettet, und die Chat-Schleife startet sofort ohne erneute Verarbeitung.
Gehen wir die Dateien durch.
fetcher.py — Drive-Zugriff über gwsDieses Modul ist die Brücke zwischen der gws-CLI und Python. Alle Drive-Aktionen wie Dateien auflisten, Inhalte exportieren und Auth prüfen laufen über Subprozesse mit gws, und der strukturierte JSON-Output wird in Python-Dicts geparst. Dadurch muss sich der Python-Code nie direkt mit OAuth-Tokens, HTTP-Clients oder API-Response-Schemata befassen – gws übernimmt alles und liefert sauberes JSON zurück.
def _gws_json_stdout(stdout: str) -> str:
    if not stdout or "{" not in stdout:
        return stdout or ""
    return stdout[stdout.find("{"):]
Der Helper _gws_json_stdout löst ein subtiles Problem: gws gibt manchmal Keyring- oder Log-Zeilen vor der JSON-Nutzlast aus. Ein direktes json.loads(result.stdout) würde dann scheitern. Die Funktion schneidet alles vor dem ersten { ab.
def check_auth() -> bool:
    cmd = ["gws", "drive", "about", "get", "--params", '{"fields": "user"}']
    result = subprocess.run(cmd, capture_output=True, text=True)
    payload = _gws_json_stdout(result.stdout)
    try:
        data = json.loads(payload) if payload.strip() else {}
    except json.JSONDecodeError:
        print("Error checking authentication status (could not parse gws output).")
        return False
    if "error" in data or result.returncode != 0:
        handle_error_output(result.stdout, result.stderr)
        return False
    return True
Die Funktion check_auth() wird beim Start in main.py aufgerufen. Sie macht einen leichten Drive-API-Call und prüft die Antwort. Wenn Auth kaputt ist oder Scopes fehlen, beendet sich die App sauber, bevor sie mit der Ingestion beginnt.
Der Error-Handler fängt zudem typische Fehlerbilder ab und gibt konkrete Hinweise aus:
def handle_error_output(stdout, stderr):
    output = _gws_json_stdout(stdout or "") or (stderr or "")
    if "insufficientPermissions" in output or "unauthenticated" in output.lower():
        print("Please run: gws auth login -s drive")
    elif "serviceusage.services.use" in output or "serviceUsageConsumer" in output:
        print(
            "GCP quota project error: run gws auth setup --project YOUR_PROJECT_ID --login"
        )
    else:
        print(f"API Error: {output}")
Der Dokumentlisten-Abruf zielt nur auf MIME-Typen, die sich als Text exportieren lassen:
def fetch_document_list(limit=10) -> list[dict]:
    q = (
        "(mimeType='text/plain' or mimeType='application/vnd.google-apps.document' "
        "or mimeType='application/vnd.google-apps.spreadsheet') and trashed=false"
    )
    cmd = [
        "gws", "drive", "files", "list",
        "--params",
        json.dumps({"q": q, "pageSize": limit, "orderBy": "modifiedTime desc"}),
    ]
Die Abfrage filtert auf Plain-Text, Google Docs und Google Sheets, jeweils sortiert nach letzter Änderung. Binärdateien (PDFs, Bilder) sind ausgeschlossen, da sie sich auf diesem Weg nicht sauber als Text exportieren lassen.
Das Herunterladen erfolgt je nach MIME-Typ unterschiedlich:
def download_document(file_id: str, mime_type: str) -> str:
    fd, out_path = tempfile.mkstemp(prefix="gws_", suffix=".bin")
    os.close(fd)
    try:
        if mime_type == "application/vnd.google-apps.document":
            cmd = ["gws", "drive", "files", "export",
                   "--params", json.dumps({"fileId": file_id, "mimeType": "text/plain"}),
                   "-o", out_path]
        elif mime_type == "application/vnd.google-apps.spreadsheet":
            cmd = ["gws", "drive", "files", "export",
                   "--params", json.dumps({"fileId": file_id, "mimeType": "text/csv"}),
                   "-o", out_path]
        else:
            cmd = ["gws", "drive", "files", "get",
                   "--params", json.dumps({"fileId": file_id, "alt": "media"}),
                   "-o", out_path]
        ...
        with open(out_path, "rb") as f:
            return f.read().decode("utf-8", errors="replace")
    finally:
        os.unlink(out_path)
gws schreibt exportierte Dateibytes per -o auf die Platte, nicht auf stdout. Stdout enthält JSON-Metadaten. Der Code nutzt eine temporäre Datei für die Binärausgabe, liest sie ein und räumt im finally-Block auf, damit temporäre Dateien auch bei Fehlern immer entfernt werden.
vector_store.py — Lokale Embeddings mit ChromaDBDieses Modul zerlegt eingehenden Text in Abschnitte, generiert Embeddings lokal mit Sentence Transformers, persistiert sie über ChromaDB auf der Festplatte und stellt eine einfache query()-Methode bereit, die die Chat-Schleife für jede Nutzerfrage aufruft.
class VectorStore:
    def __init__(self, persist_directory="./chroma_db"):
        self.client = chromadb.PersistentClient(path=persist_directory)
        self.collection = self.client.get_or_create_collection(
            name="drive_documents",
            embedding_function=embedding_functions.DefaultEmbeddingFunction()
        )
        self.text_splitter = RecursiveCharacterTextSplitter(
            chunk_size=1000,
            chunk_overlap=200
        )
PersistentClient schreibt den Vektorindex nach ./chroma_db und lädt ihn bei späteren Läufen – kein Neuimport nötig, solange du das Verzeichnis nicht löschst. Die DefaultEmbeddingFunction nutzt Sentence Transformers lokal, die Embeddings entstehen also auf deiner Maschine ohne Zusatzkosten.
Der Splitter nutzt chunk_size=1000 mit chunk_overlap=200, damit Kontext an Abschnittsgrenzen nicht verloren geht, wenn Sätze über zwei Abschnitte laufen.
def add_document(self, file_id: str, filename: str, text: str):
    chunks = self.text_splitter.split_text(text)
    ids = [f"{file_id}_{i}" for i in range(len(chunks))]
    metadatas = [{"source": filename, "file_id": file_id} for _ in chunks]
    self.collection.upsert(documents=chunks, metadatas=metadatas, ids=ids)
    print(f"-> Added {len(chunks)} chunks for {filename}")
upsert bedeutet hier: Beim erneuten Durchlauf für bereits eingelesene Dateien werden Abschnitte aktualisiert, statt dass ein Fehler wegen doppelter IDs entsteht.
def document_exists(self, file_id: str) -> bool:
    try:
        results = self.collection.get(where={"file_id": file_id}, limit=1)
        return len(results["ids"]) > 0
    except Exception:
        return False
Dieser schnelle Vorab-Check in der Ingestion-Schleife von main.py vermeidet erneutes Herunterladen bereits eingebetteter Dateien und macht spätere Läufe sofort startklar.
main.py — Ingestion, Retrieval und Streaming-ChatDie Datei main.py führt Auth-Checks aus, steuert die Ingestion-Schleife, initialisiert den Gemini-Client und betreibt die interaktive Chat-Schleife. Sie bleibt bewusst schlank, da die Schwerarbeit in fetcher.py und vector_store.py steckt.
def setup_gemini():
    api_key = os.getenv("GEMINI_API_KEY")
    if not api_key:
        print("Please enter your GEMINI_API_KEY (get one from Google AI Studio).")
        api_key = input("Key: ").strip()
    return genai.Client(api_key=api_key)
Wenn GEMINI_API_KEY nicht gesetzt ist, fragt die App interaktiv nach, statt abzustürzen. Du kannst deinen GEMINI_API_KEY wie im vorherigen Schritt setzen.
def ingest_documents(store, limit=10):
    files = fetch_document_list(limit)
    for file in files:
        file_id = file.get("id")
        if store.document_exists(file_id):
            print(f"Skipping {file.get('name')} (already in vector store)...")
            continue
        content = download_document(file_id, file.get("mimeType"))
        if content:
            store.add_document(file_id, file.get("name"), content)
Der document_exists-Check ist das inkrementelle Ingestion-Verfahren: Pro Lauf werden nur neue Dateien heruntergeladen und eingebettet. Die Chat-Schleife holt die drei semantisch ähnlichsten Abschnitte und versieht jeden mit seinem Quell-Dateinamen:
def chat_loop(model, store):
    while True:
        query = input("\nYou: ")
        results = store.query(query, n_results=3)
        documents = results.get("documents", [[]])[0]
        metadatas = results.get("metadatas", [[]])[0]
        context_parts = []
        for doc, meta in zip(documents, metadatas):
            source = meta.get("source", "Unknown")
            context_parts.append(f"Source: {source}\nText:\n{doc}\n")
        full_context = "\n---\n".join(context_parts)
        prompt = f"""You are a helpful assistant. Answer the user's question based ONLY on the following context from their Google Drive. If you cannot answer from the context, say \"I don't know based on your documents.\"\nContext:\n{full_context}\nQuestion: {query}\n"""
        model_name = os.getenv("GEMINI_MODEL", "gemini-2.5-flash")
        response = model.models.generate_content_stream(model=model_name, contents=prompt)
        for chunk in response:
            if chunk.text:
                print(chunk.text, end="", flush=True)
        print()
Der Prompt ist strikt geerdet: Das LLM wird angewiesen, ausschließlich aus dem bereitgestellten Kontext zu antworten und „I don't know based on your documents.“ zu sagen, wenn die Antwort nicht enthalten ist. So werden Halluzinationen vermieden. Die Antworten streamen Token für Token via generate_content_stream, sodass die Ausgabe sofort erscheint.
Wenn alle vier Dateien bereit sind, startest du die App mit:
python main.pyBeim ersten Lauf prüft die App die Authentifizierung, initialisiert ChromaDB, lädt das Embedding-Modell, falls es noch nicht zwischengespeichert ist, holt bis zu 10 Drive-Dateien, embeddert und speichert sie und wechselt dann in die Chat-Schleife. Du siehst den Fortschritt für jede Datei während der Ingestion:
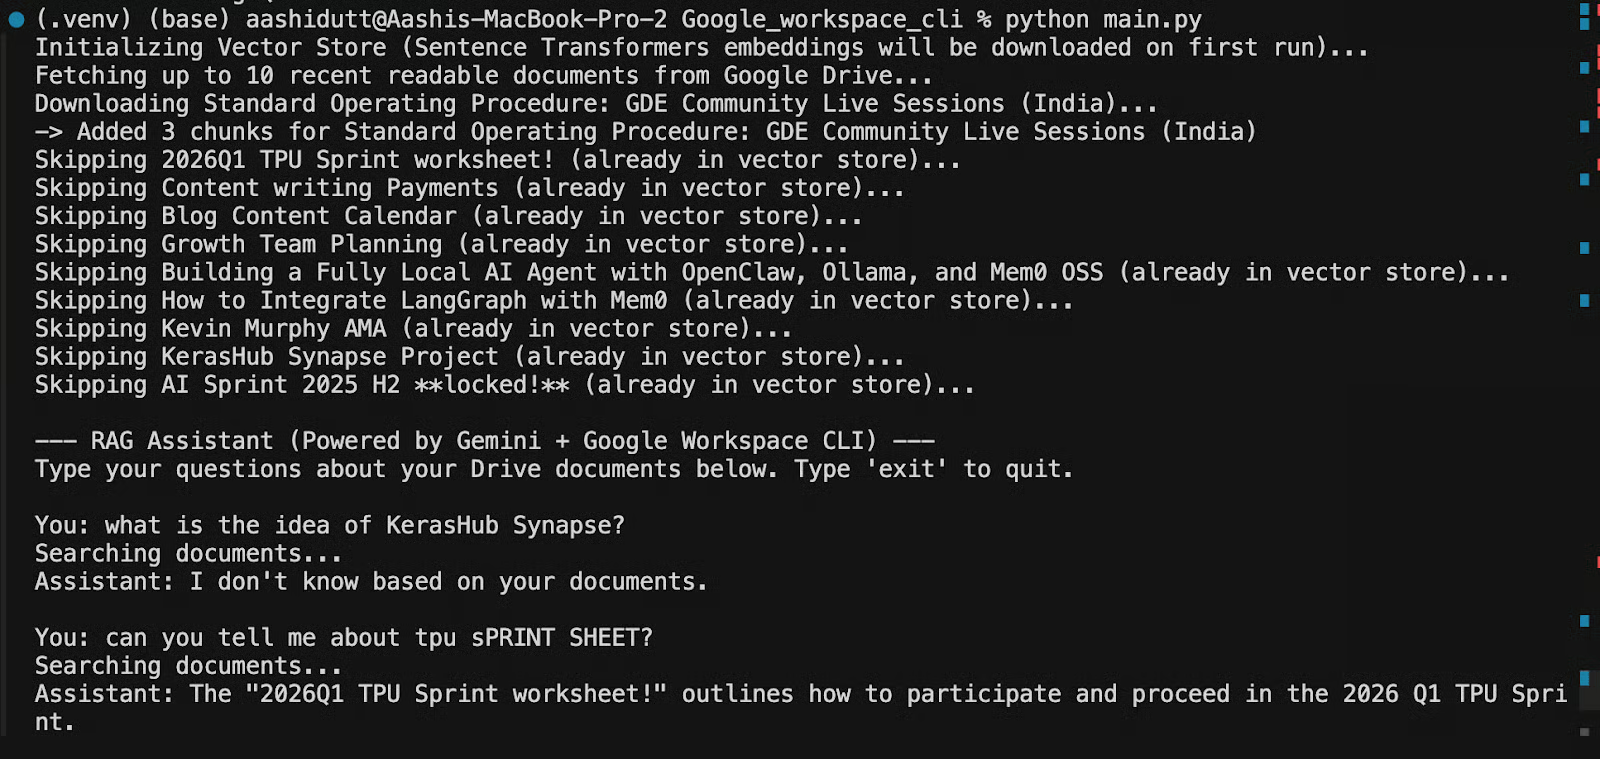
Bei späteren Läufen lädt ChromaDB den Index von der Platte, bereits eingelesene Dateien werden übersprungen, und du landest fast sofort am Chat-Prompt.
Wenn du hingegen alles neu einlesen willst – etwa nachdem du neue Drive-Dateien hinzugefügt hast –, lösche das ChromaDB-Verzeichnis und starte erneut:
rm -rf ./chroma_db
python main.py
Um die Auth unabhängig zu prüfen, ohne die ganze Pipeline zu starten, führe fetcher.py direkt aus:
python fetcher.pyDas führt check_auth() aus und gibt eine Liste deiner Drive-Dateien aus – so stellst du sicher, dass CLI, OAuth und Drive API funktionieren, bevor du eine vollständige Ingestion startest.
Der mit der Google Workspace CLI gebaute RAG-Assistent ist bewusst minimal: gws holt die Daten, Sentence Transformers embedden lokal, ChromaDB speichert, Gemini streamt die Antwort. Vier Dateien, null Cloud-Embedding-Kosten, inkrementelle Ingestion bei jedem Lauf. Die Architektur skaliert sauber, wenn du Gmail und Calendar als zusätzliche Quellen hinzufügen, ein größeres Gemini-Modell einsetzen oder die Chat-Schleife durch einen LangGraph-Agenten ersetzen willst. Das Fundament bleibt gleich.
Lerne mit DataCamp
Kurs
Kurs
Kurs