

课程
使用 LangChain 的 Retrieval Augmented Generation (RAG)
3 小时
21.2K
实践并学习路径你的进步。
使用 Google 继续传统的 RAG 系统基于语义相似度检索文档片段,对简单问题效果良好。但当查询需要综合分散在多份文档中的信息,或在相互关联的概念间进行推理时,向量搜索就显得力不从心了。系统会检索到一些片段,却不了解它们彼此之间的关系。
GraphRAG 不把文档当作彼此孤立的块来处理。它会构建一个知识图谱,捕捉实体及其关系。借助这种结构,系统能够沿着连接进行遍历,回答需要从多个来源整合信息的问题。这是若干种高级 RAG 技术之一,旨在弥补基础检索的局限。
GraphRAG 是一种检索增强生成技术,用知识图谱来表示文档,而不是向量嵌入。它并非将文本切分成彼此独立检索的块,而是抽取实体(如人物、组织、概念、事件)及其关系,并将这些信息组织成互联的图结构。
随后,GraphRag 系统会应用社区发现算法来识别相关实体的簇,并在分层级别上为这些簇生成摘要。当有查询到来时,GraphRAG 可以针对性地遍历特定实体邻域,也可以在整个语料层面上对社区摘要执行 map-reduce 来进行综合。
下面我们更近一步看它的工作机制,以理解基于图的检索为何出现,以及它填补了什么空白。
传统 RAG 的核心问题不在检索或生成,而在表示。文档被切分为块,每个块在嵌入空间中变成一个孤立的向量。原本存在的结构——诸如标题、叙事流、某个段落指代了什么——都会被压平丢失。
这在需要整合信息的问题上会带来麻烦。比如您问“这些文档的主要主题是什么?”,向量搜索会返回包含“主题”或相关词的片段。但找到相关片段并不等于理解整个语料的模式。系统无法在规模上整合信息,因为它只看到单个碎片,而不是全貌。
多跳推理也会遭遇类似瓶颈。假设一个问题的答案取决于将概念 A 连接到 B,再连接到 C。传统 RAG 会基于与查询的相似度独立检索每个块。如果 B 与问题不够接近,它可能根本不会被检索到,从而打断链条。系统能找到端点,却错过了它们之间的路径。
还要考虑检索与上下文的错配。您可以检索到二十个高度相关的块,但把它们都塞进提示词并不意味着 LLM 就能好好利用。“lost in the middle” 论文显示,LLM 倾向于关注上下文窗口开头和结尾的信息,常常忽略夹在中间的内容。更多检索并不自动意味着更好的答案。
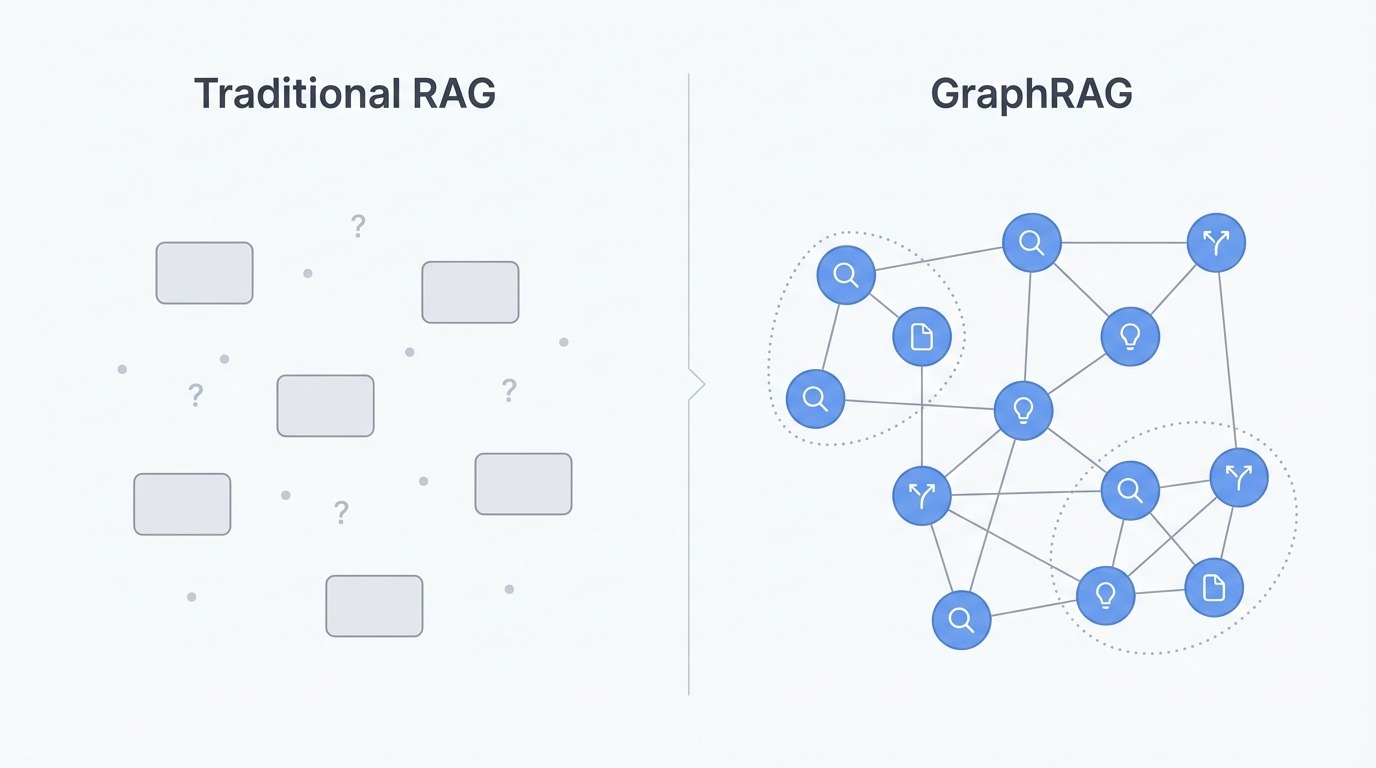
传统 RAG 与 GraphRAG 对比。作者供图。
GraphRAG 通过彻底改变表示来规避这些限制。它不再使用块,而是构建知识图谱,将实体作为节点、关系作为边。从源文档中抽取人物、组织、地点、概念和事件,以及它们彼此的连接方式。这样就保留了切分会丢掉的结构。
在图构建完成后,系统会应用社区发现(通常是 Leiden 算法),将相关实体聚为一组。这些簇会形成多个层级,有的紧密具体,有的宽泛主题化。分组源自数据中的真实连接,而非文档边界或块大小。
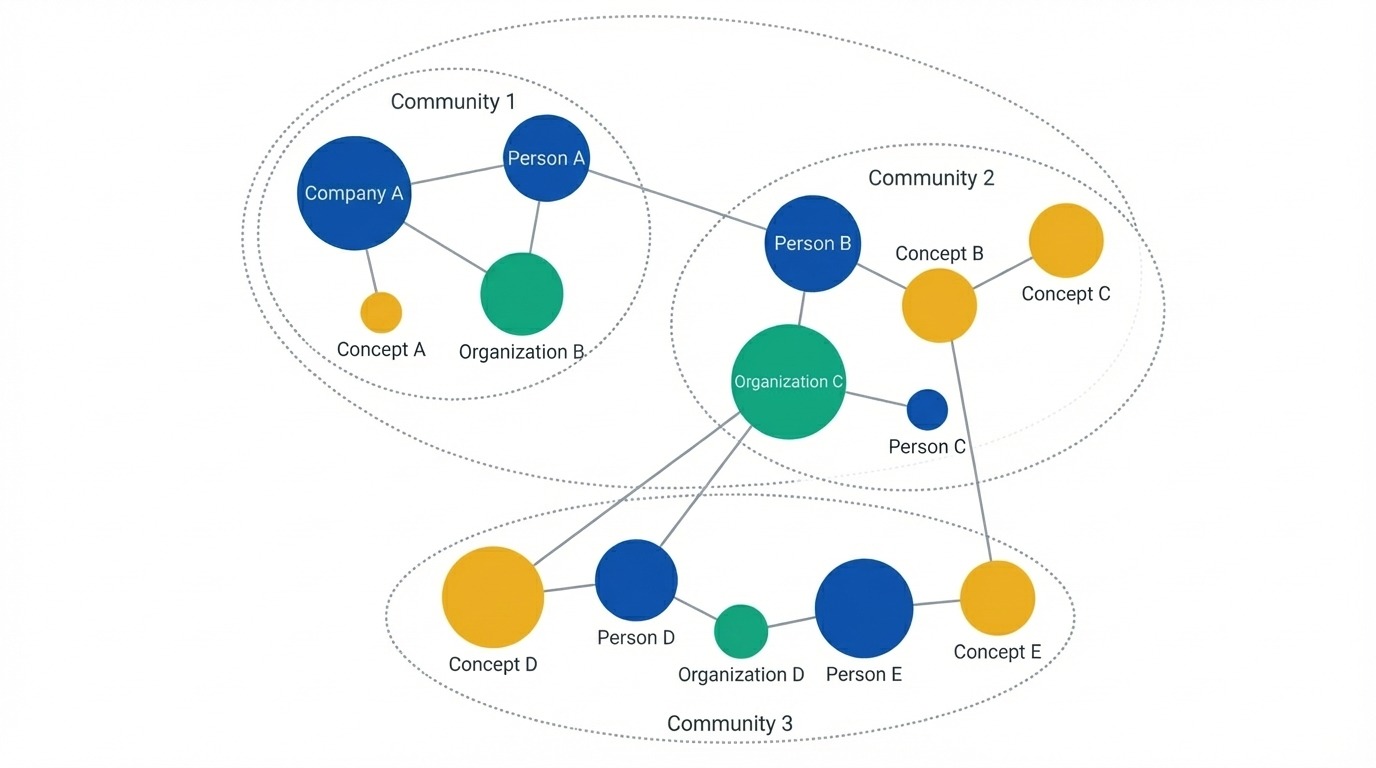
知识图谱将实体显示为节点。作者供图。
对于全局性问题,GraphRAG 会在任何用户查询到来之前,预先为每个社区生成摘要。当有人问“主要主题是什么?”时,系统不会搜索匹配文本,而是运行一次 map-reduce:每个社区摘要基于其图谱切片产生部分答案,然后将所有部分合并为最终回应。这样,GraphRAG 就能在不检索成千上万块的情况下,对整个语料进行推理。
对于多跳问题,图遍历取代相似度搜索。系统可以沿着边从一个实体走到另一个实体,追随向量搜索会错过的概念链。如果 A 连到 B 再连到 C,图谱知道这条路径存在并能沿之而行。
当您的问题需要对语料进行全局理解时,GraphRAG 的价值会体现出来。如果用户经常询问大型文档集合的主题、模式或摘要,基于图的检索会优于基于块的方法。同样适用于实体关系丰富的领域,如公司组织结构图、研究引文网络或法律案例历史,其中追踪连接至关重要。
对于简单的事实查询(“X 的电话号码是多少?”)或小型文档集,传统 RAG 完全胜任且成本更低。GraphRAG 在索引时间和 LLM 调用上都有额外开销,因此需要权衡投入产出。先从标准 RAG 开始,当遇到其局限时再转向 GraphRAG。
下表总结了权衡。传统 RAG 在简洁性和成本上占优,而当问题需要综合或关联推理时,GraphRAG 更胜一筹。
|
方面 |
传统 RAG |
GraphRAG |
|
数据表示 |
作为向量的孤立文本块 |
包含实体与关系的知识图谱 |
|
结构保留 |
在切分过程中丢失 |
通过图边加以维护 |
|
全局查询 |
较差(检索片段,无法综合) |
较强(对社区摘要执行 map-reduce) |
|
多跳推理 |
受限(独立的块级检索) |
原生支持(图遍历追随连接) |
|
索引成本 |
低(仅嵌入) |
高(LLM 抽取 + 嵌入 + 聚类) |
|
查询成本 |
低 |
不定(局部便宜,全局昂贵) |
|
最适合 |
事实查询,小型语料 |
主题性问题,关联性强的领域 |
流水线包含两个阶段:索引阶段构建图谱,查询阶段使用图谱。
索引通过五个步骤将原始文档转化为知识结构:
抽取步骤是 LLM 调用最多的部分。每个块都会用提示词让模型识别实体和关系。比如“OpenAI 发布了 GPT-4”这一块会产出两个实体,并有一条连接它们的关系。同一轮还会捕捉关系类型。由于每个块都需要一次 LLM 调用,索引是流水线中最昂贵的部分。查询时相对便宜,因为重活已经完成。
图构建会处理实体解析,这一步较为棘手。“OpenAI”“Open AI”“the company(该公司)”可能在不同块中都指向同一实体。系统会合并这些重复项以得到干净的图。
社区发现会应用 Leiden 算法,在多个层级上找到自然分组。0 级可能包含由 5–10 个相关实体组成的紧密簇。更高层级将它们归并为更宽泛的主题。比如一个关于 AI 公司的语料,0 级为各家公司的社区,1 级为“AI 实验室”“芯片制造商”,2 级涵盖整个科技生态。随后每个社区都会生成一个由 LLM 驱动的摘要,描述该簇所代表的内容。这些摘要在任何用户查询到来之前就已预计算完成。
最终产物不是检索索引,而是一种结构化表示:图谱加摘要,随时可以以不同方式查询。
图构建完成后,查询会路由到不同的检索策略:
检索到的内容(摘要、实体、关系、源文本)会被组装进提示词,LLM 生成最终答案。每种策略适合不同的问题类型,下面逐一拆解。
GraphRAG 提供三种不同的检索策略,分别适用于不同的问题。选择取决于您需要广泛综合、特定实体信息,还是介于两者之间的内容。
全局搜索回答需要理解整个语料的问题。诸如“这个文档集合的主要主题是什么?”或“这些报告中出现了哪些模式?”都需要从各处汇总信息,而不是从少数匹配片段中检索。
其机制是在社区摘要上执行 map-reduce。在 map 阶段,系统分别处理每个社区摘要:让 LLM 提取相关要点并对其重要性评分。在 reduce 阶段,将所有社区中评分最高的要点汇总成最终提示词,由 LLM 合成为连贯的回应。
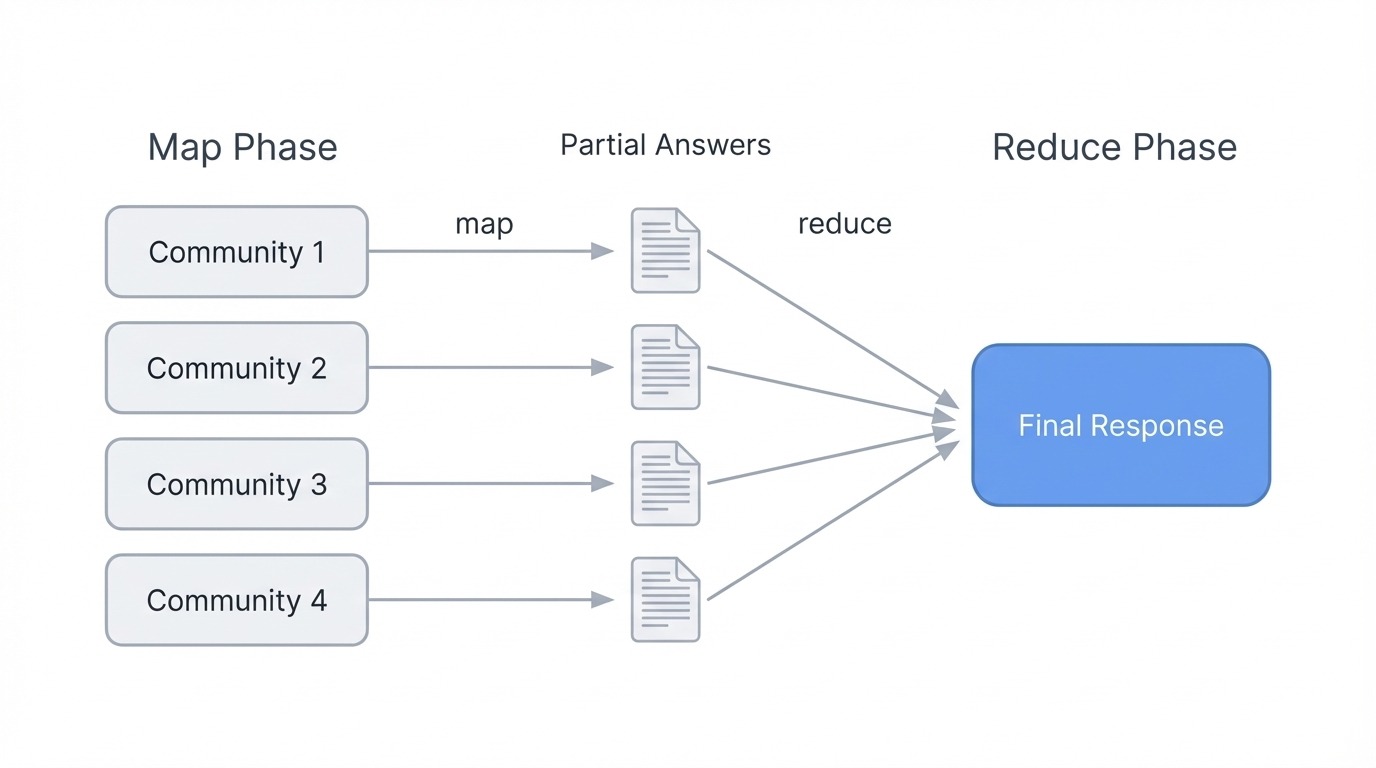
GraphRAG 全局搜索使用 map-reduce。作者供图
之所以有效,是因为社区摘要已概括了每个实体簇的主题。系统无需检索成千上万个块,而是对预先计算的描述进行推理,这些描述按您选择的层级代表图结构。较低层级(更小更紧的社区)提供更详尽的答案,但需要更多 LLM 调用;较高层级(更宽的分组)运行更快,但可能丢失细节。
全局搜索的计算负担重于其他模式,因为它会处理所有社区。仅在问题确实需要语料级理解、而非具体事实时使用它。
局部搜索处理特定实体的问题。“洋甘菊有哪些疗愈功效?”或“Acme 公司对其第三季度营收发布了什么公告?”这类问题都针对特定实体及其相关信息。
检索过程首先识别与查询相关的图中实体。这些实体成为遍历的入口点。系统从每个起始节点拉取相关实体、它们之间的关系、任何关联的主张或事实,以及这些实体所属的社区报告。同时还会检索与这些实体关联的原始文本块,为 LLM 提供结构化图数据与源文本。
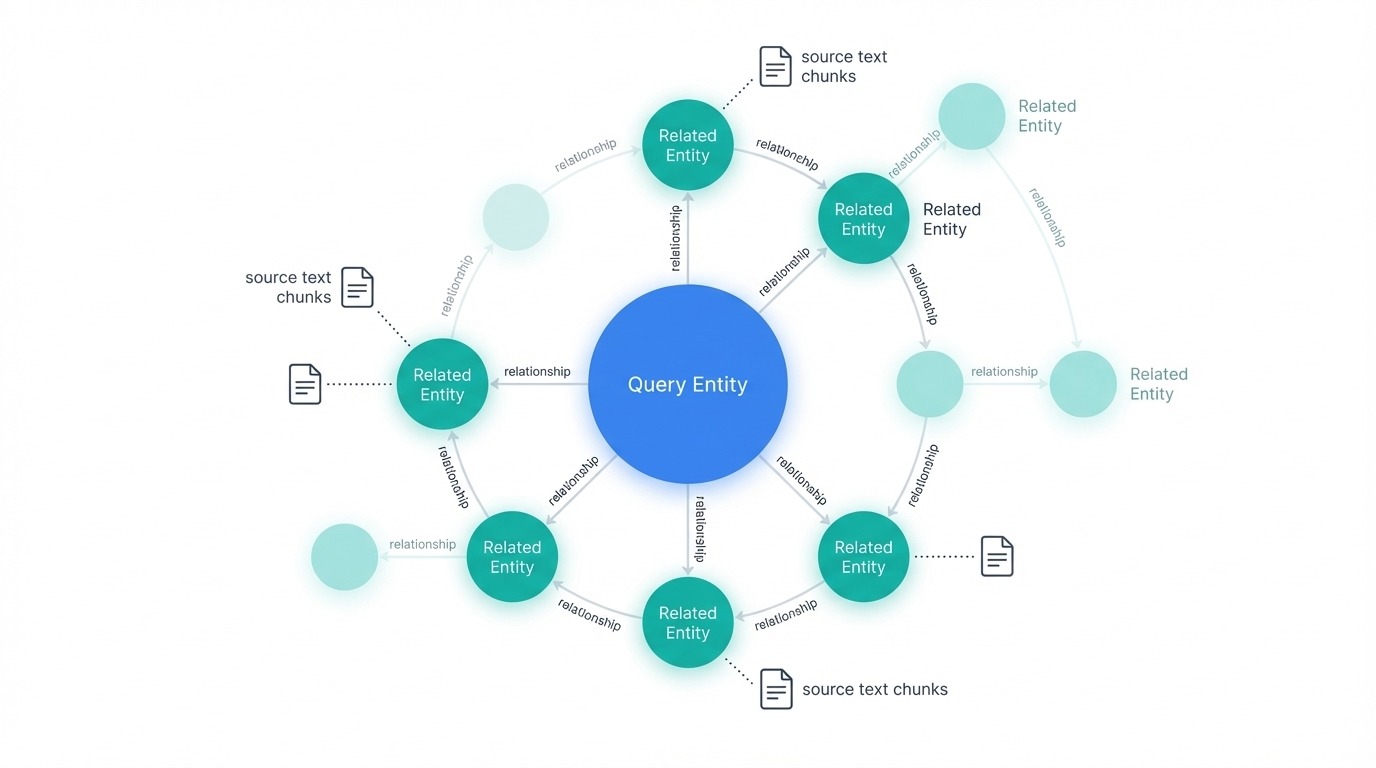
GraphRAG 局部搜索及其相关节点。作者供图
所有这些候选信息会被排序和筛选以适配上下文窗口。随后 LLM 基于检索内容生成答案。由于局部搜索聚焦于图的一个邻域而非全图,它比全局搜索更快、成本更低。
当问题询问文档中提到的具体事物、人物、组织或概念时,选择局部搜索。
DRIFT(Dynamic Reasoning and Inference with Flexible Traversal,动态推理与灵活遍历)介于全局与局部之间。它处理既需要广泛背景又需要具体细节的复杂查询。
流程分三步。第一,预热阶段将查询与最具语义相关性的社区摘要进行比对,生成初步答案与后续问题。第二,跟进阶段将这些问题应用于局部搜索,深入具体区域,产出中间答案与更有针对性的追问。第三,输出阶段将所有内容合并为排序结果,在全局洞见与局部细节间取得平衡。
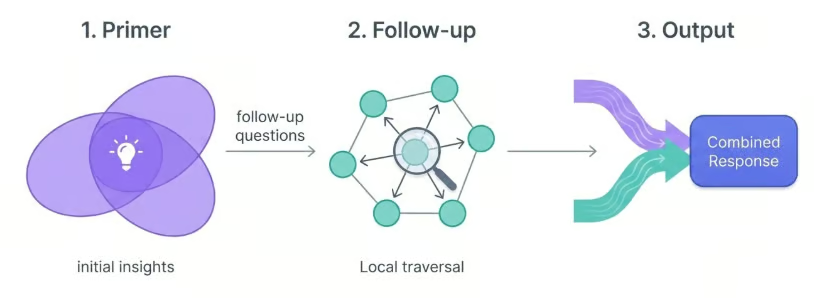
GraphRAG 的 DRIFT 搜索三阶段流程。作者供图。
DRIFT 的价值在于它扩展了搜索起点。通过从社区层面的上下文入手,它能检索到比纯局部搜索更广泛的事实;而通过局部遍历逐步细化,又避免了全局搜索的高成本。
在诸如“X 公司面临的挑战如何与更广泛的行业趋势比较?”这类既需要特定实体信息又需要主题背景的问题中,选用 DRIFT。
|
方面 |
全局 |
局部 |
DRIFT |
|
最适合 |
语料级主题与模式 |
特定实体问题 |
需要两者兼顾的复杂查询 |
|
机制 |
对社区摘要执行 map-reduce |
实体邻域遍历 |
预热 → 跟进 → 输出阶段 |
|
速度 |
最慢(处理所有社区) |
最快(聚焦遍历) |
中等(先广后窄) |
|
成本 |
最高 |
最低 |
中等 |
|
示例查询 |
“主要主题是什么?” |
“X 公司发布了什么?” |
“X 与行业趋势如何比较?” |
GraphRAG 还提供了一个基础向量搜索,作为对图遍历大材小用时的后备方案。但在大多数用例中,在全局、局部和 DRIFT 之间进行选择就已足够。
本节将演示如何基于微软的参考实现构建 GraphRAG 系统。为保持示例可运行且成本可控,我们将使用 Paul Graham 关于初创公司的小型随笔语料。如果您刚开始将知识图谱与检索系统结合,知识图谱 RAG 教程涵盖了基础概念。
创建项目目录并用 uv 初始化,然后安装 graphrag 包。该库依赖较多(包含 PyTorch 在内共 237 个包),安装预计约需五分钟:
mkdir ragtest && cd ragtest
 uv init
 uv add graphrag
 graphrag init --root .
这将生成如下项目结构:
ragtest/
 ├── .env                	# API key configuration
 ├── settings.yaml       	# Pipeline settings
 ├── prompts/            	# LLM prompt templates
 │   ├── extract_graph.txt
 │   ├── summarize_descriptions.txt
 │   └── ...
 └── input/              	# Your source documents go here
prompts/ 目录包含 GraphRAG 用于实体抽取与摘要生成的模板。您可以针对特定领域自定义它们,尽管默认设置对通用文本已相当有效。
将文本文件添加到 input/ 目录。本文示例使用 Paul Graham 关于初创公司的三篇随笔。他的网站使用极简 HTML,内容包裹在 <font> 标签中,因此用一个简单的解析器就能干净地提取文本:
import urllib.request
 from html.parser import HTMLParser

 class TextExtractor(HTMLParser):
 	def __init__(self):
     	super().__init__()
     	self.text = []
     	self.in_font = False

 	def handle_starttag(self, tag, attrs):
     	if tag == 'font':
         	self.in_font = True

 	def handle_endtag(self, tag):
     	if tag == 'font':
         	self.in_font = False

 	def handle_data(self, data):
     	if self.in_font:
         	self.text.append(data)

 essays = {
 	"startupideas": "http://paulgraham.com/startupideas.html",
     "do_things_that_dont_scale": "http://paulgraham.com/ds.html",
 	"startup_growth": "http://paulgraham.com/growth.html"
 }

 for name, url in essays.items():
 	with urllib.request.urlopen(url) as response:
     	html = response.read().decode('utf-8')
 	parser = TextExtractor()
 	parser.feed(html)
 	text = ' '.join(parser.text)
 	with open(f"input/{name}.txt", "w") as f:
     	f.write(text)
 	print(f"Saved {name}.txt ({len(text.split())} words)")
Saved startupideas.txt (3000 words)
Saved do_things_that_dont_scale.txt (3000 words)
Saved startup_growth.txt (3000 words)三篇主题相关随笔合计约 9,000 字,足以看到有意义的实体关系,同时不会产生高昂的 API 成本。
编辑 .env,添加您的 OpenAI API 密钥:
GRAPHRAG_API_KEY=your-openai-api-key-here默认的 settings.yaml 开箱即用,但您可能希望调整模型。文件默认为 gpt-4o-mini,在成本与质量之间取得平衡。完整可用选项参见完整配置参考:
models:
   default_chat_model:
 	type: openai_chat
 	auth_type: api_key
 	api_key: ${GRAPHRAG_API_KEY}
 	model: gpt-4o-mini
 	model_supports_json: true
 	concurrent_requests: 25

   default_embedding_model:
 	type: openai_embedding
 	auth_type: api_key
 	api_key: ${GRAPHRAG_API_KEY}
 	model: text-embedding-3-small
配置中其他值得注意的设置:
chunks:
   size: 1200  	# Tokens per chunk
   overlap: 100	# Overlap between chunks

 extract_graph:
   entity_types: [organization, person, geo, event]
   max_gleanings: 1	# Additional extraction passes

 cluster_graph:
max_cluster_size: 10用以下命令构建知识图谱:
graphrag index --root .流水线会依次执行实体抽取、图构建与社区发现:
├── Loading Input (InputFileType.text) - 3 files loaded (0 filtered) ───
 ├── create_base_text_units
 ├── create_final_documents
 ├── extract_graph
 ├── finalize_graph
 ├── create_final_entities
 ├── create_final_relationships
 ├── create_final_text_units
 ├── create_base_entity_graph
 ├── create_communities
 ├── create_final_communities
 ├── create_community_reports
 ├── generate_text_embeddings
 ⠋ GraphRAG Indexer
├── All workflows completed successfully每一步都建立在前一步之上。extract_graph 阶段占了大部分 LLM 调用,而 create_communities 则应用了Leiden 算法对相关实体聚类。
对于我们的三篇随笔,索引约两分钟完成。您可以通过加载 parquet 文件或查看行数来检查结果:
输出位于 output/ 目录下的 parquet 文件中:
output/
 ├── documents.parquet
 ├── entities.parquet
 ├── relationships.parquet
 ├── text_units.parquet
 ├── communities.parquet
 ├── community_reports.parquet
 └── lancedb/      	# Vector embeddings
parquet 格式具有良好的可移植性。您可以用 pandas 加载这些文件来检查实体、浏览关系或调试抽取问题。整个项目目录足够小,便于纳入版本控制(本语料低于 10MB),只需排除包含 API 密钥的 .env 文件。
GraphRAG 提供三种查询模式。我们分别试用。
全局搜索,用于主题性问题:
graphrag query \
 	--root . \
 	--method global \
 	--query "What are the main themes and lessons about startups in these essays?"
SUCCESS: Global Search Response:
The essays present several interconnected themes about startups:
**Growth as the defining characteristic**: A startup isn't just a new company—it's
specifically designed for rapid growth. This growth orientation shapes everything
from idea selection to daily decision-making. The essays suggest using weekly
growth rate as a compass for all strategic choices.
**The power of doing unscalable things**: Counterintuitively, successful startups
often begin with manual, labor-intensive approaches. Stripe's founders would
physically set up new users on the spot. Airbnb's founders went door-to-door
recruiting hosts. These unscalable tactics bootstrap the initial user base.
**Ideas emerge from problems, not brainstorming**: The best startup ideas come
from founders solving their own problems or noticing gaps while "living in the
future." Deliberately trying to generate ideas tends to produce plausible-sounding
but ultimately weak concepts.
**User relationships matter early**: Early users provide irreplaceable feedback.
Founders should go beyond standard customer service to create exceptional
experiences, gathering insights that shape the product.该回应综合了三篇随笔中的主题,这在传统 RAG 中需要检索并处理大量块。全局搜索改为利用社区摘要,给出连贯的高层视图。
用于实体问题的局部搜索:
graphrag query \
 	--root . \
 	--method local \
 	--query "What role does Y Combinator play according to these essays?"
SUCCESS: Local Search Response:
Y Combinator functions as both an accelerator and a testing ground for startup
principles. According to the essays, YC provides:
**Funding and validation**: YC offers initial funding that lets founders focus
on building rather than fundraising. The program validates ideas through its
selection process.
**Growth measurement framework**: YC tracks startups by weekly growth rate,
with 5-7% weekly growth considered good and 10% exceptional. This metric-driven
approach forces founders to confront whether they're making real progress.
**Network effects**: B2B startups at YC gain immediate access to hundreds of
potential customers—other YC companies. Stripe leveraged this extensively in
its early days.
**Demo Day as forcing function**: The program's structure, culminating in Demo
Day presentations to investors, creates urgency that pushes founders to ship
and iterate quickly.局部搜索从 Y Combinator 实体出发遍历图谱,拉入了增长指标、Stripe 和 Demo Day 等相关概念。答案扎根于随笔对 YC 的实际论述,而非泛化常识。
需要广度与细节兼顾的问题可用 DRIFT 搜索:
graphrag query \
 	--root . \
 	--method drift \
 	--query "How do the essays describe the relationship between startup ideas and user problems?"
SUCCESS: Drift Search Response:
The essays establish a direct link between viable startup ideas and genuine user
problems through several mechanisms:
**Organic discovery over invention**: Rather than brainstorming ideas, founders
should notice problems they personally experience. Microsoft, Apple, Google, and
Facebook all started this way—founders building something they themselves needed.
**The "well" vs "shallow hole" distinction**: Good ideas serve a small number of
users who desperately need the solution (a narrow, deep well) rather than many
users with mild interest (a broad, shallow hole). Depth of need matters more
than breadth of appeal initially.
**Feedback loops as validation**: Engaging directly with early users reveals
whether the problem is real and the solution fits. This feedback shapes the
product more than any amount of planning.
**Problem-first, solution-second**: The essays warn against "sitcom startup
ideas"—concepts that sound plausible but don't address real pain points. A
social network for pet owners sounds reasonable but lacks urgent demand.DRIFT 先以社区层面的初创理念作广义背景,再钻入“水井”类比与“情景喜剧式创意”等具体例子。结果将主题洞见与源文本中的具体细节结合在一起。
在生产系统中,直接使用 Python API。流程分为三部分:加载配置、加载索引数据、运行查询。
首先,通过加载环境变量并解析设置文件来配置:
import os
 import yaml
 from pathlib import Path
 from dotenv import load_dotenv
 from graphrag.config.create_graphrag_config import create_graphrag_config

 ROOT_DIR = Path(".")

 # Load environment variables and config
 load_dotenv(ROOT_DIR / ".env")
 with open(ROOT_DIR / "settings.yaml") as f:
 	yaml_content = f.read()
 yaml_content = os.path.expandvars(yaml_content)  # Expand ${VAR} references
 settings = yaml.safe_load(yaml_content)
 config = create_graphrag_config(values=settings, root_dir=str(ROOT_DIR))
接着,从 parquet 文件中加载全部索引数据。GraphRAG 将实体、关系、社区与文本块分别存储:
import pandas as pd

 output_dir = ROOT_DIR / "output"
 entities = pd.read_parquet(output_dir / "entities.parquet")
 communities = pd.read_parquet(output_dir / "communities.parquet")
 community_reports = pd.read_parquet(output_dir / "community_reports.parquet")
 text_units = pd.read_parquet(output_dir / "text_units.parquet")
 relationships = pd.read_parquet(output_dir / "relationships.parquet")

 print(f"Loaded {len(entities)} entities, {len(relationships)} relationships")
Loaded 74 entities, 89 relationships最后,使用异步 API 运行查询。local_search 函数接收所有数据框及查询参数:
import asyncio
 from graphrag.api import local_search

 async def run_query(query: str):
 	response, context = await local_search(
     	config=config,
     	entities=entities,
     	communities=communities,
         community_reports=community_reports,
     	text_units=text_units,
     	relationships=relationships,
     	covariates=None,
     	community_level=2,
     	response_type="Multiple Paragraphs",
     	query=query,
 	)
 	return response

 query = "What advice do the essays give about finding startup ideas?"
 response = asyncio.run(run_query(query))
 print(response)
The essays provide several valuable insights into finding startup ideas:
Focus on Growth: A startup is designed to grow quickly. Founders should commit
to seeking ideas that can scale significantly, as this distinguishes startups
from ordinary businesses.
Identify Unmet Needs: Successful startups arise from recognizing problems that
need solving. Founders who can see different problems, particularly those
addressable through technology, are more likely to develop effective solutions.
Leverage Personal Insights: Many successful startups originate from the unique
insights of their founders, often stemming from personal experiences or
frustrations. This personal connection leads to more authentic solutions.
Explore Overlooked Markets: Founders should think outside the box and explore
markets that may be overlooked. Successful startups often emerge from ideas
that seem obvious to the founders but aren't yet recognized broadly.Python API 让您完全掌控要加载的数据、要查询的社区层级以及响应格式。若您的应用需要自定义检索逻辑或与现有系统集成,这是一条可行路径。
传统 RAG 在很多场景下都很好用,直到不够用了为止。当用户询问主题或模式,却得到一堆松散相关的片段而不是连贯答案时,您就触到了那堵墙。GraphRAG 通过以知识图谱与预计算的社区摘要替代块,来解决这一问题。
当然这也有成本。索引会大量消耗 LLM 调用,全局搜索也不便宜。对于小型文档集或简单查找,继续用向量搜索即可。
但如果您的语料中蕴含丰富的实体连接,且用户关心这些连接,GraphRAG 值得投入。根据问题选择查询类型:全局用于主题,局部用于特定实体,DRIFT 用于两者兼而有之。跑通一次实现后并不复杂,而 parquet 输出也便于检查与调试。
与 DataCamp 一起学习
课程
课程
实践并学习路径你的进步。
使用 Google 继续