
Cursus
Retrieval Augmented Generation (RAG) met LangChain
3 uur
20.9K
Traditionele RAG-systemen halen documentfragmenten op op basis van semantische gelijkenis, wat goed werkt voor eenvoudige vragen. Maar wanneer een query informatie moet samenbrengen die verspreid is over meerdere documenten of moet redeneren over verbonden concepten, schiet vectorzoek tekort. Het systeem haalt losse brokken op zonder te begrijpen hoe ze zich tot elkaar verhouden.
GraphRAG behandelt documenten niet als geïsoleerde stukken. Het bouwt een kennisgrafiek die entiteiten en hun relaties vastlegt. Deze structuur stelt het systeem in staat om verbindingen te volgen en vragen te beantwoorden die vereisen dat informatie uit meerdere bronnen wordt samengebracht. Het is een van meerdere geavanceerde RAG-technieken die de beperkingen van basale retrieval aanpakken.
GraphRAG is een retrieval-augmented generation-techniek die documenten voorstelt als kennisgrafen in plaats van vector-embeddings. In plaats van tekst op te breken in fragmenten die onafhankelijk worden doorzocht, extraheert GraphRAG entiteiten (denk aan personen, organisaties, concepten, gebeurtenissen) en de relaties daartussen, en organiseert deze informatie in een onderling verbonden graafstructuur.
Het GraphRAG-systeem past vervolgens community-detectiealgoritmen toe om clusters van verwante entiteiten te identificeren en genereert samenvattingen voor deze clusters op hiërarchische niveaus. Wanneer er een query binnenkomt, kan GraphRAG ofwel door specifieke entiteitsbuurten traverseren voor gerichte vragen of map-reduce-operaties uitvoeren over community-samenvattingen voor synthese over de hele corpus.
Laten we nu de mechaniek van dichterbij bekijken. Dat helpt te begrijpen waarom grafiekgebaseerde retrieval is ontstaan en welk gat het vult.
Het kernprobleem van traditionele RAG is niet de retrieval of de generatie, maar de representatie. Documenten worden opgedeeld in stukken en elk stuk wordt een geïsoleerde vector die in embedding-ruimte zweeft. Welke structuur er ook in het origineel zat – de koppen, de verhaallijn, welke paragraaf waarnaar verwees – wordt platgeslagen.
Dit veroorzaakt problemen bij vragen die informatie moeten combineren. Vraag "Wat zijn de belangrijkste thema's in deze documenten?" en vectorzoek geeft stukken terug die het woord "thema's" of verwante termen bevatten. Maar relevante fragmenten vinden is niet hetzelfde als patronen over een corpus begrijpen. Het systeem kan informatie niet op schaal samenbrengen omdat het alleen individuele delen ziet, nooit het geheel.
Multi-hop-redeneren loopt tegen een vergelijkbare muur. Stel dat het antwoord op een vraag afhangt van het verbinden van concept A met B met C. Traditionele RAG haalt elk fragment onafhankelijk op op basis van gelijkenis met de query. Als B niet dicht bij de vraag ligt, wordt het misschien helemaal niet opgehaald en valt de keten uiteen. Het systeem vindt eindpunten maar mist het pad ertussen.
Er is ook een mismatch tussen retrieval en context om rekening mee te houden. Je kunt twintig zeer relevante fragmenten ophalen, maar ze allemaal in een prompt stoppen garandeert niet dat de LLM ze gebruikt. De "lost in the middle"-paper laat zien dat LLM's zich vaak focussen op informatie aan het begin en einde van hun contextvenster, en wat ertussenin begraven ligt over het hoofd zien. Meer retrieval betekent niet automatisch betere antwoorden.
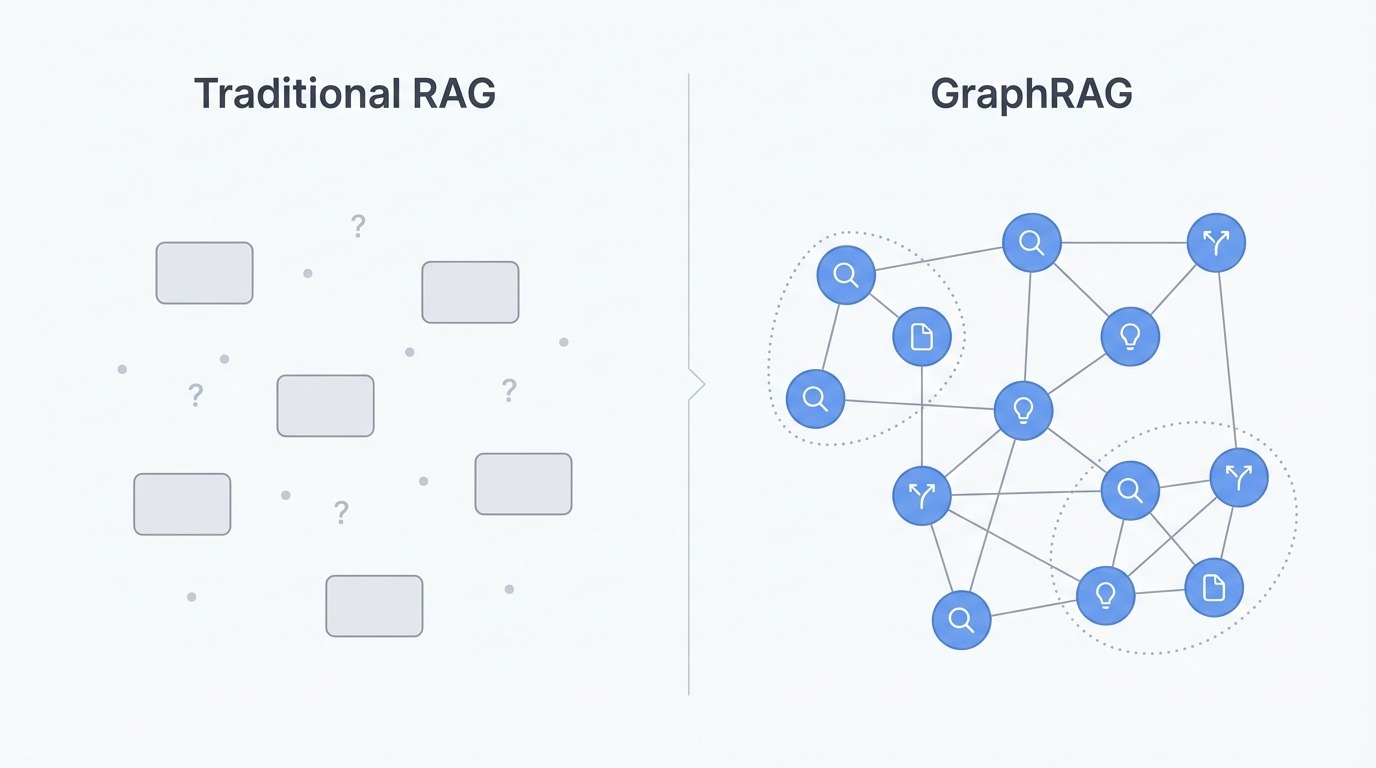
Vergelijking van traditionele RAG en GraphRAG. Afbeelding door de auteur.
GraphRAG omzeilt deze beperkingen door de representatie volledig te veranderen. In plaats van fragmenten bouwt het een kennisgrafiek waarin entiteiten knooppunten zijn en relaties randen. Personen, organisaties, locaties, concepten en gebeurtenissen worden uit de bronteksten gehaald, samen met hoe ze met elkaar verbonden zijn. Dit behoudt structuur die bij het chunken verloren gaat.
Met de graaf op zijn plaats past het systeem community-detectie toe (meestal het Leiden-algoritme) om verwante entiteiten te clusteren. Deze clusters ontstaan op meerdere niveaus: sommige klein en specifiek, andere breed en thematisch. De groeperingen komen voort uit daadwerkelijke verbindingen in de data, in plaats van documentgrenzen of chunkgroottes.
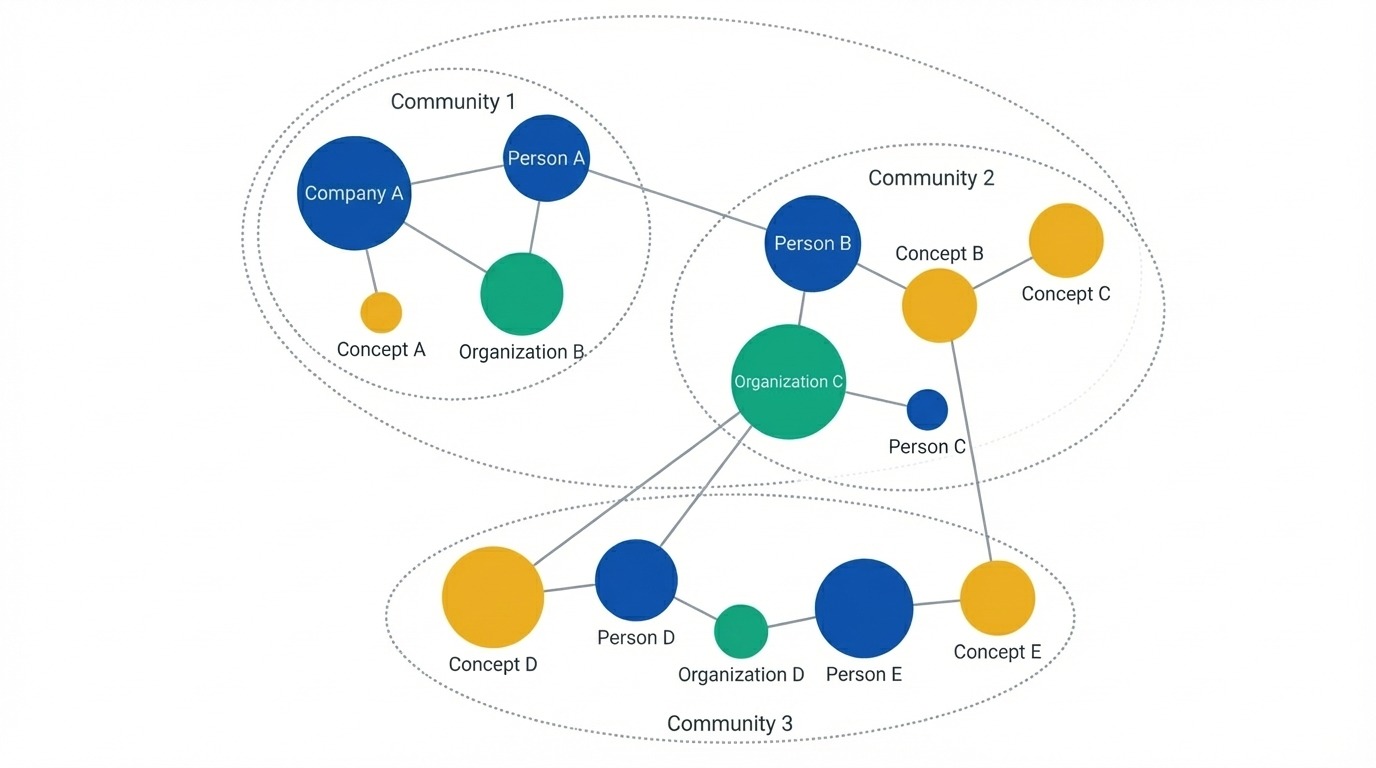
Kennisgrafiek met entiteiten als knooppunten. Afbeelding door de auteur.
Voor globale vragen genereert GraphRAG vooraf samenvattingen voor elke community, nog vóór er een gebruikersquery binnenkomt. Wanneer iemand vraagt "Wat zijn de belangrijkste thema's?", zoekt het systeem niet naar overeenkomende tekst. In plaats daarvan draait het een map-reduce-operatie: elke community-samenvatting produceert een deelantwoord op basis van zijn deel van de graaf, waarna alle deelantwoorden worden samengevoegd tot een eindantwoord. Zo kan GraphRAG over een hele corpus redeneren zonder duizenden fragmenten op te halen.
Voor multi-hop-vragen vervangt graaftraversal de gelijkeniszoektocht. Het systeem kan randen volgen van entiteit naar entiteit en zo conceptuele ketens volgen die vectorzoek zou missen. Als A verbonden is met B en B met C, weet de graaf dat dit pad bestaat en kan het volgen.
GraphRAG loont wanneer je vragen corpusbrede kennis vereisen. Als gebruikers vaak vragen naar thema's, patronen of samenvattingen over grote documentverzamelingen, presteert grafiekgebaseerde retrieval beter dan chunkaanpakken. Hetzelfde geldt voor domeinen met rijke entiteitsrelaties, zoals organogrammen van bedrijven, netwerken van onderzoekscitaties of jurisprudentie, waar het volgen van verbindingen ertoe doet.
Voor eenvoudige feitelijke opzoekvragen ("Wat is het telefoonnummer van X?") of kleine documentsets werkt traditionele RAG prima en is goedkoper. GraphRAG voegt overhead toe in zowel indextijd als LLM-calls, dus de opbrengst moet de investering rechtvaardigen. Begin met standaard RAG en stap over op GraphRAG wanneer je tegen de beperkingen aanloopt.
De onderstaande tabel vat de afwegingen samen. Traditionele RAG wint op eenvoud en kosten, terwijl GraphRAG beter presteert wanneer vragen synthese of verbonden redeneren vereisen.
|
Aspect |
Traditionele RAG |
GraphRAG |
|
Datarepresentatie |
Geïsoleerde tekstfragmenten als vectoren |
Kennisgrafiek met entiteiten en relaties |
|
Behoud van structuur |
Gaat verloren tijdens chunken |
Behouden via graaf-randen |
|
Globale vragen |
Zwak (haalt fragmenten op, kan niet synthetiseren) |
Sterk (map-reduce over community-samenvattingen) |
|
Multi-hop-redeneren |
Beperkt (onafhankelijke chunk-retrieval) |
Natuurlijk (graaftraversal volgt verbindingen) |
|
Indexeringskosten |
Laag (alleen embeddings) |
Hoog (LLM-extractie + embedding + clustering) |
|
Querykosten |
Laag |
Variabel (lokaal is goedkoop, globaal is duur) |
|
Beste voor |
Feitelijke opzoekingen, kleine corpora |
Thematische vragen, verbonden domeinen |
De pijplijn heeft twee fasen: indexeren bouwt de graaf, queryen gebruikt hem.
Indexeren zet ruwe documenten om in een kennisstructuur via vijf stappen:
De extractiestap is waar de meeste LLM-calls plaatsvinden. Elk fragment wordt verwerkt met een prompt waarin het model wordt gevraagd entiteiten en relaties te identificeren. Een fragment met "OpenAI bracht GPT-4 uit" levert entiteiten voor beide op, plus een relatie die hen verbindt. In dezelfde stap wordt het relatietype vastgelegd. Omdat elk fragment een LLM-call vereist, is indexeren het dure deel van de pijplijn. Querytijd is relatief goedkoop omdat het zware werk al gedaan is.
Graafconstructie behandelt entiteitsresolutie, wat lastig kan zijn. "OpenAI", "Open AI" en "het bedrijf" kunnen in verschillende fragmenten naar dezelfde entiteit verwijzen. Het systeem voegt deze dubbelen samen om een schone graaf te maken.
Community-detectie past het Leiden-algoritme toe om natuurlijke groeperingen op meerdere niveaus te vinden. Niveau 0 kan krappe clusters van 5–10 verwante entiteiten bevatten. Hogere niveaus groeperen die tot bredere thema's. Een corpus over AI-bedrijven kan op niveau 0 communities hebben per individueel bedrijf, op niveau 1 "AI-labs" en "chipfabrikanten", en op niveau 2 het hele tech-ecosysteem. Elke community krijgt vervolgens een door een LLM gegenereerde samenvatting die beschrijft wat die cluster vertegenwoordigt. Deze samenvattingen worden vooraf berekend voordat er een gebruikersquery binnenkomt.
Het eindresultaat is geen retrieval-index. Het is een gestructureerde representatie: graaf plus samenvattingen, klaar om op verschillende manieren te bevragen.
Met de graaf gebouwd, worden queries naar verschillende retrievalstrategieën gerouteerd:
De opgehaalde inhoud (samenvattingen, entiteiten, relaties, brontekst) wordt samengevoegd tot een prompt, en de LLM genereert het eindantwoord. Elke strategie bedient verschillende vraagtypen, die we zo uiteen zetten.
GraphRAG biedt drie verschillende retrievalstrategieën, elk geschikt voor andere vraagtypen. De juiste kiezen hangt ervan af of je brede synthese, specifieke entiteitsinformatie of iets daartussenin nodig hebt.
Globaal zoeken beantwoordt vragen die begrip van een hele corpus vereisen. Vragen als "Wat zijn de belangrijkste thema's in deze documentencollectie?" of "Welke patronen komen naar voren in deze rapporten?" hebben informatie nodig die overal vandaan wordt geaggregeerd, niet uit een paar overeenkomende fragmenten.
Het mechanisme is map-reduce over community-samenvattingen. In de map-fase wordt elke community-samenvatting onafhankelijk verwerkt: het systeem vraagt een LLM om relevante punten te extraheren en hun belang te beoordelen. In de reduce-fase worden de hoogst beoordeelde punten uit alle communities geaggregeerd in een eindprompt, en de LLM synthesizeert die tot een coherent antwoord.
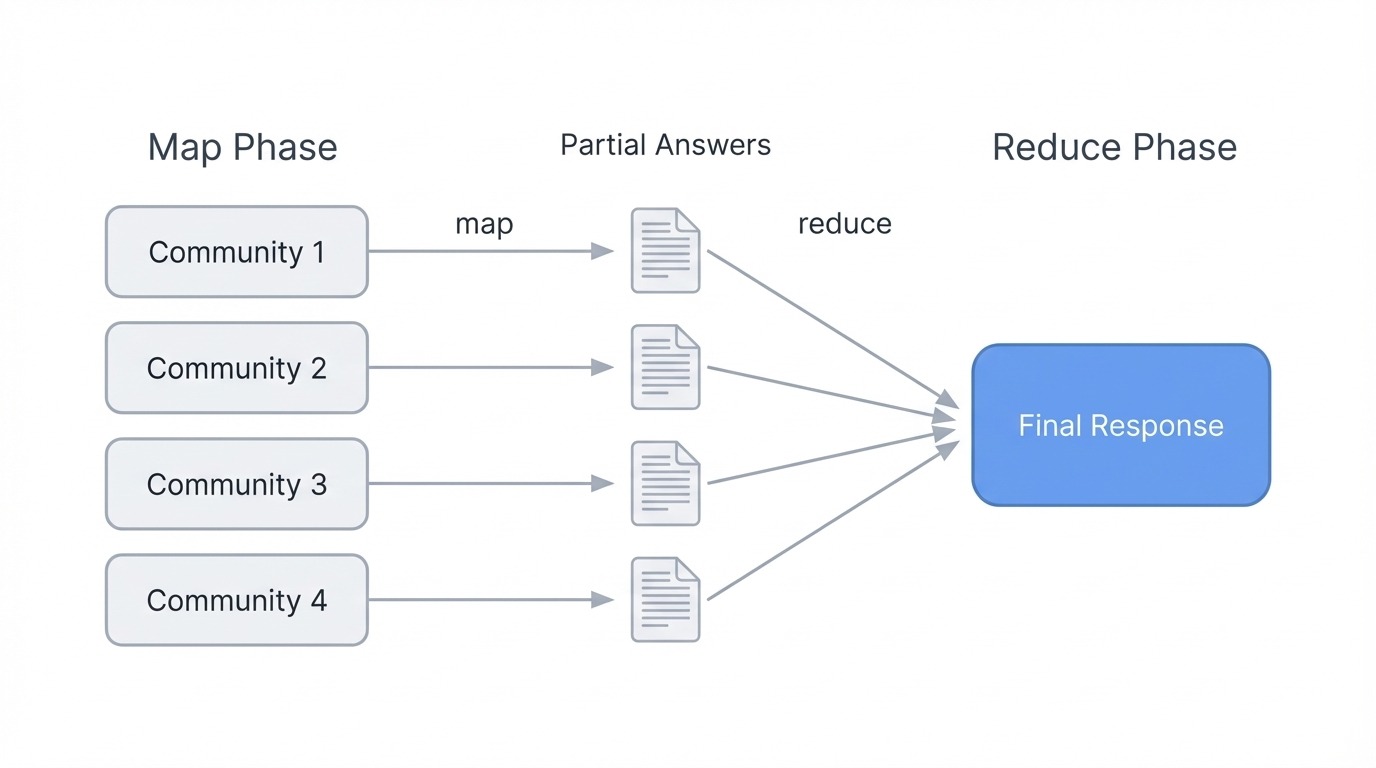
GraphRAG globaal zoeken met map-reduce. Afbeelding door de auteur
Dit werkt omdat community-samenvattingen al vastleggen waar elke cluster van entiteiten over gaat. Het systeem hoeft geen duizenden fragmenten op te halen. In plaats daarvan redeneert het over vooraf berekende beschrijvingen die de structuur van de graaf weergeven op welk hiërarchieniveau je ook kiest. Lagere niveaus (kleinere, hechtere communities) geven meer gedetailleerde antwoorden maar kosten meer LLM-calls. Hogere niveaus (bredere groeperingen) draaien sneller maar kunnen nuance missen.
Globaal zoeken is rekenkundig zwaarder dan de andere modi omdat het alle communities verwerkt. Gebruik het wanneer vragen echt corpusbrede inzichten vereisen in plaats van specifieke feiten.
Lokaal zoeken behandelt entiteitsspecifieke vragen. "Wat zijn de geneeskrachtige eigenschappen van kamille?" of "Wat kondigde Acme Corp aan over hun Q3-omzet?" richten zich op specifieke entiteiten en de informatie die ermee verbonden is.
Het retrievalproces begint met het identificeren welke entiteiten in de graaf verband houden met de query. Deze entiteiten worden startpunten voor traversal. Vanaf elk startknooppunt haalt het systeem verbonden entiteiten op, de relaties daartussen, eventuele bijbehorende claims of feiten, en de community-rapporten waar die entiteiten toe behoren. Ook haalt het de oorspronkelijke tekstfragmenten op die aan die entiteiten zijn gekoppeld, zodat de LLM zowel gestructureerde graafdata als brontekst krijgt.
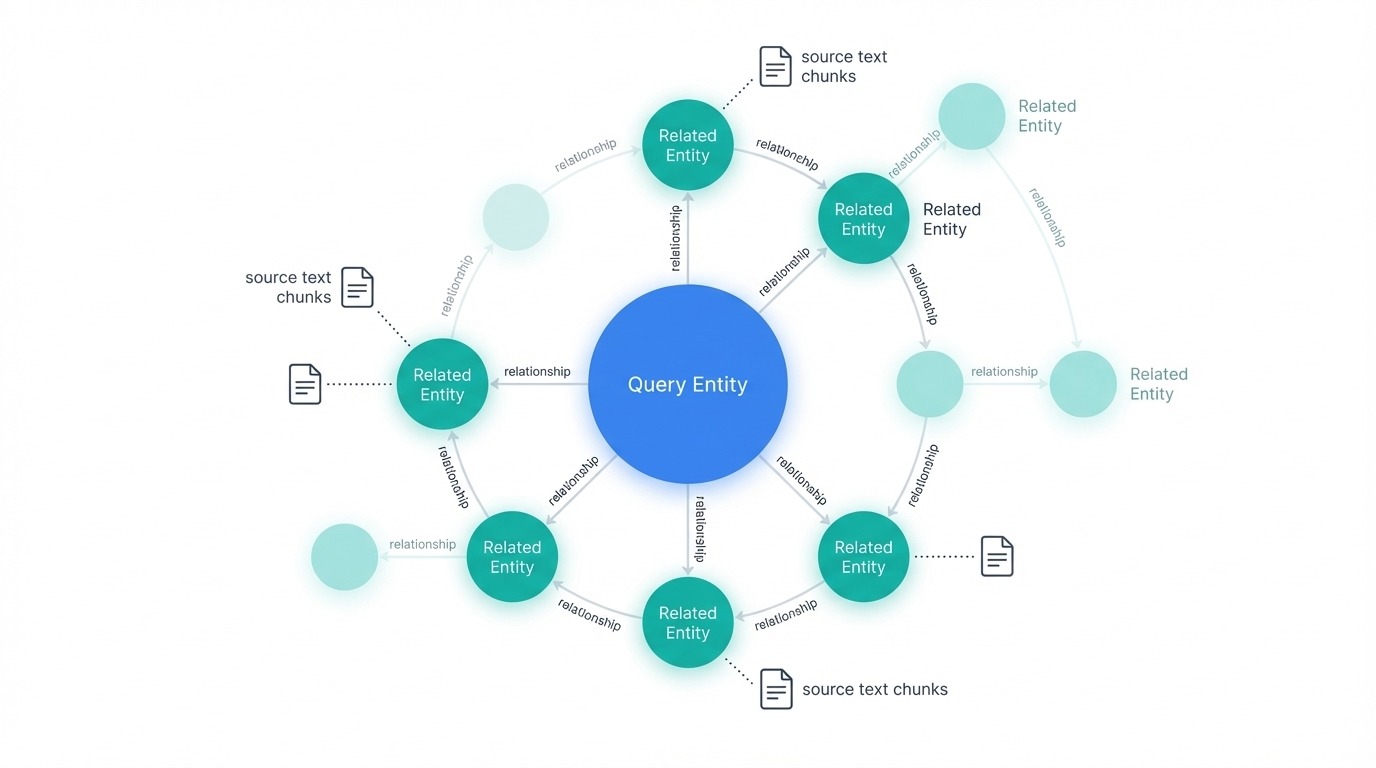
GraphRAG lokaal zoeken met gerelateerde knooppunten. Afbeelding door de auteur
Al deze kandidaat-informatie wordt gerangschikt en gefilterd om in het contextvenster te passen. De LLM genereert vervolgens een antwoord dat is gegrond in de opgehaalde inhoud. Omdat lokaal zoeken zich richt op een buurt van de graaf in plaats van het geheel, draait het sneller en goedkoper dan globaal zoeken.
Kies lokaal zoeken wanneer vragen gaan over specifieke dingen, personen, organisaties of concepten die in je documenten worden genoemd.
DRIFT (Dynamic Reasoning and Inference with Flexible Traversal) zit tussen globaal en lokaal in. Het behandelt complexe queries die zowel brede context als specifieke details nodig hebben.
Het proces heeft drie fasen. Eerst vergelijkt de primer-fase de query met de meest semantisch relevante community-samenvattingen en genereert een eerste antwoord plus vervolgvraagjes. Vervolgens neemt de follow-upfase die vragen en past lokaal zoeken toe om in specifieke gebieden te verdiepen, wat tussentijdse antwoorden en gerichtere vervolgvragen oplevert. Ten slotte combineert de outputfase alles tot gerangschikte resultaten die globale inzichten en lokale specificiteit balanceren.
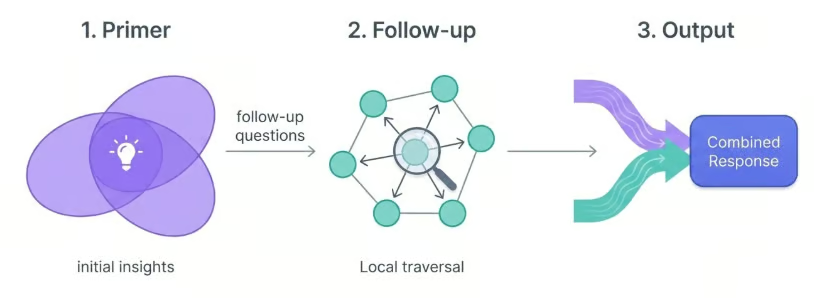
GraphRAG DRIFT-zoek driestapsproces. Afbeelding door de auteur.
Wat DRIFT nuttig maakt, is hoe het het startpunt van de zoekopdracht vergroot. Door te beginnen met context op community-niveau, haalt het een breder scala aan feiten op dan puur lokaal zoeken zou doen. Maar door te verfijnen via lokale traversal, vermijdt het de kosten van volledig globaal zoeken.
Gebruik DRIFT voor vragen als "Hoe verhouden de uitdagingen van bedrijf X zich tot bredere sectortrends?" waarbij je zowel specifieke entiteitsinformatie als thematische context nodig hebt.
|
Aspect |
Globaal |
Lokaal |
DRIFT |
|
Beste voor |
Corpusbrede thema's en patronen |
Specifieke entiteitsvragen |
Complexe queries die beide nodig hebben |
|
Mechanisme |
Map-reduce over community-samenvattingen |
Traversal van entiteitsbuurten |
Primer → follow-up → output-fasen |
|
Snelheid |
Traagst (verwerkt alle communities) |
Snelst (gerichte traversal) |
Gemiddeld (start breed, vernauwt) |
|
Kosten |
Hoogst |
Laagst |
Gemiddeld |
|
Voorbeeldquery |
"Wat zijn de belangrijkste thema's?" |
"Wat kondigde bedrijf X aan?" |
"Hoe verhoudt X zich tot sectortrends?" |
GraphRAG biedt ook een basale vectorzoekfunctie als vangnet voor eenvoudige queries waarbij graaftraversal overkill zou zijn. Maar voor de meeste use-cases kom je met globaal, lokaal en DRIFT een heel eind.
Dit onderdeel laat zien hoe je een GraphRAG-systeem bouwt met Microsofts referentie-implementatie. We werken met een kleine corpus van Paul Graham-essays over startups, zodat de voorbeelden uitvoerbaar blijven en de kosten redelijk. Als je nieuw bent met het combineren van kennisgrafen met retrievalsystemen, behandelt de kennisgraaf-RAG-tutorial de basisconcepten.
Maak een projectmap en initialiseer die met uv, installeer daarna het graphrag-pakket. De bibliotheek heeft flinke afhankelijkheden (237 pakketten inclusief PyTorch), dus reken op ongeveer vijf minuten installatietijd:
mkdir ragtest && cd ragtest
 uv init
 uv add graphrag
 graphrag init --root .
Dit genereert de projectstructuur:
ragtest/
 ├── .env                	# API key configuration
 ├── settings.yaml       	# Pipeline settings
 ├── prompts/            	# LLM prompt templates
 │   ├── extract_graph.txt
 │   ├── summarize_descriptions.txt
 │   └── ...
 └── input/              	# Your source documents go here
De map prompts/ bevat de templates die GraphRAG gebruikt voor entiteitsextractie en samenvatten. Je kunt deze aanpassen voor domeinspecifieke behoeften, al werken de standaardinstellingen goed voor algemene tekst.
Voeg tekstbestanden toe aan de map input/. Voor deze tutorial gebruiken we drie Paul Graham-essays over startups. Zijn website gebruikt minimale HTML met content in <font>-tags, dus een eenvoudige parser extraheert de tekst schoon:
import urllib.request
 from html.parser import HTMLParser

 class TextExtractor(HTMLParser):
 	def __init__(self):
     	super().__init__()
     	self.text = []
     	self.in_font = False

 	def handle_starttag(self, tag, attrs):
     	if tag == 'font':
         	self.in_font = True

 	def handle_endtag(self, tag):
     	if tag == 'font':
         	self.in_font = False

 	def handle_data(self, data):
     	if self.in_font:
         	self.text.append(data)

 essays = {
 	"startupideas": "http://paulgraham.com/startupideas.html",
     "do_things_that_dont_scale": "http://paulgraham.com/ds.html",
 	"startup_growth": "http://paulgraham.com/growth.html"
 }

 for name, url in essays.items():
 	with urllib.request.urlopen(url) as response:
     	html = response.read().decode('utf-8')
 	parser = TextExtractor()
 	parser.feed(html)
 	text = ' '.join(parser.text)
 	with open(f"input/{name}.txt", "w") as f:
     	f.write(text)
 	print(f"Saved {name}.txt ({len(text.split())} words)")
Saved startupideas.txt (3000 words)
Saved do_things_that_dont_scale.txt (3000 words)
Saved startup_growth.txt (3000 words)In totaal ongeveer 9.000 woorden over drie thematisch verbonden essays, genoeg om betekenisvolle entiteitsrelaties te zien zonder hoge API-kosten.
Bewerk .env om je OpenAI API-sleutel toe te voegen:
GRAPHRAG_API_KEY=your-openai-api-key-hereDe standaard settings.yaml werkt out-of-the-box, maar je wilt misschien het model aanpassen. Het bestand gebruikt standaard gpt-4o-mini, wat kosten en kwaliteit in balans brengt. Zie de volledige configuratiereferentie voor alle beschikbare opties:
models:
   default_chat_model:
 	type: openai_chat
 	auth_type: api_key
 	api_key: ${GRAPHRAG_API_KEY}
 	model: gpt-4o-mini
 	model_supports_json: true
 	concurrent_requests: 25

   default_embedding_model:
 	type: openai_embedding
 	auth_type: api_key
 	api_key: ${GRAPHRAG_API_KEY}
 	model: text-embedding-3-small
Andere noemenswaardige instellingen in de config:
chunks:
   size: 1200  	# Tokens per chunk
   overlap: 100	# Overlap tussen chunks

 extract_graph:
   entity_types: [organization, person, geo, event]
   max_gleanings: 1	# Additional extraction passes

 cluster_graph:
max_cluster_size: 10Bouw de kennisgrafiek met:
graphrag index --root .De pijplijn verwerkt documenten via entiteitsextractie, graafconstructie en community-detectie:
├── Loading Input (InputFileType.text) - 3 files loaded (0 filtered) ───
 ├── create_base_text_units
 ├── create_final_documents
 ├── extract_graph
 ├── finalize_graph
 ├── create_final_entities
 ├── create_final_relationships
 ├── create_final_text_units
 ├── create_base_entity_graph
 ├── create_communities
 ├── create_final_communities
 ├── create_community_reports
 ├── generate_text_embeddings
 ⠋ GraphRAG Indexer
 ├── All workflows completed successfully
Elke stap bouwt voort op de vorige. De fase extract_graph doet het gros van de LLM-calls, terwijl create_communities het Leiden-algoritme toepast om verwante entiteiten te clusteren.
Met onze drie essays is het indexeren in ongeveer twee minuten klaar. Je kunt de resultaten inspecteren door de parquet-bestanden te laden of de rijen te tellen:
De output staat in output/ als parquet-bestanden:
output/
 ├── documents.parquet
 ├── entities.parquet
 ├── relationships.parquet
 ├── text_units.parquet
 ├── communities.parquet
 ├── community_reports.parquet
 └── lancedb/      	# Vector embeddings
Het parquet-formaat houdt alles draagbaar. Je kunt deze bestanden met pandas laden om entiteiten te bekijken, relaties te doorlopen of extractieproblemen te debuggen. De hele projectmap is klein genoeg voor versiebeheer (onder 10 MB voor deze corpus); sluit alleen het .env-bestand met je API-sleutel uit.
GraphRAG biedt drie querymodi. Laten we ze allemaal proberen.
Globaal zoeken voor thematische vragen:
graphrag query \
 	--root . \
 	--method global \
 	--query "What are the main themes and lessons about startups in these essays?"
SUCCESS: Global Search Response:
The essays present several interconnected themes about startups:
**Growth as the defining characteristic**: A startup isn't just a new company—it's
specifically designed for rapid growth. This growth orientation shapes everything
from idea selection to daily decision-making. The essays suggest using weekly
growth rate as a compass for all strategic choices.
**The power of doing unscalable things**: Counterintuitively, successful startups
often begin with manual, labor-intensive approaches. Stripe's founders would
physically set up new users on the spot. Airbnb's founders went door-to-door
recruiting hosts. These unscalable tactics bootstrap the initial user base.
**Ideas emerge from problems, not brainstorming**: The best startup ideas come
from founders solving their own problems or noticing gaps while "living in the
future." Deliberately trying to generate ideas tends to produce plausible-sounding
but ultimately weak concepts.
**User relationships matter early**: Early users provide irreplaceable feedback.
Founders should go beyond standard customer service to create exceptional
experiences, gathering insights that shape the product.De reactie synthetiseert thema's over alle drie essays heen, iets wat met traditionele RAG het ophalen en verwerken van veel fragmenten zou vereisen. Globaal zoeken haalde in plaats daarvan uit community-samenvattingen en gaf zo een coherent overzicht op hoog niveau.
Lokaal zoeken voor entiteitsspecifieke vragen:
graphrag query \
 	--root . \
 	--method local \
 	--query "What role does Y Combinator play according to these essays?"
SUCCESS: Local Search Response:
Y Combinator functions as both an accelerator and a testing ground for startup
principles. According to the essays, YC provides:
**Funding and validation**: YC offers initial funding that lets founders focus
on building rather than fundraising. The program validates ideas through its
selection process.
**Growth measurement framework**: YC tracks startups by weekly growth rate,
with 5-7% weekly growth considered good and 10% exceptional. This metric-driven
approach forces founders to confront whether they're making real progress.
**Network effects**: B2B startups at YC gain immediate access to hundreds of
potential customers—other YC companies. Stripe leveraged this extensively in
its early days.
**Demo Day as forcing function**: The program's structure, culminating in Demo
Day presentations to investors, creates urgency that pushes founders to ship
and iterate quickly.Lokaal zoeken traverseerde de graaf vanuit de entiteit Y Combinator en haalde verbonden concepten op als groeimetingen, Stripe en Demo Day. Het antwoord blijft gegrond in wat de essays daadwerkelijk over YC zeggen in plaats van algemene kennis.
DRIFT-zoek voor vragen die zowel breedte als specificiteit nodig hebben:
graphrag query \
 	--root . \
 	--method drift \
 	--query "How do the essays describe the relationship between startup ideas and user problems?"
SUCCESS: Drift Search Response:
The essays establish a direct link between viable startup ideas and genuine user
problems through several mechanisms:
**Organic discovery over invention**: Rather than brainstorming ideas, founders
should notice problems they personally experience. Microsoft, Apple, Google, and
Facebook all started this way—founders building something they themselves needed.
**The "well" vs "shallow hole" distinction**: Good ideas serve a small number of
users who desperately need the solution (a narrow, deep well) rather than many
users with mild interest (a broad, shallow hole). Depth of need matters more
than breadth of appeal initially.
**Feedback loops as validation**: Engaging directly with early users reveals
whether the problem is real and the solution fits. This feedback shapes the
product more than any amount of planning.
**Problem-first, solution-second**: The essays warn against "sitcom startup
ideas"—concepts that sound plausible but don't address real pain points. A
social network for pet owners sounds reasonable but lacks urgent demand.DRIFT startte breed met context op community-niveau over start-upfilosofie en dook daarna in specifieke voorbeelden zoals de put-analogie en sitcom-ideeën. Het resultaat combineert thematische inzichten met concrete details uit de brontekst.
Voor productiesystemen gebruik je direct de Python-API. Het proces heeft drie delen: configuratie laden, de geïndexeerde data laden en queries draaien.
Stel eerst de configuratie in door omgevingsvariabelen te laden en het settings-bestand te parsen:
import os
 import yaml
 from pathlib import Path
 from dotenv import load_dotenv
 from graphrag.config.create_graphrag_config import create_graphrag_config

 ROOT_DIR = Path(".")

 # Load environment variables and config
 load_dotenv(ROOT_DIR / ".env")
 with open(ROOT_DIR / "settings.yaml") as f:
 	yaml_content = f.read()
 yaml_content = os.path.expandvars(yaml_content)  # Expand ${VAR} references
 settings = yaml.safe_load(yaml_content)
 config = create_graphrag_config(values=settings, root_dir=str(ROOT_DIR))
Laad vervolgens alle geïndexeerde data uit de parquet-bestanden. GraphRAG slaat entiteiten, relaties, communities en tekstfragmenten apart op:
import pandas as pd

 output_dir = ROOT_DIR / "output"
 entities = pd.read_parquet(output_dir / "entities.parquet")
 communities = pd.read_parquet(output_dir / "communities.parquet")
 community_reports = pd.read_parquet(output_dir / "community_reports.parquet")
 text_units = pd.read_parquet(output_dir / "text_units.parquet")
 relationships = pd.read_parquet(output_dir / "relationships.parquet")

 print(f"Loaded {len(entities)} entities, {len(relationships)} relationships")
Loaded 74 entities, 89 relationshipsVoer ten slotte queries uit met de async API. De functie local_search neemt alle dataframes plus queryparameters:
import asyncio
 from graphrag.api import local_search

 async def run_query(query: str):
 	response, context = await local_search(
     	config=config,
     	entities=entities,
     	communities=communities,
         community_reports=community_reports,
     	text_units=text_units,
     	relationships=relationships,
     	covariates=None,
     	community_level=2,
     	response_type="Multiple Paragraphs",
     	query=query,
 	)
 	return response

 query = "What advice do the essays give about finding startup ideas?"
 response = asyncio.run(run_query(query))
 print(response)
The essays provide several valuable insights into finding startup ideas:
Focus on Growth: A startup is designed to grow quickly. Founders should commit
to seeking ideas that can scale significantly, as this distinguishes startups
from ordinary businesses.
Identify Unmet Needs: Successful startups arise from recognizing problems that
need solving. Founders who can see different problems, particularly those
addressable through technology, are more likely to develop effective solutions.
Leverage Personal Insights: Many successful startups originate from the unique
insights of their founders, often stemming from personal experiences or
frustrations. This personal connection leads to more authentic solutions.
Explore Overlooked Markets: Founders should think outside the box and explore
markets that may be overlooked. Successful startups often emerge from ideas
that seem obvious to the founders but aren't yet recognized broadly.De Python-API geeft je volledige controle over welke data je laadt, welk community-niveau je bevraagt en hoe je antwoorden formatteert. Voor applicaties die aangepaste retrievallogica of integratie met bestaande systemen vereisen, is dit de aangewezen weg.
Traditionele RAG werkt prima tot het niet meer werkt. Je merkt dat je de muur raakt wanneer gebruikers vragen naar thema's of patronen en een warboel van losjes gerelateerde fragmenten terugkrijgen in plaats van een samenhangend antwoord. Dat is het probleem dat GraphRAG oplost door fragmenten in te ruilen voor een kennisgrafiek met vooraf berekende community-samenvattingen.
De kosten zijn wel reëel. Indexeren verbruikt veel LLM-calls, en globaal zoeken is ook niet goedkoop. Voor een kleine documentcollectie of rechttoe-rechtaan opzoekingen kun je bij vectorzoek blijven.
Maar als je corpus rijke verbindingen tussen entiteiten heeft en je gebruikers om die verbindingen geven, loont GraphRAG. Kies je querytype op basis van je vraag: globaal voor thema's, lokaal voor specifieke entiteiten, DRIFT wanneer je beide nodig hebt. De implementatie is niet ingewikkeld zodra je het eenmaal hebt doorlopen, en de parquet-output maakt het geheel makkelijk te inspecteren en te debuggen.
Leren met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

