
Last chance! 50% off DataCamp Premium
Sale ends in
I sistemi RAG tradizionali recuperano porzioni di documento in base alla similarità semantica, il che funziona bene per domande semplici. Ma quando le query richiedono di sintetizzare informazioni sparse su più documenti o di ragionare attraverso concetti collegati, la ricerca vettoriale non basta. Il sistema recupera frammenti senza capire come si relazionano tra loro.
GraphRAG non tratta i documenti come blocchi isolati. Costruisce un knowledge graph che cattura entità e relazioni tra di esse. Questa struttura consente al sistema di percorrere le connessioni e rispondere a domande che richiedono di mettere insieme informazioni da più fonti. È una delle diverse tecniche RAG avanzate che affrontano i limiti del recupero di base.
GraphRAG è una tecnica di generazione aumentata dal recupero che rappresenta i documenti come knowledge graph invece che come embedding vettoriali. Invece di spezzare il testo in blocchi da cercare in modo indipendente, GraphRAG estrae entità (pensa a persone, organizzazioni, concetti, eventi) e le relazioni tra di esse, organizzando queste informazioni in una struttura a grafo interconnessa.
Il sistema GraphRag applica poi algoritmi di rilevamento di comunità per identificare cluster di entità correlate e genera riepiloghi per questi cluster a livelli gerarchici. Quando arriva una query, GraphRAG può attraversare i "vicinati" di entità per domande mirate oppure eseguire operazioni di map-reduce sui riepiloghi delle comunità per una sintesi a livello di corpus.
Vediamo ora più da vicino la meccanica. Ci aiuterà a capire perché è nata la ricerca basata su grafo e quale vuoto colma.
Il problema di fondo del RAG tradizionale non è il recupero o la generazione, ma la rappresentazione. I documenti vengono divisi in blocchi e ogni blocco diventa un vettore isolato sospeso nello spazio degli embedding. Qualsiasi struttura presente nell'originale — i titoli, il flusso narrativo, a quale paragrafo si riferiva cosa — viene appiattita.
Questo crea problemi per domande che richiedono di combinare informazioni. Chiedi "Quali sono i temi principali in questi documenti?" e la ricerca vettoriale restituisce blocchi contenenti la parola "temi" o termini correlati. Ma trovare frammenti pertinenti non equivale a capire i pattern in un corpus. Il sistema non ha modo di mettere insieme le informazioni su larga scala perché vede solo pezzi singoli, mai l'insieme.
Il ragionamento multi-hop si scontra con lo stesso muro. Diciamo che la risposta a una domanda dipende dal collegare il concetto A al B al C. Il RAG tradizionale recupera ogni blocco in modo indipendente in base alla similarità con la query. Se B non è vicino alla domanda, potrebbe non essere recuperato affatto, spezzando la catena. Il sistema trova gli estremi ma perde il percorso che li unisce.
C'è anche un disallineamento tra recupero e contesto da considerare. Puoi recuperare venti blocchi molto pertinenti, ma inserirli tutti nel prompt non garantisce che l'LLM li usi bene. Lo studio "lost in the middle" mostra che gli LLM tendono a concentrarsi sulle informazioni all'inizio e alla fine della finestra di contesto, spesso trascurando ciò che rimane in mezzo. Più recupero non significa automaticamente risposte migliori.
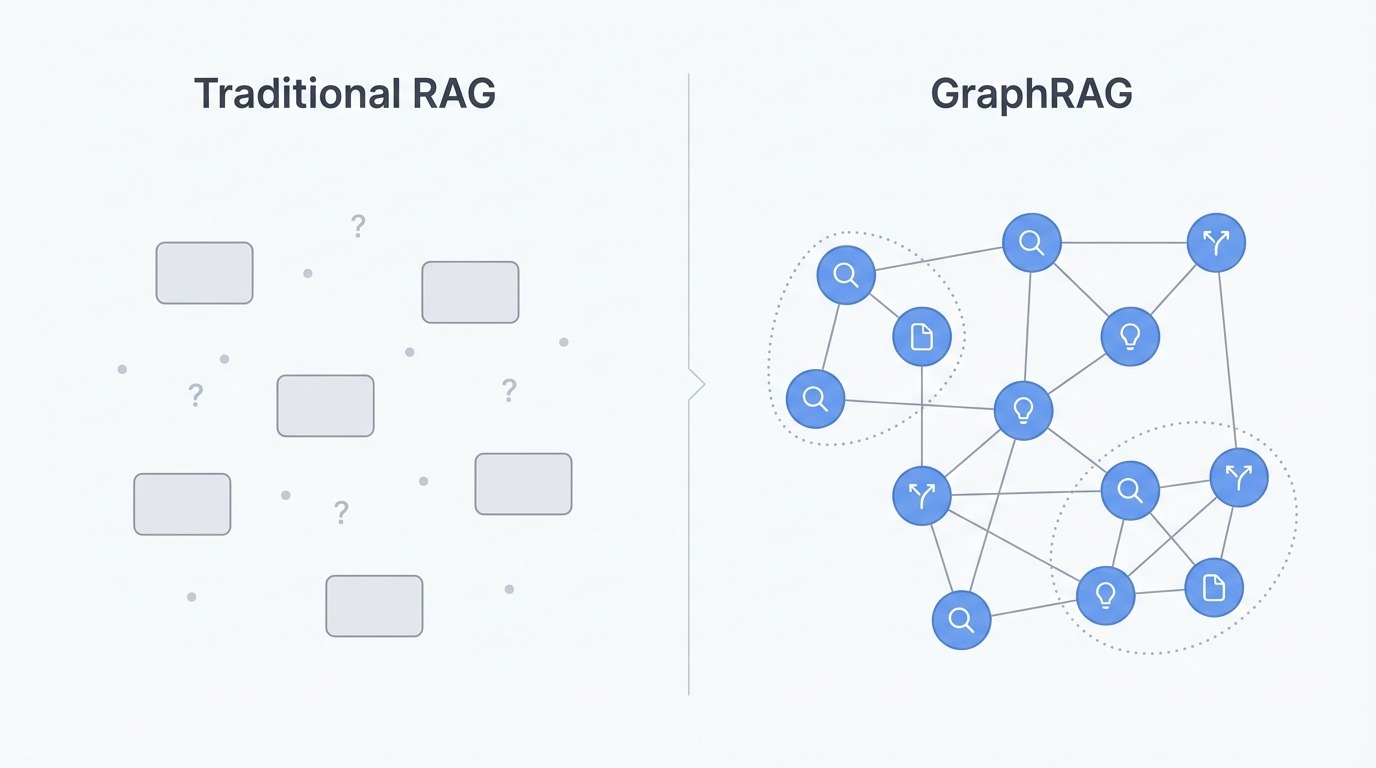
Confronto tra RAG tradizionale e GraphRAG. Immagine dell'autore.
GraphRAG aggira questi limiti cambiando completamente la rappresentazione. Invece dei blocchi, costruisce un knowledge graph in cui le entità diventano nodi e le relazioni diventano archi. Persone, organizzazioni, luoghi, concetti ed eventi vengono estratti dai documenti sorgente insieme a come si collegano tra loro. Questo preserva la struttura che il chunking butta via.
Con il grafo in posizione, il sistema applica il rilevamento di comunità (tipicamente l'algoritmo di Leiden) per raggruppare entità correlate in gruppi. Questi cluster si formano su più livelli, alcuni stretti e specifici, altri ampi e tematici. I raggruppamenti derivano da connessioni reali nei dati piuttosto che da confini dei documenti o dimensioni dei blocchi.
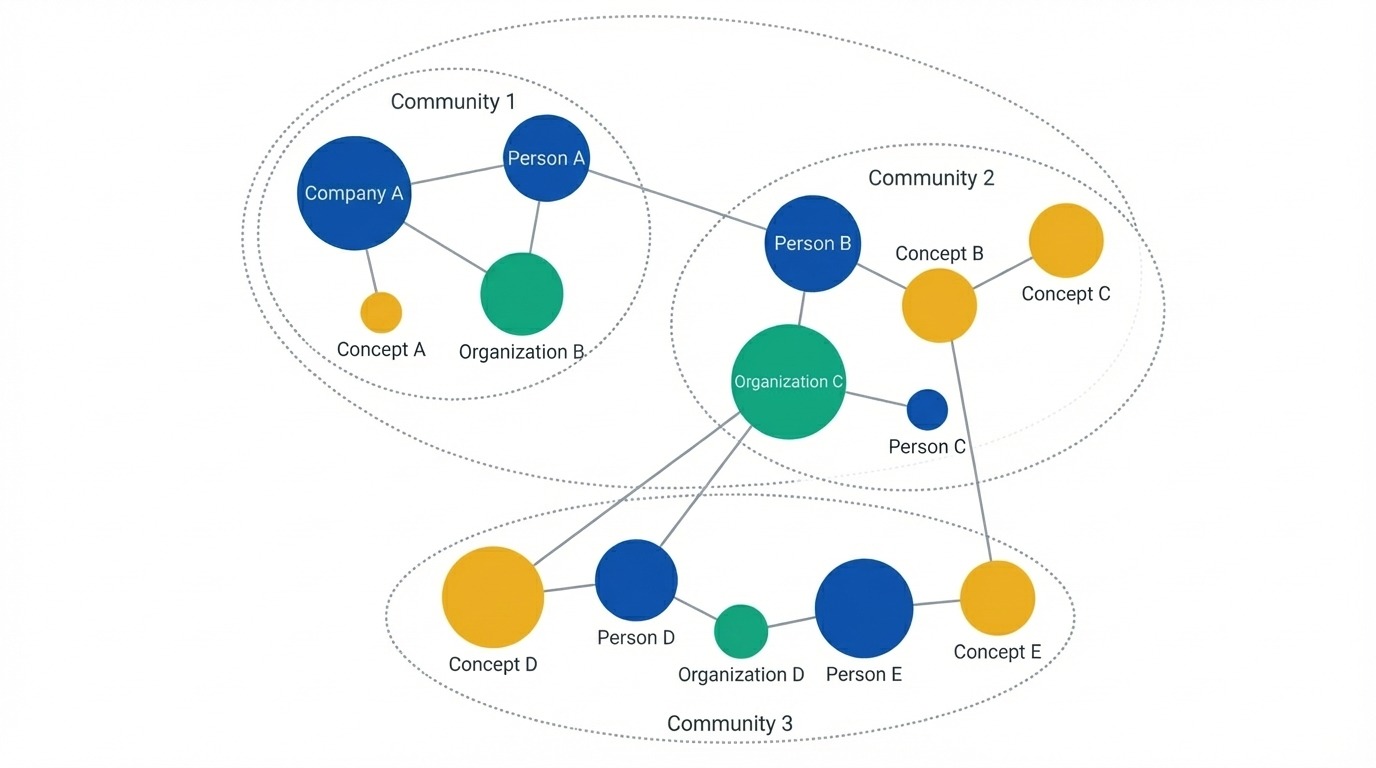
Knowledge graph che mostra le entità come nodi. Immagine dell'autore.
Per domande globali, GraphRAG pre-genera i riepiloghi per ogni comunità prima che arrivi qualsiasi query utente. Quando qualcuno chiede "Quali sono i temi principali?", il sistema non cerca testo corrispondente. Invece, esegue un'operazione di map-reduce: ogni riepilogo di comunità produce una risposta parziale basata sulla sua porzione di grafo, poi tutte le parti vengono combinate in una risposta finale. Questo permette a GraphRAG di ragionare su un intero corpus senza dover recuperare migliaia di blocchi.
Per domande multi-hop, l'attraversamento del grafo sostituisce la ricerca per similarità. Il sistema può percorrere gli archi da un'entità all'altra, seguendo catene concettuali che la ricerca vettoriale perderebbe. Se A è collegato a B ed è collegato a C, il grafo sa che quel percorso esiste e può seguirlo.
GraphRAG ripaga quando le tue domande richiedono una comprensione a livello di corpus. Se gli utenti chiedono spesso temi, pattern o riepiloghi attraverso grandi collezioni di documenti, la ricerca basata su grafo supererà gli approcci a blocchi. Vale lo stesso per domini con relazioni ricche tra entità, come organigrammi aziendali, reti di citazioni scientifiche o storici di cause legali in cui è importante seguire le connessioni.
Per ricerche fattuali semplici ("Qual è il numero di telefono di X?") o set di documenti piccoli, il RAG tradizionale va benissimo e costa meno da eseguire. GraphRAG aggiunge overhead sia nel tempo di indicizzazione che nelle chiamate all'LLM, quindi il beneficio deve giustificare l'investimento. Parti dal RAG standard e passa a GraphRAG quando ne incontri i limiti.
La tabella seguente riassume i compromessi. Il RAG tradizionale vince in semplicità e costo, mentre GraphRAG primeggia quando le domande richiedono sintesi o ragionamento su concetti collegati.
|
Aspetto |
RAG tradizionale |
GraphRAG |
|
Rappresentazione dei dati |
Blocchi di testo isolati come vettori |
Knowledge graph con entità e relazioni |
|
Conservazione della struttura |
Persa durante il chunking |
Mantenuta tramite archi del grafo |
|
Query globali |
Scarse (recupera frammenti, non sa sintetizzare) |
Forti (map-reduce sui riepiloghi delle comunità) |
|
Ragionamento multi-hop |
Limitato (recupero indipendente dei blocchi) |
Nativo (l'attraversamento del grafo segue le connessioni) |
|
Costo di indicizzazione |
Basso (solo embedding) |
Alto (estrazione con LLM + embedding + clustering) |
|
Costo di query |
Basso |
Varia (locale è economico, globale è costoso) |
|
Ideale per |
Ricerche fattuali, corpora piccoli |
Domande tematiche, domini connessi |
La pipeline ha due fasi: l'indicizzazione costruisce il grafo, le query lo usano.
L'indicizzazione trasforma i documenti grezzi in una struttura di conoscenza attraverso cinque passaggi:
Il passaggio di estrazione è quello in cui avviene la maggior parte delle chiamate all'LLM. Ogni blocco viene elaborato con un prompt che chiede al modello di identificare entità e relazioni. Un blocco che menziona "OpenAI ha rilasciato GPT-4" produce entità per entrambi, più una relazione che le collega. Nella stessa passata si cattura il tipo di relazione. Poiché ogni blocco richiede una chiamata all'LLM, l'indicizzazione è la parte costosa della pipeline. Il tempo di query è relativamente economico perché il lavoro pesante è già stato fatto.
La costruzione del grafo si occupa della risoluzione delle entità, che è complicata. "OpenAI", "Open AI" e "l'azienda" potrebbero riferirsi alla stessa entità in blocchi diversi. Il sistema unisce questi duplicati per creare un grafo pulito.
Il rilevamento di comunità applica l'algoritmo di Leiden per trovare raggruppamenti naturali su più livelli. Il livello 0 può contenere cluster stretti di 5-10 entità correlate. I livelli superiori raggruppano questi in temi più ampi. Un corpus sulle aziende di AI potrebbe avere comunità di livello 0 per singole aziende, di livello 1 per "laboratori di AI" e "produttori di chip", e di livello 2 che cattura l'intero ecosistema tecnologico. Ogni comunità riceve poi un riepilogo generato da LLM che descrive cosa rappresenta quel cluster. Questi riepiloghi sono precomputati prima che arrivi qualsiasi query utente.
Il risultato finale non è un indice di recupero. È una rappresentazione strutturata: grafo più riepiloghi, pronta per essere interrogata in modi diversi.
Con il grafo costruito, le query vengono instradate verso diverse strategie di recupero:
Il contenuto recuperato (riepiloghi, entità, relazioni, testo sorgente) viene assemblato in un prompt e l'LLM genera la risposta finale. Ogni strategia serve tipi di domande diversi, che analizzeremo a breve.
GraphRAG offre tre strategie di recupero distinte, ciascuna adatta a diversi tipi di domande. La scelta giusta dipende dal fatto che tu abbia bisogno di una sintesi ampia, di informazioni specifiche su entità o di qualcosa a metà strada.
La ricerca globale risponde a domande che richiedono di comprendere un intero corpus. Domande come "Quali sono i temi principali in questa raccolta di documenti?" o "Quali pattern emergono in questi report?" hanno bisogno di informazioni aggregate da ovunque, non recuperate da pochi blocchi corrispondenti.
Il meccanismo è il map-reduce sui riepiloghi delle comunità. Nella fase di map, ogni riepilogo di comunità viene elaborato in modo indipendente: il sistema chiede a un LLM di estrarre i punti rilevanti e valutarne l'importanza. Nella fase di reduce, i punti con il punteggio più alto da tutte le comunità vengono aggregati in un prompt finale e l'LLM li sintetizza in una risposta coerente.
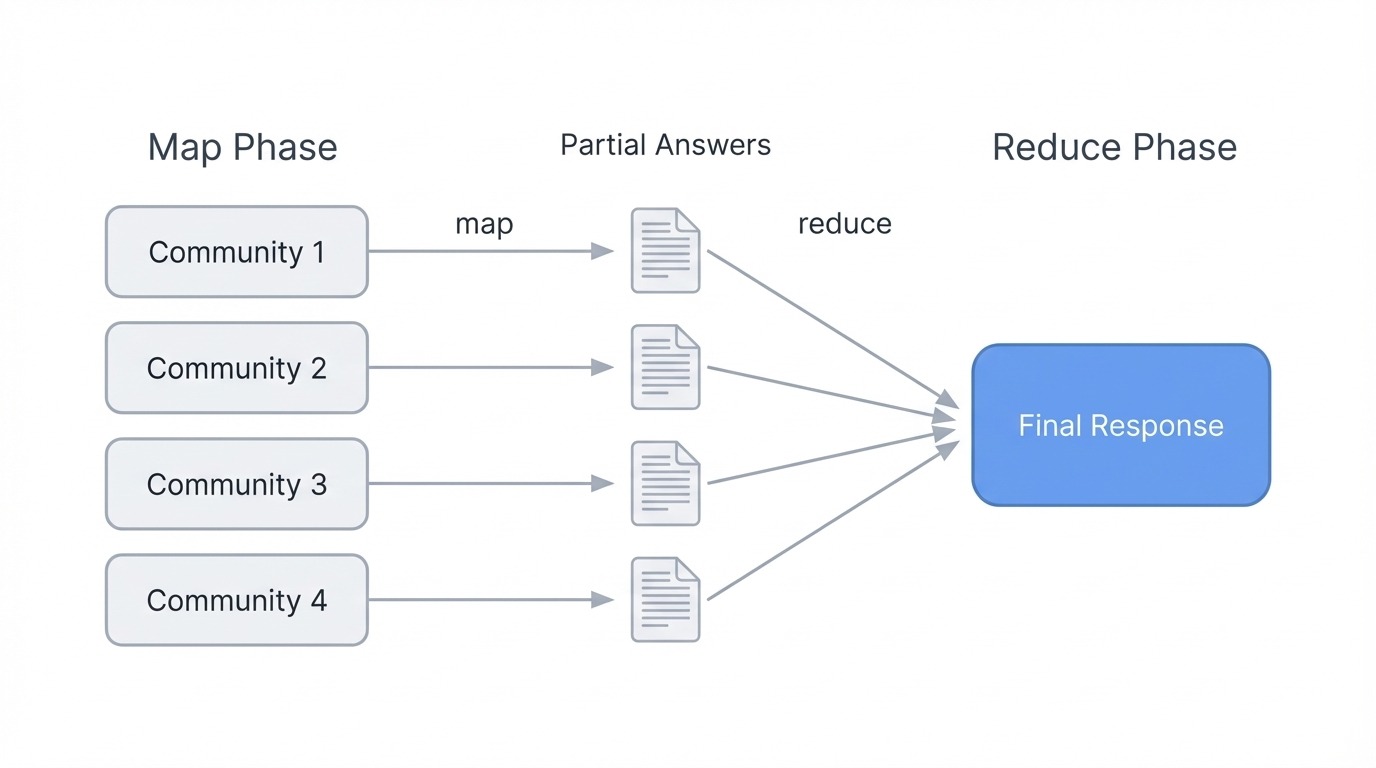
Ricerca globale di GraphRAG tramite map-reduce. Immagine dell'autore
Funziona perché i riepiloghi delle comunità catturano già di cosa tratta ciascun cluster di entità. Il sistema non ha bisogno di recuperare migliaia di blocchi. Invece, ragiona su descrizioni precompute che rappresentano la struttura del grafo al livello gerarchico che scegli. Livelli più bassi (comunità più piccole e coese) danno risposte più dettagliate ma costano più chiamate all'LLM. Livelli più alti (raggruppamenti più ampi) sono più veloci ma possono perdere sfumature.
La ricerca globale è computazionalmente più pesante rispetto alle altre modalità poiché elabora tutte le comunità. Usala quando le domande richiedono davvero una comprensione a livello di corpus piuttosto che fatti specifici.
La ricerca locale gestisce domande specifiche su entità. "Quali sono le proprietà curative della camomilla?" o "Cosa ha annunciato Acme Corp sui risultati del Q3?" puntano a entità particolari e alle informazioni a esse collegate.
Il processo di recupero parte dall'identificazione delle entità nel grafo correlate alla query. Queste entità diventano punti di ingresso per l'attraversamento. Da ogni nodo di partenza, il sistema estrae entità connesse, relazioni tra di esse, eventuali affermazioni o fatti associati e i report di comunità a cui appartengono quelle entità. Recupera anche i blocchi di testo originali collegati a quelle entità, fornendo all'LLM sia dati strutturati del grafo sia testo sorgente.
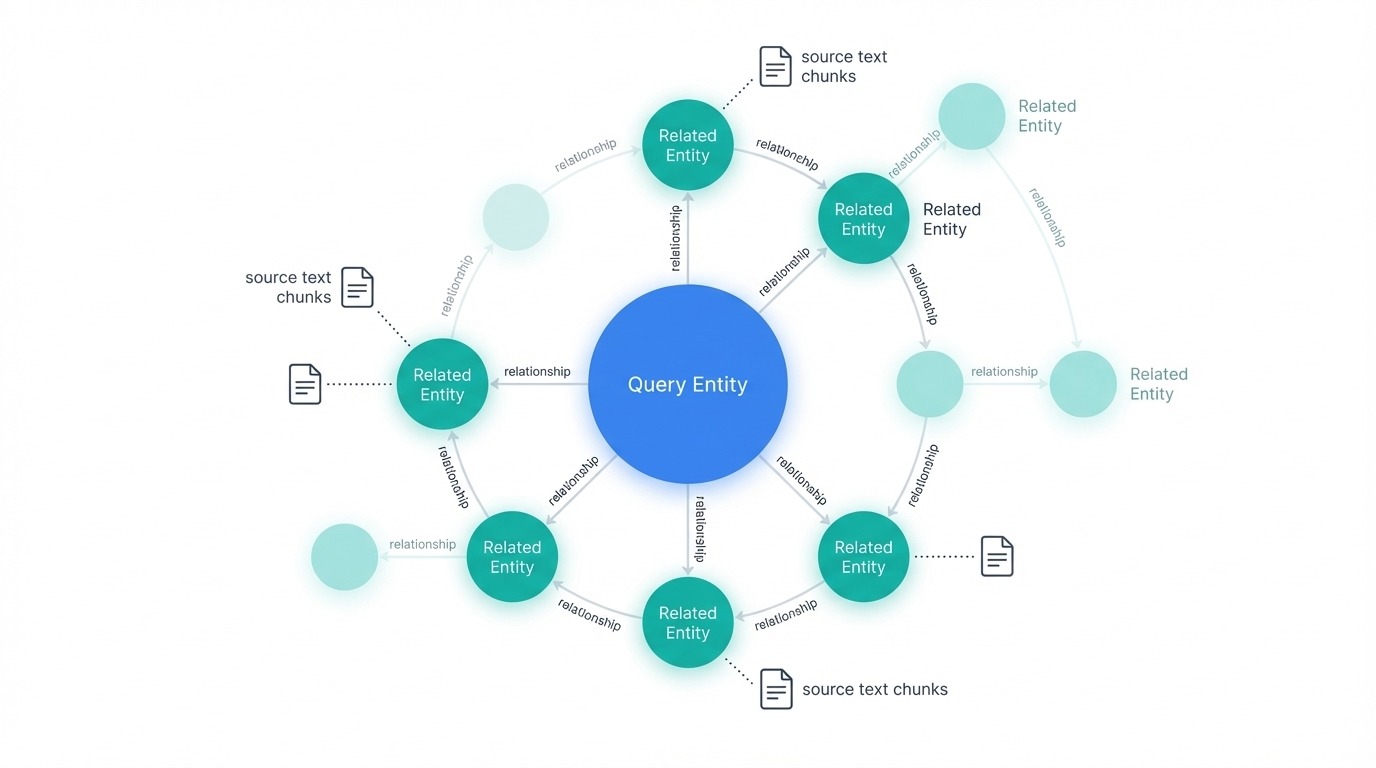
Ricerca locale di GraphRAG con nodi correlati. Immagine dell'autore
Tutte queste informazioni candidate vengono classificate e filtrate per rientrare nella finestra di contesto. L'LLM genera quindi una risposta ancorata al contenuto recuperato. Poiché la ricerca locale si concentra su un vicinato del grafo e non sull'intero grafo, è più veloce ed economica della ricerca globale.
Scegli la ricerca locale quando le domande riguardano cose, persone, organizzazioni o concetti specifici menzionati nei tuoi documenti.
DRIFT (Dynamic Reasoning and Inference with Flexible Traversal) si colloca tra globale e locale. Gestisce query complesse che richiedono sia contesto ampio sia dettaglio specifico.
Il processo ha tre fasi. Primo, la fase di primer confronta la query con i riepiloghi di comunità semanticamente più rilevanti e genera una risposta iniziale insieme a domande di follow-up. Secondo, la fase di follow-up prende quelle domande e applica la ricerca locale per approfondire aree specifiche, producendo risposte intermedie e follow-up più mirati. Terzo, la fase di output combina tutto in risultati classificati che bilanciano insight globali con specificità locali.
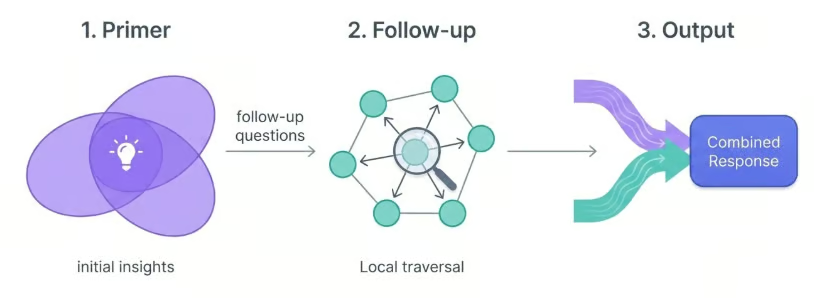
Processo in tre fasi della ricerca DRIFT di GraphRAG. Immagine dell'autore.
Ciò che rende utile DRIFT è il modo in cui amplia il punto di partenza della ricerca. Iniziando dal contesto a livello di comunità, recupera una varietà più ampia di fatti rispetto a una pura ricerca locale. Ma raffinando attraverso l'attraversamento locale, evita il costo della ricerca globale completa.
Usa DRIFT per domande come "Come si confrontano le sfide che affronta l'Azienda X con le tendenze più ampie del settore?", dove servono sia informazioni specifiche sull'entità sia contesto tematico.
|
Aspetto |
Globale |
Locale |
DRIFT |
|
Ideale per |
Temi e pattern a livello di corpus |
Domande su entità specifiche |
Query complesse che richiedono entrambi |
|
Meccanismo |
Map-reduce sui riepiloghi delle comunità |
Attraversamento del vicinato di entità |
Fasi primer → follow-up → output |
|
Velocità |
La più lenta (elabora tutte le comunità) |
La più veloce (attraversamento mirato) |
Media (parte ampia, poi restringe) |
|
Costo |
Il più alto |
Il più basso |
Medio |
|
Esempio di query |
"Quali sono i temi principali?" |
"Cosa ha annunciato l'Azienda X?" |
"Come si confronta X con le tendenze del settore?" |
GraphRAG offre anche una semplice ricerca vettoriale come fallback per query banali in cui l'attraversamento del grafo sarebbe eccessivo. Ma per la maggior parte dei casi d'uso, scegliere tra globale, locale e DRIFT copre ciò che ti serve.
Questa sezione illustra la costruzione di un sistema GraphRAG usando l'implementazione di riferimento di Microsoft. Lavoreremo con un piccolo corpus di saggi di Paul Graham sulle startup per mantenere gli esempi eseguibili e i costi ragionevoli. Se sei alle prime armi nel combinare knowledge graph con sistemi di recupero, il tutorial sul knowledge graph RAG copre i concetti di base.
Crea una directory di progetto e inizializzala con uv, quindi installa il pacchetto graphrag. La libreria ha dipendenze sostanziali (237 pacchetti inclusi PyTorch), quindi prevedi circa cinque minuti per l'installazione:
mkdir ragtest && cd ragtest
 uv init
 uv add graphrag
 graphrag init --root .
Questo genera la struttura del progetto:
ragtest/
 ├── .env                	# API key configuration
 ├── settings.yaml       	# Pipeline settings
 ├── prompts/            	# LLM prompt templates
 │   ├── extract_graph.txt
 │   ├── summarize_descriptions.txt
 │   └── ...
 └── input/              	# Your source documents go here
La directory prompts/ contiene i template che GraphRAG usa per l'estrazione di entità e la sintesi. Puoi personalizzarli per esigenze di dominio, anche se i default funzionano bene per testo generico.
Aggiungi file di testo alla directory input/. Per questo tutorial useremo tre saggi di Paul Graham sulle startup. Il suo sito usa HTML minimale con il contenuto racchiuso in tag <font>, quindi un parser semplice estrae il testo in modo pulito:
import urllib.request
 from html.parser import HTMLParser

 class TextExtractor(HTMLParser):
 	def __init__(self):
     	super().__init__()
     	self.text = []
     	self.in_font = False

 	def handle_starttag(self, tag, attrs):
     	if tag == 'font':
         	self.in_font = True

 	def handle_endtag(self, tag):
     	if tag == 'font':
         	self.in_font = False

 	def handle_data(self, data):
     	if self.in_font:
         	self.text.append(data)

 essays = {
 	"startupideas": "http://paulgraham.com/startupideas.html",
     "do_things_that_dont_scale": "http://paulgraham.com/ds.html",
 	"startup_growth": "http://paulgraham.com/growth.html"
 }

 for name, url in essays.items():
 	with urllib.request.urlopen(url) as response:
     	html = response.read().decode('utf-8')
 	parser = TextExtractor()
 	parser.feed(html)
 	text = ' '.join(parser.text)
 	with open(f"input/{name}.txt", "w") as f:
     	f.write(text)
 	print(f"Saved {name}.txt ({len(text.split())} words)")
Saved startupideas.txt (3000 words)
Saved do_things_that_dont_scale.txt (3000 words)
Saved startup_growth.txt (3000 words)Circa 9.000 parole in totale su tre saggi tematicamente connessi, abbastanza per vedere relazioni significative tra entità senza accumulare grandi costi API.
Modifica .env per aggiungere la tua chiave API di OpenAI:
GRAPHRAG_API_KEY=your-openai-api-key-hereIl settings.yaml predefinito funziona subito, ma potresti voler regolare il modello. Il file usa gpt-4o-mini di default, che bilancia costo e qualità. Consulta la documentazione completa della configurazione per tutte le opzioni disponibili:
models:
   default_chat_model:
 	type: openai_chat
 	auth_type: api_key
 	api_key: ${GRAPHRAG_API_KEY}
 	model: gpt-4o-mini
 	model_supports_json: true
 	concurrent_requests: 25

   default_embedding_model:
 	type: openai_embedding
 	auth_type: api_key
 	api_key: ${GRAPHRAG_API_KEY}
 	model: text-embedding-3-small
Altre impostazioni degne di nota nella configurazione:
chunks:
   size: 1200  	# Tokens per chunk
   overlap: 100	# Overlap between chunks

 extract_graph:
   entity_types: [organization, person, geo, event]
   max_gleanings: 1	# Additional extraction passes

 cluster_graph:
max_cluster_size: 10Crea il knowledge graph con:
graphrag index --root .La pipeline elabora i documenti attraverso estrazione di entità, costruzione del grafo e rilevamento di comunità:
├── Loading Input (InputFileType.text) - 3 files loaded (0 filtered) ───
 ├── create_base_text_units
 ├── create_final_documents
 ├── extract_graph
 ├── finalize_graph
 ├── create_final_entities
 ├── create_final_relationships
 ├── create_final_text_units
 ├── create_base_entity_graph
 ├── create_communities
 ├── create_final_communities
 ├── create_community_reports
 ├── generate_text_embeddings
 ⠋ GraphRAG Indexer
 ├── All workflows completed successfully
Ogni passaggio si basa sul precedente. La fase extract_graph effettua la maggior parte delle chiamate all'LLM, mentre create_communities applica l'algoritmo di Leiden per raggruppare le entità correlate.
Con i nostri tre saggi, l'indicizzazione si completa in circa due minuti. Puoi ispezionare i risultati caricando i file parquet o controllando i conteggi di righe:
L'output si trova in output/ come file parquet:
output/
 ├── documents.parquet
 ├── entities.parquet
 ├── relationships.parquet
 ├── text_units.parquet
 ├── communities.parquet
 ├── community_reports.parquet
 └── lancedb/      	# Vector embeddings
Il formato parquet mantiene tutto portabile. Puoi caricare questi file con pandas per ispezionare le entità, sfogliare le relazioni o fare debug dei problemi di estrazione. L'intera directory del progetto è abbastanza piccola da essere versionata (meno di 10MB per questo corpus), escludendo solo il file .env che contiene la tua chiave API.
GraphRAG offre tre modalità di query. Proviamole tutte.
Ricerca globale per domande tematiche:
graphrag query \
 	--root . \
 	--method global \
 	--query "What are the main themes and lessons about startups in these essays?"
SUCCESS: Global Search Response:
The essays present several interconnected themes about startups:
**Growth as the defining characteristic**: A startup isn't just a new company—it's
specifically designed for rapid growth. This growth orientation shapes everything
from idea selection to daily decision-making. The essays suggest using weekly
growth rate as a compass for all strategic choices.
**The power of doing unscalable things**: Counterintuitively, successful startups
often begin with manual, labor-intensive approaches. Stripe's founders would
physically set up new users on the spot. Airbnb's founders went door-to-door
recruiting hosts. These unscalable tactics bootstrap the initial user base.
**Ideas emerge from problems, not brainstorming**: The best startup ideas come
from founders solving their own problems or noticing gaps while "living in the
future." Deliberately trying to generate ideas tends to produce plausible-sounding
but ultimately weak concepts.
**User relationships matter early**: Early users provide irreplaceable feedback.
Founders should go beyond standard customer service to create exceptional
experiences, gathering insights that shape the product.La risposta sintetizza i temi dei tre saggi, qualcosa che con il RAG tradizionale richiederebbe il recupero e l'elaborazione di molti blocchi. La ricerca globale ha invece attinto dai riepiloghi delle comunità, fornendo una visione coerente ad alto livello.
Ricerca locale per domande specifiche su entità:
graphrag query \
 	--root . \
 	--method local \
 	--query "What role does Y Combinator play according to these essays?"
SUCCESS: Local Search Response:
Y Combinator functions as both an accelerator and a testing ground for startup
principles. According to the essays, YC provides:
**Funding and validation**: YC offers initial funding that lets founders focus
on building rather than fundraising. The program validates ideas through its
selection process.
**Growth measurement framework**: YC tracks startups by weekly growth rate,
with 5-7% weekly growth considered good and 10% exceptional. This metric-driven
approach forces founders to confront whether they're making real progress.
**Network effects**: B2B startups at YC gain immediate access to hundreds of
potential customers—other YC companies. Stripe leveraged this extensively in
its early days.
**Demo Day as forcing function**: The program's structure, culminating in Demo
Day presentations to investors, creates urgency that pushes founders to ship
and iterate quickly.La ricerca locale ha attraversato il grafo partendo dall'entità Y Combinator, includendo concetti collegati come metriche di crescita, Stripe e il Demo Day. La risposta resta ancorata a ciò che i saggi dicono effettivamente su YC, non a conoscenze generali.
Ricerca DRIFT per domande che richiedono ampiezza e specificità:
graphrag query \
 	--root . \
 	--method drift \
 	--query "How do the essays describe the relationship between startup ideas and user problems?"
SUCCESS: Drift Search Response:
The essays establish a direct link between viable startup ideas and genuine user
problems through several mechanisms:
**Organic discovery over invention**: Rather than brainstorming ideas, founders
should notice problems they personally experience. Microsoft, Apple, Google, and
Facebook all started this way—founders building something they themselves needed.
**The "well" vs "shallow hole" distinction**: Good ideas serve a small number of
users who desperately need the solution (a narrow, deep well) rather than many
users with mild interest (a broad, shallow hole). Depth of need matters more
than breadth of appeal initially.
**Feedback loops as validation**: Engaging directly with early users reveals
whether the problem is real and the solution fits. This feedback shapes the
product more than any amount of planning.
**Problem-first, solution-second**: The essays warn against "sitcom startup
ideas"—concepts that sound plausible but don't address real pain points. A
social network for pet owners sounds reasonable but lacks urgent demand.DRIFT è partita ampia con il contesto a livello di comunità sulla filosofia delle startup, poi ha approfondito esempi specifici come l'analogia del pozzo e le "sitcom ideas". Il risultato unisce insight tematici e dettagli concreti tratti dal testo sorgente.
Per i sistemi in produzione, usa direttamente le API Python. Il processo ha tre parti: caricare la configurazione, caricare i dati indicizzati ed eseguire le query.
Per prima cosa, imposta la configurazione caricando le variabili d'ambiente e analizzando il file delle impostazioni:
import os
 import yaml
 from pathlib import Path
 from dotenv import load_dotenv
 from graphrag.config.create_graphrag_config import create_graphrag_config

 ROOT_DIR = Path(".")

 # Load environment variables and config
 load_dotenv(ROOT_DIR / ".env")
 with open(ROOT_DIR / "settings.yaml") as f:
 	yaml_content = f.read()
 yaml_content = os.path.expandvars(yaml_content)  # Expand ${VAR} references
 settings = yaml.safe_load(yaml_content)
 config = create_graphrag_config(values=settings, root_dir=str(ROOT_DIR))
Quindi, carica tutti i dati indicizzati dai file parquet. GraphRAG memorizza separatamente entità, relazioni, comunità e blocchi di testo:
import pandas as pd

 output_dir = ROOT_DIR / "output"
 entities = pd.read_parquet(output_dir / "entities.parquet")
 communities = pd.read_parquet(output_dir / "communities.parquet")
 community_reports = pd.read_parquet(output_dir / "community_reports.parquet")
 text_units = pd.read_parquet(output_dir / "text_units.parquet")
 relationships = pd.read_parquet(output_dir / "relationships.parquet")

 print(f"Loaded {len(entities)} entities, {len(relationships)} relationships")
Loaded 74 entities, 89 relationshipsInfine, esegui le query usando le API async. La funzione local_search accetta tutti i dataframe più i parametri della query:
import asyncio
 from graphrag.api import local_search

 async def run_query(query: str):
 	response, context = await local_search(
     	config=config,
     	entities=entities,
     	communities=communities,
         community_reports=community_reports,
     	text_units=text_units,
     	relationships=relationships,
     	covariates=None,
     	community_level=2,
     	response_type="Multiple Paragraphs",
     	query=query,
 	)
 	return response

 query = "What advice do the essays give about finding startup ideas?"
 response = asyncio.run(run_query(query))
 print(response)
The essays provide several valuable insights into finding startup ideas:
Focus on Growth: A startup is designed to grow quickly. Founders should commit
to seeking ideas that can scale significantly, as this distinguishes startups
from ordinary businesses.
Identify Unmet Needs: Successful startups arise from recognizing problems that
need solving. Founders who can see different problems, particularly those
addressable through technology, are more likely to develop effective solutions.
Leverage Personal Insights: Many successful startups originate from the unique
insights of their founders, often stemming from personal experiences or
frustrations. This personal connection leads to more authentic solutions.
Explore Overlooked Markets: Founders should think outside the box and explore
markets that may be overlooked. Successful startups often emerge from ideas
that seem obvious to the founders but aren't yet recognized broadly.Le API Python ti danno il pieno controllo su quali dati caricare, quale livello di comunità interrogare e come formattare le risposte. Per applicazioni che richiedono logiche di recupero personalizzate o integrazione con sistemi esistenti, questa è la strada da seguire.
Il RAG tradizionale funziona bene finché non smette di farlo. Ti accorgi di aver raggiunto il limite quando gli utenti chiedono temi o pattern e ottengono un miscuglio di frammenti vagamente correlati invece di una risposta coerente. È il problema che GraphRAG risolve scambiando i blocchi con un knowledge graph e riepiloghi di comunità precomputati.
Il costo però è reale. L'indicizzazione consuma molte chiamate all'LLM e anche la ricerca globale non è economica. Per una piccola collezione di documenti o ricerche semplici, resta sulla ricerca vettoriale.
Ma se il tuo corpus ha connessioni ricche tra entità e ai tuoi utenti interessano quelle connessioni, GraphRAG ripaga. Scegli il tipo di query in base a ciò che stai chiedendo: globale per i temi, locale per entità specifiche, DRIFT quando servono entrambi. L'implementazione non è complicata una volta che l'hai eseguita una volta, e l'output in parquet rende l'intero sistema facile da ispezionare e fare debug.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min




